Java 8 Streams API 詳解

流式編程作為Java 8的亮點之一,是繼Java 5之後對集合的再一次升級,可以說Java 8幾大特性中,Streams API 是作為Java 函數式的主角來設計的,誇張的說,有了Streams API之後,萬物皆可一行代碼。

什麼是Stream

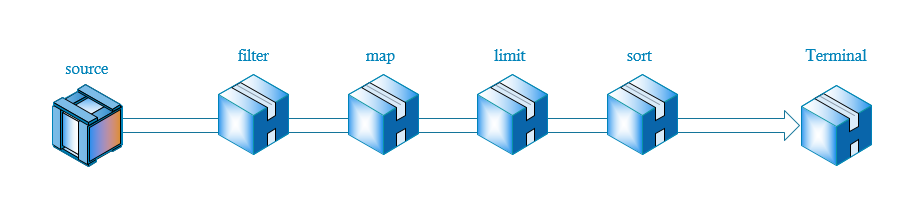
Stream被翻譯為流,它的工作過程像將一瓶水導入有很多過濾閥的管道一樣,水每經過一個過濾閥,便被操作一次,比如過濾,轉換等,最後管道的另外一頭有一個容器負責接收剩下的水。

示意圖如下:

首先通過source產生流,然後依次通過一些中間操作,比如過濾,轉換,限制等,最後結束對流的操作。

Stream也可以理解為一個更加高級的迭代器,主要的作用便是遍歷其中每一個元素。

為什麼需要Stream

Stream作為Java 8的一大亮點,它專門針對集合的各種操作提供各種非常便利,簡單,高效的API,Stream API主要是通過Lambda表達式完成,極大的提高了程序的效率和可讀性,同時Stram API中自帶的并行流使得併發處理集合的門檻再次降低,使用Stream API編程無需多寫一行多線程的大門就可以非常方便的寫出高性能的併發程序。使用Stream API能夠使你的代碼更加優雅。

流的另一特點是可無限性,使用Stream,你的數據源可以是無限大的。

在沒有Stream之前,我們想提取出所有年齡大於18的學生,我們需要這樣做:

List<Student> result=new ArrayList<>();
for(Student student:students){
 
    if(student.getAge()>18){
        result.add(student);
    }
}
return result;

使用Stream,我們可以參照上面的流程示意圖來做,首先產生Stream,然後filter過濾,最後歸併到容器中。

轉換為代碼如下:

return students.stream().filter(s->s.getAge()>18).collect(Collectors.toList());
  • 首先stream()獲得流
  • 然後filter(s->s.getAge()>18)過濾
  • 最後collect(Collectors.toList())歸併到容器中

是不是很像在寫sql?

如何使用Stream

我們可以發現,當我們使用一個流的時候,主要包括三個步驟:

  • 獲取流
  • 對流進行操作
  • 結束對流的操作

獲取流

獲取流的方式有多種,對於常見的容器(Collection)可以直接.stream()獲取
例如:

  • Collection.stream()
  • Collection.parallelStream()
  • Arrays.stream(T array) or Stream.of()

對於IO,我們也可以通過lines()方法獲取流:

  • java.nio.file.Files.walk()
  • java.io.BufferedReader.lines()

最後,我們還可以從無限大的數據源中產生流:

  • Random.ints()

值得注意的是,JDK中針對基本數據類型的昂貴的裝箱和拆箱操作,提供了基本數據類型的流:

  • IntStream
  • LongStream
  • DoubleStream

這三種基本數據類型和普通流差不多,不過他們流裏面的數據都是指定的基本數據類型。

Intstream.of(new int[]{1,2,3});
Intstream.rang(1,3);

對流進行操作

這是本章的重點,產生流比較容易,但是不同的業務系統的需求會涉及到很多不同的要求,明白我們能對流做什麼,怎麼做,才能更好的利用Stream API的特點。

流的操作類型分為兩種:

  • Intermediate:中間操作,一個流可以後面跟隨零個或多個intermediate操作。其目的主要是打開流,做出某種程度的數據映射/過濾,然後會返回一個新的流,交給下一個操作使用。這類操作都是惰性化的(lazy),就是說,僅僅調用到這類方法,並沒有真正開始流的遍歷。

    map (mapToInt, flatMap 等)、 filter、 distinct、 sorted、 peek、 limit、 skip、 parallel、 sequential、 unordered

  • Terminal:終結操作,一個流只能有一個terminal操作,當這個操作執行后,流就被使用“光”了,無法再被操作。所以這必定是流的最後一個操作。Terminal操作的執行,才會真正開始流的遍歷,並且會生成一個結果,或者一個 side effect。

    forEach、 forEachOrdered、 toArray、 reduce、 collect、 min、 max、 count、 anyMatch、 allMatch、 noneMatch、 findFirst、 findAny、 iterator

Intermediate和Terminal完全可以按照上圖的流程圖理解,Intermediate表示在管道中間的過濾器,水會流入過濾器,然後再流出去,而Terminal操作便是最後一個過濾器,它在管道的最後面,流入Terminal的水,最後便會流出管道。

下面依次詳細的解讀下每一個操作所能產生的效果:

中間操作

對於中間操作,所有的API的返回值基本都是Stream<T>,因此以後看見一個陌生的API也能通過返回值判斷它的所屬類型。

map/flatMap

map顧名思義,就是映射,map操作能夠將流中的每一個元素映射為另外的元素。

 <R> Stream<R> map(Function<? super T, ? extends R> mapper);

可以看到map接受的是一個Function,也就是接收參數,並返回一個值。

比如:

//提取 List<Student>  所有student 的名字 
List<String> studentNames = students.stream().map(Student::getName)
                                             .collect(Collectors.toList());

上面的代碼等同於以前的:

List<String> studentNames=new ArrayList<>();
for(Student student:students){
    studentNames.add(student.getName());
}

再比如:將List中所有字母轉換為大寫:

List<String> words=Arrays.asList("a","b","c");
List<String> upperWords=words.stream().map(String::toUpperCase)
                                      .collect(Collectors.toList());

flatMap顧名思義就是扁平化映射,它具體的操作是將多個stream連接成一個stream,這個操作是針對類似多維數組的,比如容器裡面包含容器等。

List<List<Integer>> ints=new ArrayList<>(Arrays.asList(Arrays.asList(1,2),
                                          Arrays.asList(3,4,5)));
List<Integer> flatInts=ints.stream().flatMap(Collection::stream).
                                       collect(Collectors.toList());

可以看到,相當於降維。

filter

filter顧名思義,就是過濾,通過測試的元素會被留下來並生成一個新的Stream

Stream<T> filter(Predicate<? super T> predicate);

同理,我們可以filter接收的參數是Predicate,也就是推斷型函數式接口,接收參數,並返回boolean值。

比如:

//獲取所有大於18歲的學生
List<Student> studentNames = students.stream().filter(s->s.getAge()>18)
                                              .collect(Collectors.toList());

distinct

distinct是去重操作,它沒有參數

  Stream<T> distinct();

sorted

sorted排序操作,默認是從小到大排列,sorted方法包含一個重載,使用sorted方法,如果沒有傳遞參數,那麼流中的元素就需要實現Comparable<T>方法,也可以在使用sorted方法的時候傳入一個Comparator<T>

Stream<T> sorted(Comparator<? super T> comparator);

Stream<T> sorted();

值得一說的是這個Comparator在Java 8之後被打上了@FunctionalInterface,其他方法都提供了default實現,因此我們可以在sort中使用Lambda表達式

例如:

//以年齡排序
students.stream().sorted((s,o)->Integer.compare(s.getAge(),o.getAge()))
                                  .forEach(System.out::println);;

然而還有更方便的,Comparator默認也提供了實現好的方法引用,使得我們更加方便的使用:

例如上面的代碼可以改成如下:

//以年齡排序 
students.stream().sorted(Comparator.comparingInt(Student::getAge))
                            .forEach(System.out::println);;

或者:

//以姓名排序
students.stream().sorted(Comparator.comparing(Student::getName)).
                          forEach(System.out::println);

是不是更加簡潔。

peek

peek有遍歷的意思,和forEach一樣,但是它是一个中間操作。

peek接受一個消費型的函數式接口。

Stream<T> peek(Consumer<? super T> action);

例如:

//去重以後打印出來,然後再歸併為List
List<Student> sortedStudents= students.stream().distinct().peek(System.out::println).
                                                collect(Collectors.toList());

limit

limit裁剪操作,和String::subString(0,x)有點先溝通,limit接受一個long類型參數,通過limit之後的元素只會剩下min(n,size)個元素,n表示參數,size表示流中元素個數

 Stream<T> limit(long maxSize);

例如:

//只留下前6個元素並打印
students.stream().limit(6).forEach(System.out::println);

skip

skip表示跳過多少個元素,和limit比較像,不過limit是保留前面的元素,skip是保留後面的元素

Stream<T> skip(long n);

例如:

//跳過前3個元素並打印 
students.stream().skip(3).forEach(System.out::println);

終結操作

一個流處理中,有且只能有一個終結操作,通過終結操作之後,流才真正被處理,終結操作一般都返回其他的類型而不再是一個流,一般來說,終結操作都是將其轉換為一個容器。

forEach

forEach是終結操作的遍歷,操作和peek一樣,但是forEach之後就不會再返迴流

 void forEach(Consumer<? super T> action);

例如:

//遍歷打印
students.stream().forEach(System.out::println);

上面的代碼和一下代碼效果相同:

for(Student student:students){
    System.out.println(sudents);
}

toArray

toArray和List##toArray()用法差不多,包含一個重載。

默認的toArray()返回一個Object[],

也可以傳入一個IntFunction<A[]> generator指定數據類型

一般建議第二種方式。

Object[] toArray();

<A> A[] toArray(IntFunction<A[]> generator);

例如:

 Student[] studentArray = students.stream().skip(3).toArray(Student[]::new);

max/min

max/min即使找出最大或者最小的元素。max/min必須傳入一個Comparator。

Optional<T> min(Comparator<? super T> comparator);

Optional<T> max(Comparator<? super T> comparator);

count

count返迴流中的元素數量

long count();

例如:

long  count = students.stream().skip(3).count();

reduce

reduce為歸納操作,主要是將流中各個元素結合起來,它需要提供一個起始值,然後按一定規則進行運算,比如相加等,它接收一個二元操作 BinaryOperator函數式接口。從某種意義上來說,sum,min,max,average都是特殊的reduce

reduce包含三個重載:

T reduce(T identity, BinaryOperator<T> accumulator);

Optional<T> reduce(BinaryOperator<T> accumulator);

 <U> U reduce(U identity,
                 BiFunction<U, ? super T, U> accumulator,
                 BinaryOperator<U> combiner);

例如:

List<Integer> integers = new ArrayList<>(Arrays.asList(1, 2, 3, 4, 5, 6, 7, 8, 9, 10));
        
long count = integers.stream().reduce(0,(x,y)->x+y);

以上代碼等同於:

long count = integers.stream().reduce(Integer::sum).get();

reduce兩個參數和一個參數的區別在於有沒有提供一個起始值,

如果提供了起始值,則可以返回一個確定的值,如果沒有提供起始值,則返回Opeational防止流中沒有足夠的元素。

anyMatch allMatch noneMatch

測試是否有任意元素\所有元素\沒有元素匹配表達式

他們都接收一個推斷類型的函數式接口:Predicate

 boolean anyMatch(Predicate<? super T> predicate);

 boolean allMatch(Predicate<? super T> predicate);

 boolean noneMatch(Predicate<? super T> predicate)

例如:

 boolean test = integers.stream().anyMatch(x->x>3);

findFirst、 findAny

獲取元素,這兩個API都不接受任何參數,findFirt返迴流中第一個元素,findAny返迴流中任意一個元素。

Optional<T> findFirst();

Optional<T> findAny();

也有有人會問findAny()這麼奇怪的操作誰會用?這個API主要是為了在并行條件下想要獲取任意元素,以最大性能獲取任意元素

例如:

int foo = integers.stream().findAny().get();

collect

collect收集操作,這個API放在後面將是因為它太重要了,基本上所有的流操作最後都會使用它。

我們先看collect的定義:

 <R> R collect(Supplier<R> supplier,
                  BiConsumer<R, ? super T> accumulator,
                  BiConsumer<R, R> combiner);

<R, A> R collect(Collector<? super T, A, R> collector);

可以看到,collect包含兩個重載:

一個參數和三個參數,

三個參數我們很少使用,因為JDK提供了足夠我們使用的Collector供我們直接使用,我們可以簡單了解下這三個參數什麼意思:

  • Supplier:用於產生最後存放元素的容器的生產者
  • accumulator:將元素添加到容器中的方法
  • combiner:將分段元素全部添加到容器中的方法

前兩個元素我們都很好理解,第三個元素是幹嘛的呢?因為流提供了并行操作,因此有可能一個流被多個線程分別添加,然後再將各個子列表依次添加到最終的容器中。

↓ – – – – – – – – –

↓ — — —

↓ ———

如上圖,分而治之。

例如:

List<String> result = stream.collect(ArrayList::new, List::add, List::addAll);

接下來看只有一個參數的collect

一般來說,只有一個參數的collect,我們都直接傳入Collectors中的方法引用即可:

List<Integer> = integers.stream().collect(Collectors.toList());

Collectors中包含很多常用的轉換器。toList(),toSet()等。

Collectors中還包括一個groupBy(),他和Sql中的groupBy一樣都是分組,返回一個Map

例如:

//按學生年齡分組
Map<Integer,List<Student>> map= students.stream().
                                collect(Collectors.groupingBy(Student::getAge));

groupingBy可以接受3個參數,分別是

  1. 第一個參數:分組按照什麼分類
  2. 第二個參數:分組最後用什麼容器保存返回(當只有兩個參數是,此參數默認為HashMap)
  3. 第三個參數:按照第一個參數分類后,對應的分類的結果如何收集

有時候單參數的groupingBy不滿足我們需求的時候,我們可以使用多個參數的groupingBy

例如:

//將學生以年齡分組,每組中只存學生的名字而不是對象
Map<Integer,List<String>> map =  students.stream().
  collect(Collectors.groupingBy(Student::getAge,Collectors.mapping(Student::getName,Collectors.toList())));

toList默認生成的是ArrayList,toSet默認生成的是HashSet,如果想要指定其他容器,可以如下操作:

 students.stream().collect(Collectors.toCollection(TreeSet::new));

Collectors還包含一個toMap,利用這個API我們可以將List轉換為Map

  Map<Integer,Student> map=students.stream().
                           collect(Collectors.toMap(Student::getAge,s->s));

值得注意的一點是,IntStream,LongStream,DoubleStream是沒有collect()方法的,因為對於基本數據類型,要進行裝箱,拆箱操作,SDK並沒有將它放入流中,對於基本數據類型流,我們只能將其toArray()

優雅的使用Stream

了解了Stream API,下面詳細介紹一下如果優雅的使用Steam

  • 了解流的惰性操作

    前面說到,流的中間操作是惰性的,如果一個流操作流程中只有中間操作,沒有終結操作,那麼這個流什麼都不會做,整個流程中會一直等到遇到終結操作操作才會真正的開始執行。

    例如:

    students.stream().peek(System.out::println);

    這樣的流操作只有中間操作,沒有終結操作,那麼不管流裡面包含多少元素,他都不會執行任何操作。

  • 明白流操作的順序的重要性

    在Stream API中,還包括一類Short-circuiting,它能夠改變流中元素的數量,一般這類API如果是中間操作,最好寫在靠前位置:

    考慮下面兩行代碼:

    students.stream().sorted(Comparator.comparingInt(Student::getAge)).
                      peek(System.out::println).
                      limit(3).              
                      collect(Collectors.toList());
    students.stream().limit(3).
                      sorted(Comparator.comparingInt(Student::getAge)).
                      peek(System.out::println).
                      collect(Collectors.toList());

    兩段代碼所使用的API都是相同的,但是由於順序不同,帶來的結果都非常不一樣的,

    第一段代碼會先排序所有的元素,再依次打印一遍,最後獲取前三個最小的放入list中,

    第二段代碼會先截取前3個元素,在對這三個元素排序,然後遍歷打印,最後放入list中。

  • 明白Lambda的局限性

    由於Java目前只能Pass-by-value,因此對於Lambda也和有匿名類一樣的final的局限性。

    具體原因可以參考

    因此我們無法再lambda表達式中修改外部元素的值。

    同時,在Stream中,我們無法使用break提前返回。

  • 合理編排Stream的代碼格式

    由於可能在使用流式編程的時候會處理很多的業務邏輯,導致API非常長,此時最後使用換行將各個操作分離開來,使得代碼更加易讀。

    例如:

    students.stream().limit(3).
                      sorted(Comparator.comparingInt(Student::getAge)).
                      peek(System.out::println).
                      collect(Collectors.toList());

    而不是:

    students.stream().limit(3).sorted(Comparator.comparingInt(Student::getAge)).peek(System.out::println).collect(Collectors.toList());

    同時由於Lambda表達式省略了參數類型,因此對於變量,盡量使用完成的名詞,比如student而不是s,增加代碼的可讀性。

    盡量寫出敢在代碼註釋上留下你的名字的代碼!

總結

總之,Stream是Java 8 提供的簡化代碼的神器,合理使用它,能讓你的代碼更加優雅。

尊重勞動成功,轉載註明出處

參考鏈接:

《Effective Java》3th

如果覺得寫得不錯,歡迎關注微信公眾號:逸游Java ,每天不定時發布一些有關Java乾貨的文章,感謝關注

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開
有了四步解題法模板,再也不害怕動態規劃!(看不懂算我輸)

導言

動態規劃問題一直是算法面試當中的重點和難點,並且動態規劃這種通過空間換取時間的算法思想在實際的工作中也會被頻繁用到,這篇文章的目的主要是解釋清楚 什麼是動態規劃,還有就是面對一道動態規劃問題,一般的 思考步驟 以及其中的注意事項等等,最後通過幾道題目將理論和實踐結合。

什麼是動態規劃

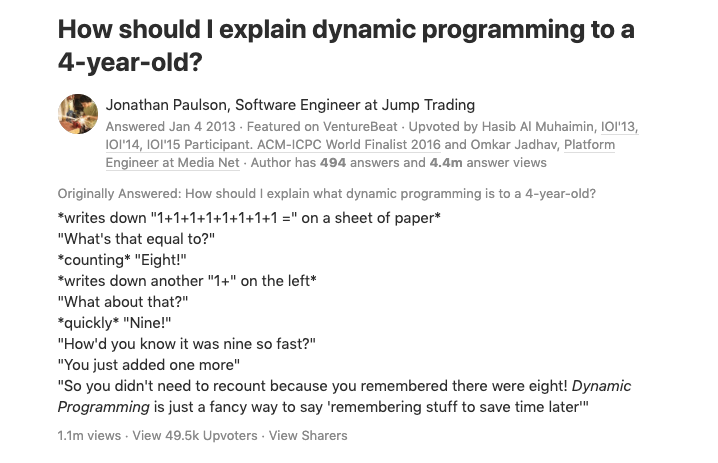
如果你還沒有聽說過動態規劃,或者僅僅只有耳聞,或許你可以看看 Quora 上面的這個 回答。

How to explain dynamic

用一句話解釋動態規劃就是 “記住你之前做過的事”,如果更準確些,其實是 “記住你之前得到的答案”。

我舉個大家工作中經常遇到的例子。

在軟件開發中,大家經常會遇到一些系統配置的問題,配置不對,系統就會報錯,這個時候一般都會去 Google 或者是查閱相關的文檔,花了一定的時間將配置修改好。

過了一段時間,去到另一個系統,遇到類似的問題,這個時候已經記不清之前修改過的配置文件長什麼樣,這個時候有兩種方案,一種方案還是去 Google 或者查閱文檔,另一種方案是借鑒之前修改過的配置,第一種做法其實是萬金油,因為你遇到的任何問題其實都可以去 Google,去查閱相關文件找答案,但是這會花費一定的時間,相比之下,第二種方案肯定會更加地節約時間,但是這個方案是有條件的,條件如下:

  • 之前的問題和當前的問題有着關聯性,換句話說,之前問題得到的答案可以幫助解決當前問題
  • 需要記錄之前問題的答案

當然在這個例子中,可以看到的是,上面這兩個條件均滿足,大可去到之前配置過的文件中,將配置拷貝過來,然後做些細微的調整即可解決當前問題,節約了大量的時間。

不知道你是否從這些描述中發現,對於一個動態規劃問題,我們只需要從兩個方面考慮,那就是 找出問題之間的聯繫,以及 記錄答案,這裏的難點其實是找出問題之間的聯繫,記錄答案只是順帶的事情,利用一些簡單的數據結構就可以做到。

概念

上面的解釋如果大家可以理解的話,接

  動態規劃算法是通過拆分問題,定義問題狀態和狀態之間的關係,使得問題能夠以遞推(或者說分治)的方式去解決。它的幾個重要概念如下所述。

  階段:對於一個完整的問題過程,適當的切分為若干個相互聯繫的子問題,每次在求解一個子問題,則對應一個階段,整個問題的求解轉化為按照階段次序去求解。

  狀態:狀態表示每個階段開始時所處的客觀條件,即在求解子問題時的已知條件。狀態描述了研究的問題過程中的狀況。

  決策:決策表示當求解過程處於某一階段的某一狀態時,可以根據當前條件作出不同的選擇,從而確定下一個階段的狀態,這種選擇稱為決策。

  策略:由所有階段的決策組成的決策序列稱為全過程策略,簡稱策略。

  最優策略:在所有的策略中,找到代價最小,性能最優的策略,此策略稱為最優策略。

  狀態轉移方程:狀態轉移方程是確定兩個相鄰階段狀態的演變過程,描述了狀態之間是如何演變的。

思考動態規劃問題的四個步驟

一般解決動態規劃問題,分為四個步驟,分別是

  • 問題拆解,找到問題之間的具體聯繫
  • 狀態定義
  • 遞推方程推導
  • 實現

這裏面的重點其實是前兩個,如果前兩個步驟順利完成,後面的遞推方程推導和代碼實現會變得非常簡單。

這裏還是拿 Quora 上面的例子來講解,“1+1+1+1+1+1+1+1” 得出答案是 8,那麼如何快速計算 “1+ 1+1+1+1+1+1+1+1”,我們首先可以對這個大的問題進行拆解,這裏我說的大問題是 9 個 1 相加,這個問題可以拆解成 1 + “8 個 1 相加的答案”,8 個 1 相加繼續拆,可以拆解成 1 + “7 個 1 相加的答案”,… 1 + “0 個 1 相加的答案”,到這裏,第一個步驟 已經完成。

狀態定義 其實是需要思考在解決一個問題的時候我們做了什麼事情,然後得出了什麼樣的答案,對於這個問題,當前問題的答案就是當前的狀態,基於上面的問題拆解,你可以發現兩個相鄰的問題的聯繫其實是 后一個問題的答案 = 前一個問題的答案 + 1,這裏,狀態的每次變化就是 +1。

定義好了狀態,遞推方程就變得非常簡單,就是 dp[i] = dp[i - 1] + 1,這裏的 dp[i] 記錄的是當前問題的答案,也就是當前的狀態,dp[i - 1] 記錄的是之前相鄰的問題的答案,也就是之前的狀態,它們之間通過 +1 來實現狀態的變更。

最後一步就是實現了,有了狀態表示和遞推方程,實現這一步上需要重點考慮的其實是初始化,就是用什麼樣的數據結構,根據問題的要求需要做那些初始值的設定。

public int dpExample(int n) {
    int[] dp = new int[n + 1];  // 多開一位用來存放 0 個 1 相加的結果

    dp[0] = 0;      // 0 個 1 相加等於 0

    for (int i = 1; i <= n; ++i) {
        dp[i] = dp[i - 1] + 1;
    }

    return dp[n];
}

你可以看到,動態規劃這四個步驟其實是相互遞進的,狀態的定義離不開問題的拆解,遞推方程的推導離不開狀態的定義,最後的實現代碼的核心其實就是遞推方程,這中間如果有一個步驟卡殼了則會導致問題無法解決,當問題的複雜程度增加的時候,這裏面的思維複雜程度會上升。

接下來我們再來看看 LeetCode 上面的幾道題目,通過題目再來走一下這些個分析步驟。

題目實戰

爬樓梯

但凡涉及到動態規劃的題目都離不開一道例題:爬樓梯(LeetCode 第 70 號問題)。

題目描述

假設你正在爬樓梯。需要 n 階你才能到達樓頂。

每次你可以爬 1 或 2 個台階。你有多少種不同的方法可以爬到樓頂呢?

注意:給定 n 是一個正整數。

示例 1:

輸入: 2
輸出: 2
解釋: 有兩種方法可以爬到樓頂。

1. 1 階 + 1 階
2. 2 階

示例 2:

輸入: 3
輸出: 3
解釋: 有三種方法可以爬到樓頂。

1. 1 階 + 1 階 + 1 階
2. 1 階 + 2 階
3. 2 階 + 1 階

題目解析

爬樓梯,可以爬一步也可以爬兩步,問有多少種不同的方式到達終點,我們按照上面提到的四個步驟進行分析:

  • 問題拆解:

    我們到達第 n 個樓梯可以從第 n – 1 個樓梯和第 n – 2 個樓梯到達,因此第 n 個問題可以拆解成第 n – 1 個問題和第 n – 2 個問題,第 n – 1 個問題和第 n – 2 個問題又可以繼續往下拆,直到第 0 個問題,也就是第 0 個樓梯 (起點)

  • 狀態定義

    “問題拆解” 中已經提到了,第 n 個樓梯會和第 n – 1 和第 n – 2 個樓梯有關聯,那麼具體的聯繫是什麼呢?你可以這樣思考,第 n – 1 個問題裏面的答案其實是從起點到達第 n – 1 個樓梯的路徑總數,n – 2 同理,從第 n – 1 個樓梯可以到達第 n 個樓梯,從第 n – 2 也可以,並且路徑沒有重複,因此我們可以把第 i 個狀態定義為 “從起點到達第 i 個樓梯的路徑總數”,狀態之間的聯繫其實是相加的關係。

  • 遞推方程

    “狀態定義” 中我們已經定義好了狀態,也知道第 i 個狀態可以由第 i – 1 個狀態和第 i – 2 個狀態通過相加得到,因此遞推方程就出來了 dp[i] = dp[i - 1] + dp[i - 2]

  • 實現

    你其實可以從遞推方程看到,我們需要有一個初始值來方便我們計算,起始位置不需要移動 dp[0] = 0,第 1 層樓梯只能從起始位置到達,因此 dp[1] = 1,第 2 層樓梯可以從起始位置和第 1 層樓梯到達,因此 dp[2] = 2,有了這些初始值,後面就可以通過這幾個初始值進行遞推得到。

參考代碼

public int climbStairs(int n) {
    if (n == 1) {
        return 1;
    }

    int[] dp = new int[n + 1];  // 多開一位,考慮起始位置

    dp[0] = 0; dp[1] = 1; dp[2] = 2;
    for (int i = 3; i <= n; ++i) {
        dp[i] = dp[i - 1] + dp[i - 2];
    }

    return dp[n];
}

三角形最小路徑和

LeetCode 第 120 號問題:三角形最小路徑和。

題目描述

給定一個三角形,找出自頂向下的最小路徑和。每一步只能移動到下一行中相鄰的結點上。

例如,給定三角形:

[
     [2],
    [3,4],
   [6,5,7],
  [4,1,8,3]
]

自頂向下的最小路徑和為 11(即,2 + 3 + 5 + 1 = 11)。

說明:

如果你可以只使用 O(n) 的額外空間(n 為三角形的總行數)來解決這個問題,那麼你的算法會很加分。

題目解析

給定一個三角形數組,需要求出從上到下的最小路徑和,也和之前一樣,按照四個步驟來分析:

  • 問題拆解:

    這裏的總問題是求出最小的路徑和,路徑是這裏的分析重點,路徑是由一個個元素組成的,和之前爬樓梯那道題目類似,[i][j] 位置的元素,經過這個元素的路徑肯定也會經過 [i - 1][j] 或者 [i - 1][j - 1],因此經過一個元素的路徑和可以通過這個元素上面的一個或者兩個元素的路徑和得到。

  • 狀態定義

    狀態的定義一般會和問題需要求解的答案聯繫在一起,這裏其實有兩種方式,一種是考慮路徑從上到下,另外一種是考慮路徑從下到上,因為元素的值是不變的,所以路徑的方向不同也不會影響最後求得的路徑和,如果是從上到下,你會發現,在考慮下面元素的時候,起始元素的路徑只會從[i - 1][j] 獲得,每行當中的最後一個元素的路徑只會從 [i - 1][j - 1] 獲得,中間二者都可,這樣不太好實現,因此這裏考慮從下到上的方式,狀態的定義就變成了 “最後一行元素到當前元素的最小路徑和”,對於 [0][0] 這個元素來說,最後狀態表示的就是我們的最終答案。

  • 遞推方程

    “狀態定義” 中我們已經定義好了狀態,遞推方程就出來了

    dp[i][j] = Math.min(dp[i + 1][j], dp[i + 1][j + 1]) + triangle[i][j]
  • 實現

    這裏初始化時,我們需要將最後一行的元素填入狀態數組中,然後就是按照前面分析的策略,從下到上計算即可

參考代碼

public int minimumTotal(List<List<Integer>> triangle) {
    int n = triangle.size();

    int[][] dp = new int[n][n];

    List<Integer> lastRow = triangle.get(n - 1);

    for (int i = 0; i < n; ++i) {
        dp[n - 1][i] = lastRow.get(i);
    }

    for (int i = n - 2; i >= 0; --i) {
        List<Integer> row = triangle.get(i);
        for (int j = 0; j < i + 1; ++j) {
            dp[i][j] = Math.min(dp[i + 1][j], dp[i + 1][j + 1]) + row.get(j);
        }
    }

    return dp[0][0];
}

最大子序和

LeetCode 第 53 號問題:最大子序和。

題目描述

給定一個整數數組 nums ,找到一個具有最大和的連續子數組(子數組最少包含一個元素),返回其最大和。

示例:

輸入: [-2,1,-3,4,-1,2,1,-5,4],
輸出: 6
解釋: 連續子數組 [4,-1,2,1] 的和最大,為 6。

進階:

如果你已經實現複雜度為 O(n) 的解法,嘗試使用更為精妙的分治法求解。

題目解析

求最大子數組和,非常經典的一道題目,這道題目有很多種不同的做法,而且很多算法思想都可以在這道題目上面體現出來,比如動態規劃、貪心、分治,還有一些技巧性的東西,比如前綴和數組,這裏還是使用動態規劃的思想來解題,套路還是之前的四步驟:

  • 問題拆解:

    問題的核心是子數組,子數組可以看作是一段區間,因此可以由起始點和終止點確定一個子數組,兩個點中,我們先確定一個點,然後去找另一個點,比如說,如果我們確定一個子數組的截止元素在 i 這個位置,這個時候我們需要思考的問題是 “以 i 結尾的所有子數組中,和最大的是多少?”,然後我們去試着拆解,這裏其實只有兩種情況:

  • i 這個位置的元素自成一個子數組

  • i 位置的元素的值 + 以 i – 1 結尾的所有子數組中的子數組和最大的值

    你可以看到,我們把第 i 個問題拆成了第 i – 1 個問題,之間的聯繫也變得清晰

  • 狀態定義

    通過上面的分析,其實狀態已經有了,dp[i] 就是 “以 i 結尾的所有子數組的最大值”

  • 遞推方程

    拆解問題的時候也提到了,有兩種情況,即當前元素自成一個子數組,另外可以考慮前一個狀態的答案,於是就有了

    dp[i] = Math.max(dp[i - 1] + array[i], array[i])

    化簡一下就成了:

    dp[i] = Math.max(dp[i - 1], 0) + array[i]
  • 實現

    題目要求子數組不能為空,因此一開始需要初始化,也就是 dp[0] = array[0],保證最後答案的可靠性,另外我們需要用一個變量記錄最後的答案,因為子數組有可能以數組中任意一個元素結尾

參考代碼

public int maxSubArray(int[] nums) {
    if (nums == null || nums.length == 0) {
        return 0;
    }

    int n = nums.length;

    int[] dp = new int[n];

    dp[0] = nums[0];

    int result = dp[0];

    for (int i = 1; i < n; ++i) {
        dp[i] = Math.max(dp[i - 1], 0) + nums[i];
        result = Math.max(result, dp[i]);
    }

    return result;
}

總結

通過這幾個簡單的例子,相信你不難發現,解動態規劃題目其實就是拆解問題,定義狀態的過程,嚴格說來,動態規劃並不是一個具體的算法,而是凌駕於算法之上的一種 思想 。

這種思想強調的是從局部最優解通過一定的策略推得全局最優解,從子問題的答案一步步推出整個問題的答案,並且利用空間換取時間。從很多算法之中你都可以看到動態規劃的影子,所以,還是那句話 技術都是相通的,找到背後的本質思想是關鍵。

公眾號:五分鐘學算法(ID:CXYxiaowu)
博客:www.cxyxiaowu.com(目前更新了 500 篇算法文章,歡迎訪問學習)
知乎:程序員吳師兄
一個正在學習算法的人,致力於將算法講清楚​!

​

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

Android音頻開發(1):基礎知識

Android音頻開發(1):基礎知識

導讀

人的說話頻率基本上為300Hz~3400Hz,但是人耳朵聽覺頻率基本上為20Hz~20000Hz。

對於人類的語音信號而言,實際處理一般經過以下步驟:

人嘴說話——>聲電轉換——>抽樣(模數轉換)——>量化(將数字信號用適當的數值表示)——>編碼(數據壓縮)——>

傳輸(網絡或者其他方式)

——> 解碼(數據還原)——>反抽樣(數模轉換)——>電聲轉換——>人耳聽聲。

  • 抽樣率

實際中,人發出的聲音信號為模擬信號,想要在實際中處理必須為数字信號,即採用抽樣、量化、編碼的處理方案。

處理的第一步為抽樣,即模數轉換。

簡單地說就是通過波形採樣的方法記錄1秒鐘長度的聲音,需要多少個數據。

根據奈魁斯特(NYQUIST)採樣定理,用兩倍於一個正弦波的頻繁率進行採樣就能完全真實地還原該波形。

所以,對於聲音信號而言,要想對離散信號進行還原,必須將抽樣頻率定為40KHz以上。實際中,一般定為44.1KHz。

44.1KHz採樣率的聲音就是要花費44000個數據來描述1秒鐘的聲音波形。

原則上採樣率越高,聲音的質量越好,採樣頻率一般共分為22.05KHz、44.1KHz、48KHz三個等級。

22.05 KHz只能達到FM廣播的聲音品質,44.1KHz則是理論上的CD音質界限,48KHz則已達到DVD音質了。

  • 碼率

對於音頻信號而言,實際上必須進行編碼。在這裏,編碼指信源編碼,即數據壓縮。如果,未經過數據壓縮,直接量化進行傳輸則被稱為PCM(脈衝編碼調製)。
要算一個PCM音頻流的碼率是一件很輕鬆的事情,採樣率值×採樣大小值×聲道數 bps。
一個採樣率為44.1KHz,採樣大小為16bit,雙聲道的PCM編碼的WAV文件,它的數據速率則為 44.1K×16×2 =1411.2 Kbps。
我們常說128K的MP3,對應的WAV的參數,就是這個1411.2 Kbps,這個參數也被稱為數據帶寬,它和ADSL中的帶寬是一個概念。將碼率除以8,就可以得到這個WAV的數據速率,即176.4KB/s。

這表示存儲一秒鐘採樣率為44.1KHz,採樣大小為16bit,雙聲道的PCM編碼的音頻信號,需要176.4KB的空間,1分鐘則約為10.34M,這對大部分用戶是不可接受的,尤其是喜歡在電腦上聽音樂的朋友,要降低磁盤佔用

只有2種方法,降低採樣指標或者壓縮。降低指標是不可取的,因此專家們研發了各種壓縮方案。最原始的有DPCM、ADPCM,其中最出名的為MP3。

所以,採用了數據壓縮以後的碼率遠小於原始碼率。

一、發的主要應用有哪些?

音頻播放器,錄音機,語音電話,音視頻監控應用,音視頻直播應用,音頻編輯/處理軟件,藍牙耳機/音箱,等等。

二、頻開發的具體內容有哪些?

(1)音頻採集/播放

(2)音頻算法處理(去噪、靜音檢測、回聲消除、音效處理、功放/增強、混音/分離,等等)

(3)音頻的編解碼和格式轉換

(4)音頻傳輸協議的開發(SIP,A2DP、AVRCP,等等)

三、 音頻應用的難點在哪?

延時敏感、卡頓敏感、噪聲抑制(Denoise)、回聲消除(AEC)、靜音檢測(VAD)、混音算法,等等。

四、 音頻開發基礎概念有哪些?

在音頻開發中,下面的這幾個概念經常會遇到。

1. 採樣率(samplerate)

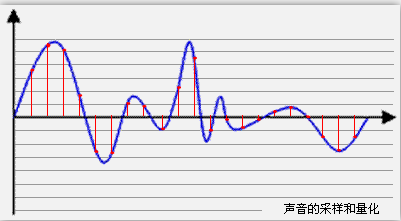
採樣就是把模擬信號数字化的過程,不僅僅是音頻需要採樣,所有的模擬信號都需要通過採樣轉換為可以用0101來表示的数字信號,示意圖如下所示:

藍色代表模擬音頻信號,紅色的點代表採樣得到的量化數值。

採樣頻率越高,紅色的間隔就越密集,記錄這一段音頻信號所用的數據量就越大,同時音頻質量也就越高。

根據奈奎斯特理論,採樣頻率只要不低於音頻信號最高頻率的兩倍,就可以無損失地還原原始的聲音。

通常人耳能聽到頻率範圍大約在20Hz~20kHz之間的聲音,為了保證聲音不失真,採樣頻率應在40kHz以上。常用的音頻採樣頻率有:8kHz、11.025kHz、22.05kHz、16kHz、37.8kHz、44.1kHz、48kHz、96kHz、192kHz等。

對採樣率為44.1kHz的AAC音頻進行解碼時,一幀的解碼時間須控制在23.22毫秒內。

通常是按1024個採樣點一幀

分析:

1. AAC

一個AAC原始幀包含某段時間內1024個採樣點相關數據。

用1024主要是因為AAC是用的1024點的mdct。

音頻幀的播放時間=一個AAC幀對應的採樣樣本的個數/採樣頻率(單位為s)

採樣率(samplerate)為 44100Hz,表示每秒 44100個採樣點,

所以,根據公式,

音頻幀的播放時長 = 一個AAC幀對應的採樣點個數 / 採樣頻率

則,當前一幀的播放時間 = 1024 * 1000/44100= 23.22 ms(單位為ms)

48kHz採樣率,

則,當前一幀的播放時間 = 1024 * 1000/48000= 21.333ms(單位為ms)

22.05kHz採樣率,

則,當前一幀的播放時間 = 1024 * 1000/22050= 46.439ms(單位為ms)

2. MP3

mp3 每幀均為1152個字節,

則:

每幀播放時長 = 1152 * 1000 / sample_rate

例如:sample_rate = 44100HZ時,

計算出的時長為26.122ms,

這就是經常聽到的mp3每幀播放時間固定為26ms的由來。

2. 量化精度(位寬)

上圖中,每一個紅色的採樣點,都需要用一個數值來表示大小,這個數值的數據類型大小可以是:4bit、8bit、16bit、32bit等等,位數越多,表示得就越精細,聲音質量自然就越好,當然,數據量也會成倍增大。

常見的位寬是:8bit 或者 16bit

3. 聲道數(channels)

由於音頻的採集和播放是可以疊加的,因此,可以同時從多個音頻源採集聲音,並分別輸出到不同的揚聲器,故聲道數一般表示聲音錄製時的音源數量或回放時相應的揚聲器數量。

單聲道(Mono)和雙聲道(Stereo)比較常見,顧名思義,前者的聲道數為1,後者為2

4. 音頻幀(frame)

是用於測量显示幀數的量度。所謂的測量單位為每秒显示幀數(Frames per Second,簡稱:FPS)或“赫茲”(Hz)。

音頻跟視頻很不一樣,視頻每一幀就是一張圖像,而從上面的正玄波可以看出,音頻數據是流式的,本身沒有明確的一幀幀的概念,在實際的應用中,為了音頻算法處理/傳輸的方便,一般約定俗成取2.5ms~60ms為單位的數據量為一幀音頻。

這個時間被稱之為“採樣時間”,其長度沒有特別的標準,它是根據編×××和具體應用的需求來決定的,我們可以計算一下一幀音頻幀的大小:

假設某通道的音頻信號是採樣率為8kHz,位寬為16bit,20ms一幀,雙通道,則一幀音頻數據的大小為:

int size = 8000 x 16bit x 0.02s x 2 = 5120 bit = 640 byte

五、常見的音頻編碼方式有哪些?

上面提到過,模擬的音頻信號轉換為数字信號需要經過採樣和量化,量化的過程被稱之為編碼,根據不同的量化策略,產生了許多不同的編碼方式,常見的編碼方式有:PCM 和 ADPCM,這些數據代表着無損的原始数字音頻信號,添加一些文件頭信息,就可以存儲為WAV文件了,它是一種由微軟和IBM聯合開發的用於音頻数字存儲的標準,可以很容易地被解析和播放。

我們在音頻開發過程中,會經常涉及到WAV文件的讀寫,以驗證採集、傳輸、接收的音頻數據的正確性。

六、常見的音頻壓縮格式有哪些?

首先簡單介紹一下音頻數據壓縮的最基本的原理:因為有冗餘信息,所以可以壓縮。

(1) 頻譜掩蔽效應: 人耳所能察覺的聲音信號的頻率範圍為20Hz~20KHz,在這個頻率範圍以外的音頻信號屬於冗餘信號。

(2) 時域掩蔽效應: 當強音信號和弱音信號同時出現時,弱信號會聽不到,因此,弱音信號也屬於冗餘信號。

下面簡單列出常見的音頻壓縮格式:

MP3,AAC,OGG,WMA,Opus,FLAC,APE,m4a,AMR,等等

七、Adndroid VoIP相關的開源應用有哪些 ?

imsdroid,sipdroid,csipsimple,linphone,WebRTC 等等

八、音頻算法處理的開源庫有哪些 ?

speex、ffmpeg,webrtc audio module(NS、VAD、AECM、AGC),等等

九、Android提供了哪些音頻開發相關的API?

音頻採集: MediaRecoder,AudioRecord

音頻播放: SoundPool,MediaPlayer,AudioTrack

音頻編解碼: MediaCodec

NDK API: OpenSL ES

十、音頻開發的延時標準是什麼?

ITU-TG.114規定,對於高質量語音可接受的時延是300ms。一般來說,如果時延在300~400ms,通話的交互性比較差,但還可以接受。時延大於400ms時,則交互通信非常困難。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

軟件測試(開發)工程師的核心競爭力是什麼?

1. 測試行業正在發生變化

在互聯網新趨勢和新要求的變革推動下,測試行業也在不知不覺中發生着非常大的改變,從早些年的懵懂發展,大家摸着石頭過河,到大多高校設立軟件測試專業,再到近幾年各種測試培訓盛行。如果說早期軟件測試行業還是一個風口,隨着不斷地轉行人員以及畢業的大學生瘋狂地湧入軟件測試行業,目前軟件測試行業“缺口”已經基本飽和,最基礎的功能測試的崗位需求已經越來越少了。測試的進入門檻,也從真正零基礎,到現在的要求具備專業的計算機專業能力(包括不限於編程能力),軟件測試在企業的受重視程度,特別是互聯網行業,也從可有可無,到不可或缺。

2. 行業人員分佈呈現兩極勢態

測試行業不斷髮展,行業已經呈現出嚴重的兩極分化勢態,一邊是資深的測試大牛,屬於全棧複合型人才,但這一類行業中人員占的比例較為稀少。一是由於行業原因,代碼能力強,有架構經驗的人員一般都在開發部門;二是要求高,資深測試開發工程師不僅要精通測試相關的技能,還要會前端設計,服務端開發等等,幾乎是全棧工程師;而做程序的人員一般精通一點或是幾點的較多,從前到后全都能上的越來越少。另一邊是測試小白,即便是有些在測試行業中已經摸爬滾打了幾年,但仍然有很多測試人員還是停留在只會業務功能測試的這個階段。而針對這類型的測試從業人員,除了一些安於現狀的除外,大多數人其實都還是想好好學習,想進步的只是不知道學習方向,或者學習不得其法。


3. 企業需要更多高端綜合人才

但不管是屬於哪一種,對於企業而言,想快速發展自己的業務,必須有一個強大的測試團隊來保證質量,通過一系列的質量保障手段,如引入CI,CD以及其他的手段來促進項目的快速迭代與交付。這就要求相關的測試工程師要能從多方面來考慮設計和解決問題,不僅要考慮項目的實施成本,還要考慮參与的測試,開發,產品甚至用戶等人員,同時要與公司發展的前景及方向相切合,並能很好地為之服務。提供這類能力的測試人才在公司都是較為吃香的,每年的找工作季節也就那麼幾個人會進入人才市場流通,而且很快就能找到工作,這也是每個測試人員的努力方向,只有具備了相應的價值實力,才有資格向企業要求你期望的回報。


4.企業招人與求職者供求總是難以匹配

很多同學抱怨,企業招人為什麼要求越來越高,除了學歷(本科以上),還要求年齡(35內),以及項目經驗,太難太難 。其實,企業也挺苦惱的:招幾個適合的人選太難了 ,這就是所謂的「供需關係」失調了 。大批測試從業者找不到工作,大量企業找不到適合的人選 。

而造成不匹配、供需關係失調的最核心的問題歸根到底還是聚焦於能力要求不匹配。

那麼測試人員核心技能或者說測試人員的核心競爭力到底有哪些? 測試人員應該思考這個問題、企業用人單位也應該要思考需要什麼樣的測試人員?相信大家面試求職時或多或少都會有這種感覺,企業在招聘時,要求會各種框架、各種編程語言、各種工具的使用。那在我們學會了測試技術、測試工具的使用,最後核心競爭力到底聚焦在哪些方面?


5. 你的核心競爭力是什麼?

提到在軟件測試這個行業,你的核心競爭力是什麼?這是個非常有意思的話題,就像我們經常說的“團隊中的價值問題”,你經常看到測試人員自己在想,我們的價值在哪裡、是什麼?但我們很少看到軟件的開發人員或者架構師,或者運維團隊去問這樣一個問題,要去找自己的價值。這是因為測試人員對這個價值本身是不太確定的,那麼這個價值本身不確定,就會帶來的一系列的問題。

在早期軟件行業中,會發現存在一個普遍的現象,有些大學的本科,或者研究生畢業,他們去面試工作的時候就會發現,面試下來的是代碼能力可能不是太好,這種情況下公司會問你願不願意去做測試?但隨着現在這個時代的變革,現在的軟件測試工程師,他的知識面,以及他需要掌握的內容已經遠遠超過了之前,可以說他的知識面是遠遠超過開發的,比如在一些技術的面上,以及對產品的理解上。

那麼這種情況下,我們再去提一個優秀的軟件測試工程師的核心價值,我們可以很自信地說,測試工程師是一個不可被替代的,並且是一個專業細分化的領域。像早年的時候,我們談到測試,就是軟件測試,沒有細分市場,但現在你去談測試,測試現在的領域太多了,除了傳統意義上的,基於業務領域的測試,然後還有測試開發。


6. 企業為什麼不願給你開高薪?

經常會有從業者諮詢我:“怎麼轉行到測試開發崗位?測試開發崗位怎麼入手?測試開發崗位到底是做什麼的?需要掌握哪些知識 ?”

其實啊,問這些問題的時候,你可能就不太適合此崗位。或者你只是聽說測試開發工資高、奔着薪資來的,也許你完全不適合 。

正如在之前介紹測試開發的文章 : 中提到過隨着現在測試開發崗在各個公司的設定,且測試開發崗一般會頂着“薪資高”的頭銜(至少在測試這個領域,測試開發的薪資普遍都要比業務手工測試高上許多),越來越多的手工測試人員,都急於想轉崗到測試開發,但需不知往往只是看到了測試開發崗的薪資高,但卻忽略了最重要的一點(那些拿高薪的人付出的努力同樣也是比你多)!我們不妨先看看下面幾則同行人的心聲。(是否曾及何時,正在讀文的你也是這麼認為的?)

  • 很多QQ群、微信群的測試同行經常在抱怨,平日測試工作乾的很苦逼,活沒少干,加班也沒少加,但工資、獎金卻比其它崗(比如開發)要拿的少。
  • 測試工作做了好幾年了,但去外面求職的時候,屢屢碰壁,總得拿不到自己滿意的薪資Offer。
  • 認為測試崗位沒有“錢”途、工作內容做的沒有意義,不如趁早轉開發、產品。


之所以行業中會有許多從業人員有上述幾點心聲,最核心的問題點還是認為自己工作乾的活所得到的薪資待遇和自己希望得到的回報無法相匹配上。正如馬雲之前說過,企業員工離職的原因,歸根結底只有兩個:1、錢沒給夠。2、平台無法施展才能,覺得委屈了。


我相信絕大多數人,都是“倒”在了第一點原因上。那為什麼企業開的薪資就總是無法達到“大多數從業人員”的要求呢?難道企業開不起薪資?但身在同一個公司,為何又存在其它崗位“測試開發”、“開發”薪資高這一說法?這顯然並不是企業開不起薪資,而是企業認為TA所能幫助企業帶來的價值只值這麼多。


7. 對高薪崗位的誤解

不論是“測試開發”或者是“開發”,頂着“薪資高”這一普遍說法,其中大多數對這個說法還是存在誤解的,並不是所謂的“崗位薪資論”,認為做了這個崗位,就一定有高的薪資,試想一下,同樣有很多開發人員,薪資不見的就比測試牛人高。而那些之所以有着“高薪崗位的人”,是因為他們所具備的能力以及能為公司帶來的價值也是越高的。因此,`高薪!= 崗位`,而**應該是高薪要等於與之匹配的能力和能為企業帶來的等同價值**。

這一觀點,恰好也回應了上述所提到的,現在越來越多的手工測試人員都想轉行測試開發。但轉行到測試開發並不是關鍵,如果能力沒有轉變,只是崗位的頭銜轉變了,即便給你安排一個測試開發或開發的頭銜,但你的能力還只是在干一些不痛不癢的工作,那麼企業仍然是不可能會為你買單的。之所有測試開發有着高薪的說法,是由於現在企業對測試開發的綜合能力已經不亞於開發,他們的技術能力和解決業務問題的能力在某些方面甚至要強於開發。因此企業肯為這些人付出高薪的回報。

我想對那些想轉崗或者埋怨自己工資低的從業人員,奉切一句:轉崗不是最終目的,提升自身能力才是根本。如果你的能力足夠出眾,能你團隊、企業帶來的價值已經超出測試所需要提供的,即便只是頂着業務測試的頭銜,我相信,企業仍然肯為你付出相應的高回報。


8. 如何打造個人核心競爭力

那些想拿高薪或者是想轉崗成為測試開發的同學,需要做的應該是要不斷提升自身能力和價值點,這些價值點立足在團隊、公司無非就是兩類能力:1.綜合技術能力、2.幫助產品業務解決問題的能力。

1. 提升綜合技術能力,說到技術,第一關:開發語言(不管是Python,還是Java,真的無所謂,先搞懂一個再說) 。

先能獨立開發一套可用的東西。至於你寫的代碼高性能、高可用,先可以放放 。但至少得通過擼代碼,實現業務方需求吧 ?

很多測試同學問,到底學Python還是學Java ?半年後,你去問他學的咋樣的,他可能還在那糾結:“到底是學Python還是學Java ?”的問題,根本就沒開始學。

“學習這事,道理都懂,就是缺行動。”,雖然這句話,看起來像廢話,但事實如此。

很多時候,看着那些:“知道自己能力有問題、想學點啥東西、到處諮詢他人應該學啥、得到答案后、依然半年沒行動”的(別笑,看文章的你,也許就是)。

否則,怎麼可能會出現:在市場上,想招一些靠譜的從業者,那麼難 。看到很多公司,耗時幾個月招不到適合的人,雖然這裡有公司的原因,但求職者能力不符合,是很大一部分原因 。

行業在發展,一直守着“自己那點業務知識、測試流程、幾年前的工具”的同學,太多 。借用之前的觀點,定期出來面試聊聊,你會發現,你根本找不到合適的工作 。

如果還在糾結學啥開發語言的,別糾結,此刻、現在,開始,學Python 。

Python易入手,簡單,好用 。而且,如果不做測試開發,通過Python也可以玩轉各種自動化測試。


OK ,如上內容,是對測試(開發)工程師核心競爭力的一些看法,摘自本人公眾號中的一部分篇幅內容,僅代表個人觀點 。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※南投搬家前需注意的眉眉角角,別等搬了再說!

線性模型之邏輯回歸(LR)(原理、公式推導、模型對比、常見面試點),3種類型的梯度下降算法總結,李宏毅機器學習筆記2:Gradient Descent(附帶詳細的原理推導過程),L0、L1、L2范數正則化

參考資料(要是對於本文的理解不夠透徹,必須將以下博客認知閱讀,方可全面了解LR):

(1).

(2).

(3).

(4).

(5).

(6).


一、邏輯回歸介紹

  邏輯回歸(Logistic Regression)是一種廣義線性回歸。線性回歸解決的是回歸問題,預測值是實數範圍,邏輯回歸則相反,解決的是分類問題,預測值是[0,1]範圍。所以邏輯回歸名為回歸,實為分類。接下來讓我們用一句話來概括邏輯回歸(LR):

邏輯回歸假設數據服從伯努利分佈,通過極大化似然函數的方法,運用梯度下降來求解參數,來達到將數據二分類的目的。

這句話包含了五點,接下來一一介紹:

  • 邏輯回歸的假設
  • 邏輯回歸的損失函數
  • 邏輯回歸的求解方法
  • 邏輯回歸的目的
  • 邏輯回歸如何分類

 二、邏輯回歸的假設

任何的模型都是有自己的假設,在這個假設下模型才是適用的。邏輯回歸的第一個基本假設是假設數據服從伯努利分佈。

伯努利分佈:是一個離散型概率分佈,若成功,則隨機變量取值1;若失敗,隨機變量取值為0。成功概率記為p,失敗為q = 1-p。

在邏輯回歸中,既然假設了數據分佈服從伯努利分佈,那就存在一個成功和失敗,對應二分類問題就是正類和負類,那麼就應該有一個樣本為正類的概率p,和樣本為負類的概率q = 1- p。具體我們寫成這樣的形式:

邏輯回歸的第二個假設是正類的概率由sigmoid的函數計算,即:

即:

寫在一起:

個人理解,解釋一下這個公式,並不是用了樣本的標籤y,而是說你想要得到哪個的概率,y = 1時意思就是你想得到正類的概率,y = 0時就意思是你想要得到負類的概率。另外在求參數時,這個y是有用的,這點在下面會說到。

另外關於這個值,  是個概率,還沒有到它真正能成為預測標籤的地步,更具體的過程應該是分別求出正類的概率,即y = 1時,和負類的概率,y = 0時,比較哪個大,因為兩個加起來是1,所以我們通常默認的是只用求正類概率,只要大於0.5即可歸為正類,但這個0.5是人為規定的,如果願意的話,可以規定為大於0.6才是正類,這樣的話就算求出來正類概率是0.55,那也不能預測為正類,應該預測為負類。

 理解了二元分類回歸的模型,接着我們就要看模型的損失函數了,我們的目標是極小化損失函數來得到對應的模型係數θ。

 三、邏輯回歸的損失函數

 回顧下線性回歸的損失函數,由於線性回歸是連續的,所以可以使用模型誤差的的平方和來定義損失函數。但是邏輯回歸不是連續的,自然線性回歸損失函數定義的經驗就用不上了。不過我們可以用最大似然法(MLE)來推導出我們的損失函數。有點人把LR的loss function成為log損失函數,也有人把它稱為交叉熵損失函數(Cross Entropy)。

極大似然估計:利用已知的樣本結果信息,反推最具有可能(最大概率)導致這些樣本結果出現的模型參數值(模型已定,參數未知)

如何理解這句話呢?

再聯繫到邏輯回歸里,一步步來分解上面這句話,首先確定一下模型是否已定,模型就是用來預測的那個公式:

參數就是裏面的  ,那什麼是樣本結果信息,就是我們的x,y,是我們的樣本,分別為特徵和標籤,我們的已知信息就是在特徵取這些值的情況下,它應該屬於y類(正或負)。

反推最具有可能(最大概率)導致這些樣本結果出現的參數,舉個例子,我們已經知道了一個樣本點,是正類,那麼我們把它丟入這個模型后,它預測的結果一定得是正類啊,正類才是正確的,才是我們所期望的,我們要盡可能的讓它最大,這樣才符合我們的真實標籤。反過來一樣的,如果你丟的是負類,那這個式子計算的就是負類的概率,同樣我們要讓它最大,所以此時不用區分正負類。

這樣串下來,一切都說通了,概括一下:

一個樣本,不分正負類,丟入模型,多的不說,就是一個字,讓它大

一直只提了一個樣本,但對於整個訓練集,我們當然是期望所有樣本的概率都達到最大,也就是我們的目標函數,本身是個聯合概率,但是假設每個樣本獨立,那所有樣本的概率就可以由以下公式推到:

設:

似然函數:

為了更方便求解,我們對等式兩邊同取對數,寫成對數似然函數:

在機器學習中我們有損失函數的概念,其衡量的是模型預測錯誤的程度。如果取整個數據集上的平均對數似然損失,我們可以得到:

即在邏輯回歸模型中,我們最大化似然函數和最小化損失函數實際上是等價的。所以說LR的loss function可以由MLE推導出來。

 四、邏輯回歸損失函數的求解

解邏輯回歸的方法有非常多,主要有梯度下降(一階方法)和牛頓法(二階方法)。優化的主要目標是找到一個方向,參數朝這個方向移動之後使得損失函數的值能夠減小,這個方嚮往往由一階偏導或者二階偏導各種組合求得。邏輯回歸的損失函數是:

隨機梯度下降:梯度下降是通過 J(w) 對 w 的一階導數來找下降方向,初始化參數w之後,並且以迭代的方式來更新參數,更新方式為 :

其中 k 為迭代次數。每次更新參數后,可以通過比較  小於閾值或者到達最大迭代次數來停止迭代。

梯度下降又有隨機梯度下降,批梯度下降,small batch 梯度下降三種方式:

  • 簡單來說 批梯度下降會獲得全局最優解,缺點是在更新每個參數的時候需要遍歷所有的數據,計算量會很大,並且會有很多的冗餘計算,導致的結果是當數據量大的時候,每個參數的更新都會很慢。
  • 隨機梯度下降是以高方差頻繁更新,優點是使得sgd會跳到新的和潛在更好的局部最優解,缺點是使得收斂到局部最優解的過程更加的複雜。
  • 小批量梯度下降結合了sgd和batch gd的優點,每次更新的時候使用n個樣本。減少了參數更新的次數,可以達到更加穩定收斂結果,一般在深度學習當中我們採用這種方法。

加分項,看你了不了解諸如Adam,動量法等優化方法(在這就不展開了,以後有時間的話專門寫一篇關於優化方法的)。因為上述方法其實還有兩個致命的問題:

  • 第一個是如何對模型選擇合適的學習率。自始至終保持同樣的學習率其實不太合適。因為一開始參數剛剛開始學習的時候,此時的參數和最優解隔的比較遠,需要保持一個較大的學習率儘快逼近最優解。但是學習到後面的時候,參數和最優解已經隔的比較近了,你還保持最初的學習率,容易越過最優點,在最優點附近來回振蕩,通俗一點說,就很容易學過頭了,跑偏了。
  • 第二個是如何對參數選擇合適的學習率。在實踐中,對每個參數都保持的同樣的學習率也是很不合理的。有些參數更新頻繁,那麼學習率可以適當小一點。有些參數更新緩慢,那麼學習率就應該大一點。

有關梯度下降原理以及優化算法詳情見我的博客:


任何模型都會面臨過擬合問題,所以我們也要對邏輯回歸模型進行正則化考慮。常見的有L1正則化和L2正則化。

L1 正則化

LASSO 回歸,相當於為模型添加了這樣一個先驗知識:w 服從零均值拉普拉斯分佈。 首先看看拉普拉斯分佈長什麼樣子:

由於引入了先驗知識,所以似然函數這樣寫:

取 log 再取負,得到目標函數:

等價於原始損失函數的後面加上了 L1 正則,因此 L1 正則的本質其實是為模型增加了“模型參數服從零均值拉普拉斯分佈”這一先驗知識。

L2 正則化

Ridge 回歸,相當於為模型添加了這樣一個先驗知識:w 服從零均值正態分佈。

首先看看正態分佈長什麼樣子:

由於引入了先驗知識,所以似然函數這樣寫:

取 ln 再取負,得到目標函數:

等價於原始的損失函數後面加上了 L2 正則,因此 L2 正則的本質其實是為模型增加了“模型參數服從零均值正態分佈”這一先驗知識。

其餘有關正則化的內容詳見:

五、邏輯回歸的目的

 該函數的目的便是將數據二分類,提高準確率。

六、邏輯回歸如何分類

這個在上面的時候提到了,要設定一個閾值,判斷正類概率是否大於該閾值,一般閾值是0.5,所以只用判斷正類概率是否大於0.5即可。

七、為什麼LR不使用平方誤差(MSE)當作損失函數?

1.  平方誤差損失函數加上sigmoid的函數將會是一個非凸的函數,不易求解,會得到局部解,用對數似然函數得到高階連續可導凸函數,可以得到最優解。

2.  其次,是因為對數損失函數更新起來很快,因為只和x,y有關,和sigmoid本身的梯度無關。如果你使用平方損失函數,你會發現梯度更新的速度和sigmod函數本身的梯度是很相關的。sigmod函數在它在定義域內的梯度都不大於0.25。這樣訓練會非常的慢。

八、邏輯回歸的優缺點

優點:

  • 形式簡單,模型的可解釋性非常好。從特徵的權重可以看到不同的特徵對最後結果的影響,某個特徵的權重值比較高,那麼這個特徵最後對結果的影響會比較大。
  • 模型效果不錯。在工程上是可以接受的(作為baseline),如果特徵工程做的好,效果不會太差,並且特徵工程可以大家并行開發,大大加快開發的速度。
  • 訓練速度較快。分類的時候,計算量僅僅只和特徵的數目相關。並且邏輯回歸的分佈式優化sgd發展比較成熟,訓練的速度可以通過堆機器進一步提高,這樣我們可以在短時間內迭代好幾個版本的模型。
  • 資源佔用小,尤其是內存。因為只需要存儲各個維度的特徵值。
  • 方便輸出結果調整。邏輯回歸可以很方便的得到最後的分類結果,因為輸出的是每個樣本的概率分數,我們可以很容易的對這些概率分數進行cut off,也就是劃分閾值(大於某個閾值的是一類,小於某個閾值的是一類)。

缺點:

  • 準確率並不是很高。因為形式非常的簡單(非常類似線性模型),很難去擬合數據的真實分佈。
  • 很難處理數據不平衡的問題。舉個例子:如果我們對於一個正負樣本非常不平衡的問題比如正負樣本比 10000:1.我們把所有樣本都預測為正也能使損失函數的值比較小。但是作為一個分類器,它對正負樣本的區分能力不會很好。
  • 處理非線性數據較麻煩。邏輯回歸在不引入其他方法的情況下,只能處理線性可分的數據,或者進一步說,處理二分類的問題 。
  • 邏輯回歸本身無法篩選特徵。有時候,我們會用gbdt來篩選特徵,然後再上邏輯回歸。


西瓜書中提到了如何解決LR缺點中的藍色字體所示的缺點:


九、 邏輯斯特回歸為什麼要對特徵進行離散化。

  • 非線性!非線性!非線性!邏輯回歸屬於廣義線性模型,表達能力受限;單變量離散化為N個后,每個變量有單獨的權重,相當於為模型引入了非線性,能夠提升模型表達能力,加大擬合; 離散特徵的增加和減少都很容易,易於模型的快速迭代;
  • 速度快!速度快!速度快!稀疏向量內積乘法運算速度快,計算結果方便存儲,容易擴展;
  • 魯棒性!魯棒性!魯棒性!離散化后的特徵對異常數據有很強的魯棒性:比如一個特徵是年齡>30是1,否則0。如果特徵沒有離散化,一個異常數據“年齡300歲”會給模型造成很大的干擾;
  • 方便交叉與特徵組合:離散化后可以進行特徵交叉,由M+N個變量變為M*N個變量,進一步引入非線性,提升表達能力;
  • 穩定性:特徵離散化后,模型會更穩定,比如如果對用戶年齡離散化,20-30作為一個區間,不會因為一個用戶年齡長了一歲就變成一個完全不同的人。當然處於區間相鄰處的樣本會剛好相反,所以怎麼劃分區間是門學問;
  • 簡化模型:特徵離散化以後,起到了簡化了邏輯回歸模型的作用,降低了模型過擬合的風險。

十、與其他模型的對比

與SVM

相同點

1. 都是線性分類器。本質上都是求一個最佳分類超平面。都是監督學習算法。
2. 都是判別模型。通過決策函數,判別輸入特徵之間的差別來進行分類。

  • 常見的判別模型有:KNN、SVM、LR。
  • 常見的生成模型有:樸素貝恭弘=叶 恭弘斯,隱馬爾可夫模型。


不同點

(1). 本質上是損失函數不同
LR的損失函數是交叉熵:

SVM的目標函數:

  • 邏輯回歸基於概率理論,假設樣本為正樣本的概率可以用sigmoid函數(S型函數)來表示,然後通過極大似然估計的方法估計出參數的值。
  • 支持向量機基於幾何間隔最大化原理,認為存在最大幾何間隔的分類面為最優分類面。

(2). 兩個模型對數據和參數的敏感程度不同

  • SVM考慮分類邊界線附近的樣本(決定分類超平面的樣本)。在支持向量外添加或減少任何樣本點對分類決策面沒有任何影響;
  • LR受所有數據點的影響。直接依賴數據分佈,每個樣本點都會影響決策面的結果。如果訓練數據不同類別嚴重不平衡,則一般需要先對數據做平衡處理,讓不同類別的樣本盡量平衡。
  • LR 是參數模型,SVM 是非參數模型,參數模型的前提是假設數據服從某一分佈,該分佈由一些參數確定(比如正太分佈由均值和方差確定),在此基礎上構建的模型稱為參數模型;非參數模型對於總體的分佈不做任何假設,只是知道總體是一個隨機變量,其分佈是存在的(分佈中也可能存在參數),但是無法知道其分佈的形式,更不知道分佈的相關參數,只有在給定一些樣本的條件下,能夠依據非參數統計的方法進行推斷。

(3). SVM 基於距離分類,LR 基於概率分類。

  • SVM依賴數據表達的距離測度,所以需要對數據先做 normalization;LR不受其影響。

(4). 在解決非線性問題時,支持向量機採用核函數的機制,而LR通常不採用核函數的方法。

  • SVM算法里,只有少數幾個代表支持向量的樣本參与分類決策計算,也就是只有少數幾個樣本需要參与核函數的計算。
  • LR算法里,每個樣本點都必須參与分類決策的計算過程,也就是說,假設我們在LR里也運用核函數的原理,那麼每個樣本點都必須參与核計算,這帶來的計算複雜度是相當高的。尤其是數據量很大時,我們無法承受。所以,在具體應用時,LR很少運用核函數機制。

(5). 在小規模數據集上,Linear SVM要略好於LR,但差別也不是特別大,而且Linear SVM的計算複雜度受數據量限制,對海量數據LR使用更加廣泛。

(6). SVM的損失函數就自帶正則,而 LR 必須另外在損失函數之外添加正則項。

那怎麼根據特徵數量和樣本量來選擇SVM和LR模型呢?Andrew NG的課程中給出了以下建議:


  • 如果Feature的數量很大,跟樣本數量差不多,這時候選用LR或者是Linear Kernel的SVM
  • 如果Feature的數量比較小,樣本數量一般,不算大也不算小,選用SVM+Gaussian Kernel
  • 如果Feature的數量比較小,而樣本數量很多,需要手工添加一些feature變成第一種情況。(LR和不帶核函數的SVM比較類似。)


插入一個知識點:判別模型與生成模型的區別?

公式上看

  • 生成模型: 學習時先得到P(x,y),繼而得到 P(y|x)。預測時應用最大后驗概率法(MAP)得到預測類別 y。
  • 判別模型: 直接學習得到P(y|x),利用MAP得到 y。或者直接學得一個映射函數 y=f(x) 。

直觀上看

  • 生成模型: 關注數據是如何生成的
  • 判別模型: 關注類別之間的差別

數據要求:生成模型需要的數據量比較大,能夠較好地估計概率密度;而判別模型對數據樣本量的要求沒有那麼多。

更多區別見


與樸素貝恭弘=叶 恭弘斯

相同點

樸素貝恭弘=叶 恭弘斯和邏輯回歸都屬於分類模型,當樸素貝恭弘=叶 恭弘斯的條件概率  服從高斯分佈時,它計算出來的 P(Y=1|X) 形式跟邏輯回歸是一樣的。

不同點

  • 邏輯回歸是判別式模型 p(y|x),樸素貝恭弘=叶 恭弘斯是生成式模型 p(x,y):判別式模型估計的是條件概率分佈,給定觀測變量 x 和目標變量 y 的條件模型,由數據直接學習決策函數 y=f(x) 或者條件概率分佈 P(y|x) 作為預測的模型。判別方法關心的是對於給定的輸入 x,應該預測什麼樣的輸出 y;而生成式模型估計的是聯合概率分佈,基本思想是首先建立樣本的聯合概率概率密度模型 P(x,y),然後再得到后驗概率 P(y|x),再利用它進行分類,生成式更關心的是對於給定輸入 x 和輸出 y 的生成關係;
  • 樸素貝恭弘=叶 恭弘斯的前提是條件獨立,每個特徵權重獨立,所以如果數據不符合這個情況,樸素貝恭弘=叶 恭弘斯的分類表現就沒邏輯會好了。

十一、多分類問題(LR解決多分類問題)

參考西瓜書!!!

現實中我們經常遇到不只兩個類別的分類問題,即多分類問題,在這種情形下,我們常常運用“拆分”的策略,通過多個二分類學習器來解決多分類問題,即將多分類問題拆解為多個二分類問題,訓練出多個二分類學習器,最後將多個分類結果進行集成得出結論。最為經典的拆分策略有三種:“一對一”(OvO)、“一對其餘”(OvR)和“多對多”(MvM),核心思想與示意圖如下所示。

  • OvO:給定數據集D,假定其中有N個真實類別,將這N個類別進行兩兩配對(一個正類/一個反類),從而產生N(N-1)/2個二分類學習器,在測試階段,將新樣本放入所有的二分類學習器中測試,得出N(N-1)個結果,最終通過投票產生最終的分類結果。

          優點:它在一定程度上規避了數據集 unbalance 的情況,性能相對穩定,並且需要訓練的模型數雖然增多,但是每次訓練時訓練集的數量都降低很多,其訓練效率會提高。

     缺點:訓練出更多的 Classifier,會影響預測時間。

  • OvM:給定數據集D,假定其中有N個真實類別,每次取出一個類作為正類,剩餘的所有類別作為一個新的反類,從而產生N個二分類學習器,在測試階段,得出N個結果,若僅有一個學習器預測為正類,則對應的類標作為最終分類結果。

    優點:普適性還比較廣,可以應用於能輸出值或者概率的分類器,同時效率相對較好,有多少個類別就訓練多少個分類器。

    缺點:很容易造成訓練集樣本數量的不平衡(Unbalance),尤其在類別較多的情況下,經常容易出現正類樣本的數量遠遠不及負類樣本的數量,這樣就會造成分類器的偏向性。

  • MvM:給定數據集D,假定其中有N個真實類別,每次取若干個類作為正類,若干個類作為反類(通過ECOC碼給出,編碼),若進行了M次劃分,則生成了M個二分類學習器,在測試階段(解碼),得出M個結果組成一個新的碼,最終通過計算海明/歐式距離選擇距離最小的類別作為最終分類結果。


十一、邏輯回歸實例(數據來源於Kaggle)

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

取道對歐輸送天然氣 俄烏達成初步協議

摘錄自2019年12月20日中央社報導

俄羅斯天然氣工業公司2019年向歐洲供應2008億立方公尺的天然氣,其中有約40%是借道烏克蘭運送,讓烏克蘭每年賺得約30億美元(約新台幣904億元)的過境費,此輸送合約將於年底到期,但自莫斯科2014年併吞克里米亞並支持烏克蘭東部的分離主義分子叛亂活動後,雙方關係急轉直下。

俄羅斯與烏克蘭歷經數個月的艱難談判,在即將到來的新年截止期限前,簽署取道烏克蘭將俄羅斯天然氣運往歐洲的初步協議。

俄羅斯通訊社引述俄羅斯天然氣工業公司(Gazprom)發言人說法報導:「俄羅斯與烏克蘭已經簽署諒解備忘錄。」但沒有提供合約細節。法新社報導,俄羅斯能源部長諾瓦克(Alexander Novak)說,這是5年合約,將在月底前簽署。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

築起和平之牆 修復河壩 達佛「氣候變遷戰爭」平息有望

環境資訊中心綜合外電;姜唯 編譯;林大利 審校

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

不甩歐盟反對 川普批准制裁俄歐天然氣管線

摘錄自2019年12月21日中央社報導

法新社報導,美國總統川普21日批准,可制裁替俄國建設天然氣管線到德國的企業。美國國會擔心,管線將讓俄國獲得影響歐洲盟邦的危險籌碼;但歐盟反對制裁,認為自己有權決定能源政策。

美國的制裁鎖定在波羅的海建造北溪天然氣2號管線(Nord Stream 2)的相關公司;造價近110億美元的這條管線,可讓俄國輸送至歐洲經濟體龍頭德國的天然氣量倍增。美國國會議員警告,管線會助長一個含敵意的俄國政府,並在歐陸緊張升溫之際,大增俄國總統蒲亭(Vladimir Putin)的影響力。

不過華府此舉已激怒莫斯科及歐盟,後者表示他們有權決定自己的能源政策。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開
日本電車撞鹿事故增 疑似鹿群缺鐵質舔軌道所致

摘錄自2019年12月21日中央社報導

日本京都新聞報導,包括滋賀縣在內的京阪神近郊區域,及JR西日本公司福知山支社轄區內,今年秋天電車撞上野生動物的次數較去年同期增加大約25%,在這些野生動物遭電車撞擊事件中,多數是梅花鹿遭殃,最主要原因是梅花鹿數量本來就持續增加,根據日本政府環境省調查推估,2017年度結束時,日本共有約244萬頭梅花鹿,數量是30年前的8倍。

示意圖,轉載自Unsplash免費圖庫

日鐵建材公司研究發現,鹿群為補充鐵質會舔食鐵軌。基於這項研究成果,日鐵建材公司開發出混合鐵質與鹽份、能引誘鹿群舔食的產品,讓鹿群攝取後就不會靠近鐵軌,以避免被電車撞上。只不過,如果真的有效,就無法解釋今年秋天電車撞上鹿群的事故為何會增加。

因此有另一種看法指出,單以今年來說,也許跟鹿群主食的橡子(團栗)歉收有關。橡子歉收造成亞洲黑熊出沒村落覓食案例增加。

※ 本文與 行政院農業委員會 林務局   合作刊登

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

搶救電網大潰堤 調度員換你當 歐洲電網公司TenneT推出線上遊戲

環境資訊中心記者 陳文姿 德國報導

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享