蘋果的第一個汽車專利由BAE公司授權 像坦克

儘管蘋果公司一直三緘其口,但是對於傳聞中的蘋果電動汽車項目,已經快成為了公開的秘密。現在,蘋果的首個關於汽車技術的專利也被人曝光,不過看起來與我們期望的距離似乎有點遙遠。  
  近日,美國專利商標局通過了一批蘋果公司的新專利,其中一項專利顯示了一種採用履帶以及軌槽設計的交通工具草圖。這項專利其實是兩個貨箱之間的接駁原理,駕駛員可以在極端寒冷空氣條件下,直接,通過加熱裝置,控制第一個車廂的轉向構件及包括一個連接機制的第二個車廂。   據悉,這項專利由瑞典軍用坦克製造商BAE公司授權給蘋果,因此至少目前來看肯定不會被使用在普通的消費和商業領域。   文章來源:騰訊數碼

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

續航力600公里的特斯拉 即將問世?

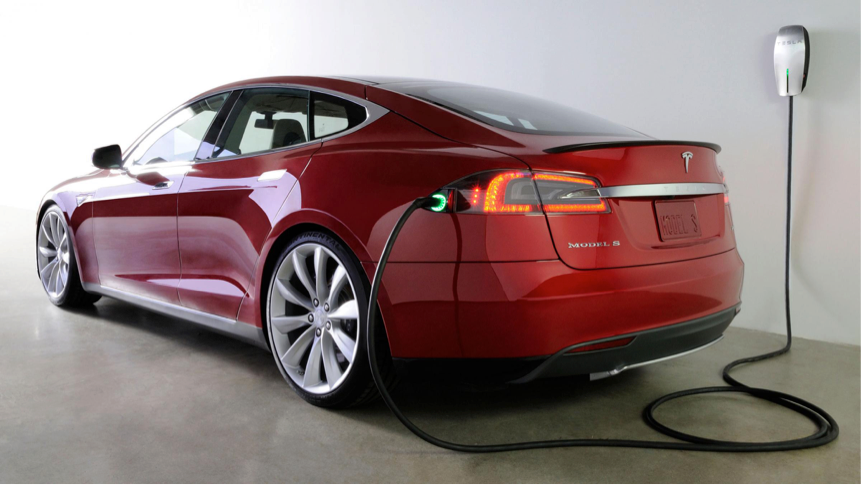
續航力是電動車最受關注的性能,而作為全球電動車龍頭廠商的特斯拉(Tesla),似乎也準備好要推出續航力更久的車款了。跟據了解,新的特斯拉電動車可能搭載100kW的電池,續航力最遠可達611公里。

《癮科技》中文版指出,德國監管機關的資料中可查到Model S與Model X的100D與P100D型號的相關資訊;而根據特斯拉為車款型號命名的邏輯,這可能暗示特斯拉將推出搭載100kW電池的車款。

100kW 的電池搭配Model S,預計最高續航里程可來到611公里,比90D的續航里程多了100公里以上。若搭配Model X,續航里程也可來到480 公里之多。這樣的續航力,將能有效減輕美國車主對駕駛特斯拉跨州旅行的疑慮。

(照片來源:Tesla 臉書專頁)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

計算機圖形學—— 隱藏線和隱藏面的消除(消隱算法)


一、概述

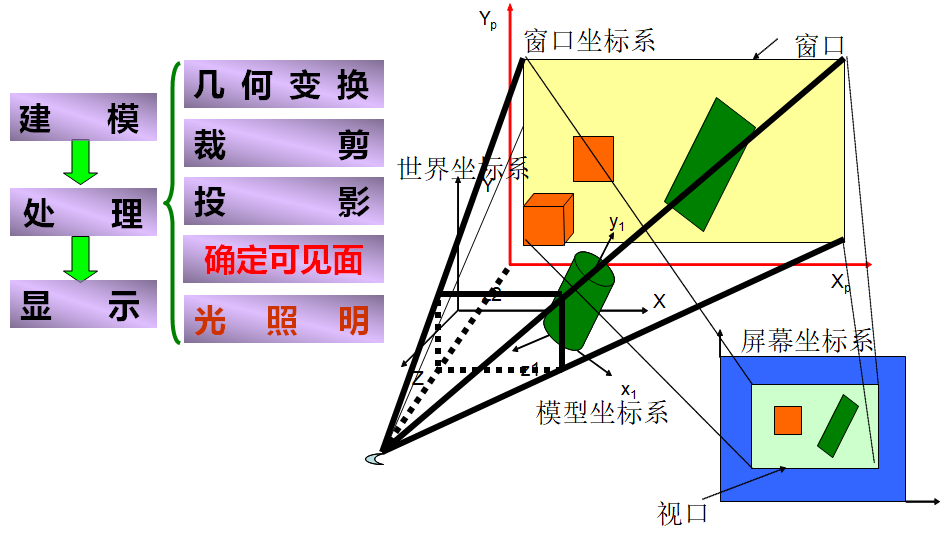
由於投影變換失去了深度信息,往往導致圖形的二義性。要消除二義性,就必須在繪製時消除被遮擋的不可見的線或面,習慣上稱作消除隱藏線和隱藏面(或可見線判定、可見面判定),或簡稱為消隱。經過消隱得到的投影圖稱為物體的真實感圖形。

下面這個圖就很好體現了這種二義性。

消隱后的效果圖:

消隱算法的分類

所有隱藏面消隱算法必須確定:
在沿透視投影的投影中心或沿平行投影的投影方向看過去哪些邊或面是可見的

兩種基本算法

1、以構成圖像的每一個像素為處理單元,對場景中的所有表面,確定相對於觀察點是可見的表面,用該表面的顏色填充該像素.
適於面消隱。

算法步驟:

a.在和投影點到像素連線相交的表面中,找到離觀察點最近的表面;
b.用該表面上交點處的顏色填充該像素;

2、以三維場景中的物體對象為處理單元,在所有對象之間進行比較,除去完全不可見的物體和物體上不可見的部分.適於面消隱也適於線消隱。

算法步驟:
a.判定場景中的所有可見表面;
b.用可見表面的顏色填充相應的像素以構成圖形;

提醒注意

1.假定構成物體的面不能相互貫穿,也不能有循環遮擋的情況。
2.假定投影平面是oxy平面,投影方向為z軸的負方向。

如果構成物體的面不滿足該假定,可以把它們剖分成互不貫穿和不循環遮擋的情況。
例如,用圖b中的虛線便可把原來循環遮擋的三個平面,分割成不存在循環遮擋的四個面。  

二、可見面判斷的有效技術

1、邊界盒

指能夠包含該物體的一個幾何形狀(如矩形/圓/長方體等),該形狀有較簡單的邊界。


邊界盒技術用於判斷兩條直線是否相交。

進一步簡化判斷

2、後向面消除(Back-face Removal)

思路:把顯然不可見的面去掉,減少消隱過程中的直線求交數目


如何判斷:根據定義尋找外(或內)法向,若外法向背離觀察者,或內法向指向觀察者,則該面為後向面。


注意:如果多邊形是凸的,則可只取一個三角形計算有向面積sp。如果多邊形不是凸的,只取一個三角形計算有向面積sp可能會出現錯誤,即F所在的面為前向面也可能出現sp≥0的情況,因此,需按上式計算多邊形F的有向面積。如果sp ≥0,則F所在的面為後向面。

3、非垂直投影轉化成垂直投影

物體之間的遮擋關係與投影中心和投影方向有着密切的關係,因此,對物體的可見性判定也和投影方式有密切的關係。

垂直投影的優點:進行投影時可以忽略z值,即:實物的(x,y)可直接做為投影后的二維平面上的坐標(x,y)

上述討論說明,垂直投影比非垂直投影容易實現,並且計算量小。因此在進行消隱工作之前,首先應將非垂直投影轉換成垂直投影,從而降低算法的複雜性,提高運算速度。

如何把透視投影變為垂直投影,其本質是把稜台變成長方體。

三、基於窗口的子分算法(Warnack算法)

是一種分而治之(Divide-Conquer)的算法。


1、關係判斷

2、可見性判斷

3、分隔結束條件

4、提高效率的有效的處理技術

5、算法描述

用多邊形的邊界對區域作劃分,其目的是盡量減少對區域劃分的次數--利用裁剪算法


四、八叉樹算法

為了生成真實感圖形,關鍵問題之一就是對圖像空間的每一個像素進行處理。從場景中所有的在該像素上有投影的表面中確定相對於觀察點是可見表面。為了提高算法效率,自然是希望從可能在像素上有投影的面片中尋找可見表面。八叉樹算法是快速尋找可見面的一種有效方法,是一種搜索算法。

基本思想:將能夠包含整個場景的立方體,即八叉樹的根結點,按照x,y,z三個方向中的剖面分割成八個子立方體,稱為根結點的八個子結點。對每一個子立方體,如果它包含的表面片少於一個給定的值,則該子立方體為八叉樹的終端結點,否則為非終端結點並將其進一步分割成八個子立方體;重複上述過程,直到每個小立方體所包含的表面片少於一個給定的值,分割即告終止。


那麼對於上述圖所示,視圖平面法向量(1,1,1)那麼此時它的一個排列是0,1,2,4,3,5,6,7,即最遠的八分體是0,與八分體0共享一個面的三個相鄰八分體是1,2和4,與最近八分體7的3個相鄰八分體是3,5和6。


五、Z緩衝器算法

1、算法描述

z緩衝器算法是最簡單的隱藏面消除算法之一。
基本思想:對屏幕上每一個像素點,過像素中心做一條投影線,找到此投影線與所有多邊形交點中離觀察者最近的點,此點的屬性(顏色或灰度)值即為這一屏幕像素點的屬性值。

需要兩個緩衝器數組,即:z緩衝器數組和幀緩衝器數組,分別設為 Zdepth[ ][ ] 與  Frame[ ][ ]
z緩衝器是一組存貯單元,其單元個數和屏幕上像素的個數相同,也和幀緩衝器的單元個數相同,它們之間一一對應。
幀緩衝器每個單元存放對應像素的顏色值;z緩衝器每個單元存放對應像素的深度值;

2、算法實現


算法的複雜性正比於m*n*N,在屏幕大小即m*n一定的情況下,算法的計算量只和多邊形個數N成正比

3、優缺點

 z-Buffer算法沒有利用圖形的相關性和連續性,這是z-Buffer算法的嚴重缺陷,更為嚴重的是,該算法是像素級上的消隱算法。

 六、掃描線z緩衝器算法

1、算法描述

將z緩衝器的單元數置為和一條掃描線上的像素數目相同。
從最上面的一條掃描線開始工作,向下對每一條掃描線作如下處理:


掃描線算法也屬於圖像空間消隱算法。該算法可以看作是多邊形區域填充里介紹過的邊相關掃描線填充算法的延伸。不同的是在消隱算法中處理的是多個面片,而多邊形填充中是對單個多邊形面進行填充。

2、數據結構

對每個多邊形,檢查它在oxy平面上的投影和當前掃描線是否相交?
若不相交,則不考慮該多邊形。
如果相交,則掃描線和多邊形邊界的交點是成對地出現
對每對交點中間的像素計算多邊形所在平面對應點的深度(即z值),並和z緩衝器中相應單元存放的深度值作比較。
若前者大於後者,則z緩衝器的相應單元內容要被求得的平面深度代替,幀緩衝器相應單元的內容也要換成該平面的屬性。
對所有的多邊形都作上述處理后,幀緩衝器中這一行的值便反應了消隱后的圖形。
對幀緩衝器每一行的單元都填上相應內容后就得到了整個消隱后的圖。

每處理一條掃描線,都要檢查各多邊形是否和該線相交,還要計算多邊形所在平面上很多點的z值,需要花費很大的計算
為了提高算法效率,採用跟多邊形掃描轉換中的掃描線算法類似的數據結構和算法.

多邊形Y表


實際上是一個指針數組 ,每個表的深度和显示屏幕行數相同.將所有多邊形存在多邊形Y表中,根據多邊形頂點中Y坐標最大值,插入多邊形Y表中的相應位置,多邊形Y表中保存多邊形的序號和其頂點的最大y坐標.

邊Y表

 要注意:Δx是下一條掃描線與邊交點的x減去當前的掃描線與邊交點的x。

多邊形活化表

邊對活化表

其實這裏最難理解的就是Δyl和Δxr了,這裏的意思就是當前掃描線所處的y值和與該掃描線相交邊的最小y值的差值。

就比如說掃描線y=6,與第一個三角形有兩個交點,左交點(4,6),右交點(7,6)那麼Δyl=6-3  Δyr=6-3

3、重溫算法目標

 對每一條掃描線,檢查對每個多邊形的投影是否相交,如相交則交點成對出現,對每對交點中間的每個像素計算多邊形所在平面對應點的深度(即z值),並和z緩衝器中相應單元存放的深度值作比較,若前者大於後者,則z緩衝器的相應單元內容要被求得的平面深度代替,幀緩衝器相應單元的內容也要換成該平面的屬性。
對所有的多邊形都作上述處理后,幀緩衝器中這一行的值便反應了消隱后的圖形,對幀緩衝器每一行的單元都填上相應內容后也就得到了整個消隱后的圖。

4、算法步驟


算法描述如下

七、優先級排序表算法

1、算法思想

優先級排序表算法按多邊形離觀察者的遠近來建立一個多邊形排序表,距觀察者遠的優先級低,放在表頭;近的優先級高,放在表尾
從優先級低的多邊形開始,依次把多邊形的顏色填入幀緩衝存儲器中
表中距觀察者近的元素覆蓋幀緩衝存儲器中原有的內容
當優先級最高的多邊形的圖形送入幀緩衝器后,整幅圖形就形成了
類似於油畫家繪畫過程,因此又稱為油畫家算法。


2、算法的優缺點

算法的優點:
簡單,容易實現,並且可以作為實現更複雜算法的基礎;
缺點:
只能處理不相交的面,而且深度優先級表中面的順序可能出錯.

該算法不能處理某些特殊情況。


解決辦法:把P沿Q平面一分為二,從多邊形序列中把原多邊形P去掉,把分割P生成的兩個多邊形加入鏈表中。具體實現時,當離視點最遠的多邊形P和其他多邊形交換時,要對P做一標誌,當有標誌的多邊形再換成離視點最遠的多邊形時,則說明出現了上述的現象,可用分割方法進行處理 。

用來解決動態显示問題時,可大大提高效率

八、光線投射算法

1、算法原理

要處理的場景中有無限多條光線,從採樣的角度講我們僅對穿過像素的光線感興趣,因此,可考慮從像素出發,逆向追蹤射入場景的光線路徑


2、算法實現

由視點出發穿過觀察平面上一像素向場景發射一條射線
求出射線與場景中各物體表面的交點
離視點最近的交點的顏色即為像素要填的顏色。
光線投射算法對於包含曲面,特別是包含球面的場景有很高的效率。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

從零開始搭建前後端分離的NetCore2.2(EF Core CodeFirst+Autofac)+Vue的項目框架之十一Swagger使用一

 一.未使用Swagger狀況

  相信無論是前端開發人員還是後端開發人員,都或多或少都被接口文檔折磨過,前端經常抱怨後端給的接口文檔或與實際情況不一致。後端又覺得編寫及維護接口文檔會耗費不少精力,經常來不及更新。 其實無論是前端調用後端,還是後端調用後端,都期望有一個好的接口文檔。但是這個接口文檔對於程序員來說,就跟註釋一樣,經常會抱怨別人寫的代碼沒有寫註釋,然而自己寫起代碼起來,最討厭的,也是寫註釋。 所以僅僅只通過強制來規範大家是不夠的,隨着時間推移,版本迭代,接口文檔往往很容易就跟不上代碼了

 二.使用Swagger狀況

  Swagger 提供了一個可視化的UI頁面展示描述文件,其中包括接口的調用,接口所需參數(header,body,url.params),接口說明,參數說明等。接口的調用方、測試、項目經理等都可以在該頁面中對相關接口進行查閱和做一些簡單的接口請求。只要在項目框架搭建時,對Swagger 進行了配置,後面持續迭代的時候,只會花很小代價去維護代碼、接口文檔以及Swagger描述文件。因為一旦接口發生改變,程序重新部署,接口文檔會重新生成對應新的文檔。

 三.如何使用?

  在NetCore項目中怎麼去使用Swagger來生成接口文檔呢?

  首先在 webApi 啟動項目 上 右鍵 點擊管理Nuget程序包, 安裝  Swashbuckle.AspNetCore ,然後到  Startup 中添加引用  using Swashbuckle.AspNetCore.Swagger; 

  在ConfigureServices方法中添加以下代碼

            #region Swagger

            services.AddSwaggerGen(options =>
            {
                options.SwaggerDoc("v1", new Info
                {
                    Version = "v1",
                    Title = "API Doc",
                    Description = "作者:Levy_w_Wang",
                    //服務條款
                    TermsOfService = "None",
                    //作者信息
                    Contact = new Contact
                    {
                        Name = "levy",
                        Email = "levy_w_wang@qq.com",
                        Url = "https://www.cnblogs.com/levywang"
                    },
                    //許可證
                    License = new License
                    {
                        Name = "tim",
                        Url = "https://www.cnblogs.com/levywang"
                    }
                });

                #region XmlComments

                var basePath1 = Path.GetDirectoryName(typeof(Program).Assembly.Location);//獲取應用程序所在目錄(絕對,不受工作目錄(平台)影響,建議採用此方法獲取路徑)
                //獲取目錄下的XML文件 显示註釋等信息
                var xmlComments = Directory.GetFiles(basePath1, "*.xml", SearchOption.AllDirectories).ToList();

                foreach (var xmlComment in xmlComments)
                {
                    options.IncludeXmlComments(xmlComment);
                }
                #endregion

                options.DocInclusionPredicate((docName, description) => true);

                options.IgnoreObsoleteProperties();//忽略 有Obsolete 屬性的方法
                options.IgnoreObsoleteActions();
                options.DescribeAllEnumsAsStrings();
            });
            #endregion

上面寫的循環是因為項目中可能有多個控制器類庫,為的是排除這種情況

接下來,再到 Configure 方法中添加:

            #region Swagger

            app.UseSwagger(c => { c.RouteTemplate = "apidoc/{documentName}/swagger.json"; });
            app.UseSwaggerUI(c =>
            {
                c.RoutePrefix = "apidoc";
                c.SwaggerEndpoint("v1/swagger.json", "ContentCenter API V1");
                c.DocExpansion(DocExpansion.Full);//默認文檔展開方式
            });

            #endregion

這裏使用了 RoutePrefix  屬性,為的是改變原始打開接口文檔目錄,原始路徑為 swagger/index.html ,現在為 /apidoc/index.html 

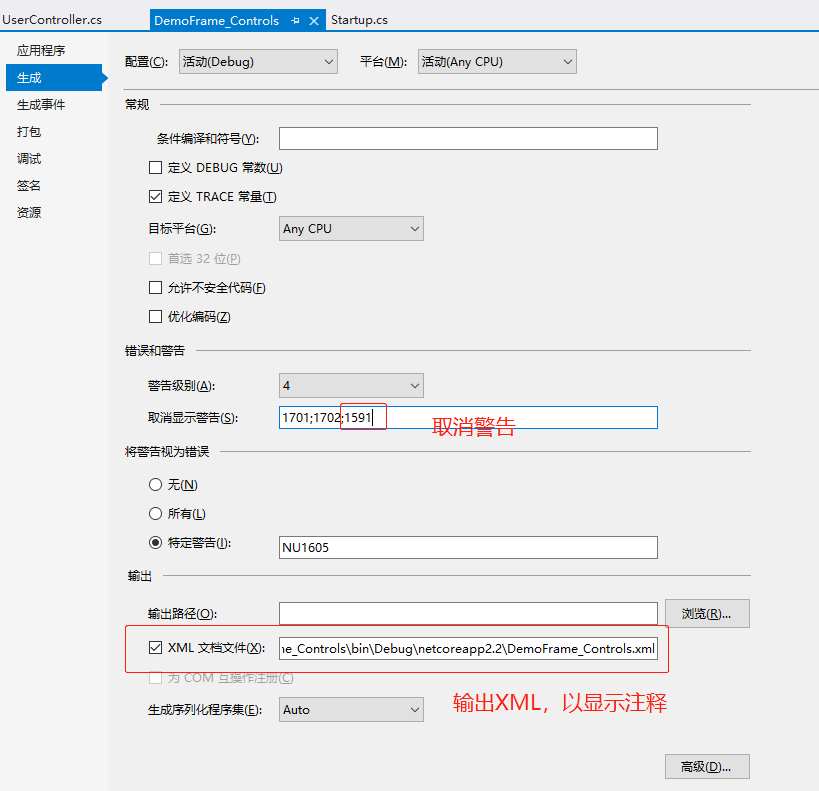
這個時候在需要輸出註釋的控制器類庫的屬性 中設置如下信息,並添加上相關註釋

然後運行起來,打開本地地址加上  /apidoc/index.html  就可以看到效果,

特別提醒:如果打開下面這個界面能正常显示,但是提示  Fetch errorInternal Server Error v1/swagger.json  錯誤,說明有方法未指明請求方式,如 HttpGet HttpPost HttpPut 等,找到並指明,重新運行就正常了


  點擊方法右上角的 Try it out ,試下調用接口,然後點擊Exectue,執行查看結果,能得到後端方法返回結果就說明成功。

特別說明:有接口不需要展示出去的時候,可以在方法上添加屬性 Obsolete ,這樣就不會显示出來。 前提:有前面ConfigureServices中 後面的 忽略 有Obsolete 屬性的方法 設置才行!!!


 最後可以看到接口返回數據正常,並且也能看到接口響應請求嘛等等信息,一個接口應該返回的信息也都有显示。


總結:

本文從為開發人員手寫api文檔的痛楚,從而引申出Swagger根據代碼自動生成出文檔和註釋,

並且還可以將不需要的方法不显示等設置。然後進行了簡單的測試使用 。

但是!!一般後端方法都有token等驗證,需要在header中添加token、sid等字段來驗證用戶,保障安全性,

該設置將在下一章節中寫!

 下一章

以上若有什麼不對或可以改進的地方,望各位指出或提出意見,一起探討學習~

有需要源碼的可通過此 鏈接拉取 覺得還可以的給個 start 和點個 下方的推薦哦~~謝謝!


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

PostgreSQL空間數據庫創建備份恢復(PostGIS vs ArcGIS)

梯子

PostGIS

創建

安裝就不必介紹了,windows下使用安裝工具Application Stack Builder,選擇空間擴展PostGIS即可自動安裝

然後新建庫后,在庫中執行以下語句創建控件擴展

CREATE EXTENSION postgis

也可以創建數據庫時選擇postgis的模板庫創建

create database postgisdb template postgis_template;

新建數據庫后添加postgis擴展後會發現庫內public模式下函數序列觸發器等都會增加一些postgis相關功能
然後就可以通過PostGIS Shapefile and DBF Loader工具導入shp數據

備份

postgersql的備份恢復主要有

  1. 增量備份和基於時間點恢復(RITR)
  2. pg_dump和pg_dumpall進行轉儲,從SQL轉儲文件恢復
  3. 文件系統級別備份

這裏我們使用簡單,容易掌握的pg_dump命令,一般在安裝目錄bin下
pg_dump備份單庫,不導出角色和表空間相關信息

pg_dump -h localhost -U postgres postgisdb > D:\backup\postgisdb.bak

有一些參數選項可以參考(很多,具體不列了,執行help可以查看到)

pg_dump --help
恢復

恢復可以使用psql

psql -h localhost -U postgres -d postgisdb2 < D:\backup\postgisdb.bak

恢復時可以指定不同的數據庫,如果pg_dump時-C創建數據庫,那也可以不用先新建數據庫

postgis庫的恢復備份還是挺簡單的,所有的東西都在public下

ArcGIS

創建

ArcGIS要連接到postgresql,需要將postgresql安裝目錄lib下的libeay32.dll、libiconv-2.dll、libintl-8.dll、libpq.dll 和 ssleay32.dll拷貝到ArcGIS Desktop的安裝目錄bin下
將ArcGIS Desktop目錄DatabaseSupport\PostgreSQL下的st_geometry.dll拷貝到postgresql的lib下

使用ArcGIS工具箱中Create Enterprise Geodatabase工具創建SDE,完事後會在創建一個sde登陸角色並在庫中創建一個sde模式,包含諸多函數序列管理表等。(注意:ArcGIS雖然可以在系統庫postgres中創建SDE擴展,然並連不上,ArcGIS不允許連接訪問系統數據庫)

然後ArcGIS可以連接該數據庫,並且進行空間數據管理操作。(注意:默認ArcGIS創建空間數據,只能創建在和登陸用戶同名的模式下)

備份

我們可以向上面PostGIS備份恢復一樣,直接備份整個庫

恢復

如果恢復至同名數據庫,像上面恢復是沒有問題的
但如果數據庫改名了,則會有驚喜發生,ArcGIS管理空間報底層gdb_release之類的錯誤,同樣的問題不止恢復庫時,修改數據庫名稱也不像其他庫那麼隨心所欲,以含SDE擴展的庫為模板創建新庫也會有問題

ArcGIS SDE未見文檔介紹內部結構邏輯,只能猜測大概,或不準確,願聞其詳

ArcSDE空間數據創建時會在SDE管理表裡註冊相關信息,比如空間參考,列啊,表的唯一標識等,便於它做數據管理、版本控制

修改庫名后,ArcSDE管理就出問題,主要是一些註冊項,安裝SDE時也會把該庫的信息註冊到SDE管理表中去,所以新庫名,它就不認識了

如果修改了庫名,我們找到以下錶

select * from sde.gdb_items
you need modify : name physicalname path etc...

update sde.sde_table_registry set database_name='testdb';
update sde.sde_column_registry set database_name='testdb';
update sde.sde_geometry_columns set f_table_catalog='testdb';
update sde.sde_raster_columns set database_name='testdb';
update sde.sde_layers set database_name='testdb';

然後就一切正常

當然我們建議不輕易改庫名

這就是商業軟件,足夠強大不夠靈活,封裝和靈活總會互相博弈

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

大規模搜索廣告的端到端一致性實時保障

一、背景

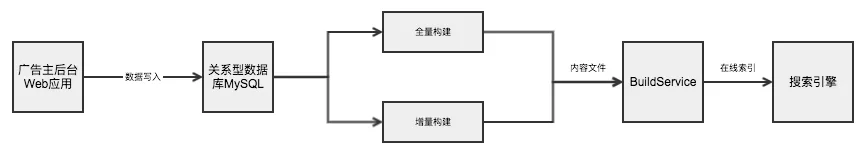
電商平台的搜索廣告數據處理鏈路通常較長,一般會經歷如下過程:

  • 廣告主在後台進行廣告投放;
  • 投放廣告品及關鍵詞數據寫入數據庫;
  • 數據庫中的數據通過全量構建(導入數據倉庫再進行離線批處理)或增量構建(藉助消息隊列和流計算引擎)的方式產出用於構建在線索引的“內容文件”;
  • BuildService基於“內容文件”,構建出在搜索服務檢索時使用的索引。

下圖是ICBU的廣告系統的買賣家數據處理鏈路:

右半部分(BP->DB)和offline部分即為廣告投放數據的更新過程。

複雜的數據處理鏈路結合海量(通常是億級以上)的商品數據,對線上全量商品的投放狀態正確性測試提出巨大挑戰。從數據庫、到離線大規模數據聯表處理、到在線索引構建,鏈路中的任一節點出現異常或數據延遲,都有可能會對廣告主以及平台造成“資損”影響,例如:

  • 廣告主在後台操作取消A商品的廣告投放,但是因為數據鏈路處理延遲,搜索引擎中A的狀態仍處於“推廣中”,導致A能繼續在買家搜索廣告時得到曝光,相應地當“點擊”行為發生時,造成錯誤扣款。
  • 廣告主設定某個產品只限定對某個地域/國家的客戶投放廣告,但是因為搜索引擎的過濾邏輯處理不恰當,導致客戶的廣告品在所有地區都進行廣告投放,同樣會造成錯誤點擊扣款。

傳統的測試手段,或聚焦於廣告主後台應用的模塊功能測試,或聚焦於搜索引擎的模塊功能測試,對於全鏈路功能的測試缺乏有效和全面的測試手段。而線上的業務監控,則側重於對業務效果指標的監控,如CTR(click through rate,點擊率)、CPC(cost per click,點擊成本)、RPM(revenue per impression,千次瀏覽收益)等。對涉及廣告主切身利益和平台總營收的廣告錯誤投放問題,缺乏有效的發現機制。

我們期望對在線搜索廣告引擎所有實際曝光的商品,通過反查數據庫中曝光時刻前它的最後狀態,來校驗它在數據庫中的投放狀態與搜索引擎中的狀態的一致性,做到線上廣告錯誤投放問題的實時發現。同時,通過不同的觸發檢測方式,做到數據變更的各個環節的有效覆蓋。

二、階段成果

我們藉助日誌流同步服務(TTLog)、海量數據NoSQL存儲系統(Lindorm)、實時業務校驗平台(BCP)、消息隊列(MetaQ)、在線數據實時同步服務(精衛)以及海量日誌實時分析系統(Xflush)實現了ICBU搜索廣告錯誤投放問題的線上實時發現,且覆蓋線上的全部用戶真實曝光流量。同時,通過在數據變更節點增加主動校驗的方式,可以做到在特定場景下(該廣告品尚未被用戶檢索)的線上問題先於用戶發現。

此外,藉助TTLog+實時計算引擎Blink+阿里雲日誌服務SLS+Xflush的技術體系,實現了線上引擎/算法效果的實時透出。

下面是ICBU廣告實時質量大盤:

從八月底開始投入線上使用,目前這套實時系統已經發現了多起線上問題,且幾乎都是直接影響資損和廣告主的利益。

三、技術實現

圖一:

1. 引擎曝光日誌數據處理

對於電商搜索廣告系統,當一個真實的用戶請求觸達(如圖一中1.1)時,會產生一次實時的廣告曝光,相對應地,搜索引擎的日誌里會寫入一條曝光記錄(如圖一中2)。我們通過日誌流同步服務TTLog對搜索引擎各個服務器節點上的日誌數據進行統一的搜集(如圖一中3),然後藉助數據對賬服務平台BCP對接TTLog中的“流式”數據(如圖一中4),對數據進行清洗、過濾、採樣,然後將待校驗的數據推送到消息隊列服務MetaQ(如圖一中5)。

2. DB數據處理

圖二:

如圖二所示,通常,業務數據庫MySQL針對每個領域對象,只會存儲它當前時刻最新的數據。為了獲取廣告品在引擎中真實曝光的時刻前的最後數據,我們通過精衛監聽數據庫中的每次數據變更,將變更數據“快照”寫入Lindorm(底層是HBase存儲,支持海量數據的隨機讀寫)。

3. 數據一致性校驗

在廣告測試服務igps(我們自己的應用)中,我們通過監聽MetaQ的消息變更,拉取MetaQ中待校驗的數據(如圖一中6),解析獲得曝光時每個廣告品在搜索引擎中的狀態,同時獲得其曝光的時刻點。然後基於曝光時刻點,通過查詢Lindorm,獲得廣告品於曝光時刻點前最後在MySQL中的數據狀態(如圖一中7)。然後igps對該次廣告曝光,校驗引擎中的數據狀態和MySQL中的數據狀態的一致性。

如果數據校驗不一致,則打印出錯誤日誌。最後,藉助海量日誌實時分析系統Xflush(如圖一中8),我們可以做到對錯誤數據的實時聚合統計、可視化展示以及監控報警。

4. 數據變更節點的主動校驗

因為線上的實時用戶搜索流量具有一定的隨機性,流量場景的覆蓋程度具有很大的不確定性,作為補充,我們在數據變更節點還增加了主動校驗。

整個數據鏈路,數據變更有兩個重要節點:

  • MySQL中的數據變更;
  • 引擎索引的切換。

對於MySQL中的數據變更:我們通過精衛監聽變更,針對單條數據的變更信息,構建出特定的引擎查詢請求串,發起查詢請求(如圖一中1.3)。

對於引擎索引的切換(主要是全量切換):我們通過離線對歷史(如過去7天)的線上廣告流量進行聚合分析/改寫,得到測試用例請求集合。再監聽線上引擎索引的切換操作。當引擎索引進行全量切換時,我們主動發起對引擎服務的批量請求(如圖一中1.2)。

上述兩種主動發起的請求,最後都會復用前面搭建的數據一致性校驗系統進行廣告投放狀態的校驗。

上圖是對廣告投放狀態的實時校驗錯誤監控圖,從圖中我們清晰看到當前時刻,搜索廣告鏈路的數據質量。無論是中美業務DB同步延遲、DB到引擎數據增量處理鏈路的延遲、或者是發布變更導致的邏輯出錯,都會導致錯誤數據曲線的異常上漲。校驗的規則覆蓋了推廣計劃(campaign)、推廣組(adgroup)、客戶狀態(customer)、詞的狀態(keyword)、品的狀態(feed)。校驗的節點覆蓋了曝光和點擊兩個不同的環節。

5. 引擎及算法的實時質量

圖三:

搜索引擎日誌pvlog中蘊含了非常多有價值的信息,利用好這些信息不僅可以做到線上問題的實時發現,還能幫助算法同學感知線上的實時效果提供抓手。如圖三所示,通過實時計算引擎Blink我們對TTLog中的pv信息進行解析和切分,然後將拆分的結果輸出到阿里雲日誌服務SLS中,再對接Xflush進行實時的聚合和可視化展示。

如上圖所示,上半年我們曾出現過一次線上的資損故障,是搜索應用端構造的搜索廣告引擎SP請求串中缺失了一個參數,導致部分頭部客戶的廣告沒有在指定地域投放,故障從發生到超過10+客戶上報才發現,歷經了10幾個小時。我們通過對SP請求串的實時key值和重要value值進行實時監控,可以快速發現key值或value值缺失的場景。

此外,不同召回類型、扣費類型、以及扣費價格的分佈,不僅可以監控線上異常狀態的出現,還可以給算法同學做實驗、調參、以及排查線上問題時提供參考。

四、幾個核心問題

1. why lindorm?

最初的實現,我們是通過精衛監聽業務DB的變更寫入另一個新的DB(MySQL),但是性能是一個非常大的瓶頸。我們的數據庫分了5+個物理庫,1000+張分表,單表的平均數據量達到1000+w行,總數據達到千億行。

后通過存儲的優化和按邏輯進行分表的方式,實現了查詢性能從平均1s到70ms的提升。

2. why BCP + MetaQ + igps?

最初我們是想直接使用BCP對數據進行校驗:通過igps封裝lindorm的查詢接口,然後提供hsf接口供在BCP里直接使用。

但是還是因為性能問題:TTLog的一條message平均包含60+條pv,每個pv可能有5個或更多廣告,每個廣告要查6張表,單條message在BCP校驗需要調用約60x5x6=1800次hsf請求。當我們在BCP中對TTLog的數據進行10%的採樣時,後端服務igps的性能已經出現瓶頸,hsf線程池被打滿,同時7台服務器的cpu平均使用率達到70%以上。

藉助MetaQ的引入,可以剔除hsf調用的網絡開銷,同時將消息的生產和消費解耦,當流量高峰到達時,igps可以保持自己的消費速率不變,更多的消息可以暫存在隊列里。通過這一優化,我們不僅扛住了10%的採樣,當線上採樣率開到100%時,我們的igps的服務器的平均cpu使用率仍只維持在20%上下,而且metaq中沒有出現消息堆積。

不過這樣一來,bcp的作用從原來的“採樣、過濾、校驗、報警”,只剩下“採樣、過濾”。無法發揮其通過在線編碼可以快速適應業務變化的作用。

3. why not all blink?

其實“BCP + MetaQ + igps”的流程可以被“Blink + SLS”取代,那為什麼不都統一使用Blink呢。

一方面,目前點擊的校驗由於其流量相對較小的因素,我們目前是直接在BCP里編寫的校驗代碼,不需要走發布流程,比較快捷。而且BCP擁有如“延遲校驗”、“限流控制”等個性化的功能。另一方面,從我們目前使用Blink的體驗來看,實時的處理引擎尚有一些不穩定的因素,尤其是會有不穩定的網絡抖動(可能是數據源和Blink workder跨機房導致)。

4. SP請求的key值如何拆分?

在做SP請求串的實時key值監控的時候,遇到了一個小難題:SP的請求串中參數key是動態的,並不是每個key都會在每個串中出現,而且不同的請求串key出現的順序是不一樣的。如何切分使其滿足Xflush的“列值分組”格式要求。

實現方式是,對每個sp請求串,使用Blink的udtf(自定義表值函數)進行解析,得到每個串的所有key和其對應的value。然後輸出時,按照“validKey={key},validValue={value}”的格式對每個sp請求串拆分成多行輸出。然後通過Xflush可以按照validKey進行分組,並對行數進行統計。

五、總結及後續規劃

本文介紹了通過大數據的處理技術做到電商搜索廣告場景下數據端到端一致性問題的實時發現,並且通過“實時發現”結合“數據變更節點的主動校驗”,實現數據全流程的一致性校驗。

後續的優化方向主要有兩方面:

  • 結合業務的使用場景,透出更豐富維度的實時數據。
  • 將該套技術體系“左移”到線下/預發測試階段,實現“功能、性能、效果”的一鍵式自動化測試,同時覆蓋從搜索應用到引擎的全鏈路。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

安卓JNI精細化講解,讓你徹底了解JNI(一):環境搭建與HelloWord

目錄

1、基礎概念

1.1、JNI

JNI(Java Native Interface)Java本地接口,使得Java與C/C++具有交互能力

1.2、NDK

NDK(Native Development Kit) 本地開發工具包,允許使用原生語言(C和C++)來實現應用程序的部分功能

Android NDK開發的主要作用:

1、特定場景下,提升應用性能;
2、代碼保護,增加反編譯難度;
3、生成庫文件,庫可重複使用,也便於平台、項目間移植;

1.3、CMake與ndk-build

當我們基於NDK開發出native功能后,通常需要編譯成庫文件,給Android項目使用。
目前,有兩種主流的編譯方式:__CMake__與ndk-build

__CMake__與__ndk-build__是兩種不同的編譯工具(與Android代碼和C/C++代碼無關)

CMake

CMake是Androidstudio2.2之後引入的跨平台編譯工具(特點:簡單易用,2.2之後是默認的NDK編譯工具)

如何配置:
   1、創建CMakeLists.txt文件,配置CMake必要參數;
   2、使用gradle配置CMakeLists.txt以及native相關參數;

如何編譯庫文件:
   1、Android Studio執行Build即可;

ndk-build

ndk-build是NDK中包含的腳本工具(可在NDK目錄下找到該工具,為了方便使用,通常配置NDK的環境變量)

如何配置:
   1、創建Android.mk文件,配置ndk-build必要參數;
   2、可選創建application.mk文件,配置ndk-build參數 (該文件的配置項可使用gradle的配置替代);
   3、使用gradle配置Android.mk以及native相關參數;

2、如何編譯庫文件(兩種方式):
   1、Android Studio執行Build即可(執行了:Android.mk + gradle配置);
   2、也可在Terminal、Mac終端、cmd終端中通過ndk-build命令直接構建庫文件(執行了:Android.mk)

2、環境搭建

JNI安裝
JNI 是JDK里的內容,電腦上正確安裝並配置JDK即可 (JDK1.1之後就正式支持了);

NDK安裝
可從官網自行下載、解壓到本地,也可基於AndroidStudio下載解壓到默認目錄;

編譯工具安裝
cmake 可基於AndroidStudio下載安裝;
ndk-build 是NDK里的腳本工具,NDK安裝好即可使用ndk-build;

當前演示,使用的Android Studio版本如下(當前最新版):

啟動Android Studio –> 打開SDK Manager –> SDK Tools,如下圖所示:

我們選擇NDK、CMake、LLDB(調試Native時才會使用),選擇Apply進行安裝,等安裝成功后,NDK開發所依賴的環境也就都齊全了。

3、Native C++ 項目(HelloWord案例)

3.1、項目創建(java / kotlin)

新建項目,選擇 Native C++,如下圖:

新創建的項目,默認已包含完整的native 示例代碼、cmake配置 ,如下圖:

這樣,我們就可以自己定義Java native方法,並在cpp目錄中寫native實現了,很方便。

但是,當我們寫完native的實現代碼,希望運行APP,查看JNI的交互效果,此時,就需要使用編譯工具了,咱們還是先看一下Android Studio默認的Native編譯方式吧:CMake

3.2、CMake的應用

在CMake編譯之前,咱們應該先做哪些準備工作?

1、NDK環境是否配置正確?
-- 如果未配置正確是無法進行C/C++開發的,更不用說CMake編譯了

2、C/C++功能是否實現? 
-- 此次演示主要使用系統默認創建的native-lib.cpp文件,關於具體如何實現:後續文章再詳細講解

3、CMakeLists.txt是否創建並正確配置? 
-- 該文件是CMake工具編譯的基礎,未配置或配置項錯誤,均會影響編譯結果

4、gradle是否正確配置?
-- gradle配置也是CMake工具編譯的基礎,未配置或配置項錯誤,均會影響編譯結果

除此之外,咱們還應該學習CMake的哪些重要知識?

1、CMake工具編譯生成的庫文件默認在什麼位置?apk中庫文件又是在什麼位置?
2、CMake工具如何指定編譯生成的庫文件位置?
3、CMake工具如何指定生成不同CPU平台對應的庫文件?

帶着這些問題,咱們開始CMake之旅吧:

3.2.1、NDK環境檢查

編譯前,建議先檢查下工程的NDK配置情況(不然容易報一些亂七八糟的錯誤):
File –> Project Structure –> SDK Location,如下圖(我本地的Android Studio默認沒有給配置NDK路徑,那麼,需要自己手動指定一下):

3.2.2、C/C++功能實現

因為本節主講CMake編譯工具,代碼就不單獨寫了,咱們直接使用工程默認生成的native-liv.cpp,簡單調整一下native實現方法的代碼吧(修改返迴文本信息):

因Native C++工程默認已配置好了CMakeLists.txt和gradle,所以咱們可直接運行工程看效果,如下圖:

JNI交互效果我們已經看到了,說明CMake編譯成功了。那麼,這究竟是怎麼做到的呢?咱們接着分析一下吧:

3.2.3、CMake生成的庫文件與apk中的庫文件

安卓工程編譯時,會執行CMake編譯,在 工程/app/build/…/cmake/ 中會產生對應的so文件,如下圖:

繼續編譯安卓工程,會根據build中的內容,生成我們的*.apk安裝包文件。我們找到、反編譯apk安裝包文件,查找so庫文件。原來在apk安裝包中,so庫都被存放在lib目錄中,如下圖:

3.2.4、CMake是如何編譯生成so庫的呢?

在前面介紹CMake定義時,提到了CMake是基於CMakeLists.txt文件和gradle配置實現編譯Native類的。那麼,咱們先來看一下CMakeLists.txt文件吧:

#cmake最低版本要求
cmake_minimum_required(VERSION 3.4.1)

#添加庫
add_library(
        # 庫名
        native-lib

        # 類型:
        # SHARED 是指動態庫,對應的是.so文件
        # STATIC 是指靜態庫,對應的是.a文件
        # 其他類型:略
        SHARED

        # native類路徑
        native-lib.cpp)

# 查找依賴庫
find_library( 
        # 依賴庫別名
        log-lib

        # 希望加到本地的NDK庫名稱,log指NDK的日誌庫
        log)


# 鏈接庫,建立關係( 此處就是指把log-lib 鏈接給 native-lib使用 )
target_link_libraries( 
        # 目標庫名稱(native-lib 是咱們要生成的so庫)
        native-lib

        # 要鏈接的庫(log-lib 是上面查找的log庫)
        ${log-lib})

實際上,CMakeList.txt可配置的內容遠不止這些,如:so輸出目錄,生成規則等等,有需要的同學可查下官網。

接着,咱們再看一下app的gradle又是如何配置CMake的呢?

apply plugin: 'com.android.application'

android {
    compileSdkVersion 29
    buildToolsVersion "29.0.1"
    defaultConfig {
        applicationId "com.qxc.testnativec"
        minSdkVersion 21
        targetSdkVersion 29
        versionCode 1
        versionName "1.0"
        testInstrumentationRunner "androidx.test.runner.AndroidJUnitRunner"
        //定義cmake默認配置屬性
        externalNativeBuild {
            cmake {
                cppFlags ""
            }
        }
    }
    
    //定義cmake對應的CMakeList.txt路徑(重要)
    externalNativeBuild {
        cmake {
            path "src/main/cpp/CMakeLists.txt"
        }
    }
}

dependencies {
    implementation fileTree(dir: 'libs', include: ['*.jar'])
    implementation 'androidx.appcompat:appcompat:1.1.0'
    implementation 'androidx.constraintlayout:constraintlayout:1.1.3'
    testImplementation 'junit:junit:4.12'
    androidTestImplementation 'androidx.test.ext:junit:1.1.1'
    androidTestImplementation 'androidx.test.espresso:espresso-core:3.2.0'
}

實際上,gradle可配置的cmake內容也遠不止這些,如:abi、cppFlags、arguments等,有需要的同學可查下官網。

3.2.5、如何指定庫文件的輸出目錄?

如果希望將so庫生成到特定目錄,並讓項目直接使用該目錄下的so,應該如何配置呢?
比較簡單:需要在CMakeList.txt中配置庫的輸出路徑信息,即:

CMAKE_LIBRARY_OUTPUT_DIRECTORY

# cmake最低版本要求
cmake_minimum_required(VERSION 3.4.1)

# 配置庫生成路徑
# CMAKE_CURRENT_SOURCE_DIR是指 cmake庫的源路徑,通常是build/.../cmake/
# /../jniLibs/是指與CMakeList.txt所在目錄的同級目錄:jniLibs (如果沒有會新建)
# ANDROID_ABI 生成庫文件時,採用gradle配置的ABI策略(即:生成哪些平台對應的庫文件)
set(CMAKE_LIBRARY_OUTPUT_DIRECTORY ${CMAKE_CURRENT_SOURCE_DIR}/../jniLibs/${ANDROID_ABI})

# 添加庫
add_library( # 庫名
        native-lib

        # 類型:
        # SHARED 是指動態庫,對應的是.so文件
        # STATIC 是指靜態庫,對應的是.a文件
        # 其他類型:略
        SHARED

        # native類路徑
        native-lib.cpp)

# 查找依賴庫
find_library(
        # 依賴庫別名
        log-lib

        # 希望加到本地的NDK庫名稱,log指NDK的日誌庫
        log)


# 鏈接庫,建立關係( 此處就是指把log-lib 鏈接給native-lib使用 )
target_link_libraries(
        # 目標庫名稱(native-lib就是咱們要生成的so庫)
        native-lib

        # 要鏈接的庫(上面查找的log庫)
        ${log-lib})

還需要在gradle中配置 jniLibs.srcDirs 屬性(即:指定了lib庫目錄):

sourceSets {
        main {
            jniLibs.srcDirs = ['jniLibs']//指定lib庫目錄
        }
    }

接着,重新build就會在cpp相同目錄級別位置生成jniLibs目錄,so庫也在其中了:

注意事項:
1、配置了CMAKE_CURRENT_SOURCE_DIR,並非表示編譯時直接將so生成在該目錄中,實際編譯時,so文件仍然是
先生成在build/.../cmake/中,然後再拷貝到目標目錄中的

2、如果只配置了CMAKE_CURRENT_SOURCE_DIR,並未在gradle中配置 jniLibs.srcDirs,也會有問題,如下:
More than one file was found with OS independent path 'lib/arm64-v8a/libnative-lib.so'

此問題是指:在編譯生成apk時,發現了多個so目錄,android studio不知道使用哪一個了,所以需要咱們
告訴android studio當前工程使用的是jniLibs目錄,而非build/.../cmake/目錄
3.2.5、如何生成指定CPU平台對應的庫文件呢?

我們可以在cmake中設置abiFilters,也可在ndk中設置abiFilters,效果是一樣的:

defaultConfig {
        applicationId "com.qxc.testnativec"
        minSdkVersion 21
        targetSdkVersion 29
        versionCode 1
        versionName "1.0"
        testInstrumentationRunner "androidx.test.runner.AndroidJUnitRunner"
        externalNativeBuild {
            cmake {
                cppFlags ""
                abiFilters "arm64-v8a"
            }
        }
    }
defaultConfig {
        applicationId "com.qxc.testnativec"
        minSdkVersion 21
        targetSdkVersion 29
        versionCode 1
        versionName "1.0"
        testInstrumentationRunner "androidx.test.runner.AndroidJUnitRunner"
        externalNativeBuild {
            cmake {
                cppFlags ""
            }
        }
        ndk {
            abiFilters "arm64-v8a"
        }
    }

按照新的配置,我們重新運行工程,如下圖:

再反編譯看下工程,果然只有arm64-v8a的so庫了,不過庫文件在apk中仍然是放在lib目錄,而非jniLibs(其實也很好理解,jniLibs只是我們本地的目錄,便於我們管理庫文件,真正生成apk時,仍然會按照lib目錄放置庫文件),如下圖:

至此,CMake的主要技術點都講完了,接下來咱們看下NDK-Build吧~

3.3、ndk-build的應用

在ndk-build編譯之前,咱們又應該先做哪些準備工作?

1、ndk-build環境變量是否正確配置?
-- 如果未配置,是無法在cmd、Mac終端、Terminal中使用ndk-build命令的(會報錯:找不到命令)

2、NDK環境是否配置正確?
-- 如果未配置正確是無法進行C/C++開發的,更不用說ndk-build編譯了

3、C/C++功能是否實現?
-- 此次演示主要使用系統默認創建的native-lib.cpp文件,關於具體如何實現:後續文章再詳細講解
-- 注意:為了與CMake區分,咱們新建一個“jni”目錄存放C/C++文件、配置文件吧

4、Android.mk是否創建並正確配置? 
-- 該文件是ndk-build工具編譯的基礎,未配置或配置項錯誤,均會影響編譯結果

5、gradle是否正確配置?(可選項,如果通過cmd、Mac終端、Terminal執行ndk-build,可忽略)
-- gradle配置也是ndk-build工具編譯的基礎,未配置或配置項錯誤,均會影響編譯結果

6、Application.mk是否創建並正確配置?(可選項,一般配ABI、版本,這些項均可在gradle中配置)
-- 該文件也是ndk-build工具編譯的基礎,未配置或配置項錯誤,均會影響編譯結果

除此之外,咱們還應該學習ndk-build的哪些重要知識?

1、ndk-build工具如何指定編譯生成的庫文件位置?
2、ndk-build工具如何指定生成不同CPU平台對應的庫文件?

帶着這些問題,咱們繼續ndk-build之旅吧:

3.3.1、環境變量配置

介紹NDK-Build定義時,提到了其實它是NDK的腳本工具。那麼,咱們還是先進NDK目錄找一下吧,ndk-build工具的位置如下圖:

如果我們希望任意情況下都能便捷的使用這種腳本工具,通常做法是配置其環境變量,否則我們在cmd、Mac終端、Terminal中執行 ndk-build 命令時,會報錯:“未找到命令”

配置NDK的環境變量,也很簡單,以Mac電腦舉例(如果是Windows電腦,網上也有很多關於配置環境變量的文章,如果有需要可自行查下):

1、打開命令終端,輸入命令: open -e .bash_profile,打開bash_profile配置文件

2、寫入如下內容(NDK_HOME指向 ndk-build 所在路徑):
export NDK_HOME=/Users/xc/SDK/android-sdk-macosx/ndk/20.1.5948944
export PATH=$PATH:$NDK_HOME

3、生效.bash_profile配置
source .bash_profile

當我們在cmd、Mac終端、Terminal中執行 ndk-build 命令時,如果出現下圖所示內容,則代表配置成功了:

3.3.2、C/C++功能實現

咱們使用比較常用的一種ndk-build方式吧:ndk-build + Android.mk + gradle配置

項目中新建jni目錄,拷貝一份CMake的代碼實現吧:

1、新建jni目錄
2、拷貝cpp/native-lib.cpp 至 jni目錄下
3、重命名為haha.cpp (與CMake區分)
4、調整一下native實現方法的文本(與CMake運行效果區分)
5、新建Android.mk文件

接着,編寫Android.mk文件內容:

#表示Android.mk所在目錄
LOCAL_PATH := $(call my-dir)

#CLEAR_VARS變量指向特殊 GNU Makefile,用於清除部分LOCAL_變量
include $(CLEAR_VARS)

#模塊名稱
LOCAL_MODULE    := haha
#構建系統用於生成模塊的源文件列表
LOCAL_SRC_FILES := haha.cpp

#BUILD_SHARED_LIBRARY 表示.so動態庫
#BUILD_STATIC_LIBRARY 表示.a靜態庫
include $(BUILD_SHARED_LIBRARY)

配置gradle:

apply plugin: 'com.android.application'
android {
    compileSdkVersion 28
    defaultConfig {
        applicationId "com.aaa.testnative"
        minSdkVersion 16
        targetSdkVersion 28
        versionCode 1
        versionName "1.0"
        testInstrumentationRunner "android.support.test.runner.AndroidJUnitRunner"

        //定義ndkBuild默認配置屬性
        externalNativeBuild {
            ndkBuild {
                cppFlags ""
            }
        }
    }
   
    //定義ndkBuild對應的Android.mk路徑(重要)
    externalNativeBuild {
        ndkBuild{
            path "src/main/jni/Android.mk"
        }
    }
}

dependencies {
    implementation fileTree(dir: 'libs', include: ['*.jar'])
    implementation 'com.android.support:appcompat-v7:28.0.0'
    implementation 'com.android.support.constraint:constraint-layout:1.1.3'
    testImplementation 'junit:junit:4.12'
    androidTestImplementation 'com.android.support.test:runner:1.0.2'
    androidTestImplementation 'com.android.support.test.espresso:espresso-core:3.0.2'
}

現在,native代碼、ndk-build配置都完成了,咱們運行看一下效果吧,如下圖:

3.3.4、如何指定庫文件的輸出目錄?

通常,可在Android.mk文件中配置NDK_APP_DST_DIR
指定源目錄與輸出目錄(與CMake類似)

#表示Android.mk所在目錄
LOCAL_PATH := $(call my-dir)

#設置庫文件的輸入目錄
#輸出目錄 ../jniLibs/
#源目錄 $(TARGET_ARCH_ABI)
NDK_APP_DST_DIR=../jniLibs/$(TARGET_ARCH_ABI)

#CLEAR_VARS變量指向特殊 GNU Makefile,用於清除部分LOCAL_變量
include $(CLEAR_VARS)

#模塊名稱
LOCAL_MODULE    := haha
#構建系統用於生成模塊的源文件列表
LOCAL_SRC_FILES := haha.cpp

#BUILD_SHARED_LIBRARY 表示.so動態庫
#BUILD_STATIC_LIBRARY 表示.a靜態庫
include $(BUILD_SHARED_LIBRARY)
3.3.5、如何生成指定CPU平台對應的庫文件呢?

可在gradle中配置abiFilters(與Cmake類似)

externalNativeBuild {
            ndkBuild {
                cppFlags ""
                abiFilters "arm64-v8a"
            }
        }
externalNativeBuild {
            ndkBuild {
                cppFlags ""
            }
        }
  ndk {
            abiFilters "arm64-v8a"
        }
3.3.6、如何在Terminal中直接通過ndk-build命令構建庫文件呢?

除了執行AndroidStudio的build命令,基於gradle配置 + Android.mk編譯生成庫文件,我們還可以在cmd、Mac 終端、Terminal中直接通過ndk-build命令構建庫文件,此處以Terminal為例進行演示吧:

先進入包含Android.mk文件的jni目錄(Android Studio中可直接選中jni目錄並拖拽到Terminal中,會自動跳轉到該目錄),再執行ndk-build命令,如下圖:

同樣,編譯也成功了,如下圖:

因是直接在Terminal中執行了ndk-build命令,所以只會根據Android.mk進行編譯(不包含gradle配置內容,也就不會執行abiFilters過濾),生成了所有默認CPU平台的so庫文件。

ndk-build命令其實也可以配上一些參數使用,此處就不再詳解了。日常開發時,還是建議選擇CMake作為Native編譯工具,因為是安卓主推的,而且更簡單一些。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享
【集合系列】- 深入淺出的分析TreeMap

一、摘要

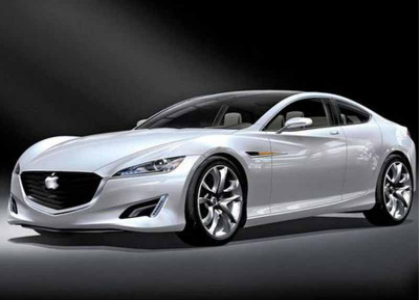
在集合系列的第一章,咱們了解到,Map的實現類有HashMap、LinkedHashMap、TreeMap、IdentityHashMap、WeakHashMap、Hashtable、Properties等等。

本文主要從數據結構和算法層面,探討TreeMap的實現。

二、簡介

Java TreeMap實現了SortedMap接口,也就是說會按照key的大小順序對Map中的元素進行排序,key大小的評判可以通過其本身的自然順序(natural ordering),也可以通過構造時傳入的比較器(Comparator)。

TreeMap底層通過紅黑樹(Red-Black tree)實現,所以要了解TreeMap就必須對紅黑樹有一定的了解,在《集合系列》文章中,如果你已經讀過紅黑樹的講解,其實本文要講解的TreeMap,跟其大同小異。

紅黑樹又稱紅-黑二叉樹,它首先是一顆二叉樹,它具有二叉樹所有的特性。同時紅黑樹更是一顆自平衡的排序二叉樹。

對於一棵有效的紅黑樹二叉樹,主要有以下規則:

  • 1、每個節點要麼是紅色,要麼是黑色,但根節點永遠是黑色的;
  • 2、每個紅色節點的兩個子節點一定都是黑色;
  • 3、紅色節點不能連續(也即是,紅色節點的孩子和父親都不能是紅色);
  • 4、從任一節點到其子樹中每個恭弘=叶 恭弘子節點的路徑都包含相同數量的黑色節點;
  • 5、所有的恭弘=叶 恭弘節點都是是黑色的(注意這裏說恭弘=叶 恭弘子節點其實是上圖中的 NIL 節點);

這些約束強制了紅黑樹的關鍵性質:從根到恭弘=叶 恭弘子的最長的可能路徑不多於最短的可能路徑的兩倍長。結果是這棵樹大致上是平衡的。因為操作比如插入、刪除和查找某個值的最壞情況時間都要求與樹的高度成比例,這個在高度上的理論上限允許紅黑樹在最壞情況下都是高效的,而不同於普通的二叉查找樹。所以紅黑樹它是複雜而高效的,其檢索效率O(log n)。下圖為一顆典型的紅黑二叉樹。

在樹的結構發生改變時(插入或者刪除操作),往往會破壞上述條件3或條件4,需要通過調整使得查找樹重新滿足紅黑樹的條件。

調整方式主要有:左旋、右旋和顏色轉換!

2.1、左旋

左旋的過程是將x的右子樹繞x逆時針旋轉,使得x的右子樹成為x的父親,同時修改相關節點的引用。旋轉之後,二叉查找樹的屬性仍然滿足。

2.2、右旋

右旋的過程是將x的左子樹繞x順時針旋轉,使得x的左子樹成為x的父親,同時修改相關節點的引用。旋轉之後,二叉查找樹的屬性仍然滿足。

2.3、顏色轉換

顏色轉換的過程是將紅色節點轉換為黑色節點,或者將黑色節點轉換為紅色節點,以滿足紅黑樹二叉樹的規則!

三、常用方法介紹

3.1、get方法

get方法根據指定的key值返回對應的value,該方法調用了getEntry(Object key)得到相應的entry,然後返回entry.value。

算法思想是根據key的自然順序(或者比較器順序)對二叉查找樹進行查找,直到找到滿足k.compareTo(p.key) == 0的entry。

源碼如下:

final Entry<K,V> getEntry(Object key) {
        //如果傳入比較器,通過getEntryUsingComparator方法獲取元素
        if (comparator != null)
            return getEntryUsingComparator(key);
        //不允許key值為null
        if (key == null)
            throw new NullPointerException();
        //使用元素的自然順序
            Comparable<? super K> k = (Comparable<? super K>) key;
        Entry<K,V> p = root;
        while (p != null) {
            int cmp = k.compareTo(p.key);
            if (cmp < 0)
                //向左找
                p = p.left;
            else if (cmp > 0)
                //向右找
                p = p.right;
            else
                return p;
        }
        return null;
}

如果傳入比較器,通過getEntryUsingComparator方法獲取元素

final Entry<K,V> getEntryUsingComparator(Object key) {
            K k = (K) key;
        Comparator<? super K> cpr = comparator;
        if (cpr != null) {
            Entry<K,V> p = root;
            while (p != null) {
                //通過比較器順序,獲取元素
                int cmp = cpr.compare(k, p.key);
                if (cmp < 0)
                    p = p.left;
                else if (cmp > 0)
                    p = p.right;
                else
                    return p;
            }
        }
        return null;
}

測試用例:

public static void main(String[] args) {
        Map initMap = new TreeMap();
        initMap.put("4", "d");
        initMap.put("3", "c");
        initMap.put("1", "a");
        initMap.put("2", "b");
        //默認自然排序,key為升序
        System.out.println("默認 排序結果:" + initMap.toString());

        //自定義排序,在TreeMap初始化階段傳入Comparator 內部對象
        Map comparatorMap = new TreeMap<String, String>(new Comparator<String>() {

            @Override
            public int compare(String o1, String o2){
                //根據key比較大小,採用倒敘,以大到小排序
                return o2.compareTo(o1);
            }
        });
        comparatorMap.put("4", "d");
        comparatorMap.put("3", "c");
        comparatorMap.put("1", "a");
        comparatorMap.put("2", "b");

        System.out.println("自定義 排序結果:" + comparatorMap.toString());
}

輸出結果:

默認 排序結果:{1=a, 2=b, 3=c, 4=d}
自定義 排序結果:{4=d, 3=c, 2=b, 1=a}

3.2、put方法

put方法是將指定的key, value對添加到map里。該方法首先會對map做一次查找,看是否包含該元組,如果已經包含則直接返回,查找過程類似於getEntry()方法;如果沒有找到則會在紅黑樹中插入新的entry,如果插入之後破壞了紅黑樹的約束,還需要進行調整(旋轉,改變某些節點的顏色)。

源碼如下:

public V put(K key, V value) {
        Entry<K,V> t = root;
        //如果紅黑樹根部為空,直接插入
        if (t == null) {
            compare(key, key); // type (and possibly null) check

            root = new Entry<>(key, value, null);
            size = 1;
            modCount++;
            return null;
        }
        int cmp;
        Entry<K,V> parent;
        // split comparator and comparable paths
        Comparator<? super K> cpr = comparator;
        //如果比較器,通過比較器順序,找到插入位置
        if (cpr != null) {
            do {
                parent = t;
                cmp = cpr.compare(key, t.key);
                if (cmp < 0)
                    t = t.left;
                else if (cmp > 0)
                    t = t.right;
                else
                    return t.setValue(value);
            } while (t != null);
        }
        else {
            //通過自然順序,找到插入位置
            if (key == null)
                throw new NullPointerException();
                Comparable<? super K> k = (Comparable<? super K>) key;
            do {
                parent = t;
                cmp = k.compareTo(t.key);
                if (cmp < 0)
                    t = t.left;
                else if (cmp > 0)
                    t = t.right;
                else
                    return t.setValue(value);
            } while (t != null);
        }
        //創建並插入新的entry
        Entry<K,V> e = new Entry<>(key, value, parent);
        if (cmp < 0)
            parent.left = e;
        else
            parent.right = e;
        //紅黑樹調整函數
        fixAfterInsertion(e);
        size++;
        modCount++;
        return null;
}

紅黑樹調整函數fixAfterInsertion(Entry<K,V> x)

private void fixAfterInsertion(Entry<K,V> x) {
    x.color = RED;
    while (x != null && x != root && x.parent.color == RED) {
        //判斷x是否在樹的左邊,還是右邊
        if (parentOf(x) == leftOf(parentOf(parentOf(x)))) {
            Entry<K,V> y = rightOf(parentOf(parentOf(x)));
            //如果x的父親的父親的右子樹是紅色,違反了紅色節點不能連續
            if (colorOf(y) == RED) {
                //進行顏色調整,以滿足紅色節點不能連續規則
                setColor(parentOf(x), BLACK);
                setColor(y, BLACK); 
                setColor(parentOf(parentOf(x)), RED);
                x = parentOf(parentOf(x));
            } else {
                //如果x的父親的右子樹等於自己,那麼需要進行左旋轉
                if (x == rightOf(parentOf(x))) {
                    x = parentOf(x);
                    rotateLeft(x);
                }
                setColor(parentOf(x), BLACK);  
                setColor(parentOf(parentOf(x)), RED);
                rotateRight(parentOf(parentOf(x)));
            }
        } else {
            //跟上面的流程正好相反
            //獲取x的父親的父親的左子樹節點
            Entry<K,V> y = leftOf(parentOf(parentOf(x)));
            //如果y是紅色節點,違反了紅色節點不能連續
            if (colorOf(y) == RED) {
                //進行顏色轉換
                setColor(parentOf(x), BLACK);
                setColor(y, BLACK);
                setColor(parentOf(parentOf(x)), RED);
                x = parentOf(parentOf(x));
            } else {
                //如果x的父親的左子樹等於自己,那麼需要進行右旋轉
                if (x == leftOf(parentOf(x))) {
                    x = parentOf(x);
                    rotateRight(x);
                }
                setColor(parentOf(x), BLACK);
                setColor(parentOf(parentOf(x)), RED);
                rotateLeft(parentOf(parentOf(x)));
            }
        }
    }
    //根節點一定為黑色
    root.color = BLACK;
}

上述代碼的插入流程:

  • 1、首先在紅黑樹上找到合適的位置;
  • 2、然後創建新的entry並插入;
  • 3、通過函數fixAfterInsertion(),對某些節點進行旋轉、改變某些節點的顏色,進行調整;

調整圖解:

3.3、remove方法

remove的作用是刪除key值對應的entry,該方法首先通過上文中提到的getEntry(Object key)方法找到 key 值對應的 entry,然後調用deleteEntry(Entry<K,V> entry)刪除對應的 entry。由於刪除操作會改變紅黑樹的結構,有可能破壞紅黑樹的約束,因此有可能要進行調整。

源碼如下:

public V remove(Object key) {
        Entry<K,V> p = getEntry(key);
        if (p == null)
            return null;

        V oldValue = p.value;
        deleteEntry(p);
        return oldValue;
}

刪除函數 deleteEntry()

private void deleteEntry(Entry<K,V> p) {
    modCount++;
    size--;
    if (p.left != null && p.right != null) {// 刪除點p的左右子樹都非空。
        Entry<K,V> s = successor(p);// 後繼
        p.key = s.key;
        p.value = s.value;
        p = s;
    }
    Entry<K,V> replacement = (p.left != null ? p.left : p.right);
    if (replacement != null) {// 刪除點p只有一棵子樹非空。
        replacement.parent = p.parent;
        if (p.parent == null)
            root = replacement;
        else if (p == p.parent.left)
            p.parent.left  = replacement;
        else
            p.parent.right = replacement;
        p.left = p.right = p.parent = null;
        if (p.color == BLACK)
            fixAfterDeletion(replacement);// 調整
    } else if (p.parent == null) {
        root = null;
    } else { //刪除點p的左右子樹都為空
        if (p.color == BLACK)
            fixAfterDeletion(p);// 調整
        if (p.parent != null) {
            if (p == p.parent.left)
                p.parent.left = null;
            else if (p == p.parent.right)
                p.parent.right = null;
            p.parent = null;
        }
    }
}

刪除后調整函數fixAfterDeletion()的具體代碼如下:

private void fixAfterDeletion(Entry<K,V> x) {
    while (x != root && colorOf(x) == BLACK) {
        //判斷當前刪除的元素,是在x父親的左邊還是右邊
        if (x == leftOf(parentOf(x))) {
            Entry<K,V> sib = rightOf(parentOf(x));
            //判斷x的父親的右子樹,是紅色還是黑色節點
            if (colorOf(sib) == RED) {
                //進行顏色轉換
                setColor(sib, BLACK);
                setColor(parentOf(x), RED);
                rotateLeft(parentOf(x));
                sib = rightOf(parentOf(x));
            }
            //x的父親的右子樹的左邊是黑色節點,右邊也是黑色節點
            if (colorOf(leftOf(sib))  == BLACK &&
                colorOf(rightOf(sib)) == BLACK) {
                //設置x的父親的右子樹為紅色節點,將x的父親賦值給x
                setColor(sib, RED);
                x = parentOf(x);
            } else {
                //x的父親的右子樹的左邊是紅色節點,右邊也是黑色節點
                if (colorOf(rightOf(sib)) == BLACK) {
                    //x的父親的右子樹的左邊進行顏色調整,右旋調整
                    setColor(leftOf(sib), BLACK);
                    setColor(sib, RED);
                    rotateRight(sib);
                    sib = rightOf(parentOf(x));
                }
                //對x進行左旋,顏色調整
                setColor(sib, colorOf(parentOf(x)));
                setColor(parentOf(x), BLACK);
                setColor(rightOf(sib), BLACK);
                rotateLeft(parentOf(x));
                x = root;
            }
        } else { // 跟前四種情況對稱
            Entry<K,V> sib = leftOf(parentOf(x));
            if (colorOf(sib) == RED) {
                setColor(sib, BLACK);
                setColor(parentOf(x), RED);
                rotateRight(parentOf(x));
                sib = leftOf(parentOf(x));
            }
            if (colorOf(rightOf(sib)) == BLACK &&
                colorOf(leftOf(sib)) == BLACK) {
                setColor(sib, RED);
                x = parentOf(x);
            } else {
                if (colorOf(leftOf(sib)) == BLACK) {
                    setColor(rightOf(sib), BLACK);
                    setColor(sib, RED);
                    rotateLeft(sib);
                    sib = leftOf(parentOf(x));
                }
                setColor(sib, colorOf(parentOf(x)));
                setColor(parentOf(x), BLACK);
                setColor(leftOf(sib), BLACK);
                rotateRight(parentOf(x));
                x = root;
            }
        }
    }
    setColor(x, BLACK);
}

上述代碼的刪除流程:

  • 1、首先在紅黑樹上找到合適的位置;
  • 2、然後刪除entry;
  • 3、通過函數fixAfterDeletion(),對某些節點進行旋轉、改變某些節點的顏色,進行調整;

四、總結

TreeMap 默認是按鍵值的升序排序,如果需要自定義排序,可以通過new Comparator構造參數,重寫compare方法,進行自定義比較。

以上,主要是對 java 集合中的 TreeMap 做了寫講解,如果有理解不當之處,歡迎指正。

五、參考

1、JDK1.7&JDK1.8 源碼
2、
2、

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

高質量App的架構設計與思考!

最近在做一功能不大、業務也不複雜的小眾App,以往做App是發現自己從來沒有考慮過一些架構方面的問題,只是按照自己以往的習慣去寫代碼,忽略了App的設計。本次分享主要包含一些開發App的小經驗和技巧,來一次App開發與設計的分享。

先和分享下一下實體類的設計與組織形式

實體類的組織

在做App開發的時候有很多的實體類,項目越複雜實體類就會越多,經過我的一番思考大致這可以將實體分為以下幾大數:

  • 面向數據庫的
  • 服務端返回的數據實體
  • 用於渲染View的實體(使用Databinding)

一般情況下實體類的操作會經過以下步驟:

  1. App請求服務器獲取數據
  2. 將數據存入數據庫(可選)
  3. 渲染頁面展示數據

現在的實體的產生只用在請求服務器數據的時候才需要新建,後續的數據庫、頁面渲染其實是可以使用一套實體:

先不說這樣做的行不行,首先三個地方使用同一實體就會引起字段歧義比如服務器數據有Id、本地數據也有Id,那兩個id字段就有衝突了不得不改字段名。

另一種情況渲染和數據本身並不會一一對應,有時候後端數據給的是一個純数字而前端頁面显示的是字符串兩個都對應不上,強行放在一起會起來更多的問題。

所為實體類的的正確組織形式應該是:相互隔離、互不干擾:

數據實體的在渲染之前都需要準備好,比如在ViewModel中將int型的數據轉換成文本型的數據然後再使用Databinding+頁面渲染實體來渲染頁面。

優雅的處理網絡數據

現在Android開發使用的網絡庫大部分都是Okhttp + Retrofit,使用Retrofit網絡交互變的非常簡單一個Service接口就能搞定一切,美茲茲~~,現在大部分後端返回的數據都會是以下形式:

{
    "code":0,
    "data": {},
    "msg": ""
}

雖然不能涵蓋所有,但還是可以非常贊的數據、消息、成功與否啥都有!對於前面主要是關注data字段,其他msg、code等都屬於輔助字段。前端對應的實體對象應該是這樣的(假代碼):

public class ApiResponse<T> {
    private int code;
    private T data;
    private String msg;
}

對應的Service那就得定義成這樣(使用了RxJava):

public intface UserService {
    @GET("/xx/{id}")
    Single<ApiResponse<UserInfo> getUserInfoById(@Path("id") Long userId);
}

從接口中可以看出來,方法的返回值就包了幾層,如果要拿data字段需要經過:ApiResponse -> UserInfo,而且在拿之前還要判斷code字段:


...

if(ApiResponse.code == 0){
    UserInfo info = ApiResponse.getData();
}

...

為了消除這些冗餘的代碼可以使用CallAdapter來使Service方法返回的數據直接就是實體類:

public intface UserService {
    @GET("/xx/{id}")
    Single<UserInfo> getUserInfoById(@Path("id") Long userId);
}

CallAdapter的代碼就不貼了,可以自行查找。這樣做帶來的另外一個問題就是業務代碼如何判斷接口是否成功或失敗,前端必需友好的把錯誤提示給用戶而不是一直搞個Loading在那裡瞎轉~~。現階段最方便的的錯誤傳遞方式是使用Java異常,前端可以定義業務異常或網絡異常:

public class BizException extends RuntimeException {
    ...
}

在CallAdapter中檢查ApiResponse的返回值是否成功:


if(!ApiResponse != 0){
    throw new BizExcepiton(ApiResponse);
}

如果後端返回業務異常那前端就對應拋出一個BizExcepiton,如果是http錯誤如:404、400那可以拋出HttpException。除了BizExcepiton和HttpException外還可使用特定的異常比如後端返回密碼錯誤異常:

public class InvalidPasswordException extends BizException {
    ...
}

如需特殊處理,也可以滿足要求。

健壯的數據層

現在很多應用都開發使用MVVM開發模式數據層都使用Repository來表示,面向數據驅動的開發模式,頁面變化都需要隨着數據變更而更新,數據發生變化然後頁面再做出響應。Repository的拆分要細一點,不建議簡單的弄個UserRepository包含登陸、註冊、更新密碼等等操作,設計Repository的一些想法:

  1. 面向接口編程
  2. 保持單一原則
  3. 功能邊界要清晰(如:登陸、註冊可以分開)
  4. 業務邏輯盡可能的少(複雜的業務考慮Presenter)

一個判斷是否是好的設計的辦法可以這樣:一個登陸頁面從Activive/Fragment到ViewModel再到Repository,有沒有多餘的代碼。比如上面說的UserRepository包含登陸、註冊但是在一個登陸頁面就不需要有註冊功能,從登陸頁面上來看註冊的代碼就是多餘的(有些App登陸/註冊在一個頁面的~~)。

一個包含登陸、註冊的UserRepository簡單圖:

另外一點是盡量將repository使用到的一些東西集中管理,可引入一個基礎的repository:

public class SimpleRepository {
    
    protected final  <T> T getService(Class<T> clz){
        return Services.getService(clz);
    }
}

做為SimpleRepository的子類,就不需要考慮從哪裡獲取service的問題。

簡潔的UI層

UI層面可以分為ViewModel和View(Activity/Fragment), View的職責應當只有二點:

  1. 展示業務數據
  2. 收集業務數據

例如一些數據的組織、判斷都不應該出現在View中比如:

 if (Strings.isNullOrEmpty(phone)) {
       ...
        return;
 }

 if (Strings.isNullOrEmpty(pwd)) {
        ...
        return;
  }

像上面這類的代碼都不應該出現在View中,而在放置在ViewModel裏面,View只收集用戶數據傳遞給ViewModel由它來進行數據校驗。再比如像這樣的if/else代碼也應該放置在ViewModel中:

 int age = 10;
 String desc = "";
 if(age < 18){
    desc = "青年";
 }else if(age < 29){
    desc = "中年";
 }

如果數據的显示和數據的收集過多,建議使用Databinding來進行雙向綁定數據。再搭配LiveData使View作為觀察者實時監聽數據變化:

registerViewModel.getRegistryResult().observe(this, new SimpleObserver<RegistryInfo>(this));

一旦數據發生變化LiveData就會通知Observer更新,通過DataBinding更新各個頁面數據。

再說ViewModel應該只包含一些簡單的判斷、檢查、打通數據的代碼,如果業務過於複雜可以考慮加Presetner,如果真的超級複雜那可以反思下這個複雜的邏輯應不應該放在前端,能不能放在後端呢?

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

Fork/Join框架詳解

Fork/Join框架詳解

Fork/Join框架是Java 7提供的一個用於并行執行任務的框架,是一個把大任務分割成若干個小任務,最終匯總每個小任務結果后得到大任務結果的框架。Fork/Join框架要完成兩件事情:

  • 任務分割:首先Fork/Join框架需要把大的任務分割成足夠小的子任務,如果子任務比較大的話還要對子任務進行繼續分割

  • 執行任務併合並結果:分割的子任務分別放到雙端隊列里,然後幾個啟動線程分別從雙端隊列里獲取任務執行。子任務執行完的結果都放在另外一個隊列里,啟動一個線程從隊列里取數據,然後合併這些數據

ForkJoinTask

使用Fork/Join框架,首先需要創建一個ForkJoin任務。該類提供了在任務中執行fork和join的機制。通常情況下我們不需要直接集成ForkJoinTask類,只需要繼承它的子類,Fork/Join框架提供了兩個子類:

  • RecursiveAction
    用於沒有返回結果的任務
  • RecursiveTask
    用於有返回結果的任務

ForkJoinPool

ForkJoinTask需要通過ForkJoinPool來執行。

任務分割出的子任務會添加到當前工作線程所維護的雙端隊列中,進入隊列的頭部。當一個工作線程的隊列里暫時沒有任務時,它會隨機從其他工作線程的隊列的尾部獲取一個任務(工作竊取算法);

Fork/Join框架的實現原理

ForkJoinPool由ForkJoinTask數組和ForkJoinWorkerThread數組組成,ForkJoinTask數組負責將存放程序提交給ForkJoinPool,而ForkJoinWorkerThread負責執行這些任務;

ForkJoinTask的fork方法的實現原理

當我們調用ForkJoinTask的fork方法時,程序會把任務放在ForkJoinWorkerThread的pushTask的workQueue中,異步地執行這個任務,然後立即返回結果,代碼如下:

public final ForkJoinTask<V> fork() {
    Thread t;
    if ((t = Thread.currentThread()) instanceof ForkJoinWorkerThread)
        ((ForkJoinWorkerThread)t).workQueue.push(this);
    else
        ForkJoinPool.common.externalPush(this);
    return this;
}

pushTask方法把當前任務存放在ForkJoinTask數組隊列里。然後再調用ForkJoinPool的signalWork()方法喚醒或創建一個工作線程來執行任務。代碼如下:

final void push(ForkJoinTask<?> task) {
    ForkJoinTask<?>[] a; ForkJoinPool p;
    int b = base, s = top, n;
    if ((a = array) != null) {    // ignore if queue removed
        int m = a.length - 1;     // fenced write for task visibility
        U.putOrderedObject(a, ((m & s) << ASHIFT) + ABASE, task);
        U.putOrderedInt(this, QTOP, s + 1);
        if ((n = s - b) <= 1) {
            if ((p = pool) != null)
                p.signalWork(p.workQueues, this);
        }
        else if (n >= m)
            growArray();
    }
}

ForkJoinTask的join方法的實現原理

Join方法的主要作用是阻塞當前線程並等待獲取結果。讓我們一起看看ForkJoinTask的join方法的實現,代碼如下:

public final V join() {
    int s;
    if ((s = doJoin() & DONE_MASK) != NORMAL){
        reportException(s);
    }
    return getRawResult();
}

它首先調用doJoin方法,通過doJoin()方法得到當前任務的狀態來判斷返回什麼結果,任務狀態有4種:已完成(NORMAL)、被取消(CANCELLED)、信號(SIGNAL)和出現異常(EXCEPTIONAL);
如果任務狀態是已完成,則直接返回任務結果;
如果任務狀態是被取消,則直接拋出CancellationException;
如果任務狀態是拋出異常,則直接拋出對應的異常;
doJoin方法的實現,代碼如下:

private int doJoin() {
    int s;
    Thread t;
    ForkJoinWorkerThread wt;
    ForkJoinPool.WorkQueue w;
    return (s = status) < 0 ? s :
            ((t = Thread.currentThread()) instanceof                                ForkJoinWorkerThread) ? (w = (wt =                                      (ForkJoinWorkerThread)t).workQueue).tryUnpush(this) && (s =                 doExec()) < 0 ? s : wt.pool.awaitJoin(w, this, 0L) :                externalAwaitDone();
}

doExec() :

final int doExec() {
    int s; 
    boolean completed;
    if ((s = status) >= 0) {
        try {
            completed = exec();
        } catch (Throwable rex) {
            return setExceptionalCompletion(rex);
        }
        if (completed){
            s = setCompletion(NORMAL);
        }
    }
    return s;
}

在doJoin()方法里,首先通過查看任務的狀態,看任務是否已經執行完成,如果執行完成,則直接返回任務狀態;如果沒有執行完,則從任務數組裡取出任務並執行。如果任務順利執行完成,則設置任務狀態為NORMAL,如果出現異常,則記錄異常,並將任務狀態設置為EXCEPTIONAL

Fork/Join框架的異常處理

ForkJoinTask在執行的時候可能會拋出異常,但是我們沒辦法在主線程里直接捕獲異常,所以ForkJoinTask提供了isCompletedAbnormally()方法來檢查任務是否已經拋出異常或已經被取消了,並且可以通過ForkJoinTask的getException方法獲取異常。代碼如下:

if(task.isCompletedAbnormally())
{
    System.out.println(task.getException());
}

getException方法返回Throwable對象,如果任務被取消了則返回CancellationException。如果任務沒有完成或者沒有拋出異常則返回null:

public final Throwable getException() {
    int s = status & DONE_MASK;
    return ((s >= NORMAL) ? null :
        (s == CANCELLED) ? new CancellationException() :
        getThrowableException());
}

DEMO

需求:求1+2+3+4的結果
分析:Fork/Join框架首先要考慮到的是如何分割任務,如果希望每個子任務最多執行兩個數的相加,那麼我們設置分割的閾值是2,由於是4個数字相加,所以Fork/Join框架會把這個任務fork成兩個子任務,子任務一負責計算1+2,子任務二負責計算3+4,然後再join兩個子任務的結果。因為是有結果的任務,所以必須繼承RecursiveTask,實現代碼如下:

import java.util.concurrent.ExecutionException;
import java.util.concurrent.ForkJoinPool;
import java.util.concurrent.Future;
import java.util.concurrent.RecursiveTask;

/**
 *
 * @author aikq
 * @date 2018年11月21日 20:37
 */
public class ForkJoinTaskDemo {

    public static void main(String[] args) {
        ForkJoinPool pool = new ForkJoinPool();
        CountTask task = new CountTask(1,4);
        Future<Integer> result = pool.submit(task);
        try {
            System.out.println("計算結果=" + result.get());
        } catch (InterruptedException e) {
            e.printStackTrace();
        } catch (ExecutionException e) {
            e.printStackTrace();
        }
    }
}

class CountTask extends RecursiveTask<Integer>{
    private static final long serialVersionUID = -7524245439872879478L;

    private static final int THREAD_HOLD = 2;

    private int start;
    private int end;

    public CountTask(int start,int end){
        this.start = start;
        this.end = end;
    }

    @Override
    protected Integer compute() {
        int sum = 0;
        //如果任務足夠小就計算
        boolean canCompute = (end - start) <= THREAD_HOLD;
        if(canCompute){
            for(int i=start;i<=end;i++){
                sum += i;
            }
        }else{
            int middle = (start + end) / 2;
            CountTask left = new CountTask(start,middle);
            CountTask right = new CountTask(middle+1,end);
            //執行子任務
            left.fork();
            right.fork();
            //獲取子任務結果
            int lResult = left.join();
            int rResult = right.join();
            sum = lResult + rResult;
        }
        return sum;
    }
}

通過這個例子,我們進一步了解ForkJoinTask,ForkJoinTask與一般任務的主要區別在於它需要實現compute方法,在這個方法里,首先需要判斷任務是否足夠小,如果足夠小就直接執行任務。如果不足夠小,就必須分割成兩個子任務,每個子任務在調用fork方法時,又會進入compute方法,看看當前子任務是否需要繼續分割成子任務,如果不需要繼續分割,則執行當前子任務並返回結果。使用join方法會等待子任務執行完並得到其結果

本文由博客一文多發平台 發布!

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益