.NET資源泄露與處理方案

.NET雖然擁有強大易用的垃圾回收機制,但並不是因為這樣,你就可以對資源管理放任不管,其實在稍不注意的時候,可能就造成了資源泄露,甚至因此導致系統崩潰,到那時再來排查問題就已經是困難重重。

==========    ==========

一、知識點簡單介紹

常見的資源泄露有:

  • 內存泄漏:非託管資源沒有釋放、非靜態對象註冊了靜態實例。
  • GDI泄露:字體。
  • 句柄泄露:Socket或線程。
  • 用戶對象泄露:移除的對象未釋放。

二、具體實例

1. 內存泄漏

很常見的現象是分不清哪些對象需要釋放,對於控件、Stream等一些非託管資源也只管新增,卻沒有釋放,功能是實現了,卻埋了顆不小的雷。

private void button1_Click(object sender, EventArgs e)
{
    for(int i=0;i<1000;i++)
        this.Controls.Add(new TabPage());
}
private void button1_Click(object sender, EventArgs e)
{
    new Form2.ShowDialog();
}

如果你覺得寫這樣的代碼很Cool,很簡潔,你在項目中也有這麼寫代碼,那你就碰到大麻煩了,你試試在上面Form2中開個大一點的數組來檢查內存,然後運行,按幾下按鈕,你就會發現,內存一直增加,即使你調用了GC也無濟於事。所以,對於此類非託管資源要記住釋放,用完即廢可以採用using關鍵字。

public Form2()
{
    InitializeComponent();
    MyApp.FormChanged += FormChanged;
}

上面這個例子中,MyApp是一個靜態類,如果在實例對象中向這種類裏面註冊了事件,而又沒有取消註冊,這樣也會遇到大麻煩,即使在外部已經記得調用了Form2的Dispose也是沒用的。

解決方案

  • 注意託管資源和非託管資源的釋放區別,非託管資源是需要手動釋放的。
  • ,如上面的ShowDialog問題。(using中還起到了try-catch的作用,避免由於異常未調用Dispose的情況)
  • 使用UnLoad事件或者析構函數,對註冊的全局事件進行取消註冊。
  • 特別注意自定義組件的穩定性更重要,發生問題時影響也更廣。

2. GDI泄露

一般會跟字體相關,例如我曾在Android上用Cocos2d做一個小遊戲時頻繁地切換字體、Dev控件的Font屬性賦值也會有這種現象。

XXX.Font = new Font(...)

解決方案

  • 這個問題我目前是採用字體池來解決,類似線程池的概念,相同Key值取同一個對象。若有更好方案歡迎留言討論

3. 句柄泄露

一般跟Socket和Thread(線程)有關

for(int i=0;i<1000;i++){
    new Thread(()=>{
        Thread.Sleep(1000);
    }).Start();
}

解決方案

  • Socket的場景暫時沒遇到。
  • 線程問題採用線程池相關的輔助類能有效解決,例如ThreadPool、Task、Parallel。

4. 用戶對象泄露

一般跟移除的對象未釋放有關

private void button1_Click(object sender, EventArgs e)
{
    tab.Remove(tabPage);
}

三、最後特別奉送一個內存釋放的大招

[DllImport("kernel32.dll", EntryPoint = "SetProcessWorkingSetSize")]
public static extern int SetProcessWorkingSetSize(IntPtr process, int minSize, int maxSize);
/// <summary>    
/// 釋放內存    
/// </summary>    
public static void ClearMemory()
{
    GC.Collect();
    GC.WaitForPendingFinalizers();
    if (Environment.OSVersion.Platform == PlatformID.Win32NT)
    {
        SetProcessWorkingSetSize(System.Diagnostics.Process.GetCurrentProcess().Handle, -1, -1);
    }
}

調用以上API能讓你的內存一下爆減,是不是很給力,一調用內存就降下來了。But,先別高興太早,這其實是偽釋放,只是暫時解決內存大量泄漏導致系統崩潰的應急處理方案。具體原因參考:,關鍵信息:物理內存轉虛擬內存,涉及磁盤讀寫。好處壞處都貼出來了,是否需要使用請君自己斟酌。

四、總結

實際上由於各個開發人員的水平跟接觸面不同,又沒有經過統一的培訓(各個人對資源釋放的理解與關注度不同,或者寫代碼時就沒考慮內存未被釋放這種問題),發現問題的時候項目往往已經做到了一個階段,系統也比較龐大了,這種時候才發現內存泄露的問題確實是很頭疼的。

  • 資源泄露的場景往往是相互關聯的,發生最多的就是內存泄漏,而除了寫法可能有問題外,也可能是因為句柄泄露或用戶對象泄露引起的。

五、參考資料

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

java中的string對象深入了解

這裏來對Java中的String對象做一個稍微深入的了解。

Java對象實現的演進

String對象是Java中使用最頻繁的對象之一,所以Java開發者們也在不斷地對String對象的實現進行優化,以便提升String對象的性能。

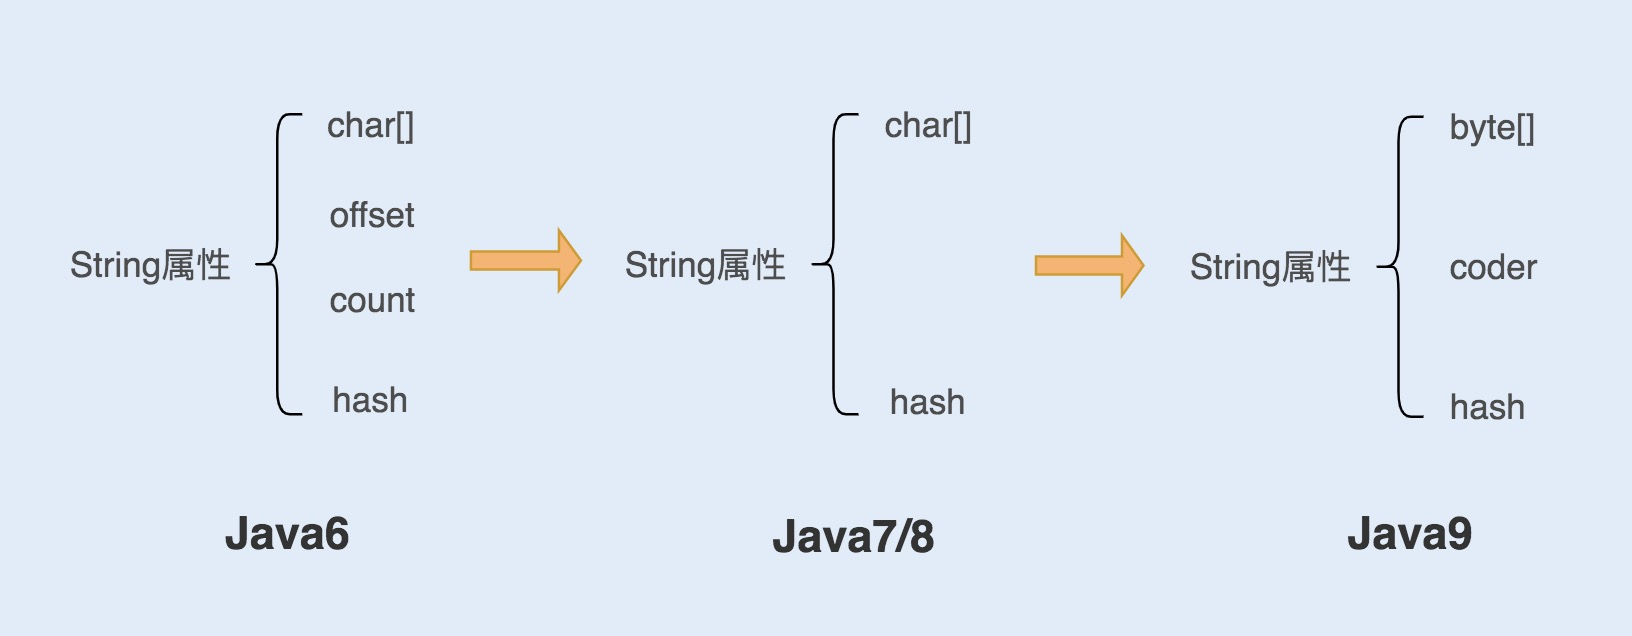
Java6以及之前版本中String對象的屬性

在Java6以及之前版本中,String對象是對char數組進行了封裝實現的對象,其主要有4個成員成員變量,分別是char數組、偏移量offset、字符數量count和哈希值hash。String對象是通過offset和count兩個屬性來定位char[]數組,獲取字符串。這樣做可以高效、快速地共享數組對象,同時節省內存空間,但是這種方式卻可能會導致內存泄漏的發生。

Java7、8版本中String對象的屬性

從Java7版本開始,Java對String類做了一些改變,具體是String類不再有offset和count兩個變量了。這樣做的好處是String對象佔用的內存稍微少了點,同時String.substring()方法也不再共享char[]了,從而解決了使用該方法可能導致的內存泄漏問題。

Java9以及之後版本中String對象的屬性

從Java9版本開始,Java將char[]數組改為了byte[]數組。我們都知道,char是兩個字節的,如果用來存一個字節的情況下就會造成內存空間的浪費。而為了節約這一個字節的空間,Java開發者就改成了一個使用一個字節的byte來存儲字符串。

另外,在Java9中,String對象維護了一個新的屬性coder,這個屬性是編碼格式的標識,在計算字符串長度或者調用indexOf()方法的時候,會需要根據這個字段去判斷如何計算字符串長度。coder屬性默認有0和1兩個值,其中0代表Latin-1(單字節編碼),1則表示UTF-16編碼。

String對象的創建方式與在內存中的存放

在Java中,對於基本數據類型的變量和對對象的引用,保存在棧內存的局部變量表中;而通過new關鍵字和Constructor創建的對象,則是保存在堆內存中。而String對象的創建方式一般為兩種,一種是字面量(字符串常量)的方式,一種則是構造函數(String())的方式,兩種方式在內存中的存放有所不同。

字面量(字符串常量)的創建方式

使用字面量的方式創建字符串時,JVM會在字符串常量池中先檢查是否存在該字面量,如果存在,則返回該字面量在內存中的引用地址;如果不存在,則在字符串常量池中創建該字面量並返回引用。使用這種方式創建的好處是避免了相同值的字符串在內存中被重複創建,節約了內存,同時這種寫法也會比較簡單易讀一些。

String str = "i like yanggb.";

字符串常量池

這裏要特別說明一下常量池。常量池是JVM為了減少字符串對象的重複創建,特別維護了一個特殊的內存,這段內存被稱為字符串常量池或者字符串字面量池。在JDK1.6以及之前的版本中,運行時常量池是在方法區中的。在JDK1.7以及之後版本的JVM,已經將運行時常量池從方法區中移了出來,在Java堆(Heap)中開闢了一塊區域用來存放運行時常量池。而從JDK1.8開始,JVM取消了Java方法區,取而代之的是位於直接內存的元空間(MetaSpace)。總結就是,目前的字符串常量池在堆中。

我們所知道的幾個String對象的特點都來源於String常量池。

1.在常量池中會共享所有的String對象,因此String對象是不可被修改的,因為一旦被修改,就會導致所有引用此String對象的變量都隨之改變(引用改變),所以String對象是被設計為不可修改的,後面會對這個不可變的特性做一個深入的了解。

2.String對象拼接字符串的性能較差的說法也是來源於此,因為String對象不可變的特性,每次修改(這裡是拼接)都是返回一個新的字符串對象,而不是再原有的字符串對象上做修改,因此創建新的String對象會消耗較多的性能(開闢另外的內存空間)。

3.因為常量池中創建的String對象是共享的,因此使用雙引號聲明的String對象(字面量)會直接存儲在常量池中,如果該字面量在之前已存在,則是會直接引用已存在的String對象,這一點在上面已經描述過了,這裏再次提及,是為了特別說明這一做法保證了在常量池中的每個String對象都是唯一的,也就達到了節約內存的目的。

構造函數(String())的創建方式

使用構造函數的方式創建字符串時,JVM同樣會在字符串常量池中先檢查是否存在該字面量,只是檢查后的情況會和使用字面量創建的方式有所不同。如果存在,則會在堆中另外創建一個String對象,然後在這個String對象的內部引用該字面量,最後返回該String對象在內存地址中的引用;如果不存在,則會先在字符串常量池中創建該字面量,然後再在堆中創建一個String對象,然後再在這個String對象的內部引用該字面量,最後返回該String對象的引用。

String str = new String("i like yanggb.");

這就意味着,只要使用這種方式,構造函數都會另行在堆內存中開闢空間,創建一個新的String對象。具體的理解是,在字符串常量池中不存在對應的字面量的情況下,new String()會創建兩個對象,一個放入常量池中(字面量),一個放入堆內存中(字符串對象)。

String對象的比較

比較兩個String對象是否相等,通常是有【==】和【equals()】兩個方法。

在基本數據類型中,只可以使用【==】,也就是比較他們的值是否相同;而對於對象(包括String)來說,【==】比較的是地址是否相同,【equals()】才是比較他們內容是否相同;而equals()是Object都擁有的一個函數,本身就要求對內部值進行比較。

String str = "i like yanggb.";
String str1 = new String("i like yanggb.");

System.out.println(str == str1); // false
System.out.println(str.equals(str1)); // true

因為使用字面量方式創建的String對象和使用構造函數方式創建的String對象的內存地址是不同的,但是其中的內容卻是相同的,也就導致了上面的結果。

String對象中的intern()方法

我們都知道,String對象中有很多實用的方法。為什麼其他的方法都不說,這裏要特別說明這個intern()方法呢,因為其中的這個intern()方法最為特殊。它的特殊性在於,這個方法在業務場景中幾乎用不上,它的存在就是在為難程序員的,也可以說是為了幫助程序員了解JVM的內存結構而存在的(?我信你個鬼,你個糟老頭子壞得很)。

/**
* When the intern method is invoked, if the pool already contains a
* string equal to this {@code String} object as determined by
* the {@link #equals(Object)} method, then the string from the pool is
* returned. Otherwise, this {@code String} object is added to the
* pool and a reference to this {@code String} object is returned.
**/
public native String intern();

上面是源碼中的intern()方法的官方註釋說明,大概意思就是intern()方法用來返回常量池中的某字符串,如果常量池中已經存在該字符串,則直接返回常量池中該對象的引用。否則,在常量池中加入該對象,然後返回引用。然後我們可以從方法簽名上看出intern()方法是一個native方法。

下面通過幾個例子來詳細了解下intern()方法的用法。

第一個例子

String str1 = new String("1");
System.out.println(str1 == str1.intern()); // false
System.out.println(str1 == "1"); // false

在上面的例子中,intern()方法返回的是常量池中的引用,而str1保存的是堆中對象的引用,因此兩個打印語句的結果都是false。

第二個例子

String str2 = new String("2") + new String("3");
System.out.println(str2 == str2.intern()); // true
System.out.println(str2 == "23"); // true

在上面的例子中,str2保存的是堆中一個String對象的引用,這和JVM對【+】的優化有關。實際上,在給str2賦值的第一條語句中,創建了3個對象,分別是在字符串常量池中創建的2和3、還有在堆中創建的字符串對象23。因為字符串常量池中不存在字符串對象23,所以這裏要特別注意:intern()方法在將堆中存在的字符串對象加入常量池的時候採取了一種截然不同的處理方案——不是在常量池中建立字面量,而是直接將該String對象自身的引用複製到常量池中,即常量池中保存的是堆中已存在的字符串對象的引用。根據前面的說法,這時候調用intern()方法,就會在字符串常量池中複製出一個對堆中已存在的字符串常量的引用,然後返回對字符串常量池中這個對堆中已存在的字符串常量池的引用的引用(就是那麼繞,你來咬我呀)。這樣,在調用intern()方法結束之後,返回結果的就是對堆中該String對象的引用,這時候使用【==】去比較,返回的結果就是true了。同樣的,常量池中的字面量23也不是真正意義的字面量23了,它真正的身份是堆中的那個String對象23。這樣的話,使用【==】去比較字面量23和str2,結果也就是true了。

第三個例子

String str4 = "45";
String str3 = new String("4") + new String("5");
System.out.println(str3 == str3.intern()); // false
System.out.println(str3 == "45"); // false

這個例子乍然看起來好像比前面的例子還要複雜,實際上卻和上面的第一個例子是一樣的,最難理解的反而是第二個例子。

所以這裏就不多說了,而至於為什麼還要舉這個例子,我相信聰明的你一下子就明白了(我有醫保,你來打我呀)。

String對象的不可變性

先來看String對象的一段源碼。

public final class String
    implements java.io.Serializable, Comparable<String>, CharSequence {
    /** The value is used for character storage. */
    private final char value[];

    /** Cache the hash code for the string */
    private int hash; // Default to 0

    /** use serialVersionUID from JDK 1.0.2 for interoperability */
    private static final long serialVersionUID = -6849794470754667710L;
}

從類簽名上來看,String類用了final修飾符,這就意味着這個類是不能被繼承的,這是決定String對象不可變特性的第一點。從類中的數組char[] value來看,這個類成員變量被private和final修飾符修飾,這就意味着其數值一旦被初始化之後就不能再被更改了,這是決定String對象不可變特性的第二點。

Java開發者為什麼要將String對象設置為不可變的,主要可以從以下三個方面去考慮:

1.安全性。假設String對象是可變的,那麼String對象將可能被惡意修改。

2.唯一性。這個做法可以保證hash屬性值不會頻繁變更,也就確保了唯一性,使得類似HashMap的容器才能實現相應的key-value緩存功能。

3.功能性。可以實現字符串常量池(究竟是先有設計,還是先有實現呢)。

String對象的優化

字符串是常用的Java類型之一,所以對字符串的操作是避免不了的。而在對字符串的操作過程中,如果使用不當的話,性能可能會有天差地別,所以有一些地方是要注意一下的。

拼接字符串的性能優化

字符串的拼接是對字符串的操作中最頻繁的一個使用。由於我們都知道了String對象的不可變性,所以我們在開發過程中要盡量減少使用【+】進行字符串拼接操作。這是因為使用【+】進行字符串拼接,會在得到最終想要的結果前產生很多無用的對象。

String str = 'i';
str = str + ' ';
str = str + 'like';
str = str + ' ';
str = str + 'yanggb';
str = str + '.';

System.out.println(str); // i like yanggb.

事實上,如果我們使用的是比較智能的IDE編寫代碼的話,編譯器是會提示將代碼優化成使用StringBuilder或者StringBuffer對象來優化字符串的拼接性能的,因為StringBuilder和StringBuffer都是可變對象,也就避免了過程中產生無用的對象了。而這兩種替代方案的區別是,在需要線程安全的情況下,選用StringBuffer對象,這個對象是支持線程安全的;而在不需要線程安全的情況下,選用StringBuilder對象,因為StringBuilder對象的性能在這種場景下,要比StringBuffer對象或String對象要好得多。

使用intern()方法優化內存佔用

前面吐槽了intern()方法在實際開發中沒什麼用,這裏又來說使用intern()方法來優化內存佔用了,這人真的是,嘿嘿,真香。關於方法的使用就不說了,上面有詳盡的用法說明,這裏來說說具體的應用場景好了。有一位Twitter的工程師在Qcon全球軟件開發大會上分享了一個他們對String對象優化的案例,他們利用了這個String.intern()方法將以前需要20G內存存儲優化到只需要幾百兆內存。具體就是,使用intern()方法將原本需要創建到堆內存中的String對象都放到常量池中,因為常量池的不重複特性(存在則返回引用),也就避免了大量的重複String對象造成的內存浪費問題。

什麼,要我給intern()方法道歉?不可能。String.intern()方法雖好,但是也是需要結合場景來使用的,並不能夠亂用。因為實際上,常量池的實現是類似於一個HashTable的實現方式,而HashTable存儲的數據越大,遍歷的時間複雜度就會增加。這就意味着,如果數據過大的話,整個字符串常量池的負擔就會大大增加,有可能性能不會得到提升卻反而有所下降。

字符串分割的性能優化

字符串的分割是字符串操作的常用操作之一,對於字符串的分割,大部分人使用的都是split()方法,split()方法在大部分場景下接收的參數都是正則表達式,這種分割方式本身沒有什麼問題,但是由於正則表達式的性能是非常不穩定的,使用不恰當的話可能會引起回溯問題並導致CPU的佔用居高不下。在以下兩種情況下split()方法不會使用正則表達式:

1.傳入的參數長度為1,且不包含“.$|()[{^?*+\”regex元字符的情況下,不會使用正則表達式。

2.傳入的參數長度為2,第一個字符是反斜杠,並且第二個字符不是ASCII数字或ASCII字母的情況下,不會使用正則表達式。

所以我們在字符串分割時,應該慎重使用split()方法,而首先考慮使用String.indexOf()方法來進行字符串分割,在String.indexOf()無法滿足分割要求的時候再使用Split()方法。而在使用split()方法分割字符串時,需要格外注意回溯問題。

總結

雖然說在不了解String對象的情況下也能使用String對象進行開發,但是了解String對象可以幫助我們寫出更好的代碼。


“只希望在故事的最後,我還是我,你也還是你。”

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

動手造輪子:實現簡單的 EventQueue

動手造輪子:實現簡單的 EventQueue

Intro

最近項目里有遇到一些併發的問題,想實現一個隊列來將併發的請求一個一個串行處理,可以理解為使用消息隊列處理併發問題,之前實現過一個簡單的 EventBus,於是想在 EventBus 的基礎上改造一下,加一個隊列,改造成類似消息隊列的處理模式。消息的處理(Consumer)直接使用 .netcore 里的 IHostedService 來實現了一個簡單的後台任務處理。

初步設計

  • Event 抽象的事件
  • EventHandler 處理 Event 的方法
  • EventStore 保存訂閱 Event 的 EventHandler
  • EventQueue 保存 Event 的隊列
  • EventPublisher 發布 Event
  • EventConsumer 處理 Event 隊列里的 Event
  • EventSubscriptionManager 管理訂閱 Event 的 EventHandler

實現代碼

EventBase 定義了基本事件信息,事件發生時間以及事件的id:

public abstract class EventBase
{
    [JsonProperty]
    public DateTimeOffset EventAt { get; private set; }

    [JsonProperty]
    public string EventId { get; private set; }

    protected EventBase()
    {
      this.EventId = GuidIdGenerator.Instance.NewId();
      this.EventAt = DateTimeOffset.UtcNow;
    }

    [JsonConstructor]
    public EventBase(string eventId, DateTimeOffset eventAt)
    {
      this.EventId = eventId;
      this.EventAt = eventAt;
    }
}

EventHandler 定義:

public interface IEventHandler
{
    Task Handle(IEventBase @event);
}

public interface IEventHandler<in TEvent> : IEventHandler where TEvent : IEventBase
{
    Task Handle(TEvent @event);
}

public class EventHandlerBase<TEvent> : IEventHandler<TEvent> where TEvent : EventBase
{
    public virtual Task Handle(TEvent @event)
    {
        return Task.CompletedTask;
    }

    public Task Handle(IEventBase @event)
    {
        return Handle(@event as TEvent);
    }
}

EventStore:

public class EventStore
{
    private readonly Dictionary<Type, Type> _eventHandlers = new Dictionary<Type, Type>();

    public void Add<TEvent, TEventHandler>() where TEventHandler : IEventHandler<TEvent> where TEvent : EventBase
    {
        _eventHandlers.Add(typeof(TEvent), typeof(TEventHandler));
    }

    public object GetEventHandler(Type eventType, IServiceProvider serviceProvider)
    {
        if (eventType == null || !_eventHandlers.TryGetValue(eventType, out var handlerType) || handlerType == null)
        {
            return null;
        }
        return serviceProvider.GetService(handlerType);
    }

    public object GetEventHandler(EventBase eventBase, IServiceProvider serviceProvider) =>
        GetEventHandler(eventBase.GetType(), serviceProvider);

    public object GetEventHandler<TEvent>(IServiceProvider serviceProvider) where TEvent : EventBase =>
        GetEventHandler(typeof(TEvent), serviceProvider);
}

EventQueue 定義:

public class EventQueue
{
    private readonly ConcurrentDictionary<string, ConcurrentQueue<EventBase>> _eventQueues =
        new ConcurrentDictionary<string, ConcurrentQueue<EventBase>>();

    public ICollection<string> Queues => _eventQueues.Keys;

    public void Enqueue<TEvent>(string queueName, TEvent @event) where TEvent : EventBase
    {
        var queue = _eventQueues.GetOrAdd(queueName, q => new ConcurrentQueue<EventBase>());
        queue.Enqueue(@event);
    }

    public bool TryDequeue(string queueName, out EventBase @event)
    {
        var queue = _eventQueues.GetOrAdd(queueName, q => new ConcurrentQueue<EventBase>());
        return queue.TryDequeue(out @event);
    }

    public bool TryRemoveQueue(string queueName)
    {
        return _eventQueues.TryRemove(queueName, out _);
    }

    public bool ContainsQueue(string queueName) => _eventQueues.ContainsKey(queueName);

    public ConcurrentQueue<EventBase> this[string queueName] => _eventQueues[queueName];
}

EventPublisher:

public interface IEventPublisher
{
    Task Publish<TEvent>(string queueName, TEvent @event)
        where TEvent : EventBase;
}
public class EventPublisher : IEventPublisher
{
    private readonly EventQueue _eventQueue;

    public EventPublisher(EventQueue eventQueue)
    {
        _eventQueue = eventQueue;
    }

    public Task Publish<TEvent>(string queueName, TEvent @event)
        where TEvent : EventBase
    {
        _eventQueue.Enqueue(queueName, @event);
        return Task.CompletedTask;
    }
}

EventSubscriptionManager:

public interface IEventSubscriptionManager
{
    void Subscribe<TEvent, TEventHandler>()
        where TEvent : EventBase
        where TEventHandler : IEventHandler<TEvent>;
}

public class EventSubscriptionManager : IEventSubscriptionManager
{
    private readonly EventStore _eventStore;

    public EventSubscriptionManager(EventStore eventStore)
    {
        _eventStore = eventStore;
    }

    public void Subscribe<TEvent, TEventHandler>()
        where TEvent : EventBase
        where TEventHandler : IEventHandler<TEvent>
    {
        _eventStore.Add<TEvent, TEventHandler>();
    }
}

EventConsumer:

public class EventConsumer : BackgroundService
{
    private readonly EventQueue _eventQueue;
    private readonly EventStore _eventStore;
    private readonly int maxSemaphoreCount = 256;
    private readonly IServiceProvider _serviceProvider;
    private readonly ILogger _logger;

    public EventConsumer(EventQueue eventQueue, EventStore eventStore, IConfiguration configuration, ILogger<EventConsumer> logger, IServiceProvider serviceProvider)
    {
        _eventQueue = eventQueue;
        _eventStore = eventStore;
        _logger = logger;
        _serviceProvider = serviceProvider;
    }

    protected override async Task ExecuteAsync(CancellationToken stoppingToken)
    {
        using (var semaphore = new SemaphoreSlim(Environment.ProcessorCount, maxSemaphoreCount))
        {
            while (!stoppingToken.IsCancellationRequested)
            {
                var queues = _eventQueue.Queues;
                if (queues.Count > 0)
                {
                    await Task.WhenAll(
                    queues
                        .Select(async queueName =>
                        {
                            if (!_eventQueue.ContainsQueue(queueName))
                            {
                                return;
                            }
                            try
                            {
                                await semaphore.WaitAsync(stoppingToken);
                                //
                                if (_eventQueue.TryDequeue(queueName, out var @event))
                                {
                                    var eventHandler = _eventStore.GetEventHandler(@event, _serviceProvider);
                                    if (eventHandler is IEventHandler handler)
                                    {
                                        _logger.LogInformation(
                                            "handler {handlerType} begin to handle event {eventType}, eventId: {eventId}, eventInfo: {eventInfo}",
                                            eventHandler.GetType().FullName, @event.GetType().FullName,
                                            @event.EventId, JsonConvert.SerializeObject(@event));

                                        try
                                        {
                                            await handler.Handle(@event);
                                        }
                                        catch (Exception e)
                                        {
                                            _logger.LogError(e, "event  {eventId}  handled exception", @event.EventId);
                                        }
                                        finally
                                        {
                                            _logger.LogInformation("event {eventId} handled", @event.EventId);
                                        }
                                    }
                                    else
                                    {
                                        _logger.LogWarning(
                                            "no event handler registered for event {eventType}, eventId: {eventId}, eventInfo: {eventInfo}",
                                            @event.GetType().FullName, @event.EventId,
                                            JsonConvert.SerializeObject(@event));
                                    }
                                }
                            }
                            catch (Exception ex)
                            {
                                _logger.LogError(ex, "error running EventConsumer");
                            }
                            finally
                            {
                                semaphore.Release();
                            }
                        })
                );
                }

                await Task.Delay(50, stoppingToken);
            }
        }
    }
}

為了方便使用定義了一個 Event 擴展方法:

public static IServiceCollection AddEvent(this IServiceCollection services)
{
    services.TryAddSingleton<EventStore>();
    services.TryAddSingleton<EventQueue>();
    services.TryAddSingleton<IEventPublisher, EventPublisher>();
    services.TryAddSingleton<IEventSubscriptionManager, EventSubscriptionManager>();

    services.AddSingleton<IHostedService, EventConsumer>();
    return services;
}

使用示例

定義 PageViewEvent 記錄請求信息:

public class PageViewEvent : EventBase
{
    public string Path { get; set; }
}

這裏作為示例只記錄了請求的Path信息,實際使用可以增加更多需要記錄的信息

定義 PageViewEventHandler,處理 PageViewEvent

public class PageViewEventHandler : EventHandlerBase<PageViewEvent>
{
    private readonly ILogger _logger;

    public PageViewEventHandler(ILogger<PageViewEventHandler> logger)
    {
        _logger = logger;
    }

    public override Task Handle(PageViewEvent @event)
    {
        _logger.LogInformation($"handle pageViewEvent: {JsonConvert.SerializeObject(@event)}");
        return Task.CompletedTask;
    }
}

這個 handler 里什麼都沒做只是輸出一個日誌

這個示例項目定義了一個記錄請求路徑的事件以及一個發布請求記錄事件的中間件

// 發布 Event 的中間件
app.Use(async (context, next) =>
{
    var eventPublisher = context.RequestServices.GetRequiredService<IEventPublisher>();
    await eventPublisher.Publish("pageView", new PageViewEvent() { Path = context.Request.Path.Value });
    await next();
});

Startup 配置:

public void ConfigureServices(IServiceCollection services)
{
    // ...
    services.AddEvent();
    services.AddSingleton<PageViewEventHandler>();// 註冊 Handler
}

// This method gets called by the runtime. Use this method to configure the HTTP request pipeline.
public void Configure(IApplicationBuilder app, IHostingEnvironment env, IEventSubscriptionManager eventSubscriptionManager)
{
    eventSubscriptionManager.Subscribe<PageViewEvent, PageViewEventHandler>();
    app.Use(async (context, next) =>
    {
        var eventPublisher = context.RequestServices.GetRequiredService<IEventPublisher>();
        await eventPublisher.Publish("pageView", new PageViewEvent() { Path = context.Request.Path.Value });
        await next();
    });
    // ...
}

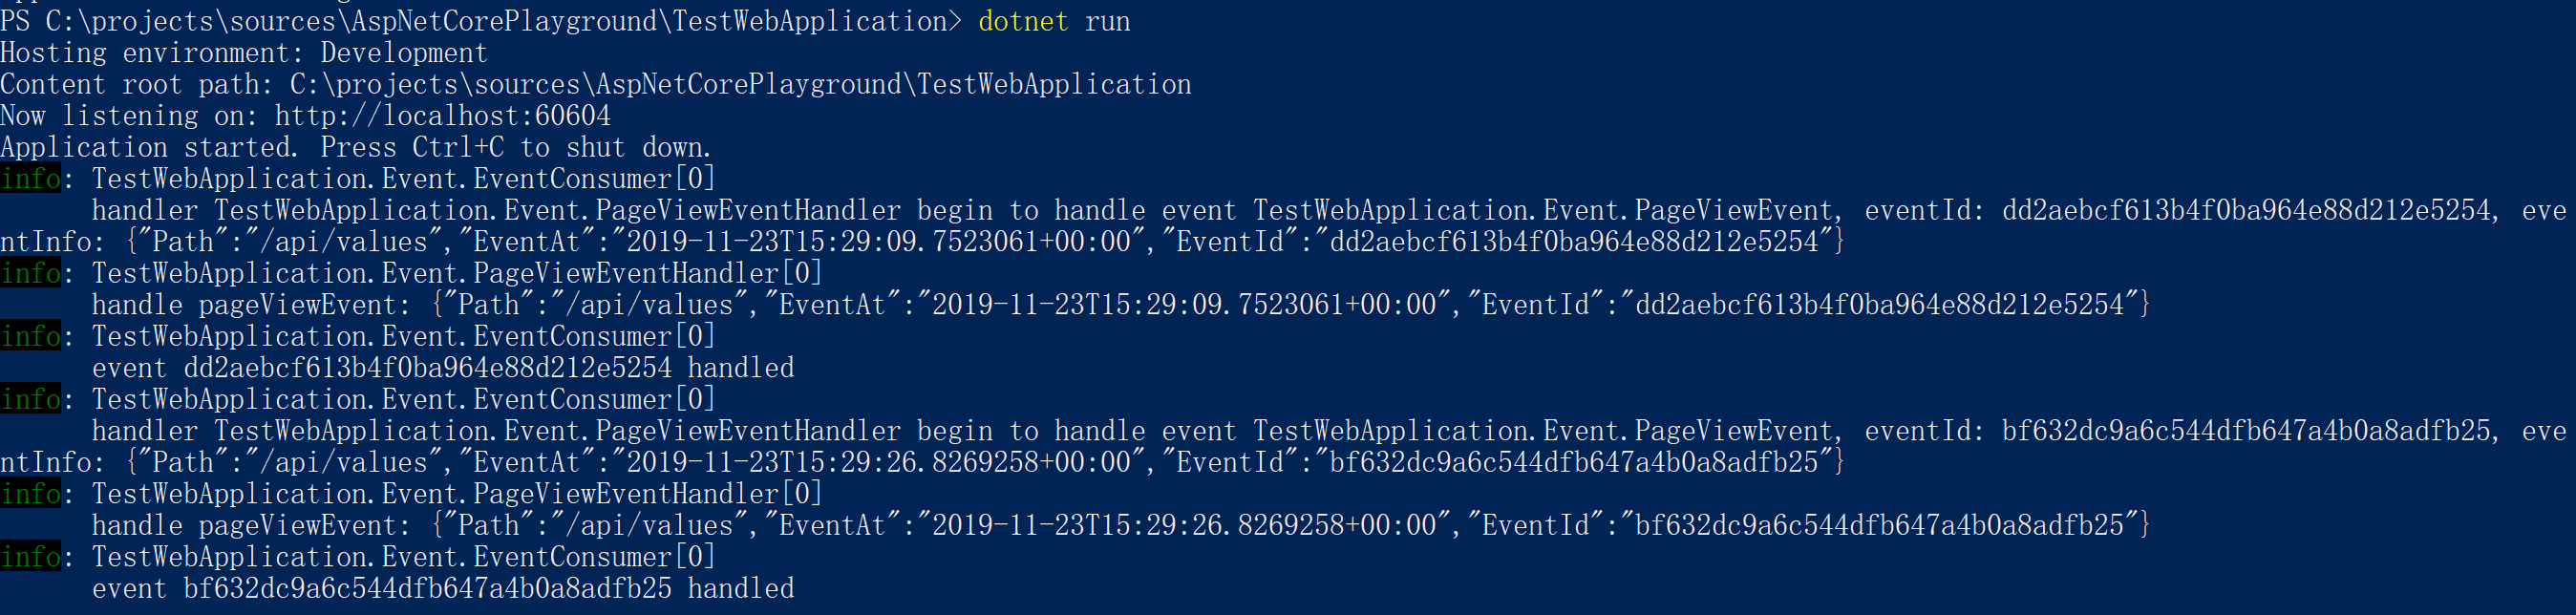
使用效果:

More

注:只是一個初步設計,基本可以實現功能,還是有些不足,實際應用的話還有一些要考慮的事情

  1. Consumer 消息邏輯,現在的實現有些問題,我們的應用場景目前比較簡單還可以滿足,如果事件比較多就會而且每個事件可能處理需要的時間長短不一樣,會導致在一個批次中執行的 Event 中已經完成的事件要等待其他還沒完成的事件完成之後才能繼續取下一個事件,理想的消費模式應該是各個隊列相互獨立,在同一個隊列中保持順序消費即可
  2. 上面示例的 EventStore 的實現只是簡單的實現了一個事件一個 Handler 的處理情況,實際業務場景中很可能會有一個事件需要多個 Handler 的情況
  3. 這個實現是基於內存的,如果要在分佈式場景下使用就不適用了,需要自己實現一下基於redis或者數據庫的以滿足分佈式的需求
  4. and more…

上面所有的代碼可以在 Github 上獲取,示例項目 Github 地址:

Reference

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整
Freemarker + xml 實現Java導出word

前言

最近做了一個調查問卷導出的功能,需求是將維護的題目,答案,導出成word,參考了幾種方案之後,選擇功能強大的freemarker+固定格式之後的wordxml實現導出功能。導出word的代碼是可以直接復用的,於是在此貼出,並進行總結,方便大家拿走。

實現過程概覽

先在word上,調整好自己想要的樣子。然後存為xml文件。保存為freemarker模板,以ftl後綴結尾。將需要替換的變量使用freemarker的語法進行替換。最終將數據準備好,和模板進行渲染,生成文件並返回給瀏覽器流。

詳細的實現過程

準備好word的樣式

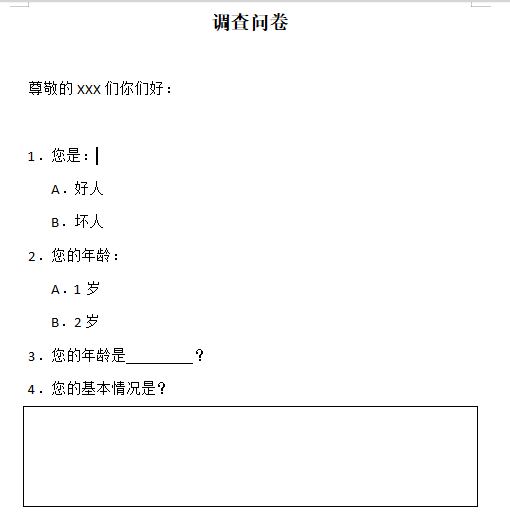
我們新建一個word,我們應該使用Microsoft office,如果使用wps可能會造成樣式有些不兼容。在新建的office中,設置好我們的表格樣式。我們的調查問卷涉及到四種類型,單選,多選,填空,簡答。我們做出四種類型的示例。

樣式沒有問題后,我們選擇另存為word xml 2003版本。將會生成一個xml文件。

格式化xml,並用freemarker語法替換xml

我們可以先下載一個工具 firstobject xml editor,這個可以幫助我們查看xml,同時方便我們定位我們需要改的位置。
複製過去之後,按f8可以將其進行格式化,左側是標籤,右側是內容,我們只需要關注w:body即可。

像右側的調查問卷這個就是個標題,我們實際渲染的時候應該將其進行替換,比如我們的程序數據map中,有title屬性,我們想要這裏展示,我們就使用語法${title}即可。

freemarker的具體語法,可以參考freemarker的問題,在這裏我給出幾個簡單的例子。
比如我們將所有的數據放置在dataList中,所以我們需要判斷,dataList是不是空,是空,我們不應該進行下面的邏輯,不是空,我們應該先循環題目是必須的,答案是需要根據類型進行再次循環的。語法參考文檔,這裏不再贅述。

程序端引入freemarker

<dependency>
    <groupId>org.freemarker</groupId>
    <artifactId>freemarker</artifactId>
</dependency>

將我們的flt文件放在resources下的templates下。

後端代碼實現

此代碼可以復用,在此貼出

public class WordUtils {

    private static Configuration configuration = null;
    private static final String templateFolder = WordUtils.class.getClassLoader().getResource("").getPath()+"/templates/word";
    static {
        configuration = new Configuration();
        configuration.setDefaultEncoding("utf-8");
        try {
            configuration.setDirectoryForTemplateLoading(new File(templateFolder));
        } catch (IOException e) {
            e.printStackTrace();
        }
    }

    /**
     *  @Description:導出word,傳入request,response,map就是值,title是導出問卷名,ftl是你要使用的模板名
     */
    public static void exportWord(HttpServletRequest request, HttpServletResponse response, Map map, String title, String ftlFile) throws Exception {
        Template freemarkerTemplate = configuration.getTemplate(ftlFile);
        File file = null;
        InputStream fin = null;
        ServletOutputStream out = null;
        try {
            file = createDocFile(map,freemarkerTemplate);
            fin = new FileInputStream(file);
            String fileName = title + ".doc";
            response.setCharacterEncoding("utf-8");
            response.setContentType("application/msword");
            response.setHeader("Content-Disposition", "attachment;filename="
             +fileName);
            out = response.getOutputStream();
            byte[] buffer = new byte[512];  
            int bytesToRead = -1;
            while((bytesToRead = fin.read(buffer)) != -1) {
                out.write(buffer, 0, bytesToRead);
            }
        }finally {
            if(fin != null) fin.close();
            if(out != null) out.close();
            if(file != null) file.delete(); 
        }
    }

    /**
     *  @Description:創建doc文件
     */
    private static File createDocFile(Map<?, ?> dataMap, Template template) {
        File file = new File("init.doc");
        try {
            Writer writer = new OutputStreamWriter(new FileOutputStream(file), "utf-8");
            template.process(dataMap, writer);
            writer.close();
        } catch (Exception e) {
            e.printStackTrace();
        }
        return file;
    }

}

有了工具類后,我們準備好我們的map數據。map裏面的數據大家可以自行定義。然後調用utils中的導出方法即可。

WordUtils.exportWord(request, response, dataMap, "word", "demo.ftl");

結語

至此已經結束了,十分的好用,有疑問的話,可以評論交流。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

推薦算法之用矩陣分解做協調過濾——LFM模型

隱語義模型(Latent factor model,以下簡稱LFM),是基於矩陣分解的推薦算法,在其基本算法上引入L2正則的FunkSVD算法在推薦系統領域更是廣泛使用,在Spark上也有其實現。本文將對 LFM原理進行詳細闡述,給出其基本算法原理。此外,還將介紹使得隱語義模型聲名大噪的算法FunkSVD和在其基礎上改進較為成功的BiasSVD。最後,對LFM進行一個較為全面的總結。

1. 矩陣分解應用於推薦算法要解決的問題

在推薦系統中,我們經常可能面臨的場景是:現有大量用戶和物品,以及少部分用戶對少部分物品的評分,我們需要使用現有的用戶對少部分物品的評分去推測用戶對物品集中其他物品的可能的評分,從而將預測中評分高的物品推薦給用戶。例如下面的用戶物品評分表:

用戶\物品 物品 1 物品 2 物品 3 物品 4 物品 5
用戶 1 3 2
用戶 2 1 2 6
用戶 3 3 4 6
用戶 4 1 2 5
用戶 5 4 2 3

對於每個用戶,我們希望較準確的預測出其對未評分物品的評分。將m個用戶和n個物品的評分看做一個矩陣M,從而將矩陣分解應用到該場景,即可解決這一問題。而本文,將關注於矩陣分解用於到推薦的方法之一,即LFM算法的解決方案。

2. LFM

LFM算法的核心思想是通過隱含特徵(Latent factor)聯繫用戶和物品,該算法最早在文本挖掘領域中被提出用於找到文本的隱含語義,相關名詞還有LDA和Topic Model等。

2.1 如何表示用戶的偏好和物品(item)屬性?

在被問到這個問題時,針對MovieLens(電影評分)數據集,你可能會說用戶是否喜歡動作片,物品所屬電影類型去回答。但用戶對其他類型的電影的偏好程度呢?物品在其它類型所佔的權重又是多少呢?就算針對現有的電影類型去表徵用戶偏好和物品,那麼能否能夠完全的表示出用戶的偏好和物品屬性呢?答案是不能,比如用戶喜歡看成龍的電影這個偏好沒法表示出來,電影由誰導演,主演是誰沒法表示。但你要問我用哪些屬性去表徵呢?這個誰也無法給出一個很好的答案,粒度很難控制。

2.2 LFM來救場

隱語義模型較好的解決了該問題,它從數據出發,通過基於用戶行為統計的自動聚類,可指定出表徵用戶偏好和物品的向量維度,最終得到用戶的偏好向量以及物品的表徵向量。LFM通過以下公式計算用戶u對物品i的偏好:
\[ preference(u, i)=p^T_u q_i=\sum_f^F{p_{u,k}q_{i,k}} \]
這個公式,\(p_{u,k}\)度量了用戶u的偏好和第f個隱類的關係,\(q_{i,k}\)度量了物品i和第f個隱類的關係。

那麼現在,我們期望用戶的評分矩陣M這樣分解:
\[ M_{m*n}=P^T_{m*k}Q_{k*n} \]
那麼,我們如何將矩陣分解呢?這裏採用了線性回歸的思想,即盡可能的讓用戶的評分和我們預測的評分的殘差盡可能小,也就是說,可以用均方差作為損失函數來尋找最終的P和Q。考慮所有的用戶和樣本的組合,我們期望的最小化損失函數為:
\[ \sum_{i,j}{(m_{ij}-p_i^Tq_j)^2} \]
只要我們能夠最小化上面的式子,並求出極值所對應的\(p_i\) 和\(q_j\),則我們最終可以得到矩陣P和Q,那麼對於任意矩陣M任意一個空白評分的位置,我們就可以通過\(p^T_i q_j\)計算預測評分。

2.3 FunkSVD用於推薦

上面是隱語義模型LFM的基本原理,但在實際業務中,為防止過擬合,我們常常會加入一個L2的正則化項,這也就誕生了我們的FunkSVD算法。其優化目標函數\(J(p,q)\)定義為:
\[ \underbrace{argmin}_{p_i,q_j}\sum_{i,j}{(m_{ij}-p^T_iq_j)^2+\lambda({\Arrowvert{p_i}\Arrowvert}^2_2+{\Arrowvert{q_i}\Arrowvert}^2_2)} \]
其中λ為正則化係數,需要調參。對於這個優化問題,我們一般通過梯度下降法來進行優化得到結果。

將上式分別對\(p_i\)和\(q_j\)求導我們得到:
\[ \frac{\partial{J}}{\partial{p_i}}=-2(m_{ij}-p^T_iq_j)q_j+2\lambda{p_i} \]

\[ \frac{\partial{J}}{\partial{q_j}}=-2(m_{ij}-p^T_iq_j)p_i+2\lambda{q_j} \]

則梯度下降中迭代公式為:
\[ p_i = p_i +\alpha((m_{ij}-p^T_iq_j)q_j-\lambda{p_i}) \]

\[ q_j = q_j+\alpha((m_{ij}-p^T_iq_j)p_i-\lambda{q_j}) \]

通過迭代我們最終可以得到P和Q,進而用於推薦。

為讀者進一步理解,筆者實現了基於MovieLens數據集實現了該方法。代碼詳見github:

2.4 BiasSVD用於推薦

BiasSVD是FunkSVD較為成功的改進版算法。BiasSVD假設評分系統包括三部分的偏置因素:一些和用戶物品無關的評分因素。用戶有一些和物品無關的評分因素,稱為用戶偏置項。而物品也有一些和用戶無關的評分因素,稱為物品偏置項。這很好理解,對於樂觀的用戶來說,它的評分行為普遍偏高,而對批判性用戶來說,他的評分記錄普遍偏低,即使他們對同一物品的評分相同,但是他們對該物品的喜好程度卻並不一樣。同理,對物品來說,以電影為例,受大眾歡迎的電影得到的評分普遍偏高,而一些爛片的評分普遍偏低,這些因素都是獨立於用戶或產品的因素,而和用戶對產品的的喜好無關。

假設評分系統平均分為μ,第i個用戶的用戶偏置項為\(b_i\),而第j個物品的物品偏置項為\(b_j\),則加入了偏置項以後的優化目標函數\(J(p_i,q_j)\)是這樣的:
\[ \underbrace{argmin}_{p_i,q_j}\sum_{i,j}{(m_{ij}-p^T_iq_j-u-b_i-b_j)^2+\lambda({\Arrowvert{p_i}\Arrowvert}^2_2+{\Arrowvert{q_i}\Arrowvert}^2_2+{\Arrowvert{b_i}\Arrowvert}^2_2+{\Arrowvert{b_j}\Arrowvert}^2_2)} \]
這個優化目標也可以採用梯度下降法求解。和FunkSVD不同的是,此時我們多了兩個偏執項\(b_i\)和 \(b_j\),\(p_i\)和\(q_j\)的迭代公式和FunkSVD類似,只是每一步的梯度導數稍有不同而已。\(b_i\)和 \(b_j\)一般可以初始設置為0,然後參与迭代。迭代公式為:
\[ p_i = p_i +\alpha((m_{ij}-p^T_iq_j-u-b_i-b_j)q_j-\lambda{p_i}) \]

\[ q_j = q_j+\alpha((m_{ij}-p^T_iq_j-u-b_i-b_j)p_i-\lambda{q_j}) \]

\[ b_i=b_i+\alpha(m_{ij}-p^T_iq_j-u-b_i-b_j-\lambda{b_i}) \]

\[ b_j=b_j+\alpha(m_{ij}-p^T_iq_j-u-b_i-b_j-\lambda{b_j}) \]

通過迭代我們最終可以得到P和Q,進而用於推薦。BiasSVD增加了一些額外因素的考慮,因此在某些場景會比FunkSVD表現好。

為讀者進一步理解,筆者實現了基於MovieLens數據集實現了該方法。代碼詳見github:

小結

LFM 是一種基於機器學習的方法,具有比較好的理論基礎,通過優化一個設定的指標建立最優的模型。它實質上是矩陣分解應用到推薦的方法,其中FunkSVD更是將矩陣分解用於推薦方法推到了新的高度,在實際應用中使用非常廣泛。當然矩陣分解方法也在不停的進步,目前矩陣分解推薦算法中分解機方法(factorization machine, FM)已成為一個趨勢。

對於矩陣分解用於推薦方法本身來說,它容易編程實現,實現複雜度低,預測效果也好,同時還能保持擴展性。這些都是其寶貴的優點。但是LFM 無法給出很好的推薦解釋,它計算出的隱類雖然在語義上確實代表了一類興趣和物品,卻很難用自然語言描述並生成解釋展現給用戶。

LFM 在建模過程中,假設有 M 個用戶、 N 個物品、 K 條用戶對物品的行為記錄,如果是 F 個隱類,那麼它離線計算的空間複雜度是 \(O(F*(M+N))\) ,迭代 S次則時間複雜度為 \(O(K * F * S)\)。當 M(用戶數量)和 N(物品數量)很大時LFM相對於ItemCF和UserCF可以很好地節省離線計算的內存,在時間複雜度由於LFM會多次迭代上所以和ItemCF、UserCF沒有質的差別。

同時,遺憾的是,LFM 無法進行在線實時推薦,即當用戶有了新的行為後,他的推薦列表不會發生變化。而從 LFM的預測公式可以看到, LFM 在給用戶生成推薦列表時,需要計算用戶對所有物品的興趣權重,然後排名,返回權重最大的 N 個物品。那麼,在物品數很多時,這一過程的時間複雜度非常高,可達 \(O(M*N*F)\) 。因此, LFM 不太適合用於物品數非常龐大的系統,如果要用,我們也需要一個比較快的算法給用戶先計算一個比較小的候選列表,然後再用LFM重新排名。另一方面,LFM 在生成一個用戶推薦列表時速度太慢,因此不能在線實時計算,而需要離線將所有用戶的推薦結果事先計算好存儲在數據庫中。

參考:

  • 推薦系統實戰—項亮

(歡迎轉載,轉載請註明出處。歡迎溝通交流: losstie@outlook.com)

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

AutoCad 二次開發 文字鏡像

AutoCad 二次開發 文字鏡像

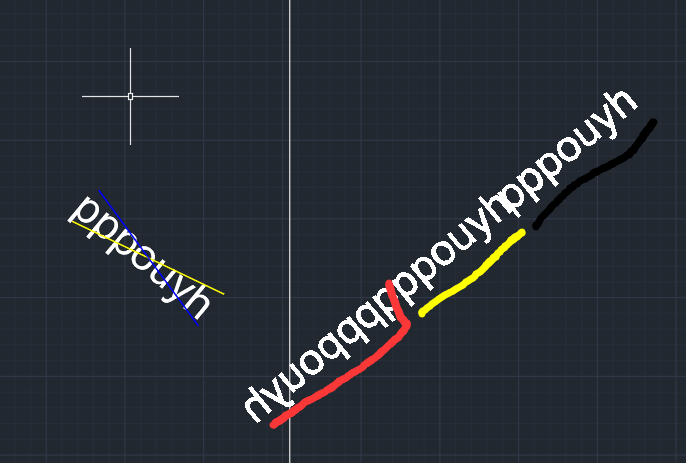
參考: 在autocad中如果使用Mirror命令把塊參照給鏡像了(最終得到一個對稱的塊),塊裏面的文字包括DBText和MText以及標註上面的文字都會被對稱,變得不易閱讀。而在單個字體實體和標註實體鏡像的時候只要設置系統變量mirrtext為0鏡像后的文字就不會與原文字對稱變成我們未學習過的文字了。   所以我們在鏡像塊的時候就可以先把塊炸開是用快捷鍵X,或者輸入explode,然後在使用鏡像命令。之後在把對稱后的實體集合組成一個新的塊。不過這樣操作十分的繁瑣,我覺得其中這樣做的優勢是mirror時的jig操作可以很方便的預先知道我們想要的對稱后的結果。但如果用代碼實現這種jig操作,我覺得有點複雜,目前我還不知道怎麼實現。   我要講的主要就是用代碼來實現塊的鏡像。難點就在與文字的鏡像,和標註的鏡像。這篇文章先講文字的鏡像。文字鏡像的主要步驟分為: 1.找到鏡像前文字邊界的四個角,這四個角構成了一個矩形,我們要求得這個矩形的長和寬所代表的向量。 2.判斷文字鏡像后的方向,如果是偏向朝Y軸鏡像,那麼文字鏡像后的方向是沿着X軸翻轉的,如果是偏向朝X軸鏡像,那麼文字鏡像后的方向是沿着X軸翻轉的。這裏我以沿着Y軸鏡像為例子。 3.移動鏡像后切被翻轉后的文字,這裏也是根據鏡像軸的不同,需按不同的向量來移動。   詳細情況見圖: 圖中左邊是要鏡像的文字,文字上的藍色線,和黃色線是我調試的時候加入的,黃線左端是 pt1,右端是pt2,藍線左端是pt3,右端是pt4。 中間的豎線是Y軸鏡像線,右邊就是不同情況下鏡像后的文字。其中黃色部分表示正確的鏡像結果,紅色部分表示:鏡像后延第一個步驟移動后求得的向量移動了文字的position但是沒翻轉的結果。黑色部分表示:鏡像后翻轉了文字但文字的position沒有按向量移動的結果。 下面我就來仔細分析一下代碼: 要實現第一步驟,前提是要有一段P/Invoke的代碼: 其中 引入的acdb22.dll是 autocad2018中的版本,不同版本,這個dll後面的数字不一樣。我們可以到cad安裝目錄下查找acdb幾個字,找到後面帶数字的就是了,64位的安裝目錄默認位置:C:\Program Files\Autodesk\AutoCAD 2018。這兩個函數一個是32位,一個是64位,具體用哪個後面的代碼會自動判斷。這個函數作用我覺得主要是求 這個name。   這裏用到了accore.dll,有的cad版本沒有這個dll,就用acad.exe代替就可以了。上面的acdbEntGet主要是根據entity的名字求的entity實體的Intptr,下面的函數時求的文字邊界對角點,這裏注意,我把這個兩個點用直線打印在cad空間里,發現它時在原點,沒旋轉的線,但其實文字不的position不在原點,也帶有旋轉角度。後面要求的文字邊界向量就是根據這兩個點來的。 上面求得的pt1,pt2 經過:
pt1 = pt1.TransformBy(rotMat).Add(dbText.Position.GetAsVector());
pt2 = pt2.TransformBy(rotMat).Add(dbText.Position.GetAsVector()); 這種操作就得到了第一幅圖中的黃線。 在經過這樣的操作,得到的pt3 和pt4就是第一幅圖的藍線。這其中的rotDir和linDir就是我們要求得的寬和長代表的向量了,然後在把它給鏡像了得到的mirRotDir和mirLinDir就是鏡像后的文字要移動的向量了,這裏第一步就結束了。 第二步,第三步:   大的話,就說明文字需要朝X軸翻轉,所以這裏的IsMirroredInX=true就代表需要朝X軸翻轉。 緊接着下面句,如果沒加mirLineDir這個向量,就會出現第一幅圖中的畫黑線的情況,如果不加IsMirrorInX就會出現畫紅線的情況。 到這裏就全部結束了。 下面給出所有代碼:

public class MyMirror
    {
        Document Doc = Application.DocumentManager.MdiActiveDocument;
        Editor Ed = Application.DocumentManager.MdiActiveDocument.Editor;
        Database Db = Application.DocumentManager.MdiActiveDocument.Database;

        List<Entity> list = new List<Entity>();
        List<ObjectId> listOId = new List<ObjectId>();

        [CommandMethod("testM")]

        public void MirrorTextCmd()

        {

            Document doc = Application.DocumentManager.MdiActiveDocument;

            Database db = doc.Database;

            Editor ed = doc.Editor;


            //Entity selection

            PromptEntityOptions peo = new PromptEntityOptions(

                "\nSelect a text entity:");


            peo.SetRejectMessage("\nMust be text entity...");

            peo.AddAllowedClass(typeof(DBText), true);


            PromptEntityResult perText = ed.GetEntity(peo);


            if (perText.Status != PromptStatus.OK)

                return;


            peo = new PromptEntityOptions("\nSelect a mirror line:");

            peo.SetRejectMessage("\nMust be a line entity...");

            peo.AddAllowedClass(typeof(Line), true);


            PromptEntityResult perLine = ed.GetEntity(peo);


            if (perLine.Status != PromptStatus.OK)

                return;


            using (Transaction tr = db.TransactionManager.StartTransaction())

            {

                Line line = tr.GetObject(perLine.ObjectId, OpenMode.ForRead)

                    as Line;


                Line3d mirrorLine = new Line3d(

                    line.StartPoint,

                    line.EndPoint);


                MirrorText(perText.ObjectId, mirrorLine);


                tr.Commit();

            }

        }


        void MirrorText(ObjectId oId, Line3d mirrorLine)

        {

            Database db = oId.Database;


            using (Transaction tr = db.TransactionManager.StartTransaction())

            {

                // Get text entity

                DBText dbText = tr.GetObject(oId, OpenMode.ForRead)

                    as DBText;


                // Clone original entity

                DBText mirroredTxt = dbText.Clone() as DBText;


                // Create a mirror matrix

                Matrix3d mirrorMatrix = Matrix3d.Mirroring(mirrorLine);


                // Do a geometric mirror on the cloned text

                mirroredTxt.TransformBy(mirrorMatrix);


                // Get text bounding box

                Point3d pt1, pt2, pt3, pt4;

                GetTextBoxCorners(

                    dbText,

                    out pt1,

                    out pt2,

                    out pt3,

                    out pt4);


                // Get the perpendicular direction to the original text

                Vector3d rotDir =

                    pt4.Subtract(pt1.GetAsVector()).GetAsVector();


                // Get the colinear direction to the original text

                Vector3d linDir =

                    pt3.Subtract(pt1.GetAsVector()).GetAsVector();


                // Compute mirrored directions

                Vector3d mirRotDir = rotDir.TransformBy(mirrorMatrix);

                Vector3d mirLinDir = linDir.TransformBy(mirrorMatrix);


                //Check if we need to mirror in Y or in X

                if (Math.Abs(mirrorLine.Direction.Y) >

                    Math.Abs(mirrorLine.Direction.X))

                {

                    // Handle the case where text is mirrored twice

                    // instead of doing "oMirroredTxt.IsMirroredInX = true"

                    mirroredTxt.IsMirroredInX = !mirroredTxt.IsMirroredInX;

                    mirroredTxt.Position = mirroredTxt.Position + mirLinDir;

                }

                else

                {

                    mirroredTxt.IsMirroredInY = !mirroredTxt.IsMirroredInY;

                    mirroredTxt.Position = mirroredTxt.Position + mirRotDir;

                }


                // Add mirrored text to database

                //btr.AppendEntity(mirroredTxt);

                //tr.AddNewlyCreatedDBObject(mirroredTxt, true);

                //list.Add(mirroredTxt);
                mirroredTxt.ToSpace();
                tr.Commit();

            }

        }
        #region p/Invoke


        public struct ads_name
        {

            public IntPtr a;

            public IntPtr b;

        };


        // Exported function names valid only for R19


        [DllImport("acdb22.dll",

            CallingConvention = CallingConvention.Cdecl,

            EntryPoint = "?acdbGetAdsName@@YA?AW4ErrorStatus@Acad@@AAY01JVAcDbObjectId@@@Z")]

        public static extern int acdbGetAdsName32(

            ref ads_name name,

            ObjectId objId);


        [DllImport("acdb22.dll",

            CallingConvention = CallingConvention.Cdecl,

            EntryPoint = "?acdbGetAdsName@@YA?AW4ErrorStatus@Acad@@AEAY01_JVAcDbObjectId@@@Z")]

        public static extern int acdbGetAdsName64(

            ref ads_name name,

            ObjectId objId);


        public static int acdbGetAdsName(ref ads_name name, ObjectId objId)

        {

            if (Marshal.SizeOf(IntPtr.Zero) > 4)

                return acdbGetAdsName64(ref name, objId);


            return acdbGetAdsName32(ref name, objId);

        }


        [DllImport("accore.dll",

            CharSet = CharSet.Unicode,

            CallingConvention = CallingConvention.Cdecl,

            EntryPoint = "acdbEntGet")]

        public static extern System.IntPtr acdbEntGet(

            ref ads_name ename);


        [DllImport("accore.dll",

            CharSet = CharSet.Unicode,

            CallingConvention = CallingConvention.Cdecl,

            EntryPoint = "acedTextBox")]

        public static extern System.IntPtr acedTextBox(

            IntPtr rb,

            double[] point1,

            double[] point2);


        void GetTextBoxCorners(DBText dbText, out Point3d pt1, out Point3d pt2, out Point3d pt3, out Point3d pt4)

        {

            ads_name name = new ads_name();


            int result = acdbGetAdsName(

                ref name,

                dbText.ObjectId);


            ResultBuffer rb = new ResultBuffer();


            Interop.AttachUnmanagedObject(

                rb,

                acdbEntGet(ref name), true);


            double[] point1 = new double[3];

            double[] point2 = new double[3];


            // Call imported arx function

            acedTextBox(rb.UnmanagedObject, point1, point2);


            pt1 = new Point3d(point1);

            pt2 = new Point3d(point2);

            var ptX = pt1 + Vector3d.XAxis * 40;
            var ptY = pt2 + Vector3d.YAxis * 50;


            var lX = new Line(pt1, ptX);
            var lY = new Line(pt2, ptY);

            lX.Color= Color.FromColor(System.Drawing.Color.Green);
            lY.Color= Color.FromColor(System.Drawing.Color.Orange);


            Line line = new Line(pt1, pt2);

            line.Color = Color.FromColor(System.Drawing.Color.Red);

            line.ToSpace();
            lX.ToSpace();
            lY.ToSpace();

            // Create rotation matrix

            Matrix3d rotMat = Matrix3d.Rotation(

                dbText.Rotation,

                dbText.Normal,

                pt1);


            // The returned points from acedTextBox need

            // to be transformed as follow

            pt1 = pt1.TransformBy(rotMat).Add(dbText.Position.GetAsVector());

            pt2 = pt2.TransformBy(rotMat).Add(dbText.Position.GetAsVector());

            Line linetrans = new Line(pt1, pt2);

            linetrans.Color = Color.FromColor(System.Drawing.Color.Yellow) ;

            linetrans.ToSpace();


            Vector3d rotDir = new Vector3d(

                -Math.Sin(dbText.Rotation),

                Math.Cos(dbText.Rotation), 0);


            //求垂直於rotDir和normal的法向量
            Vector3d linDir = rotDir.CrossProduct(dbText.Normal);


            double actualWidth =

                Math.Abs((pt2.GetAsVector() - pt1.GetAsVector())

                    .DotProduct(linDir));


            pt3 = pt1.Add(linDir * actualWidth);

            pt4 = pt2.Subtract(linDir * actualWidth);

            Line linetrans2 = new Line(pt3, pt4);

            linetrans2.Color = Color.FromColor(System.Drawing.Color.Blue);

            linetrans2.ToSpace();
        }

        #endregion
    }


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

Docker基礎與實戰,看這一篇就夠了

docker 基礎

什麼是Docker

Docker 使用 Google 公司推出的 Go 語言 進行開發實現,基於 Linux 內核的 cgroup,namespace,以及 AUFS 類的 Union FS 等技術,對進程進行封裝隔離,屬於 操作系統層面的虛擬化技術。由於隔離的進程獨立於宿主和其它的隔離的進程,因此也稱其為容器。

Docker 在容器的基礎上,進行了進一步的封裝,從文件系統、網絡互聯到進程隔離等等,極大的簡化了容器的創建和維護。使得 Docker 技術比虛擬機技術更為輕便、快捷。

記住最重要的一點,Dokcer實際是宿主機的一個普通的進程,這也是Dokcer與傳統虛擬化技術的最大不同。

為什麼要使用Docker

使用Docker最重要的一點就是Docker能保證運行環境的一致性,不會出現開發、測試、生產由於環境配置不一致導致的各種問題,一次配置多次運行。使用Docker,可更快地打包、測試以及部署應用程序,並可減少從編寫到部署運行代碼的周期。

docker 安裝

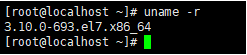
  • Docker 要求 CentOS 系統的內核版本高於 3.10 ,查看本頁面的前提條件來驗證你的CentOS 版本是否支持 Docker 。
    uname -r

  • 更新yum,升級到最新版本
    yum update

  • 卸載老版本的docker(若有)
    yum remove docker docker-common docker-selinux docker-engine
    執行該命令只會卸載Docker本身,而不會刪除Docker存儲的文件,例如鏡像、容器、卷以及網絡文件等。這些文件保存在/var/lib/docker 目錄中,需要手動刪除。

  • 查看yum倉庫,查看是否有docker
    ll /etc/yum.repos.d/

    如果用的廠商的服務器(阿里雲、騰訊雲)一般都會有docker倉庫,如果用的是虛擬機或者公司的服務器基本會沒有。

  • 安裝軟件包, yum-util 提供yum-config-manager功能,另外兩個是devicemapper驅動依賴的
    yum install -y yum-utils device-mapper-persistent-data lvm2

  • 安裝倉庫
    yum-config-manager --add-repo https://download.docker.com/linux/centos/docker-ce.repo

  • 查看docker版本
    yum list docker-ce --showduplicates | sort -r

  • 安裝docker
    yum install docker-ce
    以上語句是是安裝最新版本的Docker,你也可以通過yum install docker-ce-<VERSION> 安裝指定版本

  • 啟動docker
    systemctl start docker

  • 驗證安裝是否正確
    dokcer run hello-world

docker 重要命令

鏡像相關

  • 搜索鏡像docker search
    如docker search nginx Docker就會在Docker Hub中搜索含有“nginx”這個關鍵詞的鏡像倉庫

  • 下載鏡像docker pull
    如docker pull nginx Docker就會在Docker Hub中下載含有“nginx”最新版本的鏡像
    當然也可以使用docker pull reg.jianzh5.com/nginx:1.7.9 下載指定倉庫地址標籤的nginx鏡像

  • 列出鏡像docker images

  • 刪除鏡像docker rmi
    如docker rmi hello-world刪除我們剛剛下載的hello-world鏡像

  • 構建鏡像docker build
    通過Dockerfile構建鏡像,這個我們等下再拿出來詳細說明。

容器相關

  • 新建啟動鏡像docker run
    這個命令是我們最常用的命令,主要使用以下幾個選項
    ① -d選項:表示後台運行
    ② -P選項(大寫):隨機端口映射
    ③ -p選項(小寫):指定端口映射,前面是宿主機端口後面是容器端口,如docker run nginx -p 8080:80,將容器的80端口映射到宿主機的8080端口,然後使用localhost:8080就可以查看容器中nginx的歡迎頁了
    ④ -v選項:掛載宿主機目錄,前面是宿主機目錄,後面是容器目錄,如docker run -d -p 80:80 -v /dockerData/nginx/conf/nginx.conf:/etc/nginx/nginx.conf nginx 掛載宿主機的/dockerData/nginx/conf/nginx.conf的文件,這樣就可以在宿主機對nginx進行參數配置了,注意目錄需要用絕對路徑,不要使用相對路徑,如果宿主機目錄不存在則會自動創建。
    ⑤–rm : 停止容器後會直接刪除容器,這個參數在測試是很有用,如docker run -d -p 80:80 --rm nginx
    ⑥–name : 給容器起個名字,否則會出現一長串的自定義名稱如 docker run -name niginx -d -p 80:80 - nginx

  • 列出容器 docker ps
    這個命令可以列出當前運行的容器,使用-a參數后列出所有的容器(包括已停止的)

  • 停止容器docker stop
    docker stop 5d034c6ea010 後面跟的是容器ID,也可以使用容器名稱

  • 啟動停止的容器docker start
    docker run是新建容器並啟動,docker start 是啟動停止的容器,如docker start 5d034c6ea010

  • 重啟容器docker restart
    此命令執行的過程實際是先執行docker stop,然後再執行docker start,如docker restart 5d034c6ea010

  • 進入容器docker exec -it 容器id /bin/bash
    如 docker exec -it 5d034c6ea010 /bin/bash,就相當於進入了容器本身的操作系統

  • 刪除容器 docker rm
    如docker rm 5d034c6ea010 後面跟的是容器ID,刪除容器之前需要先停止容器運行

  • 數據拷貝docker cp
    此命令用於容器與宿主機之間進行數據拷貝,如 docker cp 5d034c6ea010: /etc/nginx/nginx.conf /dockerData/nginx/conf/nginx.conf 將容器的目錄文件拷貝到宿主機指定位置,容器ID可以替換成容器名。

命令實戰

如果我們需要一個nginx容器,並且需要在宿主機上直接修改nginx的配置文件、默認主頁,在宿主機可以實時看到容器nginx的日誌。我們可以按照如下的方式一步一步完成。

  • 使用–rm參數啟動容器,方便刪除
    docker run -d -p 8081:80 --name nginx --rm nginx

  • 進入容器,查看容器中配置文件、項目文件、日誌文件的目錄地址
    docker exec -it 9123b67e428e /bin/bash

  • 導出容器的配置文件
    docker cp nginx:/etc/nginx/nginx.conf /dockerData/nginx/conf/nginx.conf導出配置文件 nginx.conf
    docker cp nginx:/etc/nginx/conf.d /dockerData/nginx/conf/conf.d導出配置目錄 conf.d

  • 停止容器docker stop 9123b67e428e,由於加了–rm參數,容器會自動刪除

  • 再以如下命令啟動容器,完成目錄掛載
    shell docker run -d -p 8081:80 --name nginx \ -v /dockerData/nginx/conf/nginx.conf:/etc/nginx/nginx.conf \ -v /dockerData/nginx/conf/conf.d:/etc/nginx/conf.d \ -v /dockerData/nginx/www:/usr/share/nginx/html \ -v /dockerData/nginx/logs:/var/log/nginx nginx
  • 訪問服務器地址http://192.168.136.129:8081/

    訪問報錯,這時候就進入宿主機的日誌目錄/dockerData/nginx/logs查看日誌
    2019/11/23 10:08:11 [error] 6#6: *1 directory index of “/usr/share/nginx/html/” is forbidden, client: 192.168.136.1, server: localhost, request: “GET / HTTP/1.1”, host: “192.168.136.129:8081”
    因為/usr/share/nginx/html/被掛載到了服務器上面的/dockerData/nginx/www目錄下,原來的歡迎頁面在dockerData/nginx/www是沒有的,所有就報錯了,這裏我們隨便建一個。

  • 建立默認主頁
    shell #打開項目文件 cd /dockerData/nginx/www #使用vim 創建並編輯文件 vi index.html #此時我們會進入vim界面,按 i 插入,然後輸入 <h1 align="center">Hello,Welcome to Docker World</h1> #輸入完后,按 esc,然後輸入 :wq
  • 再次訪問瀏覽器地址

Dockerfile

我們可以使用Dockfile構建一個鏡像,然後直接在docker中運行。Dockerfile文件為一個文本文件,裡面包含構建鏡像所需的所有的命令,首先我們來認識一下Dockerfile文件中幾個重要的指令。

指令詳解

  • FROM
    選擇一個基礎鏡像,然後在基礎鏡像上進行修改,比如構建一個SpringBoot項目的鏡像,就需要選擇java這個基礎鏡像,FROM需要作為Dockerfile中的第一條指令
    如:FROM openjdk:8-jdk-alpine 基礎鏡像如果可以的話最好使用alpine版本的,採用alpline版本的基礎鏡像構建出來的鏡像會小很多。

  • RUN
    RUN指令用來執行命令行命令的。它有一下兩種格式:

    • shell 格式:RUN ,就像直接在命令行中輸入的命令一樣。 RUN echo '<h1>Hello, Docker!</h1>' > /usr/share/nginx/html/index.html
    • exec 格式:RUN [“可執行文件”, “參數1”, “參數2”],這更像是函數調用中的格式。
  • CMD
    此指令就是用於指定默認的容器主進程的啟動命令的。
    CMD指令格式和RUN相似,也是兩種格式
    • shell 格式:CMD
    • exec 格式:CMD [“可執行文件”, “參數1”, “參數2″…]
    • 參數列表格式:CMD [“參數1”, “參數2″…]。在指定了 ENTRYPOINT 指令后,用 CMD 指定具體的參數。
  • ENTRYPOINT
    ENTRYPOINT 的格式和 RUN 指令格式一樣,分為 exec 格式和 shell 格式。 ENTRYPOINT 的目的和 CMD 一樣,都是在指定容器啟動程序及參數。ENTRYPOINT 在運行時也可以替代,不過比 CMD 要略顯繁瑣,需要通過 docker run 的參數 --entrypoint 來指定。
    當指定了 ENTRYPOINT 后,CMD 的含義就發生了改變,不再是直接的運行其命令,而是將 CMD 的內容作為參數傳給 ENTRYPOINT 指令,換句話說實際執行時,將變為:
    <ENTRYPOINT> "<CMD>"

  • COPY & ADD
    這2個指令都是複製文件,它將從構建上下文目錄中   的文件/目錄 複製到新的一層的鏡像內的   位置。比如: COPY demo-test.jar app.jar 或 ADD demo-test.jar app.jar。
    ADD指令比 COPY高級點,可以指定一個URL地址,這樣Docker引擎會去下載這個URL的文件,如果 ADD後面是一個 tar文件的話,Dokcer引擎還會去解壓縮。
    我們在構建鏡像時盡可能使用 COPY,因為 COPY 的語義很明確,就是複製文件而已,而 ADD 則包含了更複雜的功能,其行為也不一定很清晰。

  • EXPOSE
    聲明容器運行時的端口,這隻是一個聲明,在運行時並不會因為這個聲明應用就會開啟這個端口的服務。在 Dockerfile 中寫入這樣的聲明有兩個好處,一個是幫助鏡像使用者理解這個鏡像服務的守護端口,以方便配置映射;另一個用處則是在運行時使用隨機端口映射時,也就是 docker run -P 時,會自動隨機映射 EXPOSE 的端口。
    要將 EXPOSE 和在運行時使用 -p <宿主端口>:<容器端口> 區分開來。-p,是映射宿主端口和容器端口,換句話說,就是將容器的對應端口服務公開給外界訪問,而 EXPOSE 僅僅是聲明容器打算使用什麼端口而已,並不會自動在宿主進行端口映射。

  • ENV
    這個指令很簡單,就是設置環境變量,無論是後面的其它指令,如 RUN,還是運行時的應用,都可以直接使用這裏定義的環境變量。它有如下兩種格式:
    • ENV <key> <value>
    • ENV <key1>=<value1> <key2>=<value2>...
  • VOLUME
    該指令使容器中的一個目錄具有持久化存儲的功能,該目錄可被容器本身使用,也可共享給其他容器。當容器中的應用有持久化數據的需求時可以在Dockerfile中使用該指令。如VOLUME /tmp
    這裏的 /tmp 目錄就會在運行時自動掛載為匿名卷,任何向 /tmp 中寫入的信息都不會記錄進容器存儲層,從而保證了容器存儲層的無狀態化。當然,運行時可以覆蓋這個掛載設置。比如:
    docker run -d -v mydata:/tmp xxxx

  • LABEL
    你可以為你的鏡像添加labels,用來組織鏡像,記錄版本描述,或者其他原因,對應每個label,增加以LABEL開頭的行,和一個或者多個鍵值對。如下所示:
    LABEL version="1.0" LABEL description="test"

Dockerfile實戰

我們以一個簡單的SpringBoot項目為例構建基於SpringBoot應用的鏡像。
功能很簡單,只是對外提供了一個say接口,在進入這個方法的時候打印出一行日誌,並將日誌寫入日誌文件。

@SpringBootApplication
@RestController
@Log4j2
public class DockerApplication {

    public static void main(String[] args) {
        SpringApplication.run(DockerApplication.class, args);
    }

    @GetMapping("/say")
    public String say(){
        log.info("get say request...");
        return "Hello,Java日知錄";
    }
    
}

我們使用maven將其打包成jar文件,放入一個單獨的文件夾,然後按照下面步驟一步步構建鏡像並執行

  • 在當前文件夾建立Dockerfile文件,文件內容如下:
    properties FROM openjdk:8-jdk-alpine #將容器中的/tmp目錄作為持久化目錄 VOLUME /tmp #暴露端口 EXPOSE 8080 #複製文件 COPY docker-demo.jar app.jar #配置容器啟動后執行的命令 ENTRYPOINT ["java","-Djava.security.egd=file:/dev/./urandom","-jar","/app.jar"]
  • 使用如下命令構建鏡像
    docker built -t springboot:v1.0 .

    -t 指定鏡像的名稱及版本號,注意後面需要以 . 結尾。

  • 查看鏡像文件

  • 運行構建的鏡像
    docker run -v /app/docker/logs:/logs -p 8080:8080 --rm --name springboot springboot:v1.0

  • 瀏覽器訪問http://192.168.136.129:8080/say

  • 在宿主機上實時查看日誌
    tail -100f /app/docker/logs/docker-demo-info.log

    請關注個人公眾號:JAVA日知錄

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

023.掌握Pod-Pod擴容和縮容

一 Pod的擴容和縮容

Kubernetes對Pod的擴縮容操作提供了手動和自動兩種模式,手動模式通過執行kubectl scale命令或通過RESTful API對一個Deployment/RC進行Pod副本數量的設置。自動模式則需要用戶根據某個性能指標或者自定義業務指標,並指定Pod副本數量的範圍,系統將自動在這個範圍內根據性能指標的變化進行調整。

1.1 手動縮容和擴容

  1 [root@uk8s-m-01 study]# vi nginx-deployment.yaml
  2 apiVersion: apps/v1beta1
  3 kind: Deployment
  4 metadata:
  5   name: nginx-deployment
  6 spec:
  7   replicas: 3
  8   template:
  9     metadata:
 10       labels:
 11         app: nginx
 12     spec:
 13       containers:
 14       - name: nginx
 15         image: nginx:1.7.9
 16         ports:
 17         - containerPort: 80
  1 [root@uk8s-m-01 study]# kubectl create -f nginx-deployment.yaml
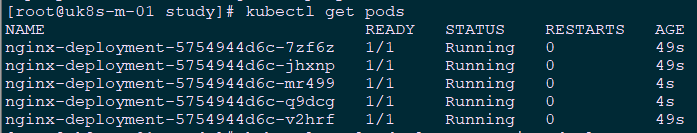
  2 [root@uk8s-m-01 study]# kubectl scale deployment nginx-deployment --replicas=5	#擴容至5個
  3 [root@uk8s-m-01 study]# kubectl get pods	                                	#查看擴容后的Pod

  1 [root@uk8s-m-01 study]# kubectl scale deployment nginx-deployment --replicas=2	#縮容至2個
  2 [root@uk8s-m-01 study]# kubectl get pods

1.2 自動擴容機制

Kubernetes使用Horizontal Pod Autoscaler(HPA)的控制器實現基於CPU使用率進行自動Pod擴縮容的功能。HPA控制器基於Master的kube-controller-manager服務啟動參數–horizontal-pod-autoscaler-sync-period定義的探測周期(默認值為15s),周期性地監測目標Pod的資源性能指標,並與HPA資源對象中的擴縮容條件進行對比,在滿足條件時對Pod副本數量進行調整。

  • HPA原理

Kubernetes中的某個Metrics Server(Heapster或自定義MetricsServer)持續採集所有Pod副本的指標數據。HPA控制器通過Metrics Server的API(Heapster的API或聚合API)獲取這些數據,基於用戶定義的擴縮容規則進行計算,得到目標Pod副本數量。
當目標Pod副本數量與當前副本數量不同時,HPA控制器就向Pod的副本控制器(Deployment、RC或ReplicaSet)發起scale操作,調整Pod的副本數量,完成擴縮容操作。

  • HPA指標類型

Master的kube-controller-manager服務持續監測目標Pod的某種性能指標,以計算是否需要調整副本數量。目前Kubernetes支持的指標類型如下:
Pod資源使用率:Pod級別的性能指標,通常是一個比率值,例如CPU使用率。
Pod自定義指標:Pod級別的性能指標,通常是一個數值,例如接收的請求數量。
Object自定義指標或外部自定義指標:通常是一個數值,需要容器應用以某種方式提供,例如通過HTTP URL“/metrics”提供,或者使用外部服務提供的指標採集URL。
Metrics Server將採集到的Pod性能指標數據通過聚合API(Aggregated API) 如metrics.k8s.io、 custom.metrics.k8s.io和external.metrics.k8s.io提供給HPA控制器進行查詢。

  • 擴縮容算法

Autoscaler控制器從聚合API獲取到Pod性能指標數據之後,基於下面的算法計算出目標Pod副本數量,與當前運行的Pod副本數量進行對比,決定是否需要進行擴縮容操作:
desiredReplicas = ceil[currentReplicas * ( currentMetricValue / desiredMetricValue )]

即當前副本數 x(當前指標值/期望的指標值),將結果向上取整。
釋義:以CPU請求數量為例,如果用戶設置的期望指標值為100m,當前實際使用的指標值為200m,則計算得到期望的Pod副本數量應為兩個(200/100=2)。如果設置的期望指標值為50m,計算結果為0.5,則向上取整值為1, 得到目標Pod副本數量應為1個。
注意:當計算結果與1非常接近時,可以設置一個容忍度讓系統不做擴縮容操作。容忍度通過kube-controller-manager服務的啟動參數–horizontalpod-autoscaler-tolerance進行設置,默認值為0.1(即10%),表示基於上述算法得到的結果在[-10%-+10%]區間內,即[0.9-1.1],控制器都不會進行擴縮容操作。
也可以將期望指標值(desiredMetricValue)設置為指標的平均值類型,例如targetAverageValue或targetAverageUtilization,此時當前指標值(currentMetricValue) 的算法為所有Pod副本當前指標值的總和除以Pod副本數量得到的平均值。
此外,存在幾種Pod異常的如下情況:

  • Pod正在被刪除(設置了刪除時間戳):將不會計入目標Pod副本數量。
  • Pod的當前指標值無法獲得:本次探測不會將這個Pod納入目標Pod副本數量,後續的探測會被重新納入計算範圍。
  • 如果指標類型是CPU使用率,則對於正在啟動但是還未達到Ready狀態的Pod,也暫時不會納入目標副本數量範圍。

提示:可以通過kubecontroller-manager服務的啟動參數–horizontal-pod-autoscaler-initialreadiness-delay設置首次探測Pod是否Ready的延時時間,默認值為30s。

另一個啟動參數–horizontal-pod-autoscaler-cpuinitialization-period設置首次採集Pod的CPU使用率的延時時間。
當存在缺失指標的Pod時,系統將更保守地重新計算平均值。系統會假設這些Pod在需要縮容(Scale Down) 時消耗了期望指標值的100%,在需要擴容(Scale Up)時消耗了期望指標值的0%,這樣可以抑制潛在的擴縮容操作。
此外,如果存在未達到Ready狀態的Pod,並且系統原本會在不考慮缺失指標或NotReady的Pod情況下進行擴展,則系統仍然會保守地假設這些Pod消耗期望指標值的0%,從而進一步抑制擴容操作。如果在HorizontalPodAutoscaler中設置了多個指標,系統就會對每個指標都執行上面的算法,在全部結果中以期望副本數的最大值為最終結果。如果這些指標中的任意一個都無法轉換為期望的副本數(例如無法獲取指標的值),系統就會跳過擴縮容操作。
最後, 在HPA控制器執行擴縮容操作之前,系統會記錄擴縮容建議信息(Scale Recommendation)。控制器會在操作時間窗口(時間範圍可以配置)中考慮所有的建議信息,並從中選擇得分最高的建議。這個值可通過kube-controller-manager服務的啟動參數–horizontal-podautoscaler-downscale-stabilization-window進行配置,默認值為5min。這個配置可以讓系統更為平滑地進行縮容操作,從而消除短時間內指標值快速波動產生的影響。

1.3 HorizontalPodAutoscaler

Kubernetes將HorizontalPodAutoscaler資源對象提供給用戶來定義擴縮容的規則。
HorizontalPodAutoscaler資源對象處於Kubernetes的API組“autoscaling”中, 目前包括v1和v2兩個版本。 其中autoscaling/v1僅支持基於CPU使用率的自動擴縮容, autoscaling/v2則用於支持基於任意指標的自動擴縮容配置, 包括基於資源使用率、 Pod指標、 其他指標等類型的指標數據。
示例1:基於autoscaling/v1版本的HorizontalPodAutoscaler配置,僅可以設置CPU使用率。

  1 [root@uk8s-m-01 study]# vi php-apache-autoscaling-v1.yaml
  2 apiVersion: autoscaling/v1
  3 kind: HorizontalPodAutoscaler
  4 metadata:
  5   name: php-apache
  6 spec:
  7   scaleTargetRef:
  8     apiVersion: apps/v1
  9     kind: Deployment
 10     name: php-apache
 11   minReplicas: 1
 12   maxReplicas: 10
 13   targetCPUUtilizationPercentage: 50


釋義:
scaleTargetRef:目標作用對象,可以是Deployment、ReplicationController或ReplicaSet。
targetCPUUtilizationPercentage:期望每個Pod的CPU使用率都為50%,該使用率基於Pod設置的CPU Request值進行計算,例如該值為200m,那麼系統將維持Pod的實際CPU使用值為100m。
minReplicas和maxReplicas:Pod副本數量的最小值和最大值,系統將在這個範圍內進行自動擴縮容操作, 並維持每個Pod的CPU使用率為50%。
為了使用autoscaling/v1版本的HorizontalPodAutoscaler,需要預先安裝Heapster組件或Metrics Server,用於採集Pod的CPU使用率。
示例2:基於autoscaling/v2beta2的HorizontalPodAutoscaler配置。

  1 [root@uk8s-m-01 study]# vi php-apache-autoscaling-v2.yaml
  2 apiVersion: autoscaling/v2beta2
  3 kind: HorizontalPodAutoscaler
  4 metadata:
  5   name: php-apache
  6 spec:
  7   scaleTargetRef:
  8     apiVersion: apps/v1
  9     kind: Deployment
 10     name: php-apache
 11   minReplicas: 1
 12   maxReplicas: 10
 13   metrics:
 14   - type: Resource
 15     resource:
 16       name: cpu
 17       target:
 18         type: Utilization
 19         averageUtilization: 50


釋義:
scaleTargetRef:目標作用對象,可以是Deployment、ReplicationController或ReplicaSet。
minReplicas和maxReplicas:Pod副本數量的最小值和最大值,系統將在這個範圍內進行自動擴縮容操作, 並維持每個Pod的CPU使用率為50%。
metrics:目標指標值。在metrics中通過參數type定義指標的類型;通過參數target定義相應的指標目標值,系統將在指標數據達到目標值時(考慮容忍度的區間)觸發擴縮容操作。

  • metrics中的type(指標類型)設置為以下幾種:
    • Resource:基於資源的指標值,可以設置的資源為CPU和內存。
    • Pods:基於Pod的指標,系統將對全部Pod副本的指標值進行平均值計算。
    • Object:基於某種資源對象(如Ingress)的指標或應用系統的任意自定義指標。

Resource類型的指標可以設置CPU和內存。對於CPU使用率,在target參數中設置averageUtilization定義目標平均CPU使用率。對於內存資源,在target參數中設置AverageValue定義目標平均內存使用值。指標數據可以通過API“metrics.k8s.io”進行查詢,要求預先啟動Metrics Server服務。
Pods類型和Object類型都屬於自定義指標類型,指標的數據通常需要搭建自定義Metrics Server和監控工具進行採集和處理。指標數據可以通過API“custom.metrics.k8s.io”進行查詢,要求預先啟動自定義Metrics Server服務。
類型為Pods的指標數據來源於Pod對象本身, 其target指標類型只能使用AverageValue,示例:

  1  metrics:
  2   - type: Pods
  3     pods:
  4       metrics:
  5         name: packets-per-second
  6       target:
  7         type: AverageValue
  8         averageValue: 1k

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

軟件架構模式

閱讀也花了較長的時間,大致也了解到整潔的架構要做到以下兩點:

  • well-isolated components:component是獨立部署的最小單元,由一系列遵循SOLID原則的module按照REP、CCP、CEP原則組成。
  • dependency rule:低層的detail去依賴高層的police

但感覺並沒有對架構設計給出可行的參考。

clean architecture 中的架構實例

在的第34章 “The Missing Chapter”(由 Simon Brown 編寫)給出了一個具體的案例,用四種架構設計來實現一個 “online book store”。

package by layer

這是最常見的方案,從前往後分為:前端、後台(business logic)、持久化DB。

優點是:簡單、容易上手,符合大多數公司的組織架構。

存在的問題:

  • 軟件規模和複雜度增加時,三層架構就不夠了,需要重新考慮拆分;
  • 分層架構體現不出business domain;

PACKAGE BY FEATURE

垂直切分方案,所有的java代碼都放在一個package裏面

好處在於凸顯domain concept

PORTS AND ADAPTERS

clean architecture這本書推薦的方案, 外層依賴於內層的domain

PACKAGE BY COMPONENT

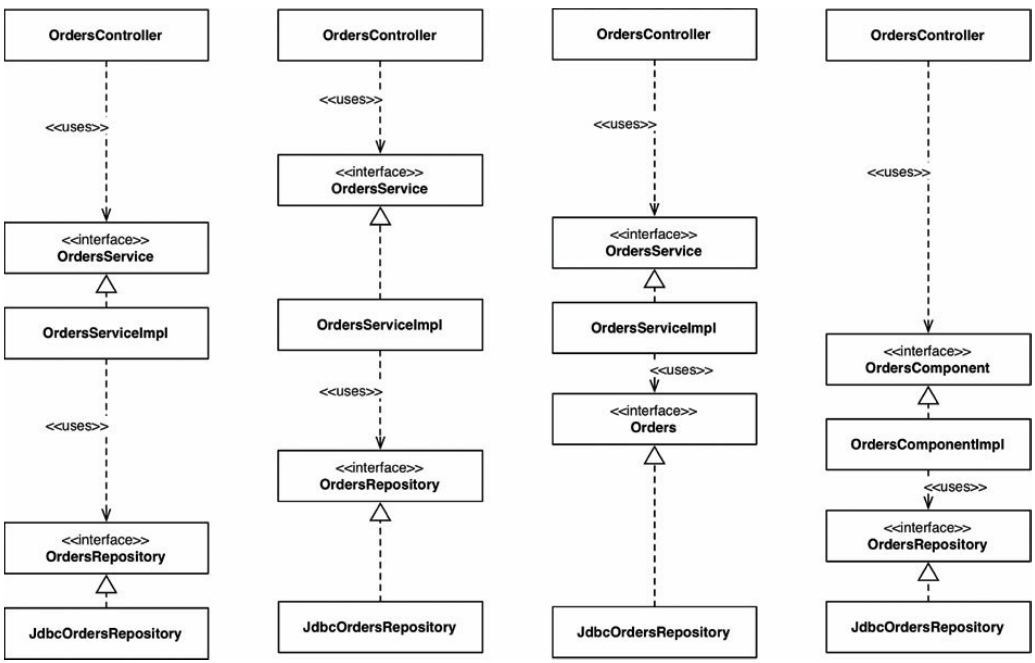
本章作者 Simon Brown 提出的方案,service-centric view,將所有相關的職責打包稱一個粗粒度的Jar包

bundling all of the responsibilities related to a single coarse-grained component into a single Java package

看起來類似現在微服務的部署方式

對於以上四種結構,依賴關係看起來是這樣的

值得注意的是

  • 虛線箭頭表示component之間的依賴關係
  • PORTS AND ADAPTERS這種架構更能體現domain(business logic),即接口命名為Orders而不是OrdersRepository

本章的作者最後還指出:++不管架構怎麼設計,粗心的implementation都可能違背最初的設計;依賴編譯器來保證架構的一以貫之,而不是自我約束或者事後檢查。++

五種常見架構模式

看完了clean architecture后,在網上搜索架構設計相關的書籍,發現了這本小冊子,篇幅很短,稱不上book,而是一個report。

指出缺乏架構設計的軟件往往高度耦合,難以改變。因此,這本小冊子的目標就是介紹常用架構模式的特點、優點、缺點,幫助我們針對特定的業務需求做出合適的選擇。

Layered Architecture

分層架構也稱為n-tire architecture,這是最為常見的一種架構模式,一般從前往後分為四層:presentation, business, persistence, and database。如下圖所示:

分層架構一般是一個新系統的最佳首選,因為其完美匹配傳統IT公司組織架構:一般的公司招人都是前端、後端、數據庫。

分層架構的優點在於關注點隔離(separation of concerns),每一層做好自己這一層的職責,並向上一層提供服務即可,最為經典的案例就是七層網絡模型,這有利於開發、測試、管理與維護。

分層架構中,需要注意的是兩個概念:closed layer、open layer

closed layer的核心就是不要越層訪問,比如在上圖中,Presentation Layer就不應該跨國Business Layer直接去Persistence Layer訪問數據。

A closed layer means that as a request moves from layer to layer, it must go through the layer right below it to get to the next layer below that one

closed layer保證了層隔離( layers of isolation),使得某一層的修改影響的範圍盡可能小,比較可控。但closed layer有時候也會帶來一個問題:architecture sinkhole anti pattern(污水池反模式),具體是指,為了查簡單數據,層層轉發請求。比如為了在展示層显示玩家的某個數據,需要通過業務層、再到持久化層、再到DB層;取到數據再一層層傳遞迴來,在這個過程中,業務層並沒有對數據有邏輯上的處理。

显示,污水池反模式衝擊了closed layer的美好想法。如何衡量這種層層轉發的請求是不是問題,可以參考80-20法則。

如果80%是附帶邏輯的,那麼就是ok的,但如果有80% 是 simple passthrough processing,那麼就得考慮讓某些layer open。比如在複雜的業務系統中, 經常會有一些可復用的邏輯,這個時候會抽取為通用的服務層(service layer)。如下圖所示

open layer 、close layer的概念可以幫助理清楚架構和請求流程之間的關係,讓架構師、程序員都清楚架構的邊界(boundary)在哪裡,重要的是,這個open-closed關係需要明確的文檔化,不要隨意打破,否則就會一團糟。

Event-Driven Architecture

The event-driven architecture pattern is a popular distributed asynchronous architecture pattern used to produce highly scalable applications.

從上述定義可以看出事件驅動架構的幾個特點:分佈式、異步、可伸縮。其核心是:高度解耦合、專一職責的事件處理單元(Event Processor)

事件驅動架構有兩種常見拓撲結構: the mediator and the broker.

Mediator Topology

需要一个中心化(全局唯一)的協調單元,用於組織一個事件中的多個步驟,這些步驟中有些是可并行的,有些必須是順序執行的,這就依賴Event Mediator的調度。如下圖所示

Broker Topology
這種是沒有中心的架構

the message flow is distributed across the event processor components in a chain-like fashion through a lightweight message broker

如下圖所示

事件驅動的好處在於,高度可伸縮、便於部署、整體性能較好(得益於某些事件的併發執行)。但由於其分佈式異步的本性,其缺點也很明顯:開發比較複雜、維護成本較高;而且很難支持事務,尤其是一個邏輯事件跨越多個processor的時候。

Microkernel Architecture

微內核架構又稱之為插件式架構(plug-in architecture)。如下圖所示:

微內核架構包含兩部分組件

  • a core system
  • plug-in modules.

plug-in modules 是相互獨立的組件,用於增加、擴展 core system 的功能。

這種架構非常適用於 product-based applications 即需要打包、下載、安裝的應用,比如桌面應用。最經典的例子就是Eclipse編輯器,玩遊戲的同學經常下載使用的MOD也可以看出插件。

微內核架構通常可以是其他架構的一部分,以實現特定部分的漸進式設計、增量開發

Microservices Architecture Pattern

微服務架構並不是為了解決新問題而發明的新架構,而是從分層架構的單體式應用和SOA(service-oriented architecture)演化而來。

微服務解決了分層架構潛在的成為單體式應用(Monolithic application)的問題:

through the development of continuous delivery, separating the application into multiple deployable units

同時,微服務還通過簡化(泛化)服務的概念,消除編排需求,簡化對服務組件的連接訪問。從而避免了SOA的各種缺點:複雜、昂貴、重度、難以理解和開發。

The microservices architecture style addresses this complexity by simplifying the notion of a service, eliminating orchestration needs, and simplifying connectivity and access to service components.

微服務架構如下:

其核心是service component,這些服務組件相互解耦,易於獨立開發、部署。服務組件的粒度是微服務架構中最難的挑戰

  • 太大:失去了微服務架構的優勢
  • 太小:導致需要編排,或者服務組件間的通信、事務。

而微服務架構相比SOA而言,其優勢就在於避免依賴和編排 — 編排引入大量的複雜工作。

對於單個請求 如果service之間還要通信,那麼可能是就是粒度過小。解決辦法:

  • 如果通信是為了訪問數據:那麼可以通過共享db解決
  • 如果通信是為了使用功能:那麼可以考慮代碼的冗餘,雖然這違背了DRY原則。在clean architecture中也指出,component的自完備性有時候要高於代碼復用。

Space-Based Architecture

基於空間的架構,其核心目標是解決由於數據庫瓶頸導致的低伸縮性、低併發問題。

分層架構中,在用戶規模激增的情況下,數據層的擴展往往會成為最後的瓶頸(相對而言,前端和業務邏輯都容易做成無狀態,比較好水平擴展)。而基於空間的架構的核心是內存複製,根本上解決了這個問題。

High scalability is achieved by removing the central database constraint and using replicated in-memory data grids instead

架構如下:

其核心組件包括

  • processing unit,處理單元,其內部又包含一下組成
    • business logic
    • in-memory data grid
    • an optional asynchronous persistent store for failover
    • replication engine,用於同步數據修改
  • virtualized middleware
    • Messaging Grid: 監控processing unit可用性,路由客戶端請求到processing unit
    • Data Grid: 核心,負責processingunit之間的數據同步,毫秒級同步?
    • Processing Grid: 可選組件,如果一個請求需要多個processing unit的服務,那麼負責協調分發
    • Deployment Manager: 負責processing unit的按需啟停

基於空間的架構很少見,而且從上面的核心組件描述來看的話,開發和維護應該都是比較負責的,由於是數據的同步這塊。而且由於數據都保存在內存中,那麼數據量就不能太大。

基於空間的架構適用於需求變化大的小型web應用,不適用於有大量數據操作的傳統大規模關係型數據庫應用

references

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

.NET進階篇06-async異步、thread多線程3

知識需要不斷積累、總結和沉澱,思考和寫作是成長的催化劑

梯子

一、任務Task

System.Threading.Tasks在.NET4引入,前麵線程的API太多了,控制不方便,而ThreadPool控制能力又太弱,比如做線程的延續、阻塞、取消、超時等功能不太方便,所以Task就抽象了線程功能,在後台使用ThreadPool

1、啟動任務

可以使用TaskFactory類或Task類的構造函數和Start()方法,委託可以提供帶有一個Object類型的輸入參數,所以可以給任務傳遞任意數據,還漏了一個常用的Task.Run

TaskFactory taskFactory = new TaskFactory();
taskFactory.StartNew(() => 
{
    Console.WriteLine($"tid={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
});
Task.Factory.StartNew(() =>
{
    Console.WriteLine($"tid={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
});
Task task = new Task(() =>
{
    Console.WriteLine($"tid={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
});
task.Start();

只有Task類實例方式需要Start()去啟動任務,當然可以RunSynchronously()來同步執行任務,主線程會等待,就是用主線程來執行這個task任務

Task task = new Task(() =>
{
    Thread.Sleep(10000);
    Console.WriteLine($"tid={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
});
task.RunSynchronously();

2、阻塞延續

在Thread中我們使用join來阻塞等待,在多個Thread時進行控制就不太方便。Task中我們使用實例方法Wait阻塞單個任務或靜態方法WaitAll和WaitAny阻塞多個任務

var task = new Task(() =>
{
    Thread.Sleep(5*1000);
    Console.WriteLine($"tid={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
});
var task2 = new Task(() =>
{
    Thread.Sleep(10 * 1000);
    Console.WriteLine($"tid={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
});
task.Start();
task2.Start();
//task.Wait();//單任務等待
//Task.WaitAny(task, task2);//任何一個任務完成就繼續
Task.WaitAll(task, task2);//任務都完成才繼續

如果不希望阻塞主線程,實現當一個任務或幾個任務完成后執行別的任務,可以使用Task靜態方法WhenAll和WhenAny,他們將返回一個Task,但這個Task不允許你控制,將會在滿足WhenAll和WhenAny里任務完成時自動完成,然後調用Task的ContinueWith方法,就可以在一個任務完成后緊跟開始另一個任務

Task.WhenAll(task, task2).ContinueWith((t) =>
{
    Console.WriteLine($"tid={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
});

Task.Factory工廠中也存在類似ContinueWhenAll和ContinueWhenAny

3、任務層次結構

不僅可以在一個任務結束后執行另一個任務,也可以在一個任務內啟動一個任務,這就啟動了一個父子層次結構

var parentTask = new Task(()=> 
{
    Console.WriteLine($"parentId={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
    Thread.Sleep(5*1000);
    var childTask = new Task(() =>
    {
        Thread.Sleep(10 * 1000);
        Console.WriteLine($"childId={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}")
    });
    childTask.Start();
});
parentTask.Start();

如果父任務在子任務之前結束,父任務的狀態為WaitingForChildrenToComplete,當子任務也完成時,父任務的狀態就變為RanToCompletion,當然,在創建任務時指定TaskCreationOptions枚舉參數,可以控制任務的創建和執行的可選行為

4、枚舉參數

簡單介紹下創建任務中的TaskCreationOptions枚舉參數,創建任務時我們可以提供TaskCreationOptions枚舉參數,用於控制任務的創建和執行的可選行為的標誌

  1. AttachedToParent:指定將任務附加到任務層次結構中的某個父級,意思就是建立父子關係,父任務必須等待子任務完成才可以繼續執行。和WaitAll效果一樣。上面例子如果在創建子任務時指定TaskCreationOptions.AttachedToParent,那麼父任務wait時也會等子任務的結束
  2. DenyChildAttach:不讓子任務附加到父任務上
  3. LongRunning:指定是長時間運行任務,如果事先知道這個任務會耗時比較長,建議設置此項。這樣,Task調度器會創建Thread線程,而不使用ThreadPool線程。因為你長時間佔用ThreadPool線程不還,那它可能必要時會在線程池中開啟新的線程,造成調度壓力
  4. PreferFairness:盡可能公平的安排任務,這意味着較早安排的任務將更可能較早運行,而較晚安排運行的任務將更可能較晚運行。實際通過把任務放到線程池的全局隊列中,讓工作線程去爭搶,默認是在本地隊列中。

另一個枚舉參數是ContinueWith方法中的TaskContinuationOptions枚舉參數,它除了擁有幾個和上面同樣功能的枚舉值外,還擁有控制任務的取消延續等功能

  1. LazyCancellation:在延續取消的情況下,防止延續的完成直到完成先前的任務。什麼意思呢?
CancellationTokenSource source = new CancellationTokenSource();
source.Cancel();
var task1 = new Task(() => 
{
    Console.WriteLine($"task1 id={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
});
var task2 = task1.ContinueWith(t =>
{
    Console.WriteLine($"task2 id={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
},source.Token);
var task3 = task2.ContinueWith(t =>
{
    Console.WriteLine($"task3 id={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
});
task1.Start();

上面例子我們企圖task1->task2->task3順序執行,然後通過CancellationToken來取消task2的執行。結果會是怎樣呢?結果task1和task3會并行執行(task3也是會執行的,而且是和task1并行,等於原來的一條鏈變成了兩條鏈),然後我們嘗試使用LazyCancellation,

var task2 = task1.ContinueWith(t =>
{
    Console.WriteLine($"task2 id={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
},source.Token,TaskContinuationOptions.LazyCancellation,TaskScheduler.Current);

這樣,將會在task1執行完成后,task2才去判斷source.Token,為Cancel就不執行,接下來執行task3就保證了原來的順序

  1. ExecuteSynchronously:指定應同步執行延續任務,比如上例中,在延續任務task2中指定此參數,則task2會使用執行task1的線程來執行,這樣防止線程切換,可以做些共有資源的訪問。不指定的話就隨機,但也能也用到task1的線程
  2. NotOnRanToCompletion:延續任務必須在前面任務非完成狀態下執行
  3. OnlyOnRanToCompletion:延續任務必須在前面任務完成狀態才能執行
  4. NotOnFaulted,OnlyOnCanceled,OnlyOnFaulted等等

5、任務取消

在上篇使用Thread時,我們使用一個變量isStop標記是否取消任務,這種訪問共享變量的方式難免會出問題。task中提出CancellationTokenSource類專門處理任務取消,常見用法看下面代碼註釋

CancellationTokenSource source = new CancellationTokenSource();//構造函數中也可指定延遲取消
//註冊一個取消時調用的委託
source.Token.Register(() =>
{
    Console.WriteLine("當前source已經取消,可以在這裏做一些其他事情(比如資源清理)...");
});
var task1 = new Task(() => 
{
    while (!source.IsCancellationRequested)
    {
        Console.WriteLine($"task1 id={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}");
    }
},source.Token);
task1.Start();
//source.Cancel();//取消
source.CancelAfter(1000);//延時取消

6、任務結果

讓子線程返回結果,可以將信息寫入到線程安全的共享變量中去,或則使用可以返回結果的任務。使用Task的泛型版本Task<TResult>,就可以定義返回結果的任務。Task是繼承自Task的,Result獲取結果時是要阻塞等待直到任務完成返回結果的,內部判斷沒有完成則wait。通過TaskStatus屬性可獲得此任務的狀態是啟動、運行、異常還是取消等

var task = new Task<string>(() =>
{
     return "hello ketty";
});
task.Start();
string result = task.Result;

7、異常

可以使用AggregateException來接受任務中的異常信息,這是一個聚合異常繼承自Exception,可以遍歷獲取包含的所有異常,以及進行異常處理,決定是否繼續往上拋異常等

var task = Task.Factory.StartNew(() =>
{
    var childTask1 = Task.Factory.StartNew(() =>
    {
        throw new Exception("childTask1異常...");
    },TaskCreationOptions.AttachedToParent);
    var childTask12= Task.Factory.StartNew(() =>
    {
        throw new Exception("childTask2異常...");
    }, TaskCreationOptions.AttachedToParent);
});
try
{
    try
    {
        task.Wait();
    }
    catch (AggregateException ex)
    {
        foreach (var item in ex.InnerExceptions)
        {
            Console.WriteLine($"message{item.InnerException.Message}");
        }
        ex.Handle(x =>
        {
            if (x.InnerException.Message == "childTask1異常...")
            {
                return true;//異常被處理,不繼續往上拋了
            }
            return false;
        });
    }
}
catch (Exception ex)
{
    throw;
}

二、并行Parallel

1、Parallel.For()、Parallel.ForEach()

在.NET4中,另一個新增的抽象的線程時Parallel類。這個類定義了并行的for和foreach的靜態方法。Parallel.For()和Parallel.ForEach()方法多次調用一個方法,而Parallel.Invoke()方法允許同時調用不同的方法。首先Parallel是會阻塞主線程的,它將讓主線程也參与到任務中
Parallel.For()類似於for允許語句,并行迭代同一個方法,迭代順序沒有保證的

ParallelLoopResult result = Parallel.For(0, 10, i =>
{
    Console.WriteLine($"{i} task:{Task.CurrentId} thread:{Thread.CurrentThread.ManagedThreadId}");
});
Console.WriteLine(result.IsCompleted);

也可以提前中斷Parallel.For()方法。For()方法的一個重載版本接受Action<int,parallelloopstate style=”font-size: inherit; color: inherit; line-height: inherit; margin: 0px; padding: 0px;”>類型參數。一般不使用,像下面這樣,本想大於5就停止,但實際也可能有大於5的任務已經在跑了。可以通過ParallelOptions傳入允許最大線程數以及取消Token等

ParallelLoopResult result = Parallel.For(0, 10, new ParallelOptions() { MaxDegreeOfParallelism = 8 },(i,loop) =>
{
    Console.WriteLine($"{i} task:{Task.CurrentId} thread:{Thread.CurrentThread.ManagedThreadId}");
    if (i > 5)
    {
        loop.Break();
    }
});

2、Parallel.For<TLocal>

For還有一個高級泛型版本,相當於并行的聚合計算

ParallelLoopResult For<TLocal>(int fromInclusive, int toExclusive, Func<TLocal> localInit, Func<int, ParallelLoopState, TLocal, TLocal> body, Action<TLocal> localFinally);

像下面這樣我們求0…100的和,第三個參數更定一個種子初始值,第四個參數迭代累計,最後聚合

int totalNum = 0;
Parallel.For<int>(0, 100, () => { return 0; }, (current, loop, total) =>
{
    total += current;
    return total;
}, (total) =>
{
    Interlocked.Add(ref totalNum, total);
});

上面For用來處理數組數據,ForEach()方法用來處理非數組的數據任務,比如字典數據繼承自IEnumerable的集合等

3、Parallel.Invoke()

Parallel.Invoke()則可以并行調用不同的方法,參數傳遞一個Action的委託數組

Parallel.Invoke(() => { Console.WriteLine($"方法1 thread:{Thread.CurrentThread.ManagedThreadId}"); }
    , () => { Console.WriteLine($"方法2 thread:{Thread.CurrentThread.ManagedThreadId}"); }
    , () => { Console.WriteLine($"方法3 thread:{Thread.CurrentThread.ManagedThreadId}"); });

4、PLinq

Plinq,為了能夠達到最大的靈活度,linq有了并行版本。使用也很簡單,只需要將原始集合AsParallel就轉換為支持并行化的查詢。也可以AsOrdered來順序執行,取消Token,強制并行等

var nums = Enumerable.Range(0, 100);
var query = from n in nums.AsParallel()
            select new
            {
                thread=$"tid={Thread.CurrentThread.ManagedThreadId},datetime={DateTime.Now}"
            };

三、異步等待AsyncAwait

異步編程模型,可能還需要大篇幅來學習,這裏先介紹下基本用法,內在本質需要用ILSpy反編譯來看,以後可能要分專題總結。文末先給幾個參考資料,有興趣自己闊以先琢磨琢磨鴨

1、簡單使用

這是.NET4.5開始提供的一對語法糖,使得可以較簡便的使用異步編程。async用在方法定義前面,await只能寫在帶有async標記的方法中,任何方法都可以增加async,一般成對出現,只有async沒有意義,只有await會報錯,請先看下面的示例

private static async void AsyncTest()
{
    //主線程執行
    Console.WriteLine($"before await ThreadId={Thread.CurrentThread.ManagedThreadId}");
    TaskFactory taskFactory = new TaskFactory();
    Task task = taskFactory.StartNew(() =>
    {
        Thread.Sleep(3000);
        Console.WriteLine($"task ThreadId={Thread.CurrentThread.ManagedThreadId}");
    });
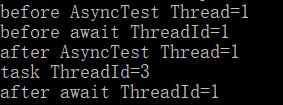
    await task;//主線程到這裏就返回了,執行主線程任務
    //子線程執行,其實是封裝成委託,在task之後成為回調(編譯器功能  狀態機實現) 後面相當於task.ContinueWith()
    //這個回調的線程是不確定的:可能是主線程  可能是子線程  也可能是其他線程,在winform中是主線程
    Console.WriteLine($"after await ThreadId={Thread.CurrentThread.ManagedThreadId}");
}

一般使用async都會讓方法返回一個Task的,像下面這樣複雜一點的

private static async Task<string> AsyncTest2()
{
    Console.WriteLine($"before await ThreadId={Thread.CurrentThread.ManagedThreadId}");
    TaskFactory taskFactory = new TaskFactory();
    string x = await taskFactory.StartNew(() =>
      {
          Thread.Sleep(3000);
          Console.WriteLine($"task ThreadId={Thread.CurrentThread.ManagedThreadId}");
          return "task over";
      });

    Console.WriteLine($"after await ThreadId={Thread.CurrentThread.ManagedThreadId}");
    return x;
}

通過var reslult = AsyncTest2().Result;調用即可。但注意如果調用Wait或Result的代碼位於UI線程,Task的實際執行在其他線程,其需要返回UI線程則會造成死鎖,所以應該Async all the way

2、優雅

從上面簡單示例中可以看出異步編程的執行邏輯:主線程A邏輯->異步任務線程B邏輯->主線程C邏輯。
異步方法的返回類型只能是void、Task、Task。示例中異步方法的返回值類型是Task,通常void也不推薦使用,沒有返回值直接用Task就是

上一篇也大概了解到如果我們要在任務中更新UI,需要調用Invoke通知UI線程來更新,代碼看起來像下面這樣,在一個任務後去更新UI

private void button1_Click(object sender, EventArgs e)
{
    var ResultTask = Task.Run(() => {
        Thread.Sleep(5000);
        return "任務完成";
    });
    ResultTask.ContinueWith((r)=> 
    {
        textBox1.Invoke(() => {
            textBox1.Text = r.Result;
        });
    });
}

如果使用async/await會看起來像這樣,是不是優雅了許多。以看似同步編程的方式實現異步

private async void button1_Click(object sender, EventArgs e)
{
    var t = Task.Run(() => {
        Thread.Sleep(5000);
        return "任務完成";
    });
    textBox1.Text = await t;
}

3、最後

在.NET 4.5中引入的Async和Await兩個新的關鍵字后,用戶能以一種簡潔直觀的方式實現異步編程。甚至都不需要改變代碼的邏輯結構,就能將原來的同步函數改造為異步函數。
在內部實現上,Async和Await這兩個關鍵字由編譯器轉換為狀態機,通過System.Threading.Tasks中的并行類實現代碼的異步執行。

字數有點多了,我的能力也就高考作文800字能寫的出奇好。看了很多異步編程,腦袋有點炸,等消化后再輸出一次,技藝不足,只能用輸出倒逼輸入了,下一篇會是線程安全集合、鎖問題、同步問題,基於事件的異步模式等

Search the fucking web
Read the fucking maunal

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整