Tesla Model 3 有對手了!LG Chem 研發長程電動車電池

Tesla 又有新對手了,南韓 LG Chem 目前也在開發最新電池技術,且無論航程或售價均足以與特斯拉研發中的 Model 3 匹敵。   Model S 是目前市面上唯一航程可以達 200 英哩的電動車,但即使是最低售價也高達 7.1 萬美元。特斯拉計畫在 2017 年推出 Model 3,售價將壓低至每輛 3.5 萬美元,但售價仍然不敵 LG Chem 正將推出的電動車。   LG Chem 位於美國的研究單位主管 Prabhakar Patil 證實,正在開發續航力 200 英哩的電池,目前已有幾家汽車業者表示對該項技術有興趣,產品最快於 2017 年就可上市,售價將介於 3 至 3.5 萬美元間。   Patil 雖然沒有明講,但外界猜想對該項技術有興趣的汽車業者,一定包含通用汽車。LG Chem 目前已是通用油電混合動力車 Volt 的電池供應商,且通用之前表示,將推出續航力 200 英哩的電動車,起價最低 3 萬美元,符合 Patil 設定的條件。

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※別再煩惱如何寫文案,掌握八大原則!

鴻海再加碼大陸 布局電動車市場

鴻海 13 日對外表示,將發行上限 240 億元無擔保普通公司債募資,以償還短期負債。另外,將透過轉投資第三地,赴大陸投資重慶元創汽車整線集成公司約新台幣 4.9 億元,強化車用相關布局。   重慶元創汽車整線集成公司主要從事汽車模、夾、檢具的設計開發與製造。市場人士預期,鴻海該項投資主要為電動車事業播種,未來有機會整合其自動化相關應用在汽車生產線上。   鴻海近期對電動車相當有興趣,市場預期,鴻海要將製造消費性電子的技術,應用在生產電動車上,讓電動車的價格更親民。

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

※南投搬家公司費用需注意的眉眉角角,別等搬了再說!

※新北清潔公司,居家、辦公、裝潢細清專業服務

※教你寫出一流的銷售文案?

挽救電動車產業 印度政府再次開啟投資

    印度政府日前通過一項 23 億美元的電動車產業振興計劃──2020 國家電動車行動計劃(NEMMP 2020 plan),打算重新帶起終止補貼後明顯下滑的電動車銷量。   印度政府過去對電動車的銷售補貼相當成功,全盛時期銷售量甚至超過 10 萬輛,但當新暨再生能源部 MNRE 在 2012 年 3 月停止補貼後,銷售量開始下滑,到了 2013 年,只剩 2.1 萬輛。幾年前,印度有 65 家電動車製造商,現在只剩 10家還在營運。   NEMMP 計劃目標是在 2020 年有 6 到 7 百萬輛電動車上路,而其中 4 到 5 百萬輛為二輪車,若達到該銷量數字,還能節省超過 200 萬噸燃料的使用。   雖然大多數電動車公司在過去兩年來已停止營運,但假如 NEMMP 2020 可在接下來的 3 或 4 個月間實施,預期印度電動車產業仍可復甦。     (圖片來源:)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※想知道最厲害的網頁設計公司"嚨底家"!

※幫你省時又省力,新北清潔一流服務好口碑

※別再煩惱如何寫文案,掌握八大原則!

美電動車銷量 7 月破萬持續看漲

美國汽車媒體 GreenCarReports 報導,由於日產和通用兩家公司的聆風和雪佛蘭沃藍達在美國市場銷量表現不俗,美國 7 月插電式電動汽車銷量繼續看漲。聆風和雪佛蘭沃藍達的月度銷售量相加第二次超過 5000 台,上次月度銷量超過 5000 台是去年 8 月。    數據顯示,2014 年 7 月美國插電式電動車整體銷量為 1 萬 533 輛。其中日產聆風當月在美國本土市場的銷量為 3,019 輛,位居第一;其次是雪佛蘭沃藍達,銷量為 2,020 輛,取代了此前豐田普銳斯季軍的位置;豐田普銳斯當季銷量為 1,371 輛。   不難發現,美國新能源汽車市場的主要車型相對集中。日產的聆風、雪佛蘭沃藍達和豐田的普銳斯一直占據主導地位,也是美國傳統汽車品牌中新能源汽車領域的三大陣地。事實上,日產聆風電動車 7 月在美國市場的銷量並不是歷史最高銷量。其聆風電動車銷量的高峰是今年 5 月,共計銷售 3,117 輛,同比上漲 46%。

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※新北清潔公司,居家、辦公、裝潢細清專業服務

※別再煩惱如何寫文案,掌握八大原則!

※教你寫出一流的銷售文案?

※超省錢租車方案

Tesla 展霸氣!推「8 年不限里程保固」

電動車大廠特斯拉(Tesla)近日再推霸氣新政策,根據馬斯克(Elon Musk)在官方部落格發表的文章,現在他們最受歡迎的車款 Model S 將享有 8 年不限里程的保固,雖然這項新措施對客戶非常大方,但馬斯克也表示這將對短期內的獲利有負面影響。   「如果我們真的相信電動機比傳統的汽油引擎可靠,而且有著更少的油質殘渣與廢氣,那我們的保固政策就該反映出這點。」馬斯克信心十足的說。另外,他在文章內也對投資者表示,雖然因為保修儲備必須提升到更高的檔次,這項政策短期內對公司的盈利會有負面影響,但長期來說,他相信只要及早做出正確的決定肯定會對公司有所幫助。

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※新北清潔公司,居家、辦公、裝潢細清專業服務

※別再煩惱如何寫文案,掌握八大原則!

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※超省錢租車方案

※教你寫出一流的銷售文案?

LG Chem 再下一城 與奧迪簽電池供應協議

    近來積極拓展車用電池事業的南韓化學巨擘 LG Chem Ltd. 宣佈,該公司已敲定價值數億美元的電動車電池供應合約,對象是德國汽車製造商福斯 (Volkswagen AG) 旗下的豪華車廠奧迪 (Audi AG)。   LG Chem 目前為通用汽車 (General Motors Co.)、雷諾 (Renault SA)、福特汽車 (Ford Motor Co.)、現代汽車 (Hyundai Motor Co.) 以及起亞汽車 (Kia Motors Corp.) 等 20 家業者的車用電池供應商。日前 LG Chem 才宣布將與通用汽車等汽車廠商攜手研發一款車用電池,其單次充電的里程數多達 200 英里,為市面上大多數電動車的兩倍以上。   20 日 LG Chem 又傳出好消息,該公司透過聲明表示,會為奧迪的次世代插電式混合動力電動車提供車用電池,總值多達數百億韓圜,而由於奧迪與母公司福斯一起共用了許多汽車平台,因此 LG Chem 認為未來應該能與福斯敲定更多類似的協議。     (圖片來源:)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※教你寫出一流的銷售文案?

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※回頭車貨運收費標準

※別再煩惱如何寫文案,掌握八大原則!

※超省錢租車方案

Tesla Model S 變身電動跑車 性能更強

  Saleen Automotive 在改車界享負盛名,無論任何車款經其改裝後,都會變得更快更有勁。最近他們看上了 Tesla 的 Model S 電動車,將其改裝為 Saleen FourSixteen,比起原版本擁有更高性能。   Saleen FourSixteen 採用與 Model S 相同的 416 匹引擎,不過其齒輪比率卻提高至 11.39:1,能大幅提高跑車的加速性能,因此由 0 加速至 100 公里只需 4 秒,比起 Model S 足足快了 1 秒。此外,Saleen FourSixteen 同時亦改善了冷卻系統及防傾桿,與及採用賽車用的車底盤及碳纖維剎車盤。   車廂內部也經過重新設計,將 Model S 原有的五座位改成全真皮的四座位,變成了一部真正的四座位超級電動跑車。該跑車目前已開放預訂,但售價並不便宜,約 15 萬 2 千美元。     (圖片來源:)
本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※超省錢租車方案

※別再煩惱如何寫文案,掌握八大原則!

※回頭車貨運收費標準

※教你寫出一流的銷售文案?

排氣不符規定 德要求戴姆勒召回數十萬輛柴油車

摘錄自2019年10月12日中央通訊社德國報導

德國汽車製造商戴姆勒(Daimler)12日表示,聯邦交通管理局(KBA)以違反排氣規定為由,要求召回數十萬輛柴油車。戴姆勒說,這波召回的數量估計將達6位數,並表示會「與有關當局合作」。

公司在聲明中表示,這次的召回涉及至少26萬輛Sprinter廂型車,並表示所有車輛都在2016年6月之前生產。

德國福斯汽車(Volkswagen)2015年承認在全球1100萬輛柴油車上安裝非法「減效裝置」(defeat device),包括歐洲850萬輛及美國60萬輛車,德國有關當局隨後展開這起造假醜聞「柴油門」調查。自從「柴油門」4年前爆發,這場排放造假醜聞就對汽車產業造成巨大後果。部分汽車排放與呼吸道及心血管疾病有關的有害氮氧化物,高達法律規定數值的40倍。

據德國媒體報導,聯邦交通管理局本月稍早展開調查,懷疑戴姆勒安裝「非法軟體」,試圖讓車輛在實驗室測試時的排汙量看起來比實際低。戴姆勒早已召回約70萬輛車,包括德國境內就有近30萬輛車被召回。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※教你寫出一流的銷售文案?

技術乾貨丨卷積神經網絡之LeNet-5遷移實踐案例

摘要:LeNet-5是Yann LeCun在1998年設計的用於手寫数字識別的卷積神經網絡,當年美國大多數銀行就是用它來識別支票上面的手寫数字的,它是早期卷積神經網絡中最有代表性的實驗系統之一。可以說,LeNet-5就相當於編程語言入門中的“Hello world!”。

華為的昇騰訓練芯片一直是大家所期待的,目前已經開始提供公測,如何在昇騰訓練芯片上運行一個訓練任務,這是目前很多人都在采坑過程中,所以我寫了一篇指導文章,附帶上所有相關源代碼。注意,本文並沒有包含環境的安裝,請查看另外相關文檔。

環境約束:昇騰910目前僅配套TensorFlow 1.15版本。

基礎鏡像上傳之後,我們需要啟動鏡像命令,以下命令掛載了8塊卡(單機所有卡):

docker run -it –net=host –device=/dev/davinci0 –device=/dev/davinci1 –device=/dev/davinci2 –device=/dev/davinci3 –device=/dev/davinci4 –device=/dev/davinci5 –device=/dev/davinci6 –device=/dev/davinci7 –device=/dev/davinci_manager –device=/dev/devmm_svm –device=/dev/hisi_hdc -v /var/log/npu/slog/container/docker:/var/log/npu/slog -v /var/log/npu/conf/slog/slog.conf:/var/log/npu/conf/slog/slog.conf -v /usr/local/Ascend/driver/lib64/:/usr/local/Ascend/driver/lib64/ -v /usr/local/Ascend/driver/tools/:/usr/local/Ascend/driver/tools/ -v /data/:/data/ -v /home/code:/home/local/code -v ~/context:/cache ubuntu_18.04-docker.arm64v8:v2 /bin/bash

設置環境變量並啟動手寫字訓練網絡:

#!/bin/bash
export LD_LIBRARY_PATH=/usr/local/lib/:/usr/local/HiAI/runtime/lib64
export PATH=/usr/local/HiAI/runtime/ccec_compiler/bin:$PATH
export CUSTOM_OP_LIB_PATH=/usr/local/HiAI/runtime/ops/framework/built-in/tensorflow
export DDK_VERSION_PATH=/usr/local/HiAI/runtime/ddk_info
export WHICH_OP=GEOP
export NEW_GE_FE_ID=1
export GE_AICPU_FLAG=1
export OPTION_EXEC_EXTERN_PLUGIN_PATH=/usr/local/HiAI/runtime/lib64/plugin/opskernel/libfe.so:/usr/local/HiAI/runtime/lib64/plugin/opskernel/libaicpu_plugin.so:/usr/local/HiAI/runtime/lib64/plugin/opskernel/libge_local_engine.so:/usr/local/H
iAI/runtime/lib64/plugin/opskernel/librts_engine.so:/usr/local/HiAI/runtime/lib64/libhccl.so
 
export OP_PROTOLIB_PATH=/usr/local/HiAI/runtime/ops/built-in/
 
export DEVICE_ID=2
export PRINT_MODEL=1
#export DUMP_GE_GRAPH=2
 
#export DISABLE_REUSE_MEMORY=1
#export DUMP_OP=1
#export SLOG_PRINT_TO_STDOUT=1
 
export RANK_ID=0
export RANK_SIZE=1
export JOB_ID=10087
export OPTION_PROTO_LIB_PATH=/usr/local/HiAI/runtime/ops/op_proto/built-in/
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:/usr/local/Ascend/fwkacllib/lib64/:/usr/local/Ascend/driver/lib64/common/:/usr/local/Ascend/driver/lib64/driver/:/usr/local/Ascend/add-ons/
export PYTHONPATH=$PYTHONPATH:/usr/local/Ascend/opp/op_impl/built-in/ai_core/tbe
export PATH=$PATH:/usr/local/Ascend/fwkacllib/ccec_compiler/bin
export ASCEND_HOME=/usr/local/Ascend
export ASCEND_OPP_PATH=/usr/local/Ascend/opp
export SOC_VERSION=Ascend910
 
rm -f *.pbtxt
rm -f *.txt
rm -r /var/log/npu/slog/*.log
rm -rf train_url/*
 
 
python3 mnist_train.py

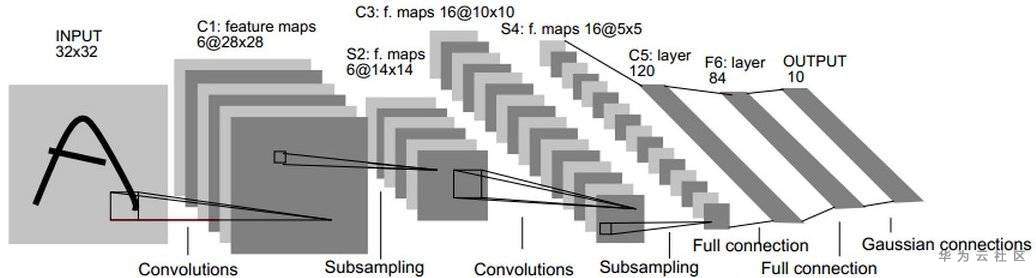
以下訓練案例中我使用的lecun大師的LeNet-5網絡,先簡單介紹LeNet-5網絡:

LeNet5誕生於1994年,是最早的卷積神經網絡之一,並且推動了深度學習領域的發展。自從1988年開始,在多年的研究和許多次成功的迭代后,這項由Yann LeCun完成的開拓性成果被命名為LeNet5。

LeNet-5包含七層,不包括輸入,每一層都包含可訓練參數(權重),當時使用的輸入數據是32*32像素的圖像。下面逐層介紹LeNet-5的結構,並且,卷積層將用Cx表示,子採樣層則被標記為Sx,完全連接層被標記為Fx,其中x是層索引。

層C1是具有六個5*5的卷積核的卷積層(convolution),特徵映射的大小為28*28,這樣可以防止輸入圖像的信息掉出卷積核邊界。C1包含156個可訓練參數和122304個連接。

層S2是輸出6個大小為14*14的特徵圖的子採樣層(subsampling/pooling)。每個特徵地圖中的每個單元連接到C1中的對應特徵地圖中的2*2個鄰域。S2中單位的四個輸入相加,然後乘以可訓練係數(權重),然後加到可訓練偏差(bias)。結果通過S形函數傳遞。由於2*2個感受域不重疊,因此S2中的特徵圖只有C1中的特徵圖的一半行數和列數。S2層有12個可訓練參數和5880個連接。

層C3是具有16個5-5的卷積核的卷積層。前六個C3特徵圖的輸入是S2中的三個特徵圖的每個連續子集,接下來的六個特徵圖的輸入則來自四個連續子集的輸入,接下來的三個特徵圖的輸入來自不連續的四個子集。最後,最後一個特徵圖的輸入來自S2所有特徵圖。C3層有1516個可訓練參數和156 000個連接。

層S4是與S2類似,大小為2*2,輸出為16個5*5的特徵圖。S4層有32個可訓練參數和2000個連接。

層C5是具有120個大小為5*5的卷積核的卷積層。每個單元連接到S4的所有16個特徵圖上的5*5鄰域。這裏,因為S4的特徵圖大小也是5*5,所以C5的輸出大小是1*1。因此S4和C5之間是完全連接的。C5被標記為卷積層,而不是完全連接的層,是因為如果LeNet-5輸入變得更大而其結構保持不變,則其輸出大小會大於1*1,即不是完全連接的層了。C5層有48120個可訓練連接。

F6層完全連接到C5,輸出84張特徵圖。它有10164個可訓練參數。這裏84與輸出層的設計有關。

LeNet的設計較為簡單,因此其處理複雜數據的能力有限;此外,在近年來的研究中許多學者已經發現全連接層的計算代價過大,而使用全部由卷積層組成的神經網絡。

LeNet-5網絡訓練腳本是mnist_train.py,具體代碼:

import os
import numpy as np
import tensorflow as tf
import time
from tensorflow.examples.tutorials.mnist import input_data
 
import mnist_inference
 
from npu_bridge.estimator import npu_ops #導入NPU算子庫
from tensorflow.core.protobuf.rewriter_config_pb2 import RewriterConfig #重寫tensorFlow里的配置,針對NPU的配置
 
 
batch_size = 100
learning_rate = 0.1
training_step = 10000
 
model_save_path = "./model/"
model_name = "model.ckpt"
 
def train(mnist):
    x = tf.placeholder(tf.float32, [batch_size, mnist_inference.image_size, mnist_inference.image_size, mnist_inference.num_channels], name = 'x-input')
    y_ = tf.placeholder(tf.float32, [batch_size, mnist_inference.num_labels], name = "y-input")
 
    regularizer = tf.contrib.layers.l2_regularizer(0.001)
    y = mnist_inference.inference(x, train = True, regularizer = regularizer) #推理過程
    global_step = tf.Variable(0, trainable=False)
    cross_entropy = tf.nn.sparse_softmax_cross_entropy_with_logits(logits = y, labels = tf.argmax(y_, 1)) #損失函數
    cross_entropy_mean = tf.reduce_mean(cross_entropy)
    loss = cross_entropy_mean + tf.add_n(tf.get_collection("loss"))
 
    train_step = tf.train.GradientDescentOptimizer(learning_rate).minimize(loss, global_step = global_step) #優化器調用
 
    saver = tf.train.Saver() #啟動訓練
 
#以下代碼是NPU所必須的代碼,開始配置參數
    config = tf.ConfigProto(
        allow_soft_placement = True,
        log_device_placement = False)
    custom_op =  config.graph_options.rewrite_options.custom_optimizers.add()
    custom_op.name =  "NpuOptimizer"
    custom_op.parameter_map["use_off_line"].b = True
    #custom_op.parameter_map["profiling_mode"].b = True
    #custom_op.parameter_map["profiling_options"].s = tf.compat.as_bytes("task_trace:training_trace")
config.graph_options.rewrite_options.remapping = RewriterConfig.OFF
#配置參數結束
 
    writer = tf.summary.FileWriter("./log_dir", tf.get_default_graph())
    writer.close()
 
 
#參數初始化
    with tf.Session(config = config) as sess:
        tf.global_variables_initializer().run()
 
        start_time = time.time()
 
        for i in range(training_step):
xs, ys = mnist.train.next_batch(batch_size)
            reshaped_xs = np.reshape(xs, (batch_size, mnist_inference.image_size, mnist_inference.image_size, mnist_inference.num_channels))
            _, loss_value, step = sess.run([train_step, loss, global_step], feed_dict={x:reshaped_xs, y_:ys})
 
            #每訓練10個epoch打印損失函數輸出日誌
            if i % 10 == 0:
                print("****************************++++++++++++++++++++++++++++++++*************************************\n" * 10)
                print("After %d training steps, loss on training batch is %g, total time in this 1000 steps is %s." % (step, loss_value, time.time() - start_time))
                #saver.save(sess, os.path.join(model_save_path, model_name), global_step = global_step)
                print("****************************++++++++++++++++++++++++++++++++*************************************\n" * 10)
                start_time = time.time()
def main():
    mnist = input_data.read_data_sets('MNIST_DATA/', one_hot= True)
    train(mnist)
 
if __name__ == "__main__":
    main()

本文主要講述了經典卷積神經網絡之LeNet-5網絡模型和遷移至昇騰D910的實現,希望大家快來動手操作一下試試看!


點擊關注,第一時間了解華為雲新鮮技術~

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※台北網頁設計公司全省服務真心推薦

※想知道最厲害的網頁設計公司"嚨底家"!

※新北清潔公司,居家、辦公、裝潢細清專業服務

※推薦評價好的iphone維修中心

新來的”大神”用策略模式把if else給”優化”了,技術總監說:能不能想好了再改?

本文來自作者投稿,原作者:上帝愛吃蘋果

目前在魔都,貝殼找房是我的僱主,平時關注一些 java 領域相關的技術,希望你們能在這篇文章中找到些有用的東西。個人水平有限,如果文章有錯誤還請指出,在留言區一起交流。

我想大家肯定都或多或少的看過各種“策略模式”的講解、佈道等等,這篇文章就是來好好“澄清”一下策略模式,並嘗試回答以下的問題:

1. 策略模式是如何優化業務邏輯代碼結構的?

2. 殺雞焉用宰牛刀?就是幾個if else場景我需要用到策略模式?!

3. 有沒有什麼更好的代碼結構來實現策略模式的嗎?

策略模式是如何優化業務邏輯代碼結構的?

要回答這個問題,我們還得先扒一扒策略模式的定義,從定義着手來理解它

策略模式的教科書定義

它的定義很精簡:一個類的行為或其算法可以在運行時更改。我們把它降維到代碼層面,用人話翻譯一下就是,運行時我給你這個類的方法傳不同的“key”,你這個方法會執行不同的業務邏輯。細品一下,這不就是 if else 乾的事嗎?

策略模式優化了什麼?

其實策略模式的核心思想和 if else如出一轍,根據不同的key動態的找到不同的業務邏輯,那它就只是如此嗎?

實際上,我們口中的策略模式其實就是在代碼結構上調整,用接口+實現類+分派邏輯來使代碼結構可維護性好點。

一般教科書上講解到接口與實現類就結束了,其他博客上會帶上提及分派邏輯。這裏就不啰嗦了。

小結一下,即使用了策略模式,你該寫的業務邏輯照常寫,到邏輯分派的時候,還是變相的if else。而它的優化點是抽象了出了接口,將業務邏輯封裝成一個一個的實現類,任意地替換。在複雜場景(業務邏輯較多)時比直接 if else 來的好維護些。

殺雞焉用宰牛刀?就是幾個if else場景我需要用到策略模式?!

我想小夥伴們經常有這樣的不滿,我的業務邏輯就3 4 行,你給我整一大堆類定義?有必要這麼麻煩嗎?我看具體的業務邏輯還需要去不同的類中,簡單點行不行。

其實我們所不滿的就是策略模式帶來的缺點:

1、策略類會增多

2、業務邏輯分散到各個實現類中,而且沒有一個地方可以俯視整個業務邏輯

針對傳統策略模式的缺點,在這分享一個實現思路,這個思路已經幫我們團隊解決了多個複雜if else的業務場景,理解上比較容易,代碼上需要用到Java8的特性——利用Map與函數式接口來實現。

直接show代碼結構:為了簡單演示一個思路,代碼用String 類型來模擬一個業務BO

其中:

  1. getCheckResult() 為傳統的做法

  2. getCheckResultSuper()則事先在Map中定義好了“判斷條件”與“業務邏輯”的映射關係,具體講解請看代碼註釋

/**
 * 某個業務服務類
 */
@Service
public class BizService {

    /**
     * 傳統的 if else 解決方法
     * 當每個業務邏輯有 3 4 行時,用傳統的策略模式不值得,直接的if else又顯得不易讀
     */
    public String getCheckResult(String order) {
        if ("校驗1".equals(order)) {
            return "執行業務邏輯1";
        } else if ("校驗2".equals(order)) {
            return "執行業務邏輯2";
        }else if ("校驗3".equals(order)) {
            return "執行業務邏輯3";
        }else if ("校驗4".equals(order)) {
            return "執行業務邏輯4";
        }else if ("校驗5".equals(order)) {
            return "執行業務邏輯5";
        }else if ("校驗6".equals(order)) {
            return "執行業務邏輯6";
        }else if ("校驗7".equals(order)) {
            return "執行業務邏輯7";
        }else if ("校驗8".equals(order)) {
            return "執行業務邏輯8";
        }else if ("校驗9".equals(order)) {
            return "執行業務邏輯9";
        }
        return "不在處理的邏輯中返回業務錯誤";
    }

    /**
     * 業務邏輯分派Map
     * Function為函數式接口,下面代碼中 Function<String, String> 的含義是接收一個Stirng類型的變量,返回一個String類型的結果
     */
    private Map<String, Function<String, String>> checkResultDispatcher = new HashMap<>();

    /**
     * 初始化 業務邏輯分派Map 其中value 存放的是 lambda表達式
     */
    @PostConstruct
    public void checkResultDispatcherInit() {
        checkResultDispatcher.put("校驗1", order -> String.format("對%s執行業務邏輯1", order));
        checkResultDispatcher.put("校驗2", order -> String.format("對%s執行業務邏輯2", order));
        checkResultDispatcher.put("校驗3", order -> String.format("對%s執行業務邏輯3", order));
        checkResultDispatcher.put("校驗4", order -> String.format("對%s執行業務邏輯4", order));
        checkResultDispatcher.put("校驗5", order -> String.format("對%s執行業務邏輯5", order));
        checkResultDispatcher.put("校驗6", order -> String.format("對%s執行業務邏輯6", order));
        checkResultDispatcher.put("校驗7", order -> String.format("對%s執行業務邏輯7", order));
        checkResultDispatcher.put("校驗8", order -> String.format("對%s執行業務邏輯8", order));
        checkResultDispatcher.put("校驗9", order -> String.format("對%s執行業務邏輯9", order));
    }

    public String getCheckResultSuper(String order) {
        //從邏輯分派Dispatcher中獲得業務邏輯代碼,result變量是一段lambda表達式
        Function<String, String> result = checkResultDispatcher.get(order);
        if (result != null) {
            //執行這段表達式獲得String類型的結果
            return result.apply(order);
        }
        return "不在處理的邏輯中返回業務錯誤";
    }
}

通過http調用一下看看效果:

/**
 * 模擬一次http調用
 */
@RestController
public class BizController {

    @Autowired
    private BizService bizService;

    @PostMapping("/v1/biz/testSuper")
    public String test2(String order) {
        return bizService.getCheckResultSuper(order);
    }
}

這是個簡單的demo演示,之後會舉一些複雜的場景案例。

魯迅曾說過,“每解決一個問題,就會因出更多的問題”。我們一起來看看這樣的實現有什麼好處,會帶來什麼問題。

好處很直觀:

  1. 在一段代碼里直觀的看到”判斷條件”與業務邏輯的映射關係
  2. 不需要單獨定義接口與實現類,直接使用現有的函數式接口(什麼?不知道函數式接口?快去了解),而實現類直接就是業務代碼本身。

不好的點:

  1. 需要團隊成員對lambda表達式有所了解(什麼?Java14都出來了還有沒用上Java8新特性的小夥伴?)

接下來我舉幾個在業務中經常遇到的if else場景,並用Map+函數式接口的方式來解決它

在真實業務場景問題的解決思路

有的小夥伴會說,我的判斷條件有多個啊,而且很複雜,你之前舉個例子只有單個判斷邏輯,而我有多個判斷邏輯該怎麼辦呢?

很好解決:寫一個判斷邏輯的方法,Map的key由方法計算出

/**
 * 某個業務服務類
 */
@Service
public class BizService {

    private Map<String, Function<String, String>> checkResultDispatcherMuti = new HashMap<>();

    /**
     * 初始化 業務邏輯分派Map 其中value 存放的是 lambda表達式
     */
    @PostConstruct
    public void checkResultDispatcherMuitInit() {
        checkResultDispatcherMuti.put("key_訂單1", order -> String.format("對%s執行業務邏輯1", order));
        checkResultDispatcherMuti.put("key_訂單1_訂單2", order -> String.format("對%s執行業務邏輯2", order));
        checkResultDispatcherMuti.put("key_訂單1_訂單2_訂單3", order -> String.format("對%s執行業務邏輯3", order));
    }

    public String getCheckResultMuti(String order, int level) {
        //寫一段生成key的邏輯:
        String ley = getDispatcherKey(order, level);

        Function<String, String> result = checkResultDispatcherMuti.get(ley);
        if (result != null) {
            //執行這段表達式獲得String類型的結果
            return result.apply(order);
        }
        return "不在處理的邏輯中返回業務錯誤";
    }

    /**
     * 判斷條件方法
     */
    private String getDispatcherKey(String order, int level) {
        StringBuilder key = new StringBuilder("key");
        for (int i = 1; i <= level; i++) {
            key.append("_" + order + i);
        }
        return key.toString();
    }
}

用http模擬一下:

/**
 * 模擬一次http調用
 */
@RestController
public class BizController {

    @Autowired
    private BizService bizService;

    @PostMapping("/v1/biz/testMuti")
    public String test1(String order, Integer level) {
        return bizService.getCheckResultMuti(order, level);
    }
}

只要設計好你的key的生成規則就好。

還有小夥伴會問:我的業務邏輯有很多很多行,在checkResultDispatcherMuitInit()方法的Map中直接寫不會很長嗎?

直接寫當然長了,我們可以抽象出一個service服務專門放業務邏輯,然後在定義中調用它就好了:

提供一個業務邏輯單元:

/**
 * 提供業務邏輯單元
 */
@Service
public class BizUnitService {

    public String bizOne(String order) {
        return order + "各種花式操作1";
    }
    public String bizTwo(String order) {
        return order + "各種花式操作2";
    }
    public String bizThree(String order) {
        return order + "各種花式操作3";
    }
}
/**
 * 某個業務服務類
 */
@Service
public class BizService {
    @Autowired
    private BizUnitService bizUnitService;

    private Map<String, Function<String, String>> checkResultDispatcherComX = new HashMap<>();

    /**
     * 初始化 業務邏輯分派Map 其中value 存放的是 lambda表達式
     */
    @PostConstruct
    public void checkResultDispatcherComXInit() {
        checkResultDispatcherComX.put("key_訂單1", order -> bizUnitService.bizOne(order));
        checkResultDispatcherComX.put("key_訂單1_訂單2", order -> bizUnitService.bizTwo(order));
        checkResultDispatcherComX.put("key_訂單1_訂單2_訂單3", order -> bizUnitService.bizThree(order));
    }

    public String getCheckResultComX(String order, int level) {
        //寫一段生成key的邏輯:
        String ley = getDispatcherComXKey(order, level);

        Function<String, String> result = checkResultDispatcherComX.get(ley);
        if (result != null) {
            //執行這段表達式獲得String類型的結果
            return result.apply(order);
        }
        return "不在處理的邏輯中返回業務錯誤";
    }

    /**
     * 判斷條件方法
     */
    private String getDispatcherComXKey(String order, int level) {
        StringBuilder key = new StringBuilder("key");
        for (int i = 1; i <= level; i++) {
            key.append("_" + order + i);
        }
        return key.toString();
    }
}

調用結果:

總結

最後,我們一起嘗試回答以下幾個問題:

1. 策略模式是如何優化業務邏輯代碼結構的?

抽象了出了接口,將業務邏輯封裝成一個一個的實現類,任意地替換。在複雜場景(業務邏輯較多)時比直接 if else 來的好維護些。

2. 殺雞焉用宰牛刀?就是幾個if else場景我需要用到策略模式?!

我們所不滿的其實就是傳統接口實現的缺點: 1、策略類會很多。 2、業務邏輯分散到各個實現類中,而且沒有一個地方可以俯覽整個業務邏輯

3. 有沒有什麼更好的代碼結構來實現策略模式的嗎?

針對傳統策略模式的缺點,分享了利用Map與函數式接口來實現的思路。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※台北網頁設計公司這麼多該如何選擇?

※智慧手機時代的來臨,RWD網頁設計為架站首選

※評比南投搬家公司費用收費行情懶人包大公開

※幫你省時又省力,新北清潔一流服務好口碑

※回頭車貨運收費標準