工信部:新能源汽車今年將翻番 騙補企業要嚴處

全國“兩會”期間,新能源車產業的發展受到更多關注。

騙補調查取得成果

在全國“兩會”的“部長通道”,苗圩接受媒體採訪時表示,已經發現一些地區個別企業存在騙補行為,現在還在進一步查處,無論涉及到誰都會嚴肅處理。值得注意的是,這距離工信部宣佈對新能源車騙補行為進行調查不足兩個月。

新能源汽車2016年保持一倍以上增長

在公佈新能源車產業騙補調查進度的同時,對於新能源車在2016年的發展情況,苗圩認為,中國新能源車目前已經進入成長期,同時也代表著汽車產業調整的方向。“新能源汽車將保持高增長態勢,預計今年有一倍以上的增長。”苗圩說。

中國汽車工業協會發佈的資料顯示,2015年我國生產新能源汽車約34萬輛,銷售約33萬輛,同比分別增長3.3倍、3.4倍。

另外,在車企方面,自主品牌、合資品牌等都開始重視新能源車車型的研發和生產。根據汽車集團此前發佈的“十三五”規劃顯示,上汽集團未來五年新能源業務將新增投入200億元,新能源車目標銷量為60萬輛;廣汽集團則到2020年新能源汽車產銷規模力爭突破20萬輛;奇瑞汽車力爭新能源汽車到2020年產銷規模達到20萬輛。

面臨兩個瓶頸

苗圩認為,在新能源車保持高速發展的同時,目前新能源汽車仍面臨兩個瓶頸,“一是產品端,要集中攻克以動力電池為代表的產品性能、可靠性、續航里程、壽命等難題;二是應用端,要重視社會充電設施建設等”。苗圩表示。

2月24日,國務院常務會議就提出,動力電池核心技術的研發與政府獎勵掛鉤以及引入社會資本構建新能源車基礎設施等幫助新能源車產業發展的新措施。

具體而言,中央財政採取以獎代補方式,根據動力電池性能、銷量等指標對企業給予獎勵,加大對動力電池數位化製造成套裝備的支援。另外,國家還將利用中央預算內投資和配電網專項金融債等支持各地充電設施建設,鼓勵地方建立以充電量為基準的獎勵補貼政策,減免充電服務費用。

文章來源:北京商報

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※台灣海運大陸貨務運送流程

※兩岸物流進出口一站式服務

電動機車 Gogoro 與時尚結合,邀請派對潮男試乘

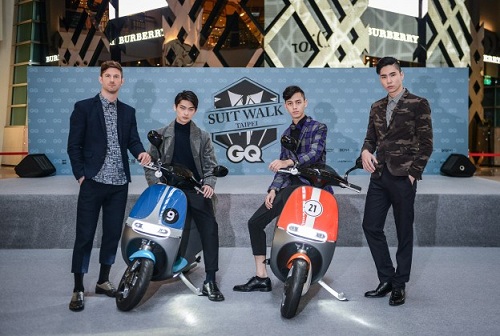
先前在媒體上熱烈討論的電動車 Gogoro 繼續以生活品味為主打形象,這次與時裝雜誌的活動結合,試圖要把騎機車這件事事情變得更潮。Gogoro 獲邀參與 GQ 紳裝正義 2016 SUIT WALK 遊行與派對活動。

為響應 GQ 派對主題,Gogoro 也舉辦「紳士有禮」體驗,只要消費者在 Taipei 101 四樓 Gogoro 展區完成最新智慧解鎖、拍照分享後即可獲得神秘限定騎乘邀請函,現場亦可索取潮男限定試騎卷,憑卷在 3 月 14 日白色情人節到 Gogoro 信義全球體驗中心試騎,即可獲得 Gogoro 限量潮 T 一件,數量有限敬請把握!   Gogoro 執行長暨創辦人陸學森表示:「Gogoro 非常榮幸可以成為這次時尚盛會中唯一的二輪交通品牌,我們希望鼓勵無論男性女性,時時刻刻都用各式方式展現自己的風格,例如 Smartscooter® 智慧雙輪可以讓消費者更換不同設計的面板,也是希望突破機車只是交通工具的想像,讓智慧雙輪不僅可以帶你帥氣的在城市間遊走、也可以透過不同的面板造型與設計,讓車主展現你獨一無二的個人風格。」  

 
▲ 全球最時尚大叔 Nick Wooster 稱讚 Gogoro 智慧雙輪時尚外型最合紳士出遊。(Source:Gogoro)   紳裝正義活動到 2016 年已經是第三屆舉行,從 2014 年開始主辦人就串連台灣、香港、新加坡與上海等亞洲時尚重地,邀請所有的型男紳士在每年白色情人節期間,穿上最時尚、最具個人風格的西裝到街頭遊行展現紳士魅力。此次 Gogoro 除了是唯一受邀參加遊行的交通工具品牌之外,遊行後也與其他時尚品牌如 Porches、HUGO BOSS、瑞士頂級 Zenith 真力時手錶等,於 Taipei 101 四樓參與 GQ 紳裝正義派對,在現場展現如何透過科技時尚魅力、展現自我風格。  

▲ 時尚男孩小杰帶領 Gogoro 型男軍團參與 GQ 紳裝正義遊行。(Source:Gogoro)   (首圖說明:Gogoro 型男軍團參與GQ SUIT WALK 2016 於台北101時尚派對。Source:Gogoro)   (本文授權轉載自《》─〈〉)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包”嚨底家”

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※小三通海運與一般國際貿易有何不同?

※小三通快遞通關作業有哪些?
寶馬 i 系電動車2015年全年銷量為29513輛

近日,寶馬集團發佈了寶馬 2015年的財報, 2015年,寶馬集團銷量達到2,247,485輛,同比增長6.1%。(2014年:2,117,965輛)。

2015年,BMW品牌全球銷量增長5.2%,至1,905,234輛(2014年:1,811,719輛)。其中,BMW 2系、4系以及BMW X家族表現突出,促進了銷量增長。

另外要提一下寶馬的新能源車型 BMW i 系,該車型實現了65.9%的增長,共交付客戶29,513輛(2014年:17,793輛),其中,BMW i3在全球範圍的銷量增幅為49.9%,共售出24,057輛(2014年:16,052輛),BMW i8銷量達到5,456輛(2014年:1,741輛)。

寶馬其他車型銷量還包括 MINI 品牌:交付量增長 12.0%,達338,466 輛(2014年:302,183 輛);勞斯萊斯:全球共交付客戶3,785輛,其中魅影和古斯特對銷量做出最大貢獻。另外,2015寶馬集團的全球前四大市場是中國、美國、德國和英國。

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

※小三通物流營運型態?

※快速運回,大陸空運推薦?

聯合國出臺國際標準 規範電動車需發出與汽油車同等音量

日前,聯合國在日內瓦的歐洲總部召開會議,討論有關行車安靜的電動汽車(EV)等靠近行人時用聲音提醒的通知裝置,通過了主要內容為規定需發出與汽油車同等音量的安全標準方案。

有關行車聲音通知裝置的討論由“聯合國世界車輛法規協調論壇”展開。尤其將加強針對老年人和兒童的安全措施。通知裝置的標準基於日本車商的技術而制定。

通知裝置的人工聲音會在汽車啟動時到時速達到20公里之間發出。原則上時速為10公里時發出50到75分貝的聲音,時速20公里時為56到75分貝。倒車時為47分貝以上的音量,設定足夠引起路人注意的音量。

通常認為,汽油車在掛空擋時也會發出50分貝左右的噪音。人工聲音的音量也是按照該水準設定的。據悉,若時速超過20公里,即使是EV也會發出55分貝以上的噪音。

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※台灣寄大陸海運貨物規則及重量限制?

※大陸寄台灣海運費用試算一覽表

※台中搬家,彰化搬家,南投搬家前需注意的眉眉角角,別等搬了再說!

蘋果電動車傳2021年問世、定價7.5萬美元

蘋果跨足電動車市場傳言甚囂塵上,投資機構Piper Jaffray資深分析師Gene Munster預測,蘋果將循設計、代工模式開發電動車,預計五年後也就是2021年上路。

蘋果電動車專案代號傳為「Titan」,Munster估計該電動車每輛定價約7.5萬美元,雖然全由蘋果設計,但生產製造有八成都將委外代工。

年初有報導指出,蘋果電動車計畫的幕後推手薩德斯基(Steve Zadesky)可能離職,即便如此,Munster仍舊看好蘋果電動車成功的機率超過五成,畢竟蘋果有錢、有人還有廣大粉絲做後盾。

據AppleInsider報導,蘋果電動車員工人數今年已膨脹至逾1千人,但可能也就是因為擴編速度太快,造成薩德斯基飯碗不保。

基本上,Munster認為電動車幾乎是營收成長動能的保證,因此蘋果不太可能放棄,最快2019、2020年應該會有初步產品展出。

(本文內容由授權提供)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※大陸寄台灣空運注意事項

※大陸海運台灣交貨時間多久?

※避免吃悶虧無故遭抬價!台中搬家公司免費估價,有契約讓您安心有保障!

現代起亞計畫投研發汽車版 AlphaGo

近日,韓國圍棋傳奇人物李世石與Google公司人工智慧「AlphaGo」進行的人機大戰引發矚目。韓國車企表示,擬研發汽車版「AlphaGo」。

據韓國SBS電視台報導,為在2020年推出自動駕駛系統,現代起亞汽車將在研發自動駕駛系統方面投入共2萬億韓元。現代起亞汽車宣佈,自動駕駛汽車將在5年內上市。

目前賓士等公司也正在研發自動駕駛汽車,哪家企業率先面市自動駕駛汽車備受關注。

分析認為,人工智慧和汽車行業結合起來的落地前景無限,無人駕駛要求更多,隨時處理多因數事件。鑒於目前現代起亞汽車技術情況,2020年推出的自動駕駛汽車雖不完美,但可以接近完成。

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※專營大陸空運台灣貨物推薦

※台灣空運大陸一條龍服務

※評比彰化搬家公司費用,南投搬家公司費用收費行情懶人包大公開

※彰化搬家費用,南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

Zabbix-(三)監控主機CPU、磁盤、內存並創建監控圖形

Zabbix-(三)監控主機CPU、磁盤、內存並創建監控圖形

一.前言

前文中已經講述了兩種方式對Zabbix的搭建,本文將講述如何在zaibbx上添加需要監控的主機,以及使用Zabbix自帶模板和自定義模板對主機的CPU、磁盤、內存進行監控,並觸發問題,並且在Zabbix儀錶盤創建實時監控圖形。

準備

  • Zabbix Server (Zabbix 4.4) (ip:192.168.152.140)
  • 被監控主機A (Centos7.6),下文簡稱 Server-A (ip:192.168.152.142)
  • 被監控主機B (Centos7.6),下文簡稱 Server-B (ip:192.168.152.143)

二.為被監控主機安裝zabbix-agent

  1. Server-A、Server-B分別安裝zabbix-agent

    # rpm -Uvh https://repo.zabbix.com/zabbix/4.4/rhel/7/x86_64/zabbix-release-4.4-1.el7.noarch.rpm
    
    # yum install -y zabbix-agent

  2. Server-A、Server-B配置zabbix-agent

    # vim /etc/zabbix/zabbix_agentd.conf

    修改以下配置:

    • Server-A的zabbix_agentd.conf
    Server=192.168.152.140
    ServerActive=192.168.152.140
    
    # Hostname要與在Zabbix界面配置的Hostname(主機名稱)保持一致
    Hostname=Server-A
    • Server-B的zabbix_agentd.conf
    Server=192.168.152.140
    ServerActive=192.168.152.140
    
    # Hostname要與在Zabbix界面配置的Hostname(主機名稱)保持一致
    Hostname=Server-B

  3. 分別啟動zabbix-agent

    # systemctl start zabbix-agent

    可以查看agent日誌

    # tailf /var/log/zabbix/zabbix_agentd.log

    可能會出現以下內容,是由於zabbix界面上沒有配置主機,接下來將在zabbix頁面上進行主機配置

      6981:20191030:111132.151 no active checks on server [192.168.152.140:10051]: host [Server-A] not found

三.Zabbix添加主機

通過頁面操作,將需要監控的主機添加到zabbix中

  1. 登錄Zabbix,默認賬號:Zabbix,默認密碼:admin (可在zabbix數據庫 users表查詢)

  2. 點擊【配置】-【主機】-【創建主機】,添加需要被監控的主機

    首先配置【主機】信息,添加Server-A,輸入配置項

    配置項 值
    * 主機名稱 Server-A
    可見的名稱 Server-A
    * 群組 Linux servers (進行選擇)
    * agent代理程序的接口 IP地址: 192.168.152.142 端口: 10050

    再配置【模板】信息,點擊【添加】,選擇群組 Templates,勾選 Template OS Linux by Zabbix agent,點擊【選擇】

    最後點擊【保存】

  3. 在【主機】頁面可以看到Server-A已經成功添加了

    同時,Server-A的zabbix-agent日誌也不再打印

    注: 由於在之前在安裝Zabbix server時,也在zabbix server上安裝了zabbix-agent,因此圖例上除了Server-A主機以外,還有zabbix server主機

  4. 通過全克隆添加主機Server-B

    選擇需要複製的主機Server-A

    點擊【全克隆】(full clone)

    修改主機名稱、agent IP地址等信息

    修改配置項 值
    *主機名稱 Server-B
    *agent IP 192.168.152.143

    最後點擊【添加】,等待Server-B與zabbix server建立通信

四.創建自定義模板(Template)

在添加主機步驟中,添加了2台需要監控的主機,添加監控項時也可以給每台主機單獨添加監控項,但是隨着主機數量增多,就會出現過多重複的操作,因此可以使用zabbix的Templates(模板)將Items(監控項和Triggers(觸發器)等眾多配置定義在模板中,將主機鏈接到定義好的模板上,就可以免去重複的操作。

下面將自定義模板,定義監控磁盤剩餘空間監控項,並配置觸發器當磁盤剩餘空間低於一定閾值時觸發告警。

  1. 創建自定義模板

    點擊【配置】-【模板】-【創建模板】

  2. 輸入模板信息,完成後點擊【添加】

    配置項 值
    * 模版名稱 Template Disk Free Size
    可見的名稱 Template Disk Free Size
    * 群組 Linux servers (選擇)
    描述 自定義磁盤剩餘空間模板

    注: 讀者也可以自定義一個群組,並在自定義群組中創建模板,這個步驟本文不再示範

五.創建磁盤剩餘空間監控項和觸發器

  1. 創建自定義磁盤監控項(Item)

    進入自定義模板的監控項模塊

    點擊【創建監控項】

    輸入監控參數

    配置項 值
    * 名稱 磁盤剩餘空間監控項
    類型 Zabbix 客戶端
    * 鍵值 vfs.fs.size[/,free]
    單位 B
    ……其他配置項 根據需要填寫

    這裏的鍵值 vfs.fs.size[/,free]是指,監控根路徑下,空餘的磁盤大小

    點擊【添加】

    注:創建監控項(Items)可以參考, 更多的鍵值(Keys)可以參考

  2. 創建觸發器(Trigger)

    觸發器可以配置當監控項監控到的數據達到一定閾值,從而觸發問題。

    在Template Disk Free Size模板中選擇【觸發器】,點擊【創建觸發器】

    輸入觸發器參數

    配置項 值
    * 名稱 磁盤剩餘空間觸發器
    嚴重性 嚴重(選擇)
    * 表達式/問題表現形式 {Template Disk Free Size:vfs.fs.size[/,free].last()}<15000000000 (可通過選擇監控項)
    事件成功迭代 恢復表達式(選擇)
    * 恢復表達式 {Template Disk Free Size:vfs.fs.size[/,free].last()}>=15000000000
    問題事件生成模式 多重(選擇)

    表達式/問題表示形式

    選擇已配置的磁盤剩餘空間監控項

    配置結果 < 15000000000, 監控項中單位為B,這裏15GB換算成15000000000B

    點擊【插入】,可以看到如下錶達式,表達式意思是,當檢測到磁盤弓箭剩餘不足15GB時,將觸發問題

    {Template Disk Free Size:vfs.fs.size[/,free].last()}<15000000000

    因此可以直接輸入問題恢復表達式,即磁盤剩餘空間高於15GB時,恢復問題

    {Template Disk Free Size:vfs.fs.size[/,free].last()}>=15000000000

    點擊【添加】

    再將該自定義模板,鏈接到Server-A、Server-B主機的模板中,參考,不過在篩選模板時,群組要選擇Linux servers(與創建模板時群組保持一致),添加後點擊【更新】

    進入【配置】-【主機】-【Server-A】(或者 Server-B)-【監控項】中,可以搜索到磁盤剩餘空間監控項已經添加成功

    注:如果監控項狀態不為【已啟動】可以查看zabbix server日誌進行排查

  3. 測試一下

    當前Server-A主機磁盤剩餘空間,為15G

    上傳一些文件到Server-A,此時磁盤剩餘空間為14G

    等待Zabbix監控到Server-A磁盤變化,查看儀錶盤,出現問題,配置成功

    刪除Server-A大文件,等待Zabbix監控到主機磁盤恢復,儀錶盤問題恢復

六.監控CPU空閑率

在添加主機時,由於已經鏈接了模板(該模板還鏈接了Template Module Linux CPU by Zabbix agent等若干個其他模板),Template Module Linux CPU by Zabbix agent模板自帶了許多監控項,其中包括CPU idle time 監控項,因此可以直接使用該監控項監控主機CPU空閑率數值,無需自定義監控項,只需要添加一個觸發器(Trigger)來讀取監控項觸發告警即可。

注: zabbix自帶模板中,有許多監控項可以直接利用起來,無需再單獨創建監控項,使用時可先在已有模板中查找下可用的監控項。

  1. 使用自帶模板中監控項

    直接使用CPU idle time 監控項即可,可以在【配置】-【主機】,【Server-A】的【監控項】中搜索到該監控項(在下圖中可以看到該監控項鏈接了模板)

  2. 在已有模板中添加觸發器(trigger)

    這裡在模板Template Module Linux CPU by Zabbix agent添加一個觸發器。

    點擊【配置】-【模板】搜索模板Template Module Linux CPU by Zabbix agent,並進入【觸發器】配置

    創建觸發器操作流程參考上面步驟中的,這裏說明一下配置參數

    配置項 值
    * 名稱 CPU空閑率觸發器
    嚴重性 嚴重 (選擇)
    表達式/問題表現式 {Template Module Linux CPU by Zabbix agent:system.cpu.util[,idle].avg(5m)}>=80
    事件成功迭代 恢復表達式(選擇)
    * 恢復表達式 {Template Module Linux CPU by Zabbix agent:system.cpu.util[,idle].avg(5m)}<80

    表達式/問題表現式:表示在5分鐘內CPU平均空閑率如果高於80%,那麼將觸發問題

    添加表達式示例:

    system.cpu.util[,idle]官方說明

    注:這裏修改了zabbix自帶的模板(Template Module Linux CPU by Zabbix agent),為其添加了一個新的觸發器,在實際使用中,要謹慎操作,因為鏈接了該模板的主機觸發器都會被修改,因此實際使用中需要對這種操作進行評估。

  3. 測試一下

    等待5分鐘,Zabbix server、Server-A、Server-B的CPU空閑率都高於80%,Dashboard界面觸發了問題,由於Zabbix server主機也鏈接了模板,因此修改Template Module Linux CPU by Zabbix agent模板,Zabbix server的CPU空閑率也被監控,所以在修改模板時要。

七.監控內存佔用率

在上面的步驟中添加了磁盤剩餘空間、CPU空閑率監控,直接使用了Zabbix 客戶端類型的監控項的鍵值,但是有些監控項可能不能直接獲取,需要通過計算的方式來獲取,例如監控內存佔用率,雖然可以使用vm.memory.size這個鍵值,但是得到值並不是我們所期望的,參考下面官方的解釋,雖然mode中有pused (used, percentage),但是“used”=”total – free” 而 “available”=”free + buffers + cached”(內核版本Linux<3.14),實際是想要的值:

(available - total) / total

因此需要使用可計算的鍵值類型

官方對vm.memory.size以及參數解釋:

​

  1. 在Template OS Linux by Zabbix agent模板新增監控項

    配置項 值
    * 名稱 內存佔用率監控項
    類型 可計算的
    * 鍵值 memory.utilization (自定義)
    * 公式 100*(last(“vm.memory.size[total]”)-last(“vm.memory.size[available]”))/last(“vm.memory.size[total]”)
    信息類型 浮點數
    單位 %
    ……其他配置項 默認即可

    自定義鍵值可自己輸入,具體規則參考官方

這裏就不再創建觸發器了,感興趣的讀者可以自行創建,可參考上面的

八.Dashboard創建圖形

可以在首頁儀錶盤裡創建圖形,實時查看監控項的數據值。

  1. 回到zabbix首頁,點擊【編輯儀錶盤】-【添加構件】

  2. 創建磁盤剩餘空間圖形

    輸入基本信息

    添加【主機】和【監控項】

    左邊一欄選擇主機Server-A,右邊一欄選擇Server-A的磁盤監控項

    ​

    再【添加新數據集】,同樣操作將Server-B的磁盤監控也添加到圖形中

  3. 添加CPU空閑率圖形

    按照,添加Server-A,Server-B的CPU空閑率圖形

  4. 添加內存佔用率圖形

    同樣按照,添加Server-A,Server-B的內存佔用率圖形

  5. 保存設置並在儀錶盤中查看

    點擊【保存設置】

    在儀錶盤頁面查看圖形

九.參考文檔

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步”網站設計“幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※試算大陸海運運費!

Windows下編譯最新版ChezScheme

    據說ChezScheme是最快的神級編譯器,一秒鐘幾百萬行,王垠說的2秒內編譯自身絕不是誇張(看這裏《》,Scheme中文社區)。ChezScheme由美國印第安納大學的Kent Dybvig博士發明,後來賣給了思科CISCO,作為內部絕密的編譯器工具來運行苛刻的計算任務,現在已經開源,倉庫地址是。有關如何開始使用Chez Scheme,請看官方的文檔:,有關Scheme的使用入門,這裏推薦一本中文翻譯的《》,這是一本面向初學者的溫和且循序漸進的Scheme教程。目標讀者是僅有些許編程經驗的PC用戶。

    下面來介紹下截止到2019.11.19日的最新版如何在Windows下編譯一個ChezScheme,其它環境下如何編譯請看源碼下的文件BUILDING的介紹:Building Chez Scheme Version 9.5.3。請注意這個版本號,之前的版本編譯方法可能與本文介紹的不同,本人也為此踩坑了不少時間。

1,首先,安裝Visual Studio 2015/2017,注意必須選擇按照Visual C++ 桌面開發組件,否則你在最後一步無法編譯Scheme。

2,安裝msys2,這是一個Windows下的Linux Shell環境,可以讓你在Windows上使用Linux命令,並且它還自帶包管理功能。安裝完後按照官網提示更新下msys2,會給你安裝一堆組件,默認都安裝。

3,打開Visual Studio命令提示符,選擇“vs2015 x64 native tools command prompt”,vs2017類似,中文名稱是“適用於VS2017的本機命令工具提示”。

4,在上面的Visual Studio命令提示工具裏面,輸入c:\msys64\msys2_shell.cmd,打開msys2的命令提示窗口。

5,在msys2裏面安裝GCC編譯工具和Git工具,如果Git已經安裝跳過。

pacman -S gcc base- devel
pacman -S git


6,下載Chez Scheme源碼,然後進行編譯前配置,最後編譯。如果源碼已經下載跳過。

git clone https: // github.com/cisco/ChezScheme.git 
cd ChezScheme
cd wininstall
make workareas
 make


7,最後等make完成,我們在ChezScheme目錄a6nt\bin\a6nt 下可以看到scheme.exe,雙擊它即可運行。

8,將a6nt目類下的bin目錄和boot目錄都複製到一個新建的build目錄下,然後創建一個run.bat 文件,文件內容如下:

@ECHO  off 
ECHO Chez Scheme for Windows. make by bluedoctor. 2019.11.18 
bin \a6nt\scheme.exe

build目錄的文件結構如下:

E:\ChezScheme\build\ChezScheme>dir /s
 驅動器E 中的捲是LENOVO
 卷的序列號是E2D7-2E41

 E:\ChezScheme\build\ChezScheme 的目錄

2019/11/18 23:23 <DIR> .
2019/11/18 23:23 <DIR> ..
2019/11/18 23:23 <DIR> bin
2019/11/18 23:19 <DIR> boot
2019/11/19 10:38 94 run.bat
               1 個文件94 字節

 E:\ChezScheme\build\ChezScheme\bin 的目錄

2019/11/18 23:23 <DIR> .
2019/11/18 23:23 <DIR> ..
2019/11/18 23:19 <DIR> a6nt
               0 個文件0 字節

 E:\ChezScheme\build\ChezScheme\bin\a6nt 的目錄

2019/11/18 23:19 <DIR> .
2019/11/18 23:19 <DIR> ..
2019/11/18 20:25 764,928 csv953.dll
2019/11/18 20:25 7,102 csv953.exp
2019/11/18 20:25 1,581,688 csv953.ilk
2019/11/18 20:25 12,368 csv953.lib
2019/11/18 20:25 2,084,864 csv953.pdb
2019/11/18 20:25 112,640 scheme.exe
2019/11/18 20:25 430,080 scheme.pdb
               7 個文件4,993,670 字節

 E:\ChezScheme\build\ChezScheme\boot 的目錄

2019/11/18 23:19 <DIR> .
2019/11/18 23:19 <DIR> ..
2019/11/18 23:19 <DIR> a6nt
               0 個文件0 字節

 E:\ChezScheme\build\ChezScheme\boot\a6nt 的目錄

2019/11/18 23:19 <DIR> .
2019/11/18 23:19 <DIR> ..
2019/11/18 20:25 2,751,464 csv953md.lib
2019/11/18 20:25 2,564,910 csv953mt.lib
2019/11/18 17:14 36,556 equates.h
2019/11/18 20:24 27,609 mainmd.obj
2019/11/18 20:25 25,538 mainmt.obj
2019/11/18 17:14 1,624,450 petite.boot
2019/11/18 17:14 982,321 scheme.boot
2019/11/18 17:14 8,675 scheme.h
2019/11/18 20:24 92,444 scheme.res
               9 個文件8,113,967 字節

     所列文件總數:
              17 個文件13,107,731 字節
              14 個目錄514,061,447,168 可用字節

9,最後運行run.bat文件,就可以看到期待已久的Chez Scheme了:

Chez Scheme for Windows. make by bluedoctor. 2019.11.18
Chez Scheme Version 9.5.3
Copyright 1984-2019 Cisco Systems, Inc.

> (+ 1 2 3 4 5 6 7 8 9 10)
55
> (/ 1 3)
1/3
>


10,上面是在Chez Scheme運行的簡單Scheme程序,第一行代碼運行的是一個累加多個自然數的程序,如果用C#,需要一個List<int>變量來存儲列表數據,然後循環處理,代碼量要多好幾行。第二行Scheme代碼,它的結果直接以分數表示了,很高級。

有關Scheme更多的程序介紹,請看本文推薦的學習鏈接。如果你不想這麼麻煩的自己來編譯,也可以考慮直接使用給予.NET DLR的IronScheme,具體請看我原來的文章:《》。

如果你不想編譯或者安裝任何一個Scheme程序,但又想看看Scheme是什麼樣子,推薦訪問下面的網址,它提供了一個Web版本的Scheme編譯運行環境:


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※專營大陸快遞台灣服務

※台灣快遞大陸的貨運公司有哪些呢?

Java 讀取Word批註中的文本和圖片

本文將介紹讀取Word批註的方法,包括讀取Word批註中的文本及圖片。關於操作Word批註的方法還可以參考這兩篇文章:;。下面將通過Java代碼來演示如何讀取批註。

工具使用: Word類庫(Free Spire.Doc for Java免費版)

Jar 文件獲取:可通過官網,下載後解壓文件,並將lib文件夾下的Spire.Doc.jar文件導入java程序;也可以通過Maven倉庫安裝導入,具體路徑配置及導入方法可以參考。

測試文檔如下:批註中包含文本和圖片


【示例1 】讀取批註中的文本

import com.spire.doc.* ;
 import com.spire.doc.documents.Paragraph;
 import com.spire.doc.fields.Comment;
 import com.spire.doc.fields.TextRange;

public  class ReadComment {
     public  static  void main(String[] args) {
         // 加載測試文檔 
        Document doc = new Document();
        doc.loadFromFile( "sample.docx" );

        // 實例化String類型變量 
        String text = "" ;

        // 遍歷所有批註
        for ( int i = 0;i< doc.getComments().getCount();i++ ){
            Comment comment = doc.getComments().get(i);
             // 遍歷所有批註中的段落
            for ( int j= 0;j < comment.getBody().getParagraphs().getCount();j++ ) {
                Paragraph paragraph = comment.getBody().getParagraphs().get(j);
                 // 遍歷段落中的對象
                for (Object object : paragraph.getChildObjects()) {
                     // 讀取文本
                    if (object instanceof TextRange) {
                        TextRange textRange = (TextRange) object;
                        text = text + textRange.getText();
                    }
                }
            }
        }
        // 輸入文本內容
        System.out.println(text);
    }
}

批註文本讀取結果:


【示例2 】讀取批註中的圖片

import com.spire.doc.* ;
 import com.spire.doc.documents.Paragraph;
 import com.spire.doc.fields.Comment;
 import com.spire.doc.fields.DocPicture;

import javax.imageio.ImageIO;
 import java.awt.image.RenderedImage;
 import java.io.File;
 import java.io.IOException;
 import java.util.ArrayList;


public  class ExtractImgsInComment {
     public  static  void main(String[] args) throws IOException{
         // 加載測試文檔 
        Document doc = new Document();
        doc.loadFromFile( "sample.docx" );

        // 創建ArrayList數組對象 
        ArrayList images = new ArrayList();

        // 遍歷所有批註
        for ( int i = 0;i< doc.getComments().getCount();i++ ){
            Comment comment = doc.getComments().get(i);
             // 遍歷所有批註中的段落
            for ( int j= 0;j < comment.getBody().getParagraphs().getCount();j++ ) {
                Paragraph paragraph = comment.getBody().getParagraphs().get(j);
                 // 遍歷段落中的對象
                for (Object object : paragraph.getChildObjects()) {
                     // 獲取圖片對象
                    if (object instanceof DocPicture){
                        DocPicture picture = (DocPicture) object;
                        images.add(picture.getImage());
                    }
                }
            }
        }
        // 提取圖片,並指定圖片格式
        for ( int z = 0; z< images.size(); z++ ) {
            File file = new File(String.format("圖片-%d.png" , z));
            ImageIO.write((RenderedImage) images.get(z), "PNG" , file);
        }
    }
}

批註圖片讀取結果:


(本文完)


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※台灣海運大陸貨務運送流程

※兩岸物流進出口一站式服務

java面試題-Java集合相關

1. ArrayList 和Vector 的區別

  ArrayList和Vector底層實現原理都是一樣得,都是使用數組方式存儲數據

  Vector是線程安全的,但是性能比ArrayList要低。

  ArrayList,Vector主要區別為以下幾點:

   (1):Vector是線程安全的,源碼中有很多的synchronized可以看出,而ArrayList不是。導致Vector效率無法和ArrayList相比;

      (2):ArrayList和Vector都採用線性連續存儲空間,當存儲空間不足的時候,ArrayList默認增加為原來的50%,Vector默認增加為原來的一倍;

   (3):Vector可以設置capacityIncrement,而ArrayList不可以,從字面理解就是capacity容量,Increment增加,容量增長的參數。


2.說說ArrayList,Vector, LinkedList 的存儲性能和特性

  ArrayList採用的數組形式來保存對象,這種方法將對象放在連續的位置中,所以最大的缺點就是插入和刪除的時候比較麻煩,查找比較快;

  Vector使用了sychronized方法(線程安全),所以在性能上比ArrayList要差些.

  LinkedList採用的鏈表將對象存放在獨立的空間中,而且在每個空間中還保存下一個鏈表的索引。使用雙向鏈表方式存儲數據,按序號索引數據需要前向或後向遍曆數據,所以索引數據慢,是插入數據時只需要記錄前後項即可,所以插入的速度快。


3.快速失敗(fail-fast) 和安全失敗(fail-safe) 的區別是什麼?

  1.快速失敗

  原理是:

        迭代器在遍歷時直接訪問集合中的內容,並且在遍歷過程中使用一個modCount變量。集合在被遍歷期間如果內容發生變化,就會改變modCount的值。每當迭代器使用hasNext()或next()遍歷下一個元素之前,都會先檢查modCount變量是否為expectmodCount值。如果是的話就返回遍歷;否則拋出異常,終止遍歷。

  查看ArrayList源碼,在next方法執行的時候,會執行checkForComodification()方法。


        @SuppressWarnings("unchecked")
        public E next() {
            checkForComodification();
            int i = cursor;
            if (i >= size)
                throw new NoSuchElementException();
            Object[] elementData = ArrayList.this.elementData;
            if (i >= elementData.length)
                throw new ConcurrentModificationException();
            cursor = i + 1 ;
             return (E) elementData[lastRet = i];
        }
        final  void checkForComodification() {
             if (modCount != expectedModCount)
                 throw  new ConcurrentModificationException();
        }

  這裏異常的拋出條件是modCount != expectedModCount這個條件。如果集合發生變化時修改modCount值剛好又設置為了expectedModCount值,則異常不會拋出。因此,不能依賴於這個異常是否拋出而進行併發操作,這個異常只建議用於檢測併發修改的bug。

  2.安全失敗

    採用安全失敗機制的集合容器,在遍歷時不是直接在集合上訪問的,而是先複製原有集合內容,在拷貝的集合上進行遍歷。

  原理:

          由於迭代時是對原集合的拷貝進行遍歷,所以在遍歷過程中對原集合所做的修改並不能被迭代器檢測到,所以不會觸發ConcurrentModificationException,例如CopyOnWriteArrayList。

  缺點:

          基於拷貝內容的優點是避免了ConcurrentModificationException,但同樣地,迭代器並不能訪問到修改後的內容。即:迭代器遍歷的是開始遍歷那一刻拿到的集合拷貝,在遍歷期間原集合發生的修改迭代器是不知道的。

  場景:

          Java.util.concurrent包下的容器都是安全失敗的,可以在多線程下併發使用,併發修改。

        快速失敗和安全失敗都是對迭代器而言的。快速失敗:當在迭代一個集合時,如果有另外一個線程在修改這個集合,就會跑出ConcurrentModificationException,java.util下都是快速失敗。安全失敗:在迭代時候會在集合二層做一個拷貝,所以在修改集合上層元素不會影響下層。在java.util.concurrent包下都是安全失敗。


4.HashMap 的數據結構

  HashMap的主幹類是一個Entry數組(jdk1.7) ,每個Entry都包含有一個鍵值隊(key-value).

  我們可以看一下源碼:

static  class Entry<K,V> implements Map.Entry<K,V> {
         final K key;
        V value;
        Entry <K,V> next; // 存儲指向下一個Entry的引用,單鏈表結構
        int hash; // 對key的hashcode值進行hash運算後得到的值,存儲在Entry,避免重複計算

        /**
         * Creates new entry.
         */ 
        Entry( int h, K k, V v, Entry<K,V> n) {
            value = v;
            next = n;
            key = k;
            hash = h;
        }

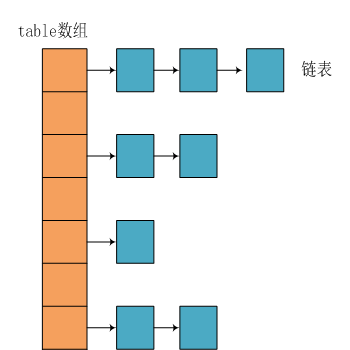
  所以,HashMap的整體結果如下


   簡單來說,HashMap由數組+鏈表組成的,數組是HashMap的主體,鏈表則是主要為了解決哈希衝突而存在的,如果定位到的數組位置不含鏈表(當前entry的next指向null ),那麼對於查找,添加等操作很快,僅需一次尋址即可;如果定位到的數組包含鏈表,對於添加操作,其時間複雜度為O(n),首先遍歷鏈表,存在即覆蓋,否則新增;對於查找操作來講,仍需遍歷鏈表,然後通過key對象的equals方法逐一比對查找。所以,性能考慮,HashMap中的鏈表出現越少,性能才會越好。


5.HashMap 的工作原理

  HashMap基於hashing原理,我們通過put()和get()方法存儲和獲取對象,當我們將鍵值對傳遞給put()方法時,它調用鍵對象的hashCode()方法來計算hashcode,讓後找到bucket位置來存儲值對象。當獲取對象時,通過鍵對象的equals()方法找到正確的鍵值對,然後返回對象。

  我們看一下put()源碼:

public V put(K key, V value) {
         // 當key為null,調用putForNullKey方法,保存null與table第一個位置中,這是HashMap允許為null的原因
        if (key == null )
             return putForNullKey( value);
         // 計算key的hash值
        int hash = hash(key.hashCode());                   // 計算key hash值在table數組中的位置
        int i = indexFor(hash, table.length);              // 從i出開始迭代e,找到key保存的位置
        for (Entry<K, V> e = table[i]; e != null ; e = e.next) {
            Object k;
            // 判斷該條鏈上是否有hash值相同的(key相同)
             // 若存在相同,則直接覆蓋value,返回舊value 
            if (e.hash == hash && ((k = e.key) == key || key.equals(k))) {
                V oldValue = e.value;     // 舊值=新值 
                e.value = value;
                e.recordAccess( this );
                 return oldValue;      // 返回舊值
            }
        }
        // 修改次數增加1 
        modCount++ ;
         // 將key、value添加至i位置處
        addEntry(hash, key, value, i);
         return  null ;
    }

  通過源碼我們可以清晰看到HashMap保存數據的過程為:首先判斷key是否為null,若為null,則直接調用putForNullKey方法。若不為空則先計算key的hash值,然後根據hash值搜索在table數組中的索引位置,如果table數組在該位置處有元素,則通過比較是否存在相同的key,若存在則覆蓋原來key的value,否則將該元素保存在鏈頭(最先保存的元素放在鏈尾)。若table在該處沒有元素,則直接保存。

  get()源碼: 

public V get(Object key) {
         // 若為null,調用getForNullKey方法返回相對應的value 
        if (key == null )
             return getForNullKey();
         // 根據該key的hashCode值計算它的hash碼   
        int hash = hash(key.hashCode());
         // 取出table數組中指定索引處的值
        for (Entry<K, V> e = table[indexFor(hash, table.length)]; e != null ; e = e .next) {
            Object k;
            // 若搜索的key與查找的key相同,則返回相對應的value 
            if (e.hash == hash && ((k = e.key) == key || key.equals(k)))
                 return e .value;
        }
        return  null ;
    }

  在這裡能夠根據key快速的取到value除了和HashMap的數據結構密不可分外,還和Entry有莫大的關係,在前面就提到過,HashMap在存儲過程中並沒有將key,value分開來存儲,而是當做一個整體key-value來處理的,這個整體就是Entry對象。同時value也只相當於key的附屬而已。在存儲的過程中,系統根據key的hashcode來決定Entry在table數組中的存儲位置,在取的過程中同樣根據key的hashcode取出相對應的Entry對象。


6.Hashmap 什麼時候進行擴容呢?

  這裏我們再來複習put的流程:當我們想一個HashMap中添加一對key-value時,系統首先會計算key的hash值,然後根據hash值確認在table中存儲的位置。若該位置沒有元素,則直接插入。否則迭代該處元素鏈表並依此比較其key的hash值。如果兩個hash值相等且key值相等(e.hash == hash && ((k = e.key) == key || key.equals(k))),則用新的Entry的value覆蓋原來節點的value。如果兩個hash值相等但key值不等,則將該節點插入該鏈表的鏈頭。具體的實現過程見addEntry方法,如下:

void addEntry( int hash, K key, V value, int bucketIndex) {
         // 獲取bucketIndex處的Entry 
        Entry<K, V> e = table[bucketIndex];
         // 將新創建的Entry放入bucketIndex索引處,並讓新的Entry指向原來的Entry 
        table[bucketIndex] = new Entry<K, V> (hash, key, value, e);
         // 若HashMap中元素的個數超過極限了,則容量擴大兩倍
        if ( size++ >= threshold)
            resize( 2 * table.length);
    }

  這個方法中有兩點需要注意:

      一是鏈的產生。這是一個非常優雅的設計。系統總是將新的Entry對象添加到bucketIndex處。如果bucketIndex處已經有了對象,那麼新添加的Entry對象將指向原有的Entry對象,形成一條Entry鏈,但是若bucketIndex處沒有Entry對象,也就是e==null,那麼新添加的Entry對象指向null ,也就不會產生Entry鏈了。

      二、擴容問題。

      隨著HashMap中元素的數量越來越多,發生碰撞的概率就越來越大,所產生的鏈表長度就會越來越長,這樣勢必會影響HashMap的速度,為了保證HashMap的效率,系統必須要在某個臨界點進行擴容處理。該臨界點在當HashMap中元素的數量等於table數組長度*加載因子。但是擴容是一個非常耗時的過程,因為它需要重新計算這些數據在新table數組中的位置並進行複製處理。所以如果我們已經預知HashMap中元素的個數,那麼預設元素的個數能夠有效的提高HashMap的性能。


 7.HashSet怎樣保證元素不重複

  都知道HashSet中不能存放重複的元素,有時候可以用來做去重操作。但是其內部是怎麼保證元素不重複的呢?

  打開HashSet源碼,發現其內部維護一個HashMap:

public  class HashSet<E> 
    extends AbstractSet <E> 
    implements Set <E> , Cloneable, java.io.Serializable
{
    static final long serialVersionUID = - 5024744406713321676L ;

    private transient HashMap<E,Object> map;

    private  static final Object PRESENT = new Object();

 
    public HashSet() {
        map = new HashMap<> ();
    } 
  ...
}

  HashSet的構造方法其實就是在內部實例化了一個HashMap對象,其中還會看到一個static final的PRESENT變量;

  想知道為什麼HashSet不能存放重複對象,那麼第一步看看它的add方法進行的判重,代碼如下

    public  boolean add(E e) {
         return map.put(e, PRESENT)== null ;
    }

  其實看add()方法,這時候答案已經出來了:HashMap的key是不能重複的,而這裏HashSet的元素又是作為了map的key,當然也不能重複了。

  順便看一下HashMap裏面又是怎麼保證key不重複的,代碼如下:

public V put(K key, V value) {
     if (table == EMPTY_TABLE) {
        inflateTable(threshold);
    }
    if (key == null )
         return putForNullKey(value);
     int hash = hash(key);
     int i = indexFor(hash, table.length);
     for (Entry<K,V> e = table[i]; e ! = null ; e = e.next) {
        Object k;
        if (e.hash == hash && ((k = e.key) == key || key.equals(k))) {
            V oldValue = e.value;
            e.value = value;
            e.recordAccess( this );
             return oldValue;
        }
    }

    modCount ++ ;
    addEntry(hash, key, value, i);
    return  null ;
}

  其中最關鍵的一句: 

if (e.hash == hash && ((k = e.key) == key || key.equals(k)))

  調用了對象的hashCode和equals方法進行判斷,所以又得到一個結論:若要將對象存放到HashSet中並保證對像不重複,應根據實際情況將對象的hashCode方法和equals方法進行重寫

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包”嚨底家”

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※小三通海運與一般國際貿易有何不同?

※小三通快遞通關作業有哪些?