【nodejs原理&源碼雜記(8)】Timer模塊與基於二叉堆的定時器

目錄

  • 一.概述
  • 二. 數據結構
    • 2.1 鏈表
    • 2.2 二叉堆
  • 三. 從setTimeout理解Timer模塊源碼
    • 3.1 timers.js中的定義
    • 3.2 Timeout類定義
    • 3.3 active(timeout)
    • 3.4 定時器的處理執行邏輯
    • 3.5 實例分析
  • 四. 小結

示例代碼託管在:http://www.github.com/dashnowords/blogs

博客園地址:《大史住在大前端》原創博文目錄

華為雲社區地址:【你要的前端打怪升級指南】

一.概述

Timer模塊相關的邏輯較為複雜,不僅包含JavaScript層的實現,也包括C++編寫的與底層libuv協作的代碼,想要完整地看明白是比較困難的,本章僅以setTimeout這個API的實現機製為主線,講述源碼中的JavaScript相關的實現部分,這部分只需要一些數據結構的基本知識就可以理解。

二. 數據結構

setTimeout這個API的實現基於兩類基本數據結構,我們先來複習一下相關的特點。對數據結構知識比較陌生的小夥伴可以參考【野生前端的數據結構基礎練習】系列博文自行學習,所有的章節都有示例代碼。

2.1 鏈表

鏈表是一種物理存儲單元上非連續的存儲結構,存儲元素的邏輯順序是由鏈表中的指針鏈接次序來決定的。每一個節點包含一個存放數據的數據域和存放下一個節點的指針域(雙向鏈表中指針數量為2)。鏈表在插入元素時的時間複雜度為O(1)(因為隻影響插入點前後的節點,無論鏈表有多大),但是由於空間不連續的特點,訪問一個未排序鏈表的指定節點時就需要逐個對比,時間複雜度為O(n),比數組結構就要慢一些。鏈表結構也可以根據指針特點分為單向鏈表,雙向鏈表和循環鏈表,Timer模塊中使用的鏈表結構就是雙向循環鏈表,Node.js中源碼的底層數據結構實現都是獨立的,鏈表的源碼放在lib/internal/linkedlist.js:

'use strict';

function init(list) {
  list._idleNext = list;
  list._idlePrev = list;
}

// Show the most idle item.
function peek(list) {
  if (list._idlePrev === list) return null;
  return list._idlePrev;
}

// Remove an item from its list.
function remove(item) {
  if (item._idleNext) {
    item._idleNext._idlePrev = item._idlePrev;
  }

  if (item._idlePrev) {
    item._idlePrev._idleNext = item._idleNext;
  }

  item._idleNext = null;
  item._idlePrev = null;
}

// Remove an item from its list and place at the end.
function append(list, item) {
  if (item._idleNext || item._idlePrev) {
    remove(item);
  }

  // Items are linked  with _idleNext -> (older) and _idlePrev -> (newer).
  // Note: This linkage (next being older) may seem counter-intuitive at first.
  item._idleNext = list._idleNext; //1
  item._idlePrev = list;//2

  // The list _idleNext points to tail (newest) and _idlePrev to head (oldest).
  list._idleNext._idlePrev = item;//3
  list._idleNext = item;//4
}

function isEmpty(list) {
  return list._idleNext === list;
}

鏈表實例初始化了兩個指針,初始時均指向自己,_idlePrev指針將指向鏈表中最新添加進來的元素,_idleNext指向最新添加進來的元素,實現的兩個主要操作為remove和append。鏈表的remove操作非常簡單,只需要將刪除項前後的元素指針加以調整,然後將被刪除項的指針置空即可,就像從一串鎖鏈中拿掉一節,很形象。

源碼中的idlePrev和idleNext很容易混淆,建議不用強行翻譯為“前後”或者“新舊”,(反覆記憶N次都記不住我也很無奈),直接按對應位置來記憶就可以了,愛翻譯成什麼就翻譯成什麼。

源碼中的鏈表實現並沒有提供指定位置插入的方法,append( )方法默認只接收list和item兩個參數,新元素會被默認插入在鏈表的固定位置,這與它的使用方式有關,所以沒必要實現完整的鏈表數據結構。append稍微複雜一些,但是源碼中也做了非常詳細的註釋。首先需要確保插入的元素是獨立的(也就是prev和next指針都為null),然後再開始調整,源碼中的鏈表是一個雙向循環鏈表,我們調整一下源碼的順序會更容易理解,其實插入一個元素就是要將各個元素的prev和next兩個指針調整到位就可以了。先來看_idlePrev指針鏈的調整, 也就是指針調整代碼中標記為2和3的語句:

item._idlePrev = list;//2
list._idleNext._idlePrev = item;//3

這裏可以把list看作是一個prev指針連接起來的單向鏈表,相當於將新元素item按照prev指針的指向添加到list和原本的list._idleNext指向的元素中間,而1和4語句是調整了反方向的next指針鏈:

item._idleNext = list._idleNext; //1
list._idleNext = item;//4

調整后的鏈表以next指針為依據就可以形成反方向的循環鏈表,然後只需要記住list._idleNext指針指向的是最新添加的項就可以了。

如上圖所示,next和prev分別可以作為鏈表的邏輯順序形成循環鏈。

2.2 二叉堆

源碼放在lib/internal/priority_queue.js中,一些博文也直接翻譯為優先隊列,它們是抽象結構和具體實現之間的關係,特性是一致的。二叉堆是一棵有序的完全二叉樹,又以節點與其後裔節點的關係分為最大堆和最小堆。完全二叉樹的特點使其可以很容易地轉化為一維數組來存儲,且不需要二外記錄其父子關係,索引為i的節點的左右子節點對應的索引為2i+1和2i+2(當然左右子節點也可能只有一個或都不存在)。Node.js就使用一維數組來模擬最小堆。源碼基本上就是這一數據結構和“插入”,“刪除”這些基本操作的實現。

堆結構的使用最主要的是為了獲得堆頂的元素,因為它總是所有數據里最大或最小的,同時堆結構是一個動態調整的數據結構,插入操作時會將新節點插入到堆底,然後逐層檢測和父節點值的相對大小而“上浮”直到整個結構重新變為堆;進行移除操作(移除堆頂元素也是移除操作的一種)時,需要將堆尾元素置換到移除的位置,以維持整個數據結構依然是一棵完全二叉樹,然後通過與父節點和子節點進行比較來決定該位置的元素應該“上浮”或“下沉”,並遞歸這個過程直到整個數據結構被重建為堆。相關的文章非常,本文不再贅述(可以參考這篇博文【二叉堆的添加和刪除元素方法】,有動畫好理解)。

三. 從setTimeout理解Timer模塊源碼

timer模塊並不需要手動引入,它的源碼在/lib/timers.js目錄中,我們以這樣一段代碼來看看setTimeout方法的執行機制:

setTimeout(()=>{console.log(1)},1000);
setTimeout(()=>{console.log(2)},500);
setTimeout(()=>{console.log(3)},1000);

3.1 timers.js中的定義

最上層方法的定義進行了一些參數格式化,將除了回調函數和延遲時間以外的其他參數組成數組(應該是用apply來執行callback方法時把這些參數傳進去),接着做了三件事,生成timeout實例,激活實例,返回實例。

3.2 Timeout類定義

Timeout類定義在【lib/internal/timers.js】中:

初始化了一些屬性,可以看到傳入構造函數的callback,after,args都被記錄下來,可以看到after的最小值為1ms,Timeout還定義了一些原型方法可以先不用管,然後調用了initAsyncResource( )這個方法,它在實例上添加了[async_id_symbol]和[trigger_async_id_symbol]兩個標記后,又調用了emitInit( )方法將這些參數均傳了進去,這個emitInit( )方法來自於/lib/internal/async_hooks.js,官方文檔對async_hook模塊的解釋是:

The async_hooks module provides an API to register callbacks tracking the lifetime of asynchronous resources created inside a Node.js application.

它是一個實驗性質的API,是為了Node.js內部創建的用於追蹤異步資源生命周期的模塊,所以推測這部分邏輯和執行機制關係不大,可以先擱在一邊。

3.3 active(timeout)

獲得了timeout實例后再回到上層函數來,接下來執行的是active(timeout)這個方法,它調用的是insert( item, true, getLibuvNow()),不難猜測最後這個方法就是從底層libuv中獲取一個準確的當前時間,insert方法的源碼如下:

首先為timeout實例添加了開始執行時間idleStart屬性,接下來的邏輯涉及到兩個對象,這裏提前說明一下:timerListMap是一個哈希表,延時的毫秒數為key,其value是一個雙向鏈表,鏈表中存放着timeout實例,所以timerListMap就相當於一個按延時時間來分組存放定時器實例的Hash+linkedList結構,另一個重要對象timerListQueue就是上面講過的優先隊列(後文使用“二叉堆”這一概念)。

這裡有一個小細節,就是將新的定時器鏈表加入二叉堆時,比較函數是自定義傳入的,在源碼中很容易看到compareTimersLists ( )這個方法使用鏈表的expiry屬性的值進行比較來得到最小堆,由此可以知道,堆頂的鏈表總是expiry最小的,也就是說堆頂鏈表的__idlePrev指向的定時器,就是所有定時器里下一個需要觸發回調的。

接下來再來看看active( )函數體的具體邏輯,如果有對應鍵的鏈表則獲取到它(list變量),如果沒有則生成一個新的空鏈表,然後將這個鏈表添加進二叉堆,跳過中間的步驟,在最後可以看到執行了:

L.append(list, item);

這個L實際上是來自於前文提過的linkedList.js中的方法,就是將timeout實例添加到list鏈表中,來個圖就很容易理解了:

中間我們跳過了一點邏輯,就是在新鏈表生成時執行的:

if(nextExpiry > expiry){
    scheduleTimer(msecs);
    nextExpiry = expiry;
}

nextExpiry是timer模塊中維護的一個模塊內的相對全局變量,這裏的expiry是新鏈表的下一個定時器的過期時間(也就是新鏈表中唯一一個timeout實例的過期時間),這裏針對的情況就是新生成的定時器比已存在的所有定時器都要更早觸發,這時就需要重新調度一下,並把當前這個定時器的過期時間點設置為nextExpiry時間。

這個scheduleTimer( )使用internalBinding('timers')引入的,在lib/timer.cc中找到這個方法:

void ScheduleTimer(const FunctionCallbackInfo<Value>& args) {
  auto env = Environment::GetCurrent(args);
  env->ScheduleTimer(args[0]->IntegerValue(env->context()).FromJust());
}

再跳到env.cc:

void Environment::ScheduleTimer(int64_t duration_ms) {
  if (started_cleanup_) return;
  uv_timer_start(timer_handle(), RunTimers, duration_ms, 0);
}

可以看到這裏就將定時器的信息和libuv的事件循環聯繫在一起了,libuv還沒有研究,所以這條邏輯線暫時到此為止。再回到之前的示例,當三個定時器都添加完成后,內存中的對象關係基本是下面的樣子:

3.4 定時器的處理執行邏輯

至此我們已經將定時器的信息都存放好了,那麼它是如何被觸發的呢?我們找到node.js的啟動文件lib/internal/bootstrap/node.js284-290行,可以看到,在啟動函數中,Node.js通過調用setTimers( )方法將定時器處理函數processTimers傳遞給了底層,它最終會被用來調度執行定時器,processTimers方法由lib/internal/timers.js中提供的getTimerCallbacks(runNextTicks) 方法運行得到,所以聚焦到/lib/internal/timers.js中:

推測libuv每次需要檢查是否有定時器到期時都會運行processTimers( )方法,來看一下對應的邏輯,一個無限循環的while語句,直到二叉堆的堆頂沒有任何定時器時跳出循環並返回0。在循環體內部,會用堆頂元素的過期時間和當前時間相比,如果list.expiry更大,說明時機未到還不需要執行,把它的過期時間賦值給nextExpiry然後返回(返回邏輯先不細究)。如果邏輯執行到471行,說明堆頂元素的過期時間已經過了,ranAtLeastOneList這個標記位使得這段邏輯按照如下方式運行:

1.獲取到一個expiry已經過期的鏈表,首次向下執行時`ranAtLeastOneList`為false,則將其置為true,然後執行`listOnTimeout()`這個方法;
2.然後繼續取堆頂的鏈表,如果也過期了,再次執行時,會先執行`runNextTicks()`,再執行`listOnTimeout()`。

我們按照邏輯順序,先來看看listOnTimeout( )這個方法,它有近100行(我們以上面3個定時器的實例來看看它的執行邏輯):

  function listOnTimeout(list, now) {
    const msecs = list.msecs; //500 , 500ms的鏈表在堆頂

    debug('timeout callback %d', msecs);

    var diff, timer;
    let ranAtLeastOneTimer = false;
    while (timer = L.peek(list)) {  //取鏈表_idlePrev指向的定時器,也就是鏈表中最先到期的
      diff = now - timer._idleStart;  //計算當前時間和它開始計時那個時間點的時間差,

      // Check if this loop iteration is too early for the next timer.
      // This happens if there are more timers scheduled for later in the list.
      // 原文翻譯:檢測當前事件循環對於下一個定時器是否過早,這種情況會在鏈表中還有其他定時器時發生。
      // 人話翻譯:就是當前的時間點只需要觸發鏈表中第一個500ms定時器,下一個500ms定時器還沒到觸發時間。
      //         極端的相反情況就是由於阻塞時間已經過去很久了,鏈表裡的N個定時器全都過期了,都得執行。
      if (diff < msecs) {
        //更新鏈表中下一個到期定時器的時間記錄,計算邏輯稍微有點繞
        list.expiry = Math.max(timer._idleStart + msecs, now + 1);
        list.id = timerListId++;
        timerListQueue.percolateDown(1);//堆頂元素值發生更新,需要通過“下沉”來重構“堆”
        debug('%d list wait because diff is %d', msecs, diff);
        return; //直接結束了
      }

      //是不是貌似見過這段,先放着等會一塊說
      if (ranAtLeastOneTimer)
        runNextTicks();
      else
        ranAtLeastOneTimer = true;

      // The actual logic for when a timeout happens.
      L.remove(timer);

      const asyncId = timer[async_id_symbol];

      if (!timer._onTimeout) {
        if (timer[kRefed])
          refCount--;
        timer[kRefed] = null;

        if (destroyHooksExist() && !timer._destroyed) {
          emitDestroy(asyncId);
          timer._destroyed = true;
        }
        continue;
      }

      emitBefore(asyncId, timer[trigger_async_id_symbol]);

      let start;
      if (timer._repeat) //這部分看起來應該是interval的邏輯,interval底層實際上就是一個重複的timeout
        start = getLibuvNow();

      try {
        const args = timer._timerArgs;
        if (args === undefined)
          timer._onTimeout();  //設置定時器時傳入的回調函數被執行了
        else
          timer._onTimeout(...args);
      } finally {
        if (timer._repeat && timer._idleTimeout !== -1) {
          timer._idleTimeout = timer._repeat;
          if (start === undefined)
            start = getLibuvNow();
          insert(timer, timer[kRefed], start);//interval的真實執行邏輯,重新獲取時間然後插入到鏈表中
        } else if (!timer._idleNext && !timer._idlePrev) {
          if (timer[kRefed])
            refCount--;
          timer[kRefed] = null;

          if (destroyHooksExist() && !timer._destroyed) {
            emitDestroy(timer[async_id_symbol]);
            timer._destroyed = true;
          }
        }
      }

      emitAfter(asyncId);
    }
      
    //這塊需要注意的是,上面整個邏輯都包在while(timer = L.peek(list)){...}裏面

    // If `L.peek(list)` returned nothing, the list was either empty or we have
    // called all of the timer timeouts.
    // As such, we can remove the list from the object map and
    // the PriorityQueue.
    debug('%d list empty', msecs);

    // The current list may have been removed and recreated since the reference
    // to `list` was created. Make sure they're the same instance of the list
    // before destroying.
    // 原文翻譯:當前的list標識符所引用的list有可能已經經過了重建,刪除前需要確保它指向哈希表中的同一個實例。
    if (list === timerListMap[msecs]) {
      delete timerListMap[msecs];
      timerListQueue.shift();
    }
  }

3.5 實例分析

代碼邏輯因為包含了很多條件分支,所以不容易理解,我們以前文的實例作為線索來看看定時器觸發時的執行邏輯:

程序啟動后,processTimer( )方法不斷執行,第一個過期的定時器會在堆頂的500ms定時器鏈表(下面稱為500鏈表)中產生,過期時間戳為511。

假設時間戳到達600時程序再次執行processTimer( ),此時發現當前時間已經超過nextExpiry記錄的時間戳511,於是繼續向下執行進入listOnTimeout(list, now),這裏的list就是哈希表中鍵為500的鏈表,now就是當前時間600,進入listOnTimeout方法后,獲取到鏈表中最早的一個定時器timer,然後計算diff參數為600-11=589, 589 > 500, 於是繞過條件分支語句,ranAtLeastOneTimer為false也跳過(跳過後其值為true),接下來的邏輯從鏈表中刪除了這個timer,然後執行timer._onTimeout指向的回調函數,500鏈表只有一個定時器,所以下一循環時L.peek(list)返回null,循環語句跳出,繼續向後執行。此時list依然指向500鏈表,於是執行刪除邏輯,從哈希表和二叉堆中均移除500鏈表,兩個數據結構在底層會進行自調整。

processTimer( )再次執行時,堆頂的鏈表變成了1000ms定時器鏈表(下面稱為1000鏈表),nextExpiry賦值為list.expiry,也就是1001,表示1000ms定時器鏈表中下一個到期的定時器會在時間戳超過1001時過期,但時間還沒有到。下面分兩種情況來分析:

1.時間戳為1010時執行processTimer( )

時間來到1010點,processTimer( )被執行,當前時間1010大於nextExpiry=1001,於是從堆頂獲取到1000鏈表,進入listOnTimeout( ),第一輪while循環執行時的情形和500鏈表執行時是一致的,在第二輪循環中,timer指向1000鏈表中后添加的那個定時器,diff的值為 1010 – 21 = 989,989 < 1000 ,所以進入if(diff < msecs)的條件分支,list.expiry調整為下一個timer的過期時間1021,然後通過下沉來重建二叉堆(堆頂元素的expiry發生了變化),上面的實例中只剩了唯一一個鏈表,所以下沉操作沒有引發什麼實質影響,接着退出當前函數回到processTimer的循環體中,接着processTimer里的while循環繼續執行,再次檢查棧頂元素,時間還沒到,然後退出,等時間超過下一個過期時間1021后,最後一個定時器被觸發,過程基本一致,只是鏈表耗盡後會觸發listOnTimeout後面的清除哈希表和二叉堆中相關記錄的邏輯。

總結一下,鏈表的消耗邏輯是,從鏈表中不斷取出peek位置的定時器,如果過期了就執行,如果取到一個沒過期的,說明鏈表裡後續的都沒過期,就修改鏈表上的list.expiry屬性然後退回到processTimer的循環體里,如果鏈表耗盡了,就將它從哈希表和二叉堆中把這個鏈表刪掉。

2.時間戳為1050時執行processTimer( )

假如程序因為其他原因直到時間為1050時才開始檢查1000鏈表,此時它的兩個定時器都過期了需要被觸發,listOnTimeout( )中的循環語句執行第一輪時是一樣的,第二次循環執行時,跳過if(diff < msecs)的分支,然後由於ranAtLeastOneTimer標記位的變化,除了第一個定時器的回調外,其他都會先執行runNextTicks( )然後再執行定時器上綁的回調,等到鏈表耗盡后,進入後續的清除邏輯。

我們再來看一種更極端的情況,假如程序一直阻塞到時間戳為2000時才執行到processTimer(此時3個定時器都過期了,2個延遲1000ms,1個延遲500ms,堆頂為500ms鏈表),此時processTimer( )先進入第一次循環,處理500鏈表,然後500鏈表中唯一的定時器處理完后,邏輯回到processTimer的循環體,再進行第二輪循環,此時獲取到堆頂的1000鏈表,發現仍然需要執行,那麼就會先執行runNextTicks( ),然後在處理1000鏈表,後面的邏輯就和上面時間戳為1050時執行processTimer基本一致了。

至此定時器的常規邏輯已經解析完了,還有兩個細節需要提一下,首先是runNextTicks( ),從名字可以推測它應該是執行通過process.nextTick( )添加的函數,從這裏的實現邏輯來看,當有多個定時器需要觸發時,每個間隙都會去消耗nextTicks隊列中的待執行函數,以保證它可以起到“盡可能早地執行”的職責,對此不了解的讀者可以參考上一篇博文【譯】Node.js中的事件循環,定時器和process.nextTick。

四. 小結

timer模塊比較大,在了解基本數據結構的前提下不算特別難理解,setImmediate( )和process.nextTick( )的實現感興趣的讀者可以自行學習,想要對事件循環機制有更深入的理解,需要學習C++和libuv的相關原理,筆者尚未深入涉獵,以後有機會再寫。

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

SAP中的數據庫表索引

數據庫表中的索引可以加快查詢的速度。索引是數據庫表字段的有序副本。附加的字段包含指向真實數據庫錶行的指針。排序可以使訪問錶行的速度變快,例如,可以使用二分搜索。數據庫表至少有一個主索引,由它的key字段定義。它也可以有一到多個二級索引。

本文鏈接:https://www.cnblogs.com/hhelibeb/p/11061879.html 

英文原文:https://help.sap.com/doc/abapdocu_753_index_htm/7.53/en-US/abenddic_database_tables_index.htm

主索引

主索引是由主鍵的key字段構造的唯一索引,AS ABAP總會自動創建它。對於每個索引字段的組合,表中最多只能有一條記錄。 如果無法使用主索引識別記錄集,比如說,沒有使用主索引查詢字段,就會發生全表掃描,或者數據庫系統會嘗試使用合適的二級索引(如果有的話)。

二級索引

除了由主鍵定義的主索引,也可以為數據庫表定義唯一或不唯一的二級索引。創建二級索引通常會提高數據庫的讀性能,前提是讀取的時候使用到了二級索引。

二級索引包含一系列數據庫表字段,有一個最大3位長度的文本数字組成的ID。0是一個保留ID,用來表示主索引。string和rawstring類型的字段無法成為索引字段(全文索引除外)。也不建議使用數據類型FLTP的字段作為索引字段。

數據庫表在數據庫中被創建的時候,二級索引也會被定義。此外,可以晚些在相同的系統中創建新的二級索引。如果如果在其他系統增加新的二級索引而不作修改的話,它們會被創建為擴展索引。以下是建議的索引的命名空間:

  • 客戶為標準表添加的索引ID前綴為’Y’或者’Z’。
  • 合作夥伴為標準表添加的索引ID前綴為’J’,不同合作夥伴創建的索引的名稱可能衝突。
  • 其他表可以有任意名字的索引,不過不應以’Y’,’Z’或’J’開頭。

數據庫中的索引名字通常是DBTAB~ID,DBTAB是數據庫表的名字,ID是3位字符的ID。也可能有其它名字,比如空格或下劃線。

二級索引可以是唯一的,但是(不像主索引)沒必要。對唯一索引而言,數據庫表不能含有同樣索引值的多行數據。試圖插入重複的行,會取消數據庫操作,並在ABAP中觸發相應的異常。在指定了client的表中,唯一索引必須包含client字段。

訪問數據庫時,數據庫系統的優化器會檢查是否有合適的索引,並使用它。索引的選擇取決於平台,意味着可以在ABAP字典中定義非唯一索引在不同的數據庫系統中是否可用。有幾種選項,

  • Index in all database systems:這個索引會在每個數據庫中創建。
  • In selected database systems:可以使用選擇列表或排除列表來定義數據庫系統,每個列表最多有4個條目。
  • No database index:不在任何數據庫中創建索引,這個選項可以用於刪除二級索引。

這些選項對錶緩存的二級索引無效。如果表緩存有相關設置,那麼系統就會根據表緩存的設置決定是否使用二級索引。

唯一二級索引總是會被創建,而且無法從數據庫刪除。可以使用事務代碼ST05中的SQL跟蹤功能來判斷訪問數據時系統使用的索引。

索引對於查詢數據的提升效果取決於索引代表結果數據集的能力。只有索引中可以對結果集進行有效約束的字段才是有用的。這種情況下,索引中的字段順序是一個對於數據的訪問速度十分重要的因素。第一個字段必須是那些有着大量不同可選值的字段。在查詢中,要在查詢條件中指定索引的第一個字段,這樣索引才有用。另外,只有一個索引字段前面的全部索引字段都在查詢條件內時,這個索引字段才生效。字段的訪問速度和索引是否為唯一索引無關。

對於以下情況,創建二級索引可以帶來好處:

  • 如果需要查詢的表記錄不包含在現有索引內,響應時間很久,應該創建二級索引。
  • 這個字段的選擇性很強,每個值可以用於區分少於5%的表記錄。
  • 數據庫主要用於讀取。因為更改表時也需要更新索引,會降低寫入性能。
  • 如果讀取的字段也在索引里,那麼在訪問索引后不需要再次從索引之外讀取它們。如果只有少量字段經常被選擇,把它們全部包含在索引里的做法可以大大提高性能。

注:選擇性(Selectivity),是指不重複的索引值(也叫基數,Cardinality)與表記錄數(#T)的比值, Index Selectivity = Cardinality / #T

二級索引也會增加系統負載,因為每次表內容被修改時,二級索引都要做相應調整。表的每個額外的索引都會降低插入行的性能。如果需要頻繁在表中插入數據,那麼應該只建立很少的索引。太多索引也會導致數據庫的優化器找不到正確的索引。為了避免這點,表中的索引最好不相交(沒有相同的字段)。

索引應該只包含幾個字段,比如,原則上不超過4個。這是因為索引字段在被更新的時候,索引也要被更新。適合作為索引的字段是:

  • 經常被查詢,並且選擇性高。需要把選擇性最高的字段放在索引的開始位置。
  • 如果一個字段在大部分表記錄中的值都是初始值,那麼它不應成為索引字段。
  • 如果一個數據庫表有不止一個索引,那麼索引間不應該重疊。

不應該為一個表創建超過5個索引,因為,

  • 每個索引都會增加更新開銷。
  • 數據量會增加。
  • 數據庫優化器會因為可選擇的索引過多變得更加容易出錯。

索引只支持明確的條件值,比如=或者LIKE。如果條件中包含某些不確定因素,比如<>,那麼索引將無法改善性能。條件中包含OR時,優化器通常停止工作。換句話說,使用索引時,OR條件的字段是不生效的。一個例外是OR關係互相獨立。因此,對於包含OR和索引字段結合的條件,有時需要修改條件的形式。(可以看下面的例子)

注意

  • 某些數據庫的索引會忽略0,意味着查詢0值時,沒有索引可用。
  • 如有必要,可以在ABAP SQL(Open SQL)中使用附加項%_HINTS為database hints來調整系統優化器,以決定使用哪個二級索引。

例子

下面這個句子會導致優化器無法使用索引,因為遇到了OR:

SELECT * FROM spfli 
         WHERE carrid = 'LH' AND 
              ( CITYFROM = 'FRANKFURT' OR  cityfrom = 'NEW YORK' ).

替換成下面這樣的一個相等的句子,可以根據現有索引對整個條件進行優化(原因見前文):

SELECT * 
       FROM spfli 
       WHERE ( carrid = 'LH' AND cityfrom = 'FRANKFURT' ) OR 
             ( carrid = 'LH' AND cityfrom = 'NEW YORK' ).

全文索引

SAP HANA數據庫支持全文索引,全文索引可以作為二級索引。全文索引會在數據庫中被創建為一個額外的可見的列。全文索引的列的內容會被保存在這個額外的列中,以某種格式存儲,在相關數據被訪問的時候會發揮作用。

以下是全文索引的使用條件:

  • 只有對SAP HANA數據庫中的列存儲類型的表,才可以創建全文索引。
  • 只能為數據類型為指定的幾種內建數據類型的列(CHAR, SHORTSTRING, STRING, or RAWSTRING)創建全文索引,一個全文索引只能對應一個列。
  • 數據庫表必須包含一個文本語言列。

全文索引總是非唯一索引。使用全文索引的訪問基於數據庫中的WHERE CONTAINS元素。目前這個元素在ABAP SQL中還不可用,需要使用Native SQL或者AMDP。

注意

更多有關全文索引的信息,參看:SAP HANA Developer Guide.


參考閱讀:MySQL索引入門簡述


【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

【機器學習之數學】03 有約束的非線性優化問題——拉格朗日乘子法、KKT條件、投影法

目錄

  • 1 將有約束問題轉化為無約束問題
    • 1.1 拉格朗日法
      • 1.1.1 KKT條件
      • 1.1.2 拉格朗日法更新方程
      • 1.1.3 凸優化問題下的拉格朗日法
    • 1.2 罰函數法
  • 2 對梯度算法進行修改,使其運用在有約束條件下
    • 2.1 投影法
      • 2.1.1 梯度下降法 to 投影梯度法
      • 2.1.2 正交投影算子
  • References
  • 相關博客

梯度下降法、最速下降法、牛頓法等迭代求解方法,都是在無約束的條件下使用的,而在有約束的問題中,直接使用這些梯度方法會有問題,如更新后的值不滿足約束條件。

那麼問題來了,如何處理有約束的優化問題?大致可以分為以下兩種方式:

  1. 將有約束的問題轉化為無約束的問題,如拉格朗日乘子法和KKT條件;
  2. 對無約束問題下的求解算法進行修改,使其能夠運用在有約束的問題中,如對梯度下降法進行投影,使得更新后的值都滿足約束條件。

1 將有約束問題轉化為無約束問題

1.1 拉格朗日法

僅含等式約束的優化問題
\[ \begin{array}{cl}{\text { minimize }} & {f(\boldsymbol{x})} \\ {\text { subject to }} & {\boldsymbol{h}(\boldsymbol{x})=\mathbf{0}}\end{array} \]

其中,\(x \in \mathbb{R}^n\),\(f : \mathbb{R}^{n} \rightarrow \mathbb{R}\),\(\boldsymbol{h} : \mathbb{R}^{n} \rightarrow \mathbb{R}^{m}, \boldsymbol{h}=\left[h_{1}, \ldots, h_{m}\right]^{\top}, \text { and } m \leq n\)。

該問題的拉格朗日函數為:
\[ l(\boldsymbol{x}, \boldsymbol{\lambda})=f(\boldsymbol{x})+\boldsymbol{\lambda}^{\top} \boldsymbol{h}(\boldsymbol{x}) \]

FONC:對拉格朗日函數 \(l(\boldsymbol{x}, \boldsymbol{\lambda})\) 求偏導數,令偏導數都等於 0,求得的解必然滿足原問題的等式約束,可以從這些解裏面尋找是否有局部最優解。這是求得局部最優解的一階必要條件。

拉格朗日條件:(分別對 \(\bm x\) 和 \(\bm \lambda\) 求偏導)
\[ \begin{array}{l}{D_{x} l\left(\boldsymbol{x}^{*}, \boldsymbol{\lambda}^{*}\right)=\mathbf{0}^{\top}} \\ {D_{\lambda} l\left(\boldsymbol{x}^{*}, \boldsymbol{\lambda}^{*}\right)=\mathbf{0}^{\top}}\end{array} \]

上式中,對 \(\lambda\) 求偏導數得到的就是等式約束。

拉格朗日條件是必要而非充分條件,即滿足上述方程的點 \(\boldsymbol x^{*}\) 不一定是極值點。

1.1.1 KKT條件

既含等式約束又含不等式約束的優化問題:
\[ \begin{array}{rl}{\operatorname{minimize}} & {f(\boldsymbol{x})} \\ {\text { subject to }} & {\boldsymbol{h}(\boldsymbol{x})=\mathbf{0}} \\ {} & {\boldsymbol{g}(\boldsymbol{x}) \leq \mathbf{0}}\end{array} \]

其中,\(f : \mathbb{R}^{n} \rightarrow \mathbb{R}\),\(\boldsymbol{h} : \mathbb{R}^{n} \rightarrow \mathbb{R}^{m}, m \leq n\),並且 \(\boldsymbol{g} : \mathbb{R}^{n} \rightarrow \mathbb{R}^{p}\)。

將該問題轉化為拉格朗日形式:
\[ l(\boldsymbol{x}, \boldsymbol{\lambda})=f(\boldsymbol{x})+\boldsymbol{\lambda}^{\top} \boldsymbol{h}(\boldsymbol{x}) +\boldsymbol{\mu}^{\top} \boldsymbol{g}(\boldsymbol{x}) \]

設 \(\bm x^{*}\) 是原問題的一個局部極小點,則必然存在 \(\bm{\lambda}^{* \top} \in \mathbb{R}^m\),\(\bm{\mu}^{* \top} \in \mathbb{R}^p\),使得下列KKT條件成立:

  1. \(\bm {\mu}^{*} \geq 0\)
  2. \(D f\left(\boldsymbol{x}^{*}\right)+\boldsymbol{\lambda}^{* \top} D \boldsymbol{h}\left(\boldsymbol{x}^{*}\right)+\boldsymbol{\mu}^{* \top} D \boldsymbol{g}\left(\boldsymbol{x}^{*}\right)=\mathbf{0}^{\top}\)
  3. \(\boldsymbol{\mu}^{* \top} \boldsymbol{g}\left(\boldsymbol{x}^{*}\right)=0\)
  4. \({\boldsymbol{h}(\boldsymbol{x}^*)=\mathbf{0}}\)
  5. \({\boldsymbol{g}(\boldsymbol{x}^*) \leq \mathbf{0}}\)

KKT條件中,\(\bm{\lambda}^{*}\) 是拉格朗日乘子向量,\(\bm{\mu}^{*}\) 是KKT乘子向量,\(\bm{\lambda}^{*}\) 和 \(\bm{\mu}^{*}\) 的元素分別稱為拉格朗日乘子和KKT乘子。

1.1.2 拉格朗日法更新方程

將含約束的優化問題轉化為拉格朗日形式后,我們可以用更新方程對該問題進行迭代求解。

這也是一種梯度算法,但拉格朗日乘子、KKT 乘子的更新和自變量 \(\bm x\) 的更新不同,自變量 \(\bm x\) 繼續採用梯度下降法更新,而拉格朗日乘子、KKT 乘子的更新方程如下:
\[ \boldsymbol{\lambda}^{(k+1)}=\boldsymbol{\lambda}^{(k)}+\beta_{k} \boldsymbol{h}\left(\boldsymbol{x}^{(k)}\right), \\ \boldsymbol{\mu}^{(k+1)}=\left[\boldsymbol{\mu}^{(k)}+\beta_{k} \boldsymbol{g}\left(\boldsymbol{x}^{(k)}\right)\right]_{+} \]

其中,\([\cdot]_{+}=\max \{\cdot, 0\}\)。

1.1.3 凸優化問題下的拉格朗日法

拉格朗日乘子法和KKT條件在一般的含約束條件的優化問題中,都只是一階必要條件,而在凸優化問題中,則變成了充分條件。

凸優化問題指的是目標函數是凸函數,約束集是凸集的優化問題。線性規劃、二次規劃(目標函數為二次型函數、約束方程為線性方程)都可以歸為凸優化問題。

凸優化問題中,局部極小點就是全局極小點。極小點的一階必要條件就是凸優化問題的充分條件。

1.2 罰函數法

考慮一般形式的有約束優化問題:
\[ \begin{array}{cl}{\operatorname{minimize}} & {f(\boldsymbol{x})} \\ {\text { subject to }} & {\boldsymbol{x} \in \Omega}\end{array} \]

將問題變為如下無約束的形式:
\[ \operatorname{minimize} f(\boldsymbol{x})+\gamma P(\boldsymbol{x}) \]

其中,\(\gamma\) 是懲罰因子,\(P : \mathbb{R}^{n} \rightarrow \mathbb{R}\) 是罰函數。求解該無約束優化問題,把得到的解近似作為原問題的極小點。

罰函數需要滿足以下 3 個條件:

  1. \(\bm P\) 是連續的;
  2. 對所有 \(\bm x \in \mathbb{R}^n\),\(P(\boldsymbol{x}) \ge 0\) 成立;
  3. \(P(\boldsymbol{x})=0\),當且僅當 \(\bm x\) 是可行點(即 \({\bm{x} \in \Omega}\))。

2 對梯度算法進行修改,使其運用在有約束條件下

2.1 投影法

梯度下降法、最速下降法、牛頓法等優化算法都有通用的迭代公式:
\[ \boldsymbol{x}^{(k+1)}=\boldsymbol{x}^{(k)}+\alpha_{k} \boldsymbol{d}^{(k)} \]

其中,\(\boldsymbol{d}^{(k)}\) 是關於梯度 \(\nabla f(\bm x^{(k)})\) 的函數,如在梯度下降法中,\(\boldsymbol{d}^{(k)} = -\nabla f(\bm x^{(k)})\)。

考慮優化問題:
\[ \begin{array}{cl}{\operatorname{minimize}} & {f(\boldsymbol{x})} \\ {\text { subject to }} & {\boldsymbol{x} \in \Omega}\end{array} \]

在上述有約束的優化問題中,\(\boldsymbol{x}^{(k)}+\alpha_{k} \boldsymbol{d}^{(k)}\) 可能不在約束集 \(\Omega\) 內,這是梯度下降等方法無法使用的原因。

而投影法做的是,如果 \(\boldsymbol{x}^{(k)}+\alpha_{k} \boldsymbol{d}^{(k)}\) 跑到約束集 \(\Omega\) 外面去了,那麼將它投影到約束集內“最接近”的點;如果 \(\boldsymbol{x}^{(k)}+\alpha_{k} \boldsymbol{d}^{(k)} \in \Omega\),那麼正常更新即可。

投影法的更新公式為:
\[ \boldsymbol{x}^{(k+1)}=\boldsymbol{\Pi}\left[\boldsymbol{x}^{(k)}+\alpha_{k} \boldsymbol{d}^{(k)}\right] \]

其中 \(\bm \Pi\) 為投影算子,\(\bm \Pi[\bm x]\) 稱為 \(\bm x\) 到 \(\Omega\) 上的投影。

2.1.1 梯度下降法 to 投影梯度法

梯度下降法的迭代公式為:
\[ \boldsymbol{x}^{(k+1)}=\boldsymbol{x}^{(k)}-\alpha_{k} \nabla f\left(\boldsymbol{x}^{(k)}\right) \]

將投影算法引入梯度下降法,可得投影梯度法,迭代公式如下:
\[ \boldsymbol{x}^{(k+1)}=\boldsymbol{\Pi}\left[\boldsymbol{x}^{(k)}-\alpha_{k} \nabla f\left(\boldsymbol{x}^{(k)}\right)\right] \]

2.1.2 正交投影算子

含線性約束優化問題的投影梯度法可以利用正交投影算子來更新 \(\bm x^{(k)}\)。

含線性約束的優化問題如下所示:
\[ \begin{array}{cl}{\operatorname{minimize}} & {f(\boldsymbol{x})} \\ {\text { subject to }} & {\boldsymbol{A x}=\boldsymbol{b}}\end{array} \]

其中,\(f : \mathbb{R}^{n} \rightarrow \mathbb{R}\),\(\boldsymbol{A} \in \mathbb{R}^{m \times n}, m<n\),\(\operatorname{rank} \boldsymbol{A}=m, \boldsymbol{b} \in \mathbb{R}^{m}\),約束集 \(\Omega=\{\boldsymbol{x} :\boldsymbol{A} \boldsymbol{x}=\boldsymbol{b} \}\)。

這種情況下,正交投影算子矩陣 \(\bm P\) 為:
\[ \boldsymbol{P}=\boldsymbol{I}_{n}-\boldsymbol{A}^{\top}\left(\boldsymbol{A} \boldsymbol{A}^{\top}\right)^{-1} \boldsymbol{A} \]

正交投影算子 \(\bm P\) 有兩個重要性質:

  1. \(P=P^{\top}\).
  2. \(P^{2}=P\).

在投影梯度算法中,可以按照如下公式更新 \(\bm x^{(k)}\):
\[ \boldsymbol{x}^{(k+1)}=\boldsymbol{x}^{(k)}-\alpha_{k} \boldsymbol{P} \nabla \boldsymbol{f}(\boldsymbol{x}^{(k)}) \]

References

Edwin K. P. Chong, Stanislaw H. Zak-An Introduction to Optimization, 4th Edition

相關博客

【機器學習之數學】01 導數、偏導數、方嚮導數、梯度
【機器學習之數學】02 梯度下降法、最速下降法、牛頓法、共軛方向法、擬牛頓法
【機器學習之數學】03 有約束的非線性優化問題——拉格朗日乘子法、KKT條件、投影法

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

Java多線程(二):Thread類

Thread類的實例方法

start()

start方法內部會調用方法start方法啟動一個線程,該線程返回start方法,同時Java虛擬機調用native start0啟動另一個線程調用run方法,此時有兩個線程并行執行;
我們來分析下start0方法,start0到底是如何調用run方法的

Thread類里有一個本地方法叫registerNatives,此方法註冊一些本地方法給Thread類使用
在OpenJDK官網找到Thread.c

#include "jni.h"
#include "jvm.h"

#include "java_lang_Thread.h"

#define THD "Ljava/lang/Thread;"
#define OBJ "Ljava/lang/Object;"
#define STE "Ljava/lang/StackTraceElement;"

#define ARRAY_LENGTH(a) (sizeof(a)/sizeof(a[0]))

static JNINativeMethod methods[] = {
    {"start0",           "()V",        (void *)&JVM_StartThread}, //Java中Thread類的start方法所調用的start0方法
    {"stop0",            "(" OBJ ")V", (void *)&JVM_StopThread},
    {"isAlive",          "()Z",        (void *)&JVM_IsThreadAlive},
    {"suspend0",         "()V",        (void *)&JVM_SuspendThread},
    {"resume0",          "()V",        (void *)&JVM_ResumeThread},
    {"setPriority0",     "(I)V",       (void *)&JVM_SetThreadPriority},
    {"yield",            "()V",        (void *)&JVM_Yield},
    {"sleep",            "(J)V",       (void *)&JVM_Sleep},
    {"currentThread",    "()" THD,     (void *)&JVM_CurrentThread},
    {"countStackFrames", "()I",        (void *)&JVM_CountStackFrames},
    {"interrupt0",       "()V",        (void *)&JVM_Interrupt},
    {"isInterrupted",    "(Z)Z",       (void *)&JVM_IsInterrupted},
    {"holdsLock",        "(" OBJ ")Z", (void *)&JVM_HoldsLock},
    {"getThreads",        "()[" THD,   (void *)&JVM_GetAllThreads},
    {"dumpThreads",      "([" THD ")[[" STE, (void *)&JVM_DumpThreads},
};

......

根據關鍵字”JVM_StartThread”再找到jvm.cpp

JVM_ENTRY(void, JVM_StartThread(JNIEnv* env, jobject jthread))
  JVMWrapper("JVM_StartThread");
  JavaThread *native_thread = NULL;
  bool throw_illegal_thread_state = false;

  {
    MutexLocker mu(Threads_lock);
    if (java_lang_Thread::thread(JNIHandles::resolve_non_null(jthread)) != NULL) {
      throw_illegal_thread_state = true;
    } else {

      jlong size =
             java_lang_Thread::stackSize(JNIHandles::resolve_non_null(jthread));
      size_t sz = size > 0 ? (size_t) size : 0;
      native_thread = new JavaThread(&thread_entry, sz); //請看這裏,實例化了一個線程native_thread

      if (native_thread->osthread() != NULL) {
        // Note: the current thread is not being used within "prepare".
        native_thread->prepare(jthread);
      }
    }
  }

sz是大小參數,忽略之,我們看thread_entry是什麼

static void thread_entry(JavaThread* thread, TRAPS) {
  HandleMark hm(THREAD);
  Handle obj(THREAD, thread->threadObj());
  JavaValue result(T_VOID);
  JavaCalls::call_virtual(&result,
                          obj,
                          KlassHandle(THREAD, SystemDictionary::Thread_klass()),
                          vmSymbols::run_method_name(),  //請看這裏,jvm調用run_method_name方法
                          vmSymbols::void_method_signature(),
                          THREAD);
}

run_method_name在vmSymbols.hpp被定義

  /* common method and field names */                                                             
  template(run_method_name,                           "run")      //run_method_name的名稱是"run"

簡言之:當前線程調用start方法通知ThreadGroup當前線程可以運行了,可以被加入了,當前線程啟動后,當前線程狀態為”Runnable”。另一個線程等待CPU時間片,調用run方法(線程真正執行)。產生一個異步執行的效果;
用start方法來啟動線程,真正實現了多線程運行,這時無需等待run方法體代碼執行完畢而直接繼續執行下面的代碼。
代碼如下

public class MyThread03 extends Thread{
    public void run()
    {
        try
        {
            for (int i = 0; i < 3; i++)
            {
                Thread.sleep((int)(Math.random() * 1000));
                System.out.println("run = " + Thread.currentThread().getName());
            }
        }
        catch (InterruptedException e)
        {
            e.printStackTrace();
        }
    }

    public static void main(String[] args)
    {
        MyThread03 mt = new MyThread03();
        mt.start();

        try
        {
            for (int i = 0; i < 3; i++)
            {
                Thread.sleep((int)(Math.random() * 1000));
                System.out.println("run = " + Thread.currentThread().getName());
            }
        }
        catch (InterruptedException e)
        {
            e.printStackTrace();
        }
    }
}

執行結果如下,可以看到,Thead-0和main線程交叉執行,是無序的。很好理解,因為main和Thread-0在爭搶CPU資源,這個過程是無序的。

run = main
run = Thread-0
run = main
run = main
run = Thread-0
run = Thread-0

再看一個例子,代碼如下

public class MyThread04 extends Thread{
    public void run()
    {
        System.out.println(Thread.currentThread().getName());
    }

    public static void main(String[] args)
    {
        MyThread04 mt0 = new MyThread04();
        MyThread04 mt1 = new MyThread04();
        MyThread04 mt2 = new MyThread04();

        mt0.start();
        mt1.start();
        mt2.start();
    }
}

執行結果如下

Thread-0
Thread-2
Thread-1

我們依次啟動mt0,mt1,mt2,這說明線程啟動順序也是無序的。因為start方法僅僅返回調用,線程想要執行必須得到CPU時間片再執行run方法,CPU時間片的獲得是無序的。

run()

run方法是Thread類的一個普通方法,執行run方法其實是單線程執行

public class MyThread05 extends Thread{

    public void run()
    {
        System.out.println("run = " + Thread.currentThread().getName());
    }

    public static void main(String[] args)
    {
        MyThread05 mt = new MyThread05();
        mt.run();

        try
        {
            for (int i = 0; i < 3; i++)
            {
                Thread.sleep((int)(Math.random() * 1000));
                System.out.println("run = " + Thread.currentThread().getName());
            }
        }
        catch (InterruptedException e)
        {
            e.printStackTrace();
        }
    }
}

輸出結果如下

run = main
run = main
run = main
run = main

main線程循環了3次,run方法1次,結果是main線程執行了四次,我們寫在run方法體內的被main線程執行,這說明調用run方法執行多線程是不可行的。

isAlive()

判斷線程是否存活

public class MyThread06 extends Thread{
    public void run()
    {
        System.out.println("run = " + this.isAlive());
    }


    public static void main(String[] args) throws Exception
    {
        MyThread06 mt = new MyThread06();
        System.out.println("begin == " + mt.isAlive());
        mt.start();
        Thread.sleep(100);
        System.out.println("end == " + mt.isAlive());
    }
}

輸出結果如下,增加0.1秒延遲,讓線程執行完

begin == false
run = true
end == false

可以看到,執行前false,執行中true,執行后false

getId()

返回線程的標識符,線程ID是正值,線程ID在生命周期內不會變化,當線程終止了,線程ID可能會被重用

getName()

返回線程名稱

getPriority()和setPriority(int)

返回優先級和設置優先級
優先級越高的線程獲取CPU時間片的概率越高
請看如下的例子

public class MyThread07_0 extends Thread{
    public void run()
    {
        System.out.println("MyThread07_0 run priority = " +
                this.getPriority());
    }

    public static void main(String[] args)
    {
        System.out.println("main thread begin, priority = " +
                Thread.currentThread().getPriority());
        System.out.println("main thread end, priority = " +
                Thread.currentThread().getPriority());
        MyThread07_0 thread = new MyThread07_0();
        thread.start();
    }
}

運行結果如下

main thread begin, priority = 5
main thread end, priority = 5
MyThread07_0 run priority = 5

線程的默認優先級是5
再看如下的例子

public class MyThread07_1 extends Thread {

    public void run()
    {
        System.out.println("MyThread07_1 run priority = " +
                this.getPriority());
        MyThread07_0 thread = new MyThread07_0();
        thread.start();
    }

    public static void main(String[] args)
    {
        System.out.println("main thread begin, priority = " +
                Thread.currentThread().getPriority());
        System.out.println("main thread end, priority = " +
                Thread.currentThread().getPriority());
        MyThread07_1 thread = new MyThread07_1();
        thread.start();
    }
}

我們在MyThread07_1線程內部啟動MyThread07_0線程,我們觀察MyThread07_1和MyThread07_0的優先級有什麼關係。
運行結果如下

main thread begin, priority = 5
main thread end, priority = 5
MyThread07_1 run priority = 5
MyThread07_0 run priority = 5

MyThread07_0和MyThread07_1線程的優先級一致,說明線程具有繼承性。
現在我們來設置優先級

public class MyThread08 {

    static class MyThread08_0 extends Thread {
        public void run() {
            long beginTime = System.currentTimeMillis();
            for (int j = 0; j < 1000000; j++) {}
            long endTime = System.currentTimeMillis();
            System.out.println("★★★★ MyThread08_0 use time = " +
                    (endTime - beginTime));
        }
    }

    static class MyThread08_1 extends Thread {
        public void run()
        {
            long beginTime = System.currentTimeMillis();
            for (int j = 0; j < 1000000; j++){}
            long endTime = System.currentTimeMillis();
            System.out.println("☆☆☆☆ MyThread08_1 use time = " +
                    (endTime - beginTime));
        }
    }

    public static void main(String[] args)
    {
        for (int i = 0; i < 5; i++)
        {
            MyThread08_0 mt0 = new MyThread08_0();
            mt0.setPriority(5);
            mt0.start();
            MyThread08_1 mt1 = new MyThread08_1();
            mt1.setPriority(4);
            mt1.start();
        }
    }

}

我們給MyThread08_0線程設置更高的優先級5
運行結果如下

★★★★ MyThread08_0 use time = 7
☆☆☆☆ MyThread08_1 use time = 4
★★★★ MyThread08_0 use time = 18
★★★★ MyThread08_0 use time = 16
★★★★ MyThread08_0 use time = 20
★★★★ MyThread08_0 use time = 17
☆☆☆☆ MyThread08_1 use time = 0
☆☆☆☆ MyThread08_1 use time = 10
☆☆☆☆ MyThread08_1 use time = 9
☆☆☆☆ MyThread08_1 use time = 8

可以看到MyThread08_0先執行的次數更多,輸出結果為實心五角星的這個。
多運行幾次,都會是MyThread08_0先打印完,每次結果都不盡相同,CPU會盡量先讓MyThread08_0執行完。

isDaemon()和setDaemon(boolean)

isDaemon方法判斷是否是守護線程;
setDaemon設置守護線程
在Java中有兩類線程:User Thread(用戶線程)、Daemon Thread(守護線程)
我們自定義的線程和main線程都是用戶線程,我們熟知的GC(垃圾回收器)就是守護線程。守護線程是用戶線程的“奴僕”,當用戶線程執行完畢,守護線程就會終止,因為它沒有存在的必要了。
如用戶線程執行結束,GC無垃圾可回收,它只能死亡
看如下代碼

public class MyThread09 extends Thread{
    private int i = 0;

    public void run()
    {
        try
        {
            while (true)
            {
                i++;
                System.out.println(Thread.currentThread().getName()+" i = " + i);
                Thread.sleep(1000);
            }
        }
        catch (InterruptedException e)
        {
            e.printStackTrace();
        }
    }

    public static void main(String[] args)
    {
        try
        {
            MyThread09 mt = new MyThread09();
            mt.setDaemon(true);
            mt.start();
            Thread.sleep(5000);
            System.out.println("現在是"+Thread.currentThread().getName()+"線程");
            Thread.sleep(1);

        }
        catch (InterruptedException e)
        {
            e.printStackTrace();
        }
    }
}

我們自定義MyThread09線程的run方法里是死循環,如果是用戶線程,它應該永遠地執行下去,現在把它設置成守護線程。
注意:mt.setDaemon(true);要在mt.start();之前,見

否則會拋出IllegalThreadStateException異常
運行結果如下

Thread-0 i = 1
Thread-0 i = 2
Thread-0 i = 3
Thread-0 i = 4
Thread-0 i = 5
現在是main線程
Thread-0 i = 6
MyThread09變成了守護線程,它的使命已經完成。現在是main線程

Thread.sleep(5000)的目的是使main線程沉睡5s,即用戶線程(main線程)仍在執行,此時main線程輸出,再沉睡1ms,當main線程執行完畢,守護線程就沒有存在的意義了,即死亡;
main線程總共執行了大約5001ms(略大於這個數值),Thread-0打印到i=6,說明守護線程在main線程之後死亡,這個時間差極小

interrupt()

設置中斷標誌位,無法中斷線程

public class MyThread10 extends Thread{
    public void run()
    {
        for (int i = 0; i < 500000; i++)
        {
            System.out.println("i = " + (i + 1));
        }
    }

    public static void main(String[] args)
    {
        try
        {
            MyThread10 mt = new MyThread10();
            mt.start();
            Thread.sleep(2000);
            mt.interrupt();
        }
        catch (InterruptedException e)
        {
            e.printStackTrace();
        }
    }
}

輸出結果如下

......
i = 499993
i = 499994
i = 499995
i = 499996
i = 499997
i = 499998
i = 499999
i = 500000

可以看到,interrupt()沒有中斷線程,interrupt()後續將會詳細講解

isInterrupted()

判斷線程是否被中斷

join()

等待這個線程死亡,舉例說明:
線程A執行join方法,會阻塞線程B,線程A join方法執行完畢,才能執行線程B
代碼如下

public class MyThread11 extends Thread{
    public void run()
    {
        try
        {
            int secondValue = (int)(Math.random() * 1000);
            System.out.println(secondValue);
            Thread.sleep(secondValue);
        }
        catch (InterruptedException e)
        {
            e.printStackTrace();
        }
    }

    public static void main(String[] args) throws Exception
    {
        MyThread11 mt = new MyThread11();
        mt.start();
        mt.join();
        System.out.println("MyThread11執行完畢之後我再執行");
    }
}

輸出結果如下

75
MyThread11執行完畢之後我再執行

可以看到,main線程在mt線程之後執行。mt調用join方法,使main線程阻塞,待mt線程執行完畢,方可執行main線程。

Thread類的靜態方法

currentThread()

返回當前正在執行線程的引用

public class MyThread12 extends Thread{

    static
    {
        System.out.println("靜態塊的打印:" +
                Thread.currentThread().getName());
    }

    public MyThread12()
    {
        System.out.println("構造方法的打印:" +
                Thread.currentThread().getName());
    }

    public void run()
    {
        System.out.println("run()方法的打印:" +
                Thread.currentThread().getName());
    }


    public static void main(String[] args)
    {
        MyThread12 mt = new MyThread12();
        mt.start();
    }


}

輸出結果

靜態塊的打印:main
構造方法的打印:main
run()方法的打印:Thread-0

可以看到,構造方法和靜態塊是main線程在調用,重寫的run方法是線程自己在調用。
再看個例子

public class MyThread13 extends Thread{
    public MyThread13()
    {
        System.out.println("MyThread13----->Begin");
        System.out.println("Thread.currentThread().getName()----->" +
                Thread.currentThread().getName());
        System.out.println("this.getName()----->" + this.getName());
        System.out.println("MyThread13----->end");
    }

    public void run()
    {
        System.out.println("run----->Begin");
        System.out.println("Thread.currentThread().getName()----->" +
                Thread.currentThread().getName());
        System.out.println("this.getName()----->" + this.getName());
        System.out.println("run----->end");
    }


    public static void main(String[] args)
    {
        MyThread13 mt = new MyThread13();
        mt.start();
    }


}

輸出結果

MyThread13----->Begin
Thread.currentThread().getName()----->main
this.getName()----->Thread-0
MyThread13----->end
run----->Begin
Thread.currentThread().getName()----->Thread-0
this.getName()----->Thread-0
run----->end

可以看到,執行MyThread13構造方法的線程是main,執行MyThread13的線程是Thread-0(當前線程),run方法就是被線程實例所執行。

sleep(long)

讓當前線程沉睡若干毫秒

public class MyThread14 extends Thread{
    public void run()
    {
        try
        {
            System.out.println("run threadName = " +
                    this.getName() + " begin");
            Thread.sleep(2000);
            System.out.println("run threadName = " +
                    this.getName() + " end");
        }
        catch (InterruptedException e)
        {
            e.printStackTrace();
        }
    }

    public static void main(String[] args)
    {
        MyThread14 mt = new MyThread14();
        mt.start();
    }
}

輸出結果如下

run threadName = Thread-0 begin
run threadName = Thread-0 end

打印完第一句兩秒后打印第二句。

yield()

當前線程放棄CPU的使用權,這裏的放棄是指當前線程少用CPU資源,最後線程還是會執行完成

public class MyThread15 extends Thread {
    public void run()
    {
        long beginTime = System.currentTimeMillis();
        int count = 0;
        for (int i = 0; i < 5000000; i++)
        {
            Thread.yield();
            count = count + i + 1;
        }
        long endTime = System.currentTimeMillis();
        System.out.println("用時:" + (endTime - beginTime) + "毫秒!");
    }


    public static void main(String[] args)
    {
        MyThread15 mt = new MyThread15();
        mt.start();
    }


}

輸出結果如下

用時:4210毫秒!

可以看到,任務執行完畢,當我們把Thread.yield();註釋掉,執行時間只需要7ms。說明當前線程放棄了一些CPU資源。

interrupted()

判斷當前線程是否中斷,靜態版的isInterrupted方法。多線程中斷機制,後續會詳細解析。

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

量子邏輯門

量子態的演化

在前面量子糾纏1中我們已經提到了量子比特的線性代數表示,即,對於一個量子態 \(\alpha_0 | 0\rangle +\alpha_1 | 1\rangle\)我們可以化簡成$ \left[ \begin{array}{}{\alpha_0} \ {\alpha_1}\end{array}\right]$ 。

量子態不是一成不變的,就像高電平會變成低電平,一個量子態也能演化成另一個量子態,量子態的演化就是在Hilbert空間中的旋轉,如圖(a)所示。

通過一個U操作,我們就將 \(| 0\rangle\) 變成了 \(U| 0\rangle\) , \(| 1\rangle\) 變成了 \(U| 1\rangle\) , \(| u\rangle\) 變成了 \(U| u\rangle\) ,如圖(b)所示。需要注意的是,我添加一個U操作,沒有改變 \(| 0\rangle\) 、 \(| 1\rangle\) 、 \(| u\rangle\) 之間的關係, \(U| 0\rangle\) 、 \(U| 1\rangle\) 和 \(| 0\rangle\) 、 \(| 1\rangle\) 一樣,他們之間的關係依舊是垂直。

$ (| 0\rangle, | 1\rangle)=0$

$ (U| 0\rangle, U| 1\rangle)=0$

\((,)\) 是內積的意思, $ (| 0\rangle, | 1\rangle)= \left[ \begin{array}{}{1}&{0}\end{array}\right]\left[ \begin{array}{}{0} \ {1}\end{array}\right]$ ,同樣,也可以簡寫成 \(\langle0| 1\rangle\) , \(\langle0|\) 表明是 \(| 0\rangle\) 的共軛轉置。

對於這種兩個向量之間夾角不會變的旋轉稱為剛性旋轉 rigid rotation。

而這種U操作被成為酉操作,也是unitary transformation

Unitary Transformation

量子比特我們用向量來表示,因為我們量子比特的演化是線性的,所以在量子比特上的操作,可以用矩陣來表示。

單量子比特是 \(2*1\) 的向量,則單量子比特門是 \(2*2\) 的矩陣。

\(| 0\rangle\) 變到 \(U| 0\rangle\) 在線性代數上就是 $ \left[ \begin{array}{}{1} \ {0}\end{array}\right]$ 變到 $ \left[ \begin{array}{}{\frac{1}{\sqrt2}} \ {\frac{1}{\sqrt2}}\end{array}\right]$

\[ \left[ \begin{array}{}{\frac{1}{\sqrt2}} \\ {\frac{1}{\sqrt2}}\end{array}\right]=U\left[ \begin{array}{}{1} \\ {0}\end{array}\right]\]

\[U= \left[ \begin{array}{}{\frac{1}{\sqrt2}} &{-\frac{1}{\sqrt2}} \\ {\frac{1}{\sqrt2}}&{\frac{1}{\sqrt2}} \end{array}\right]\]

對於旋轉了 \(\theta\) 角度的操作,都可以用 \(U_{\theta}= \left[ \begin{array}{}{cos\theta} &{-sin\theta} \\ {sin\theta}&{cos\theta} \end{array}\right]\) 表達。

如果要做相反操作,就是將順時針轉 \(\theta\) 角度, \(U_{-\theta}= \left[ \begin{array}{}{cos\theta} &{sin\theta} \\ {-sin\theta}&{cos\theta} \end{array}\right]\)

很巧的是, \(U_\theta^\dagger=U_{-\theta}\) , \(\dagger\) 是共軛轉置的意思。

\(U_\theta U_{\theta}^\dagger=I\) ,意思也很好理解,因為順時針 \(\theta\) 又 \(-\theta\) ,正好就回到原位。

事實上所有的量子操作都是可逆的,所有的量子操作都酉操作。

那麼什麼是酉操作呢?

U is unitary iff \(U^\dagger U =I\)

對於酉矩陣的更多特徵會在線性代數的章節提到,這裏主要提一個,酉矩陣是保內積的。

保內積又是什麼意思?

兩個向量在乘以相同的U后,他們的內積不變。

\[(U| a\rangle, U| b\rangle)=\langle a|U^\dagger U|b\rangle=\langle a|I|b\rangle=\langle a|b\rangle\]

單量子邏輯門

量子邏輯門和經典邏輯門一個巨大的不同是——量子邏輯門可逆。

經過了經典的邏輯門與門或者非門,我們的信息會丟失,告訴你與門后的輸出結果是0,你知道與門前的輸入嗎?(0,0)、(0,1)、(1,0)都有可能。

而對於量子邏輯門來說,我經過U變換后的結果是 \(|a\rangle\) ,那麼 \(U^\dagger |a\rangle\) 就是變換前的輸入了。

舉例幾個常用的單量子邏輯門:

\(X=\left[ \begin{array}{}{0} &{1} \\ {1}&{0} \end{array}\right]\),X門又稱為比特翻轉,他可以把 \(|0\rangle\) 變成 \(|1\rangle\) ,把 \(|1\rangle\) 變成 \(|0\rangle\) 。

\(Y=\left[ \begin{array}{}{0} &{-i} \\ {i}&{0} \end{array}\right]\)

\(Z=\left[ \begin{array}{}{1} &{0} \\ {0}&{-1} \end{array}\right]\),Z門又稱為相位翻轉門,可以把 \(|+\rangle\) 變成 \(|-\rangle\) , \(-|1\rangle\) 變成 \(|1\rangle\) 。

以及一個特別有用的門,Hadamard門:
\(H=\left[ \begin{array}{}{\frac{1}{\sqrt2}} &{\frac{1}{\sqrt2}} \\ {\frac{1}{\sqrt2}}&{-\frac{1}{\sqrt2}} \end{array}\right]\) ,他的作用是把 \(|1\rangle\) 變成 \(|-\rangle\) , \(|0\rangle\) 變成 \(|+\rangle\) 。

兩量子邏輯門

對於兩量子比特來說,他們的狀態是 \(\alpha_{00} | 00\rangle+\alpha_{01} | 01\rangle+\alpha_{10} | 10\rangle+\alpha_{11} | 11\rangle\) ,需要用 \(4*1\) 的向量來描述,也就是 $ \left[ \begin{array}{}{\alpha_{00}} \ {\alpha_{01}} \ {\alpha_{10}} \ {\alpha_{11}} \end{array} \right]$ ,對應操作兩比特的邏輯門,也就是 \(4*4\) 的矩陣了。

兩比特的量子門有各自管各自的,如圖(c),也有一個控制另一個的,如圖(d)。

對於圖c來說, \(U=u_1\otimes u_2\) ,如果 \(u_1=\left[ \begin{array}{}{a} &{c} \\ {b}&{d} \end{array}\right],u_2=\left[ \begin{array}{}{e} &{g} \\ {f}&{h} \end{array}\right]\) ,那麼, \(U=\left[ \begin{array}{}{a\left[ \begin{array}{}{e} &{g} \\ {f}&{h} \end{array}\right]} &{c\left[ \begin{array}{}{e} &{g} \\ {f}&{h} \end{array}\right]} \\ {b\left[ \begin{array}{}{e} &{g} \\ {f}&{h} \end{array}\right]}&{d\left[ \begin{array}{}{e} &{g} \\ {f}&{h} \end{array}\right]} \end{array}\right]\) ,這也就是張量積的算法。

對於圖d來說,這是一個受控非門CNOT門,他的意思是,如果a是0,那麼b保持不變,如果a是1,那麼b就是變成相反的,比如 \(|0\rangle\) 變成 \(|1\rangle\) ,或者把 \(|1\rangle\) 變成 \(|0\rangle\) 。

即 \(|00\rangle to|00\rangle,|01\rangle to|01\rangle,|10\rangle to|11\rangle,|11\rangle to|10\rangle\) 。

用矩陣來描述就是 \(\left[\begin{array}{cccc}{1} & {0} & {0} & {0} \\ {0} & {1} & {0} & {0} \\ {0} & {0} & {0} & {1} \\ {0} & {0} & {1} & {0}\end{array}\right]\) 。

至此,主要的量子邏輯門就介紹完畢,如果想要動手實踐的話,有阿里的量子計算雲平台、華為的hiQ、IMB的IBM Q

參考資料

Quantume Mechanics & Quantume Computation Lecture 5

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

Windows性能計數器監控實踐

Windows性能計數器(Performance Counter)是Windows提供的一種系統功能,它能實時採集、分析系統內的應用程序、服務、驅動程序等的性能數據,以此來分析系統的瓶頸、監控組件的表現,最終幫助用戶對系統進行合理調優。市面上採集Windows性能計數器指標的產品參差不齊,尤其在處理某類應用程序有多個進程實例時,採集的數據更是差強人意。所幸微軟為碼農精心準備了獲得性能計數器指標的接口,用於靈活獲得相關性能計數器指標值,但進程級別Windows性能計數器指標的採集監控,並沒有想象的那麼美好。因此本文結合筆者應用實踐,探討進程級別Windows性能計數器指標統一採集監控方案,以及在應用實踐中遇到的坑,作為避坑指南,供感興趣的同行參考。

進程級別Windows性能計數器指標作為特來電監控平台的一部分,對深入掌握系統進程級別運行狀態,定位系統存在的問題,以便更快、更準的發現潛在的線上問題,起到了舉足輕重的作用。

針對Windows性能計數器的監控,統一的採集監控方案如下所示:


 性能計數器指標統一採集監控方案

本文重點關注指標管理與指標採集,對指標存儲及指標展現只做概要闡述。

一、        指標管理

Windows性能計數器指標類別比較多,因此我們需要對關注的指標進行分類管理。針對進程級別監控,我們主要關注CLR以及進程相關類別指標:.NET CLR Memory、.NET CLR Exception、.NET CLR Jit、.NET CLR Loading、Process等。

一個Windows性能計數器主要由3個屬性來標識:指標類別(Category Name)、指標名稱(Counter Name)、指標實例(Instance Name)。為了能對某類應用程序的多個進程實例進行統一採集,我們不對指標實例進行管理,而對指標實例對應的進程名稱進行管理,同時支持一個性能計數器指標關聯多個進程名稱,並且在運行時動態計算出每個進程名稱對應的多個進程實例,從而大幅降低指標管理的工作量。

二、        指標採集

指標採集主要解決採集插件運行時的空間(採集範圍)與時間(採集頻率)問題。並不是所有機器都部署了我們關注的應用程序,因此需要通過採集範圍,確定需要對哪些機器上的性能計數器指標進行採集,同時需要確定採集頻率,比如10秒、1分鐘、5分鐘等。

雖然微軟提供了性能計數器接口用於採集對應的指標值,但當一個應用程序有多個進程實例時(比如一個機器上部署了多個IIS站點,進程名稱都是w3wp,在性能計數器中的實例名稱是w3wp、w3wp#1、…、w3wp#n),進行指標採集的坑會比較多,這裏介紹幾個比較典型的問題。

由於性能計數器默認不显示進程ID,所以無法直接建立進程實例和性能計數器指標實例的關聯關係,相同的性能計數器指標實例名稱,可能屬於一個或多個不同的進程實例。


 進程實例與性能計數器實例關聯關係

比如在.NET CLR Memory和Process中實例名稱同為w3wp#1的性能計數器,可能對應同一個進程實例,也可能對應不同的進程實例,這是最詭異的坑!市面上一些監控產品無法準確採集同一應用程序對應多個進程實例的性能計數器指標值,可能與此有關。

為了能建立進程實例與性能計數器實例的關聯關係,需要在显示性能計數器實例時帶上進程ID。

方案一:修改註冊表。但潛在的坑也很明顯:只適用於.NET CLR Memory以及Process類別的性能計數器,同時可能會導致第三方監控工具失效,並且修改生產環境的註冊表風險不可控,不是首選方案。

方案二:動態設置環境變量。針對.NET CLR相關的性能計數器,在調用性能計數器接口之前,進行如下環境變量設置:

Environment.SetEnvironmentVariable(“COMPlus_ProcessNameFormat”, “1”);

該方案是進程級別的,設置后得到的性能計數器實例會自動帶上進程ID,並且不會影響到全局設置或者其它應用程序,是推薦方案。

採集進程級別指標時,有時需要根據IIS站點進程ID獲得對應的應用程序池以及物理路徑:


 通過進程ID獲得應用程序池以及物理路徑

方案一:調用WMI(Windows Management Instrumentation)接口獲得應用程序池。

Select * from Win32_Process WHERE processID=PID

該方案存在的坑:頻繁調用會導致機器CPU飆升,不是首選方案。

方案二:調用Appcmd.exe命令獲得應用程序池。

appcmd.exe list wp

該方案通過命令獲得結果后,只需要進行字符串解析,即可獲得進程ID與應用程序池的關聯關係,是推薦方案。

三、        指標存儲

指標存儲在時序數據庫中,每個性能計數器類別(Category Name)+性能計數器名稱(Counter Name)對應一個指標表,表中按進程名稱進行分類,每一行表示一個進程實例對應性能計數器實例的指標值。

四、        指標展現

指標展現可以按進程名稱、進程實例、機器等維度進行分類聚合展現,相比登錄到每個機器設置性能計數器,指標集中展現大幅提升了工作效率。

五、        總結

本文探討了Windows性能計數器監控實踐,主要涉及指標管理、指標採集、指標存儲、指標展現四個方面,同時介紹了同一應用程序對應多個進程實例時,指標採集中遇到的坑。

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

python算法與數據結構-希爾排序(35)

一、希爾排序的介紹

  希爾排序(Shell Sort)是插入排序的一種。也稱縮小增量排序,是直接插入排序算法的一種更高效的改進版本。希爾排序是非穩定排序算法。 希爾排序是把記錄按下標的一定增量分組,對每組使用直接插入排序算法排序;隨着增量逐漸減少,每組包含的記錄越來越多,當增量減至1時,整個文件恰被分成一組,算法便終止。  

二、希爾排序的原理

  在前面文章中介紹的直接插入排序,它對於已經基本有序的數據進行排序,效率會很高,而如果對於最初的數據是倒序排列的,則每次比較都需要移動數據,導致算法效率降低。

      希爾排序的基本思想就是:將需要排序的序列邏輯上劃分為若干個較小的序列(但並非真的分割成若干分區),對這些邏輯上序列進行直接插入排序,通過這樣的操作可使需要排序的數列基本有序,最後再使用一次直接插入排序。

      在希爾排序中首先要解決的是怎樣劃分序列,對於子序列的構成不是簡單地分段,而是採取將相隔某個增量的數據組成一個序列。一般選擇增量的規則是:取上一個增量的一半作為此次子序列劃分的增量,一般初始值元素的總數量的一半。

三、希爾排序的圖解 


四、希爾排序的python代碼實現

# 創建一個希爾排序的函數
def shell_sort(alist):
    # 需要排序數組的個數
    N = len(alist)
    # 最初選取的步長
    gap = N//2
    
    # 根據每次不同的步長,對分組內的數據進行排序
    # 如果步長沒有減為1就繼續執行
    while gap>0:
        # 對每個分組進行插入排序,
        # 因為插入排序從第二個元素開始,而這裏第二個元素的下標就是gap
        # 所以i的起始點是gap
        for i in range(gap,N):
            # 控制每個分組內相鄰的兩個元素,邏輯上相鄰的兩個元素間距為gap,
            # j的前一個元素比它少一個gap距離,所以for循環中j的步長為 -gap
            for j in  range(i,0,-gap):
                # 判斷和邏輯上的分組相鄰的兩個數據大小
                if alist[j]<alist[j-gap] and j-gap>=0:
                    # 交換
                    temp = alist[j]
                    alist[j] = alist[j-gap]
                    alist[j-gap] = temp
        # 改變步長
        gap = gap//2
    
    
numlist = [5,7,8,3,1,2,4,6,9]
print("排序前:%s"%numlist)
shell_sort(numlist)
print("排序后:%s"%numlist)

運行結果為:

排序前:[5, 7, 8, 3, 1, 2, 4, 6, 9]
排序后:[1, 2, 3, 4, 5, 6, 7, 8, 9]

五、希爾排序的C語言實現

#include <stdio.h>
// 創建一個希爾排序的函數
void shell_sort(int arr[],int arrLength,int gap)
{
    // 根據每次不同的步長,對分組內的數據進行排序
    // 如果步長沒有減為1就繼續執行
    while (gap>0)
    {
        // 對每個分組進行插入排序,
        // 因為插入排序從第二個元素開始,而這裏第二個元素的下標就是gap,
        // 所以i的起始點是gap
        for (int i = gap; i<arrLength; i++)
        {
            // 控制每個分組內相鄰的兩個元素,邏輯上相鄰的兩個元素間距為gap,
            // j的前一個元素比它少一個gap距離,所以for循環中j每次減少一個gap
            // 因為j-gap是上一個元素的下標,也必須保證大於等於0
            for (int j = i; j>0&&j-gap>=0; j=j-gap)
            {
                // 判斷和邏輯上的分組相鄰的兩個數據大小
                if (arr[j]<arr[j-gap])
                {
                    // 交換
                    int temp = arr[j];
                    arr[j] = arr[j-gap];
                    arr[j-gap] = temp;
                }
            }
        }
        gap = gap/2;
    }
}

int main(int argc, const char * argv[]) {
   
    // 定義數組
    int array[] = {5,7,8,3,1,2,4,6,9};
    // 希爾排序的聲明
    void shell_sort(int arr[],int arrLength,int gap);
    // 計算數組長度
    int len = sizeof(array)/sizeof(int);
    // 制定gap為二分之一的長度
    int g = len/2;
    // 使用希爾排序
    shell_sort(array, len, g);
    // 驗證
    for (int i = 0; i<len; i++)
    {
        printf("%d ",array[i]);
    }
    
    return 0;
}

運行結果為:

1 2 3 4 5 6 7 8 9


六、希爾排序的時間複雜度

  • 最優時間複雜度:根據步長序列的不同而不同
  • 最壞時間複雜度:O(n2)

七、希爾排序的穩定性

  由於多次插入排序,我們知道一次插入排序是穩定的,不會改變相同元素的相對順序,但在不同的插入排序過程中,相同的元素可能在各自的插入排序中移動,最後其穩定性就會被打亂,所以shell排序是不穩定的。


【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

[NewLife.XCode]角色權限

NewLife.XCode是一個有10多年歷史的開源數據中間件,支持nfx/netcore,由新生命團隊(2002~2019)開發完成並維護至今,以下簡稱XCode。

整個系列教程會大量結合示例代碼和運行日誌來進行深入分析,蘊含多年開發經驗於其中,代表作有百億級大數據實時計算項目。

開源地址:https://github.com/NewLifeX/X (求star, 864+)


前面講解了XCode的各種用法,這一章我們來講講內置的Membership,同時也是XCode的第一標準示例!


設計背景

現代管理信息系統絕大部分採用BS架構,無一例外需要用戶角色權限的支持!

結合團隊諸多兄弟姐妹的經驗,設計了一個大小適中的用戶權限系統Membership,目標是滿足80%的使用場景,並具備一定的擴展性。


Membership剛開始就採用了角色授權體系,每個用戶只有一種角色,角色擁有菜單資源權限集。

隨着Membership實用性日益增加,2015年初正式合併進入XCode,作為一個模塊存在。


2016年第二代魔方NewLife.Cube採用ASP.Net MVC5重構,讓Membership的榮譽達到了鼎峰!

在MVC中,每個Controller就是一個菜單資源,其下的Search/Detail/Insert/Update/Delete等Action作為角色在該菜單資源下的權限子項,保存在角色屬性數據中。


2018年為了增強魔方功能,在某些場景下支持單用戶多角色,且兼容已有系統,用戶表增加RoleIDs字段,保存擴展角色,原來的RoleID作為主角色。


管理提供者

管理提供者接口 IManageProvider ,提供了Membership基本操作實現。

  1. 當前登錄用戶 GetCurrent、SetCurrent,靜態訪問 ManageProvider.User
  2. 查找用戶 FindByID、FindByName
  3. 註冊登錄註銷 Register、Login、Logout
  4. 當前用戶主機(訪問者IP)ManageProvider.UserHost
  5. IManageProvider 默認由XCode.Membership中的UserX/Role/Menu支持,如若用戶使用自己的用戶權限表,可重新實現該接口


用戶權限

用戶 UserX

用戶數據模型:

  <Table Name="User" Description="用戶" RenderGenEntity="true">
    <Columns>
      <Column Name="ID" DataType="Int32" Identity="True" PrimaryKey="True" Description="編號" />
      <Column Name="Name" DataType="String" Master="True" Nullable="False" Description="名稱。登錄用戶名" />
      <Column Name="Password" DataType="String" Description="密碼" />
      <Column Name="DisplayName" DataType="String" Description="昵稱" />
      <Column Name="Sex" DataType="Int32" Description="性別。未知、男、女" Type="SexKinds" />
      <Column Name="Mail" DataType="String" Description="郵件" />
      <Column Name="Mobile" DataType="String" Description="手機" />
      <Column Name="Code" DataType="String" Description="代碼。身份證、員工編號等" />
      <Column Name="Avatar" DataType="String" Length="200" Description="頭像" />
      <Column Name="RoleID" DataType="Int32" Description="角色。主要角色" />
      <Column Name="RoleIDs" DataType="String" Length="200" Description="角色組。次要角色集合" />
      <Column Name="DepartmentID" DataType="Int32" Description="部門。組織機構" />
      <Column Name="Online" DataType="Boolean" Description="在線" />
      <Column Name="Enable" DataType="Boolean" Description="啟用" />
      <Column Name="Logins" DataType="Int32" Description="登錄次數" />
      <Column Name="LastLogin" DataType="DateTime" Description="最後登錄" />
      <Column Name="LastLoginIP" DataType="String" Description="最後登錄IP" />
      <Column Name="RegisterTime" DataType="DateTime" Description="註冊時間" />
      <Column Name="RegisterIP" DataType="String" Description="註冊IP" />
      <Column Name="Ex1" DataType="Int32" Description="擴展1" />
      <Column Name="Ex2" DataType="Int32" Description="擴展2" />
      <Column Name="Ex3" DataType="Double" Description="擴展3" />
      <Column Name="Ex4" DataType="String" Description="擴展4" />
      <Column Name="Ex5" DataType="String" Description="擴展5" />
      <Column Name="Ex6" DataType="String" Description="擴展6" />
      <Column Name="UpdateUser" DataType="String" Description="更新用戶" />
      <Column Name="UpdateUserID" DataType="Int32" Description="更新用戶" />
      <Column Name="UpdateIP" DataType="String" Description="更新地址" />
      <Column Name="UpdateTime" DataType="DateTime" Nullable="False" Description="更新時間" />
      <Column Name="Remark" DataType="String" Length="200" Description="備註" />
    </Columns>
    <Indexes>
      <Index Columns="Name" Unique="True" />
      <Index Columns="RoleID" />
      <Index Columns="UpdateTime" />
    </Indexes>
  </Table>

常用字段有ID、用戶名和密碼,登錄註冊相關信息;

角色RoleID、RoleIDs用於實現權限集控制;

部分場景需要郵箱Mail、手機Mobile或者工號Code登錄;

如果仍然不能滿足要求,可以考慮使用Ex1~Ex6等擴展字段。


常用功能點:

  1. 初始化時,如果數據表為空,自動插入admin/admin用戶賬號,角色是“管理員”
  2. 支持註冊登錄,使用MD5保存密碼
  3. 支持編號查詢FindByID和名稱查詢FindByName,分別採用了對象緩存和對象從鍵,輕鬆實現百萬級賬號快速查詢
  4. 支持IIdentity接口


角色 Role

角色數據模型:

  <Table Name="Role" Description="角色" RenderGenEntity="true">
    <Columns>
      <Column Name="ID" DataType="Int32" Identity="True" PrimaryKey="True" Description="編號" />
      <Column Name="Name" DataType="String" Master="True" Nullable="False" Description="名稱" />
      <Column Name="Enable" DataType="Boolean" Description="啟用" />
      <Column Name="IsSystem" DataType="Boolean" Description="系統。用於業務系統開發使用,不受數據權限約束,禁止修改名稱或刪除" />
      <Column Name="Permission" DataType="String" Length="500" Description="權限。對不同資源的權限,逗號分隔,每個資源的權限子項豎線分隔" />
      <Column Name="Ex1" DataType="Int32" Description="擴展1" />
      <Column Name="Ex2" DataType="Int32" Description="擴展2" />
      <Column Name="Ex3" DataType="Double" Description="擴展3" />
      <Column Name="Ex4" DataType="String" Description="擴展4" />
      <Column Name="Ex5" DataType="String" Description="擴展5" />
      <Column Name="Ex6" DataType="String" Description="擴展6" />
      <Column Name="CreateUser" DataType="String" Description="創建用戶" />
      <Column Name="CreateUserID" DataType="Int32" Description="創建用戶" />
      <Column Name="CreateIP" DataType="String" Description="創建地址" />
      <Column Name="CreateTime" DataType="DateTime" Nullable="False" Description="創建時間" />
      <Column Name="UpdateUser" DataType="String" Description="更新用戶" />
      <Column Name="UpdateUserID" DataType="Int32" Description="更新用戶" />
      <Column Name="UpdateIP" DataType="String" Description="更新地址" />
      <Column Name="UpdateTime" DataType="DateTime" Nullable="False" Description="更新時間" />
      <Column Name="Remark" DataType="String" Length="200" Description="備註" />
    </Columns>
    <Indexes>
      <Index Columns="Name" Unique="True" />
    </Indexes>
  </Table>

角色表比較簡單主要是名稱和啟用,以及保存菜單權限數據的Permission

角色支持的操作權限:

    /// <summary>操作權限</summary>
    [Flags]
    [Description("操作權限")]
    public enum PermissionFlags
    {
        /// <summary>無權限</summary>
        [Description("無權限")]
        None = 0,

        /// <summary>查看權限</summary>
        [Description("查看")]
        Detail = 1,

        /// <summary>添加權限</summary>
        [Description("添加")]
        Insert = 2,

        /// <summary>修改權限</summary>
        [Description("修改")]
        Update = 4,

        /// <summary>刪除權限</summary>
        [Description("刪除")]
        Delete = 8,

        /// <summary>所有權限</summary>
        [Description("所有")]
        All = 0xFF,
    }

主要功能點:

  1. 數據表為空時初始化4個基本角色:管理員、高級用戶、普通用戶、遊客
  2. 啟動時角色權限校驗,清理角色中無效的權限項(可能菜單已刪除),以及授權管理員訪問所有角色都無權訪問的新菜單
  3. 支持編號查詢FindByID和名稱查詢FindByID,採用實體緩存,目標系統不會超過1000個角色
  4. 支持權限判斷與設置 Has/Get/Set/Reset 等
  5. 重載實體類 Delete/Save/Update/OnLoad/OnPropertyChanged,加載實體對象時展開權限,保存時合併


菜單 Menu

菜單數據模型:

  <Table Name="Menu" Description="菜單" BaseType="EntityTree" RenderGenEntity="true">
    <Columns>
      <Column Name="ID" DataType="Int32" Identity="True" PrimaryKey="True" Description="編號" />
      <Column Name="Name" DataType="String" Master="True" Nullable="False" Description="名稱" />
      <Column Name="DisplayName" DataType="String" Description="显示名" />
      <Column Name="FullName" DataType="String" Length="200" Description="全名" />
      <Column Name="ParentID" DataType="Int32" Description="父編號" />
      <Column Name="Url" DataType="String" Length="200" Description="鏈接" />
      <Column Name="Sort" DataType="Int32" Description="排序" />
      <Column Name="Icon" DataType="String" Description="圖標" />
      <Column Name="Visible" DataType="Boolean" Description="可見" />
      <Column Name="Necessary" DataType="Boolean" Description="必要。必要的菜單,必須至少有角色擁有這些權限,如果沒有則自動授權給系統角色" />
      <Column Name="Permission" DataType="String" Length="200" Description="權限子項。逗號分隔,每個權限子項名值豎線分隔" />
      <Column Name="Ex1" DataType="Int32" Description="擴展1" />
      <Column Name="Ex2" DataType="Int32" Description="擴展2" />
      <Column Name="Ex3" DataType="Double" Description="擴展3" />
      <Column Name="Ex4" DataType="String" Description="擴展4" />
      <Column Name="Ex5" DataType="String" Description="擴展5" />
      <Column Name="Ex6" DataType="String" Description="擴展6" />
      <Column Name="CreateUser" DataType="String" Description="創建用戶" />
      <Column Name="CreateUserID" DataType="Int32" Description="創建用戶" />
      <Column Name="CreateIP" DataType="String" Description="創建地址" />
      <Column Name="CreateTime" DataType="DateTime" Nullable="False" Description="創建時間" />
      <Column Name="UpdateUser" DataType="String" Description="更新用戶" />
      <Column Name="UpdateUserID" DataType="Int32" Description="更新用戶" />
      <Column Name="UpdateIP" DataType="String" Description="更新地址" />
      <Column Name="UpdateTime" DataType="DateTime" Nullable="False" Description="更新時間" />
      <Column Name="Remark" DataType="String" Length="200" Description="備註" />
    </Columns>
    <Indexes>
      <Index Columns="Name" />
      <Index Columns="ParentID,Name" Unique="True" />
    </Indexes>
  </Table>

菜單實體類採用樹形實體基類 EntityTree ,通過 ParentID 實現上下級關聯,同級 ParentID+Name 唯一


主要功能點:

  1. 支持自動掃描Controller作為菜單,因此魔方只需要增加Controller,即可在菜單表看到新頁面
  2. 實體樹適用於1000行以內樹形數據表,一次性加載數據到內存,在內存中根據ParentID構造實體對象樹,最常用樹形是Parent/Childs


日誌統計

日誌 Log

數據模型:

  <Table Name="Log" Description="日誌" ConnName="Log" RenderGenEntity="true">
    <Columns>
      <Column Name="ID" DataType="Int32" Identity="True" PrimaryKey="True" Description="編號" />
      <Column Name="Category" DataType="String" Description="類別" />
      <Column Name="Action" DataType="String" Description="操作" />
      <Column Name="LinkID" DataType="Int32" Description="鏈接" />
      <Column Name="UserName" DataType="String" Description="用戶名" />
      <Column Name="Ex1" DataType="Int32" Description="擴展1" />
      <Column Name="Ex2" DataType="Int32" Description="擴展2" />
      <Column Name="Ex3" DataType="Double" Description="擴展3" />
      <Column Name="Ex4" DataType="String" Description="擴展4" />
      <Column Name="Ex5" DataType="String" Description="擴展5" />
      <Column Name="Ex6" DataType="String" Description="擴展6" />
      <Column Name="CreateUser" DataType="String" Description="創建用戶" />
      <Column Name="CreateUserID" DataType="Int32" Description="用戶編號" />
      <Column Name="CreateIP" DataType="String" Description="IP地址" />
      <Column Name="CreateTime" DataType="DateTime" Nullable="False" Description="時間" />
      <Column Name="Remark" DataType="String" Length="500" Description="詳細信息" />
    </Columns>
    <Indexes>
      <Index Columns="Category" />
      <Index Columns="CreateUserID" />
      <Index Columns="CreateTime" />
    </Indexes>
  </Table>

日誌表記錄分類、操作和日誌內容。

主要功能點:

  1. 日誌提供者LogProvider,提供了唯一核心方法 WriteLog,默認實現就是寫該日誌表。可從對象容器取得日誌提供者 ObjectContainer.Resolve<LogProvider>()
  2. 從IManageProvider接口獲取當前登錄用戶以及遠程訪問IP寫入日誌相應字段


在線 UserOnline

數據模型:

  <Table Name="UserOnline" Description="用戶在線" ConnName="Log">
    <Columns>
      <Column Name="ID" DataType="Int32" Identity="True" PrimaryKey="True" Description="編號" />
      <Column Name="UserID" DataType="Int32" Description="用戶" />
      <Column Name="Name" DataType="String" Master="True" Description="名稱" />
      <Column Name="SessionID" DataType="String" Description="會話。Web的SessionID或Server的會話編號" />
      <Column Name="Times" DataType="Int32" Description="次數" />
      <Column Name="Page" DataType="String" Description="頁面" />
      <Column Name="Status" DataType="String" Length="200" Description="狀態" />
      <Column Name="OnlineTime" DataType="Int32" Description="在線時間。本次在線總時間,秒" />
      <Column Name="CreateIP" DataType="String" Description="創建地址" />
      <Column Name="CreateTime" DataType="DateTime" Nullable="False" Description="創建時間" />
      <Column Name="UpdateTime" DataType="DateTime" Nullable="False" Description="修改時間" />
    </Columns>
    <Indexes>
      <Index Columns="UserID" />
      <Index Columns="SessionID" />
      <Index Columns="CreateTime" />
    </Indexes>
  </Table>

藉助用戶行為模塊 UserBehaviorModule , 維護用戶在線記錄,持久化在 UserOnline 表


訪問統計 VisitStat

  <Table Name="VisitStat" Description="訪問統計" ConnName="Log">
    <Columns>
      <Column Name="ID" DataType="Int32" Identity="True" PrimaryKey="True" Description="編號" />
      <Column Name="Level" DataType="Int32" Description="層級" Type="XCode.Statistics.StatLevels" />
      <Column Name="Time" DataType="DateTime" Description="時間" />
      <Column Name="Page" DataType="String" Nullable="False" Description="頁面" />
      <Column Name="Title" DataType="String" Master="True" Description="標題" />
      <Column Name="Times" DataType="Int32" Description="次數" />
      <Column Name="Users" DataType="Int32" Description="用戶" />
      <Column Name="IPs" DataType="Int32" Description="IP" />
      <Column Name="Error" DataType="Int32" Description="錯誤" />
      <Column Name="Cost" DataType="Int32" Description="耗時。毫秒" />
      <Column Name="MaxCost" DataType="Int32" Description="最大耗時。毫秒" />
      <Column Name="CreateTime" DataType="DateTime" Nullable="False" Description="創建時間" />
      <Column Name="UpdateTime" DataType="DateTime" Nullable="False" Description="更新時間" />
      <Column Name="Remark" DataType="String" Length="5000" Description="詳細信息" />
    </Columns>
    <Indexes>
      <Index Columns="Page,Level,Time" Unique="True" />
      <Index Columns="Level,Time" />
    </Indexes>
  </Table>

藉助用戶行為模塊 UserBehaviorModule , 維護用戶訪問記錄,寫入日誌表,並寫入訪問統計表。

主要功能要點:

  1. 記錄頁面訪問統計,簡單支持IP數和用戶數
  2. 支持年月日三級統計,作為XCode日期統計表的標準示例


其它

部門 Department

數據模型:

  <Table Name="Department" Description="部門。組織機構,多級樹狀結構" BaseType="EntityTree" RenderGenEntity="true">
    <Columns>
      <Column Name="ID" DataType="Int32" Identity="True" PrimaryKey="True" Description="編號" />
      <Column Name="Code" DataType="String" Description="代碼" />
      <Column Name="Name" DataType="String" Master="True" Nullable="False" Description="名稱" />
      <Column Name="FullName" DataType="String" Length="200" Description="全名" />
      <Column Name="ParentID" DataType="Int32" Description="父級" />
      <Column Name="Level" DataType="Int32" Description="層級。樹狀結構的層級" />
      <Column Name="Sort" DataType="Int32" Description="排序。同級內排序" />
      <Column Name="Enable" DataType="Boolean" Description="啟用" />
      <Column Name="Visible" DataType="Boolean" Description="可見" />
      <Column Name="Ex1" DataType="Int32" Description="擴展1" />
      <Column Name="Ex2" DataType="Int32" Description="擴展2" />
      <Column Name="Ex3" DataType="Double" Description="擴展3" />
      <Column Name="Ex4" DataType="String" Description="擴展4" />
      <Column Name="Ex5" DataType="String" Description="擴展5" />
      <Column Name="Ex6" DataType="String" Description="擴展6" />
      <Column Name="CreateUser" DataType="String" Description="創建用戶" />
      <Column Name="CreateUserID" DataType="Int32" Description="創建用戶" />
      <Column Name="CreateIP" DataType="String" Description="創建地址" />
      <Column Name="CreateTime" DataType="DateTime" Nullable="False" Description="創建時間" />
      <Column Name="UpdateUser" DataType="String" Description="更新用戶" />
      <Column Name="UpdateUserID" DataType="Int32" Description="更新用戶" />
      <Column Name="UpdateIP" DataType="String" Description="更新地址" />
      <Column Name="UpdateTime" DataType="DateTime" Nullable="False" Description="更新時間" />
      <Column Name="Remark" DataType="String" Length="200" Description="備註" />
    </Columns>
    <Indexes>
      <Index Columns="Name" />
      <Index Columns="ParentID,Name" Unique="True" />
      <Index Columns="Code" />
      <Index Columns="UpdateTime" />
    </Indexes>
  </Table>


字典參數 Parameter

數據模型:

  <Table Name="Parameter" Description="字典參數">
    <Columns>
      <Column Name="ID" DataType="Int32" Identity="True" PrimaryKey="True" Description="編號" />
      <Column Name="Category" DataType="String" Description="類別" />
      <Column Name="Name" DataType="String" Master="True" Description="名稱" />
      <Column Name="Value" DataType="String" Length="200" Description="數值" />
      <Column Name="LongValue" DataType="String" Length="2000" Description="長數值" />
      <Column Name="Kind" DataType="Int32" Description="種類。0普通,21列表,22名值" Type="XCode.Membership.ParameterKinds" />
      <Column Name="Enable" DataType="Boolean" Description="啟用" />
      <Column Name="Ex1" DataType="Int32" Description="擴展1" />
      <Column Name="Ex2" DataType="Int32" Description="擴展2" />
      <Column Name="Ex3" DataType="Double" Description="擴展3" />
      <Column Name="Ex4" DataType="String" Description="擴展4" />
      <Column Name="Ex5" DataType="String" Description="擴展5" />
      <Column Name="Ex6" DataType="String" Description="擴展6" />
      <Column Name="CreateUser" DataType="String" Description="創建用戶" />
      <Column Name="CreateUserID" DataType="Int32" Description="創建用戶" />
      <Column Name="CreateIP" DataType="String" Description="創建地址" />
      <Column Name="CreateTime" DataType="DateTime" Nullable="False" Description="創建時間" />
      <Column Name="UpdateUser" DataType="String" Description="更新用戶" />
      <Column Name="UpdateUserID" DataType="Int32" Description="更新用戶" />
      <Column Name="UpdateIP" DataType="String" Description="更新地址" />
      <Column Name="UpdateTime" DataType="DateTime" Nullable="False" Description="更新時間" />
      <Column Name="Remark" DataType="String" Length="200" Description="備註" />
    </Columns>
    <Indexes>
      <Index Columns="Category,Name" Unique="True" />
      <Index Columns="Name" />
      <Index Columns="UpdateTime" />
    </Indexes>
  </Table>


系列教程

NewLife.XCode教程系列[2019版]

  1. 增刪改查入門。快速展現用法,代碼配置連接字符串
  2. 數據模型文件。建立表格字段和索引,名字以及數據類型規範,推薦字段(時間,用戶,IP)
  3. 實體類詳解。數據類業務類,泛型基類,接口
  4. 功能設置。連接字符串,調試開關,SQL日誌,慢日誌,參數化,執行超時。代碼與配置文件設置,連接字符串局部設置
  5. 反向工程。自動建立數據庫數據表
  6. 數據初始化。InitData寫入初始化數據
  7. 高級增刪改。重載攔截,自增字段,Valid驗證,實體模型(時間,用戶,IP)
  8. 臟數據。如何產生,怎麼利用
  9. 增量累加。高併發統計
  10. 事務處理。單表和多表,不同連接,多種寫法
  11. 擴展屬性。多表關聯,Map映射
  12. 高級查詢。複雜條件,分頁,自定義擴展FieldItem,查總記錄數,查匯總統計
  13. 數據層緩存。Sql緩存,更新機制
  14. 實體緩存。全表整理緩存,更新機制
  15. 對象緩存。字典緩存,適用用戶等數據較多場景。
  16. 百億級性能。字段精鍊,索引完備,合理查詢,充分利用緩存
  17. 實體工廠。元數據,通用處理程序
  18. 角色權限。Membership
  19. 導入導出。Xml,Json,二進制,網絡或文件
  20. 分表分庫。常見拆分邏輯
  21. 高級統計。聚合統計,分組統計
  22. 批量寫入。批量插入,批量Upsert,異步保存
  23. 實體隊列。寫入級緩存,提升性能。
  24. 備份同步。備份數據,恢複數據,同步數據
  25. 數據服務。提供RPC接口服務,遠程執行查詢,例如SQLite網絡版
  26. 大數據分析。ETL抽取,調度計算處理,結果持久化

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

使用ASP.NET Web API和Web API Client Gen使Angular 2應用程序的開發更加高效

本文介紹“ 為ASP.NET Web API生成TypeScript客戶端API ”,重點介紹Angular 2+代碼示例和各自的SDLC。如果您正在開發.NET Core Web API後端,則可能需要閱讀為ASP.NET Core Web API生成C#Client API。

背景

自WebApiClientGenAngular 2仍然在RC2時,自2016年6月v1.9.0-beta 以來,對Angular2的支持已經可用。並且在WebApiClientGenv2.0中提供了對Angular 2產品發布的支持。希望NG2的發展不會如此頻繁地破壞我的CodeGen和我的Web前端應用程序。🙂

在2016年9月底發布Angular 2的第一個產品發布幾周后,我碰巧啟動了一個使用Angular2的主要Web應用程序項目,因此我WebApiClientGen對NG2應用程序開發的使用方法幾乎相同。

推定

  1. 您正在開發ASP.NET Web API 2.x應用程序,並將基於Angular 2+為SPA開發TypeScript庫。
  2. 您和其他開發人員喜歡在服務器端和客戶端都通過強類型數據和函數進行高度抽象。
  3. Web API和實體框架代碼優先使用POCO類,您可能不希望將所有數據類和成員發布到客戶端程序源碼。

並且可選地,如果您或您的團隊支持基於Trunk的開發,那麼更好,因為使用的設計WebApiClientGen和工作流程WebApiClientGen假設基於Trunk的開發,這比其他分支策略(如Feature Branching和GitFlow等)更有效。對於熟練掌握TDD的團隊。

為了跟進這種開發客戶端程序的新方法,最好有一個ASP.NET Web API項目。您可以使用現有項目,也可以創建演示項目。

使用代碼

本文重點介紹Angular 2+的代碼示例。假設您有一個ASP.NET Web API項目和一個Angular2項目作為VS解決方案中的兄弟項目。如果你將它們分開,那麼為了使開發步驟無縫地編寫腳本應該不難。

我認為您已閱讀“ 為ASP.NET Web API生成TypeScript客戶端API ”。為jQuery生成客戶端API的步驟幾乎與為Angular 2生成客戶端API的步驟相同。演示TypeScript代碼基於TUTORIAL:TOUR OF HEROES,許多人從中學習了Angular2。因此,您將能夠看到如何WebApiClientGen適應並改進Angular2應用程序的典型開發周期。

這是Web API代碼:

using System;
using System.Collections.Generic;
using System.Linq;
using System.Web.Http;
using System.Runtime.Serialization;
using System.Collections.Concurrent;

namespace DemoWebApi.Controllers
{
    [RoutePrefix("api/Heroes")]
    public class HeroesController : ApiController
    {
        public Hero[] Get()
        {
            return HeroesData.Instance.Dic.Values.ToArray();
        }

        public Hero Get(long id)
        {
            Hero r;
            HeroesData.Instance.Dic.TryGetValue(id, out r);
            return r;
        }

        public void Delete(long id)
        {
            Hero r;
            HeroesData.Instance.Dic.TryRemove(id, out r);
        }

        public Hero Post(string name)
        {
            var max = HeroesData.Instance.Dic.Keys.Max();
            var hero = new Hero { Id = max + 1, Name = name };
            HeroesData.Instance.Dic.TryAdd(max + 1, hero);
            return hero;
        }

        public Hero Put(Hero hero)
        {
            HeroesData.Instance.Dic[hero.Id] = hero;
            return hero;
        }

        [HttpGet]
        public Hero[] Search(string name)
        {
            return HeroesData.Instance.Dic.Values.Where(d => d.Name.Contains(name)).ToArray();
        }          
    }

    [DataContract(Namespace = DemoWebApi.DemoData.Constants.DataNamespace)]
    public class Hero
    {
        [DataMember]
        public long Id { get; set; }

        [DataMember]
        public string Name { get; set; }
    }

    public sealed class HeroesData
    {
        private static readonly Lazy<HeroesData> lazy =
            new Lazy<HeroesData>(() => new HeroesData());

        public static HeroesData Instance { get { return lazy.Value; } }

        private HeroesData()
        {
            Dic = new ConcurrentDictionary<long, Hero>(new KeyValuePair<long, Hero>[] {
                new KeyValuePair<long, Hero>(11, new Hero {Id=11, Name="Mr. Nice" }),
                new KeyValuePair<long, Hero>(12, new Hero {Id=12, Name="Narco" }),
                new KeyValuePair<long, Hero>(13, new Hero {Id=13, Name="Bombasto" }),
                new KeyValuePair<long, Hero>(14, new Hero {Id=14, Name="Celeritas" }),
                new KeyValuePair<long, Hero>(15, new Hero {Id=15, Name="Magneta" }),
                new KeyValuePair<long, Hero>(16, new Hero {Id=16, Name="RubberMan" }),
                new KeyValuePair<long, Hero>(17, new Hero {Id=17, Name="Dynama" }),
                new KeyValuePair<long, Hero>(18, new Hero {Id=18, Name="Dr IQ" }),
                new KeyValuePair<long, Hero>(19, new Hero {Id=19, Name="Magma" }),
                new KeyValuePair<long, Hero>(20, new Hero {Id=29, Name="Tornado" }),

                });
        }

        public ConcurrentDictionary<long, Hero> Dic { get; private set; }
    }
}


步驟0:將NuGet包WebApiClientGen安裝到Web API項目

安裝還將安裝依賴的NuGet包Fonlow.TypeScriptCodeDOM和Fonlow.Poco2Ts項目引用。

此外,用於觸發CodeGen的CodeGenController.cs被添加到Web API項目的Controllers文件夾中。

將CodeGenController只在調試版本開發過程中應該是可用的,因為客戶端API應該用於Web API的每個版本生成一次。

提示

如果您正在使用@ angular / http中定義的Angular2的Http服務,那麼您應該使用WebApiClientGenv2.2.5。如果您使用的HttpClient是@ angular / common / http中定義的Angular 4.3中可用的服務,並且在Angular 5中已棄用,那麼您應該使用WebApiClientGenv2.3.0。

第1步:準備JSON配置數據

下面的JSON配置數據是POSTCodeGen Web API:

{
    "ApiSelections": {
        "ExcludedControllerNames": [
            "DemoWebApi.Controllers.Account"
        ],

        "DataModelAssemblyNames": [
            "DemoWebApi.DemoData",
            "DemoWebApi"
        ],
        "CherryPickingMethods": 1
    },

    "ClientApiOutputs": {
        "ClientLibraryProjectFolderName": "DemoWebApi.ClientApi",
        "GenerateBothAsyncAndSync": true,

        "CamelCase": true,
        "TypeScriptNG2Folder": "..\\DemoAngular2\\clientapi",
        "NGVersion" : 5

    }
}


提示

Angular 6正在使用RxJS v6,它引入了一些重大變化,特別是對於導入Observable。默認情況下,WebApiClientGen2.4和更高版本默認將導入聲明為import { Observable } from 'rxjs';  。如果您仍在使用Angular 5.x,則需要"NGVersion" : 5在JSON配置中聲明,因此生成的代碼中的導入將是更多詳細信息,import { Observable } from 'rxjs/Observable'; . 請參閱RxJS v5.x至v6更新指南和RxJS:版本6的TSLint規則。

備註

您應確保“ TypeScriptNG2Folder”存在的文件夾存在,因為WebApiClientGen不會為您創建此文件夾,這是設計使然。

建議到JSON配置數據保存到與文件類似的這一個位於Web API項目文件夾。

如果您在Web API項目中定義了所有POCO類,則應將Web API項目的程序集名稱放在“ DataModelAssemblyNames” 數組中。如果您有一些專用的數據模型程序集可以很好地分離關注點,那麼您應該將相應的程序集名稱放入數組中。您可以選擇為jQuery或NG2或C#客戶端API代碼生成TypeScript客戶端API代碼,或者全部三種。

“ TypeScriptNG2Folder”是Angular2項目的絕對路徑或相對路徑。例如,“ .. \\ DemoAngular2 \\ ClientApi ”表示DemoAngular2作為Web API項目的兄弟項目創建的Angular 2項目“ ”。

在CodeGen根據“從POCO類生成強類型打字稿接口CherryPickingMethods,其在下面的文檔註釋描述”:

/// <summary>
/// Flagged options for cherry picking in various development processes.
/// </summary>
[Flags]
public enum CherryPickingMethods
{
    /// <summary>
    /// Include all public classes, properties and properties.
    /// </summary>
    All = 0,

    /// <summary>
    /// Include all public classes decorated by DataContractAttribute,
    /// and public properties or fields decorated by DataMemberAttribute.
    /// And use DataMemberAttribute.IsRequired
    /// </summary>
    DataContract =1,

    /// <summary>
    /// Include all public classes decorated by JsonObjectAttribute,
    /// and public properties or fields decorated by JsonPropertyAttribute.
    /// And use JsonPropertyAttribute.Required
    /// </summary>
    NewtonsoftJson = 2,

    /// <summary>
    /// Include all public classes decorated by SerializableAttribute,
    /// and all public properties or fields
    /// but excluding those decorated by NonSerializedAttribute.
    /// And use System.ComponentModel.DataAnnotations.RequiredAttribute.
    /// </summary>
    Serializable = 4,

    /// <summary>
    /// Include all public classes, properties and properties.
    /// And use System.ComponentModel.DataAnnotations.RequiredAttribute.
    /// </summary>
    AspNet = 8,
}


默認選項是DataContract選擇加入。您可以使用任何方法或組合方法。

第2步:運行Web API項目的DEBUG構建

步驟3:POST JSON配置數據以觸發客戶端API代碼的生成

在IIS Express上的IDE中運行Web項目。

然後使用Curl或Poster或任何您喜歡的客戶端工具POST到http:// localhost:10965 / api / CodeGen,with content-type=application/json。

提示

基本上,每當Web API更新時,您只需要步驟2來生成客戶端API,因為您不需要每次都安裝NuGet包或創建新的JSON配置數據。

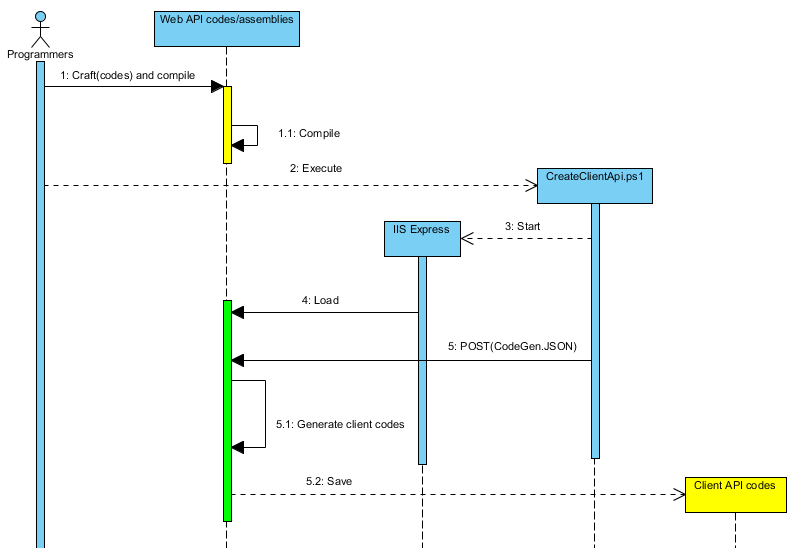
編寫一些批處理腳本來啟動Web API和POST JSON配置數據應該不難。為了您的方便,我實際起草了一個:Powershell腳本文件CreateClientApi.ps1,它在IIS Express上啟動Web(API)項目,然後發布JSON配置文件以觸發代碼生成。

基本上,您可以製作Web API代碼,包括API控制器和數據模型,然後執行CreateClientApi.ps1。而已!WebApiClientGen和CreateClientApi.ps1將為您完成剩下的工作。

發布客戶端API庫

現在您在TypeScript中生成了客戶端API,類似於以下示例:

import { Injectable, Inject } from '@angular/core';
import { Http, Headers, Response } from '@angular/http';
import { Observable } from 'rxjs/Observable';
export namespace DemoWebApi_DemoData_Client {
    export enum AddressType {Postal, Residential}

    export enum Days {Sat=1, Sun=2, Mon=3, Tue=4, Wed=5, Thu=6, Fri=7}

    export interface PhoneNumber {
        fullNumber?: string;
        phoneType?: DemoWebApi_DemoData_Client.PhoneType;
    }

    export enum PhoneType {Tel, Mobile, Skype, Fax}

    export interface Address {
        id?: string;
        street1?: string;
        street2?: string;
        city?: string;
        state?: string;
        postalCode?: string;
        country?: string;
        type?: DemoWebApi_DemoData_Client.AddressType;
        location?: DemoWebApi_DemoData_Another_Client.MyPoint;
    }

    export interface Entity {
        id?: string;
        name: string;
        addresses?: Array<DemoWebApi_DemoData_Client.Address>;
        phoneNumbers?: Array<DemoWebApi_DemoData_Client.PhoneNumber>;
    }

    export interface Person extends DemoWebApi_DemoData_Client.Entity {
        surname?: string;
        givenName?: string;
        dob?: Date;
    }

    export interface Company extends DemoWebApi_DemoData_Client.Entity {
        businessNumber?: string;
        businessNumberType?: string;
        textMatrix?: Array<Array<string>>;
        int2DJagged?: Array<Array<number>>;
        int2D?: number[][];
        lines?: Array<string>;
    }

    export interface MyPeopleDic {
        dic?: {[id: string]: DemoWebApi_DemoData_Client.Person };
        anotherDic?: {[id: string]: string };
        intDic?: {[id: number]: string };
    }
}

export namespace DemoWebApi_DemoData_Another_Client {
    export interface MyPoint {
        x: number;
        y: number;
    }

}

export namespace DemoWebApi_Controllers_Client {
    export interface FileResult {
        fileNames?: Array<string>;
        submitter?: string;
    }

    export interface Hero {
        id?: number;
        name?: string;
    }
}

   @Injectable()
    export class Heroes {
        constructor(@Inject('baseUri') private baseUri: string = location.protocol + '//' + 
        location.hostname + (location.port ? ':' + location.port : '') + '/', private http: Http){
        }

        /**
         * Get all heroes.
         * GET api/Heroes
         * @return {Array<DemoWebApi_Controllers_Client.Hero>}
         */
        get(): Observable<Array<DemoWebApi_Controllers_Client.Hero>>{
            return this.http.get(this.baseUri + 'api/Heroes').map(response=> response.json());
        }

        /**
         * Get a hero.
         * GET api/Heroes/{id}
         * @param {number} id
         * @return {DemoWebApi_Controllers_Client.Hero}
         */
        getById(id: number): Observable<DemoWebApi_Controllers_Client.Hero>{
            return this.http.get(this.baseUri + 'api/Heroes/'+id).map(response=> response.json());
        }

        /**
         * DELETE api/Heroes/{id}
         * @param {number} id
         * @return {void}
         */
        delete(id: number): Observable<Response>{
            return this.http.delete(this.baseUri + 'api/Heroes/'+id);
        }

        /**
         * Add a hero
         * POST api/Heroes?name={name}
         * @param {string} name
         * @return {DemoWebApi_Controllers_Client.Hero}
         */
        post(name: string): Observable<DemoWebApi_Controllers_Client.Hero>{
            return this.http.post(this.baseUri + 'api/Heroes?name='+encodeURIComponent(name), 
            JSON.stringify(null), { headers: new Headers({ 'Content-Type': 
            'text/plain;charset=UTF-8' }) }).map(response=> response.json());
        }

        /**
         * Update hero.
         * PUT api/Heroes
         * @param {DemoWebApi_Controllers_Client.Hero} hero
         * @return {DemoWebApi_Controllers_Client.Hero}
         */
        put(hero: DemoWebApi_Controllers_Client.Hero): Observable<DemoWebApi_Controllers_Client.Hero>{
            return this.http.put(this.baseUri + 'api/Heroes', JSON.stringify(hero), 
            { headers: new Headers({ 'Content-Type': 'text/plain;charset=UTF-8' 
            }) }).map(response=> response.json());
        }

        /**
         * Search heroes
         * GET api/Heroes?name={name}
         * @param {string} name keyword contained in hero name.
         * @return {Array<DemoWebApi_Controllers_Client.Hero>} Hero array matching the keyword.
         */
        search(name: string): Observable<Array<DemoWebApi_Controllers_Client.Hero>>{
            return this.http.get(this.baseUri + 'api/Heroes?name='+
            encodeURIComponent(name)).map(response=> response.json());
        }
    }


提示

如果您希望生成的TypeScript代碼符合JavaScript和JSON的camel大小寫,則可以在WebApiConfigWeb API的腳手架代碼類中添加以下行:

config.Formatters.JsonFormatter.SerializerSettings.ContractResolver = 
            new Newtonsoft.Json.Serialization.CamelCasePropertyNamesContractResolver();

然後屬性名稱和函數名稱將在camel大小寫中,前提是C#中的相應名稱都在Pascal大小寫中。有關詳細信息,請查看camelCasing或PascalCasing。

客戶端應用編程

在像Visual Studio這樣的正常文本編輯器中編寫客戶端代碼時,您可能會獲得很好的智能感知。

import { Component, OnInit } from '@angular/core';
import { Router } from '@angular/router';
import * as namespaces from '../clientapi/WebApiNG2ClientAuto';
import DemoWebApi_Controllers_Client = namespaces.DemoWebApi_Controllers_Client;

@Component({
    moduleId: module.id,
    selector: 'my-heroes',
    templateUrl: 'heroes.component.html',
    styleUrls: ['heroes.component.css']
})


通過IDE進行設計時類型檢查,並在生成的代碼之上進行編譯時類型檢查,可以更輕鬆地提高客戶端編程的效率和產品質量。

不要做計算機可以做的事情,讓計算機為我們努力工作。我們的工作是為客戶提供自動化解決方案,因此最好先自行完成自己的工作。

興趣點

在典型的角2個教程,包括官方的一個  這已經存檔,作者經常督促應用程序開發者製作一個服務類,如“ HeroService”,而黃金法則是:永遠委託給配套服務類的數據訪問。

WebApiClientGen為您生成此服務類DemoWebApi_Controllers_Client.Heroes,它將使用真正的Web API而不是內存中的Web API。在開發過程中WebApiClientGen,我創建了一個演示項目DemoAngular2和各自用於測試的Web API控制器。

典型的教程還建議使用模擬服務進行單元測試。WebApiClientGen使用真正的Web API服務要便宜得多,因此您可能不需要創建模擬服務。您應該在開發期間平衡使用模擬或實際服務的成本/收益,具體取決於您的上下文。通常,如果您的團隊已經能夠在每台開發機器中使用持續集成環境,那麼使用真實服務運行測試可能非常無縫且快速。

在典型的SDLC中,在初始設置之後,以下是開發Web API和NG2應用程序的典型步驟:

  1. 升級Web API
  2. 運行CreateClientApi.ps1以更新TypeScript for NG2中的客戶端API。
  3. 使用生成的TypeScript客戶端API代碼或C#客戶端API代碼,在Web API更新時創建新的集成測試用例。
  4. 相應地修改NG2應用程序。
  5. 要進行測試,請運行StartWebApi.ps1以啟動Web API,並在VS IDE中運行NG2應用程序。

提示

對於第5步,有其他選擇。例如,您可以使用VS IDE同時以調試模式啟動Web API和NG2應用程序。一些開發人員可能更喜歡使用“ npm start”。

本文最初是為Angular 2編寫的,具有Http服務。Angular 4.3中引入了WebApiClientGen2.3.0支持HttpClient。並且生成的API在接口級別保持不變。這使得從過時的Http服務遷移到HttpClient服務相當容易或無縫,與Angular應用程序編程相比,不使用生成的API而是直接使用Http服務。

順便說一句,如果你沒有完成向Angular 5的遷移,那麼這篇文章可能有所幫助:  升級到Angular 5和HttpClient。如果您使用的是Angular 6,則應使用WebApiClientGen2.4.0+。

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

HBase 系統架構及數據結構

一、基本概念

一個典型的Hbase Table 表如下:

1.1 Row Key (行鍵)

Row Key是用來檢索記錄的主鍵。想要訪問HBase Table中的數據,只有以下三種方式:

  • 通過指定的Row Key進行訪問;
  • 通過Row Key的range進行訪問,即訪問指定範圍內的行;
  • 進行全表掃描。

Row Key可以是任意字符串,存儲時數據按照Row Key的字典序進行排序。這裏需要注意以下兩點:

  • 因為字典序對Int排序的結果是1,10,100,11,12,13,14,15,16,17,18,19,2,20,21,…,9,91,92,93,94,95,96,97,98,99。如果你使用整型的字符串作為行鍵,那麼為了保持整型的自然序,行鍵必須用0作左填充。
  • 行的一次讀寫操作時原子性的 (不論一次讀寫多少列)。

1.2 Column Family(列族)

HBase表中的每個列,都歸屬於某個列族。列族是表的Schema的一部分,所以列族需要在創建表時進行定義。列族的所有列都以列族名作為前綴,例如courses:history,courses:math都屬於courses這個列族。

1.3 Column Qualifier (列限定符)

列限定符,你可以理解為是具體的列名,例如courses:history,courses:math都屬於courses這個列族,它們的列限定符分別是history和math。需要注意的是列限定符不是表Schema的一部分,你可以在插入數據的過程中動態創建列。

1.4 Column(列)

HBase中的列由列族和列限定符組成,它們由:(冒號)進行分隔,即一個完整的列名應該表述為列族名 :列限定符。

1.5 Cell

Cell是行,列族和列限定符的組合,並包含值和時間戳。你可以等價理解為關係型數據庫中由指定行和指定列確定的一個單元格,但不同的是HBase中的一個單元格是由多個版本的數據組成的,每個版本的數據用時間戳進行區分。

1.6 Timestamp(時間戳)

HBase 中通過row key和column確定的為一個存儲單元稱為Cell。每個Cell都保存着同一份數據的多個版本。版本通過時間戳來索引,時間戳的類型是 64位整型,時間戳可以由HBase在數據寫入時自動賦值,也可以由客戶顯式指定。每個Cell中,不同版本的數據按照時間戳倒序排列,即最新的數據排在最前面。

二、存儲結構

2.1 Regions

HBase Table中的所有行按照Row Key的字典序排列。HBase Tables 通過行鍵的範圍(row key range)被水平切分成多個Region, 一個Region包含了在start key 和 end key之間的所有行。

每個表一開始只有一個Region,隨着數據不斷增加,Region會不斷增大,當增大到一個閥值的時候,Region就會等分為兩個新的Region。當Table中的行不斷增多,就會有越來越多的Region。

Region是HBase中分佈式存儲和負載均衡的最小單元。這意味着不同的Region可以分佈在不同的Region Server上。但一個Region是不會拆分到多個Server上的。

2.2 Region Server

Region Server運行在HDFS的DataNode上。它具有以下組件:

  • WAL(Write Ahead Log,預寫日誌):用於存儲尚未進持久化存儲的數據記錄,以便在發生故障時進行恢復。
  • BlockCache:讀緩存。它將頻繁讀取的數據存儲在內存中,如果存儲不足,它將按照最近最少使用原則清除多餘的數據。
  • MemStore:寫緩存。它存儲尚未寫入磁盤的新數據,並會在數據寫入磁盤之前對其進行排序。每個Region上的每個列族都有一個MemStore。
  • HFile :將行數據按照Key\Values的形式存儲在文件系統上。

Region Server存取一個子表時,會創建一個Region對象,然後對錶的每個列族創建一個Store實例,每個Store會有 0 個或多個StoreFile與之對應,每個StoreFile則對應一個HFile,HFile 就是實際存儲在HDFS上的文件。

三、Hbase系統架構

3.1 系統架構

HBase系統遵循Master/Salve架構,由三種不同類型的組件組成:

Zookeeper

  1. 保證任何時候,集群中只有一個Master;
  2. 存貯所有Region的尋址入口;
  3. 實時監控Region Server的狀態,將Region Server的上線和下線信息實時通知給Master;
  4. 存儲HBase的Schema,包括有哪些Table,每個Table有哪些Column Family等信息。

Master

  1. 為Region Server分配Region ;
  2. 負責Region Server的負載均衡 ;
  3. 發現失效的Region Server並重新分配其上的Region;
  4. GFS上的垃圾文件回收;
  5. 處理Schema的更新請求。

Region Server

  1. Region Server負責維護Master分配給它的Region ,並處理髮送到Region上的IO請求;
  2. Region Server負責切分在運行過程中變得過大的Region。

3.2 組件間的協作

HBase使用ZooKeeper作為分佈式協調服務來維護集群中的服務器狀態。 Zookeeper負責維護可用服務列表,並提供服務故障通知等服務:

  • 每個Region Server都會在ZooKeeper上創建一個臨時節點,Master通過Zookeeper的Watcher機制對節點進行監控,從而可以發現新加入的Region Server或故障退出的Region Server;
  • 所有Masters會競爭性地在Zookeeper上創建同一個臨時節點,由於Zookeeper只能有一個同名節點,所以必然只有一個Master能夠創建成功,此時該Master就是主Master,主Master會定期向Zookeeper發送心跳。備用Masters則通過Watcher機制對主HMaster所在節點進行監聽;
  • 如果主Master未能定時發送心跳,則其持有的Zookeeper會話會過期,相應的臨時節點也會被刪除,這會觸發定義在該節點上的Watcher事件,使得備用的Master Servers得到通知。所有備用的Master Servers在接到通知后,會再次去競爭性地創建臨時節點,完成主Master的選舉。

四、數據的讀寫流程簡述

4.1 寫入數據的流程

  1. Client向Region Server提交寫請求;
  2. Region Server找到目標Region;
  3. Region檢查數據是否與Schema一致;
  4. 如果客戶端沒有指定版本,則獲取當前系統時間作為數據版本;
  5. 將更新寫入WAL Log;
  6. 將更新寫入Memstore;
  7. 判斷Memstore存儲是否已滿,如果存儲已滿則需要flush為Store Hfile文件。

更為詳細寫入流程可以參考:HBase - 數據寫入流程解析

4.2 讀取數據的流程

以下是客戶端首次讀寫HBase上數據的流程:

  1. 客戶端從Zookeeper獲取META表所在的Region Server;
  2. 客戶端訪問META表所在的Region Server,從META表中查詢到訪問行鍵所在的Region Server,之後客戶端將緩存這些信息以及META表的位置;
  3. 客戶端從行鍵所在的Region Server上獲取數據。

如果再次讀取,客戶端將從緩存中獲取行鍵所在的Region Server。這樣客戶端就不需要再次查詢META表,除非Region移動導致緩存失效,這樣的話,則將會重新查詢並更新緩存。

注:META表是HBase中一張特殊的表,它保存了所有Region的位置信息,META表自己的位置信息則存儲在ZooKeeper上。

更為詳細讀取數據流程參考:

HBase原理-數據讀取流程解析

HBase原理-遲到的‘數據讀取流程部分細節

參考資料

本篇文章內容主要參考自官方文檔和以下兩篇博客,圖片也主要引用自以下兩篇博客:

  • HBase Architectural Components
  • Hbase系統架構及數據結構

官方文檔:

  • Apache HBase ™ Reference Guide

更多大數據系列文章可以參見個人 GitHub 開源項目: 大數據入門指南

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!