高速輸出-我們戲說緩存

前言

緩存要解決的問題是速度的問題,使用緩存的目的是為了減少對物理資源的訪問,緩存大量的應用在軟硬件的方方面面,從 CPU 到硬盤,就應用了 一級緩存、二級緩存,少部分高速緩存和大量低速緩存相結合,以提高 CPU 的計算能力,本文講的主要是系統集成項目中的軟件級別的緩存。

緩存因果圖

緩存在現代系統中的位置可以說是舉足輕重,不是可有可無的問題了,而是怎麼樣用好的問題。怎麼樣講好緩存這個話題,我思考了很久;如果是生搬硬套,我估計我肯定是涼涼,但要是上來就一頓代碼操作,顯得字太多,各位看官老爺也是要噴死我的(你們噴我算我贏)。各位看官就當故事隨便看看就好了。

客戶端緩存

小明同學是一個大學生,每個月都會從爸爸那裡領取生活費,由於爸爸給的生活費比較充裕,他就將一部分存了起來,周而復始,固定頻率,這就是瀏覽器網頁緩存;有一天,他接到爸爸的一個電話,說每個月給現金,我總是從銀行拿也不方便,這樣,咱給存銀行卡裡頭,但是說好了,每個月1號的時候轉1000塊進去,3號之前可以領取,過時不侯。這就是 Cookie!小明說爸,這時間太緊迫了,我萬一太過於專心學習忘記取錢那你兒子可是要餓死的吖,到時候沒人給你養老送終事兒就大了。他爸爸經過深思熟慮后,決定放開取現時間的限制:行,你想什麼時候取都成,就是別把卡給弄掉了就行。這就是LocalStorage/IndexDB,瀏覽器本地存儲。如果銀行卡掉了(瀏覽器重裝,刪庫跑路),那還得找爸爸。

服務器緩存

我們本次討論的重點就是服務器緩存,對於小明的爸爸來說,每次給小明生活費之前都要到銀行(數據庫)去取錢出來,實在是太麻煩,不如提前把錢取出來準備好,每次取半年的錢出來放家裡保險箱里(緩存),小明申請生活費的時候,直接給他就好了,節約時間效率又高,唯一的問題就是可能沒那麼安全,有可能被小偷把錢給偷了(緩存更新),然後就是半年時間過後再重新取一筆出來(緩存過期策略)。

靜態對象緩存

靜態對象也是一種特殊的緩存,靜態對象作用於程序的整個生命周期中。需要注意的是,靜態對象不會被 GC 回收 ,但是,如果靜態對象被多次引用覆蓋,那麼之前的引用就有可能被 GC 回收。這就好像,小明在向爸爸領取生活費的時候,發現這次領到手的錢實在是太破舊了,都不好意思花出去,爸爸只好重新給了另一份。

會話級緩存

在 Web 站點中,Session 是私有制的,各個 Session 之間是不會共享內存對象的,我們可以利用這個特性(在Asp.NET 時代常用)來暫時保存一些數據,例如用戶購物車。還是以小明的需求為例子,小明下面還有一個妹妹,妹妹每個月都可以從爸爸那裡多領取200元生活費,看到妹妹的資源這麼好,小明憤憤不平,就像妹妹提議共享生活費,一家人一起用,多好吖!結果小明被爸爸揍了一頓,還收回了部分生活費。

進程級別緩存

基本上每個應用程序都具有本地緩存的能力,在 Asp.NET 中就有 MemoryCache ,也叫做進程級緩存(本地緩存),MemoryCache 和 分佈式緩存的作用基本一致,所不同的是,本地緩存在應用程序停止后就會被釋放掉,無法進行持久存儲。就好像,小明在上大學期間,每個月都是生活費的,但是到暑假的時候就沒有了(只能靠苦逼的暑期工掙點生活費啊)。

分佈式緩存

分佈式緩存是個好東西,目前市場上出現了非常多的 nosql 數據庫,都可用作緩存數據庫,有時候,這些緩存數據庫也提供持久化的能力。

小明家的生活條件,在經過爸爸的不懈努力之後,生活水平漸漸提高了;有一天,爸爸對小明說:明仔吖,咱們家現在生活水平提高了,但是爸爸也越來越忙了,這樣,如果我忙的時候,你問媽媽或者爺爺奶奶,也是可以拿到生活費的,咱們家這幾位長輩手裡都有錢了,這就是分佈式緩存。

但是分佈式緩存又分為主從模式和集群模式,上面說的是集群模式,爸爸媽媽爺爺奶奶都可以拿錢,但是主從模式就不同了,主從模式就是錢都在爸爸手裡,爸爸會把錢分給每個長輩一份,如果當時正好爸爸太忙了,沒來得及分給媽媽,而小明又恰好問媽媽要生活費的話;媽媽只能對他說:小命呀,不好意思,媽媽這裏也沒有,你看看再問問其它人(客戶端自己輪詢),在問了媽媽、爺爺后(引用指向),終於知道,錢在爸爸那裡,還得問爸爸要生活費。而且爸爸給其它人分錢的時候,還要佔用他工作的時間。

緩存雪崩

緩存雪崩就是在某一個時刻,大量的緩存同時失效,造成數據庫訪問壓力倍增。小明的爸爸最近壓力比較大,因為收入減少了,他爸爸做的一個工程因為種種原因,貨款只能分期付清,為了防止小明和妹妹同時申請生活費,造成資金周轉困難;爸爸規定妹妹 1 號領取生活費,而小明在 5 號才能領取,小明心裏的苦啊!

緩存穿透

緩存穿透就是客戶端總是嘗試訪問某個不存在的緩存,造成了每次都要取請求數據庫讀取數據。就好像小明吧,本來生活挺平靜的,這剛上大二,就交了個女朋友,每個月的 1000 元生活費有點捉襟見肘,然後他又不能讓爸爸知道,就在申請生活費的時候,每次都多要一點;這樣就搞得爸爸很被動,本來計劃得好好的,每個月都是 1000 塊,這沒次都不夠,老是要跑銀行取現金,終於在3個月後,爸爸發現了這個問題,想著兒子也大了,為了早日抱上孫子,就提高了小明的生活費,解決了每次都要跑銀行的問題。

緩存擊穿

緩存擊穿和緩存雪崩有點類似,其中不同的是;緩存雪崩是大量緩存 key 同時過期,而緩存擊穿是大量的請求指向同一個緩存key,在這個 key 過期的時候,大量的請求湧入數據庫中,造成了瞬間巨大的壓力。舉個栗子,因為小明交了女朋友的原因,他的生活費總是很快用完了;這種情況下,他也必須在 1 號的時候拿到生活費,不然就要吃土了,但是媽媽不允許他們一起取打擾爸爸,媽媽就指定了妹妹去問,在妹妹沒有回來之前,小明只能等着,這就是為了解決緩存擊穿而採用的策略:互斥鎖(mutex key)

運維級別緩存

除了在應用程序中可以接入緩存以外,部分運維工具也集成了緩存服務,比如 Nginx、IIS。

代理緩存

Nginx 就是反向代理緩存,通過配置 Nginx 的緩存功能,在客戶端請求到來到時候去加載緩存內容,用以提高響應能力,IIS 緩存又分為用戶緩存和內核緩存。IIS 的輸出緩存設置中,內核模式緩存不會對驗證等用戶信息進行檢查,就好像小明等爸爸因為太趕時間,把錢放門衛大媽那裡了,結果隨便來了個學生就把小明等生活費給領走了,但是加上用戶模式緩存后,就可以添加對身份的檢查(請求標頭),這樣大媽就會知道誰是小明而不會隨便把生活費交給別人了。

網頁靜態化

這種技術,在 Web1.0 時代非常的流行,我還記得那些個年頭的網站開發項目中的要求,大部分項目的需求分析文檔裏面就明晃晃的寫着:網頁靜態化!,而靜態化常見於各種企業型、論壇帖子,在發表這些信息后就將其生成靜態網頁,客戶端訪問的時候,直接重定向到該靜態網頁,基本無需訪問數據庫。

CDN 緩存

CDN 緩存類似於上面提到的分佈式緩存,但是實際上 CDN 緩存服務目前來說,主要說針對靜態資源的,比如圖片、視頻、文件等等;大家經常可以看到,很多站點都號稱提供了 CDN 加速服務,這些站點就像一個個代辦信用卡的銷售中介,實際上拿的都是銀行的資源。

更形象一些的說法,就是大家的錢都是中國人民銀行發行的,我們可以通過各個不同的銀行(CDN節點)查詢我們的銀行卡餘額(我怎麼可能有餘額),在以前沒有手機銀行的時候,大家就可以到附近的銀行去查詢,然後取款(CDN緩存),如果附近的銀行的櫃員機沒有現金,那麼可能就需要到總行去取了(回源),如果發生了太多回源的事件,就會造成 CDN 的擁堵,所以 CDN 服務商也不敢打包票自己的基礎服務沒有問題,反正我是沒見到哪家 CDN 服務商敢註明服務穩定性 100%,基本上都是 99.99%

結束語

緩存的理論知識,其實是非常宏大的,我這裏只是拋磚引玉,希望能給入門的朋友帶來一點幫助,如果你喜歡這篇文章,請給我點贊,讓更多同學可以看到。

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

SpringBoot啟動流程分析(五):SpringBoot自動裝配原理實現

SpringBoot系列文章簡介

SpringBoot源碼閱讀輔助篇:

  Spring IoC容器與應用上下文的設計與實現

SpringBoot啟動流程源碼分析:

  1. SpringBoot啟動流程分析(一):SpringApplication類初始化過程
  2. SpringBoot啟動流程分析(二):SpringApplication的run方法
  3. SpringBoot啟動流程分析(三):SpringApplication的run方法之prepareContext()方法
  4. SpringBoot啟動流程分析(四):IoC容器的初始化過程
  5. SpringBoot啟動流程分析(五):SpringBoot自動裝配原理實現
  6. SpringBoot啟動流程分析(六):IoC容器依賴注入

筆者註釋版Spring Framework與SpringBoot源碼git傳送門:請不要吝嗇小星星

  1. spring-framework-5.0.8.RELEASE
  2. SpringBoot-2.0.4.RELEASE

自定義Starter:

  SpringBoot應用篇(一):自定義starter

一、前言

  上一篇文章,通過分析refresh()方法中的invokeBeanFactoryPostProcessors()方法,分析了IoC容器的初始化過程,這一節從代碼上如下所示,接上一節ConfigurationClassParser類中的parse()方法,接着分析SpringBoot的自動裝配原理。

 1 // ConfigurationClassParser類
 2 public void parse(Set<BeanDefinitionHolder> configCandidates) {
 3     this.deferredImportSelectors = new LinkedList<>();
 4     for (BeanDefinitionHolder holder : configCandidates) {
 5         BeanDefinition bd = holder.getBeanDefinition();
 6         try {
 7             // 如果是SpringBoot項目進來的,bd其實就是前面主類封裝成的 AnnotatedGenericBeanDefinition(AnnotatedBeanDefinition接口的實現類)
 8             if (bd instanceof AnnotatedBeanDefinition) {
 9                 parse(((AnnotatedBeanDefinition) bd).getMetadata(), holder.getBeanName());
10             } else if (bd instanceof AbstractBeanDefinition && ((AbstractBeanDefinition) bd).hasBeanClass()) {
11                 parse(((AbstractBeanDefinition) bd).getBeanClass(), holder.getBeanName());
12             } else {
13                 parse(bd.getBeanClassName(), holder.getBeanName());
14             }
15         } catch (BeanDefinitionStoreException ex) {
16             throw ex;
17         } catch (Throwable ex) {
18             throw new BeanDefinitionStoreException(
19                     "Failed to parse configuration class [" + bd.getBeanClassName() + "]", ex);
20         }
21     }
22     // 加載默認的配置---》(對springboot項目來說這裏就是自動裝配的入口了)
23     processDeferredImportSelectors();
24 }


二、SpringBoot自動裝配原理。

2.1、@SpringBootApplication註解

  對這個註解詳細大家一定非常熟悉了。再來好好看看這個註解。

 1 @Target(ElementType.TYPE)
 2 @Retention(RetentionPolicy.RUNTIME)
 3 @Documented
 4 @Inherited
 5 @SpringBootConfiguration
 6 @EnableAutoConfiguration
 7 @ComponentScan(excludeFilters = {
 8         @Filter(type = FilterType.CUSTOM, classes = TypeExcludeFilter.class),
 9         @Filter(type = FilterType.CUSTOM, classes = AutoConfigurationExcludeFilter.class) })
10 public @interface SpringBootApplication {
11     ...
12 }

  接着看@EnableAutoConfiguration

1 @Target(ElementType.TYPE)
2 @Retention(RetentionPolicy.RUNTIME)
3 @Documented
4 @Inherited
5 @AutoConfigurationPackage
6 @Import(AutoConfigurationImportSelector.class)
7 public @interface EnableAutoConfiguration {
8     ...
9 }

  OK,看到@Import(AutoConfigurationImportSelector.class)導入了一個重要的類AutoConfigurationImportSelector。

2.2、AutoConfigurationImportSelector

 1 // AutoConfigurationImportSelector類
 2 //自動裝配
 3 @Override
 4 public String[] selectImports(AnnotationMetadata annotationMetadata) {
 5     if (!isEnabled(annotationMetadata)) {
 6         return NO_IMPORTS;
 7     }
 8     AutoConfigurationMetadata autoConfigurationMetadata = AutoConfigurationMetadataLoader
 9             .loadMetadata(this.beanClassLoader);
10     AnnotationAttributes attributes = getAttributes(annotationMetadata);
11     //獲取所有的自動配置類(META-INF/spring.factories中配置的key為org.springframework.boot.autoconfigure.EnableAutoConfiguration的類)
12     List<String> configurations = getCandidateConfigurations(annotationMetadata,
13             attributes);
14     configurations = removeDuplicates(configurations);
15     //需要排除的自動裝配類(springboot的主類上 @SpringBootApplication(exclude = {com.demo.starter.config.DemoConfig.class})指定的排除的自動裝配類)
16     Set<String> exclusions = getExclusions(annotationMetadata, attributes);
17     checkExcludedClasses(configurations, exclusions);
18     //將需要排除的類從 configurations remove掉
19     configurations.removeAll(exclusions);
20     configurations = filter(configurations, autoConfigurationMetadata);
21     fireAutoConfigurationImportEvents(configurations, exclusions);
22     return StringUtils.toStringArray(configurations);
23 }

  至於怎麼從章節一中提到的ConfigurationClassParser類中的parse()===>processDeferredImportSelectors()==>AutoConfigurationImportSelector#selectImports(),篇幅有限不做過多介紹。

   List<String> configurations = getCandidateConfigurations(annotationMetadata, attributes); 

  我們來看一下getCandidateConfigurations()方法是怎麼拿到這些自動配置類的。

// AutoConfigurationImportSelector類
1
protected List<String> getCandidateConfigurations(AnnotationMetadata metadata, 2 AnnotationAttributes attributes) { 3 List<String> configurations = SpringFactoriesLoader.loadFactoryNames( 4 getSpringFactoriesLoaderFactoryClass(), getBeanClassLoader()); 5 Assert.notEmpty(configurations, 6 "No auto configuration classes found in META-INF/spring.factories. If you " 7 + "are using a custom packaging, make sure that file is correct."); 8 return configurations; 9 }

  是不是又看到一個十分熟悉的方法loadFactoryNames(),沒錯,其實我們在分析SpringBoot啟動流程的第一篇文章的時候,就已經分析了,SpringBoot是如何從META-INF/spring.factories中加載指定key的value的。ok,我們在這裏再次回顧一遍。

  看看loadFactoryNames()方法

// SpringFactoriesLoader類
1
public static List<String> loadFactoryNames(Class<?> factoryClass, @Nullable ClassLoader classLoader) { 2 String factoryClassName = factoryClass.getName(); 3 return loadSpringFactories(classLoader).getOrDefault(factoryClassName, Collections.emptyList()); 4 }

  debug,看看要從META-INF/spring.factories中加載的類的key,如下圖所示:org.springframework.boot.autoconfigure.EnableAutoConfiguration

  回到selectImports()方法,debug,跳過List<String> configurations = getCandidateConfigurations(annotationMetadata,attributes);看一下configurations

  竟然有110個,那這些類都在哪裡呢?看spring-boot-autoconfigure(當然在SpringBoot的工程中,也不止這一個依賴包中存在該配置文件)工程下的META-INF/spring.factories,我們能看到org.springframework.boot.autoconfigure.EnableAutoConfiguration定義了一大堆。

  其中還有一個com.demo.starter.config.DemoConfig是我自定義的starter。如下所示,我在測試工程中添加了自定義starter的依賴,所以SpringBoot就能掃描到。

1 <dependency>
2     <groupId>com.demo</groupId>
3     <artifactId>demo-spring-boot-starter</artifactId>
4     <version>0.0.1-RELEASE</version>
5 </dependency>

   繼續看Set<String> exclusions = getExclusions(annotationMetadata, attributes);方法,該方法是排除主類上@SpringBootApplication註解上排除的自動裝配的類。比如我們在該註解上排除我們自定義starter的自動裝配的類,@SpringBootApplication(exclude = {com.demo.starter.config.DemoConfig.class})(當然也可以用excludeName進行排除),那麼在後面的configurations.removeAll(exclusions);方法中將會刪除我們的com.demo.starter.config.DemoConfig.class。

  configurations = filter(configurations, autoConfigurationMetadata);該行代碼將會過濾掉不需要裝配的類。過濾的邏輯有很多,比如我們常用的@ConditionXXX註解。如下所示:

 1 @ConditionalOnBean:容器中有指定的Bean 
 2 @ConditionalOnClass:當類路徑下有指定的類
 3 @ConditionalOnExpression:基於SpEL表達式作為判斷條件  
 4 @ConditionalOnJava:基於JVM版本作為判斷條件  
 5 @ConditionalOnJndi:在JNDI存在的條件下查找指定的位置  
 6 @ConditionalOnMissingBean:當容器中沒有指定Bean的情況下  
 7 @ConditionalOnMissingClass:當類路徑下沒有指定的類
 8 @ConditionalOnNotWebApplication:當前項目不是Web項目
 9 @ConditionalOnProperty:配置文件中指定的屬性是否有指定的值  
10 @ConditionalOnResource:類路徑下是否有指定的資源  
11 @ConditionalOnSingleCandidate:當指定Bean在容器中只有一個,或者雖然有多個但是指定首選Bean
12 @ConditionalOnWebApplication:當前項目是Web項目的條件下

   至於如何將這些類解析成BeanDefinition並註冊進beanDefinition中的,和上一節講的過程是一樣的,不再贅述了。

  debug,跳過refresh()方法中的invokeBeanFactoryPostProcessors(beanFactory);方法。如下圖所示,最終在beanFactory的BeanDefinitionMap中找到了自定義starter中的自動裝配的類。


  綜合本文和上一篇博文我們詳細的梳理了IoC容器的初始化過程,到此IoC容器的初始化過程就結束了。


  原創不易,轉載請註明出處。

  如有錯誤的地方還請留言指正。

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

一文帶你了解爬蟲

六月分享主題:爬蟲
HTTP詳解
網頁結構簡介

前段時間我媽突然問我:兒子,爬蟲是什麼?我當時既驚訝又尷尬,驚訝的是為什麼我媽會對爬蟲好奇?尷尬的是我該怎麼給她解釋呢?

一、爬蟲介紹

1.爬蟲是什麼

網絡爬蟲(web crawler 簡稱爬蟲)就是按照一定規則從互聯網上抓取信息的程序,既然是程序那和正常用戶訪問頁面有何區別?爬蟲與用戶正常訪問信息的區別就在於:用戶是緩慢、少量的獲取信息,而爬蟲是大量的獲取信息。

這裏還需要注意的是:爬蟲並不是Python語言的專利,Java、Js、C、PHP、Shell、Ruby等等語言都可以實現,那為什麼Python爬蟲會這麼火?我覺得相比其他語言做爬蟲Python可能就是各種庫完善點、上手簡單大家都在用,社區自然活躍,而社區活躍促成Python爬蟲慢慢變成熟,成熟又促使更多用戶來使用,如此良性循環,所以Python爬蟲相比其他語言的爬蟲才更火。

下面是一段hello world級別的Python爬蟲,它等效於你在百度搜索關鍵字:python。

2.爬蟲案例

既然爬蟲是大量抓取網頁,那是不是爬蟲都是不好的呢?答案當然不是,可以說我們的日常上網已經離不開爬蟲了,為什麼這麼說?下面我就為大家盤點幾個爬蟲日常應用:

  1. 搜索引擎:如Google、百度、雅虎、搜狗、必應等等很多搜索引擎其本質就是一個(可能多個)巨大爬蟲,這些搜索引擎工作原理是:頁面收錄->頁面分析->頁面排序->響應關鍵字查詢,也就是說它會先把互聯網上很多頁面保存到服務器,然後分析網頁內容建立關鍵字索引,最後用戶輸入關鍵字的時候去查詢內容,然後根據相關性排序(百度害人的競價排名毫無相關性可言),第一步的頁面收錄就是爬蟲,百度查看一個網站有多少網頁被收錄方法,百度輸入:site:你想查詢的網站,如:site:blog.csdn.net。
  2. 搶票軟件:很多人在吐槽12306卡,可你不知道12306幾乎每天都相當於淘寶雙11的流量,這誰受得了。為什麼每天都是如此高的流量?答案自然是爬蟲了,為什麼搶票軟件可以搶票?因為它在不斷的刷新和監控是否有餘票,大大小小這麼多搶票app,訪問量之高可想而知。之前很多公司都出過搶票插件,如:百度、360、金山、搜狗等等,後來都被鐵道部約談下線了,而現在又流行搶票app,為什麼搶票app可以,插件就不可以?可能是因為管理和可控性的原因。
  3. 惠惠購物助手:這是一款能進行多個網站比價並能知道最低價的一個網站,其工作原理也是通過大量爬蟲爬取商品價格然後存儲,這樣就可以製作一個價格走勢圖,幫助你了解商品最低價。

二、爬蟲的價值

從上面舉的幾個例子來看,爬蟲對整個互聯網的價值真的無法估量,那對於小我而言,爬蟲能給我們帶來哪些價值?

1.隱形的翅膀

如果你問我學完Python基礎之後該學習什麼技能?我會毫不猶疑的說爬蟲,為什麼是爬蟲?

  1. 爬蟲相對其他技能簡單易學,且效果立即可見,會有一定的成就感
  2. 爬蟲可以說是其他技能的基石,因為他是數據的來源,現在這個時代誰有數據誰才能稱王,所以會爬蟲絕對會讓你如虎添翼
  3. 在國內,很多企業巴不得你啥都會,所以在應聘時,爬蟲會是一個不錯的加分項

2.看不見的商戰

職場對話:

老闆:小明給你個重要任務。
小明:就算996我也在所不辭(第一次接到老闆的直接需求)!
老闆:你能不能搞到競爭對手的商品價格?
小明:沒問題(牛逼先吹出去),小事!
老闆:這可不是小事,只要你能持續獲取競品價格,我們就可以標價低於他們一點點,持續如此大家就知道我們的價格肯定是比他們低,這樣大家就直接來我們這裏購買商品了,到時候慶功宴上你就是最大功臣(先畫個餅)。
小明:老闆牛逼,老闆英明!

3.會爬蟲就可以創業

工作之後很多同學會利用上班空餘時間,來做自己的東西或者項目,別看開始是一個小打小鬧的東西,慢慢豐富將來也許會成為一款成熟的產品。

而爬蟲可以讓你很輕鬆的實現自己的產品,做的好的話就可以創業。這裏豬哥給大家列幾個簡單的創業項目,當然作為一個思維引導。

如果你想做一款好的產品,你需要從用戶需求出發去思考,做解決目前存在的問題的產品或者目前還沒有的服務,也許你的產品就是下一個頭條。

三、盜亦有道

爬蟲既然如此強大而優秀,那是不是會了爬蟲就可以為所欲為?

延伸話題:其實我內心一直有一個疑問:為什麼互聯網公司都偏愛用動植物來命名或作為logo?如:螞蟻金服、天貓、菜鳥、金東狗、騰訊企鵝,百度的熊掌、搜狗、途牛、美團的袋鼠。。。真的是太多了,難道僅僅是因為好記?我認為好記是一個原因,其根本原因是受到編程行業的影響,你想想編程行業有多少動植物:Java(咖啡)、Python(蟒蛇)、Go(囊地鼠)、PHP(大象)、Linux(企鵝)、Perl(駱駝)、Mysql(海豚)等等,具體為什麼編程行業喜歡用動植物這豬哥就不清楚,還請明白的同學留言告知大家!

講上面的延伸話題想表達的是,大自然世間萬物,相生相剋,衡而不禍!而爬蟲也是如此,下面就為大家介紹一下約束爬蟲的幾個點。

1.robots協議

做過網站的同學也許知道,我們在建站的時候需要在網站根目錄下放一個文件:robots.txt,這個文件是干什麼用的呢?

Robots協議,也稱為爬蟲協議、機器人協議等,其全稱為“網絡爬蟲排除標準(Robots Exclusion Protocol)”。網站通過Robots協議告訴搜索引擎哪些頁面可以抓取,哪些頁面不能抓取。

每個網站的根目錄下都必須放置robots.txt文件,否則搜索引擎將不收錄網站任何網頁。

下面我們以百度為例子,來看看百度的robots.txt文件:

我們在百度robots協議的最下面,有這樣一條:

User-agent: *
Disallow: /

這表示除上面那些定義過的爬蟲以外其他爬蟲都不允許爬取百度任何東西!

2.法律

我們都知道在發起請求時User-agent是可以自定義的,也就是說我們可以繞過robots協議和以User-agent來定義的反爬蟲技術,所以robots協議可能更像一個君子協議,那咱們國家有沒有法律明文規定呢?我們來了解一下非法侵入計算機信息系統罪:

第二百八十五條 非法侵入計算機信息系統罪:違反國家規定,侵入前款規定以外的計算機信息系統或者採用其他技術手段,獲取該計算機信息系統中存儲、處理或者傳輸的數據,或者對該計算機信息系統實施非法控制,情節嚴重的,處三年以下有期徒刑或者拘役,並處或者單處罰金;情節特別嚴重的,處三年以上七年以下有期徒刑,並處罰金。

我們可以看到重點信息:入侵計算機獲取數據是違法的,也就是說爬蟲技術本身是無罪的,因為它是獲取的公開信息,並未非法入侵計算機。但是如果你用爬取到的數據去從事商業化操作,那也許就構成了違法犯罪行為!

給大家介紹下因爬蟲而被判刑的案件:

  1. 頭條爬蟲官司:https://dwz.cn/qBBHc2fq
  2. 酷米客公司官司:https://dwz.cn/9IpAOHGB
  3. 360和百度爬蟲官司:https://dwz.cn/RGRa3HJc

我發現這幾起案件的通性有兩點:1、公司性質。2、競爭對手。3、讓人家找到線索。

最後提醒大家:技術人,要守住自己的底線,違反國家法律法規的事情咱們堅決不能做!

3.反爬蟲工程師

本來想採訪一位攜程反爬蟲工程師,但是他說由於工作保密原因不便接受採訪,所以只好尊重他的選擇!

四、爬蟲現狀

之前豬哥說過互聯網中有超過50%的流量來自爬蟲,那我們就來簡單聊聊目前爬蟲的現狀吧!

1.技術

反爬蟲幾乎和爬蟲同時誕生,它們是相愛相殺的連個技術,如果沒有爬蟲就沒有反扒,而反扒技術又反過來又可以促進爬蟲技術的發展。

  1. 交互問題:各種變態的驗證碼充斥,尤其是12306,分分鐘都想爆粗口,以後會越來越變態。。。
  2. js加密:最近很流行的一種反扒技術,會爬蟲還得先學js,然後反爬蟲工程師在js裏面各種投毒,殺人誅心。。。
  3. IP限制:限制單個ip某段時間內訪問次數

豬哥只介紹了一個反扒技術,當然都有現成的技術解決,但是作為爬蟲員最重的並不是會使用工具或框架去應對反扒,而是能通過自己的思考和摸索破解反扒,因為反扒技術更新快且多樣化。

2.就業

就業的話主要從招聘、薪資、就業形勢三個方面分析,我從網上查閱了一些資料,然後整理以圖片形式提供給大家參考。

數據來源:職友集:https://dwz.cn/6PeU46QY

3.前景

現在很多人並不看好爬蟲的前景,只搞爬蟲的話技術只停留在當前水平,不再學習新知識,不再進步的話,那麼是沒有前途的,總有一天會被時代淘汰,其實其他職位也只如此。

每個職業都是有一個橫向和縱向的發展,也就是所謂的廣度和深度的意思。第一、如果專研得夠深,你的爬蟲功能很強大,性能很高,擴展性很好等等,那麼還是很有前途的。第二、爬蟲作為數據的來源,後面還有很多方向可以發展,比如可以往大數據分析、數據展示、機器學習等方面發展,前途不可限量,現在作為大數據時代,你佔據在數據的的入口,還怕找不到發展方向?所以爬蟲也許只是一個起點一個跳板,是你走向人生巔峰的一個基石,總有一天你會迎娶白富美!

五、總結

本期為大家講解什麼是爬蟲、爬蟲的價值、爬蟲的合法性以及爬蟲的現狀,下期豬哥將採訪一位牛逼的爬蟲工程師,讓他為大家講講實際工作中的一些知識以及作為一名爬蟲工程師該掌握和學習哪些技能,讓大家能更近距離接觸爬蟲,如果你有想對他提問的問題,可以在下方留言哦,我會抽取一些問題讓他為大家解答,問題不限

​

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

Spring Boot從入門到實戰:整合通用Mapper簡化單表操作

數據庫訪問是web應用必不可少的部分。現今最常用的數據庫ORM框架有Hibernate與Mybatis,Hibernate貌似在傳統IT企業用的較多,而Mybatis則在互聯網企業應用較多。通用Mapper(https://github.com/abel533/Mapper) 是一個基於Mybatis,將單表的增刪改查通過通用方法實現,來減少SQL編寫的開源框架,且也有對應開源的mapper-spring-boot-starter提供。我們在此基礎上加了一些定製化的內容,以便達到更大程度的復用。

框架源碼地址:https://github.com/ronwxy/base-spring-boot (持續更新完善中,歡迎follow,star)
Demo源碼地址:https://github.com/ronwxy/springboot-demos/tree/master/springboot-tkmapper

在開源mapper-spring-boot-starter的基礎上,增加了如下內容:

  1. 針對MySQL數據庫與PostgreSQL數據庫添加了一些Java類型與數據庫類型的轉換處理類,如將List、Map類型與MySQL數據庫的json類型進行轉換處理
  2. 對Domain、Mapper、Service、Controller各層進行了封裝,將基本的增刪改查功能在各層通用化
  3. 提供了基於druid連接池的自動配置
  4. 其它一些調整,如默認映射複雜類型屬性(主要是List、Map類型,其它自定義類型需要自定義轉換處理類),將枚舉作為簡單類型處理
  5. 提供了一個parent項目,將一些常用的框架進行集成,實際項目可繼承parent簡化依賴配置(持續更新完善)

該框架可用於實際基於springboot的項目,只需簡單配置數據源,即可引入druid連接池及通用mapper的功能,以及各層基本的增刪改查方法。

如何使用?
下文給出使用步驟,可參考示例:https://github.com/ronwxy/springboot-demos/tree/master/springboot-tkmapper

1. 框架Maven部署安裝

下載框架源碼后,在項目根路徑下執行mvn clean install可安裝到本地maven庫。如果需要共享,且搭了Nexus私服,則在根路徑pom.xml文件中添加distributionManagement配置,指定Nexus倉庫分發地址,使用mvn clean deploy安裝到遠程maven倉庫,如

<distributionManagement>
     <repository>
         <id>nexus-releases</id>
         <url>
             http://ip:port/repository/maven-releases/
         </url>
     </repository>
     <snapshotRepository>
         <id>nexus-snapshots</id>
         <url>
             http://ip:port/repository/maven-snapshots/
         </url>
     </snapshotRepository>
 </distributionManagement>


上述指定的repository需要在maven的全部配置文件settings.xml中有對應賬號配置(id需要一一對應),如 

 <servers>
   <server>
     <id>nexus-snapshots</id>
     <username>admin</username>
     <password>xxx</password>
   </server>
<server>
     <id>nexus-releases</id>
     <username>admin</username>
     <password>xxx</password>
   </server>
 </servers>


2. pom.xml配置

項目中引入該數據庫框架有三種方式:

  1. 直接引入 cn.jboost.springboot:tkmapper-spring-boot-starter(沒有連接池)
  2. 直接引入 cn.jboost.springboot:druid-spring-boot-starter(druid連接池支持)
  3. 項目繼承 cn.jboost.springboot:spring-boot-parent(使用的是druid連接池)

三種方式的pom.xml配置如下

#第一種方式
<dependency>
   <groupId>cn.jboost.springboot</groupId>
   <artifactId>tkmapper-spring-boot-starter</artifactId>
   <version>1.2-SNAPSHOT</version>
</dependency>

#第二種方式
<dependency>
   <groupId>cn.jboost.springboot</groupId>
   <artifactId>druid-spring-boot-starter</artifactId>
   <version>1.2-SNAPSHOT</version>
</dependency>

#第三種方式
<parent>
   <groupId>cn.jboost.springboot</groupId>
   <artifactId>spring-boot-parent</artifactId>
   <version>1.2-SNAPSHOT</version>
   <relativePath/> <!-- lookup parent from repository -->
</parent>


根據情況引入mysql或postgresql的驅動依賴(其它數據庫暫未做類型轉換支持,未作測試)


3. 配置數據源

如果使用druid連接池,則在application.yml配置文件中,加入如下數據源配置(推薦)

spring:
  datasource:
    druid:
      driver-class-name: com.mysql.jdbc.Driver
      url: jdbc:mysql://localhost:3306/test?autoReconnect=true&useUnicode=true&characterEncoding=utf-8
      username: root
      password:
      # 自定義配置
      initialSize: 2  # 初始化大小
      minIdle: 1   # 最小連接
      maxActive: 5 # 最大連接
      druidServletSettings:
        allow: 127.0.0.1
        deny:
        loginUsername: admin
        loginPassword: Passw0rd
        resetEnable: true
      druidFilterSettings:
        exclusions: '*.js,*.gif,*.jpg,*.png,*.css,*.ico,/druid/*'
      maxWait: 60000   # 配置獲取連接等待超時的時間
      timeBetweenEvictionRunsMillis: 60000 # 配置間隔多久才進行一次檢測,檢測需要關閉的空閑連接,單位是毫秒
      minEvictableIdleTimeMillis: 300000 # 配置一個連接在池中最小生存的時間,單位是毫秒
      validationQuery: SELECT 'x'
      testWhileIdle: true
      testOnBorrow: false
      testOnReturn: false
      poolPreparedStatements: true # 打開PSCache,並且指定每個連接上PSCache的大小
      maxPoolPreparedStatementPerConnectionSize: 20
      filters: stat #,wall(添加wall代碼里不能直接拼接sql,druid有sql注入校驗) # 配置監控統計攔截的filters,去掉后監控界面sql無法統計,'wall'用於防火牆
      connectionProperties: druid.stat.mergeSql=true;druid.stat.slowSqlMillis=5000 # 通過connectProperties屬性來打開mergeSql功能;慢SQL記錄
      useGlobalDataSourceStat: true # 合併多個DruidDataSource的監控數據


如果不使用連接池,則配置相對簡單,如下 

spring:
  datasource:
    url: jdbc:mysql://localhost:3306/test?autoReconnect=true&useUnicode=true&characterEncoding=utf-8
    username: root
    password:
    driver-class-name: com.mysql.jdbc.Driver


4. 定義相應domain,mapper,service,controller各層對象 

以demo為例(demo數據庫腳本見resources/schema.sql),domain定義一個User類,

@Table(name = "user")
@Getter
@Setter
@ToString
public class User extends AutoIncrementKeyBaseDomain<Integer> {
    private String name;
    @ColumnType(jdbcType = JdbcType.CHAR)
    private Gender gender;
    private List<String> favor;
    private Map<String, String> address;

    public enum Gender{
        M,
        F
    }
}


需要添加@Table註解指定數據庫表名,可通過繼承AutoIncrementKeyBaseDomain來實現自增主鍵,或UUIDKeyBaseDomain來實現UUID主鍵,如果自定義其它類型主鍵,則繼承BaseDomain。 

該框架Service層通用方法實現BaseService只支持單列主鍵,不支持組合主鍵(也不建議使用組合主鍵)

框架默認對List、Map等複雜類型屬性會映射到mysql的json類型或postgresql的jsonb類型,如果某個屬性不需要映射,可添加@Transient註解;枚舉類型需添加@ColumnType指定jdbcType。

dao層定義UserMapper,

@Repository
public interface UserMapper extends BaseMapper<User> {
}


BaseMapper默認實現了單表的增刪改查及批量插入等功能,如需定義複雜查詢,可在該接口中定義,然後通過mapper xml文件編寫實現。 

service層定義 UserService,繼承了BaseService的通用功能(具體可查看源碼),同樣可在該類中自定義方法

@Service
public class UserService extends BaseService<Integer, User> {

    @Transactional
    public void createWithTransaction(User user){
        create(user);
        //用於測試事務
        throw new RuntimeException("拋出異常,讓前面的數據庫操作回滾");
    }
}


controller層定義 UserController,繼承了BaseController的通用接口(具體可查看源碼) 

@RestController
@RequestMapping("/user")
public class UserController extends BaseController<Integer, User> {
}


如上,只需要定義各層對應的接口或類,繼承基礎接口或類,便完成了用戶基本的增刪改查功能,不需要寫一行具體的實現代碼。 

5. 測試、運行

  1. 示例中提供了兩個新建用戶的單元測試,參考SpringbootTkmapperApplicationTests類

  2. 運行,在主類上直接運行,然後瀏覽器里打開 http://localhost:8080/user 則可列出單元測試中創建的用戶(其它接口參考BaseController實現)

6. 總結

本文介紹框架基於tk.mybatis:mapper-spring-boot-starter做了一些自定義擴展,以更大程度地實現復用。可用於實際項目開發,使用過程中如果遇到問題,可關注公眾號留言反饋。

我的個人博客地址:http://blog.jboost.cn
我的頭條空間: https://www.toutiao.com/c/user/5833678517/#mid=1636101215791112
我的github地址:https://github.com/ronwxy
我的微信公眾號:jboost-ksxy

————————————————————————————————————————

歡迎關注我的微信公眾號,及時獲取最新分享

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

Prometheus 入門

簡介

Prometheus 是一套開源的系統監控報警框架。它啟發於 Google 的 borgmon 監控系統,由工作在 SoundCloud 的 google 前員工在 2012 年創建,作為社區開源項目進行開發,並於 2015 年正式發布。

特點

作為新一代的監控框架,Prometheus 具有以下特點:

  • 強大的多維度數據模型:
  1. 時間序列數據通過 metric 名和鍵值對來區分。
  2. 所有的 metrics 都可以設置任意的多維標籤。
  3. 數據模型更隨意,不需要刻意設置為以點分隔的字符串。
  4. 可以對數據模型進行聚合,切割和切片操作。
  5. 支持雙精度浮點類型,標籤可以設為全 unicode。
  • 靈活而強大的查詢語句(PromQL):在同一個查詢語句,可以對多個 metrics 進行乘法、加法、連接、取分數位等操作。
  • 易於管理: Prometheus server 是一個單獨的二進制文件,可直接在本地工作,不依賴於分佈式存儲。
  • 高效:平均每個採樣點僅占 3.5 bytes,且一個 Prometheus server 可以處理數百萬的 metrics。
    使用 pull 模式採集時間序列數據,這樣不僅有利於本機測試而且可以避免有問題的服務器推送壞的 metrics。
  • 可以採用 push gateway 的方式把時間序列數據推送至 Prometheus server 端。
  • 可以通過服務發現或者靜態配置去獲取監控的 targets。
  • 有多種可視化圖形界面。
  • 易於伸縮。

組成及架構

Prometheus 生態圈中包含了多個組件,其中許多組件是可選的:

  • Prometheus Server: 用於收集和存儲時間序列數據。
  • Client Library: 客戶端庫,為需要監控的服務生成相應的 metrics 並暴露給 Prometheus server。當 Prometheus server 來 pull 時,直接返回實時狀態的 metrics。
  • Push Gateway: 主要用於短期的 jobs。由於這類 jobs 存在時間較短,可能在 Prometheus 來 pull 之前就消失了。為此,這次 jobs 可以直接向 Prometheus server 端推送它們的 metrics。這種方式主要用於服務層面的 metrics,對於機器層面的 metrices,需要使用 node exporter。
  • Exporters: 用於暴露已有的第三方服務的 metrics 給 Prometheus。
  • Alertmanager: 從 Prometheus server 端接收到 alerts 后,會進行去除重複數據,分組,並路由到對收的接受方式,發出報警。常見的接收方式有:电子郵件,pagerduty,OpsGenie, webhook 等。
  • 一些其他的工具。

下圖為 Prometheus 官方文檔中的架構圖:

從上圖可以看出,Prometheus 的主要模塊包括:Prometheus server, exporters, Pushgateway, PromQL, Alertmanager 以及圖形界面。

其大概的工作流程是:

  1. Prometheus server 定期從配置好的 jobs 或者 exporters 中拉 metrics,或者接收來自Pushgateway 發過來的 metrics,或者從其他的 Prometheus server 中拉 metrics。
  2. Prometheus server 在本地存儲收集到的 metrics,並運行已定義好的 alert.rules,記錄新的時間序列或者向 Alertmanager 推送警報。
  3. Alertmanager 根據配置文件,對接收到的警報進行處理,發出告警。
    在圖形界面中,可視化採集數據。

相關概念

下面將對 Prometheus 中的數據模型(時間序列),metric 類型,instance 和 jobs等概念進行介紹。

數據模型

Prometheus 中存儲的數據為時間序列,是由 metric 的名字和一系列的標籤(鍵值對)唯一標識的,不同的標籤則代表不同的時間序列。

  • metric 名字:該名字應該具有語義,一般用於表示 metric 的功能,例如:http_requests_ total, 表示 http 請求的總數。其中,metric 名字由 ASCII 字符,数字,下劃線,以及冒號組成,且必須滿足正則表達式 [a-zA-Z_:][a-zA-Z0-9_:]*。
  • 標籤:使同一個時間序列有了不同維度的識別。例如 http_requests_total{method=”Get”} 表示所有 http 請求中的 Get 請求。當 method=”post” 時,則為新的一個 metric。標籤中的鍵由 ASCII 字符,数字,以及下劃線組成,且必須滿足正則表達式 [a-zA-Z_:][a-zA-Z0-9_:]*。
  • 樣本:實際的時間序列,每個序列包括一個 float64 的值和一個毫秒級的時間戳。
  • 格式: { =, …},例如:http_requests_total{method=”POST”,endpoint=”/api/tracks”}。

Metrics種類

Prometheus客戶端庫提供了四種核心Metrics類型。

Counter(計數器)

  • 說明:Counter是一個累積度量,它表示一個單調遞增的 Metrics,其值只能在重啟時遞增或重置為零
  • 場景:可以使用Counter來表示http的請求數、已完成的任務數或錯誤數、下單數。

Gauge(測量儀)

  • 說明:當前值的一次快照(snapshot)測量,可增可減。
  • 場景:磁盤使用率,當前同時在線用戶數。

Histogram(直方圖)

  • 說明:通過區間統計樣本分佈。
  • 場景:請求延遲時間的統計。例如統計 0~200ms、200ms~400ms、400ms~800ms 區間的請求數有多。

Summary(匯總)

  • 說明:根據樣本統計出百分位。
  • 場景:請求延遲時間的統計。例如統計 95%的請求延遲 < xxx ms ,99%的請求延遲 < xxx ms

instance 和 jobs

在Prometheus術語中,你可以scrape(刮擦)的端點稱為 實例,通常對應於單個進程。一組同種類型的 instances(主要用於保證可擴展性和可靠性),例如:具有四個複製instances(實例)的API服務器job作業:

  • job: api-server
    • instance 1: 1.2.3.4:5670
    • instance 2: 1.2.3.4:5671
    • instance 3: 5.6.7.8:5670
    • instance 4: 5.6.7.8:5671

當Prometheus scrape(刮擦)目標時,它會自動在scrape的時間序列上附加一些標籤,用來識別scrape的目標。

  • job:目標所屬的已配置job名稱。
  • instance: : 已刮擦的目標URL 的一部分。

對於每次實例 scrape(刮取,Prometheus都會在以下時間序列中存儲樣本:

  • up{job=”<job-name>”, instance=”<instance-id>”}:1如果實例是健康的,即可達,或者0刮擦失敗。
  • scrape_duration_seconds{job=”<job-name>”, instance=”<instance-id>”}:刮擦持續時間。
  • scrape_samples_post_metric_relabeling{job=”<job-name>”, instance=”<instance-id>”}:應用度量標準重新標記后剩餘的樣本數。
  • scrape_samples_scraped{job=”<job-name>”, instance=”<instance-id>”}:目標暴露的樣本數。
  • scrape_series_added{job=”<job-name>”, instance=”<instance-id>”}:該刮擦中新系列的大致數量。v2.10中的新功能。

up時間序列對於實例可用性監視非常有用。

安裝和配置

安裝

你可以在官網 https://prometheus.io/download/ 下載 安裝包,解壓后使用。為了方便,我使用docker 鏡像的方式 運行Prometheus。

docker run --name prometheus -d -p 9090:9090 prom/prometheus

瀏覽器輸入http://localhost:9090 ,訪問 Prometheus 的 Web UI:

點擊菜單欄 “Status” 下的 Targets ,界面如下:

可以看大Prometheus 自身 metrics 處於UP狀態 ,說明 安裝成功。

配置

Prometheus 的配置文件 prometheus.yml 內容如下:

# 全局設置,可以被覆蓋
global:
  scrape_interval:     15s
  evaluation_interval: 15s
  
rule_files:
  # - "first.rules"
  # - "second.rules"

scrape_configs:
  - job_name: prometheus
    static_configs:
    - targets: ['localhost:9090']

該global塊控制 Prometheus 的全局配置。我們有兩種選擇。第一個,scrape_interval控制Prometheus 刮擦目標的頻率。你可以為單個目標覆蓋此值。在這種情況下,全局設置是每15秒刮一次。該evaluation_interval選項控制普羅米修斯評估規則的頻率。Prometheus 使用規則創建新的時間序列並生成警報。

該rule_files塊指定我們希望 Prometheus 加載的任何規則的位置。現在我們沒有規則。

最後一個塊scrape_configs控制 Prometheus 監視的資源。由於 Prometheus 還將自己的數據公開為HTTP端點,因此它可以抓取並監控自身的健康狀況。在默認配置中有一個名為 prometheus 的job,它抓取 prometheus 服務器 公開的時間序列數據。該作業包含一個靜態配置的目標,即端口9090上的本地主機。返回的時間序列數據將詳細說明Prometheus服務器的狀態和性能。

實驗

Prometheus HTTP 度量模擬器

為了演示 Prometheus 的簡單使用,這裏運行一個 Prometheus HTTP 度量模擬器。模擬一個簡單的HTTP微服務,生成Prometheus Metrics,通過 docker 運行。

docker run -p 8080:8080 pierrevincent/prom-http-simulator:0.1

它在/metrics端點下公開以下Prometheus指標:

  • http_requests_total:請求計數器,標籤endpoint和status
  • http_request_duration_milliseconds:請求延遲直方圖

可以開啟流量高峰模式,更改流量高峰模式可以通過以下方式完成:

# ON
curl -X POST http://127.0.0.1:8080/spike/on

# OFF
curl -X POST http://127.0.0.1:8080/spike/off

# RANDOM
curl -X POST http://127.0.0.1:8080/spike/random

錯誤率默認為1%。它可以更改為0到100之間的数字:

# 例如將錯誤率設置為50%
curl -H 'Content-Type: application/json' -X PUT -d '{"error_rate": 50}' http://127.0.0.1:8080/error_rate

修改Prometheus配置

需要將 HTTP 度量模擬器 的 metrics端點 配置到 Prometheus的配置文件 prometheus.yml 中。

創建一個 prometheus.yml 文件 內容如下:

global:
  scrape_interval: 5s
  evaluation_interval: 5s
  scrape_timeout: 5s

scrape_configs:
  - job_name: 'prometheus'
    static_configs:
    - targets: ['localhost:9090']
  - job_name: 'http-simulator'
    metrics_path: /metrics
    static_configs:
    - targets: ['172.16.1.232:8080']

通過docker up 命令替換 容器中的配置文件:

docker cp prometheus.yml prometheus:/etc/prometheus/

重啟容器:

docker restart prometheus

訪問 http://localhost:9090/targets ,發現已經出現了 target “http-simulator” ,並且為UP狀態。

查詢

請求率(Request Rate)查詢

查詢http請求數

http_requests_total{job="http-simulator"}

查詢成功login請求數

http_requests_total{job="http-simulator", status="200", endpoint="/login"}

查詢成功請求數,以endpoint區分

http_requests_total{job="http-simulator", status="200"}

查詢總成功請求數

sum(http_requests_total{job="http-simulator", status="200"})

查詢成功請求率,以endpoint區分

rate(http_requests_total{job="http-simulator", status="200"}[5m])

查詢總成功請求率

sum(rate(http_requests_total{job="http-simulator", status="200"}[5m]))

延遲分佈(Latency distribution)查詢

查詢http-simulator延遲分佈

http_request_duration_milliseconds_bucket{job="http-simulator"}

查詢成功login延遲分佈

http_request_duration_milliseconds_bucket{job="http-simulator", status="200", endpoint="/login"}

不超過200ms延遲的成功login請求佔比

sum(http_request_duration_milliseconds_bucket{job="http-simulator", status="200", endpoint="/login", le="200"}) / sum(http_request_duration_milliseconds_count{job="http-simulator", status="200", endpoint="/login"})

成功login請求延遲的99百分位

histogram_quantile(0.99, rate(http_request_duration_milliseconds_bucket{job="http-simulator", status="200", endpoint="/login"}[5m]))

上面給出的這些查詢表達式,在 prometheus 的 查詢界面上自行測試下 ,這裏就不一一測試了,

總結

本篇對 Prometheus 的組成,架構和基本概念進行了介紹,並實例演示了 Prometheus 的查詢表達式的應用。本篇是 Prometheus 系列的第一篇, 後續還會有Prometheus與其他圖形界面的集成,與 springboot 應用的集成等 。

參考

https://prometheus.io/docs/introduction/overview/
https://www.ibm.com/developerworks/cn/cloud/library/cl-lo-prometheus-getting-started-and-practice/index.html

歡迎掃碼或微信搜索公眾號《程序員果果》關注我,關注有驚喜~

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

Trie|如何用字典樹實現搜索引擎的關鍵詞提示功能

Trie字典樹

Trie字典樹又稱前綴樹,顧名思義,是查詢前綴匹配的一種樹形數據結構

可以分為插入(創建) 和 查詢兩部分。參考地址極客時間

下圖為插入字符串的過程:

創建完成后,每個字符串最後一個字母標記為終結點(圖中显示為紅色)

下圖為查詢字符串:“her”的過程:綠色箭頭表示查詢路徑
我們將要查找的字符串分割成單個的字符 h,e,r,一個一個查詢

下圖為查詢字符串:“he”的過程:綠色箭頭表示查詢路徑
因為‘e’不是終結點,所以不能完全匹配上。

Trie字典樹的實現

1.首先是字典樹 數據結構定義的代碼實現

樹形結構,類比於二叉樹的存儲嘛,每個結點兩條分支(二叉樹);
而字典樹,每個節點可以最多有 26個分支(存儲英文字母)。

1-1二維數組存儲字母

int trie[MAX_NODE][26];//MAX_NODE表示結點數量,每個結點有26個字母結點
int k;

MAX_NODE表示結點數量,每個結點有26個字母結點
Trie[i][j]的值是0,表示trie樹中i號節點,並沒有一條連出去的邊滿足邊上的字符標識是字符集中第j個字符(從0開始);
trie[i][j]的值是正整數x表示trie樹中i號節點,有一條連出去的邊滿足邊上的字符標識是字符集中第j個字符,並且
這條邊的終點是x號節點。

1-2鏈表
我這裏用C++中的vector實現,

vector< pair<char, int> > trie[MAX_NODE];
int k;

也可以寫一個真正的鏈表,包含二元組字段<char,int>型的對應關係

1-3hash,

map<char, int> trie[MAX_NODE];

每次我們想找i號節點有沒有標識
是某個字符ch的邊時,只要看trie[i][ch]的值即可
但是實際上map時空複雜度的常數都比較大

2.插入 和 查詢 兩個函數的代碼實現

插入 查詢 實際上是類似的,就是從樹的根開始往下遍歷,

2-1插入:從樹的根開始往下遍歷,到達一個結點,沒有這個字母就插入到這個結點下,作為這個結點的子節點

基於二維數組結構的插入功能實現

代碼的第6~8行,一開始trie[][]被初始化為0,保證每個節點被創建出來時,都沒有子節點。K初
始化為1表示一開始只有1個節點,也就是0號節點根節點。Color是用來標記一個節點是不是終結
點。Color[i]=1標識i號節點是終結點。
第9~21行是插入函數insert(w),w是字符指針,實際上可以看作是一個字符串。
第11行是p從0號節點開始。
第12~19行是依次插入w的每一個字符。
第13行是計算w[i]是字符集第幾個字符,這裏我們假設字符集只包含26個小寫字母。
第14~17行是如果p沒有連出標識是w[i]的邊,那麼就創建一個。這裏新創建的節點一定就是k號節
點。所謂創建新節點實際上也沒什麼可創建的,新節點就是個編號。所以我們直接令trie[i][c]=k
即可,然後將k累加1,整個創建過程就完成了。
第18行是沿着標記着w[i]的邊移動到下一個節點。
最後第20行,是將最後到達的節點p標記為終結點。

2-2查詢:從樹的根開始往下遍歷,查看是否匹配上當前正在查的單詞
基於二維數組結構的查詢功能實現

第24行是從p=0也就是根節點開始。
第25~29行是枚舉s的每一個字符。
第26行是計算當前字符s[i]在字符集的序號。
第27行是判斷p節點有沒有連出標識s[i]字符的邊,如果沒有,說明現在無路可走,直接返回0;如
果有的話,
第28行就是移動到下一個節點。如果整個循環結束還沒有return 0,那就說明成功沿着s的每一個
字符到達了p節點。這時只要判斷p節點是不是終結點即可,也就是第30行的代

3.完整代碼C++版

public class Trie {
  private TrieNode root = new TrieNode('/'); // 存儲無意義字符

  // 往 Trie 樹中插入一個字符串
  public void insert(char[] text) {
    TrieNode p = root;
    for (int i = 0; i < text.length; ++i) {
      int index = text[i] - 'a';
      if (p.children[index] == null) {
        TrieNode newNode = new TrieNode(text[i]);
        p.children[index] = newNode;
      }
      p = p.children[index];
    }
    p.isEndingChar = true;
  }

  // 在 Trie 樹中查找一個字符串
  public boolean find(char[] pattern) {
    TrieNode p = root;
    for (int i = 0; i < pattern.length; ++i) {
      int index = pattern[i] - 'a';
      if (p.children[index] == null) {
        return false; // 不存在 pattern
      }
      p = p.children[index];
    }
    if (p.isEndingChar == false) return false; // 不能完全匹配,只是前綴
    else return true; // 找到 pattern
  }

  public class TrieNode {
    public char data;
    public TrieNode[] children = new TrieNode[26];
    public boolean isEndingChar = false;
    public TrieNode(char data) {
      this.data = data;
    }
  }
}

Trie字典樹的時間複雜度 與 缺點

插入的時間複雜度:O(N),N為所有待插入字符串的長度之和
查詢的時間複雜度:O(K),K為待查詢字符串的長度

占內存:如果用二維數組實現,每個節點就會額外需要 26*8=208 個字節
優化思路:將每個節點中的數組換成其他數據結構,比如有序數組(可以二分查找)、跳錶、散列表、紅黑樹等。

Trie變體,縮點優化:對只有一個子節點的節點,而且此節點不是一個串的結束節點,可以將此節點與子節點合併

Trie字典樹的實際應用

1.搜索引擎輸入框關鍵詞提示

因為字典樹是查找 “與前綴匹配的字符串”,又稱為前綴樹。
關鍵詞提示就是 查尋找前綴匹配的前綴合適關鍵詞,當然還有更複雜的關鍵詞排名問題,這裏不再展開。

2.自動補全功能,如:IDE編譯器自動補全,輸入法自動補全等

原理與搜索引擎類似。

3.敏感詞過濾系統

4.其它

Trie在面試與算法競賽中的例題

1.hihoCoder1014

hihoCoder1014

解題思路:Trie字典樹

首先我們把集合中的N個字符串都插入到trie中。
對於每一個查詢s我們在trie中查找s,如果查找過程中無路可走,那麼一定沒有以s為前綴的字符串。
如果最後停在一個節點p,那我們就要看看以p為根的子樹里一共有多少終結點。
終結點的數目就是答案。

但是如果我們每次都遍歷以P為根的子樹,那時間複雜度就太高了。解決的辦法是用空間換時間,我們增加一個數組intcnt[MAX_NODE]
cnt[i]記錄的是以i號節點為根的子樹中,有幾個終結點。
然後我們每次insert一個字符串的時候,順便就把沿途的節點的cnt值都+1。
這樣就不用每次遍歷以P為根的子樹,而是直接輸出cnt[P]即可。

代碼:

2.hihoCoder1107微軟面試題

hihoCoder1014

其實就是找一個節點p,滿足以p為根的子樹中的終結點不多於5個,同時以p的父節點為根的子樹中的終結點大於5個。
和上題一樣用cnt數組標記,之後dfs查找終結點的數目

3.Trie應用在整數xor異或值最大的題目

給定一個包含N個整數的集合S={A1, A2, A3, … AN}。然
後有M個詢問,每次詢問給定一個整數X,讓你找一個Ai使得Ai xor X的值最大。

首先我們知道一個整數可以用二進製表示成一個01串。比如3=(011)2, 5=(101)2, 4=(100)2……。
我們假設輸入的整數都在0~2^32-1之間,於是我們可以用一個長度是32位的01串表示一個整數。
然後對於給定的N個整數A1, A2, A3, … AN,我們把它們對應的01串都插入到一個trie中。注意這裏字符集只有0和1,所以整個trie是一棵二叉樹。

下面我們舉一個例子,為了描述方便,我們假設整數都在0~7之間,也就是可以用3位01串表示。
現在假設S={1, 2, 7},也就是說我們要在Trie中插入{001, 010, 111}:

這時假設我們要查詢x=4,也就是哪個數和4異或結果最大?4=(100)2,
我們的做法是在trie樹中,盡量與4的二進制位反着走。
比如4的第一位(最高位)是1,我們從0出發第一步就盡量沿着0走。因為我們要異或和最大,01相反才能異或值是1。
並且這一步是可以貪心的,也就是說如果有相反的邊,那麼我們一定沿着這條邊走。因為最高位異或得1的話,即便後面都是0, 10000…000也要比最高位是0,後面都是1的011111…111大。
所以我們第一步沿着標識是0的邊,移動到了1號節點;4第二位是0,所以我們沿着標識是1的邊移動到4號節點;
4的第三位是0,但是4號節點沒有標識是1的邊,所以我們也只好沿着標識是0的邊移動到5號節點。
已經到了終結點,所以5號節點對應的A2=(010)2=2就是我們要求的答案,A2 xor 4 = 6是最大的。

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

ApplicationContextRunner如何簡化自動配置測試


1. 概覽

眾所周知,自動配置是Spring Boot的關鍵功能之一, 但測試自動配置可能會很棘手。

在以下部分中,我們將展示ApplicationContextRunner如何簡化自動配置測試。

2. 測試自動化配置方案

ApplicationContextRunner是一個實用程序類,它運行ApplicationContext並提供AssertJ樣式斷言。 最好用作測試類中的字段以便共享配置,然後我們在每個測試中進行自定義:

private final ApplicationContextRunner contextRunner = new ApplicationContextRunner();

讓我們通過測試一些案例來展示它的魔力。

2.1. 測試Class Condition

在本節中,我們將測試一些使用@ConditionalOnClass和@ConditionalOnMissingClass 註解的自動配置類:

@Configuration
@ConditionalOnClass(ConditionalOnClassIntegrationTest.class)
protected static class ConditionalOnClassConfiguration {
    @Bean
    public String created() { return "This is created when ConditionalOnClassIntegrationTest is present on the classpath"; } } @Configuration @ConditionalOnMissingClass("com.baeldung.autoconfiguration.ConditionalOnClassIntegrationTest") protected static class ConditionalOnMissingClassConfiguration { @Bean public String missed() { return "This is missed when ConditionalOnClassIntegrationTest is present on the classpath"; } } 

我們想測試自動配置是否正確實例化或跳過created和missing beans給定的預期條件。

  • ApplicationContextRunner為我們提供了withUserConfiguration方法,我們可以根據需要提供自動配置,以便為每個測試自定義ApplicationContext。

  • run 方法將 ContextConsumer 作為將斷言應用於上下文的參數。 測試退出時,ApplicationContext將自動關閉:

@Test
public void whenDependentClassIsPresent_thenBeanCreated() {     this.contextRunner.withUserConfiguration(ConditionalOnClassConfiguration.class)       .run(context -> {         assertThat(context).hasBean("created");         assertThat(context.getBean("created"))           .isEqualTo("This is created when ConditionalOnClassIntegrationTest is present on the classpath");       }); }   @Test public void whenDependentClassIsPresent_thenBeanMissing() {     this.contextRunner.withUserConfiguration(ConditionalOnMissingClassConfiguration.class)         .run(context -> {             assertThat(context).doesNotHaveBean("missed");         }); } 

通過前面的示例,我們發現測試classpath上存在某個類的場景的簡單性。但是,當類不在classpath上時,我們如何測試相反的情況呢

這就是FilteredClassLoader發揮作用的地方。它用於在運行時過濾classpath上指定的類:

@Test
public void whenDependentClassIsNotPresent_thenBeanMissing() {     this.contextRunner.withUserConfiguration(ConditionalOnClassConfiguration.class)         .withClassLoader(new FilteredClassLoader(ConditionalOnClassIntegrationTest.class))         .run((context) -> {             assertThat(context).doesNotHaveBean("created");             assertThat(context).doesNotHaveBean(ConditionalOnClassIntegrationTest.class);         }); }   @Test public void whenDependentClassIsNotPresent_thenBeanCreated() {     this.contextRunner.withUserConfiguration(ConditionalOnMissingClassConfiguration.class)       .withClassLoader(new FilteredClassLoader(ConditionalOnClassIntegrationTest.class))       .run((context) -> {         assertThat(context).hasBean("missed");         assertThat(context).getBean("missed")           .isEqualTo("This is missed when ConditionalOnClassIntegrationTest is present on the classpath");         assertThat(context).doesNotHaveBean(ConditionalOnClassIntegrationTest.class);       }); } 

2.2. 測試 Bean Condition

我們剛剛測試了 @ConditionalOnClass 和 @ConditionalOnMissingClass 註解, 現在 讓我們看看使用@ConditionalOnBean和@ConditionalOnMissingBean註釋時的情況。

首先, 我們同樣需要 一些自動配置的類:

@Configuration
protected static class BasicConfiguration {
    @Bean
    public String created() {         return "This is always created";     } } @Configuration @ConditionalOnBean(name = "created") protected static class ConditionalOnBeanConfiguration {     @Bean     public String createOnBean() {         return "This is created when bean (name=created) is present";     } } @Configuration @ConditionalOnMissingBean(name = "created") protected static class ConditionalOnMissingBeanConfiguration {     @Bean     public String createOnMissingBean() {         return "This is created when bean (name=created) is missing";     } } 

然後,我們將像上一節一樣調用withUserConfiguration方法,然後發送我們的自定義配置類來測試自動配置是否在不同的條件下恰當地實例化bean或跳過createOnBean或createOnMissingBean :

@Test
public void whenDependentBeanIsPresent_thenConditionalBeanCreated() {     this.contextRunner.withUserConfiguration(BasicConfiguration.class,       ConditionalOnBeanConfiguration.class)     // ommitted for brevity } @Test public void whenDependentBeanIsNotPresent_thenConditionalMissingBeanCreated() {     this.contextRunner.withUserConfiguration(ConditionalOnMissingBeanConfiguration.class)     // ommitted for brevity } 

2.3. 測試 Property Condition

在本節中,我們測試使用 @ConditionalOnPropertyannotations的自動配置類。

首先,我們需要這個測試的屬性:

com.baeldung.service=custom

然後,我們編寫嵌套的自動配置類,根據前面的屬性創建bean:

@Configuration
@TestPropertySource("classpath:ConditionalOnPropertyTest.properties") protected static class SimpleServiceConfiguration {     @Bean     @ConditionalOnProperty(name = "com.baeldung.service", havingValue = "default")     @ConditionalOnMissingBean     public DefaultService defaultService() {         return new DefaultService();     }     @Bean @ConditionalOnProperty(name = "com.baeldung.service", havingValue = "custom") @ConditionalOnMissingBean public CustomService customService() { return new CustomService(); } } 

現在,我們調用withPropertyValues方法來覆蓋每個測試中的屬性值:

@Test
public void whenGivenCustomPropertyValue_thenCustomServiceCreated() { this.contextRunner.withPropertyValues("com.baeldung.service=custom") .withUserConfiguration(SimpleServiceConfiguration.class) .run(context -> { assertThat(context).hasBean("customService"); SimpleService simpleService = context.getBean(CustomService.class); assertThat(simpleService.serve()).isEqualTo("Custom Service"); assertThat(context).doesNotHaveBean("defaultService"); }); } @Test public void whenGivenDefaultPropertyValue_thenDefaultServiceCreated() { this.contextRunner.withPropertyValues("com.baeldung.service=default") .withUserConfiguration(SimpleServiceConfiguration.class) .run(context -> { assertThat(context).hasBean("defaultService"); SimpleService simpleService = context.getBean(DefaultService.class); assertThat(simpleService.serve()).isEqualTo("Default Service"); assertThat(context).doesNotHaveBean("customService"); }); } 

3. 結論

總結一下, 這篇教程主要展示 如何使用ApplicationContextRunner運行帶有自定義的ApplicationContext並應用斷言.

我們在這裏介紹了最常用的場景,而不是列出如何自定義ApplicationContext 。

在此期間,請記住ApplicationConetxtRunner適用於非Web應用程序,因此請考慮WebApplicationContextRunner用於基於servlet的Web應用程序,ReactiveWebApplicationContextRunner用於響應式Web應用程序。

本文源代碼,請訪問GitHub。

原文:www.baeldung.com/spring-boot…

作者:baeldung

譯者:Leesen


【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

Spring 中的Null-Safety

之前一直在某些代碼中看到過使用@Nullable 標註過的註釋,當時也沒有在意到底是什麼意思,所以這篇文章來談談Spring中關於Null的那些事。

在Java中不允許讓你使用類型表示其null的安全性,但Spring Framework 現在在org.sprinngframework.lang包提供以下註釋,以便聲明API和字段的可空性:

  • @Nullable: 用於指定參數、返回值或者字段可以作為null的註釋。
  • @NonNull: 與上述註釋相反,表明指定參數、返回值或者字段不允許為null。(不需要@NonNullApi和@NonNullFields適用的參數/返回值和字段)
  • @NonNullApi: 包級別的註釋聲明非null作為參數和返回值。
  • @NonNullFields:包級別的註釋聲明字段默認非空

Spring Framework 本身利用了上面這幾個註釋,但它們也可以運用在任何基於Spring的Java 項目中,以聲明空安全api 和 空安全字段。尚未支持泛型和數組元素的可空性,但應也即將發布在後來的版本。Spring Null-Safety出現在Spring5中,讓我們更方便的編寫空安全的代碼,這叫做null-safety,null-safety不是讓我們逃脫不安全的代碼,而是在編譯時產生警告。 此類警告可以在運行時防止災難性空指針異常(NPE)。

@NonNull

@NonNull註釋是null-safety的所有註釋中最重要的一個,我們可以使用此註釋在期望對象引用的任何地方聲明非空約束:字段、方法參數或者方法返回值。

先來看一個例子

public class Student {

    private String name;

    public String getName() {
        return name;
    }

    public void setName(String name) {
        if(name != null && name.isEmpty()){
            name = null;
        }
        this.name = name;
    }
}

上述代碼對name的校驗是有效的,但是存在一個缺陷,如果name被設置為null的話,那麼當我們使用name的時候,就會以NullPointerException來結尾。

使用@NonNull

Spring 的null-safety特性能夠允許idea或者eclipse報告這個潛在的威脅,例如,如果我們用IDEA對屬性加上@NonNull會出現如下的效果。

奇怪,並沒有什麼變化啊,沒看見有潛在的安全提示啊,那是因為你沒有在idea進行設置

設置安全檢查

如果你也沒有提示的話,可以通過如下的方式設置安全檢查

如果還不好使的話,那就在右側 configuration annotations 添加一下 @NonNull和 @Nullable 所在的jar包,如下:

添加上,打上 ✅ 即可看到如下效果。

現在fullName 已經被@NonNull 註釋添加編譯器檢查null值的功能了!

如果你不相信的話,可以把@NonNull 註釋去掉,你的鼠標再放在fullName 上,已經沒有這句提示了。

@NonNullFields

@NonNull 註解能夠幫助你確保null-safety。然而,如果此註釋直接裝飾所有的字段的話,就會污染整個代碼庫。

Spring提供了另外一個不允許為null的註解 — @NonNullFields。這個註解適合用在包級別上,通知我們的開發工具註釋包中所有的字段,默認的,不允許為null

新建一個Parent類,並在該類所屬包下創建一個名為package-info.java的類,創建的不是Java類,而是創建的file,名為package-info.java,如下

package-info.java

@NonNullFields
package com.nullsafety.demo.pojo;

import org.springframework.lang.NonNullFields;

新建一個Parent.java 類

public class Parent {

    private String son;
    private String age;
    private String name;

    public void setSon(String son) {
        if(son != null && son.isEmpty()){
            son = null;
        }
        this.son = son;
    }

    public void setAge(String age) {
        if(age != null && age.isEmpty()){
            age = null;
        }
        this.age = age;
    }

    public void setName(String name) {
        if(name != null && name.isEmpty()){
            name = null;
        }
        this.name = name;
    }
}

package-info.java 中的@NonNullFields能夠對Parent類中所有的屬性起作用,把鼠標放在任意一個屬性上,會出現編譯期檢查的提示

@Nullable

@NonNullFields註釋通常比@NonNull更好,因為它有助於減少樣板。 但是,有時我們想要從包級別指定的非null約束中免除某些字段,這時候就會使用到@Nullable註解

改造一下Person.java,Person.java 與pack-info.java 處於同一包下

public class Person {

    @NonNull
    private String fullName;

    @Nullable
    private String nickName;

    public String getNickName() {
        return nickName;
    }

    public void setNickName(String nickName) {
        if(nickName != null && nickName.isEmpty()){
            nickName = null;
        }
        this.nickName = nickName;
    }

    public String getFullName() {
        return fullName;
    }

    public void setFullName(String fullName) {
        if(fullName != null && fullName.isEmpty()){
            fullName = null;
        }
        this.fullName = fullName;
    }
}

在這種情況下,我們使用@Nullable註釋來覆蓋字段上@NonNullFields的語義。

@NonNullApi

@NonNullFields註釋僅適用於其名稱所示的字段。 如果我們想對方法的參數和返回值產生相同的影響,我們需要@NonNullApi。

添加 @NonNullApi和 @NonNullFields 在 configure annotations 中,並選用NonNullApi

與@NonNullFields一樣,我們需要在package-info.java 中定義@NonNullApi

package-info.java

@NonNullApi
@NonNullFields
package com.nullsafety.demo.pojo;

import org.springframework.lang.NonNullApi;
import org.springframework.lang.NonNullFields;

加上如下註釋后的效果如下: 可以在返回值的時候接受到編譯期的提示。

後記:

看完文章,你至少應該了解

  • 四個註解 @NonNull, @Nullable, @NonNullFields, @NonNullApi 四個註解各自的作用範圍
  • 如何設置編譯期的Null-safety檢查

歡迎關注

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

為什麼阿里巴巴要求謹慎使用ArrayList中的subList方法

GitHub 3.7k Star 的Java工程師成神之路 ,不來了解一下嗎?

GitHub 3.7k Star 的Java工程師成神之路 ,真的不來了解一下嗎?

GitHub 3.7k Star 的Java工程師成神之路 ,真的確定不來了解一下嗎?

集合是Java開發日常開發中經常會使用到的。在之前的一些文章中,我們介紹過一些關於使用集合類應該注意的事項,如《為什麼阿里巴巴禁止在 foreach 循環里進行元素的 remove/add 操作》、《為什麼阿里巴巴建議集合初始化時,指定集合容量大小》等。

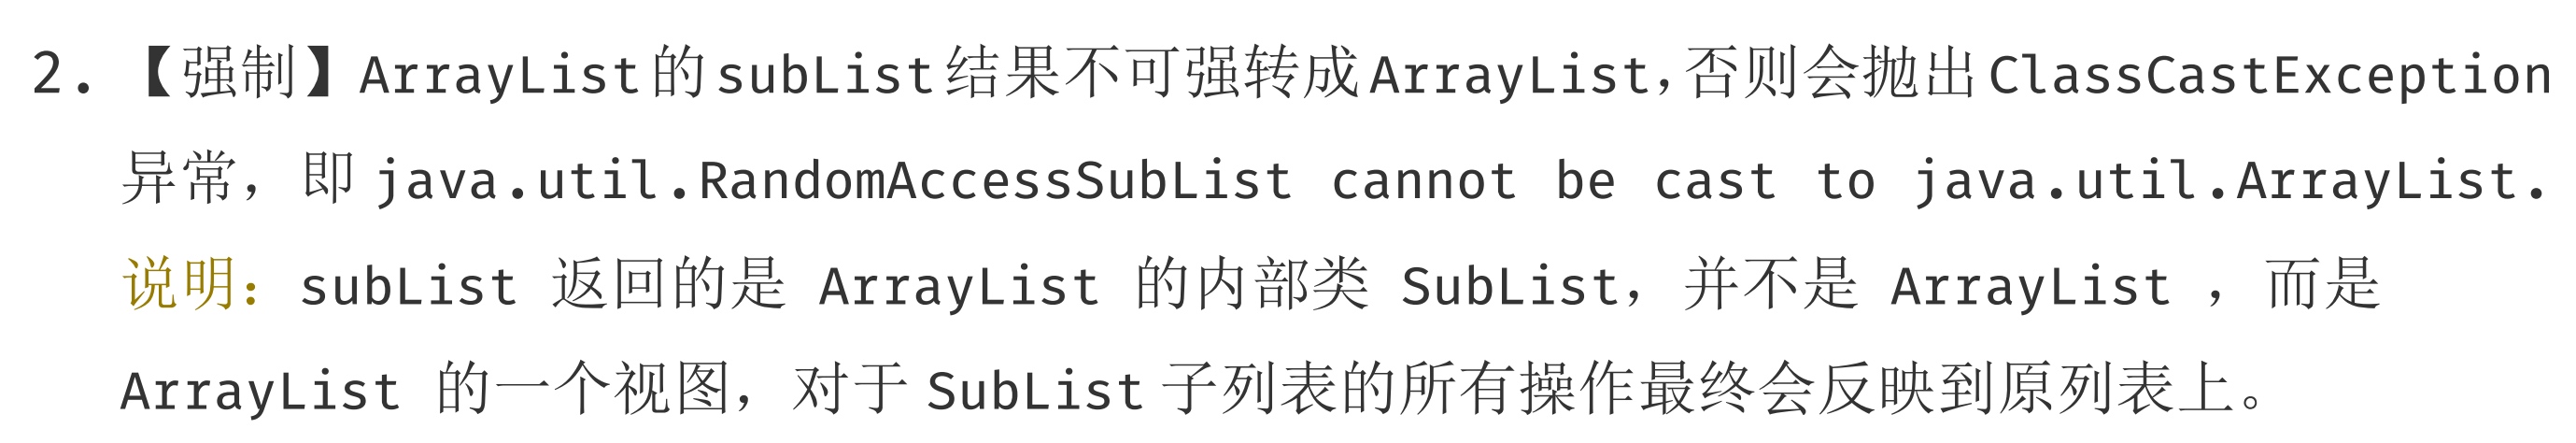
關於集合類,《阿里巴巴Java開發手冊》中其實還有另外一個規定:


本文就來分析一下為什麼會有如此建議?其背後的原理是什麼?

subList

subList是List接口中定義的一個方法,該方法主要用於返回一個集合中的一段、可以理解為截取一個集合中的部分元素,他的返回值也是一個List。

如以下代碼:

public static void main(String[] args) {
    List<String> names = new ArrayList<String>() {{
        add("Hollis");
        add("hollischuang");
        add("H");
    }};

    List subList = names.subList(0, 1);
    System.out.println(subList);
}

以上代碼輸出結果為:

[Hollis]

如果我們改動下代碼,將subList的返回值強轉成ArrayList試一下:

public static void main(String[] args) {
    List<String> names = new ArrayList<String>() {{
        add("Hollis");
        add("hollischuang");
        add("H");
    }};

    ArrayList subList = names.subList(0, 1);
    System.out.println(subList);
}

以上代碼將拋出異常:

java.lang.ClassCastException: java.util.ArrayList$SubList cannot be cast to java.util.ArrayList

不只是強轉成ArrayList會報錯,強轉成LinkedList、Vector等List的實現類同樣也都會報錯。

那麼,為什麼會發生這樣的報錯呢?我們接下來深入分析一下。

底層原理

首先,我們看下subList方法給我們返回的List到底是個什麼東西,這一點在JDK源碼中註釋是這樣說的:

Returns a view of the portion of this list between the specifiedfromIndex, inclusive, and toIndex, exclusive.

也就是說subList 返回是一個視圖,那麼什麼叫做視圖呢?

我們看下subList的源碼:

public List<E> subList(int fromIndex, int toIndex) {
    subListRangeCheck(fromIndex, toIndex, size);
    return new SubList(this, 0, fromIndex, toIndex);
}

這個方法返回了一個SubList,這個類是ArrayList中的一個內部類。

SubList這個類中單獨定義了set、get、size、add、remove等方法。

當我們調用subList方法的時候,會通過調用SubList的構造函數創建一個SubList,那麼看下這個構造函數做了哪些事情:

SubList(AbstractList<E> parent,
            int offset, int fromIndex, int toIndex) {
    this.parent = parent;
    this.parentOffset = fromIndex;
    this.offset = offset + fromIndex;
    this.size = toIndex - fromIndex;
    this.modCount = ArrayList.this.modCount;
}

可以看到,這個構造函數中把原來的List以及該List中的部分屬性直接賦值給自己的一些屬性了。

也就是說,SubList並沒有重新創建一個List,而是直接引用了原有的List(返回了父類的視圖),只是指定了一下他要使用的元素的範圍而已(從fromIndex(包含),到toIndex(不包含))。

所以,為什麼不能講subList方法得到的集合直接轉換成ArrayList呢?因為SubList只是ArrayList的內部類,他們之間並沒有集成關係,故無法直接進行強制類型轉換。

視圖有什麼問題

前面通過查看源碼,我們知道,subList()方法並沒有重新創建一個ArrayList,而是返回了一個ArrayList的內部類——SubList。

這個SubList是ArrayList的一個視圖。

那麼,這個視圖又會帶來什麼問題呢?我們需要簡單寫幾段代碼看一下。

1、非結構性改變SubList

public static void main(String[] args) {
    List<String> sourceList = new ArrayList<String>() {{
        add("H");
        add("O");
        add("L");
        add("L");
        add("I");
        add("S");
    }};

    List subList = sourceList.subList(2, 5);

    System.out.println("sourceList : " + sourceList);
    System.out.println("sourceList.subList(2, 5) 得到List :");
    System.out.println("subList : " + subList);

    subList.set(1, "666");

    System.out.println("subList.set(3,666) 得到List :");
    System.out.println("subList : " + subList);
    System.out.println("sourceList : " + sourceList);

}

得到結果:

sourceList : [H, O, L, L, I, S]
sourceList.subList(2, 5) 得到List :
subList : [L, L, I]
subList.set(3,666) 得到List :
subList : [L, 666, I]
sourceList : [H, O, L, 666, I, S]

當我們嘗試通過set方法,改變subList中某個元素的值得時候,我們發現,原來的那個List中對應元素的值也發生了改變。

同理,如果我們使用同樣的方法,對sourceList中的某個元素進行修改,那麼subList中對應的值也會發生改變。讀者可以自行嘗試一下。

1、結構性改變SubList

public static void main(String[] args) {
    List<String> sourceList = new ArrayList<String>() {{
        add("H");
        add("O");
        add("L");
        add("L");
        add("I");
        add("S");
    }};

    List subList = sourceList.subList(2, 5);

    System.out.println("sourceList : " + sourceList);
    System.out.println("sourceList.subList(2, 5) 得到List :");
    System.out.println("subList : " + subList);

    subList.add("666");

    System.out.println("subList.add(666) 得到List :");
    System.out.println("subList : " + subList);
    System.out.println("sourceList : " + sourceList);

}

得到結果:

sourceList : [H, O, L, L, I, S]
sourceList.subList(2, 5) 得到List :
subList : [L, L, I]
subList.add(666) 得到List :
subList : [L, L, I, 666]
sourceList : [H, O, L, L, I, 666, S]

我們嘗試對subList的結構進行改變,即向其追加元素,那麼得到的結果是sourceList的結構也同樣發生了改變。

1、結構性改變原List

public static void main(String[] args) {
    List<String> sourceList = new ArrayList<String>() {{
        add("H");
        add("O");
        add("L");
        add("L");
        add("I");
        add("S");
    }};

    List subList = sourceList.subList(2, 5);

    System.out.println("sourceList : " + sourceList);
    System.out.println("sourceList.subList(2, 5) 得到List :");
    System.out.println("subList : " + subList);

    sourceList.add("666");

    System.out.println("sourceList.add(666) 得到List :");
    System.out.println("sourceList : " + sourceList);
    System.out.println("subList : " + subList);

}

得到結果:

Exception in thread "main" java.util.ConcurrentModificationException
    at java.util.ArrayList$SubList.checkForComodification(ArrayList.java:1239)
    at java.util.ArrayList$SubList.listIterator(ArrayList.java:1099)
    at java.util.AbstractList.listIterator(AbstractList.java:299)
    at java.util.ArrayList$SubList.iterator(ArrayList.java:1095)
    at java.util.AbstractCollection.toString(AbstractCollection.java:454)
    at java.lang.String.valueOf(String.java:2994)
    at java.lang.StringBuilder.append(StringBuilder.java:131)
    at com.hollis.SubListTest.main(SubListTest.java:28)

我們嘗試對sourceList的結構進行改變,即向其追加元素,結果發現拋出了ConcurrentModificationException。關於這個異常,我們在《一不小心就踩坑的fail-fast是個什麼鬼?》中分析過,這裏原理相同,就不再贅述了。

小結

我們簡單總結一下,List的subList方法並沒有創建一個新的List,而是使用了原List的視圖,這個視圖使用內部類SubList表示。

所以,我們不能把subList方法返回的List強制轉換成ArrayList等類,因為他們之間沒有繼承關係。

另外,視圖和原List的修改還需要注意幾點,尤其是他們之間的相互影響:

1、對父(sourceList)子(subList)List做的非結構性修改(non-structural changes),都會影響到彼此。

2、對子List做結構性修改,操作同樣會反映到父List上。

3、對父List做結構性修改,會拋出異常ConcurrentModificationException。

所以,阿里巴巴Java開發手冊中有另外一條規定:


如何創建新的List

如果需要對subList作出修改,又不想動原list。那麼可以創建subList的一個拷貝:

subList = Lists.newArrayList(subList);
list.stream().skip(strart).limit(end).collect(Collectors.toList());

PS:最近,《阿里巴巴Java開發手冊》已經正式更名為《Java開發手冊》,併發布了新版本,增加了21條新規約,修改描述112處。

關注公眾號後台回復:手冊,即可獲取最新版Java開發手冊。

參考資料: https://www.jianshu.com/p/5854851240df https://www.cnblogs.com/ljdblog/p/6251387.html

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

【機器學習】算法原理詳細推導與實現(二):邏輯回歸

【機器學習】算法原理詳細推導與實現(二):邏輯回歸

在上一篇算法中,線性回歸實際上是 連續型 的結果,即 \(y\in R\) ,而邏輯回歸的 \(y\) 是離散型,只能取兩個值 \(y\in \{0,1\}\),這可以用來處理一些分類的問題。

logistic函數

我們可能會遇到一些分類問題,例如想要劃分 鳶尾花 的種類,嘗試基於一些特徵來判斷鳶尾花的品種,或者判斷上一篇文章中的房子,在6個月之後能否被賣掉,答案是 是 或者 否,或者一封郵件是否是垃圾郵件。所以這裡是 \(x\) ,這裡是 \(y\) 在一個分類問題中,\(y\) 只能取兩個值0和1,這就是一個二元分類的問題,如下所示:

可以使用線性回歸對以上數值進行劃分,可以擬合出如下那麼一條線,用 \(y=0.5\) 作為臨界點,如果 \(x\) 在這個臨界點的右側,那麼 \(y\) 的值就是1,如果在臨界點的左側,那麼 \(y\) 的值就是0,所以確實會有一些人會這麼做,用線性回歸解決分類問題:

線性回歸解決分類問題,有時候它的效果很好,但是通常用線性回歸解決像這樣的分類問題會是一個很糟糕的主意,加入存在一個額外的訓練樣本 \(x=12\),如果現在對這個訓練集合做線性擬合,那麼可能擬合出來那麼一條直線:

這時候\(y\)的臨界點估計已經不太合適了,可以知道線性回歸對於分類問題來說,不是一個很好的方法。

假設 \(h_\theta(x) \in [0,1]\),當如果已知 \(y\in \{0,1\}\),那麼至少應該讓假設 \(h_\theta(x)\) 預測出來的值不會比1大太多,也不會比0小太多,所以一般不會選擇線性函數作為假設,而是會選擇一些稍微不同的函數圖像:

\[ g(z)=\frac{1}{1+e^{-z}} \]

\[ h_\theta(x)=g(\theta^Tx)=\frac{1}{1+e^{-\theta^Tx}} \]

\(g(z)\) 被稱為 sigmoid函數 ,也通常被稱為 logistic函數,它的函數圖像是:

當 \(z\) 變得非常小的時候,\(g(x)\) 會趨向於0,當\(z\)變得非常大的時候,\(g(x)\) 會趨向於1,它和縱軸相較於0.5。

邏輯回歸

那麼我們的假設\(h_\theta(x)\) 要嘗試估計 \(y\in \{0,1\}\) 的概率,即:

\[ P(y=1|x;\theta)=h_\theta(x) \]

\[ P(y=0|x;\theta)=1-h_\theta(x) \]

以上可以把兩個公式合併簡寫為(如果\(y=1\)那麼公式為\(h_\theta(x)\);如果\(y=0\)那麼公式為\(1-h_\theta(x)\)):

\[ P(y|x;\theta)=(h_\theta(x))^y(1-h_\theta(x))^{1-y} \]

如果對《概率論和數理統計》學得好的人不難看出,以上函數其實就是 伯努利分佈 的函數。

對於每一個假設值\(h_\theta(x)\),為了使每一次假設值更準確,即當 \(y=1\) 時估計函數 \(P(y=1|x;\theta)=h_\theta(x)\) 趨向於1,當\(y=0\) 時估計函數 \(P(y=0|x;\theta)=1-h_\theta(x)\) 趨向於0。則對於每一個\((x_i,y_i)\),參數 \(\theta\) 的似然估計 \(L(\theta)\)為:

\[ \begin{split} L(\theta)&=P(\vec{y}|X;\theta) \\ &=\prod_{i=1}^mP(y^{(i)}|x^{(i)};\theta) \\ &=\prod_{i=1}^m(h_\theta(x^{(i)}))^{y^{(i)}}(1-h_\theta(x^{(i)}))^{1-{y^{(i)}}} \end{split} \]

如果每一個\((x_i,y_i)\)都準確,即 \(P(y|x;\theta)\) 趨向於1,則應該使似然估計 \(L(\theta)\) 最大化,也就是轉化成熟悉的問題:求解 \(L(\theta)\) 的極大似然估計。

為了調整參數 \(\theta\) 使似然估計 \(L(\theta)\) 最大化,推導如下(取 \(log\) 是為了去掉疊乘方便計算):

\[ \begin{split} l(\theta)&=logL(\theta) \\ &=\sum_{i=1}^m{y^{(i)}logh(x^{(i)})+(1-y^{(i)})log(1-h(x^{(i)}))} \end{split} \]

為了使這個函數最大,同樣可以使用前面學習過的梯度下降算法使對數似然估計最大化。之前學習的是要使誤差和 最小化,所以梯度下降的公式為:

\[ \theta:=\theta-\alpha\frac{\partial J(\theta)}{\partial\theta}=>\theta:=\theta-\alpha\nabla_\theta J(\theta) \]

而本次為了求解似然估計最大化,使用的是梯度上升:

\[ \theta:=\theta+\alpha\nabla_\theta l(\theta)=>\theta:=\theta+\alpha\frac{\partial l(\theta)}{\partial\theta} \]

對數似然性是和 \(\theta\) 有關,同樣的為了計算 梯度上升 最快的方向,要對上述公式求偏導得到極值,即是上升最快的方向:

\[ \begin{split} \frac{\partial l(\theta)}{\partial\theta_j}&=(y\frac{1}{g(\theta^Tx)}-(1-y)\frac{1}{1-g(\theta^Tx)})\frac{\partial}{\partial\theta_j}g(\theta^Tx) \\ &=(y\frac{1}{g(\theta^Tx)}-(1-y)\frac{1}{1-g(\theta^Tx)})g(\theta^Tx)(1-g(\theta^Tx))\frac{\partial}{\partial\theta_j}\theta^Tx \\ &=(y(1-g(\theta^Tx))-(1-y)g(\theta^Tx))x_j \\ &=(y-g(\theta^Tx))x_j \\ &=(y-h_{\theta}(x))x_j \end{split} \]

則對於 m 個樣本,則有:

\[ \frac{\partial l(\theta)}{\partial\theta_j}=\sum_{i=1}^m{(y-h_{\theta}(x))x_j} \]

\[ \theta_j:=\theta_j+\sum_{i=1}^m{(y^{(i)}-h_{\theta}(x^{(i)}))x^{(i)}_j} \]

所以總結來說:

邏輯回歸假設數據服從伯努利分佈,通過極大化似然函數的方法,運用梯度下降來求解參數,來達到將數據二分類的目的。

鳶尾花分類

為了劃分 鳶尾花 的種類,嘗試基於一些特徵來判斷鳶尾花的品種,選取100條鳶尾花數據集如下所示:

花萼長度(單位cm) 花萼寬度(單位cm) 種類
5.1 3.5 0
4.9 3.0 0
4.7 3.2 0
7.0 3.2 1
6.4 3.2 1
… … …

其中:

種類 含義
0 山鳶尾(setosa)
1 變色鳶尾(versicolor)
2 維吉尼亞鳶尾(virginica)

數據集的圖像分佈為:

計算損失函數:

# 損失函數
def computeCost(theta, X, y):
    theta = np.matrix(theta)
    X = np.matrix(X)
    y = np.matrix(y)
    first = np.multiply(-y, np.log(sigmoid(X * theta.T)))
    second = np.multiply((1 - y), np.log(1 - sigmoid(X * theta.T)))
    return np.sum(first - second) / (len(X))

梯度下降函數為:

# 梯度下降
def gradient(theta, X, y):
    theta = np.matrix(theta)
    X = np.matrix(X)
    y = np.matrix(y)

    parameters = int(theta.ravel().shape[1])
    grad = np.zeros(parameters)

    error = sigmoid(X * theta.T) - y

    for i in range(parameters):
        term = np.multiply(error, X[:, i])
        grad[i] = np.sum(term) / len(X)

    return grad

最終預測準確率為:

accuracy = 99%

結果分類的圖像為:

數據和代碼下載請關注公眾號【 TTyb 】,後台回復【 機器學習 】即可獲取:

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益