Java 反射簡介

本文部分內容參考博客。點擊鏈接可以查看原文。

1. 反射的概念

反射是指在運行時將類的屬性、構造函數和方法等元素動態地映射成一個個對象。通過這些對象我們可以動態地生成對象實例,調用類的方法和更改類的屬性值。

2. 使用場景

什麼情況下運用JAVA反射呢?如果編譯時根本無法預知對象和類可能屬於哪些類,程序只依靠運行時信息來發現該對象和類的真實信息,此時就必須使用反射。

使用反射可以實現下面的功能:

  • 在運行時判斷任意一個對象所屬的類
  • 在運行時構造任意一個類的對象
  • 在運行時判斷任意一個類所具有的方法和屬性
  • 在運行時調用任意一個對象的方法
  • 生成動態代理

3. 獲得Class對象的幾種方式

前面已經介紹過了,每個類被加載之後,系統就會為該類生成一個對應的Class對象,通過該Class對象就可以訪問到JVM中的這個類。在Java程序中獲得Class對象通常有如下3種方式。

  • 使用Class類的forName(String clazzName)靜態方法。該方法需要傳入字符串參數,該字符串參數的值是某個類的全限定類名(必須添加完整包名)。
  • 調用某個類的class屬性來獲取該類對應的Class對象。例如,Person.class將會返回Person類對應的Class對象。
  • 調用某個對象的getClass()方法。該方法是java.lang.Object類中的一個方法,所以所有的Java對象都可以調用該方法,該方法將會返回該對象所屬類對應的Class對象。

對於第一種方式和第二種方式都是直接根據類來取得該類的Class對象,相比之下,第二種方式有如下兩種優勢。

  • 代碼更安全。程序在編譯階段就可以檢查需要訪問的Class對象是否存在。
  • 程序性能更好。因為這種方式無須調用方法,所以性能更好。

也就是說,大部分時候我們都應該使用第二種方式來獲取指定類的Class對象。但如果我們只有一個字符串,例如“java.lang.String”,若需要獲取該字符串對應的Class對象,則只能使用第一種方式,使用Class的forName(String clazzName)方法獲取Class對象時,該方法可能拋出一個ClassNotFoundException異常。一旦獲得了某個類所對應的Class對象之後,程序就可以調用Class對象的方法來獲得該對象和該類的真實信息了。

4. Class類 API介紹

通過class類我們能夠獲取大量的信息:

  1. 獲取構造函數
  • Connstructor getConstructor(Class<?>… parameterTypes):返回此Class對象對應類的指定public構造器。
  • Constructor<?>[] getConstructors():返回此Class對象對應類的所有public構造器。
  • Constructor getDeclaredConstructor(Class<?>… parameterTypes):返回此Class對象對應類的指定構造器,與構造器的訪問權限無關。
  • Constructor<?>[] getDeclaredConstructors():返回此Class對象對應類的所有構造器,與構造器的訪問權限無關。
  1. 獲取方法
  • Method getDeclaredMethod(String name, Class<?>… parameterTypes):返回此Class對象對應類的指定方法,與方法的訪問權限無關。
  • Method[] getDeclaredMethods():返回此Class對象對應類的全部方法,與方法的訪問權限無關。
  1. 獲取屬性
  • Field getField(String name):返回此Class對象對應類的指定public Field。
  • Field[] getFields():返回此Class對象對應類的所有public Field。
  • Field getDeclaredField(String name):返回此Class對象對應類的指定Field,與Field的訪問權限無關。
  • Field[] getDeclaredFields():返回此Class對象對應類的全部Field,與Field的訪問權限無關。
  1. 獲取Class對應類上所包含的Annotation。
  • A getAnnotation(Class annotationClass):試圖獲取該Class對象對應類上指定類型的Annotation;如果該類型的註釋不存在,則返回null。
  • Annotation[] getAnnotations():返回該Class對象對應類上的所有Annotation。
  • Annotation[] getDeclaredAnnotations():返回直接修飾該Class對應類的所有Annotation。
  1. 獲取Class對象對應類包含的內部類。
  • Class<?>[] getDeclaredClasses():返回該Class對象對應類里包含的全部內部類。
    如下方法用於訪問該Class對象對應類所在的外部類。
  • Class<?> getDeclaringClass():返回該Class對象對應類所在的外部類。
    如下方法用於訪問該Class對象對應類所繼承的父類、所實現的接口等。
  • Class<?>[] getInterfaces():返回該Class對象對應類所實現的全部接口。
  1. 獲取Class對象對應類所繼承的父類
  • Class<? super T> getSuperclass():返回該Class對象對應類的超類的Class對象。
  1. 獲取Class對象對應類的修飾符、所在包、類名等基本信息。
  • int getModifiers():返回此類或接口的所有修飾符。修飾符由public、protected、private、final、static、abstract等對應的常量組成,返回的整數應使用Modifier工具類的方法來解碼,才可以獲取真實的修飾符。
  • Package getPackage():獲取此類的包。
  • String getName():以字符串形式返回此Class對象所表示的類的名稱。
  • String getSimpleName():以字符串形式返回此Class對象所表示的類的簡稱。
  1. 判斷該類是否為接口、枚舉、註釋類型等
  • boolean isAnnotation():返回此Class對象是否表示一個註釋類型(由@interface定義)。
  • boolean isAnnotationPresent(Class<? extends Annotation> annotationClass):判斷此Class對象是否使用了Annotation註釋修飾。
  • boolean isAnonymousClass():返回此Class對象是否是一個匿名類。
  • boolean isArray():返回此Class對象是否表示一個數組類。
  • boolean isEnum():返回此Class對象是否表示一個枚舉(由enum關鍵字定義)。
  • boolean isInterface():返回此Class對象是否表示一個接口(使用interface定義)。
  • boolean isInstance(Object obj):判斷obj是否是此Class對象的實例,該方法可以完全代替instanceof操作符。

上面的多個getMethod()方法和getConstructor()方法中,都需要傳入多個類型為Class<?>的參數,用於獲取指定的方法或指定的構造器。關於這個參數的作用,假設某個類內包含如下3個info方法簽名:

  • public void info()
  • public void info(String str)
  • public void info(String str , Integer num)

這3個同名方法屬於重載,它們的方法名相同,但參數列表不同。在Java語言中要確定一個方法光有方法名是不行的,例如,我們指定info方法——實際上可以是上面3個方法中的任意一個!如果需要確定一個方法,則應該由方法名和形參列表來確定,但形參名沒有任何實際意義,所以只能由形參類型來確定。例如,我們想要確定第二個info方法,則必須指定方法名為info,形參列表為String.class——因此在程序中獲取該方法使用如下代碼:

clazz.getMethod("info",String.class);

使用反射生成對象

  1. 利用構造函數生成對象
  • 使用Class對象的newInstance()方法來創建該Class對象對應類的實例,這種方式要求該Class對象的對應類有默認構造器,而執行newInstance()方法時實際上是利用默認構造器來創建該類的實例。
  • 先使用Class對象獲取指定的Constructor對象,再調用Constructor對象的newInstance()方法來創建該Class對象對應類的實例。通過這種方式可以選擇使用指定的構造器來創建實例。
Constructor c = clazz.getConstructor(String.class);
c.newInstance("xx");

調用方法

Method setProName = aClass.getDeclaredMethod("setProName",String.class);
setProName.setAccessible(true);
etProName.invoke(product,"我是一個產品");

操作屬性

Field[] declaredFields = aClass.getDeclaredFields();
        for (Field declaredField : declaredFields) {
            System.out.println("fieldName:"+declaredField.getName()+" filedType:"+declaredField.getType());
        }
        Field proName = aClass.getDeclaredField("proName");
        proName.setAccessible(true);
        proName.set(product,"我是一個產品");
        System.out.println("修稿屬性:"+product);

操作數組

//使用反射動態地創建數組
//創建一個元素類型為String,長度為3的數組
Object arr = Array.newInstance(String.class, 3);
//依次為arr數組中index為0,1,2的元素賦值
Array.set(arr, 0, "榮耀盒子");
Array.set(arr, 1, "榮耀8手機");
Array.set(arr, 2, "華為mate9保時捷版");
Object o1= Array.get(arr, 0);
Object o2= Array.get(arr, 1);
Object o3= Array.get(arr, 2);
System.out.println(o1);
System.out.println(o2);
System.out.println(o3);

5. 使用Demo

public class ReflectDemo {
    public static void main(String[] args) throws Exception {
        Class<Product> aClass = Product.class;
        Constructor<?>[] declaredConstructors = aClass.getDeclaredConstructors();
        for (Constructor<?> declaredConstructor : declaredConstructors) {
            System.out.println(declaredConstructor.getName());
        }
        Constructor<Product> constructor = aClass.getConstructor(int.class, String.class);
        Product product = constructor.newInstance(10, "ds");
        System.out.println("創建對象:"+product);

        //獲取方法並調用
        Method setProName = aClass.getDeclaredMethod("setProName", String.class);
        setProName.setAccessible(true);
        setProName.invoke(product,"我是一個產品");
        System.out.println("調用方法:"+product);

        //獲取屬性,並設置屬性的值
        Field[] declaredFields = aClass.getDeclaredFields();
        for (Field declaredField : declaredFields) {
            System.out.println("fieldName:"+declaredField.getName()+" filedType:"+declaredField.getType());
        }
        Field proName = aClass.getDeclaredField("proName");
        proName.setAccessible(true);
        proName.set(product,"我是一個產品");
        System.out.println("修稿屬性:"+product);

        //使用反射動態地創建數組
        //創建一個元素類型為String,長度為3的數組
        Object arr = Array.newInstance(String.class, 3);
        //依次為arr數組中index為0,1,2的元素賦值
        Array.set(arr, 0, "榮耀盒子");
        Array.set(arr, 1, "榮耀8手機");
        Array.set(arr, 2, "華為mate9保時捷版");
        Object o1= Array.get(arr, 0);
        Object o2= Array.get(arr, 1);
        Object o3= Array.get(arr, 2);
        System.out.println(o1);
        System.out.println(o2);
        System.out.println(o3);
        
        System.out.println("end...");
    }
}

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

※超省錢租車方案

法國黃背心運動滿週年 萬人上街抗議

摘錄自2019年11月19日公視報導

11月17號適逢法國黃背心運動一週年,去年不滿總統馬克宏調漲油價的民眾發起抗議行動,在各大城市遍地開花,並逐漸演變成反對馬克宏政府政策的社運。直到現在,仍有部分示威者,每星期六都會固定集會,提醒政府他們怒火難平。今年再度出現幾萬人走上街頭的盛大場面。有群眾和鎮暴警察發生衝突,還有人闖進巴黎的老佛爺百貨,讓業者被迫停業一天。

抗議民眾表示,「我很高興能夠在這向馬克宏宣告:我們就在這裡,我們還在這裡,黃背心運動不死。儘管他們多方試圖摧毀黃背心,但黃背心屹立不搖,我們都是為了法國。」

近幾個月來,黃背心運動趨於和緩,但週年紀念又讓情勢再度激化,數萬人走上街頭。部分抗議人士推翻路邊車輛,點燃垃圾桶等物,還向鎮暴警察扔擲石頭,而警方也以催淚瓦斯和水柱還擊和驅散人群。

根據法國內政部的說法,法國全國各地星期六一共逮捕了264人,其中巴黎就佔了六成以上。黃背心支持者表示,目前他們考慮加入其他工會行動,參與12月5號開始反對馬克宏年金改革的無限期大罷工。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

※超省錢租車方案

自已做動畫及編寫程序搞清楚最大堆的實現原理

目錄

  • 背景
  • 概念
  • 最大堆
    • 最大堆的線性存儲
    • 動畫實現最大堆加入新元素
    • 代碼實現最大堆加入新元素
    • 動畫實現最大堆取出最大元素
    • 代碼實現最大堆取出最大元素
    • 程序測試
  • 最大堆的應用–優先隊列
  • 寫在最後

背景

  • 二叉樹是數據結構中的重點,也是難點。二叉樹比數組、棧、隊列等線性結構相比複雜度更高,想要做到心中有“樹”,需要自己動手畫圖、觀察、思考,才能領會其真諦。
  • 在上篇文章《自己動手作圖深入理解二叉樹、滿二叉樹及完全二叉樹》中,我們對完全二叉樹有了一定認識,該文將對一種特殊的完全二叉樹”最大堆”進行底層研究。

概念

堆(heap)通常是一個可以被看做一棵二叉樹的數組對象。堆總是滿足下列性質:

  • 堆總是一棵完全二叉樹。
  • 堆中某個節點的值總是不大於或不小於其父節點的值;

最大堆

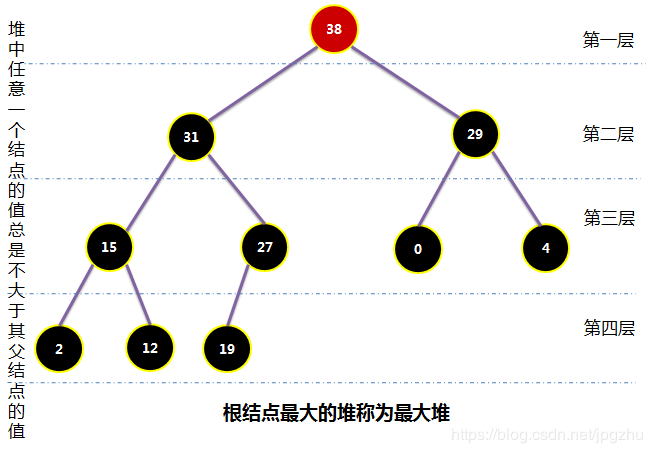
  • 根節點最大的堆叫做最大堆
最大堆的線性存儲
  • 由於堆是一種特殊的完全二叉樹,可以利用數組集合形成線性存儲的數據結構。
/**
 * 最大堆的底層實現--數組集合形成線性存儲的數據結構
 *  * @author zhuhuix
 * @date 2020-06-28
 */
public class MaxHeap<E extends Comparable<E>> {

    // 存放元素的數組集合
    private ArrayList<E> list;

    MaxHeap() {
        this.list = new ArrayList<>();
    }

    // 得到左孩子索引
    private int getLeftChildIndex(int i) {
        return (2 * i + 1);
    }

    // 得到右孩子索引
    private int getRightChildIndex(int i) {
        return (2 * i + 2);
    }

    // 得到父結點索引
    private int getParentIndex(int i) {
        if (i == 0) {
            throw new IllegalArgumentException("非法索引值");
        } else {
            return ((i - 1) / 2);
        }
    }
}
動畫實現最大堆加入新元素
  • 加入到數組集合尾部的元素與父結點進行比較,通過上浮操作,保證所有子結點不能大於父結點。
代碼實現最大堆加入新元素
/**
 * 最大堆的底層實現
 *
 * @author zhuhuix
 * @date 2020-06-28
 */
public class MaxHeap<E extends Comparable<E>> {

    // 存放元素的數組集合
    private ArrayList<E> list;

    MaxHeap() {
        this.list = new ArrayList<>();
    }

    // 得到左孩子索引
    private int getLeftChildIndex(int i) {
        return (2 * i + 1);
    }

    // 得到右孩子索引
    private int getRightChildIndex(int i) {
        return (2 * i + 2);
    }

    // 得到父結點索引
    private int getParentIndex(int i) {
        if (i == 0) {
            throw new IllegalArgumentException("非法索引值");
        } else {
            return ((i - 1) / 2);
        }
    }

    // 添加元素
    public void add(E e) {
        this.list.add(e);
        /**
         * 將加入的結點與父結點進行比較:
         * 如果加入的結點大於父結點,則進行上浮
         * 直至新結點小於或等於父結點為止
         */

        // 獲取當前添加元素在數組中的索引
        int i = this.list.size() - 1;
        while (i > 0) {
            E current = this.list.get(i);
            E parent = this.list.get(getParentIndex(i));
            // 如果父結點元素大於當前加入的元素,則進行交換
            if (parent.compareTo(current) < 0) {
                // 交換新加入的結點與父結點的位置
                Collections.swap(this.list, i, getParentIndex(i));
            } else {
                break;
            }
            i = getParentIndex(i);
        }
    }
    
}
動畫實現最大堆取出最大元素
  • 獲取最大堆中的根結點,即為最大元素;並把尾部結點放置到根結點,並通過下沉操作,把子結點中的最大元素移動根結點。
代碼實現最大堆取出最大元素
/**
 * 最大堆的底層實現
 *
 * @author zhuhuix
 * @date 2020-06-28
 */
public class MaxHeap<E extends Comparable<E>> {

    // 存放元素的數組集合
    private ArrayList<E> list;

    MaxHeap() {
        this.list = new ArrayList<>();
    }

    // 得到左孩子索引
    private int getLeftChildIndex(int i) {
        return (2 * i + 1);
    }

    // 得到右孩子索引
    private int getRightChildIndex(int i) {
        return (2 * i + 2);
    }

    // 得到父結點索引
    private int getParentIndex(int i) {
        if (i == 0) {
            throw new IllegalArgumentException("非法索引值");
        } else {
            return ((i - 1) / 2);
        }
    }

    // 查找最大元素
    public E findMax() {
        if (this.list.size() == 0) {
            return null;
        }
        // 最大堆中的元素永遠在根結點
        return this.list.get(0);
    }

    // 取出最大元素
    public E getMax() {
        if (findMax() != null) {
            E e = findMax();

            /**
             * 取出最大元素后,需要把堆中第二大的元素放置在根結點:
             * 將根結點元素與最後面的元素進行交換,
             * 讓最後面的元素出現在根結點,並移除最大元素
             * 將根結點的元素與左右孩子結點比較,直至根結點的元素變成最大值
             */
            int i = 0;
            Collections.swap(this.list, i, this.list.size() - 1);
            this.list.remove(this.list.size() - 1);

            // 通過循環進行當前結點與左右孩子結點的大小比較
            while (getLeftChildIndex(i) < this.list.size() && getRightChildIndex(i) < this.list.size()) {
                int leftIndex = getLeftChildIndex(i);
                int rightIndex = getRightChildIndex(i);

                // 通過比較左右孩子的元素哪個較大,確定當前結點與哪個孩子進行交換
                int index = this.list.get(leftIndex).compareTo(this.list.get(rightIndex)) > 0 ? leftIndex : rightIndex;
                if (this.list.get(i).compareTo(this.list.get(index)) < 0) {
                    Collections.swap(this.list, i, index);
                } else {
                    // 如果當前結點都大於左右孩子,則結束比較
                    break;
                }
                i = index;
            }

            return e;
        } else {
            return null;
        }
    }
}

程序測試
/**
 * 最大堆的底層實現--測試程序
 *
 * @author zhuhuix
 * @date 2020-06-28
 */
public class MaxHeapTest {
    public static void main(String[] args) {
        MaxHeap<Integer> maxHeap = new MaxHeap<>();

        // 將10個数字加入形成最大堆
        int[] arrays = {19,29,4,2,27,0,38,15,12,31};
        for (int i = 0; i < arrays.length; i++) {
            maxHeap.add(arrays[i]);
        }

        // 依次從堆中取出最大值
        for (int i = 0; i < arrays.length; i++) {
            System.out.println("第"+(i+1)+"次取出堆目前的最大值:"+maxHeap.getMax());
        }
    }
}

最大堆的應用–優先隊列

優先隊列:出隊的和順序與入隊的順序無關,只與優先級相關;
優先隊列通常可以採用最大堆的數據結構來實現。

/**
 * 用最大堆的數據結構實現優先隊列
 * 
 * @author zhuhuix
 * @date 2020-06-28
 */
public class PriorityQueue<E extends Comparable<E>>  {
    private MaxHeap<E> mhp;
    PriorityQueue() {
        mhp=new MaxHeap<>();
    }

    // 入隊
    public void enqueue(E e) {
        mhp.add(e);
    }

    // 優選級最高的元素出隊
    public E dequeue() {
        return mhp.getMax();
    }

    // 查看優先級最高的元素
    public E getFront() {
        return mhp.findMax();
    }
}

寫在最後

  • 以上通過畫圖、動畫演示、代碼編寫對堆與最大堆的概念和底層實現方式,都作了深入分析;作為最大堆的反向結構,最小堆的實現也是一樣,讀者可參考以上動畫和代碼,動手練習。
  • 畫圖、編碼不易,請點贊、收藏、關注三連!!!

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

※超省錢租車方案

馬來西亞最後一頭蘇門答臘犀牛病逝 全球剩80頭

摘錄自2019年11月24日中央通訊社馬來西亞報導

馬來西亞最後一隻蘇門答臘犀牛,25歲的母犀牛伊曼自2014年被捕獲後,一直在野生動物保護區接受妥善照顧,牠今天(24日)因癌病逝於婆羅洲(Borneo)沙巴(Sabah)。沙巴野生動物部門(Sabah Wildlife Department)主任奧古斯丁(Augustine Tuuga)說:「伊曼的死亡比預期要快,但我們知道,牠已經開始承受極大痛苦。」

蘇門答臘犀牛是體型最小的犀牛,曾廣布亞洲各地,野生蘇門答臘犀牛如今已近乎絕種,據保育人士估計,目前全球僅剩約30至80頭,大多棲息在蘇門答臘和印尼所管轄的婆羅洲地區。馬來西亞2015年宣布野生蘇門答臘犀牛絕種,最後一頭公蘇門答臘犀牛今年5月離世。

保育團體國際犀牛基金會(International Rhino Foundation)說,棲地減少和盜獵導致蘇門答臘犀牛生存於孤立區域,代表牠們繁衍困難,數十年內可能就會滅絕。

自2011年以來,馬來西亞不斷嘗試以體外受精方式,繁殖人工飼養的蘇門答臘犀牛,但迄今尚未成功。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

詳解電動汽車無線充電技術

Q1:無線充電有哪些方式?原理是什麼?  

  A:現在劃分的無線充電類型有好些種,比如感應式、共振式、微波傳輸式等等,不過總體來說,它們的基本原理都是一樣的,就是利用交變電磁場的電磁感應,來實現能量的無線傳輸。    感應式的無線電能傳輸算是目前比較成熟的技術,很多手機無線充電、甚至我們常見的電磁爐就是利用的這種原理。由於數碼設備空間小,接收線圈也小,加上充電設備功率小,所以通常充電的距離近(甚至需要與充電座接觸),不過相對電磁輻射也小。    共振式則是麻省理工目前在開發的一類充電技術,說起來也不複雜,他們利用電磁感應現象,加上共振的原理,能提升無線充電的效率。共振傳輸的距離比普通感應式更遠一些,而麻省理工目前正在進行小型化的研究——對於車長好幾米的電動車來說,這方面的技術壓力倒不是太大。    微波傳輸式此前更多出現在科幻電影或者小說裡面,實際上它也是無線電力傳輸的一個很好的方式,只不過受到發送功率等方面的限制,並未大規模實用化。微波傳輸的最大好處就是傳輸距離遠,甚至可以實現航天器與地面之間的能量傳輸,同時還可以實現定向傳輸(發射天線有方向性),未來前景值得期待。  


Q2:無線充電的好處有哪些?

  A:無線充電的第一個好處就是不需要線,不必為了到處找充電線而費神。第二就是無線充電在硬體方面的標準更容易統一。  
Q3:有待解決的問題有哪些?   A: 一、傳輸效率是所有無線充電都面臨的問題,對於電動車這樣充電功率更大的“電器”來說更是如此——電能首先轉換為無線電波,再由無線電波轉換成電能,這兩次轉換都會損失不少的能量。   二、電磁相容也是無線充電需要解決的技術瓶頸之一。電磁波很容易產生洩漏,當大功率的車用無線充電設備運行時,也會對周圍的生物和電子設備產生影響,甚至會危害人體健康。利用封閉的自動智慧化車庫安裝無線充電設備是解決電磁相容比較好的途徑,不過成本也確實不菲。   三、電氣標準等方面的問題。  
Q4:有哪些典型案例呢?   A:從國外車企來看,特斯拉、沃爾沃、奧迪、寶馬、賓士等傳統汽車都已經開始研發或測試旗下電動車的無線充電系統。全球通訊以及IT界的新貴們也將“觸角”伸向了電動車無線充電的新領域。而在無線充電的規劃和靜態還是動態充電的選擇上,國內外車企則各有不同。  
一、沃爾沃:利用道路進行無線充電  

  在瑞典,沃爾沃集團、瑞典電力公司 Alstom、瑞典能源局正在共同合作測試利用公路給電動汽車充電,通過將兩個電源線鋪設在公路上,電動車經過時便可獲得電力供應。這項技術的核心在於汽車得搭載集電器,集電器與公路上的電纜連線,利用直流電充電。汽車不必走在電纜的中央,但必須時速大於 60 公里。    沃爾沃已在瑞典的 H llered 測試中心建立了一條 1/4 英里長的軌道,用一輛卡車進行測試。未來,當電動汽車需要充電時,必須安裝無線發射器讓道路感知,然後經過加密信號啟動充電功能。由於對速度有要求,沃爾沃的這一充電系統適合在高速路上實行,如果未來成真,人們出遠門的時候就不用擔心電力問題。   利用公路地表進行無線充電很可能是未來的發展方向,相比地面上的設施,它的好處是不需要佔用地面空間,可減少建設、維護成本。汽車不需要停下來進行充電,可持續駕駛。   沃爾沃的這一舉措是為了給電動汽車打造一個良好的充電網路。不過它需要面對很多普及的問題,比如公路建設、設計問題、集電器、電動汽車的支持等。就像無人駕駛一樣,這是一個浩大的工程,短期內還難以實現。  
二、高通:Halo的感應充電系統  

  在2015年4月22日的Formula E電動方程式錦標賽上,高通就展示了自己研發的Halo無線汽車充電技術。只要將車開到充電墊的正上方,當充電線圈對齊之後,電流便會開始輸送到汽車當中。如果汽車和墊子之間存在外來物體,系統還可自動暫停充電。   高通Halo的感應充電系統是個相對直接明瞭的構想:一個由兩個鐵氧體組成的變壓器,兩者的旁邊還各有一個電線線圈。一般來講,這兩個部分是連接在一起的。交流電會在第一個線圈中被轉換成磁場,隨後再被第二個線圈轉換成直流電。而高通Halo卻將兩個鐵氧體分離開來,並讓系統跨越空氣間隔實現最大功率傳輸。    Halo的無線充電器被放置在了車尾的位置,是一個比機上盒稍大一些的金屬盒子,並連接著幾條橙色的電線。至於另一半的充電器,就在汽車的下方。感應充電其實是可以作用於移動中的車輛的。Halo目前已經具備了半動態充電的能力,可在最高30mph的速度下進行電能傳輸。  
三、日產無線充電汽車   日產魔方電動車採用了可在供電線圈和受電線圈之間提供電力的電磁感應方式。即將一個受電線圈裝置安裝在汽車的底盤上,將另一個供電線圈裝置安裝在地面,當電動汽車駛到供電線圈裝置上,受電線圈即可接受到供電線圈的電流,從而對電池進行充電。目前,這套裝置的額定輸出功率為 10kW,一般的電動汽車可在7-8小時內完成充電。    日本無線充電式混合動力巴士:電磁感應式,供電線圈是埋入充電台的混凝土中的。車開上充電台後,當車載線圈對準供電線圈後(重合),車內的儀錶板上有一個指示燈會亮,司機按一下充電按鈕,就開始充電。   
三、中興:無線供電系統   中興通訊的無線供電系統是通過非接觸的電磁感應方式進行電力傳輸。當充電車輛在充電停車位停泊後,就能自動通過無線接入充電場的通信網路,建立起地面系統和車載系統的通信鏈路,並完成車輛鑒權和其他相關資訊交換。   充電位元也可以通過有線或者無線的方式和雲服務中心進行互聯。一旦出現充電和受電的任何隱患,地面充電模組將立即停止充電並報警,確保充電過程安全可靠。最重要的是,無線充電系統在車輛運行時完全不工作,即使車輛在上面駛過,或者在雷雨等惡劣天氣情況下,也能確保安全。  
四、比亞迪:WAVE無線充電墊   比亞迪早在2005年12月就申請了非接觸感應式充電器專利。在2014年7月賣給猶他大學一輛40英尺的純電動巴士,這款巴士就裝配著最新的WAVE無線充電墊。  
五、奧迪:可升降的無線充電系統   奧迪的可升降的無線充電系統最大的特點就是可讓供電線圈更靠近車輛底部的受電線圈,實現了超過90%的電力傳輸效率。這種方式能讓一些高底盤的SUV在充電時保證更好的充電效率。奧迪的無線充電技術僅需要使用者將停車位元元上安置一塊配置線圈和逆變器(AC/AC)充電板,並連接至電網,當車輛停在電板上時,充電過程會自動開啟。   這種充電的原理是充電板內的交變磁場將3.3千瓦的交變電流感應至集成在車內次級線圈的空氣層中,實現電網電流逆向並輸入到車輛的充電系統中。當電池組充滿電時,充電將自動中止。感應式無線充電所需的充電時間與電纜充電所需的充電時間大致相同,且用戶可以隨時中斷充電並使用車輛。   奧迪的無線充電技術效率超過90%,不受譬如雨雪或結冰等天氣因素的影響。同時,交變磁場只有當車輛在充電板上方時才會產生,且不對人體或動物構成傷害。未來利用感應線圈的充電原理,奧迪電動汽車不僅可以在駛入車位後自動開始充電,甚至可以在設有感應線圈的公路上,一邊行駛一邊充電。  
六、特斯拉   在19世紀90年代,尼古拉•特斯拉發明瞭“特斯拉線圈”,能夠通過空氣傳播電力,開啟了無線式電力傳播的時代。在“2011年國際消費電子展”上,美國安利公司旗下子公司富爾頓創新公司展示了無線充電技術,並推出了世界上第一輛無線充電的特斯拉汽車。目前,特斯拉希望能在各個大城市中建立起一張張相互連接的充電網,以解決電動車很容易出現的電力不足問題。   (圖片來源:EEPW)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?
前端進階筆記之核心基礎知識—那些HTML標籤你熟悉嗎?

目錄

  • 1、交互實現
    • 1.1 meta標籤:自動刷新/跳轉
    • 1.2 title標籤:消息提醒
  • 2、性能優化
    • 2.1 script標籤:調整加載順序提升渲染速度
    • 2.2 link標籤:通過預處理提升渲染速度
  • 3、搜索優化
    • 3.1 meta標籤:提取關鍵信息
    • 3.2 link標籤:減少重複
    • 3.3 延伸內容:OGP(開放圖表協議)
  • 總結

提到HTML標籤,我們會非常熟悉,開發中經常使用。但我們往往關注更多的是頁面渲染效果及交互邏輯,也就是對用戶可見可操作的部分,比如表單、菜單欄、列表、圖文等。其實還有一些非常重要卻容易忽視的標籤,這些標籤大多數用在頁面頭部head標籤內,雖然對用戶不可見,但如果在某些場景下,比如交互實現、性能優化、搜索優化,合理利用它們可以讓我們在開發中達到事半功倍的效果。

1、交互實現

在實現一個功能的時候,我們編寫的代碼越多,不僅開發成本越高,而且代碼的健壯性也越差。因此我們在開發中提倡編碼簡約原則:Less code, less bug

1.1 meta標籤:自動刷新/跳轉

meta標籤妙用場景一:假如每隔一分鐘就需要刷新頁面,這個時候就可以用到meta標籤:

<meta http-equiv="Refresh" content="60">

meta標籤妙用場景二:假如想讓某個頁面在對用戶展示一段時間后,然後跳轉到其他頁面去,也可用到meta標籤:

<meta http-equiv="Refresh" content="5; URL=page2.html">

上面這行代碼的意思是當前頁面展示5s之後,跳轉到page2.html頁面去。

1.2 title標籤:消息提醒

B/S架構有很多優點,比如版本更新方便、跨平台、跨終端,但在處理某些場景時,比如即時通信時,會變得有點麻煩。

因為前後端通信深度依賴HTTP協議,而HTTP協議採用“請求-響應”模式,這就決定了服務端也只能被動地發送數據。一種低效的解決方案是客戶端通過輪詢機制獲取最新消息(HTML5下可使用WebSocket協議)。

另外在HTML5標準發布之前,瀏覽器沒有開放圖標閃爍、彈出系統消息之類的接口,因此消息提醒功能實現比較困難。但是我們可以通過修改title標籤來達到類似的效果(HTML5下可使用Web Notifications API彈出系統消息)。

下面這段代碼,通過定時修改title標籤內容,模擬了類似消息提醒的閃爍效果:

let msgNum = 1 // 消息條數
let cnt = 0 // 計數器
const inerval = setInterval(() => {
  cnt = (cnt + 1) % 2
  if(msgNum===0) {
    // 通過DOM修改title
    document.title += `聊天頁面`
    clearInterval(interval)
    return
  }
  const prefix = cnt % 2 ? `新消息(${msgNum})` : ''
  document.title = `${prefix}聊天頁面`
}, 1000)

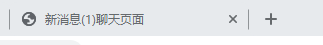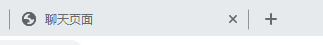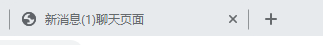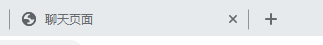
實現效果如下圖所示,可以看到title標籤名稱上有提示文字在閃爍。

通過模擬消息閃爍,可以讓用戶在瀏覽其他頁面的時候,及時得知服務端返回的消息。

通過定時修改title標籤內容,除了用來實現閃爍效果之外,還可以製作其他動畫效果,比如文字滾動,但需要注意瀏覽器會對title標籤文本進行去空格操作;還可以將一些關鍵信息显示到標籤上(比如下載時的進度、當前操作步驟),從而提升用戶體驗。

2、性能優化

性能優化是前端開發中避不開的問題,性能問題無外乎兩方面原因:渲染速度慢、請求時間長。性能優化雖然涉及很多複雜的原因和解決方案,但其實只要通過合理地使用標籤,就可以在一定程度上提升渲染速度,以及減少請求時間。

2.1 script標籤:調整加載順序提升渲染速度

由於瀏覽器的底層運行機制,一般情況下,渲染引擎在解析HTML時從上往下執行,若遇到script標籤引用文件,則會暫停解析過程,同時通知網絡線程加載引用文件。
文件加載完成后,再切換至JavaScript引擎來執行對應代碼,代碼執行完成之後,再切換至渲染引擎繼續渲染頁面。
即默認情況下,加載HTML的過程主要有四個步驟:

  • 從上往下解析HTML;
  • 碰到script標籤引用文件,暫停解析,同時通知網絡線程加載引用文件;
  • 文件加載完成,切換至JavaScript引擎來執行對應代碼;
  • 代碼執行完成后,再切換至渲染頁面,繼續渲染HTML。

從這一過程可以看出,頁面渲染過程包含了請求文件以及執行文件的時間,但頁面的首次渲染可能並不依賴這些文件。這些請求和執行文件的動作反而延長了用戶看到頁面的時間,從而降低了用戶體驗。

為了減少這些時間損耗,可以藉助script標籤的三個屬性來實現:

  • async屬性:立即請求文件,但不阻塞渲染引擎,而是文件加載完成后,再阻塞渲染引擎並立即執行文件內容。
  • defer屬性:立即請求文件,但不阻塞渲染引擎,等到解析完HTML之後再執行文件內容。
  • HTML5標準type屬性,對應值為“module”:讓瀏覽器按照ECMA Script6標準將文件當作模塊進行解析,默認阻塞效果同defer,也可以配合async在請求完成后立即執行。

通過對比,我們看出,設置defer和type=”module”最推薦,都是在HTML渲染完成后才執行script引用的文件代碼。
效果圖比較見下面:

另外注意,當渲染引擎解析HTML遇到script標籤引入文件時,會立即進行一次渲染。

所以這也就是為什麼構建工具會把編譯好的引用JavaScript代碼的script標籤放入到body標籤底部。因為當渲染引擎執行到body底部時,會先將已解析的內容渲染出來,然後再去請求相應的JavaScript文件。

如果是內聯腳本(即不通過src屬性引用外部腳本文件直接在HTML中編寫JavaScript代碼的形式),渲染引擎則不會渲染,先執行腳本代碼再渲染頁面。

我們可以來做個試驗驗證下,第一個測試:在HTML頁面中間引用外部js文件

<!DOCTYPE html>
<html lang="en">
    <head><meta charset="UTF-8"><title>引用js腳本</title></head>
    <body>
        <br/><br/><br/><br/><br/>
        <h3>古人學問無遺力,少壯工夫老始成;</h3>
        <script type="text/javascript" src="./test.js"></script>
        <h3>紙上得來終覺淺,絕知此事要躬行。</h3>
    </body>
</html>

引用外部js腳本test.js:alert('男兒何不帶吳鈎,收取關山五十州');
效果圖:

第二個測試:在HTML頁面中間內聯js腳本

<!DOCTYPE html>
<html lang="en">
    <head><meta charset="UTF-8"><title>內聯js腳本</title></head>
    <body>
        <br/><br/><br/><br/><br/>
        <h3>古人學問無遺力,少壯工夫老始成;</h3>
        <script type="text/javascript">
            alert('男兒何不帶吳鈎,收取關山五十州');
        </script>
        <h3>紙上得來終覺淺,絕知此事要躬行。</h3>
    </body>
</html>

效果圖:

2.2 link標籤:通過預處理提升渲染速度

在大型單頁應用進行性能優化時,也許會用到按需賴加載的方式來加載對應的模塊。但是如果能合理利用link標籤的rel屬性值來進行預加載,就能進一步提升渲染速度。

  • dns-prefetch:當link標籤的rel屬性值為“dns-prefetch”時,瀏覽器會對某個域名預先進行dsn解析並緩存。這樣,當瀏覽器在請求同域名資源的時候,能省去從域名查詢IP的過程,從而減少時間損耗。下圖是淘寶網設置的dns預解析。
  • preconnect:讓瀏覽器在一個HTTP請求正式發給服務器前預先執行一些操作,這包括dns解析、TLS協商、TCP握手,通過消除往返延遲來為用戶節省時間。
  • prefetch/preload:兩個值都是讓瀏覽器預先下載並緩存某個資源,但不同的是,prefetch可能會在瀏覽器忙時被忽略,而preload則是一定會被預先下載。
  • prerender:瀏覽器不僅會加載資源,還會解析執行頁面,進行預渲染。

這幾個屬性值恰好反映了瀏覽器獲取文件的過程,它們獲取文件的流程:

  1. 設置dns-prefetch, 然後判斷是否有對dns進行預解析。沒有則進行dns解析,有則執行下一步preconnect;
  2. 執行preconnect, 對ddns、TLS、TCP進行預連接,然後判斷是否已經TCP連接。沒有則進行TCP連接,有則執行下一步prefetch/preload;
  3. 執行prefetch/preload,加載資源文件。然後判斷資源文件是否已經預加載。沒有則進行http進行資源請求下載,有則進行下一步prerender;
  4. 執行prerender, 預渲染頁面。然後判斷預渲染是否成功。沒有預渲染成功則進行渲染,預渲染成功則呈現給用戶看。

流程圖如下:

3、搜索優化

我們寫的前端代碼,除了要讓瀏覽器更好的執行,有時候也要考慮更方便其他程序(如搜索引擎)理解。合理地使用meta標籤和link標籤,恰好能讓搜索引擎更好的理解和收錄我們的頁面。

3.1 meta標籤:提取關鍵信息

通過meta標籤可以設置頁面的描述信息,從而讓搜索引擎更好的展示搜索結果。
比如在百度中搜索“拉勾”,就會發現網站的描述,這些描述信息就是通過meta標籤專門為搜索引擎設置的,目的是方便用戶預覽搜索到的結果。
為了讓搜索引擎更好的識別頁面,除了描述信息之外還可以使用關鍵字,這樣即使頁面其他地方沒有包含搜索內容,也可以被搜索到(當然搜索引擎有自己的權重和算法,如果濫用關鍵字是會被降權的,比如Google引擎會對堆砌大量相同關鍵詞的網頁進行懲罰,降低它被搜索的權重)。

當我們搜索關鍵字“垂直互聯網招聘”的時候搜索結果會显示拉勾網的信息,雖然显示的搜索內容上並沒有看到“垂直互聯網招聘”字樣,實際上因為拉勾網頁面中設置了這個關鍵字。
對應代碼如下:

<meta content="拉勾,拉勾網,拉勾招聘,拉鈎, 拉鈎網 ,互聯網招聘,拉勾互聯網招聘, 移動互聯網招聘, 垂直互聯網招聘, 微信招聘, 微博招聘, 拉勾官網, 拉勾百科,跳槽, 高薪職位, 互聯網圈子, IT招聘, 職場招聘, 獵頭招聘,O2O招聘, LBS招聘, 社交招聘, 校園招聘, 校招,社會招聘,社招" name="keywords">

3.2 link標籤:減少重複

有時候為了用戶訪問方便或者出於歷史原因,對於同一個頁面會有多個網址,又或者在某些重定向頁面,比如:https://xx.com/a.html、 https://xx.com/detail?id=abcd,那麼在這些頁面中可以設置:<link href="https://xx.com/a.html" rel="canonical">這樣可以讓搜索引擎避免花費時間抓取重複網頁。不過需要注意的是,它還有個限制條件,那就是指向的網站不允許跨域。
當然,要合併網址還有其他的方式,比如使用站點地圖,或者在http請求響應頭部添加rel=”canonical”。

3.3 延伸內容:OGP(開放圖表協議)

前面說的是HTML5標準的一些標籤和屬性,下面再延伸說一說基於meta標籤擴展屬性值實現的第三方協議—OGP(open graph protocal, 開放圖表協議)。

OGP是Facebook公司在2010年提出的,目的是通過增加文檔信息來提升社交網頁在被分享時的預覽效果。你只需要在一些分享頁面中添加一些meta標籤及屬性,支持OGP協議的社交網站就會在解析頁面時生成豐富的預覽信息,比如站點名稱、網頁作者、預覽圖片。具體預覽效果會因各個網站而有所變化。

下面是微信文章支持OGP協議的代碼,可以看到通過meta標籤屬性值聲明了:標題、網址、預覽圖片、描述信息、站點名稱、網頁類型和作者信息。

總結

本篇從交互實現、性能優化、搜索優化場景觸發,分別講解了meta標籤、title標籤、link標籤,一級script標籤在這些場景中的重要作用,希望這些內容你都能應用到工作場景中,不再只是了解,而是能夠熟練運用。
最後在思考一下:你還知道哪些“看不見”的標籤及用法?

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

特斯拉要求員工 4/29 復工,加州工廠可能提前恢復生產

特斯拉已通知部分員工,要求 4 月 29 日重返工作崗位,雖然加州超級工廠所在地的公共衛生部門還沒有公告解除和放鬆居家隔離。特斯拉要求員工提前復工是為了 5 月 3 日前準備好恢復生產。

特斯拉加州超級工廠所在地 Fremont 的公共衛生部門仍然沒有解除居家隔離,超級工廠屬於非必要生產製造工廠,僅可維持最基本營運,生產線處於停產狀態。特斯拉計劃在 5 月 4 日恢復生產,但在正式復工前主管已通知部分員工,要求 4 月 29 日到工廠報到,主要是沖壓、油漆業務員工。特斯拉沒有透露提前復工的員工數量。

Fremont 所屬 Alameda 郡新聞發言人 Ray Kelly 表示,目前居家隔離沒有任何調整,預期 5 月 3 日前公共衛生部門會說明,可能延長、放鬆或完全解除。

特斯拉加州工廠在 3 月 19 日接到政府部門通知,必須停止生產,特斯拉沒有第一時間配合政府部門調整生產線,繼續生產了 5 天,法務團隊也持續與政府部門溝通,特斯拉認為電動車生產屬於必要業務,不能因居家隔離停產,同時為員工提供必要的健康保障措施。停產前特斯拉會測量進入工廠的員工體溫,並向部分員工發放口罩。

政府部門強制要求停工後,特斯拉通知所有員工,除必要工作外,所有員工在家上班,部分無法在家工作的員工列為休假,降低員工薪水,並停止與外部承包商臨時性員工合作。

儘管員工對復工非常期待,但工廠環境和作業方式將使降低傳染變得困難。截至 4 月 26 日,Alameda 郡共報告 1,468 例武漢肺炎病例,52 例死亡,特斯拉工廠大部分員工都住在這區。

選擇在 4 月 29 日部分員工提前復工,對特斯拉意義不僅是工廠恢復營運,也是 4 月 29 日發表第一季財報的日子,投資者會很樂見工廠恢復生產。加州超級工廠生產 Model Y、Model 3、Model X、Model S 電動車,據 Credit Suisse 的分析師估計,關閉後特斯拉每週至少虧損 3 億美元。

關於汽車製造公司何時恢復營運、保障員工安全仍有許多爭議,豐田、Volkswagen、Hyundai 等汽車廠商都計劃 5 月初恢復生產,但汽車工人聯合會代表認為,過早恢復生產對員工非常危險。

(合作媒體:。首圖來源:)

本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

如何在 asp.net core 3.x 的 startup.cs 文件中獲取注入的服務

一、前言

從 18 年開始接觸 .NET Core 開始,在私底下、工作中也開始慢慢從傳統的 mvc 前後端一把梭,開始轉向 web api + vue,之前自己有個半成品的 asp.net core 2.2 的項目模板,最近幾個月的時間,私下除了學習 Angular 也在對這個模板基於 asp.net core 3.1 進行慢慢補齊功能

因為涉及到底層框架大版本升級,由於某些 breaking changes 必定會造成之前的某些寫法沒辦法繼續使用,趁着端午節假期,在改造模板時,發現沒辦法通過構造函數注入的形式在 Startup 文件中注入某些我需要的服務了,因此本篇文章主要介紹如何在 asp.net core 3.x 的 startup 文件中獲取注入的服務

二、Step by Step

2.1、問題案例

這個問題的發現源於我需要改造模型驗證失敗時返回的錯誤信息,如果你有嘗試的話,在 3.x 版本中你會發現在 Startup 類中,我們沒辦法通過構造函數注入的方式再注入任何其它的服務了,這裏僅以我的代碼中需要解決的這個問題作為案例

在定義接口時,為了降低後期調整的複雜度,在接收參數時,一般會將參數包裝成一個 dto 對象(data transfer object – 數據傳輸對象),不管是提交數據,還是查詢數據,對於這個 dto 中的某些屬性,都會存在一定的卡控,例如 xxx 字段不能為空了,xxx 字段的長度不能超過 30

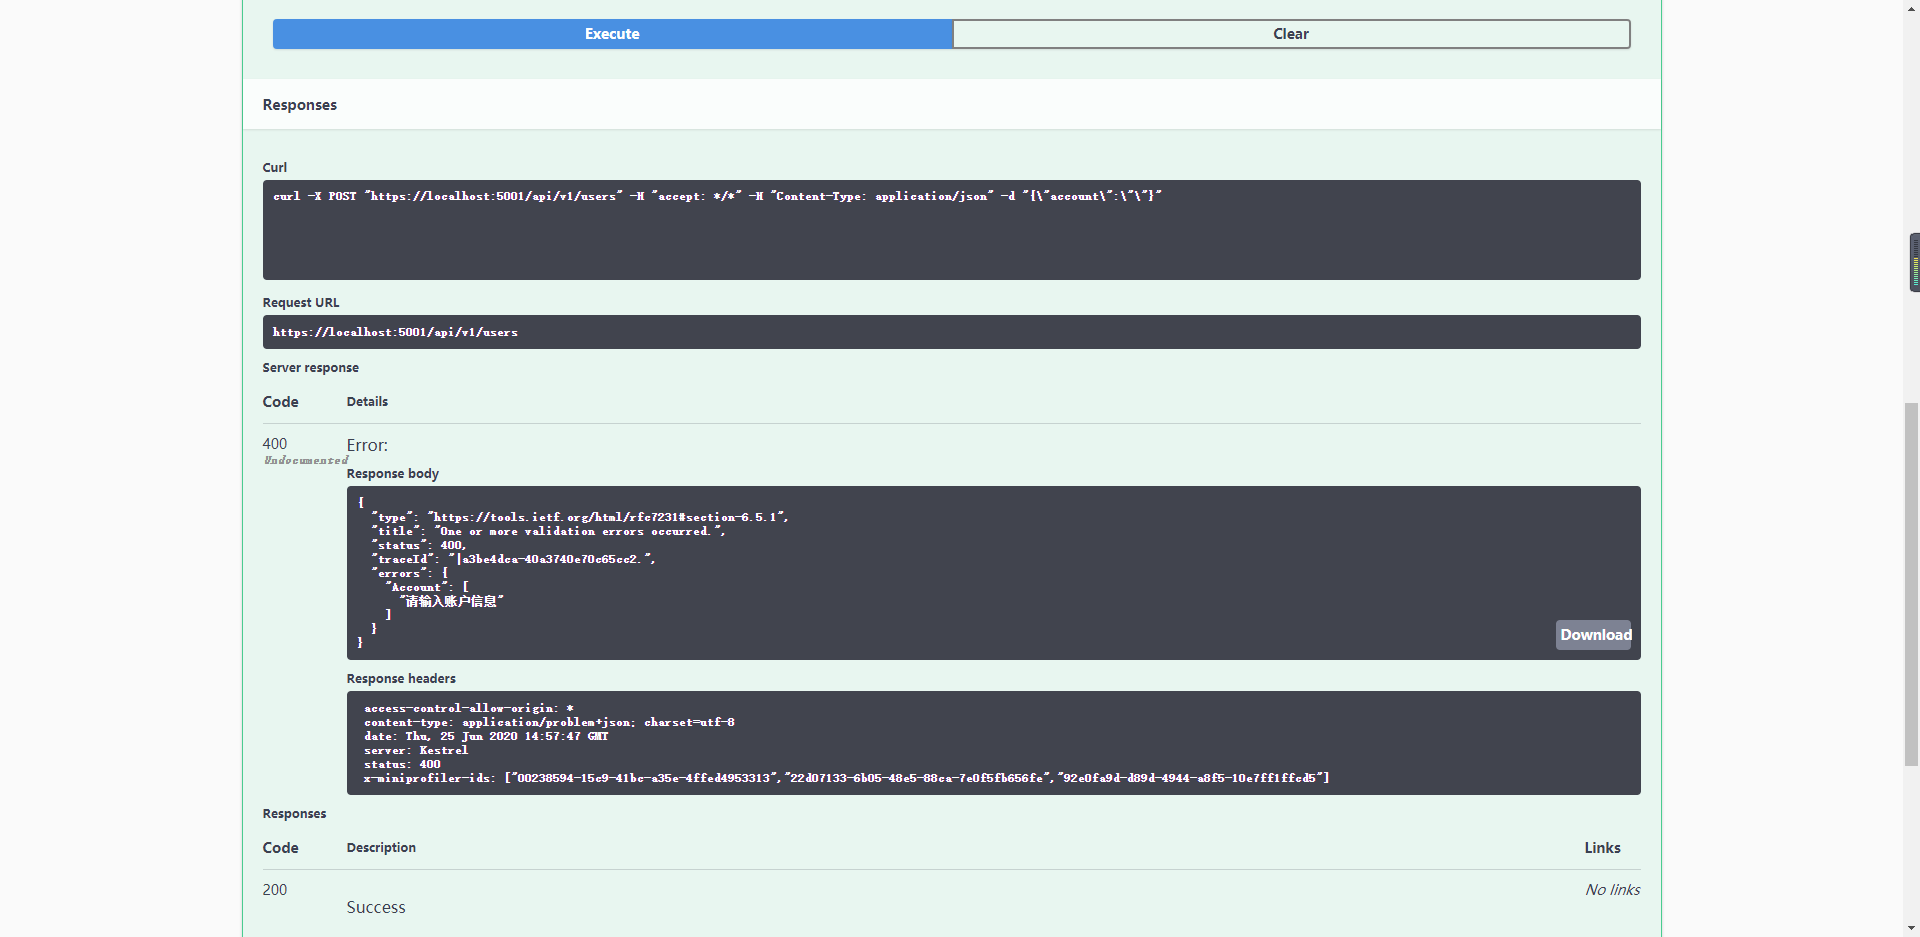
而在 asp.net core 中,因為會自動進行模型驗證,當不符合 dto 中的屬性要求時,接口會自動返回錯誤信息,默認的返回信息如下圖所示

可以看到,因為這裏其實是按照 rfc7231這個 RFC 協議返回的錯誤信息,這個並不符合我的要求,因此這裏我需要改寫這個返回的錯誤信息

自定義 asp.net core 的模型驗證錯誤信息方法有很多種,我的實現方法如下,因為我需要記錄請求的標識 Id 和錯誤日誌,所以這裏我需要將 ILogger 和 IHttpContextAccessor 注入到 Startup 類中

/// <summary>
/// 修改模型驗證錯誤返回信息
/// </summary>
/// <param name="services">服務容器集合</param>
/// <param name="logger">日誌記錄實例</param>
/// <param name="httpContextAccessor"></param>
/// <returns></returns>
public static IServiceCollection AddCustomInvalidModelState(this IServiceCollection services,
    ILogger<Startup> logger, IHttpContextAccessor httpContextAccessor)
{
    services.Configure<ApiBehaviorOptions>(options =>
    {
        options.InvalidModelStateResponseFactory = actionContext =>
        {
            // 獲取驗證不通過的字段信息
            //
            var errors = actionContext.ModelState.Where(e => e.Value.Errors.Count > 0)
                .Select(e => new ApiErrorDto
                {
                    Title = "請求參數不符合字段格式要求",
                    Message = e.Value.Errors.FirstOrDefault()?.ErrorMessage
                }).ToList();

            var result = new ApiReturnDto<object>
            {
                TraceId = httpContextAccessor.HttpContext.TraceIdentifier,
                Status = false,
                Error = errors
            };

            logger.LogError($"接口請求參數格式錯誤: {JsonConvert.SerializeObject(result)}");

            return new BadRequestObjectResult(result);
        };
    });

    return services;
}

在 asp.net core 2.x 版本中,你完全可以像在別的類中採用構造函數注入的方式一樣直接注入使用

public class Startup
{
    /// <summary>
    /// 日誌記錄實例
    /// </summary>
    private readonly ILogger<Startup> _logger;

    /// <summary>
    /// Http 請求實例
    /// </summary>
    private readonly IHttpContextAccessor _httpContextAccessor;

    /// <summary>
    /// ctor
    /// </summary>
    /// <param name="configuration"></param>
    /// <param name="logger"></param>
    /// <param name="httpContextAccessor"></param>
    public Startup(IConfiguration configuration, ILogger<Startup> logger, IHttpContextAccessor httpContextAccessor)
    {
        Configuration = configuration ?? throw new ArgumentNullException(nameof(configuration));
        _logger = logger ?? throw new ArgumentNullException(nameof(logger));
        _httpContextAccessor = httpContextAccessor ?? throw new ArgumentNullException(nameof(httpContextAccessor));
    }

    /// <summary>
    /// 配置實例
    /// </summary>
    public IConfiguration Configuration { get; }

    /// <summary>
    /// This method gets called by the runtime. Use this method to add services to the container.
    /// </summary>
    public void ConfigureServices(IServiceCollection services)
    {
        //注入的其它服務

        // 返回自定義的模型驗證錯誤信息
        services.AddCustomInvalidModelState(_logger, _httpContextAccessor);
    }
}

但是當你直接遷移到 asp.net core 3.x 版本后,你會發現程序會報如下的錯誤,很常見的一個依賴注入的錯誤,源頭直指我們通過構造函數注入的 ILogger、IHttpContextAccessor 接口

2.2、解決方法

根本原因

通過查閱 stackoverflow 發現了這樣的一個問題:How do I write logs from within Startup.cs,在最高贊的回答中提到了在泛型主機(GenericHostBuilder)中,沒辦法注入除 IConfiguration 之外的任何服務到 Startup類中,而泛型主機則是在 asp.net core 3.0 中添加的功能

查了下升級日誌,從中可以看到,在泛型主機中, Startup 類的構造函數注入只支持 IHostEnvironment、 IWebHostEnvironment、IConfiguration ,嗯,不好好看別人文檔的鍋

為什麼使用 WebHostBuilder可以,換成 GenericHostBuilder 就不行了呢

按照正常的邏輯來說,對於一個 asp.net core 應用,原則上來說只有有一個根級(root)的依賴注入容器,但是因為我們在 Startup 類中通過構造函數注入的形式注入服務時,告訴程序了我需要這個服務的實例,從而導致在構建 WebHost 時存在了一個單獨的容器,並且這個容器只包含了我們需要使用到的服務信息,之後,因為會創建了一個包含完整服務的依賴注入容器,這裏就會存在一個服務哪怕是單例的也可能會存在註冊兩次的問題,這無疑有些不太合乎規範

在推行泛型主機之後,嚴格控制了只會存在一個依賴注入容器,而所有的服務都是在 Startup.ConfigureServices 方法執行完成后才會註冊到依賴注入容器中,因此沒辦法像之前一樣在根容器註冊完成之前通過構造函數注入的形式使用

解決方案

如果你需要在 Startup.Configure 方法中使用自定義的服務,因為這裏已經完成了各種服務的註冊,和之前一樣,我們直接在方法簽名中包含需要使用到的服務即可

public void Configure(IApplicationBuilder app, IHostEnvironment env, ILogger<Startup> logger)
{
    logger.LogInformation("在 Configure 中使用自定義的服務");
}

如果你需要在 Startup.ConfigureServices 中使用的話,則需要換一種方法

最簡單的方法,直接替換泛型主機為原來的 WebHostBuilder,這樣就可以直接在 Startup 類中注入各種服務接口了,不過,考慮到這一改動其實是在開倒車,所以這裏不推薦採用這種方法

既然沒辦法正向通過依賴注入容器來自動創建我們需要的服務實例,是不是可以通過服務容器,手動去獲取我們需要的服務,也就是被稱為服務定位(Service Locator)的方式來獲取實例

當然,這似乎與依賴注入的思想相左,對於依賴注入來說,我們將所有需要使用的服務定義好,在應用啟動前完成註冊,之後在使用時由依賴注入容器提供服務的實例即可,而服務定位則是我們已經知道存在這個服務了,從容器中獲取出來然後由自己手動的創建實例

雖然服務定位是一種反模式,但是在某些情況下,我們又不得不採用

這裏對於本篇文章開篇中需要解決的問題,我也是採用服務定位的方式,通過構建一個 ServiceProvider 之後,手動的從容器中獲取需要使用的服務實例,調整后的代碼如下

/// <summary>
/// 添加自定義模型驗證失敗時返回的錯誤信息
/// </summary>
/// <param name="services">服務容器集合</param>
/// <returns></returns>
public static IServiceCollection AddCustomInvalidModelState(this IServiceCollection services)
{
    // 構建一個服務的提供程序
    var provider = services.BuildServiceProvider();

    // 獲取需要使用的服務實例
    //
    var logger = provider.GetRequiredService<ILogger<Startup>>();
    var httpContextAccessor = provider.GetRequiredService<IHttpContextAccessor>();

    services.Configure<ApiBehaviorOptions>(options =>
    {
        options.InvalidModelStateResponseFactory = actionContext =>
        {
            // 獲取失敗信息
            //
            var errors = actionContext.ModelState.Where(e => e.Value.Errors.Count > 0)
                .Select(e => new ApiErrorMessageDto
                {
                    Title = "Request parameters do not meet the field requirements",
                    Message = e.Value.Errors.FirstOrDefault()?.ErrorMessage
                }).ToList();

            var result = new ApiResponseDto<object>
            {
                TraceId = httpContextAccessor.HttpContext.TraceIdentifier,
                Status = false,
                Error = errors
            };

            logger.LogError($"接口請求參數格式錯誤: {JsonSerializer.Serialize(result)}");

            return new BadRequestObjectResult(result);
        };
    });

    return services;
}

對於配置一些需要基於某些服務的服務,這裏也可以通過委託的形式獲取到需要使用的服務實例,示例代碼如下

public void ConfigureServices(IServiceCollection services)
{
    services.AddSingleton<IMyService>((container) =>
    {
        var logger = container.GetRequiredService<ILogger<MyService>>();
        return new MyService
        {
            Logger = logger
        };
    });
}

三、參考資料

  • ASP.NET Core 3.0 的新增功能

  • Generic Host restricts Startup constructor injection

  • 依賴注入模式

  • Avoiding Startup service injection in ASP.NET Core 3

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

dubbo源碼解析之負載均衡

在分佈式系統中,負載均衡是必不可少的一個模塊,dubbo 中提供了五種負載均衡的實現,在閱讀這塊源碼之前,建議先學習負載均衡的基礎知識。把看源碼當做一個印證自己心中所想的過程,這樣會得到事半功倍的效果

以下源碼分析基於 dubbo 2.77 版本

類結構

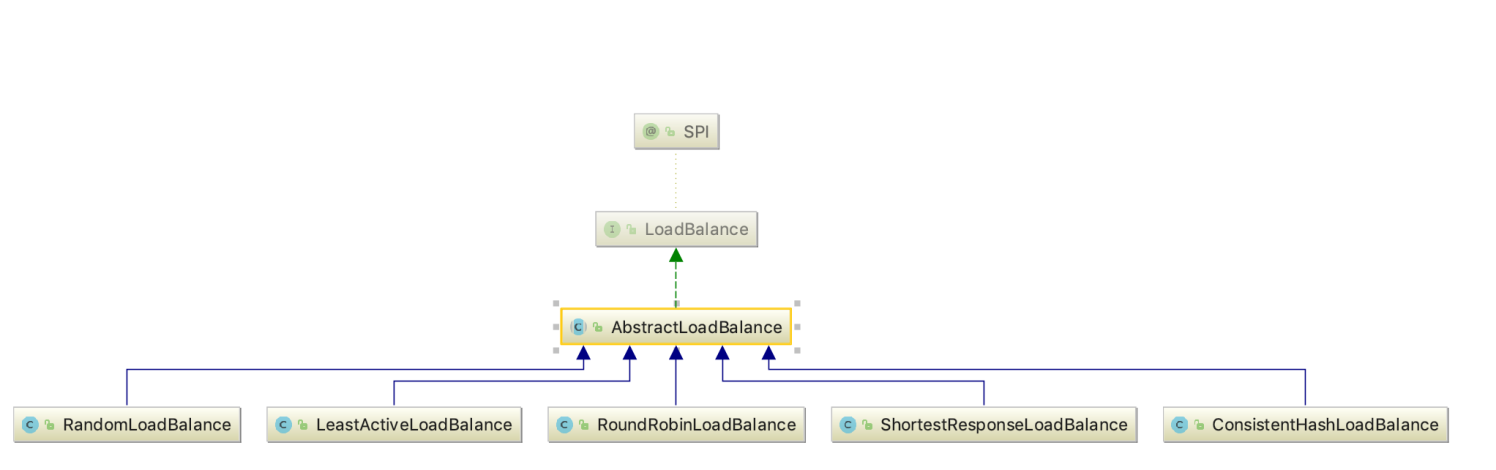
先來看一下這一塊的類結構圖

大部分算法都是在權重比的基礎上進行負載均衡,RandomLoadBalance 是默認的算法

類型 描述 是否默認 是否加權
RandomLoadBalance 隨機 是 是,默認權重相同
RoundRobinLoadBalance 輪訓 否 是,默認權重相同
LeastActiveLoadBalance 最少活躍數調用 否 不完全是,默認權重相同,僅在活躍數相同時按照權重比隨機
ConsistentHashLoadBalance 一致性hash 否 否
ShortestResponseLoadBalance 最短時間調用 否 不完全是,默認權重相同,僅在預估調用相同時按照權重比隨機

AbstractLoadBalance

AbstractLoadBalance 對一些通用的操作做了處理,是一個典型的模板方法模式的實現

select 方法只做一些簡單的範圍校驗,具體的實現有子類通過 doSelect 方法去實現

    @Override
    public <T> Invoker<T> select(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        if (CollectionUtils.isEmpty(invokers)) {
            return null;
        }
        if (invokers.size() == 1) {
            return invokers.get(0);
        }
        return doSelect(invokers, url, invocation);
    }

getWeight方法封裝了獲取一個調用者的權重值的方法,並加入了預熱處理

    int getWeight(Invoker<?> invoker, Invocation invocation) {
        int weight;
        URL url = invoker.getUrl();
        // Multiple registry scenario, load balance among multiple registries.
        // 註冊中心不需要預熱
        if (REGISTRY_SERVICE_REFERENCE_PATH.equals(url.getServiceInterface())) {
            weight = url.getParameter(REGISTRY_KEY + "." + WEIGHT_KEY, DEFAULT_WEIGHT);
        } else {
            // 獲取配置的權重值
            weight = url.getMethodParameter(invocation.getMethodName(), WEIGHT_KEY, DEFAULT_WEIGHT);
            if (weight > 0) {
                // 獲取服務提供者啟動時的時間戳
                long timestamp = invoker.getUrl().getParameter(TIMESTAMP_KEY, 0L);
                if (timestamp > 0L) {
                    //  獲取啟動時長
                    long uptime = System.currentTimeMillis() - timestamp;
                    // 當前時間小於服務提供者啟動時間,直接給一個最小權重1
                    if (uptime < 0) {
                        return 1;
                    }
                    // 獲取預熱時間
                    int warmup = invoker.getUrl().getParameter(WARMUP_KEY, DEFAULT_WARMUP);
                    // 如果小於預熱時間,計算權重
                    if (uptime > 0 && uptime < warmup) {
                        weight = calculateWarmupWeight((int)uptime, warmup, weight);
                    }
                }
            }
        }
        // 取與零比較的最大值,保證不會出現負值權重
        return Math.max(weight, 0);
    }

calculateWarmupWeight 方法用來計算權重,保證隨着預熱時間的增加,權重逐漸達到設置的權重

    static int calculateWarmupWeight(int uptime, int warmup, int weight) {
        // 運行時間/(預熱時間/權重)
        int ww = (int) ( uptime / ((float) warmup / weight));
        // 保證計算的權重最小值是1,並且不能超過設置的權重
        return ww < 1 ? 1 : (Math.min(ww, weight));
    }

RandomLoadBalance

隨機調用是負載均衡算法中最常用的算法之一,也是 dubbo 的默認負載均衡算法,實現起來也較為簡單
隨機調用的缺點是在調用量比較少的情況下,有可能出現不均勻的情況

	@Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // Number of invokers
        int length = invokers.size();
        // Every invoker has the same weight?
        boolean sameWeight = true;
        // the weight of every invokers
        int[] weights = new int[length];
        // the first invoker's weight
        int firstWeight = getWeight(invokers.get(0), invocation);
        weights[0] = firstWeight;
        // The sum of weights
        int totalWeight = firstWeight;
        for (int i = 1; i < length; i++) {
            int weight = getWeight(invokers.get(i), invocation);
            // save for later use
            // 依次把權重放到數組對應的位置
            weights[i] = weight;
            // Sum
            // 累加權重
            totalWeight += weight;
            // 如果出現權重不一樣的,sameWeight 設為false
            if (sameWeight && weight != firstWeight) {
                sameWeight = false;
            }
        }
        if (totalWeight > 0 && !sameWeight) {
            // If (not every invoker has the same weight & at least one invoker's weight>0), select randomly based on totalWeight.
            // 在總權重裏面隨機選擇一個偏移量
            int offset = ThreadLocalRandom.current().nextInt(totalWeight);
            // Return a invoker based on the random value.
            for (int i = 0; i < length; i++) {
                offset -= weights[i];
                // 依次用偏移量減去當前權重,小於0說明選中
                if (offset < 0) {
                    return invokers.get(i);
                }
            }
        }
        // If all invokers have the same weight value or totalWeight=0, return evenly.
        // 如果所有的調用者有同樣的權重或者總權重為0,則隨機選擇一個
        return invokers.get(ThreadLocalRandom.current().nextInt(length));
    }

RoundRobinLoadBalance

輪訓算法避免了隨機算法在小數據量產生的不均勻問題,我個人認為,輪訓算法可以理解為隨機算法的一種特例,在大量請求的情況下,從調用次數看,和隨機並無區別,主要區別在於短時間內的調用分配上

加權輪訓算法給人的直觀感受,實現起來並不複雜,算出一權重總量,依次調用即可
例如A,B,C 三個節點的權重比依次 1,200,1000,如果依次輪訓調用,就會出現先調用A 10 次,再調用B 200次,最後調用 C 1000次,不斷重複前面的過程
但這樣有一個問題,我們可以發現C 被練習調用1000次,會對C瞬間造成很大的壓力

dubbo的新版本採用的是平滑加權輪詢算法,輪訓的過程中節點之間穿插調用,可以避免了上面說的問題,因此這塊源碼看起來會稍有難度

輪訓算法 在dubbo 在升級的過程中,做過多次優化,有興趣的可以去了解下該算法的優化過程,也是件很有意思的事情

public class RoundRobinLoadBalance extends AbstractLoadBalance {
    public static final String NAME = "roundrobin";

    private static final int RECYCLE_PERIOD = 60000;

    protected static class WeightedRoundRobin {
        // 權重值
        private int weight;
        // 當前權重值
        private AtomicLong current = new AtomicLong(0);
        // 最後一次使用該對象時間
        private long lastUpdate;

        public int getWeight() {
            return weight;
        }

        public void setWeight(int weight) {
            this.weight = weight;
            current.set(0);
        }

        // 獲取自增權重基數的當前權重值
        public long increaseCurrent() {
            return current.addAndGet(weight);
        }

        public void sel(int total) {
            current.addAndGet(-1 * total);
        }

        public long getLastUpdate() {
            return lastUpdate;
        }

        // 設置最後一次更新時間戳
        public void setLastUpdate(long lastUpdate) {
            this.lastUpdate = lastUpdate;
        }
    }

    private ConcurrentMap<String, ConcurrentMap<String, WeightedRoundRobin>> methodWeightMap = new ConcurrentHashMap<String, ConcurrentMap<String, WeightedRoundRobin>>();

    /**
     * get invoker addr list cached for specified invocation
     * <p>
     * <b>for unit test only</b>
     *
     * @param invokers
     * @param invocation
     * @return
     */
    protected <T> Collection<String> getInvokerAddrList(List<Invoker<T>> invokers, Invocation invocation) {
        String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName();
        Map<String, WeightedRoundRobin> map = methodWeightMap.get(key);
        if (map != null) {
            return map.keySet();
        }
        return null;
    }

    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // {group}/{interfaceName}:{version} + methoName 獲取當前消費者的唯一標示
        String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName();
        // 獲取對應的 WeightedRoundRobin map,如果不存在,new 一個map放進去
        ConcurrentMap<String, WeightedRoundRobin> map = methodWeightMap.computeIfAbsent(key, k -> new ConcurrentHashMap<>());
        int totalWeight = 0;
        long maxCurrent = Long.MIN_VALUE;
        long now = System.currentTimeMillis();
        Invoker<T> selectedInvoker = null;
        WeightedRoundRobin selectedWRR = null;
        for (Invoker<T> invoker : invokers) {
            // 服務提供者在的唯一標識
            String identifyString = invoker.getUrl().toIdentityString();
            int weight = getWeight(invoker, invocation);
            WeightedRoundRobin weightedRoundRobin = map.computeIfAbsent(identifyString, k -> {
                WeightedRoundRobin wrr = new WeightedRoundRobin();
                wrr.setWeight(weight);
                return wrr;
            });
            // 如果權重改變了,更新 weightedRoundRobin 裏面權重的值
            if (weight != weightedRoundRobin.getWeight()) {
                //weight changed
                weightedRoundRobin.setWeight(weight);
            }
            // 當前權重自增自身權重
            long cur = weightedRoundRobin.increaseCurrent();
            // 設置最後一次更新時間戳
            weightedRoundRobin.setLastUpdate(now);
            // 如果當前權重大於最大當前權重
            if (cur > maxCurrent) {
                // 重置最大當前權重的值
                maxCurrent = cur;
                // 把當前提供者設為選中的提供者
                selectedInvoker = invoker;
                // 把當前輪訓權重實例設為選中
                selectedWRR = weightedRoundRobin;
            }
            // 累計總權重
            totalWeight += weight;
        }
        // 提供者有變化
        if (invokers.size() != map.size()) {
            // 超過60s沒有使用,刪除掉
            map.entrySet().removeIf(item -> now - item.getValue().getLastUpdate() > RECYCLE_PERIOD);
        }
        if (selectedInvoker != null) {
            // 減去總權重
            // 關於這個地方為什麼要減去總權重,是一個很容易造成迷惑的地方
            // 我的理解:每一次調用循環 每個提供者的 當前權重 都會自增自己的權重
            // 因此在選中后(只有一個被選中),再減去總權重,正好保證了所有 WeightedRoundRobin 中當前權重之和永遠等於0
            selectedWRR.sel(totalWeight);
            return selectedInvoker;
        }
        // 理論上不會走到這個地方
        // should not happen here
        return invokers.get(0);
    }

}

LeastActiveLoadBalance

最少活躍數調用算法是指在調用時判斷此時每個服務提供者此時正在處理的請求個數,選取最小的調用

dubbo 在實現該算法時的具體邏輯如下

  1. 選取所有活躍數最少的提供者
  2. 如果只有一個,直接返回
  3. 如果權重不同,加權隨機選擇一個
  4. 如果權重相同,隨機選擇一個
    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // Number of invokers
        int length = invokers.size();
        // The least active value of all invokers
        // 最少活躍數量
        int leastActive = -1;
        // The number of invokers having the same least active value (leastActive)
        // 有同樣活躍值的提供者數量
        int leastCount = 0;
        // The index of invokers having the same least active value (leastActive)
        int[] leastIndexes = new int[length];
        // the weight of every invokers
        // 每一個提供者的權重
        int[] weights = new int[length];
        // The sum of the warmup weights of all the least active invokers
        // 最少活躍提供者的總權重
        int totalWeight = 0;
        // The weight of the first least active invoker
        int firstWeight = 0;
        // Every least active invoker has the same weight value?
        // 所有的最少活躍提供者是否擁有同樣的權重值
        boolean sameWeight = true;


        // Filter out all the least active invokers
        for (int i = 0; i < length; i++) {
            Invoker<T> invoker = invokers.get(i);
            // Get the active number of the invoker
            // 活躍數量
            int active = RpcStatus.getStatus(invoker.getUrl(), invocation.getMethodName()).getActive();
            // Get the weight of the invoker's configuration. The default value is 100.
            // 獲取權重值
            int afterWarmup = getWeight(invoker, invocation);
            // save for later use
            // 保存權重留着後面用
            weights[i] = afterWarmup;
            // If it is the first invoker or the active number of the invoker is less than the current least active number
            // 如果是第一個提供者,或者當前活躍數量比最少的少
            if (leastActive == -1 || active < leastActive) {
                // Reset the active number of the current invoker to the least active number
                // 重置最少活躍數量
                leastActive = active;
                // Reset the number of least active invokers
                // 重置最少活躍提供者的數量
                leastCount = 1;
                // Put the first least active invoker first in leastIndexes
                // 把最少活躍提供者的索引保存起來
                leastIndexes[0] = i;
                // Reset totalWeight
                // 重置總權重
                totalWeight = afterWarmup;
                // Record the weight the first least active invoker
                // 記錄第一個最少活躍提供者的權重
                firstWeight = afterWarmup;
                // Each invoke has the same weight (only one invoker here)
                // 每個最少活躍提供者是否有同樣的權重???
                sameWeight = true;
                // If current invoker's active value equals with leaseActive, then accumulating.
                // 如果當前活躍數量等於最少活躍數量
            } else if (active == leastActive) {
                // Record the index of the least active invoker in leastIndexes order
                // 最少活躍提供者的索引依次放入 leastIndexes
                leastIndexes[leastCount++] = i;
                // Accumulate the total weight of the least active invoker
                // 累計最少活躍提供者的總權重
                totalWeight += afterWarmup;
                // If every invoker has the same weight?
                // 如果當前權重和第一個最少活躍的權重不同,sameWeight 設為false
                if (sameWeight && afterWarmup != firstWeight) {
                    sameWeight = false;
                }
            }
        }
        // Choose an invoker from all the least active invokers
        // 最少活躍提供者只有一個,直接返回
        if (leastCount == 1) {
            // If we got exactly one invoker having the least active value, return this invoker directly.
            return invokers.get(leastIndexes[0]);
        }
        // 如擁有不同的權重,在權重的基礎上隨機選取一個,可以參考 RandomLoadBalance,有同樣的寫法
        if (!sameWeight && totalWeight > 0) {
            // If (not every invoker has the same weight & at least one invoker's weight>0), select randomly based on 
            // totalWeight.
            int offsetWeight = ThreadLocalRandom.current().nextInt(totalWeight);
            // Return a invoker based on the random value.
            for (int i = 0; i < leastCount; i++) {
                int leastIndex = leastIndexes[i];
                offsetWeight -= weights[leastIndex];
                if (offsetWeight < 0) {
                    return invokers.get(leastIndex);
                }
            }
        }
        // 權重相同,隨機選取一個
        // If all invokers have the same weight value or totalWeight=0, return evenly.
        return invokers.get(leastIndexes[ThreadLocalRandom.current().nextInt(leastCount)]);
    }

ShortestResponseLoadBalance

最短時間調用調用算法是指預估出來每個處理完請求的提供者所需時間,然後又選擇最少最短時間的提供者進行調用,整體處理邏輯和最少活躍數算法基本相似

dubbo 在實現該算法時的具體邏輯如下

  1. 選取所有預估處理時間最短的提供者
  2. 如果只有一個,直接返回
  3. 如果權重不同,加權隨機選擇一個
  4. 如果權重相同,隨機選擇一個
    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        // Number of invokers
        int length = invokers.size();
        // Estimated shortest response time of all invokers
        // 最少響應時間
        long shortestResponse = Long.MAX_VALUE;
        // The number of invokers having the same estimated shortest response time
        // 最少響應時間的提供者數量
        int shortestCount = 0;
        // The index of invokers having the same estimated shortest response time
        int[] shortestIndexes = new int[length];
        // the weight of every invokers
        int[] weights = new int[length];
        // The sum of the warmup weights of all the shortest response  invokers
        // 最少響應時間的提供者的總權重
        int totalWeight = 0;
        // The weight of the first shortest response invokers
        // 第一個最少響應時間的權重
        int firstWeight = 0;
        // Every shortest response invoker has the same weight value?
        // 所有的最少響應時間提供者是否擁有同樣的權重值
        boolean sameWeight = true;

        // Filter out all the shortest response invokers
        for (int i = 0; i < length; i++) {
            Invoker<T> invoker = invokers.get(i);
            RpcStatus rpcStatus = RpcStatus.getStatus(invoker.getUrl(), invocation.getMethodName());
            // Calculate the estimated response time from the product of active connections and succeeded average elapsed time.
            //  平均響應成功時間
            long succeededAverageElapsed = rpcStatus.getSucceededAverageElapsed();
            // 活躍的連接連接數量
            int active = rpcStatus.getActive();
            // 預估響應時間
            long estimateResponse = succeededAverageElapsed * active;
            // 獲取權重值
            int afterWarmup = getWeight(invoker, invocation);
            // 保存權重留着後面用
            weights[i] = afterWarmup;
            // Same as LeastActiveLoadBalance
            // 如果預估時間小於最少的響應時間
            if (estimateResponse < shortestResponse) {
                // 重置最少響應時間
                shortestResponse = estimateResponse;
                // 最少響應時間的提供者數量設為1
                shortestCount = 1;
                // 保存提供者下標
                shortestIndexes[0] = i;
                // 重置最少響應時間的提供者的總權重
                totalWeight = afterWarmup;
                // 重置第一個最少響應時間的權重
                firstWeight = afterWarmup;
                sameWeight = true;
                // 如果當前最少響應時間等於最少響應時間
            } else if (estimateResponse == shortestResponse) {
                // 最少最少響應時間的下標依次放入 shortestIndexes
                shortestIndexes[shortestCount++] = i;
                // 累計最少響應時間的總權重
                totalWeight += afterWarmup;
                // 如果當前權重和第一個最少響應時間的權重不同,sameWeight 設為false
                if (sameWeight && i > 0
                        && afterWarmup != firstWeight) {
                    sameWeight = false;
                }
            }
        }
        // 最少最少響應時間只有一個,直接返回
        if (shortestCount == 1) {
            return invokers.get(shortestIndexes[0]);
        }
        // 如擁有不同的權重,在權重的基礎上隨機選取一個,可以參考 RandomLoadBalance,有同樣的寫法
        if (!sameWeight && totalWeight > 0) {
            int offsetWeight = ThreadLocalRandom.current().nextInt(totalWeight);
            for (int i = 0; i < shortestCount; i++) {
                int shortestIndex = shortestIndexes[i];
                offsetWeight -= weights[shortestIndex];
                if (offsetWeight < 0) {
                    return invokers.get(shortestIndex);
                }
            }
        }
        // 權重相同,隨機選取一個
        return invokers.get(shortestIndexes[ThreadLocalRandom.current().nextInt(shortestCount)]);
    }

ConsistentHashLoadBalance

一致性hash算法是一種廣泛應用與分佈式緩存中的算法,該算法的優勢在於新增和刪除節點后,只有少量請求發生變動,大部分請求仍舊映射到原來的節點
為了防止節點過少,造成節點分佈不均勻,一般採用虛擬節點的方式,dubbo默認的是160個虛擬節點

網上關於一致性hash算法的文章有很多,這裏就不再多贅述,以下是dubbo中的實現,需要說明的是, 一致性hash算法中權重配置不起作用

    @Override
    protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
        String methodName = RpcUtils.getMethodName(invocation);
        // {group}/{interfaceName}:{version} + methoName 獲取當前消費者的唯一標示
        String key = invokers.get(0).getUrl().getServiceKey() + "." + methodName;
        // using the hashcode of list to compute the hash only pay attention to the elements in the list
        int invokersHashCode = invokers.hashCode();
        // 獲取當前消費者的一致性hash選擇器
        ConsistentHashSelector<T> selector = (ConsistentHashSelector<T>) selectors.get(key);
        // 如果 selector 還沒初始化,或者 invokers 已經變化,重新初始化 selector
        if (selector == null || selector.identityHashCode != invokersHashCode) {
            selectors.put(key, new ConsistentHashSelector<T>(invokers, methodName, invokersHashCode));
            selector = (ConsistentHashSelector<T>) selectors.get(key);
        }
        return selector.select(invocation);
    }
    // 一致性hash選擇器
    private static final class ConsistentHashSelector<T> {

        // 存儲hash環的數據結構 節點 -> 提供者
        private final TreeMap<Long, Invoker<T>> virtualInvokers;

        // 虛擬節點數量
        private final int replicaNumber;

        // 用來標示所有提供者是唯一標示
        private final int identityHashCode;
        // 用來存儲計算hash值參數下標的數組,例如計算第一個和第三個參數 該數組為[0,2]
        private final int[] argumentIndex;

        ConsistentHashSelector(List<Invoker<T>> invokers, String methodName, int identityHashCode) {
            this.virtualInvokers = new TreeMap<Long, Invoker<T>>();
            this.identityHashCode = identityHashCode;
            URL url = invokers.get(0).getUrl();
            // 虛擬節點數量,默認 160
            this.replicaNumber = url.getMethodParameter(methodName, HASH_NODES, 160);
            // 默認只對第一個參數進行hash
            String[] index = COMMA_SPLIT_PATTERN.split(url.getMethodParameter(methodName, HASH_ARGUMENTS, "0"));
            argumentIndex = new int[index.length];
            for (int i = 0; i < index.length; i++) {
                argumentIndex[i] = Integer.parseInt(index[i]);
            }
            for (Invoker<T> invoker : invokers) {
                String address = invoker.getUrl().getAddress();
                // 關於這個地方為什麼要除以4,我理解的是md5後為16字節的數組,計算hash值只需要用到四個字節,所以可以用四次
                // 因此除以4,算是一個性能優化點
                for (int i = 0; i < replicaNumber / 4; i++) {
                    // md5, 獲得一個長度為16的字節數組
                    byte[] digest = md5(address + i);
                    for (int h = 0; h < 4; h++) {
                        // 如果h=0,則用第0,1,2,3四個字節進行位運算,得出一個0-2^32-1的值
                        // 如果h=1,則用第4,5,6,7四個字節進行位運算,得出一個0-2^32-1的值
                        // 如果h=2,則用第8,9,10,11四個字節進行位運算,得出一個0-2^32-1的值
                        // 如果h=3,則用第12,13,14,15四個字節進行位運算,得出一個0-2^32-1的值
                        long m = hash(digest, h);
                        virtualInvokers.put(m, invoker);
                    }
                }
            }
        }

        public Invoker<T> select(Invocation invocation) {
            String key = toKey(invocation.getArguments());
            byte[] digest = md5(key);
            return selectForKey(hash(digest, 0));
        }
        // 根據配置生成計算hash值的key
        private String toKey(Object[] args) {
            StringBuilder buf = new StringBuilder();
            for (int i : argumentIndex) {
                if (i >= 0 && i < args.length) {
                    buf.append(args[i]);
                }
            }
            return buf.toString();
        }

        private Invoker<T> selectForKey(long hash) {
            // 找到hash值在hash環上的位置
            // ceilingEntry 方法返回大於或者等於當前key的鍵值對
            Map.Entry<Long, Invoker<T>> entry = virtualInvokers.ceilingEntry(hash);
            // 如果返回為空,說明落在了hash環中2的32次方-1的最後,直接返回第一個
            if (entry == null) {
                entry = virtualInvokers.firstEntry();
            }
            return entry.getValue();
        }
        // 得出一個0-2^32-1的值, 四個字節組成一個長度為32位的二進制数字並轉化為long值
        private long hash(byte[] digest, int number) {
            return (((long) (digest[3 + number * 4] & 0xFF) << 24)
                    | ((long) (digest[2 + number * 4] & 0xFF) << 16)
                    | ((long) (digest[1 + number * 4] & 0xFF) << 8)
                    | (digest[number * 4] & 0xFF))
                    & 0xFFFFFFFFL;
        }

        private byte[] md5(String value) {
            MessageDigest md5;
            try {
                md5 = MessageDigest.getInstance("MD5");
            } catch (NoSuchAlgorithmException e) {
                throw new IllegalStateException(e.getMessage(), e);
            }
            md5.reset();
            byte[] bytes = value.getBytes(StandardCharsets.UTF_8);
            md5.update(bytes);
            return md5.digest();
        }

    }

總結

以上就是dubbo負載均衡源碼的全部解析,如果還是不明白,可以看下官方文檔的解析  
http://dubbo.apache.org/zh-cn/docs/source_code_guide/loadbalance.html

dubbo的負載均衡算法總體來說並不複雜,代碼寫的也很優雅,簡潔,看起來很舒服,而且有很多細節的處理值得稱讚,例如預熱處理,輪訓算法的平滑處理等。

我們平時使用時,可以根據自己的業務場景,選擇適合自己的算法,當然,一般情況下,默認的的隨機算法就能滿足我們的日常需求,而且隨機算法的性能足夠好。

如果覺得dubbo提供的五種算法都不能滿足自己的需求,還可以通過dubbo的SPI機制很方便的擴展自己的負載均衡算法。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

歐盟2020年環保目標難達陣 生物多樣性挑戰尤多

摘錄自2019年12月4日中央社報導

聯合國氣候變化綱要公約第25次締約方會議(COP25)2日在西班牙馬德里開議,將持續至13日。歐洲環保署在配合會議出版的報告中指出,儘管大部分原定2020年達成的環保目標勢必已無法達成,尤其是在生物多樣性領域,歐盟仍有機會實現為2030年和2050年設定的較長遠目標。

報告強調,有鑑於生物多樣性降低的程度令人憂心、氣候變遷衍生的多方面衝擊日益嚴重,以及天然資源遭過度消耗,歐洲必須在未來10年儘速行動。

報告指出,儘管1990至2017年期間,歐洲的溫室氣體排放量已減少22%,且再生能源的使用比例也提升,歐洲在環保領域仍有進步空間。

根據歐洲環保署,在為2020年設定的13個生物多樣性政策目標中,只有兩個達標:劃設海洋保護區和陸地保護區。然而,物種、天然棲地、水生態系統、溼地和土壤狀況的保護,以及化學物排放與空氣和噪音的污染,仍令人擔憂。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?