Spring Boot 2.X(十六):應用監控之 Spring Boot Actuator 使用及配置

Actuator 簡介

Actuator 是 Spring Boot 提供的對應用系統的自省和監控功能。通過 Actuator,可以使用數據化的指標去度量應用的運行情況,比如查看服務器的磁盤、內存、CPU等信息,系統的線程、gc、運行狀態等等。

Actuator 通常通過使用 HTTP 和 JMX 來管理和監控應用,大多數情況使用 HTTP 的方式。

Actuator 端點說明

端點 描述
auditevents 獲取當前應用暴露的審計事件信息
beans 獲取應用中所有的 Spring Beans 的完整關係列表
caches 獲取公開可以用的緩存
conditions 獲取自動配置條件信息,記錄哪些自動配置條件通過和沒通過的原因
configprops 獲取所有配置屬性,包括默認配置,显示一個所有 @ConfigurationProperties 的整理列版本
env 獲取所有環境變量
flyway 獲取已應用的所有Flyway數據庫遷移信息,需要一個或多個 Flyway Bean
liquibase 獲取已應用的所有Liquibase數據庫遷移。需要一個或多個 Liquibase Bean
health 獲取應用程序健康指標(運行狀況信息)
httptrace 獲取HTTP跟蹤信息(默認情況下,最近100個HTTP請求-響應交換)。需要 HttpTraceRepository Bean
info 獲取應用程序信息
integrationgraph 显示 Spring Integration 圖。需要依賴 spring-integration-core
loggers 显示和修改應用程序中日誌的配置
logfile 返回日誌文件的內容(如果已設置logging.file.name或logging.file.path屬性)
metrics 獲取系統度量指標信息
mappings 显示所有@RequestMapping路徑的整理列表
scheduledtasks 显示應用程序中的計劃任務
sessions 允許從Spring Session支持的會話存儲中檢索和刪除用戶會話。需要使用Spring Session的基於Servlet的Web應用程序
shutdown 關閉應用,要求endpoints.shutdown.enabled設置為true,默認為 false
threaddump 獲取系統線程轉儲信息
heapdump 返回hprof堆轉儲文件
jolokia 通過HTTP公開JMX bean(當Jolokia在類路徑上時,不適用於WebFlux)。需要依賴 jolokia-core
prometheus 以Prometheus服務器可以抓取的格式公開指標。需要依賴 micrometer-registry-prometheus

Actuator 使用及配置

快速使用

項目依賴

<dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <!-- actuator -->
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-actuator</artifactId>
        </dependency>
</dependencies>

配置文件

management.endpoints.enabled-by-default=true
#啟動所有端點
management.endpoints.web.exposure.include=*
#自定義管理端點路徑
#management.endpoints.web.base-path=/manage

Spring Boot 2.X 中,Actuator 默認只開放 health 和 info 兩個端點。

添加management.endpoints.web.exposure.include=*配置后啟動應用,訪問 http://127.0.0.1:8080/actuator 我們可以看到所有的 Actuator 端點列表。

如果將management.endpoints.enabled-by-default設置為false,則禁用所有端點,如需啟用則如下:

management.endpoints.enabled-by-default=false
management.endpoint.info.enabled=true

禁用的端點將從應用程序上下文中完全刪除。如果只想更改公開端點,使用include和exclude屬性。使用如下:

management.endpoints.web.exposure.include=*
management.endpoints.web.exposure.exclude=env,beans

management.endpoints.web.base-path=/manage 配置表示將 /actuator 路徑重定義為 /manage。

常用端點詳解

health

主要用來檢測應用的運行狀況,是使用最多的一個監控點。監控軟件通常使用該接口實時監測應用運行狀況,在系統出現故障時把報警信息推送給相關人員,如磁盤空間使用情況、數據庫和緩存等的一些健康指標。
默認情況下 health 端點是開放的,訪問 http://127.0.0.1:8080/actuator/health 即可看到應用運行狀態。

{"status":"UP"}

如果需要看到詳細信息,則需要做添加配置:

management.endpoint.health.show-details=always

訪問返回信息如下:

{"status":"UP","details":{"diskSpace":{"status":"UP","details":{"total":180002725888,"free":8687988736,"threshold":10485760}}}}

info

查看應用信息是否在 application.properties 中配置。如我們在項目中配置是:

info.app.name=Spring Boot Actuator Demo
info.app.version=v1.0.0
info.app.description=Spring Boot Actuator Demo

啟動項目,訪問 http://127.0.0.1:8080/actuator/info 返回信息如下:

{"app":{"name":"Spring Boot Actuator Demo","version":"v1.0.0","description":"Spring Boot Actuator Demo"}}

env

通過 env 可以獲取到所有關於當前 Spring Boot 應用程序的運行環境信息,如:操作系統信息(systemProperties)、環境變量信息、JDK 版本及 ClassPath 信息、當前啟用的配置文件(activeProfiles)、propertySources、應用程序配置信息(applicationConfig)等。

可以通過 http://127.0.0.1:8080/actuator/env/{name} ,name表示想要查看的信息,可以獨立显示。

beans

訪問 http://127.0.0.1:8080/actuator/beans 返回部分信息如下:

{
    "contexts": {
        "Spring Boot Actuator Demo": {
            "beans": {
                "endpointCachingOperationInvokerAdvisor": {
                    "aliases": [
                    ],
                    "scope": "singleton",
                    "type": "org.springframework.boot.actuate.endpoint.invoker.cache.CachingOperationInvokerAdvisor",
                    "resource": "class path resource [org/springframework/boot/actuate/autoconfigure/endpoint/EndpointAutoConfiguration.class]",
                    "dependencies": [
                        "environment"
                    ]
                },
                "defaultServletHandlerMapping": {
                    "aliases": [
                    ],
                    "scope": "singleton",
                    "type": "org.springframework.web.servlet.HandlerMapping",
                    "resource": "class path resource [org/springframework/boot/autoconfigure/web/servlet/WebMvcAutoConfiguration$EnableWebMvcConfiguration.class]",
                    "dependencies": [
                    ]
                },
                ...
            }
        }
    }
}

從返回的信息中我們可以看出主要展示了 bean 的別名、類型、是否單例、類的地址、依賴等信息。

conditions

通過 conditions 可以在應用運行時查看代碼了某個配置在什麼條件下生效,或者某個自動配置為什麼沒有生效。

訪問 http://127.0.0.1:8080/actuator/conditions 返回部分信息如下:

{
    "contexts": {
        "Spring Boot Actuator Demo": {
            "positiveMatches": {
                "SpringBootAdminClientAutoConfiguration": [
                    {
                        "condition": "OnWebApplicationCondition",
                        "message": "@ConditionalOnWebApplication (required) found 'session' scope"
                    },
                    {
                        "condition": "SpringBootAdminClientEnabledCondition",
                        "message": "matched"
                    }
                ],
                "SpringBootAdminClientAutoConfiguration#metadataContributor": [
                    {
                        "condition": "OnBeanCondition",
                        "message": "@ConditionalOnMissingBean (types: de.codecentric.boot.admin.client.registration.metadata.CompositeMetadataContributor; SearchStrategy: all) did not find any beans"
                    }
                ],
                ...
            }
        }
    }
}

loggers

獲取系統的日誌信息。

訪問 http://127.0.0.1:8080/actuator/loggers 返回部分信息如下:

{
    "levels": [
        "OFF",
        "ERROR",
        "WARN",
        "INFO",
        "DEBUG",
        "TRACE"
    ],
    "loggers": {
        "ROOT": {
            "configuredLevel": "INFO",
            "effectiveLevel": "INFO"
        },
        "cn": {
            "configuredLevel": null,
            "effectiveLevel": "INFO"
        },
        "cn.zwqh": {
            "configuredLevel": null,
            "effectiveLevel": "INFO"
        },
        "cn.zwqh.springboot": {
            "configuredLevel": null,
            "effectiveLevel": "INFO"
        },
        ...
    }
}

mappings

查看所有 URL 映射,即所有 @RequestMapping 路徑的整理列表。

訪問 http://127.0.0.1:8080/actuator/mappings 返回部分信息如下:

{
    "contexts": {
        "Spring Boot Actuator Demo": {
            "mappings": {
                "dispatcherServlets": {
                    "dispatcherServlet": [
                        {
                            "handler": "ResourceHttpRequestHandler [class path resource [META-INF/resources/], class path resource [resources/], class path resource [static/], class path resource [public/], ServletContext resource [/], class path resource []]",
                            "predicate": "/**/favicon.ico",
                            "details": null
                        },
                        ...
                    ]
                }
            }
        }
    }
}

heapdump

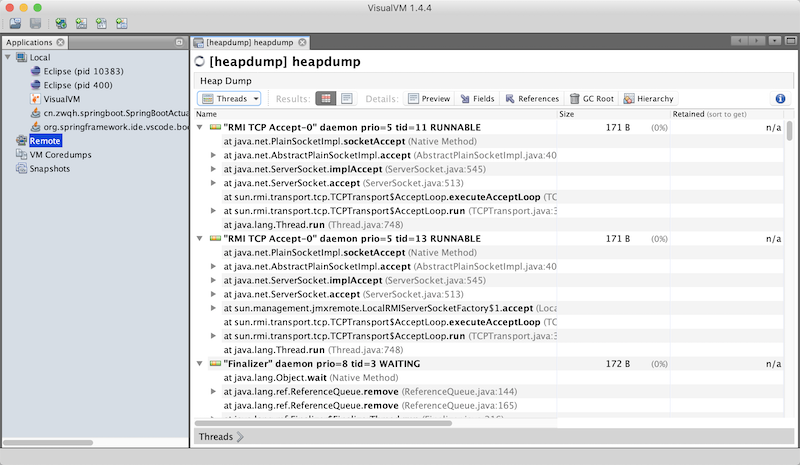
訪問:http://127.0.0.1:8080/actuator/heapdump會自動生成一個 GZip 壓縮的 Jvm 的堆文件 heapdump,我們可以使用 JDK 自帶的 Jvm 監控工具 VisualVM 打開此文件查看。如圖:

VisualVM下載:https://visualvm.github.io/download.html

threaddump

獲取系統線程的轉儲信息,主要展示了線程名、線程ID、線程的狀態、是否等待鎖資源等信息。在工作中,我們可以通過查看線程的情況來排查相關問題。

訪問 http://127.0.0.1:8080/actuator/threaddump 返回部分信息如下:

{
    "threads": [
        {
            "threadName": "DestroyJavaVM",
            "threadId": 40,
            "blockedTime": -1,
            "blockedCount": 0,
            "waitedTime": -1,
            "waitedCount": 0,
            "lockName": null,
            "lockOwnerId": -1,
            "lockOwnerName": null,
            "inNative": false,
            "suspended": false,
            "threadState": "RUNNABLE",
            "stackTrace": [
            ],
            "lockedMonitors": [
            ],
            "lockedSynchronizers": [
            ],
            "lockInfo": null
        },
        ...
    ]
}

shutdown

開啟可以接口關閉 Spring Boot 應用,要使用這個功能需要做如下配置:

management.endpoint.shutdown.enabled=true

可以通過 post(僅支持 post) 請求訪問 http://127.0.0.1:8080/actuator/shutdown 關閉應用。

metrics

訪問 http://127.0.0.1:8080/actuator/metrics 可以獲取系統度量指標信息項如下:

{
    "names": [
        "jvm.memory.max",
        "jvm.threads.states",
        "jvm.gc.pause",
        "http.server.requests",
        "process.files.max",
        "jvm.gc.memory.promoted",
        "system.load.average.1m",
        "jvm.memory.used",
        "jvm.gc.max.data.size",
        "jvm.memory.committed",
        "system.cpu.count",
        "logback.events",
        "tomcat.global.sent",
        "jvm.buffer.memory.used",
        "tomcat.sessions.created",
        "jvm.threads.daemon",
        "system.cpu.usage",
        "jvm.gc.memory.allocated",
        "tomcat.global.request.max",
        "tomcat.global.request",
        "tomcat.sessions.expired",
        "jvm.threads.live",
        "jvm.threads.peak",
        "tomcat.global.received",
        "process.uptime",
        "tomcat.sessions.rejected",
        "process.cpu.usage",
        "tomcat.threads.config.max",
        "jvm.classes.loaded",
        "jvm.classes.unloaded",
        "tomcat.global.error",
        "tomcat.sessions.active.current",
        "tomcat.sessions.alive.max",
        "jvm.gc.live.data.size",
        "tomcat.threads.current",
        "process.files.open",
        "jvm.buffer.count",
        "jvm.buffer.total.capacity",
        "tomcat.sessions.active.max",
        "tomcat.threads.busy",
        "process.start.time"
    ]
}

對應訪問 names 中的指標,可以查看具體的指標信息。如訪問 http://127.0.0.1:8080/actuator/metrics/jvm.memory.used 返回信息如下:

{
    "name": "jvm.memory.used",
    "description": "The amount of used memory",
    "baseUnit": "bytes",
    "measurements": [
        {
            "statistic": "VALUE",
            "value": 1.16828136E8
        }
    ],
    "availableTags": [
        {
            "tag": "area",
            "values": [
                "heap",
                "nonheap"
            ]
        },
        {
            "tag": "id",
            "values": [
                "Compressed Class Space",
                "PS Survivor Space",
                "PS Old Gen",
                "Metaspace",
                "PS Eden Space",
                "Code Cache"
            ]
        }
    ]
}

示例代碼

參考文檔

https://docs.spring.io/spring-boot/docs/2.2.1.RELEASE/reference/html/production-ready-features.html

非特殊說明,本文版權歸 所有,轉載請註明出處.

原文標題:Spring Boot 2.X(十六):應用監控之 Spring Boot Actuator 使用及配置

原文地址:

如果文章對您有幫助,請掃碼關注下我的公眾號,文章持續更新中…

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※教你寫出一流的銷售文案?
go中的數據結構-切片slice

1. 部分基本類型

  go中的類型與c的相似,常用類型有一個特例:byte類型,即字節類型,長度為,默認值是0;

1 bytes = [5]btye{'h', 'e', 'l', 'l', 'o'}

  變量bytes的類型是[5]byte,一個由5個字節組成的數組。它的內存表示就是連起來的5個字節,就像C的數組。

1.1 字符串

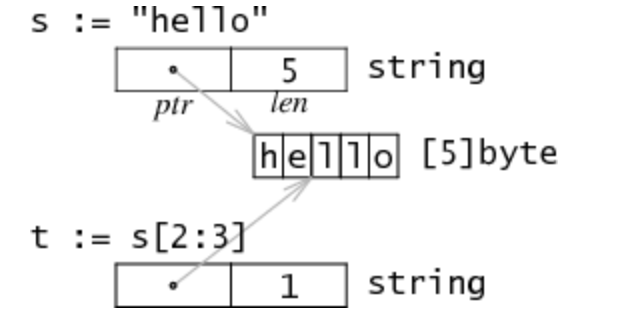
  字符串在Go語言內存模型中用一個2字長(64位,32位內存布局方式下)的數據結構表示。它包含一個指向字符串數據存儲地方的指針,和一個字符串長度數據如下圖:

  s是一個string類型的字符串,因為string類型不可變,對於多字符串共享同一個存儲數據是安全的。切分操作str[i:j]會得到一個新的2字長結構t,一個可能不同的但仍指向同一個字節序列(即上文說的存儲數據)的指針和長度數據。所以字符串切分不涉及內存分配或複製操作,其效率等同於傳遞下標。

1.2 數組

  數組是內置(build-in)類型,是一組同類型數據的集合,它是值類型,通過從0開始的下標索引訪問元素值。數組類型定義了長度和元素類型。如, [4]int 類型表示一個四個整數的數組,其長度是固定的,長度是數組類型的一部分( [4]int 和 [5]int 是完全不同的類型)。 數組可以以常規的索引方式訪問,表達式 s[n] 訪問數組的第 n 個元素。數組不需要顯式的初始化;數組的零值是可以直接使用的,數組元素會自動初始化為其對應類型的零值。

1  var a [4]int
2  a[0] = 1
3  i := a[0]
4  // i == 1
5  // a[2] == 0, int 類型的零值
6 [5] int {1,2}  //長度為5的數組,其元素值依次為:1,2,0,0,0 。在初始化時沒有指定初值的元素將會賦值為其元素類型int的默認值0,string的默認值是"" 
7 [...] int {1,2,3,4,5}  //長度為5的數組,其長度是根據初始化時指定的元素個數決定的 
8 [5] int { 2:1,3:2,4:3}  //長度為5的數組,key:value,其元素值依次為:0,0,1,2,3。在初始化時指定了2,3,4索引中對應的值:1,2,3 
9 [...] int {2:1,4:3}  //長度為5的數組,起元素值依次為:0,0,1,0,3。由於指定了最大索引4對應的值3,根據初始化的元素個數確定其長度為5賦值與使用

  Go的數組是值語義。一個數組變量表示整個數組,它不是指向第一個元素的指針(不像 C 語言的數組)。 當一個數組變量被賦值或者被傳遞的時候,實際上會複製整個數組。 (為了避免複製數組,你可以傳遞一個指向數組的指針,但是數組指針並不是數組。) 可以將數組看作一個特殊的struct,結構的字段名對應數組的索引,同時成員的數目固定。

b := [2]string{"Penn", "Teller"}
b := [...]string{"Penn", "Teller"}

  這兩種寫法, b 都是對應 [2]string 類型。

2. 切片slice 

2.1 結構

  切片類型的寫法是[]T ,T是切片元素的類型。和數組不同的是,切片類型並沒有給定固定的長度。切片的字面值和數組字面值很像,不過切片沒有指定元素個數,切片可以通過數組來初始化,也可以通過內置函數make()初始化。

letters := []string{"a", "b", "c", "d"}   //直接初始化切片,[]表示是切片類型,{"a", "b", "c", "d"},初始化值依次是a,b,c,d.其cap=len=4
s := letters [:]  //初始化切片s,是數組letters的引用(a slice referencing the storage of x)
func make([]T, len, cap) []T    //使用內置函數 make 創建
s :=make([]int,len,cap)    //通過內置函數make()初始化切片s,[]int 標識為其元素類型為int的切片
s := arr[startIndex:endIndex]   //將arr中從下標startIndex到endIndex-1 下的元素創建為一個新的切片
s := arr[startIndex:]   //缺省endIndex時將表示一直到arr的最後一個元素
s := arr[:endIndex]   //缺省startIndex時將表示從arr的第一個元素開始
s1 := s[startIndex:endIndex]   //通過切片s初始化切片s1

  slice可以從一個數組或一個已經存在的slice中再次聲明。slice通過array[i:j]來獲取,其中i是數組的開始位置,j是結束位置,但不包含array[j],它的長度是j-i。

1 var ar = [10]byte{'a','b','c','d','e','f','g','h','i','j'}   // 聲明一個含有10個元素元素類型為byte的數組
2 var a, b []byte  // 聲明兩個含有byte的slice
3 a = ar[2:5]  //現在a含有的元素: ar[2]、ar[3]和ar[4]
4  
5 // b是數組ar的另一個slice
6 b = ar[3:5]// b的元素是:ar[3]和ar[4]

  一個slice是一個數組某個部分的引用。在內存中它是一個包含三個域的結構體:指向slice中第一個元素的指針ptr,slice的長度數據len,以及slice的容量cap。長度是下標操作的上界,如x[i]中i必須小於長度。容量是分割操作的上界,如x[i:j]中j不能大於容量。slice在Go的運行時庫中就是一個C語言動態數組的實現,在$GOROOT/src/pkg/runtime/runtime.h中定義:

struct    Slice
{    // must not move anything
    byte*    array;        // actual data
    uintgo    len;        // number of elements
    uintgo    cap;        // allocated number of elements
};

  數組的slice會創建一份新的數據結構,包含一個指針,一個指針和一個容量數據。如同分割一個字符串,分割數組也不涉及複製操作,它只是新建了一個結構放置三個數據。如下圖:

  示例中,對[]int{2,3,5,7,11}求值操作會創建一個包含五個值的數組,並設置x的屬性來描述這個數組。分割表達式x[1:3]不重新分配內存數據,只寫了一個新的slice結構屬性來引用相同的存儲數據。上例中,長度為2–只有y[0]和y[1]是有效的索引,但是容量為4–y[0:4]是一個有效的分割表達式。

  因為slice分割操作不需要分配內存,也沒有通常被保存在堆中的slice頭部,這種表示方法使slice操作和在C中傳遞指針、長度對一樣廉價。

2.2 擴容

  其實slice在Go的運行時庫中就是一個C語言動態數組的實現,要增加切片的容量必須創建一個新的、更大容量的切片,然後將原有切片的內容複製到新的切片。在對slice進行append等操作時,可能會造成slice的自動擴容。其擴容時的大小增長規則是:

  • 如果新的大小是當前大小2倍以上,則大小增長為新大小
  • 否則循環以下操作:如果當前大小小於1024,按每次2倍增長,否則每次按當前大小1/4增長。直到增長的大小超過或等於新大小。

  下面的例子將切片 s 容量翻倍,先創建一個2倍 容量的新切片 t ,複製 s 的元素到 t ,然後將 t 賦值給 s : 

t := make([]byte, len(s), (cap(s)+1)*2) // +1 in case cap(s) == 0
for i := range s {
        t[i] = s[i]
}
s = t

  循環中複製的操作可以由 copy 內置函數替代,返回複製元素的數目。此外, copy 函數可以正確處理源和目的切片有重疊的情況。

一個常見的操作是將數據追加到切片的尾部。必要的話會增加切片的容量,最後返回更新的切片:

func AppendByte(slice []byte, data ...byte) []byte {
    m := len(slice)
    n := m + len(data)
    if n > cap(slice) { // if necessary, reallocate
        // allocate double what's needed, for future growth.
        newSlice := make([]byte, (n+1)*2)
        copy(newSlice, slice)
        slice = newSlice
    }
    slice = slice[0:n]
    copy(slice[m:n], data)
    return slice
}

  Go提供了一個內置函數 append,也實現了這樣的功能。

func append(s []T, x ...T) []T
//append 函數將 x 追加到切片 s 的末尾,並且在必要的時候增加容量。
a := make([]int, 1)
// a == []int{0}
a = append(a, 1, 2, 3)
// a == []int{0, 1, 2, 3}

  如果是要將一個切片追加到另一個切片尾部,需要使用 ... 語法將第2個參數展開為參數列表。

a := []string{"John", "Paul"}
b := []string{"George", "Ringo", "Pete"}
a = append(a, b...) // equivalent to "append(a, b[0], b[1], b[2])"
// a == []string{"John", "Paul", "George", "Ringo", "Pete"}

  由於切片的零值 nil 用起來就像一個長度為零的切片,我們可以聲明一個切片變量然後在循環 中向它追加數據:

// Filter returns a new slice holding only
// the elements of s that satisfy fn()
func Filter(s []int, fn func(int) bool) []int {
    var p []int // == nil
    for _, v := range s {
        if fn(v) {
            p = append(p, v)
        }
    }
    return p
}

3. 使用切片需要注意的陷阱

  切片操作並不會複製底層的數組。整個數組將被保存在內存中,直到它不再被引用。 有時候可能會因為一個小的內存引用導致保存所有的數據。

  如下, FindDigits 函數加載整個文件到內存,然後搜索第一個連續的数字,最後結果以切片方式返回。

var digitRegexp = regexp.MustCompile("[0-9]+")

func FindDigits(filename string) []byte {
    b, _ := ioutil.ReadFile(filename)
    return digitRegexp.Find(b)
}

  這段代碼的行為和描述類似,返回的 []byte 指向保存整個文件的數組。因為切片引用了原始的數組, 導致 GC 不能釋放數組的空間;只用到少數幾個字節卻導致整個文件的內容都一直保存在內存里。要修復整個問題,可以將需要的數據複製到一個新的切片中:

func CopyDigits(filename string) []byte {
    b, _ := ioutil.ReadFile(filename)
    b = digitRegexp.Find(b)
    c := make([]byte, len(b))
    copy(c, b)
    return c
}

  使用 append 實現一個更簡潔的版本:

    8  func CopyDigitRegexp(filename string) []byte {
    7     b,_ := ioutil.ReadFile(filename)
    6     b = digitRefexp.Find(b)
    5     var c []intb
    4    // for _,v := range b{
    3         c =append(c, b)
    2     //}
    1     return c
    0  }

4. make和new

Go有兩個數據結構創建函數:make和new,也是兩種不同的內存分配機制。

make和new的基本的區別是new(T)返回一個*T,返回的是一個指針,指向分配的內存地址,該指針可以被隱式地消除引用)。而make(T, args)返回一個普通的T。通常情況下,T內部有一些隱式的指針。所以new返回一個指向已清零內存的指針,而make返回一個T類型的結構。更詳細的區別在後面內存分配的學習里研究。

5. 數組和切片的區別

  • 數組長度不能改變,初始化后長度就是固定的;切片的長度是不固定的,可以追加元素,在追加時可能使切片的容量增大。
  • 結構不同,數組是一串固定數據,切片描述的是截取數組的一部分數據,從概念上說是一個結構體。
  • 初始化方式不同,如上。另外在聲明時的時候:聲明數組時,方括號內寫明了數組的長度或使用...自動計算長度,而聲明slice時,方括號內沒有任何字符。
  • unsafe.sizeof的取值不同,unsafe.sizeof(slice)返回的大小是切片的描述符,不管slice里的元素有多少,返回的數據都是24。unsafe.sizeof(arr)的值是在隨着arr的元素的個數的增加而增加,是數組所存儲的數據內存的大小。

  unsafe.sizeof總是在編譯期就進行求值,而不是在運行時,這意味着,sizeof的返回值可以賦值給常量。  在編譯期求值,還意味着可以獲得數組所佔的內存大小,因為數組總是在編譯期就指明自己的容量,並且在以後都是不可變的。

  unsafe.sizeof(string)時大小始終是16,不論字符串的len有多大,sizeof始終返回16,這是因為字符串類型對應一個結構體,該結構體有兩個域,第一個域是指向該字符串的指針,第二個域是字符串的長度,每個域佔8個字節,但是並不包含指針指向的字符串的內容。

6. nil

  按照Go語言規範,任何類型在未初始化時都對應一個零值:布爾類型是false,整型是0,字符串是””,而指針,函數,interface,slice,channel和map的零值都是nil。

interface

  一個interface在沒有進行初始化時,對應的值是nil。也就是說var v interface{},此時v就是一個nil。在底層存儲上,它是一個空指針。與之不同的情況是,interface值為空。比如:

1 var v *T
2 var i interface{}
3 i = v

  此時i是一個interface,它的值是nil,但它自身不為nil。

string

  string的空值是””,它是不能跟nil比較的。即使是空的string,它的大小也是兩個機器字長的。slice也類似,它的空值並不是一個空指針,而是結構體中的指針域為空,空的slice的大小也是三個機器字長的。

channel

  channel跟string或slice有些不同,它在棧上只是一個指針,實際的數據都是由指針所指向的堆上面。

  跟channel相關的操作有:初始化/讀/寫/關閉。channel未初始化值就是nil,未初始化的channel是不能使用的。下面是一些操作規則:

  • 讀或者寫一個nil的channel的操作會永遠阻塞。
  • 讀一個關閉的channel會立刻返回一個channel元素類型的零值。
  • 寫一個關閉的channel會導致panic。

map

  map也是指針,實際數據在堆中,未初始化的值是nil。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※新北清潔公司,居家、辦公、裝潢細清專業服務

通俗地說邏輯回歸【Logistic regression】算法(二)sklearn邏輯回歸實戰

前情提要:

上一篇主要介紹了邏輯回歸中,相對理論化的知識,這次主要是對上篇做一點點補充,以及介紹sklearn 邏輯回歸模型的參數,以及具體的實戰代碼。

1.邏輯回歸的二分類和多分類

上次介紹的邏輯回歸的內容,基本都是基於二分類的。那麼有沒有辦法讓邏輯回歸實現多分類呢?那肯定是有的,還不止一種。

實際上二元邏輯回歸的模型和損失函數很容易推廣到多元邏輯回歸。比如總是認為某種類型為正值,其餘為0值。

舉個例子,要分類為A,B,C三類,那麼就可以把A當作正向數據,B和C當作負向數據來處理,這樣就可以用二分類的方法解決多分類的問題,這種方法就是最常用的one-vs-rest,簡稱OvR。而且這種方法也可以方便得推廣到其他二分類模型中(當然其他算法可能有更好的多分類辦法)。

另一種多元邏輯回歸的方法是Many-vs-Many(MvM),它會選擇一部分類別的樣本和另一部分類別的樣本來做邏輯回歸二分類。

聽起來很不可思議,但其實確實是能辦到的。比如數據有A,B,C三個分類。

我們將A,B作為正向數據,C作為負向數據,訓練出一個分模型。再將A,C作為正向數據,B作為負向數據,訓練出一個分類模型。最後B,C作為正向數據,C作為負向數據,訓練出一個模型。

通過這三個模型就能實現多分類,當然這裏只是舉個例子,實際使用中有其他更好的MVM方法。限於篇幅這裏不展開了。

MVM中最常用的是One-Vs-One(OvO)。OvO是MvM的特例。即每次選擇兩類樣本來做二元邏輯回歸。

對比下兩種多分類方法,通常情況下,Ovr比較簡單,速度也比較快,但模型精度上沒MvM那麼高。MvM則正好相反,精度高,但速度上比不過Ovr。

2.邏輯回歸的正則化

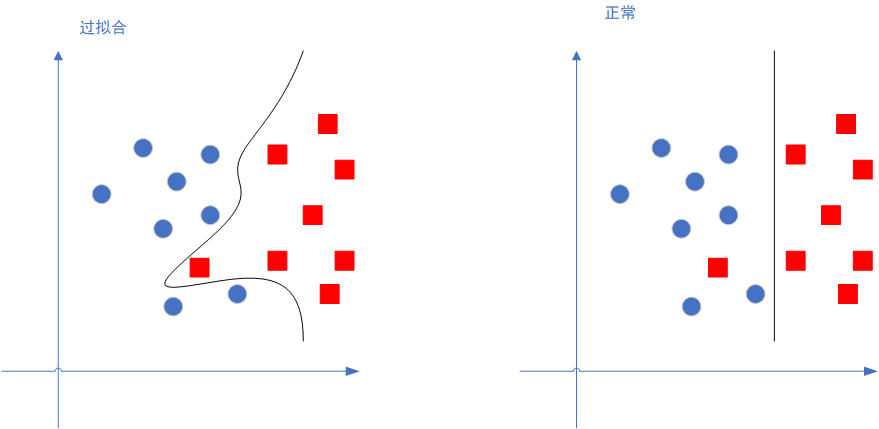
所謂正則化,其目的是為了減弱邏輯回歸模型的精度,難道模型的準確度不是越高越好嘛?看看下面這張圖就明白了:

左邊那個圖就是過擬合的情況,過擬合其實就是模型的精度太過高了,它能非常好得匹配訓練集的數據,但一旦有新的數據,就會表現得很差。

而我們要的非過擬合的模型是,精度可以差一些,但泛化性能,也就是對新的數據的識別能力,要比較好。

正則化就是減弱模型精度,提高泛化效果的這個東西。

3.sklearn各個參數

def LogisticRegression(penalty='l2', 
                                    dual=False, 
                                    tol=1e-4, 
                                    C=1.0,
                                    fit_intercept=True, 
                                    intercept_scaling=1, 
                                    class_weight=None,
                                    random_state=None, 
                                    solver='warn', 
                                    max_iter=100,
                                    multi_class='warn', 
                                    verbose=0, 
                                    warm_start=False, 
                                    n_jobs=None,
                                    l1_ratio=None
                                    )
跟線性回歸一比,邏輯回歸的參數那還真是多啊,不過我們一個一個來看看參數都是什麼意思吧。                                 

- dual:對偶或者原始方法,布爾類型,默認為False。Dual只適用於正則化相為l2的‘liblinear’的情況,通常樣本數大於特徵數的情況下,默認為False。

- tol:停止迭代求解的閾值,單精度類型,默認為1e-4。

- C:正則化係數的倒數,必須為正的浮點數,默認為 1.0,這個值越小,說明正則化效果越強。換句話說,這個值越小,越訓練的模型更泛化,但也更容易欠擬合。

- fit_intercept:是否要使用截距(在決策函數中使用截距),布爾類型,默認為True。

- intercept_scaling:官方解釋比較模糊,我說下個人理解。浮點型,默認值是1.0。這個參數僅在“solver”參數(下面介紹)為“liblinear”“fit_intercept ”參數為True的時候生效。作用是給特徵向量添加一個常量,這個常量就是intercept_scaling。比如原本的向量是[x],那麼添加后就變成[x,intercept_scaling]。

- class_weight:分類權重,可以是一個dict(字典類型),也可以是一個字符串"balanced"字符串。默認是None,也就是不做任何處理,而"balanced"則會去自動計算權重,分類越多的類,權重越低,反之權重越高。也可以自己輸出一個字典,比如一個 0/1 的二元分類,可以傳入{0:0.1,1:0.9},這樣 0 這個分類的權重是0.1,1這個分類的權重是0.9。這樣的目的是因為有些分類問題,樣本極端不平衡,比如網絡攻擊,大部分正常流量,小部分攻擊流量,但攻擊流量非常重要,需要有效識別,這時候就可以設置權重這個參數。

- random_state:設置隨機數種子,可以是int類型和None,默認是None。當"solver"參數為"sag"和"liblinear"的時候生效。

- verbose:輸出詳細過程,int類型,默認為0(不輸出)。當大於等於1時,輸出訓練的詳細過程。僅當"solvers"參數設置為"liblinear"和"lbfgs"時有效。

- warm_start:設置熱啟動,布爾類型,默認為False。若設置為True,則以上一次fit的結果作為此次的初始化,如果"solver"參數為"liblinear"時無效。

- max_iter:最大迭代次數,int類型,默認-1(即無限制)。注意前面也有一個tol迭代限制,但這個max_iter的優先級是比它高的,也就如果限制了這個參數,那是不會去管tol這個參數的。

OK,上述就是對一些比較簡略的參數的說明,但是還有幾個重要的參數沒講到,這是因為這幾個參數我覺得需要單獨拎出來講一講。

sklearn邏輯回歸參數 –penalty

正則化類型選擇,字符串類型,可選’l1’,’l2’,’elasticnet’和None,默認是’l2’,通常情況下,也是選擇’l2’。這個參數的選擇是會影響到參數’solver’的選擇的,下面會介紹。

其中’l1’和’l2’。分別對應L1的正則化和L2的正則化,’elasticnet’則是彈性網絡(這玩意我也不大懂),默認是L2的正則化。

在調參時如果主要的目的只是為了解決過擬合,一般penalty選擇L2正則化就夠了。但是如果選擇L2正則化發現還是過擬合,即預測效果差的時候,就可以考慮L1正則化。另外,如果模型的特徵非常多,我們希望一些不重要的特徵係數歸零,從而讓模型係數稀疏化的話,也可以使用L1正則化。

penalty參數的選擇會影響我們損失函數優化算法的選擇。即參數solver的選擇,如果是L2正則化,那麼4種可選的算法{‘newton-cg’,‘lbfgs’,‘liblinear’,‘sag’}都可以選擇。但是如果penalty是L1正則化的話,就只能選擇‘liblinear’了。這是因為L1正則化的損失函數不是連續可導的,而{‘newton-cg’,‘lbfgs’,‘sag’}這三種優化算法時都需要損失函數的一階或者二階連續導數。而‘liblinear’並沒有這個依賴。最後還有一個’elasticnet’,這個只有solver參數為’saga’才能選。

sklearn邏輯回歸參數 –solver

優化算法參數,字符串類型,一個有五種可選,分別是”newton-cg”,”lbfgs”,”liblinear”,”sag”,”saga。默認是”liblinear”。分別介紹下各個優化算法:

  • a) liblinear:使用了開源的liblinear庫實現,內部使用了坐標軸下降法來迭代優化損失函數。
  • b) lbfgs:擬牛頓法的一種,利用損失函數二階導數矩陣即海森矩陣來迭代優化損失函數。
  • c) newton-cg:也是牛頓法家族的一種,利用損失函數二階導數矩陣即海森矩陣來迭代優化損失函數。
  • d) sag:即隨機平均梯度下降,是梯度下降法的變種,和普通梯度下降法的區別是每次迭代僅僅用一部分的樣本來計算梯度,適合於樣本數據多的時候。
    在優化參數的選擇上,官方是這樣建議的:
  • e)saga:優化的,無偏估計的sag方法。(‘sag’ uses a Stochastic Average Gradient descent, and ‘saga’ uses its improved, unbiased version named SAGA.)
    對小的數據集,可以選擇”liblinear”,如果是大的數據集,比如說大於10W的數據,那麼選擇”sag”和”saga”會讓訓練速度更快。

對於多分類問題,只有newton-cg,sag,saga和lbfgs能夠處理多項損失(也就是MvM的情況,還記得上面說到的多分類嘛?),而liblinear僅處理(OvR)的情況。啥意思,就是用liblinear的時候,如果是多分類問題,得先把一種類別作為一個類別,剩餘的所有類別作為另外一個類別。一次類推,遍歷所有類別,進行分類。

這個的選擇和正則化的參數也有關係,前面說到”penalty”參數可以選擇”l1″,”l2″和None。這裏’liblinear’是可以選擇’l1’正則和’l2’正則,但不能選擇None,’newton-cg’,’lbfgs’,’sag’和’saga’這幾種能選擇’l2’或no penalty,而’saga’則能選怎’elasticnet’正則。好吧,這部分還是挺繞的。

歸納一下吧,二分類情況下,數據量小,一般默認的’liblinear’的行,數據量大,則使用’sag’。多分類的情況下,在數據量小的情況下,追求高精度,可以用’newton-cg’或’lbfgs’以’MvM’的方式求解。數據量一大還是使用’sag’。

當然實際情況下還是要調參多次才能確定參數,這裏也只能給些模糊的建議。

sklearn邏輯回歸參數 –multi_class

multi_class參數決定了我們分類方式的選擇,有 ovr和multinomial兩個值可以選擇,默認是 ovr。
ovr即前面提到的one-vs-rest(OvR),而multinomial即前面提到的many-vs-many(MvM)。如果是二元邏輯回歸,ovr和multinomial並沒有任何區別,區別主要在多元邏輯回歸上。

4.sklearn實例

實例這部分,就直接引用sklearn官網的,使用邏輯回歸對不同種類的鳶尾花進行分類的例子吧。

import numpy as np
import matplotlib.pyplot as plt
from sklearn import linear_model, datasets

# 加載鳶尾花數據
iris = datasets.load_iris()
# 只採用樣本數據的前兩個feature,生成X和Y
X = iris.data[:, :2]  
Y = iris.target

h = .02  # 網格中的步長

# 新建模型,設置C參數為1e5,並進行訓練
logreg = linear_model.LogisticRegression(C=1e5)
logreg.fit(X, Y)

# 繪製決策邊界。為此我們將為網格 [x_min, x_max]x[y_min, y_max] 中的每個點分配一個顏色。
x_min, x_max = X[:, 0].min() - .5, X[:, 0].max() + .5
y_min, y_max = X[:, 1].min() - .5, X[:, 1].max() + .5
xx, yy = np.meshgrid(np.arange(x_min, x_max, h), np.arange(y_min, y_max, h))
Z = logreg.predict(np.c_[xx.ravel(), yy.ravel()])

# 將結果放入彩色圖中
Z = Z.reshape(xx.shape)
plt.figure(1, figsize=(4, 3))
plt.pcolormesh(xx, yy, Z, cmap=plt.cm.Paired)

# 將訓練點也同樣放入彩色圖中
plt.scatter(X[:, 0], X[:, 1], c=Y, edgecolors='k', cmap=plt.cm.Paired)
plt.xlabel('Sepal length')
plt.ylabel('Sepal width')

plt.xlim(xx.min(), xx.max())
plt.ylim(yy.min(), yy.max())
plt.xticks(())
plt.yticks(())

plt.show()

運行上面那段代碼會有如下的結果:

可以看到,已將三種類型的鳶尾花都分類出來了。

小結

邏輯回歸算是比較簡單的一種分類算法,而由於簡單,所以也比較適合初學者初步接觸機器學習算法。學習了之後,對後面一些更複雜的機器學習算法,諸如Svm,或更高級的神經網絡也能有一個稍微感性的認知。

而實際上,Svm可以看作是邏輯回歸的更高級的演化。而從神經網絡的角度,邏輯回歸甚至可以看作一個最初級,最淺層的神經網絡。

邏輯回歸就像是金庸小說裏面,獨孤九劍的第一式,最為簡單,卻又是其他威力極大的招式的基礎,其他的招式都又第一式演化而出。

夯實基礎,才能砥礪前行。

以上~

參考文章:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開

※幫你省時又省力,新北清潔一流服務好口碑

HtmlSpanner 使用小結 — 安卓解析html

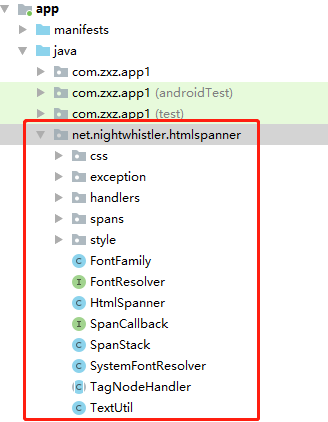
如何利用 HtmlSpanner解析 HTML格式 的字符串:

1. GitHub 下載HtmlSpanner項目 https://github.com/NightWhistler/HtmlSpanner

2. 最好是直接放在java目錄下在,這樣不需要改引用的包路徑

3.  引入需要的依賴包

    implementation 'net.sourceforge.htmlcleaner:htmlcleaner:2.21'
    implementation 'com.osbcp:cssparser:1.7'

  4. 使用方法:

 // 頁面上用於展示 html格式的文本布局
 TextView textView = findViewById(R.id.htmlSpanner);
 // 直接 new一個 HtmlSpanner對象
 HtmlSpanner htmlSpanner = new HtmlSpanner(); // 格式化
 // 解析 html得到 spannable對象
 Spannable spannable1 = htmlSpanner.fromHtml("<span style='color:red'>html格式的文字1</span>");
 // 显示到 TextView上
 textView.setText(spannable1);

 5. 在使用中遇到的問題——當富文本中顏色格式是rgb格式,解析失敗


 解決思路:

  1. 首先我們解析的是style=’color:rgb(0,255,255)’ 這種格式,於是看源碼覺得 CSSCompiler 這個類很有問題

  2. 找與顏色相關的於是就找到了 parseCSSColor( String colorString ) 這個方法,看起來就是轉換顏色用的

  3. 源碼的寫法如下:(是沒有對於rgb格式的算法,所以不能解析就很合理啦)


   4. 想法修改:( 遇到 0rgb格式就先處理成我們的 hex格式,這樣不就完美了嘛 )

  5. 工具類代碼如下:

package com.xxx.xxx.xxx;

public class ColorUtil {

     /**
     * rgb 格式的顏色轉 hex格式顏色
     * @param rgb
     * @return
     */
    public static String rgb2hex(String rgb) {
        int r = 0;
        int g = 0;
        int b = 0;
        int left = rgb.indexOf("(");
        int right = rgb.indexOf(")");
        if (left > -1 && right > -1 && right > left) {
            String substring = rgb.substring(left + 1, right);
            String[] split = substring.split(",");
            if (split.length == 3){
                r = Integer.valueOf(split[0].trim());
                g = Integer.valueOf(split[1].trim());
                b = Integer.valueOf(split[2].trim());
            }
        }
        String rFString, rSString, gFString, gSString,
                bFString, bSString, result;
        int red, green, blue;
        int rred, rgreen, rblue;
        red = r / 16;
        rred = r % 16;
        if (red == 10) rFString = "A";
        else if (red == 11) rFString = "B";
        else if (red == 12) rFString = "C";
        else if (red == 13) rFString = "D";
        else if (red == 14) rFString = "E";
        else if (red == 15) rFString = "F";
        else rFString = String.valueOf(red);

        if (rred == 10) rSString = "A";
        else if (rred == 11) rSString = "B";
        else if (rred == 12) rSString = "C";
        else if (rred == 13) rSString = "D";
        else if (rred == 14) rSString = "E";
        else if (rred == 15) rSString = "F";
        else rSString = String.valueOf(rred);

        rFString = rFString + rSString;

        green = g / 16;
        rgreen = g % 16;

        if (green == 10) gFString = "A";
        else if (green == 11) gFString = "B";
        else if (green == 12) gFString = "C";
        else if (green == 13) gFString = "D";
        else if (green == 14) gFString = "E";
        else if (green == 15) gFString = "F";
        else gFString = String.valueOf(green);

        if (rgreen == 10) gSString = "A";
        else if (rgreen == 11) gSString = "B";
        else if (rgreen == 12) gSString = "C";
        else if (rgreen == 13) gSString = "D";
        else if (rgreen == 14) gSString = "E";
        else if (rgreen == 15) gSString = "F";
        else gSString = String.valueOf(rgreen);

        gFString = gFString + gSString;

        blue = b / 16;
        rblue = b % 16;

        if (blue == 10) bFString = "A";
        else if (blue == 11) bFString = "B";
        else if (blue == 12) bFString = "C";
        else if (blue == 13) bFString = "D";
        else if (blue == 14) bFString = "E";
        else if (blue == 15) bFString = "F";
        else bFString = String.valueOf(blue);

        if (rblue == 10) bSString = "A";
        else if (rblue == 11) bSString = "B";
        else if (rblue == 12) bSString = "C";
        else if (rblue == 13) bSString = "D";
        else if (rblue == 14) bSString = "E";
        else if (rblue == 15) bSString = "F";
        else bSString = String.valueOf(rblue);
        bFString = bFString + bSString;
        result = "#" + rFString + gFString + bFString;
        return result;
    }
}


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

深入理解計算機系統 — 信息的表示和處理

1. 信息的存儲

    大多數計算機使用 8 位的塊,或者字節,作為最小的尋址內存單位,而非訪問內存中單獨的位,機器級程序將內存視為一個非常大的字節數組,稱為 虛擬內存 ,內存的每個字節都用一個唯一的数字標識,稱為它的 地址 。以 C 語言的指針為例,指針使用時指向某一個存儲塊的首字節的 虛擬地址 ,C 編譯器將指針和其類型信息結合起來,這樣即可以根據指針的類型,生成不同的機器級代碼來訪問存儲在指針所指向位置處的值。每個程序對象可以簡單視為一個字節塊,而程序本身就是一個字節序列。

1.1 十六進製表示法

    一個字節由 8 位組成。用二進製表示即 00000000 ~ 11111111 。十進製表示為 0 ~ 255 。由於兩者表示要麼過於冗餘,要麼轉換不遍,因此通常使用十六進制來表示一個字節。這幾種進制的轉換在此就不多說了。

1.2 字數據大小

    每台計算機都會有一個字長(此處字長非字節長度),指明 指針數據的標稱大小(nominal size),因為虛擬地址是以這樣的一個字來進行編碼的,所以字長決定的最重要的一個系統參數即是虛擬地址空間的最大大小。 對於一個字長為 w 位的機器而言,虛擬地址的範圍為 0 ~ (2 ^w )- 1 ,程序最多訪問 2 ^ w 個字節。以 32 位機器為例,32位字長限制虛擬地址空間為 (2 ^32) -1 ,程序最多訪問 2 ^ 32 個字節,大約為 4 x 10^9 字節,即4 GB ( 根據 2 ^ 10 (1024) 約等於 10 ^ 3 (1000) ,可以得到 2 ^ 32 =  4 * 2^30 = 4 * 10 ^ 9 ) 。64位機器的限制虛擬地址空間為 16 EB。大約為 1.84 x 10 ^9 。

1.3 尋址和字節順序

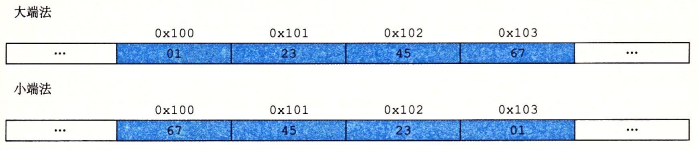
    對於跨越多個字節的對象,我們必須建立兩個規則:這個對象的地址是什麼以及在內存中如何排列這些字節。在幾乎所有的機器上,多字節對象都被存儲為連續的字節序列,對象的地址為這個字節序列中最小的字節地址。以 int 類型為例,假定int 大小為32 位,有變量 int x = 0x01234567 。若 x 的地址為 0x100 ,則 x 的 4 個字節將被存儲在 0x100 , 0x101 , 0x102, 0x103 的位置,此時 4個字節的值分別為 0x01, 0x23, 0x45, 0x67,那麼在內存中的排列順序有如下兩種情況,

  • 大端法:最高有效字節放在最前面的方式稱為大端法,即將一個数字的最高位字節放在最小的字節地址。
  • 小端法:最低有效字節放在最前面的方式稱為小端法,即將一個数字的最低位字節放在最小的字節地址。

  以上面的 x 為例,x 的最高位字節是 0x01 ,將其放在最小的字節地址即 0x100。x 的最低位字節為 0x67 ,將其放在最小的字節地址 0x100 。即大小端對應高低位字節。對於我們來說,機器的字節順序是完全不可見的,我們大部分情況下也無需關心其字節順序,但是在不同類型的機器之間通過網絡傳遞二進制數據的時候,如小端法機器傳送數據給大端法機器時,接受方接收到的字節序會變成反序,為了避免這種問題的產生,發送方和接收方都需要遵循一個網絡規則,發送方將二進制數據轉換成網絡標準,接收方再將這個網絡標準的字節序轉換成自己的字節序。此外,我們在閱讀機器級代碼的時候,可能會出現如下的情況:

  暫時忽略這條指令的意義,可以看到左邊6個字節分別為 01 05 43 0b 20 00 ,而右邊的指令中的地址為 0x200b43,可以看到從左邊的第三個字節開始,43 0b 20 是右邊指令地址的倒序,因此在閱讀這種機器級代碼的時候,也需要注意字節序的問題。此外還存在一種情況。如下圖所示。

    我們可以看到, show_bytes 這個函數可以打印出 start 指針指向的地址開始的 len 個字節內容,且不受字節序的影響,那麼它是如何做到的呢?在 show_int 函數中,可以看到它將 參數 x 的地址強制類型轉換為了 byte_pointer , 即 unsigned char * 。通過強制類型轉換的 start 指針指向的仍是 x 的最低字節地址,但是其類型改變了,通過其類型編譯器會認為該指針指向的對象大小為 1 個字節,此時將該指針進行 ++ 操作可以得到順延下一個字節的內容,從而得到對應的整個對象的字節序列中每個字節的內容而不受字節序影響。

1.4 字符串

    在C語言中,字符串被編碼為一個以 null (其值為0 )字符結尾的字符數組。每個字符都有某個標準編碼來表示,最常見的則是 ASCII 字符碼。假如我們調用 show_bytes(“12345”, 6),那麼會輸出 31 32 33 34 35 00 。可以看到最後打印出了一個終止符,所以通常 C 字符串的長度為實際字符串長度 + 1。 在C 標準庫中的 strlen 函數可以傳入一個字符串得出其長度,這裏的長度即是實際長度,不包含終止符。

2. 整數表示

    在本章節中,介紹了編碼整數的兩種不同的方式,一種只能表示非負數,另一種則能夠表示負數,正數和零。接下來逐一進行介紹。

2.1 整型數據類型

    C語言中,整數有多種數據類型,如下圖所示,此外可以通過加上 unsigned 符號來限定該數據類型為非負數。這些數據類型有的是根據機器的字長(32位和64位)決定其實際最大值和最小值的範圍。我們可以看到,圖中最小值和最大值的取值範圍是不對稱的,負數的取值範圍比正數大一,當我們考慮如何表現負數時,會看到為什麼會這樣。

    關於無符號整數的編碼,其實與普通的十進制正數轉換成二進制沒有什麼區別,假設字長 w = 32 位,轉換后大於 32 位的数字將被捨去。這裏主要介紹一下關於有符號数字的編碼,通常計算機使用的編碼錶示方式為 補碼 ,在這個表示方式中,將字的最高有效位(即符號位)表示為負權,權重為 – 2^(w-1) ,當 w 位的值為 1 時表示為負數,反之為正數。以 -1 為例,-1 的補碼為1111 1111  …. …. 1111 ,即 -2^31 + 2^30 + … + 2^0 = -1 ,通常我們看到一個負數想要直接將其使用補碼錶示還是有些不方便的,因此我們可以先使用原碼錶示,所謂原碼和普通的十進制數轉二進制數沒有區別,只不過最高位用來表示符號位,然後再求其反碼,即符號位不變,其餘位取反加 1,就可以得到這個負數的補碼了,還是以 -1 舉例, -1 的原碼為 1000 0000 …. 0001 ,其反碼的值為 1111 1111 …. 1111 ,與 -1 的補碼值是相同的。而正數的補碼為其本身,不需要做這種轉換。

    那麼為什麼要使用補碼這種表示方式呢,首先,二進制補碼可以使正負數相加時仍然採用正常加法的邏輯,不需要做特殊的處理,此外,如果不採用補碼錶示,採用原碼的表示方法,那麼會出現幾個問題,正負零的存在,以及提高了減法的計算複雜度,而補碼可以十分簡單的計算正負數相加,只需求出兩者的補碼對其進行加法,更多關於補碼的解釋可以參考  。

PS: 為什麼正負數補碼相加會得到正確的結果,這裏個人的見解是:由於補碼最高位為負權,而正數與負數補碼相加相當於正數去抵消這個負權。比如 -16 的補碼為 1111 …. 1111 0000,加上正數 1,由於正數的補碼為本身,所以等價於 -16 + 1  == (-2^31 + 2^30 + … + 2^4 ) +  2^ 0 ,相當於多了一個 2^0 的正權去抵消其最高位的負權。

2.2 有符號數和無符號數之間的轉換

    C語言允許各種不同的数字類型之間進行強制類型轉換, 如 int x= -1 ; unsigned y = (unsigned) x ; 此時會將 x 的值強制類型轉換成 unsigned 類型然後賦值給 y ,那麼此時 y 的值是多少呢?可以通過打印兩者的十六進制值來看有什麼區別。下面為 test.c 的代碼:

int main()

{

int x = -1;

unsigned y = (unsigned) x;

printf(“%x \n”, x);

printf(“%x \n”, x);

return 0;

}

此處為編譯后可執行文件的輸出結果:

ffffffff
ffffffff

可以看到, x 和 y 的十六進制值是相同的,這也說明了,強制類型轉換並不會改變數據底層的位表示,只是改變了解釋位模式的方式。我們可以利用 printf 的指示符進一步驗證這個結果,使用 %d (有符號十進制), %u (無符號十進制), 來打印 x 和 y 的值。以下是代碼:

int main()

{

int x = 1;

unsigned y = (unsigned) x;

printf(“x format d = %d , format u = %u \n”, x, x);

printf(“y format d = %d , format u = %u \n”, y, y);

return 0;

}

這是編譯后可執行文件的對應輸出:

x format d = -1 , format u = 4294967295
y format d = -1 , format u = 4294967295

 我們可以看到,我們使用指示符控制了解釋這些位的方式,得到的結果是一致的。

2.3 整數運算

 關於整數的運算,主要就是加減乘除四種運算,補碼的加減乘除都比較簡單明了,這裏主要說一下除法的舍入問題,首先,我們先確認下 C 語言中的舍入方式,在 C 語言中,浮點數被賦值給整數時,小數位總是被捨去,如

float f = 1.5;

int x = f ;

printf(“%d \n “, x);

輸出的結果為:

1

當 f 為負數時結果又是如何呢 ?

float f = -1.5 ;

int x = f;

printf(“%d \n”, x);

輸出的結果為:

-1

因此我們可以認為,C語言的舍入方式為向零舍入。接下來看一下除法的舍入問題。此處先以除以 2 的冪的無符號除法為例,

上圖表示 12340 / 2^k 的時候二進制與對應的十進制的表示,此時的舍入是完全沒有問題的。接下來看下除以 2 的冪的有符號除法。

    當k = 4 的時候,-12340 / 2^ 4 == -771.25,此時的正確舍入值應該為 -771,但是其卻舍入成了 -772。這是因為,如果我們單純使用右移來進行除法的時候,其舍入方式為向下舍入,即總是往更小值的方向舍入,在沒有小數位的情況下是正確的,但是如果有小數位的時候,如 -771.25 舍入為 -772, 771.25 舍入為 771。而C語言的舍入方式為向零舍入,即總是往靠近零的值舍入,如 771.25 舍入為 771, -771.25 舍入為 -771。那麼如何實現這種舍入方式呢。當被除數為負數時,我們可以通過加上一個偏置值來糾正這種不正確的舍入方式。

    我們可以觀察一下上圖的有符號除法例子,可以發現,當右移的 k 位單獨拿出來,不為 0 的時候,會導致舍入結果不正確,這是因為,k 位的值不為 0 的時候,表示該結果有小數,所以可以通過 (x + (1 << k) – 1) >> k 得到正確的結果, (1 << k) – 1 可以獲得 k 個 1,x 加上 k 個 1 可以使捨去的 k 位不為 0 時產生進位,x >> k 的結果加一,從而使舍入正確。

關於整數的表示和運算,個人覺得有幾個需要關注的點,一是溢出問題,由於使用有限的位來表示整數,所以當数字過大的時候可能會產生溢出,溢出的位會被捨去,但是有符號數的溢出可能會使符號位被置反,如 0111 1111 …. 1111 + 1 = 1000 0000 …. 0000,0111 1111 …. 1111 為 INT_MAX , INT_MAX + 1 會得到 INT_MIN。此外,無符號數與有符號數進行比較的時候,會使有符號數強制轉換為無符號數,如果有以下循環代碼:

for(size_t i = 10; i >= 0 ; i–);

由於 i 為無符號數,當 i == 0 的時候,判斷還會繼續循環下去, 0 – 1  = -1 , -1 的補碼錶示為 1111 1111 …. 1111 , 剛好是無符號數的最大值,會導致死循環。因此也需要注意一切與無符號類型數據的運算,以及強制類型轉換可能出現的問題。

3. 浮點數

    終於來到了這一章的重點內容之一(其實感覺這本書哪裡都挺重要的),這裏主要介紹浮點數是如何表示的,並且介紹浮點數舍入的問題(和上面講到的舍入不大一樣),浮點數的表示及其運算標準稱為 IEEE754 標準,初看可能會讓你覺得有些晦澀難懂,但是理解之後會覺得設計的十分巧妙。

3.1 定點表示法

    首先讓我們先看下十進制的浮點數是如何表示的,浮點數的定義與小數點息息相關,定義在小數點左邊的数字的權是 10 的正冪,右邊的数字為 10 的負冪,如 12.34 表示 1 * 10^ 1 + 2 * 10^0 + 3 * 10 ^-1 + 4 * 10 ^ -2 = 12又34/100,同理可以得到二進制的浮點數表示,即定義在小數點左邊的数字的權是 2 的正冪,右邊的数字為 2 的負冪,如 101.11 = 1 * 2^2 + 0 * 2^1 + 1 * 2^0 + 1 * 2^-1 + 1 * 2^-2 。這種浮點數的表示方法是有缺陷的,無法精準的表示特定的数字,以 1/5 為例,可以用 十進制数字 0.2 表示,但是我們無法用二進制數字錶示它,只能近似的表示它,通過增加二進製表示的長度可以提升表示的精度。如下圖所示。

3.2 IEEE754標準

    在前面談到的定點表示法不能有效的表示一個比較大的数字,例如 5 x 2^100 是用 101 後面跟隨 100 個零的位模式,我們希望能夠通過給定 x 和 y 的值來表示如 x * 2 ^y 的数字。IEEE754 標準使用 V = ( – 1)^S * M * 2^E 的形式來表示一個數。

  • 符號(Sign): S 決定這個數是負數(S = 1 )還是正數 (S = 0), 對於數值為 0 的符號位做特殊解釋。
  • 尾數(Significand): M 是一個二進制小數,範圍為 1 ~ 2 – e , 或者是 0 ~ 1 – e 。
  • 階碼(Exponent): E 的作用是對浮點數進行加權,這個權重是 2 的 E 次冪(E 可能為負數)。

通過將浮點數的位劃分為三個字段,分別對這些值進行編碼:

  • 一個單獨的符號位 S 。
  • k 位的階碼字段 ,exp = e(0) e(1) e(2) … e(k-1) ,exp 用來編碼階碼 E。
  • n 位的小数字段 ,   frac = f(n-1) … f(1) f(0) ,frac 用來編碼尾數 M。

下圖是該標準下封裝到字中的兩種最常見的格式。

此外,根據階碼值(exp),被編碼的值可以分為下圖幾種情況(階碼值全為 0 ,階碼值全為 1 , 階碼值不全為 0 也不全為 1):

接下來對這幾種格式進行一一介紹~:

  • 規格化浮點數 : 這是最普遍的情況,當 exp 的值不全為 0 也不全為 1 時,就屬於這種情況,這種情況下,階碼值 E = e – bias ,其中 e 為無符號數,即 exp 的值,而 bias 是一個 2^(k-1) – 1 的偏置值(單精度為 127,雙精度為 1023),而小数字段 frac 被解釋為描述小數值 f ,其中 0 <= f < 1,其二進製表示為 0.f(n-1)…f(1)f(0) 的数字,也就是二進制小數點在最高有效位的左邊的形式。尾數定義為 M = 1 + f 。 有時候這種方式也叫做 隱含 1 開頭的表示(implied leading  1),因為這種定義我們可以把 M 看成一個二進製表示為 1.f(n-1) … f(1)f(0) 的数字。既然我們總是能調整階碼 E ,使得尾數 M 在範圍 1 <= M < 2 之中(假設沒有溢出),那麼這樣可以節約一個位,因為第一位總是為 1 。
  • 非規格化浮點數 : 當 exp 的值全為 0 的時候,所表示的浮點數為非規格化類型,E = 1 – bias ,而尾數的值為 M = f 。不含開頭的 1 。非規格化有兩種用途,首先它提供了表示  0 的方法,因為規格化數使得 M >=  1,所以不能表示 0 ,另外非規格化數另一個功能則是表示那些非常接近於 0.0 的數,他們提供了一種屬性,稱為逐漸溢出,其中,可能的數值均勻分佈接近於 0.0 。
  • 特殊值 : 最後一類數值是指當階碼全為 1 的時候出現的。當小數域全為 0 時,表示為無窮大/小,當我們將兩個非常大的數相乘時,或者除以零時,無窮能夠表示溢出的結果。當小數域為非 0 時,結果為 NaN(Not a Number),一些運算的結果不能為實數或者無窮時,會返回 NaN,比如 根號 -1 ,或者 無窮減無窮。此外,在某些應用中也可以用來表示未初始化的數值。

    首先,通過一個字長為 8 位的例子,來看一下IEEE754標準實際上使用時是如何表示的 :

    上圖為展示了假定 w = 8 的字長,k = 4 的階碼位以及 n = 3 的小數位。偏移量為 2 ^ ( k -1 ) -1 = (2 ^ 3) – 1 = 7。圖中分別展示了非規格化數,規格化數以及特殊值是如何編碼的,以及如何結合在一起表示 V = (2^E) * M。我們可以看到,從最大非規格化數到最小規格化數,其值的轉變十分平滑,從 7/512 到 8/512 。這得益於非規格化數的 E 定義為 1 – bias ,最大的非規格化數的階碼值 E 與最小的規格化數的階碼值 E 是相等的,兩者唯一的區別在於 M 值,規格化數尾數 M = 1 + f ,而非規格化的尾數 M = f ,因為非規格化值是用於表示 [0, 1] 區間的小數的,當 f 達到最大值時, f 接近於 1 ,此時最大的非規格化數再進一位,小數 M 只能表示為 1 ,因為此時限制於 f 的位數,沒有比 f 大又比 1 小的小數值 ,進位後轉換成了規格化數,此時 f = 0 , 在階碼值 E 相等的情況下,讓規格化的 M = 1 + f 恰好可以使兩者進行平滑的轉換。

    假如我們使非規格化數的 E = 0 – bias = -7 ,那麼會導致最大非規格化數和最小規格化數的粒度過大,兩者的值分別為 7/1024 和 8/512 。這種定義可以彌補非規格化數的尾數沒有隱含的 1 。通過上述的例子,我們可以發現 ,假如我們把上述的例子按無符號整數表示的話,會發現它的值是有序上升的,這不是偶然的,IEEE 格式如此設計就是為了浮點數能夠使用整數排序函數進行排序。

    通過練習將整數值轉換為浮點數值形式對理解浮點數很有用,以 12345(十進制) 為例,其二進製表示為 1100 0000 1110 01 . 0  ,通過將小數點左移 13 位得到 1.1000000111001 * 2^13 ,我們丟棄開頭的 1 (這裏的 1 就是規格化數隱含的 1),構造小数字段,當 f 不足 23 位的時候,往後填充 0 ,即 M = 1 + f = 1 + 1000 0001 1100 1000 0000 000 ,當 f 大於 23 位的時候,f 多出的位會被捨棄(這裏可以看出浮點數的兩個性質,以 int 類型和 float 類型舉例,當 int 值 大於 2^24 的時候,int 轉換成 float 兩者很有可能值會不相等,因為多出的部分被捨棄了,二是 float 可以表示的數值遠遠大於 int 類型,V =  (-1 ^ S)  * M * 2^E  ,E 最高可以等於 127 ,float 的最大值為 (2^127) * (1 + f),而 int 最大值為 (2^31) -1。

3.3 舍入

    浮點數的舍入方式有四種,分別是向上舍入,向下舍入,向零舍入,向偶數舍入。下圖是幾種舍入方式的例子 :

偶數舍入是浮點數默認的舍入方式,可以看到,向偶數舍入時,當小數值為中間值時,會使最低有效数字總為偶數,如 2.5 和 1.5 都舍入為 2 。為什麼使用向偶數舍入呢,假設我們採用向上舍入,用這種方法舍入一組數值,會在計算這些值的平均值中引入統計偏差。我們採用這種方式舍入得到的平均值總是比這些數本身的平均值要略高一些,反之向下舍入亦然,向偶數舍入則可以使在 50% 的時間內向上舍入,50% 的時間內向下舍入。

4. 小結

    • 計算機將信息編碼為位(bit),通常組織成字節序列,有不同的編碼方式來表示整數,實數和字符串。不同的計算機模型在編碼数字和多字節數據中的字節順序時使用不同的約定。
    • 絕大部分機器使用補碼來編碼整數。對於浮點數使用 IEEE754 標準來編碼。
    • 在進行對無符號和有符號整數進行強制類型轉換時,底層的位模式是不變的。(浮點數與整數轉換則會進行 改變,如 float f = 1.25; int x = f; 此時打印兩者的十六進制值,可以分別輸出為 f = 92463258 ,x = 1 )
    • 由於編碼的長度有限,當超出表示範圍時,有限長度會引起數值溢出,如 x * x 可能會得到負數。當浮點數非常接近於 0.0 時,轉換成 0 時也會產生下溢。
    • 使用補碼運算 ~x + 1 = -x (不適用於 INT_MIN) 。可以通過 (2^k) – 1 生成一個 k 位的掩碼。
    • 浮點數不具備結合率,因為可能發生溢出或者舍入,從而失去精度。如(le20 * le20) * le-20 = 正無窮,而 le20 * (le20 * le-20) = le20 。此外也不具備分配性,如 le20 * (le20 – le20) = 0.0 ,而 le20 * le20 – le20 * le20 = NaN。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※教你寫出一流的銷售文案?
計算機專業學生常用網站

這篇文章我很早之前就想寫了,但奈何一直沒有合適的時間,也不知道應該怎樣去表達。現在自己是一個大三的學生,學習了兩年多的計算機,我不知道自己算不算合格,和那些初中就搞OI,大三實習就業的大佬們相比,我肯定是不行的,但我覺得我這兩年的學習經歷應該更符合一般的計算機專業學生,可能也更有參考性吧。這裏我主要來分享一下我常用的一些網站,這些網站主要受眾還是學生,關注我的人也大都是同輩的學生,大家可以在評論區討論或補充,這篇博客也會一直更新下去。

1、Google

這個網站就不必說了吧,我一直有一種觀點,搜索資料對計算機專業的學生來說是一種特別重要的能力。現在的世界有那麼多的知識,誰也不可能都學會,咱們的大腦只是一個cache級別的存儲器,想要獲得知識、解決問題,學會使用搜索引擎必不可少!至於google被牆,使用百度也是可以的,但注意對信息要辨偽存真,多去比較。

2、GitHub

這是開發者最為重要的網站了吧,代碼託管網站。大概大一下學期才注意到這個網站,各種資源應有盡有,想要什麼輪子,上去搜就好了。最令我震驚的是,裏面還有這種網課學習資料,清華北大浙大等名校計算機專業所有課程的資料都齊全,互聯網時代真的太便利了。


3、Stack Overflow

這個網站也挺有用的,之前我查找一個C++問題,搜索的結果都答不到點上,在上面看到一個美國人的回答才如夢初醒。後來學習過程中遇到什麼 問題,上去搜一下,大概率能搜到答案。缺點也很明顯,這是一個英語網站,大多數回答都是英文,所以要有點計算機英語基礎。至於同樣英文網站的GitHub,我只能感慨,中國程序員太厲害了,中文項目一點也不少,可以說GitHub的繁榮離不開中國人。


4、bilibili

或許最初這隻是一個二次元愛好者的聚集地,但現在B站應該可以算是中國的油管吧。我在高中的時候入坑B站,申請會員需要答題就讓我知道這個網站應該有着素質不錯的成員,果然這裡有無數的沙雕網友逗你開心,逛B站也成為我高中生活最快樂的消遣方式。上了大學才發現B站也可以是一個學習網站,甚至中央都表揚過B站。跟着B站上的老師學了高數、離散數學、線性代數、数字邏輯、概率論、計算機組成原理等等,我一般是在課堂上聽一遍,課後快到考試周了跟着B站視頻複習一遍,很穩!我愛死這個小破站了!(不知道大家有沒有注意到我博客背景上的22娘33娘呢?)

5、中國大學MOOC

 這個算是對B站的一個補充的,其實B站中很多學校視頻都是轉自這裏的,很多網課其實是侵權的,隨時可能被B站刪掉。雖然有些可能需要收費,但也還能接受,至少質量有保證。

6、知乎

為什麼要提知乎這個看似很無關的網站?我主要覺得這是一個可以用來增長見識的社區,雖然現在它一點點的向微博貼吧靠近。

知乎給自己的定位是一個網絡問答社區,用戶在上面分享自己專業的知識和見解。據統計與計算機相關的用戶佔總用戶很大的比重,可能大家上班都在划水?

也有很多大佬直接在知乎上寫博客,平時逛逛知乎把握一下行業動向,聽聽大佬吹吹牛逼,很有意思。

7、博客園

這個我立足的地方嘛!我在大一下學期才正式開始寫博客,最初搞ACM,師哥讓我們寫題解,最開始真是不愛寫,隨便應付一下,後來發現寫博客的樂趣,一發不可收拾。每天逛一下,大家說話有好聽,我超級喜歡這裏!

8、CSDN

這應該是一個邁不過去的話題吧,我也不想修什麼優越感,但是現在CSDN真的令人不悅呀!以前聽前輩講起過它的輝煌,現在也不能說是沒落了吧,依舊有龐大的用戶,龐大的流量,也算是一個成功的商業網址了。CSDN最讓我反感的一點是找一個問題,所有答案都是一樣複製粘貼過來的,很難找到原作者,問轉載者詳情問題詳情也無法解答。我不反對轉載別人的博客,畢竟要有開源精神,但轉載能不能貼一個原文鏈接?還有積分下載,講一個笑話,我一個師哥發了一份JDK1.8,5C幣下載,一年賺了300C幣,這是在收智商稅?

9、MSDN 我告訴你

這個網站可就厲害了,整合了許多微軟原版系統鏡像,精簡版本,純凈系統。

10、W3school

就算不去學前端,我們多多少少也要了解一些相關知識,這也算是一個前端只是比較全的網站了。

11、鳩摩搜索

能夠搜索出不少專業書,配合pandownload使用吧,這個給出pandownload的使用說明

12、菜鳥教程


 有朋友提到了菜鳥教程,這裏也來介紹一下吧,個人覺得菜鳥教程提供了較為全面,系統詳細的教程,廣告少,界面簡約,聽說網站最早是一個人寫的,很牛。這個網站挺適合新手做輔助,個人覺得就是有些教程獲取不到較為詳細的說明。

13、各大OJ

北京大學

杭州电子科技大學

浙江大學

codeforces

PAT

藍橋杯


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※新北清潔公司,居家、辦公、裝潢細清專業服務

Java I/O體系從原理到應用,這一篇全說清楚了

本文介紹操作系統I/O工作原理,Java I/O設計,基本使用,開源項目中實現高性能I/O常見方法和實現,徹底搞懂高性能I/O之道

基礎概念

在介紹I/O原理之前,先重溫幾個基礎概念:

  • (1) 操作系統與內核

操作系統:管理計算機硬件與軟件資源的系統軟件
內核:操作系統的核心軟件,負責管理系統的進程、內存、設備驅動程序、文件和網絡系統等等,為應用程序提供對計算機硬件的安全訪問服務

  • 2 內核空間和用戶空間

為了避免用戶進程直接操作內核,保證內核安全,操作系統將內存尋址空間劃分為兩部分:
內核空間(Kernel-space),供內核程序使用
用戶空間(User-space),供用戶進程使用
為了安全,內核空間和用戶空間是隔離的,即使用戶的程序崩潰了,內核也不受影響

  • 3 數據流

計算機中的數據是基於隨着時間變換高低電壓信號傳輸的,這些數據信號連續不斷,有着固定的傳輸方向,類似水管中水的流動,因此抽象數據流(I/O流)的概念:指一組有順序的、有起點和終點的字節集合,

抽象出數據流的作用:實現程序邏輯與底層硬件解耦,通過引入數據流作為程序與硬件設備之間的抽象層,面向通用的數據流輸入輸出接口編程,而不是具體硬件特性,程序和底層硬件可以獨立靈活替換和擴展

I/O 工作原理

1 磁盤I/O

典型I/O讀寫磁盤工作原理如下:

tips: DMA:全稱叫直接內存存取(Direct Memory Access),是一種允許外圍設備(硬件子系統)直接訪問系統主內存的機制。基於 DMA 訪問方式,系統主內存與硬件設備的數據傳輸可以省去CPU 的全程調度

值得注意的是:

  • 讀寫操作基於系統調用實現
  • 讀寫操作經過用戶緩衝區,內核緩衝區,應用進程並不能直接操作磁盤
  • 應用進程讀操作時需阻塞直到讀取到數據

2 網絡I/O

這裏先以最經典的阻塞式I/O模型介紹:

tips:recvfrom,經socket接收數據的函數

值得注意的是:

  • 網絡I/O讀寫操作經過用戶緩衝區,Sokcet緩衝區
  • 服務端線程在從調用recvfrom開始到它返回有數據報準備好這段時間是阻塞的,recvfrom返回成功后,線程開始處理數據報

Java I/O設計

1 I/O分類

Java中對數據流進行具體化和實現,關於Java數據流一般關注以下幾個點:

  • (1) 流的方向
    從外部到程序,稱為輸入流;從程序到外部,稱為輸出流

  • (2) 流的數據單位
    程序以字節作為最小讀寫數據單元,稱為字節流,以字符作為最小讀寫數據單元,稱為字符流

  • (3) 流的功能角色

從/向一個特定的IO設備(如磁盤,網絡)或者存儲對象(如內存數組)讀/寫數據的流,稱為節點流;
對一個已有流進行連接和封裝,通過封裝后的流來實現數據的讀/寫功能,稱為處理流(或稱為過濾流);

2 I/O操作接口

java.io包下有一堆I/O操作類,初學時看了容易搞不懂,其實仔細觀察其中還是有規律:
這些I/O操作類都是在繼承4個基本抽象流的基礎上,要麼是節點流,要麼是處理流

2.1 四個基本抽象流

java.io包中包含了流式I/O所需要的所有類,java.io包中有四個基本抽象流,分別處理字節流和字符流:

  • InputStream
  • OutputStream
  • Reader
  • Writer

2.2 節點流

節點流I/O類名由節點流類型 + 抽象流類型組成,常見節點類型有:

  • File文件
  • Piped 進程內線程通信管道
  • ByteArray / CharArray (字節數組 / 字符數組)
  • StringBuffer / String (字符串緩衝區 / 字符串)

節點流的創建通常是在構造函數傳入數據源,例如:

FileReader reader = new FileReader(new File("file.txt"));
FileWriter writer = new FileWriter(new File("file.txt"));

2.3 處理流

處理流I/O類名由對已有流封裝的功能 + 抽象流類型組成,常見功能有:

  • 緩衝:對節點流讀寫的數據提供了緩衝的功能,數據可以基於緩衝批量讀寫,提高效率。常見有BufferedInputStream、BufferedOutputStream
  • 字節流轉換為字符流:由InputStreamReader、OutputStreamWriter實現
  • 字節流與基本類型數據相互轉換:這裏基本數據類型數據如int、long、short,由DataInputStream、DataOutputStream實現
  • 字節流與對象實例相互轉換:用於實現對象序列化,由ObjectInputStream、ObjectOutputStream實現

處理流的應用了適配器/裝飾模式,轉換/擴展已有流,處理流的創建通常是在構造函數傳入已有的節點流或處理流:

FileOutputStream fileOutputStream = new FileOutputStream("file.txt");
// 擴展提供緩衝寫
BufferedOutputStream bufferedOutputStream = new BufferedOutputStream(fileOutputStream);
 // 擴展提供提供基本數據類型寫
DataOutputStream out = new DataOutputStream(bufferedOutputStream);

3 Java NIO

3.1 標準I/O存在問題

Java NIO(New I/O)是一個可以替代標準Java I/O API的IO API(從Java 1.4開始),Java NIO提供了與標準I/O不同的I/O工作方式,目的是為了解決標準 I/O存在的以下問題:

  • (1) 數據多次拷貝

標準I/O處理,完成一次完整的數據讀寫,至少需要從底層硬件讀到內核空間,再讀到用戶文件,又從用戶空間寫入內核空間,再寫入底層硬件

此外,底層通過write、read等函數進行I/O系統調用時,需要傳入數據所在緩衝區起始地址和長度
由於JVM GC的存在,導致對象在堆中的位置往往會發生移動,移動後傳入系統函數的地址參數就不是真正的緩衝區地址了

可能導致讀寫出錯,為了解決上面的問題,使用標準I/O進行系統調用時,還會額外導致一次數據拷貝:把數據從JVM的堆內拷貝到堆外的連續空間內存(堆外內存)

所以總共經歷6次數據拷貝,執行效率較低

  • (2) 操作阻塞

傳統的網絡I/O處理中,由於請求建立連接(connect),讀取網絡I/O數據(read),發送數據(send)等操作是線程阻塞的

// 等待連接
Socket socket = serverSocket.accept();

// 連接已建立,讀取請求消息
StringBuilder req = new StringBuilder();
byte[] recvByteBuf = new byte[1024];
int len;
while ((len = socket.getInputStream().read(recvByteBuf)) != -1) {
    req.append(new String(recvByteBuf, 0, len, StandardCharsets.UTF_8));
}

// 寫入返回消息
socket.getOutputStream().write(("server response msg".getBytes()));
socket.shutdownOutput();

以上面服務端程序為例,當請求連接已建立,讀取請求消息,服務端調用read方法時,客戶端數據可能還沒就緒(例如客戶端數據還在寫入中或者傳輸中),線程需要在read方法阻塞等待直到數據就緒

為了實現服務端併發響應,每個連接需要獨立的線程單獨處理,當併發請求量大時為了維護連接,內存、線程切換開銷過大

3.2 Buffer

Java NIO核心三大核心組件是Buffer(緩衝區)、Channel(通道)、Selector

Buffer提供了常用於I/O操作的字節緩衝區,常見的緩存區有ByteBuffer, CharBuffer, DoubleBuffer, FloatBuffer, IntBuffer, LongBuffer, ShortBuffer,分別對應基本數據類型: byte, char, double, float, int, long, short,下面介紹主要以最常用的ByteBuffer為例,Buffer底層支持Java堆內(HeapByteBuffer)或堆外內存(DirectByteBuffer)

堆外內存是指與堆內存相對應的,把內存對象分配在JVM堆以外的內存,這些內存直接受操作系統管理(而不是虛擬機,相比堆內內存,I/O操作中使用堆外內存的優勢在於:

  • 不用被JVM GC線回收,減少GC線程資源佔有
  • 在I/O系統調用時,直接操作堆外內存,可以節省一次堆外內存和堆內內存的複製

ByteBuffer底層堆外內存的分配和釋放基於malloc和free函數,對外allocateDirect方法可以申請分配堆外內存,並返回繼承ByteBuffer類的DirectByteBuffer對象:

public static ByteBuffer allocateDirect(int capacity) {
    return new DirectByteBuffer(capacity);
}

堆外內存的回收基於DirectByteBuffer的成員變量Cleaner類,提供clean方法可以用於主動回收,Netty中大部分堆外內存通過記錄定位Cleaner的存在,主動調用clean方法來回收;
另外,當DirectByteBuffer對象被GC時,關聯的堆外內存也會被回收

tips: JVM參數不建議設置-XX:+DisableExplicitGC,因為部分依賴Java NIO的框架(例如Netty)在內存異常耗盡時,會主動調用System.gc(),觸發Full GC,回收DirectByteBuffer對象,作為回收堆外內存的最後保障機制,設置該參數之後會導致在該情況下堆外內存得不到清理

堆外內存基於基礎ByteBuffer類的DirectByteBuffer類成員變量:Cleaner對象,這個Cleaner對象會在合適的時候執行unsafe.freeMemory(address),從而回收這塊堆外內存

Buffer可以見到理解為一組基本數據類型,存儲地址連續的的數組,支持讀寫操作,對應讀模式和寫模式,通過幾個變量來保存這個數據的當前位置狀態:capacity、 position、 limit:

  • capacity 緩衝區數組的總長度
  • position 下一個要操作的數據元素的位置
  • limit 緩衝區數組中不可操作的下一個元素的位置:limit <= capacity

3.3 Channel

Channel(通道)的概念可以類比I/O流對象,NIO中I/O操作主要基於Channel:
從Channel進行數據讀取 :創建一個緩衝區,然後請求Channel讀取數據
從Channel進行數據寫入 :創建一個緩衝區,填充數據,請求Channel寫入數據

Channel和流非常相似,主要有以下幾點區別:

  • Channel可以讀和寫,而標準I/O流是單向的
  • Channel可以異步讀寫,標準I/O流需要線程阻塞等待直到讀寫操作完成
  • Channel總是基於緩衝區Buffer讀寫

Java NIO中最重要的幾個Channel的實現:

  • FileChannel: 用於文件的數據讀寫,基於FileChannel提供的方法能減少讀寫文件數據拷貝次數,後面會介紹
  • DatagramChannel: 用於UDP的數據讀寫
  • SocketChannel: 用於TCP的數據讀寫,代表客戶端連接
  • ServerSocketChannel: 監聽TCP連接請求,每個請求會創建會一個SocketChannel,一般用於服務端

基於標準I/O中,我們第一步可能要像下面這樣獲取輸入流,按字節把磁盤上的數據讀取到程序中,再進行下一步操作,而在NIO編程中,需要先獲取Channel,再進行讀寫

FileInputStream fileInputStream = new FileInputStream("test.txt");
FileChannel channel = fileInputStream.channel();

tips: FileChannel僅能運行在阻塞模式下,文件異步處理的 I/O 是在JDK 1.7 才被加入的 java.nio.channels.AsynchronousFileChannel

// server socket channel:
ServerSocketChannel serverSocketChannel = ServerSocketChannel.open();
serverSocketChannel.bind(new InetSocketAddress(InetAddress.getLocalHost(), 9091));

while (true) {
    SocketChannel socketChannel = serverSocketChannel.accept();
    ByteBuffer buffer = ByteBuffer.allocateDirect(1024);
    int readBytes = socketChannel.read(buffer);
    if (readBytes > 0) {
        // 從寫數據到buffer翻轉為從buffer讀數據
        buffer.flip();
        byte[] bytes = new byte[buffer.remaining()];
        buffer.get(bytes);
        String body = new String(bytes, StandardCharsets.UTF_8);
        System.out.println("server 收到:" + body);
    }
}

3.4 Selector

Selector(選擇器) ,它是Java NIO核心組件中的一個,用於檢查一個或多個NIO Channel(通道)的狀態是否處於可讀、可寫。實現單線程管理多個Channel,也就是可以管理多個網絡連接

Selector核心在於基於操作系統提供的I/O復用功能,單個線程可以同時監視多個連接描述符,一旦某個連接就緒(一般是讀就緒或者寫就緒),能夠通知程序進行相應的讀寫操作,常見有select、poll、epoll等不同實現

Java NIO Selector基本工作原理如下:

  • (1) 初始化Selector對象,服務端ServerSocketChannel對象
  • (2) 向Selector註冊ServerSocketChannel的socket-accept事件
  • (3) 線程阻塞於selector.select(),當有客戶端請求服務端,線程退出阻塞
  • (4) 基於selector獲取所有就緒事件,此時先獲取到socket-accept事件,向Selector註冊客戶端SocketChannel的數據就緒可讀事件事件
  • (5) 線程再次阻塞於selector.select(),當有客戶端連接數據就緒,可讀
  • (6) 基於ByteBuffer讀取客戶端請求數據,然後寫入響應數據,關閉channel

示例如下,完整可運行代碼已經上傳github(https://github.com/caison/caison-blog-demo):

Selector selector = Selector.open();
ServerSocketChannel serverSocketChannel = ServerSocketChannel.open();
serverSocketChannel.bind(new InetSocketAddress(9091));
// 配置通道為非阻塞模式
serverSocketChannel.configureBlocking(false);
// 註冊服務端的socket-accept事件
serverSocketChannel.register(selector, SelectionKey.OP_ACCEPT);

while (true) {
    // selector.select()會一直阻塞,直到有channel相關操作就緒
    selector.select();
    // SelectionKey關聯的channel都有就緒事件
    Iterator<SelectionKey> keyIterator = selector.selectedKeys().iterator();

    while (keyIterator.hasNext()) {
        SelectionKey key = keyIterator.next();
        // 服務端socket-accept
        if (key.isAcceptable()) {
            // 獲取客戶端連接的channel
            SocketChannel clientSocketChannel = serverSocketChannel.accept();
            // 設置為非阻塞模式
            clientSocketChannel.configureBlocking(false);
            // 註冊監聽該客戶端channel可讀事件,併為channel關聯新分配的buffer
            clientSocketChannel.register(selector, SelectionKey.OP_READ, ByteBuffer.allocateDirect(1024));
        }

        // channel可讀
        if (key.isReadable()) {
            SocketChannel socketChannel = (SocketChannel) key.channel();
            ByteBuffer buf = (ByteBuffer) key.attachment();

            int bytesRead;
            StringBuilder reqMsg = new StringBuilder();
            while ((bytesRead = socketChannel.read(buf)) > 0) {
                // 從buf寫模式切換為讀模式
                buf.flip();
                int bufRemain = buf.remaining();
                byte[] bytes = new byte[bufRemain];
                buf.get(bytes, 0, bytesRead);
                // 這裏當數據包大於byteBuffer長度,有可能有粘包/拆包問題
                reqMsg.append(new String(bytes, StandardCharsets.UTF_8));
                buf.clear();
            }
            System.out.println("服務端收到報文:" + reqMsg.toString());
            if (bytesRead == -1) {
                byte[] bytes = "[這是服務回的報文的報文]".getBytes(StandardCharsets.UTF_8);

                int length;
                for (int offset = 0; offset < bytes.length; offset += length) {
                    length = Math.min(buf.capacity(), bytes.length - offset);
                    buf.clear();
                    buf.put(bytes, offset, length);
                    buf.flip();
                    socketChannel.write(buf);
                }
                socketChannel.close();
            }
        }
        // Selector不會自己從已selectedKeys中移除SelectionKey實例
        // 必須在處理完通道時自己移除 下次該channel變成就緒時,Selector會再次將其放入selectedKeys中
        keyIterator.remove();
    }
}

tips: Java NIO基於Selector實現高性能網絡I/O這塊使用起來比較繁瑣,使用不友好,一般業界使用基於Java NIO進行封裝優化,擴展豐富功能的Netty框架來優雅實現

高性能I/O優化

下面結合業界熱門開源項目介紹高性能I/O的優化

1 零拷貝

零拷貝(zero copy)技術,用於在數據讀寫中減少甚至完全避免不必要的CPU拷貝,減少內存帶寬的佔用,提高執行效率,零拷貝有幾種不同的實現原理,下面介紹常見開源項目中零拷貝實現

1.1 Kafka零拷貝

Kafka基於Linux 2.1內核提供,並在2.4 內核改進的的sendfile函數 + 硬件提供的DMA Gather Copy實現零拷貝,將文件通過socket傳送

函數通過一次系統調用完成了文件的傳送,減少了原來read/write方式的模式切換。同時減少了數據的copy, sendfile的詳細過程如下:

基本流程如下:

  • (1) 用戶進程發起sendfile系統調用
  • (2) 內核基於DMA Copy將文件數據從磁盤拷貝到內核緩衝區
  • (3) 內核將內核緩衝區中的文件描述信息(文件描述符,數據長度)拷貝到Socket緩衝區
  • (4) 內核基於Socket緩衝區中的文件描述信息和DMA硬件提供的Gather Copy功能將內核緩衝區數據複製到網卡
  • (5) 用戶進程sendfile系統調用完成並返回

相比傳統的I/O方式,sendfile + DMA Gather Copy方式實現的零拷貝,數據拷貝次數從4次降為2次,系統調用從2次降為1次,用戶進程上下文切換次數從4次變成2次DMA Copy,大大提高處理效率

Kafka底層基於java.nio包下的FileChannel的transferTo:

public abstract long transferTo(long position, long count, WritableByteChannel target)

transferTo將FileChannel關聯的文件發送到指定channel,當Comsumer消費數據,Kafka Server基於FileChannel將文件中的消息數據發送到SocketChannel

1.2 RocketMQ零拷貝

RocketMQ基於mmap + write的方式實現零拷貝:
mmap() 可以將內核中緩衝區的地址與用戶空間的緩衝區進行映射,實現數據共享,省去了將數據從內核緩衝區拷貝到用戶緩衝區

tmp_buf = mmap(file, len); 
write(socket, tmp_buf, len);

mmap + write 實現零拷貝的基本流程如下:

  • (1) 用戶進程向內核發起系統mmap調用
  • (2) 將用戶進程的內核空間的讀緩衝區與用戶空間的緩存區進行內存地址映射
  • (3) 內核基於DMA Copy將文件數據從磁盤複製到內核緩衝區
  • (4) 用戶進程mmap系統調用完成並返回
  • (5) 用戶進程向內核發起write系統調用
  • (6) 內核基於CPU Copy將數據從內核緩衝區拷貝到Socket緩衝區
  • (7) 內核基於DMA Copy將數據從Socket緩衝區拷貝到網卡
  • (8) 用戶進程write系統調用完成並返回

RocketMQ中消息基於mmap實現存儲和加載的邏輯寫在org.apache.rocketmq.store.MappedFile中,內部實現基於nio提供的java.nio.MappedByteBuffer,基於FileChannel的map方法得到mmap的緩衝區:

// 初始化
this.fileChannel = new RandomAccessFile(this.file, "rw").getChannel();
this.mappedByteBuffer = this.fileChannel.map(MapMode.READ_WRITE, 0, fileSize);

查詢CommitLog的消息時,基於mappedByteBuffer偏移量pos,數據大小size查詢:

public SelectMappedBufferResult selectMappedBuffer(int pos, int size) {
    int readPosition = getReadPosition();
    // ...各種安全校驗
    
    // 返回mappedByteBuffer視圖
    ByteBuffer byteBuffer = this.mappedByteBuffer.slice();
    byteBuffer.position(pos);
    ByteBuffer byteBufferNew = byteBuffer.slice();
    byteBufferNew.limit(size);
    return new SelectMappedBufferResult(this.fileFromOffset + pos, byteBufferNew, size, this);
}

tips: transientStorePoolEnable機制
Java NIO mmap的部分內存並不是常駐內存,可以被置換到交換內存(虛擬內存),RocketMQ為了提高消息發送的性能,引入了內存鎖定機制,即將最近需要操作的CommitLog文件映射到內存,並提供內存鎖定功能,確保這些文件始終存在內存中,該機制的控制參數就是transientStorePoolEnable

因此,MappedFile數據保存CommitLog刷盤有2種方式:

  • 1 開啟transientStorePoolEnable:寫入內存字節緩衝區(writeBuffer) -> 從內存字節緩衝區(writeBuffer)提交(commit)到文件通道(fileChannel) -> 文件通道(fileChannel) -> flush到磁盤
  • 2 未開啟transientStorePoolEnable:寫入映射文件字節緩衝區(mappedByteBuffer) -> 映射文件字節緩衝區(mappedByteBuffer) -> flush到磁盤

RocketMQ 基於 mmap+write 實現零拷貝,適用於業務級消息這種小塊文件的數據持久化和傳輸
Kafka 基於 sendfile 這種零拷貝方式,適用於系統日誌消息這種高吞吐量的大塊文件的數據持久化和傳輸

tips: Kafka 的索引文件使用的是 mmap+write 方式,數據文件發送網絡使用的是 sendfile 方式

1.3 Netty零拷貝

Netty 的零拷貝分為兩種:

  • 1 基於操作系統實現的零拷貝,底層基於FileChannel的transferTo方法
  • 2 基於Java 層操作優化,對數組緩存對象(ByteBuf )進行封裝優化,通過對ByteBuf數據建立數據視圖,支持ByteBuf 對象合併,切分,當底層僅保留一份數據存儲,減少不必要拷貝

2 多路復用

Netty中對Java NIO功能封裝優化之後,實現I/O多路復用代碼優雅了很多:

// 創建mainReactor
NioEventLoopGroup boosGroup = new NioEventLoopGroup();
// 創建工作線程組
NioEventLoopGroup workerGroup = new NioEventLoopGroup();

final ServerBootstrap serverBootstrap = new ServerBootstrap();
serverBootstrap 
     // 組裝NioEventLoopGroup 
    .group(boosGroup, workerGroup)
     // 設置channel類型為NIO類型
    .channel(NioServerSocketChannel.class)
    // 設置連接配置參數
    .option(ChannelOption.SO_BACKLOG, 1024)
    .childOption(ChannelOption.SO_KEEPALIVE, true)
    .childOption(ChannelOption.TCP_NODELAY, true)
    // 配置入站、出站事件handler
    .childHandler(new ChannelInitializer<NioSocketChannel>() {
        @Override
        protected void initChannel(NioSocketChannel ch) {
            // 配置入站、出站事件channel
            ch.pipeline().addLast(...);
            ch.pipeline().addLast(...);
        }
    });

// 綁定端口
int port = 8080;
serverBootstrap.bind(port).addListener(future -> {
    if (future.isSuccess()) {
        System.out.println(new Date() + ": 端口[" + port + "]綁定成功!");
    } else {
        System.err.println("端口[" + port + "]綁定失敗!");
    }
});

3 頁緩存(PageCache)

頁緩存(PageCache)是操作系統對文件的緩存,用來減少對磁盤的 I/O 操作,以頁為單位的,內容就是磁盤上的物理塊,頁緩存能幫助程序對文件進行順序讀寫的速度幾乎接近於內存的讀寫速度,主要原因就是由於OS使用PageCache機制對讀寫訪問操作進行了性能優化:

頁緩存讀取策略:當進程發起一個讀操作 (比如,進程發起一個 read() 系統調用),它首先會檢查需要的數據是否在頁緩存中:

  • 如果在,則放棄訪問磁盤,而直接從頁緩存中讀取
  • 如果不在,則內核調度塊 I/O 操作從磁盤去讀取數據,並讀入緊隨其後的少數幾個頁面(不少於一個頁面,通常是三個頁面),然後將數據放入頁緩存中

頁緩存寫策略:當進程發起write系統調用寫數據到文件中,先寫到頁緩存,然後方法返回。此時數據還沒有真正的保存到文件中去,Linux 僅僅將頁緩存中的這一頁數據標記為“臟”,並且被加入到臟頁鏈表中

然後,由flusher 回寫線程周期性將臟頁鏈表中的頁寫到磁盤,讓磁盤中的數據和內存中保持一致,最後清理“臟”標識。在以下三種情況下,臟頁會被寫回磁盤:

  • 空閑內存低於一個特定閾值
  • 臟頁在內存中駐留超過一個特定的閾值時
  • 當用戶進程調用 sync() 和 fsync() 系統調用時

RocketMQ中,ConsumeQueue邏輯消費隊列存儲的數據較少,並且是順序讀取,在page cache機制的預讀取作用下,Consume Queue文件的讀性能幾乎接近讀內存,即使在有消息堆積情況下也不會影響性能,提供了2種消息刷盤策略:

  • 同步刷盤:在消息真正持久化至磁盤后RocketMQ的Broker端才會真正返回給Producer端一個成功的ACK響應
  • 異步刷盤,能充分利用操作系統的PageCache的優勢,只要消息寫入PageCache即可將成功的ACK返回給Producer端。消息刷盤採用後台異步線程提交的方式進行,降低了讀寫延遲,提高了MQ的性能和吞吐量

Kafka實現消息高性能讀寫也利用了頁緩存,這裏不再展開

參考

《深入理解Linux內核 —— Daniel P.Bovet》

更多精彩,歡迎關注公眾號 分佈式系統架構

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開

※幫你省時又省力,新北清潔一流服務好口碑

Redis 的底層數據結構(壓縮列表)

上一篇我們介紹了 redis 中的整數集合這種數據結構的實現,也談到了,引入這種數據結構的一個很大的原因就是,在某些僅有少量整數元素的集合場景,通過整數集合既可以達到字典的效率,也能使用遠少於字典的內存達到同樣的效果。

我們本篇介紹的壓縮列表,相信你從他的名字里應該也能看出來,又是一個為了節約內存而設計的數據結構,它的數據結構相對於整數集合來說會複雜了很多,但是整數集合只能允許存儲少量的整型數據,而我們的壓縮列表可以允許存儲少量的整型數據或字符串。

這是他們之間的一個區別,下面我們來看看這種數據結構。

一、基本的結構定義

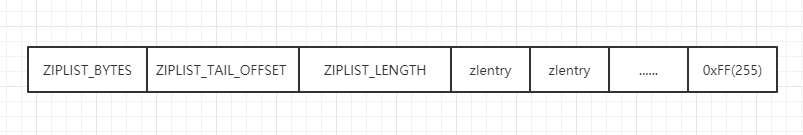
  • ZIPLIST_BYTES:四個字節,記錄了整個壓縮列表總共佔用了多少字節數
  • ZIPLIST_TAIL_OFFSET:四個字節,記錄了整個壓縮列表第一個節點到最後一個節點跨越了多少個字節,通故這個字段可以迅速定位到列表最後一個節點位置
  • ZIPLIST_LENGTH:兩個字節,記錄了整個壓縮列表中總共包含幾個 zlentry 節點
  • zlentry:非固定字節,記錄的是單個節點,這是一個複合結構,我們等下再說
  • 0xFF:一個字節,十進制的值為 255,標誌壓縮列表的結尾

其中,zlentry 在 redis 中確實有着這樣的結構體定義,但實際上這個結構定義了一堆類似於 length 這樣的字段,記錄前一個節點和自身節點佔用的字節數等等信息,用處不多,而我們更傾向於使用這樣的邏輯結構來描述 zlentry 節點。

這種結構在 redis 中是沒有具體結構體定義的,請知悉,網上的很多博客文章都直接描述 zlentry 節點是這樣的一種結構,其實是不準確的。

簡單解釋一下這三個字段的含義:

  • previous_entry_length:每個節點會使用一個或者五個字節來描述前一個節點佔用的總字節數,如果前一個節點佔用的總字節數小於 254,那麼就用一個字節存儲,反之如果前一個節點佔用的總字節數超過了 254,那麼一個字節就不夠存儲了,這裡會用五個字節存儲並將第一個字節的值存儲為固定值 254 用於區分。
  • encoding:壓縮列表可以存儲 16位、32位、64位的整數以及字符串,encoding 就是用來區分後面的 content 字段中存儲於的到底是哪種內容,分別佔多少字節,這個我們等下細說。
  • content:沒什麼特別的,存儲的就是具體的二進制內容,整數或者字符串。

下面我們細說一個 encoding 具體是怎麼存儲的。

主要分為兩種,一種是字符串的存儲格式:

編碼 編碼長度 content類型
00xxxxxx 一個字節 長度小於 63 的字符串
01xxxxxx xxxxxxxx 兩個字節 長度小於 16383 的字符串
10xxxxxx xxxxxxxx xxxxxxxx xxxxxxxx xxxxxxxx 五個字節 長度小於 4294967295 的字符串

content 的具體長度,由編碼除去高兩位剩餘的二進制位表示。

編碼 編碼長度 content類型
11000000 一個字節 int16_t 類型的整數
11010000 一個字節 int32_t 類型的整數
11100000 一個字節 int64_t 類型的整數
11110000 一個字節 24 位有符號整數
11111110 一個字節 8 位有符號整數

注意,整型數據的編碼是固定 11 開頭的八位二進制,而字符串類型的編碼都是非固定的,因為它還需要通過後面的二進制位得到字符串的長度,稍有區別。

這就是壓縮列表的基本的結構定義情況,下面我們通過節點的增刪改查方法源碼實現來看看 redis 中具體的實現情況。

二、redis 的具體源碼實現

1、ziplistNew

我們先來看看壓縮列表初始化的方法實現:

unsigned char *ziplistNew(void) {
    //bytes=2*4+2
    //分配壓縮列表結構所需要的字節數
    //ZIPLIST_BYTES + ZIPLIST_TAIL_OFFSET + ZIPLIST_LENGTH
    unsigned int bytes = ZIPLIST_HEADER_SIZE+1;
    unsigned char *zl = zmalloc(bytes);
    //初始化 ZIPLIST_BYTES 字段
    ZIPLIST_BYTES(zl) = intrev32ifbe(bytes);
    //初始化 ZIPLIST_TAIL_OFFSET
    ZIPLIST_TAIL_OFFSET(zl) = intrev32ifbe(ZIPLIST_HEADER_SIZE);
    //初始化 ZIPLIST_LENGTH 字段
    ZIPLIST_LENGTH(zl) = 0;
    //為壓縮列表最後一個字節賦值 255
    zl[bytes-1] = ZIP_END;
    return zl;
}

2、ziplistPush

接着我們看新增節點的源碼實現:

unsigned char *ziplistPush(unsigned char *zl, unsigned char *s
        ,unsigned int slen, int where) {
    unsigned char *p;
    //找到待插入的位置,頭部或者尾部
    p = (where == ZIPLIST_HEAD) ? ZIPLIST_ENTRY_HEAD(zl) : ZIPLIST_ENTRY_END(zl);
    return __ziplistInsert(zl,p,s,slen);
}

解釋一下 ziplistPush 的幾個入參的含義。

zl 指向一個壓縮列表的首地址,s 指向一個字符串首地址),slen 指向字符串的長度(如果節點存儲的值是整型,存儲的就是整型值),where 指明新節點的插入方式,頭插亦或尾插。

ziplistPush 方法的核心是 __ziplistInsert:

unsigned char *__ziplistInsert(unsigned char *zl, unsigned char *p, unsigned char *s, unsigned int slen) {
    size_t curlen = intrev32ifbe(ZIPLIST_BYTES(zl)), reqlen;
    unsigned int prevlensize, prevlen = 0;
    size_t offset;
    int nextdiff = 0;
    unsigned char encoding = 0;
    long long value = 123456789; 
    zlentry tail;
    //prevlensize 存儲前一個節點長度,本節點使用了幾個字節 1 or 5
    //prelen  存儲前一個節點實際佔用了幾個字節
    if (p[0] != ZIP_END) {
        ZIP_DECODE_PREVLEN(p, prevlensize, prevlen);
    } else {
        unsigned char *ptail = ZIPLIST_ENTRY_TAIL(zl);
        if (ptail[0] != ZIP_END) {
            prevlen = zipRawEntryLength(ptail);
        }
    }
    if (zipTryEncoding(s,slen,&value,&encoding)) {
        //s 指針指向一個整數,嘗試進行一個轉換並得到存儲這個整數佔用了幾個字節
        reqlen = zipIntSize(encoding);
    } else {
        //s 指針指向一個字符串(字符數組),slen 就是他佔用的字節數
        reqlen = slen;
    }
    //當前節點存儲數據佔用 reqlen 個字節,加上存儲前一個節點長度佔用的字節數
    reqlen += zipStorePrevEntryLength(NULL,prevlen);
    //encoding 字段存儲實際佔用字節數
    reqlen += zipStoreEntryEncoding(NULL,encoding,slen);
    //至此,reqlen 保存了存儲當前節點數據佔用字節數和 encoding 編碼佔用的字節數總和
    int forcelarge = 0;
    //當前節點佔用的總字節減去存儲前一個節點字段佔用的字節
    //記錄的是這一個節點的插入會引起下一個節點佔用字節的變化量
    nextdiff = (p[0] != ZIP_END) ? zipPrevLenByteDiff(p,reqlen) : 0;
    if (nextdiff == -4 && reqlen < 4) {
        nextdiff = 0;
        forcelarge = 1;
    }
    //擴容有可能導致 zl 的起始位置偏移,故記錄 p 與 zl 首地址的相對偏差數,事後還原 p 指針指向
    offset = p-zl;
    zl = ziplistResize(zl,curlen+reqlen+nextdiff);
    p = zl+offset;
    if (p[0] != ZIP_END) {
        memmove(p+reqlen,p-nextdiff,curlen-offset-1+nextdiff);
        //把當前節點佔用的字節數存儲到下一個節點的頭部字段
        if (forcelarge)
            zipStorePrevEntryLengthLarge(p+reqlen,reqlen);
        else
            zipStorePrevEntryLength(p+reqlen,reqlen);

        //更新 tail_offset 字段,讓他保存從頭節點到尾節點之間的距離
        ZIPLIST_TAIL_OFFSET(zl) =
            intrev32ifbe(intrev32ifbe(ZIPLIST_TAIL_OFFSET(zl))+reqlen);
        zipEntry(p+reqlen, &tail);
        if (p[reqlen+tail.headersize+tail.len] != ZIP_END) {
            ZIPLIST_TAIL_OFFSET(zl) =
                intrev32ifbe(intrev32ifbe(ZIPLIST_TAIL_OFFSET(zl))+nextdiff);
        }
    } else {
        ZIPLIST_TAIL_OFFSET(zl) = intrev32ifbe(p-zl);
    }
    //是否觸發連鎖更新
    if (nextdiff != 0) {
        offset = p-zl;
        zl = __ziplistCascadeUpdate(zl,p+reqlen);
        p = zl+offset;
    }
    //將節點寫入指定位置
    p += zipStorePrevEntryLength(p,prevlen);
    p += zipStoreEntryEncoding(p,encoding,slen);
    if (ZIP_IS_STR(encoding)) {
        memcpy(p,s,slen);
    } else {
        zipSaveInteger(p,value,encoding);
    }
    ZIPLIST_INCR_LENGTH(zl,1);
    return zl;
}

具體細節我不再贅述,總結一下整個插入節點的步驟。

  1. 計算並得到前一個節點的總長度,並判斷得到當前待插入節點保存前一個節點長度的 previous_entry_length 佔用字節數
  2. 根據傳入的 s 和 slen,計算並保存 encoding 字段內容
  3. 構建節點並將數據寫入節點添加到壓縮列表中

ps:重點要去理解壓縮列表節點的數據結構定義,previous_entry_length、encoding、content 字段,這樣才能比較容易理解節點新增操作的實現。

三、連鎖更新

談到 redis 的壓縮列表,就必然會談到他的連鎖更新,我們先引一張圖:

假設原本 entry1 節點佔用字節數為 211(小於 254),那麼 entry2 的 previous_entry_length 會使用一個字節存儲 211,現在我們新插入一個節點 NEWEntry,這個節點比較大,佔用了 512 個字節。

那麼,我們知道,NEWEntry 節點插入后,entry2 的 previous_entry_length 存儲不了 512,那麼 redis 就會重分配內存,增加 entry2 的內存分配,並分配給 previous_entry_length 五個字節存儲 NEWEntry 節點長度。

看似沒什麼問題,但是如果極端情況下,entry2 擴容四個字節后,導致自身佔用字節數超過 254,就會又觸發后一個節點的內存佔用空間擴大,非常極端情況下,會導致所有的節點都擴容,這就是連鎖更新,一次更新導致大量甚至全部節點都更新內存的分配。

如果連鎖更新發生的概率很高的話,壓縮列表無疑就會是一個低效的數據結構,但實際上連鎖更新發生的條件是非常苛刻的,其一是需要大量節點長度小於 254 連續串聯連接,其二是我們更新的節點位置恰好也導致后一個節點內存擴充更新。

基於這兩點,且少量的連鎖更新對性能是影響不大的,所以這裏的連鎖更新對壓縮列表的性能是沒有多大的影響的,可以忽略,但需要知曉。

同樣的,如果覺得我寫的對你有點幫助的話,順手點一波關注吧,也歡迎加作者微信深入探討,我們逐漸開始走近 redis 比較實用性的相關內容了,盡請關注。

關注公眾不迷路,一個愛分享的程序員。


公眾號回復「1024」加作者微信一起探討學習!


每篇文章用到的所有案例代碼素材都會上傳我個人 github


歡迎來踩!

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

Hibernate一對多、多對一的關係表達

一、關係表達:

1、一對多、多對一表的關係:

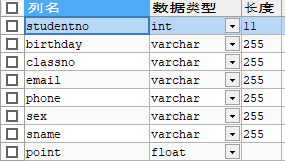
學生表:


  班級表:


 在學生表中,學生的學號是主鍵。在班級表中,班級號是主鍵,因此,學生表的外鍵是classno。因此,班級對應學生是一對多,學生對應班級是多對一。因為,一個班級可以有多個學生,但是一個學生只能在一個班級。

2、對象的一對多、多對一關係:

(1)在Class類中,定義Set集合,表達一對多的關係:


package pers.zhb.domain;
import java.util.HashSet;
import java.util.Set;
public class Class {
    private String classno;
    private String department;
    private String monitor;
    private String classname;
    private Set<Student> classes=new HashSet<Student>();//使用set集合表達一對多關係
    public Class(){
    }
    public Set<Student> getClasses() {
        return classes;
    }
    public void setClasses(Set<Student> classes) {
        this.classes = classes;
    }
    public String getMonitor() {
        return monitor;
    }

    public void setMonitor(String monitor) {
        this.monitor = monitor;
    }

    public String getDepartment() {
        return department;
    }

    public void setDepartment(String department) {
        this.department = department;
    }


    public String getClassname() {
        return classname;
    }

    public void setClassname(String classname) {
        this.classname = classname;
    }
    public String getClassno() {
        return classno;
    }

    public void setClassno(String classno) {
        this.classno = classno;
    }
    @Override
    public String toString() {
        return "Class{" +
                "classno='" + classno + '\'' +
                ", department='" + department + '\'' +
                ", monitor='" + monitor + '\'' +
                ", classname='" + classname + '\'' +
                ", classes=" + classes +
                '}';
    }
}
package pers.zhb.domain;
public class Student {
    private Integer studentno;
    private String sname;
    private String sex;
    private String birthday;
    private String classno;
    private Float point;
    private String phone;
    private String email;
    private Clas aClas;
    public Student(){//無參的構造方法
    }
    public Clas getaClas() {
        return aClas;
    }

    public void setaClas(Clas aClas) {
        this.aClas = aClas;
    }
    @Override
    public String toString() {
        return "Student{" +
                "studentno='" + studentno + '\'' +
                ", sname='" + sname + '\'' +
                ", sex='" + sex + '\'' +
                ", birthday='" + birthday + '\'' +
                ", classno='" + classno + '\'' +
                ", point=" + point +
                ", phone='" + phone + '\'' +
                ", email='" + email + '\'' +
                '}';
    }

    public int getStudentno() {
        return studentno;
    }

    public void setStudentno(int studentno) {
        this.studentno = studentno;
    }

    public String getSname() {
        return sname;
    }

    public void setSname(String sname) {
        this.sname = sname;
    }

    public String getSex() {
        return sex;
    }

    public void setSex(String sex) {
        this.sex = sex;
    }

    public String getBirthday() {
        return birthday;
    }

    public void setBirthday(String birthday) {
        this.birthday = birthday;
    }

    public String getClassno() {
        return classno;
    }

    public void setClassno(String classno) {
        this.classno = classno;
    }

    public float getPoint() {
        return point;
    }

    public void setPoint(float point) {
        this.point = point;
    }

    public String getPhone() {
        return phone;
    }

    public void setPhone(String phone) {
        this.phone = phone;
    }

    public String getEmail() {
        return email;
    }

    public void setEmail(String email) {
        this.email = email;
    }
}


(2)定義學生和班級的關係:


package pers.zhb.domain;
import java.util.HashSet;
import java.util.Set;
public class Clas {
    private String classno;
    private String department;
    private String monitor;
    private String classname;
    private Set<Student> students=new HashSet<Student>();//使用set集合表達一對多關係
    public Clas(){
    }
    public Set<Student> getStudents() {
        return students;
    }
    public void setClasses(Set<Student> students) {
        this.students = students;
    }
    public String getMonitor() {
        return monitor;
    }

    public void setMonitor(String monitor) {
        this.monitor = monitor;
    }

    public String getDepartment() {
        return department;
    }

    public void setDepartment(String department) {
        this.department = department;
    }


    public String getClassname() {
        return classname;
    }

    public void setClassname(String classname) {
        this.classname = classname;
    }
    public String getClassno() {
        return classno;
    }

    public void setClassno(String classno) {
        this.classno = classno;
    }
    @Override
    public String toString() {
        return "Class{" +
                "classno='" + classno + '\'' +
                ", department='" + department + '\'' +
                ", monitor='" + monitor + '\'' +
                ", classname='" + classname + '\'' +
                ",students=" + students +
                '}';
    }
}


3、配置映射文件:

  Class.hbm.xml:

(1)實現一對多的關係映射,即:一個班級對應多個學生:

<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE hibernate-mapping PUBLIC
        "-//Hibernate/Hibernate Mapping DTD 3.0//EN"
        "http://www.hibernate.org/dtd/hibernate-mapping-3.0.dtd">
<hibernate-mapping package="pers.zhb.domain">
    <class name="Clas" table="class">
        <id name="classno" column="classno">
            <generator class="native"></generator>
        </id><!--主鍵-->
        <property name="department" column="department"></property>
        <property name="monitor" column="monitor"></property>
        <property name="classname" column="classname"></property>
        <set name="students" table="student"><!--一對多關係配置-->
        <key column="classno" update="false"></key><!--指定了集合表的外鍵-->
            <one-to-many class="Student"></one-to-many>
        </set>
    </class>
</hibernate-mapping>


<set name="students">

指定映射的存儲學生的集合的名字。

<key column="classesno"></key>

映射的class表的外鍵。

<one-to-many class="Student"></one-to-many>

指定學生的類型。

(2)實現多對一的關係映射,即:多個學生對應一個班級。

<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE hibernate-mapping PUBLIC
        "-//Hibernate/Hibernate Mapping DTD 3.0//EN"
        "http://www.hibernate.org/dtd/hibernate-mapping-3.0.dtd">
<hibernate-mapping package="pers.zhb.domain">
    <class name="Student" table="student">
        <id name="studentno" column="studentno" >
            <generator class="native"></generator>
        </id>
        <property name="birthday" column="birthday"></property>
        <property name="classno" column="classno" insert="false" update="false"></property>
        <property name="email" column="email"></property>
        <property name="phone" column="phone"></property>
        <property name="sex" column="sex"></property>
        <property name="sname" column="sname"></property>
        <property name="point" column="point"></property>
        <many-to-one name="aClas" column="classno" class="Clas"></many-to-one>
    </class>
</hibernate-mapping>


name屬性:映射的班級。

column屬性:映射的班級對象對應的外鍵。

class屬性:指定班級的類型。

4、主配置文件:

<?xml version="1.0" encoding="UTF-8"?>
<!DOCTYPE hibernate-configuration PUBLIC
        "-//Hibernate/Hibernate Configuration DTD 3.0//EN"
        "http://www.hibernate.org/dtd/hibernate-configuration-3.0.dtd">
<hibernate-configuration>
    <!--配置數據庫信息-必須的-->
    <session-factory>
        <property name="hibernate.connection.driver_class">com.mysql.jdbc.Driver</property>
        <property name="hibernate.connection.url">jdbc:mysql://localhost:3306/stu_mangement</property>
        <property name="hibernate.connection.username">root</property>
        <property name="hibernate.connection.password">root</property>
        <!--配置hibernate信息-可選的-->
        <property name="hibernate.show_sql">true</property><!--輸出底層sql語句-->
        <property name="hibernate.format_sql">true</property><!--格式化輸出sql語句-->
        <property name="hibernate.hbm2ddl.auto">update</property><!--hibernate幫助創建表,如果已經有表更新表,如果沒有則創建新表-->
        <property name="hibernate.dialect">org.hibernate.dialect.MySQL5Dialect</property>
        <property name="hibernate.connection.isolation">4</property>
        <!--指定session與當前線程綁定-->
        <property name="hibernate.current_session_context_class">thread</property>
        <!--配置數據庫的方言,讓hibernate識別框架自己的特有語句-->
        <!--把映射文件放到核心配置文件-->
        <mapping resource="pers/zhb/domain/Student.hbm.xml"/><!--都在src目錄下-->
        <mapping resource="pers/zhb/domain/Class.hbm.xml"/><!--都在src目錄下-->
    </session-factory>
</hibernate-configuration>

 二、具體運用:

1、增加:

(1)創建一個新班級併為新班級添加兩名學生:

public class Test {
    public static void testSel() {
            Session session = HibernateUtils.openSession();//獲得session
            Transaction transaction = session.beginTransaction();//開啟事務
            Clas clas=new Clas();
            clas.setClassname("計科171");
            clas.setClassno(4600);
            clas.setDepartment("一號樓");
            clas.setMonitor("zhai");

            Student student=new Student();
            student.setSname("翟");
            student.setStudentno(2017151411);
            student.setPoint(123f);
            student.setSex("男");
            student.setBirthday("2019-11-11");
            student.setPhone("18739496522");
            student.setClassno("221221");
            student.setEmail("34288334@qq.com");

            Student student1=new Student();
            student1.setSname("翟hb");
            student1.setStudentno(2017151419);
            student1.setPoint(666f);
            student1.setSex("女");
            student1.setBirthday("2019-11-11");
            student1.setPhone("18739496522");
            student1.setClassno("221221");
            student1.setEmail("34288334@qq.com");

            clas.getStudents().add(student);//一對多,一個班級下有多個學生
            clas.getStudents().add(student1);//獲取Set集合對象並向其中添加元素

            student.setaClas(clas);//多對一,學生屬於哪一個班級
            student1.setaClas(clas);

            session.save(clas);
            session.save(student);
            session.save(student1);

            transaction.commit();//提交事務
            session.close();//關閉資源
        }


 (2)為一個已經存在的班級添加學生:

 public static void testAdd(){
            Session session = HibernateUtils.openSession();//獲得session
            Transaction transaction = session.beginTransaction();//開啟事務
            Clas clas=session.get(Clas.class,80501);//獲得一個已經存在的班級
            Student student=new Student();//創建一個學生對象
            student.setSname("翟zz");
            student.setStudentno(20190000);
            student.setPoint(133f);
            student.setSex("男");
            student.setBirthday("2019-11-16");
            student.setPhone("18739496522");
            student.setEmail("34288334@qq.com");

            Student student1=new Student();//再創建一個學生對象
            student1.setSname("翟zz");
            student1.setStudentno(20190000);
            student1.setPoint(133f);
            student1.setSex("男");
            student1.setBirthday("2019-11-16");
            student1.setPhone("18739496522");
            student1.setEmail("34288334@qq.com");

            clas.getStudents().add(student);//學生添加到班級
            student.setaClas(clas);//班級與學生對應
            clas.getStudents().add(student1);
            student1.setaClas(clas);

            session.save(student);
            session.save(student1);


            transaction.commit();//提交事務
            session.close();//關閉資源

        }


 2、刪除:

刪除80501班的一名學生信息:

 public static void testDel() {
           Session session = HibernateUtils.openSession();//獲得session
           Transaction transaction = session.beginTransaction();//開啟事務
           Clas clas=session.get(Clas.class,80501);//獲得要刪除的學生屬於那一個班級
           Student student=session.get(Student.class,937221532);//獲得要刪除的學生
           clas.getStudents().remove(student);
           student.setaClas(null);
           transaction.commit();//提交事務
           session.close();//關閉資源
       }


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

※別再煩惱如何寫文案,掌握八大原則!

基於cookie的用戶登錄狀態管理

cookie是什麼

先來花5分鐘看完這篇文章:

看完上文,相信大家對cookie已經有了一個整體的概念,我再強調一下,cookie是一個客戶端概念,它是存儲在瀏覽器本地的一小段文本(通常由服務器來生成這段文本)。

cookie的作用

如上文所說,cookie有許多作用,如會話狀態管理,個性化設置,瀏覽器行為跟蹤,客戶端數據的存儲等等。本篇文章就來講講基於cookie的用戶登錄狀態管理。

插一句哈,一般提到cookie,還會有一個叫session的傢伙和它一起出現,下篇文章我會講到它,以及兩者的區別。

cookie的產生過程

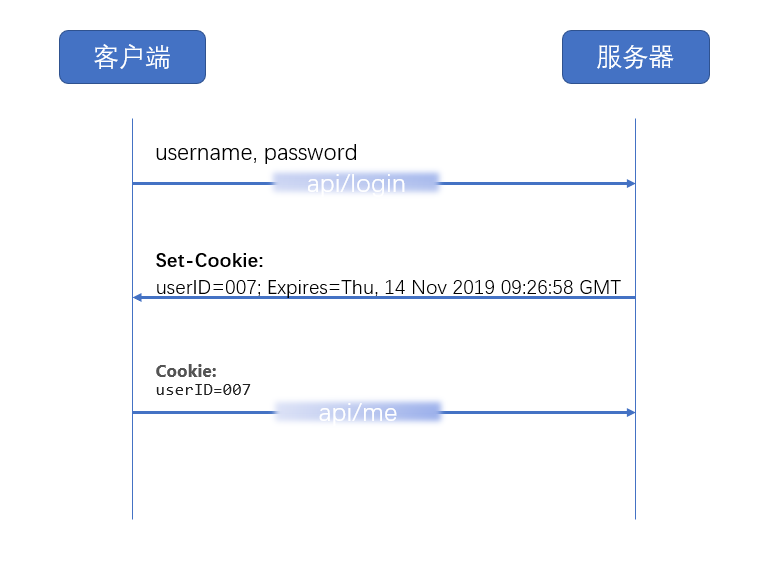
如上圖所示,客戶端攜帶賬號和密碼向服務器發起請求,服務器在校驗通過後,通過HTTP Respose Header中的Set-Cookie頭部,將一小段文本寫入客戶端瀏覽器,在以後的每個客戶端HTTP Request Header的Cookie頭部中會自動攜帶這段文本。

基於cookie的用戶登錄狀態管理

下面我基於golang和gin框架(中間件使用比較舒服)來簡單的實現一個基於cookie的用戶登錄狀態管理demo

package main

import (
    "net/http"
    "time"

    "github.com/gin-gonic/gin"
)

func main() {
    r := gin.Default()

    r.GET("/login", Login)
    
    // 需要登陸保護的
    auth := r.Group("")
    auth.Use(AuthRequired())
    {
        auth.GET("/me", UserInfo)
        auth.GET("/logout", Logout)
    }

    r.Run("localhost:9000")
}

// 登陸
func Login(c *gin.Context) {
    // 為了演示方便,我直接通過url明文傳遞賬號密碼,實際生產中應該用HTTP POST在body中傳遞
    userID := c.Query("user_id")
    password := c.Query("password")

    // 用戶身份校驗(查詢數據庫)
    if userID == "007" && password == "007" {
        // 生成cookie
        expiration := time.Now()
        expiration = expiration.AddDate(0, 0, 1)
        // 實際生產中我們可以加密userID
        cookie := http.Cookie{Name: "userID", Value: userID, Expires: expiration}
        http.SetCookie(c.Writer, &cookie)

        c.JSON(http.StatusOK, gin.H{"msg": "Hello " + userID})
        return
    }
    c.JSON(http.StatusBadRequest, gin.H{"msg": "賬號或密碼錯誤"})
}

// 檢測是否登陸的中間件
func AuthRequired() gin.HandlerFunc {
    return func(c *gin.Context) {
        cookie, _ := c.Request.Cookie("userID")
        if cookie == nil {
            c.JSON(http.StatusUnauthorized, gin.H{"msg": "請先登陸"})
            c.Abort()
        }
        // 實際生產中應校驗cookie是否合法
        c.Next()
    }
}

// 查看用戶個人信息
func UserInfo(c *gin.Context) {
    c.JSON(http.StatusOK, gin.H{"msg": "007的個人頁面"})
}

// 退出登陸
func Logout(c *gin.Context) {
    // 設置cookie過期
    expiration := time.Now()
    expiration = expiration.AddDate(0, 0, -1)
    cookie := http.Cookie{Name: "userID", Value: "", Expires: expiration}
    http.SetCookie(c.Writer, &cookie)

    c.JSON(http.StatusOK, gin.H{"msg": "退出成功"})
}

我們來看具體的演示流程和效果:

如下圖所示,當我們退出后再去嘗試訪問個人頁面時,會出現401沒有權限的錯誤。

上述例子的缺點

先來說說上面的demo存在的問題吧,我們的退出登錄函數本質是設置了一個過期了的cookie來覆蓋以前發送給用戶的正常cookie。

但是,這兒存在着一個重大的安全問題。如果用戶將之前未過期的正常cookie記錄下來(即本例子中的userID=007),即使調用了我們的logout接口,只要用戶自己手動輸入之前未過期的正常cookie,也是可以通過服務器的驗證。

而且,最重要的是,我們無法讓其失效,因為cookie的過期刪除機制是由瀏覽器來控制的,但是當用戶記錄了cookie中的哪段文本后,在cookie到期后,瀏覽器只能刪除存在於瀏覽器中的cookie,對用戶自己記錄下來的cookie確無能為力,也就是說這段cookie永遠有效。(後面我們會講一種叫json web token的技術,可以做到讓我們簽發的憑證自帶過期機制,而不依賴瀏覽器)

當然,有同學會說,我們可以在服務器存儲一份有效的cookie列表,在用戶退出登錄后,從有效列表中刪除對應的cookie,這種在服務端維護用戶狀態的機制本質是session的思想,我們後面會講基於session的用戶登錄狀態管理。

再來說說cookie別的缺點:

當然這個我們通過設置cookie的屬性為HttpOnly,來禁止JavaScript讀取cookie值,可以起到一定的防護作用。

當然,cookie也是有優點的,我們把用戶的登錄狀態保存在客戶端,這樣就不需要每一次去訪問數據庫來檢測用戶是否登錄,減少了系統的IO開銷。

最後

本文希望通過一個不是很完美的demo來講述基於cookie的用戶登錄狀態管理,下期我們來講講session。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※南投搬家前需注意的眉眉角角,別等搬了再說!

※新北清潔公司,居家、辦公、裝潢細清專業服務