Net Core Identity 身份驗證:註冊、登錄和註銷 (簡單示例)

一、前言

  一般我們自己的系統都會用自己設置的一套身份驗證授權的代碼,這次用net core的identity來完成簡單的註冊、登錄和註銷。

二、數據庫

  首先就是創建上下文,我這裏簡單的建了Users和UserClaim表,要是沒有UserClaim等下的登錄操作是會報錯的,應該是有身份認證方面的關係。

    public class DataBaseContext : DbContext
    {
        public DataBaseContext(DbContextOptions<DataBaseContext> options)
        : base(options)
        { }
        public DbSet<User> Users { get; set; }
        public DbSet<IdentityUserClaim<string>> UserClaim { get; set; }
    }
    public class User : IdentityUser
    {
        public string companyId { get; set; }
        public string PassWord { get; set; }
    }

  這裏User繼承了IdentityUser,IdentityUser中就用很多的基礎字段,像是UserName等所以我們可以再User類中擴展我們的字段。

  add-migration Init和update-database Init再控制台執行,生成表。

三、Startup註冊服務

  在ConfigureServices中註冊如下

  1、數據庫上下文連接

  //添加數據庫連接
  services.AddDbContext<DataBaseContext>(options => options.UseSqlServer(Configuration.GetConnectionString("DefaultConnection")));

  2、添加標識服務,包括默認的UI、令牌提供和身份驗的cookie,並且添加identity信息存儲的實體框架實現,用於關聯數據庫創建用戶獲取用戶信息等。AddDefaultIdentity一個相當於AddIdentity、AddDefaultUI和AddDefaultTokenProviders三個。如果User不繼承IdentityUser使用AddEntityFrameworkStores會報錯。

  services.AddDefaultIdentity<User>().AddEntityFrameworkStores<DataBaseContext>();

  3、添加Identity的選項,可以設定密碼的強度、長度、使用字符、密碼輸入錯誤次數等等。

    services.Configure<IdentityOptions>(options =>
    {
        // 密碼設置
        options.Password.RequireDigit = false;
        options.Password.RequireLowercase = false;
        options.Password.RequireNonAlphanumeric = false;
        options.Password.RequireUppercase = false;
        options.Password.RequiredLength = 1;
        options.Password.RequiredUniqueChars = 1;

        // 鎖定設置
        options.Lockout.DefaultLockoutTimeSpan = TimeSpan.FromMinutes(5);
        options.Lockout.MaxFailedAccessAttempts = 5;
        options.Lockout.AllowedForNewUsers = true;

        // 用戶設置
        options.User.AllowedUserNameCharacters =
        "abcdefghijklmnopqrstuvwxyzABCDEFGHIJKLMNOPQRSTUVWXYZ0123456789-._@+";
        options.User.RequireUniqueEmail = false;
    });

  4、配置應用程序的cookie

    services.ConfigureApplicationCookie(options =>
    {
        // Cookie設置
        options.Cookie.HttpOnly = true;
        options.ExpireTimeSpan = TimeSpan.FromMinutes(5);

        options.LoginPath = "/Login/Index";
        options.AccessDeniedPath = "/Home/Index";
        options.SlidingExpiration = true;
    });

  在Config中註冊身份認證

  app.UseAuthentication();

四、簡單的登錄、註冊和註銷

  既然是簡單的例子,那我是真的怎麼簡單怎麼來,代碼也就沒幾條。

  先創建一個Home控制器並加上[Authorize]特性,沒得到驗證的就統統無法訪問。按照上面的Startup.cs已經將UserManager依賴注入了,它是用來管理用戶的比如註冊啥的。

  [Authorize]
    public class HomeController : Controller
    { 
        private UserManager<User> userManager;public HomeController(UserManager<User> _userManager)
        {
            userManager = _userManager;
        }
        public async Task<IActionResult> Index()
        {
            var res = await userManager.GetUserAsync(HttpContext.User);
            return View();
        }
    }

  然後創建一個Login控制器,我們可以在裏面寫登錄、註冊和註銷的方法。Login控制器除了UserManager外還要注入SignManager,它是用來用戶登錄、註銷等操作的。

    public class LoginController : Controller
    {
        //用於提供持久性存儲的用戶信息
        private UserManager<User> userManager;
        private SignInManager<User> signManager;
        public LoginController(UserManager<User> _userManager,SignInManager<User> _signManager)
        {
            userManager = _userManager;
            signManager = _signManager;
        }
    }

  1、註冊

   註冊直接用CreateAsync方法,會自動在數據庫創建用戶。SignInAsync方法用於剛註冊的馬上用戶登錄。

        public async Task<IActionResult> Register()
        {
            var user = new User() { UserName = "xu2", PhoneNumber = "123", companyId = "1" };
            var result = await userManager.CreateAsync(user, "123");
            await signManager.SignInAsync(user, true);
            if (result.Succeeded)
                return Redirect("/Home/Index");
            return Redirect("/Login/Index");
        }

  2、登錄

  登錄不能用SignInAsync了,要用PasswordSignInAsync密碼登錄

        public async Task<IActionResult> Index()
        {
            var s = await signManager.PasswordSignInAsync("xu", "123", true, false);
            return View();
        }

  3、註銷

  這邊直接return view()是無法註銷的,因為cookie會被重新加載,需要return Redirect(“/Home/Index”)重定向

        public async Task<IActionResult> LogOut()
        {
            await signManager.SignOutAsync();
            return View();
        }

  4、獲取當前登錄用戶

    var res = await userManager.GetUserAsync(HttpContext.User);


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※幫你省時又省力,新北清潔一流服務好口碑

※別再煩惱如何寫文案,掌握八大原則!
程序員需要了解的硬核知識之操作系統入門

對於程序員來說,最莫大的榮耀莫過於自己的軟件被大多數人使用了吧。

歷史文章請戳

本篇文章作為操作系統的入門文章,可能入門都算不上吧,畢竟操作系統太龐大和複雜了。本篇文章主要帶你了解一下我們常用的操作系統環境。

操作系統環境

程序中包含着運行環境這一內容,可以說 運行環境 = 操作系統 + 硬件 ,操作系統又可以被稱為軟件,它是由一系列的指令組成的。我們不介紹操作系統,我們主要來介紹一下硬件的識別。

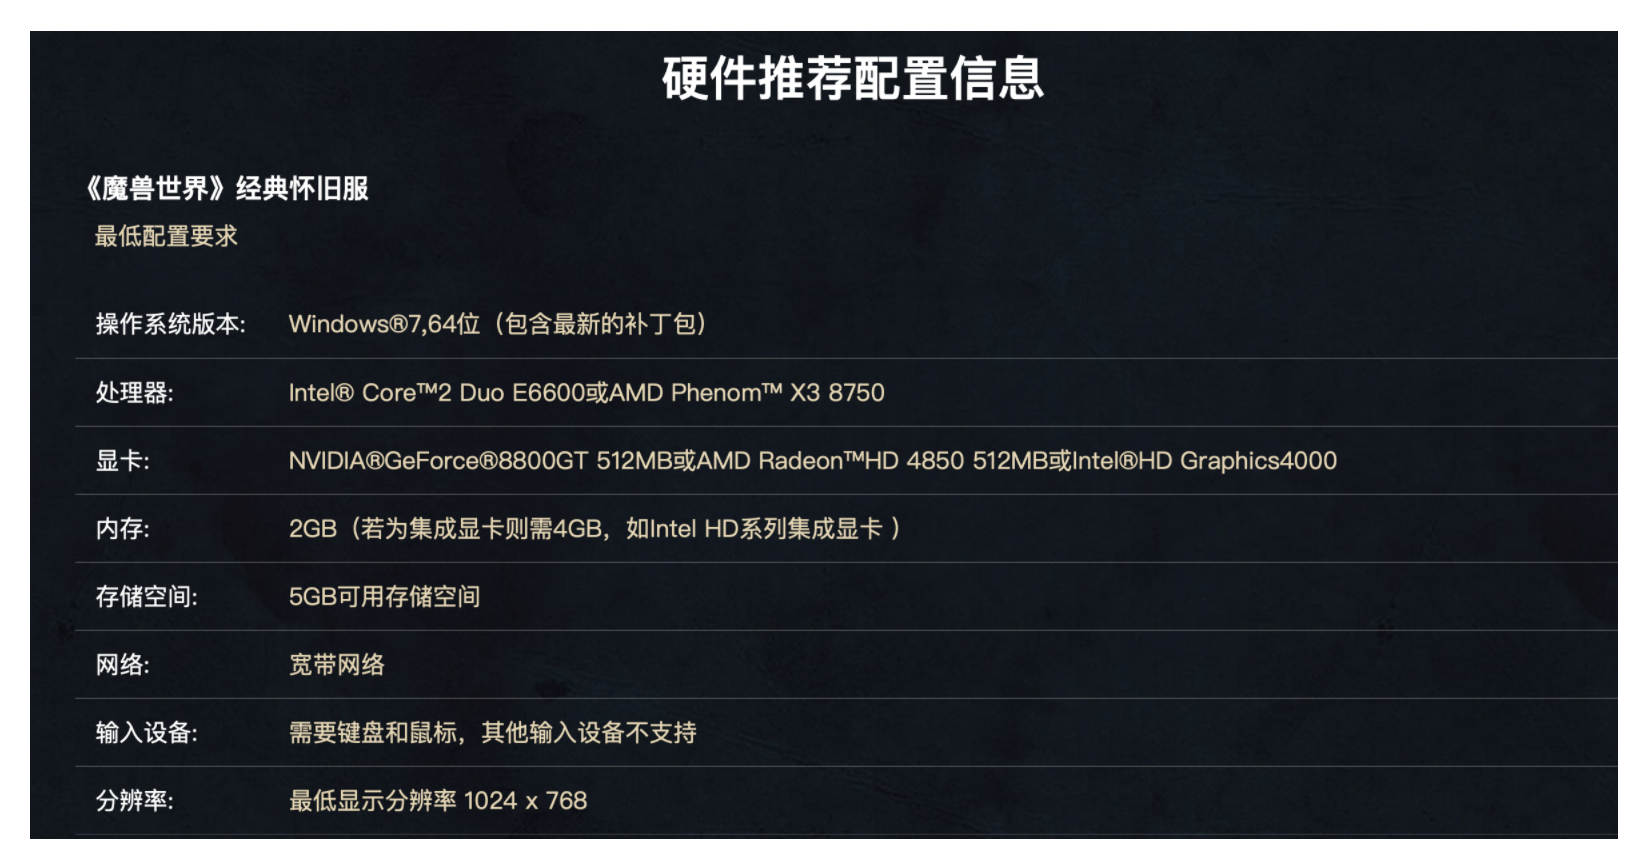
我們肯定都玩兒過遊戲,你玩兒遊戲前需要干什麼?是不是需要先看一下自己的筆記本或者電腦是不是能肝的起遊戲?下面是一個遊戲的配置(懷念一下 wow)

圖中的主要配置如下

  • 操作系統版本:說的就是應用程序運行在何種系統環境,現在市面上主要有三種操作系統環境,Windows 、Linux 和 Unix ,一般我們玩兒的大型遊戲幾乎都是在 Windows 上運行,可以說 Windows 是遊戲的天堂。Windows 操作系統也會有區分,分為32位操作系統和64位操作系統,互不兼容。
  • 處理器:處理器指的就是 CPU,你的電腦的計算能力,通俗來講就是每秒鐘能處理的指令數,如果你的電腦覺得卡帶不起來的話,很可能就是 CPU 的計算能力不足導致的。想要加深理解,請閱讀博主的另一篇文章:

  • 顯卡:顯卡承擔圖形的輸出任務,因此又被稱為圖形處理器(Graphic Processing Unit,GPU),顯卡也非常重要,比如我之前玩兒的劍靈開五檔(其實就是圖像變得更清晰)會卡,其實就是顯卡显示不出來的原因。
  • 內存:內存即主存,就是你的應用程序在運行時能夠動態分析指令的這部分存儲空間,它的大小也能決定你電腦的運行速度,想要加深理解,請閱讀博主的另一篇文章

  • 存儲空間:存儲空間指的就是應用程序安裝所佔用的磁盤空間,由圖中可知,此遊戲的最低存儲空間必須要大於 5GB,其實我們都會遺留很大一部分用來安裝遊戲。

從程序的運行環境這一角度來考量的話,CPU 的種類是特別重要的參數,為了使程序能夠正常運行,必須滿足 CPU 所需的最低配置。

CPU 只能解釋其自身固有的語言。不同的 CPU 能解釋的機器語言的種類也是不同的。機器語言的程序稱為 本地代碼(native code),程序員用 C 等高級語言編寫的程序,僅僅是文本文件。文本文件(排除文字編碼的問題)在任何環境下都能显示和編輯。我們稱之為源代碼。通過對源代碼進行編譯,就可以得到本地代碼。下圖反映了這個過程。

Windows 操作系統克服了CPU以外的硬件差異

計算機的硬件並不僅僅是由 CPU 組成的,還包括用於存儲程序指令的數據和內存,以及通過 I/O 連接的鍵盤、显示器、硬盤、打印機等外圍設備。

在 WIndows 軟件中,鍵盤輸入、显示器輸出等並不是直接向硬件發送指令。而是通過向 Windows 發送指令實現的。因此,程序員就不用注意內存和 I/O 地址的不同構成了。Windows 操作的是硬件而不是軟件,軟件通過操作 Windows 系統可以達到控制硬件的目的。

不同操作系統的 API 差異性

接下來我們看一下操作系統的種類。同樣機型的計算機,可安裝的操作系統類型也會有多種選擇。例如:AT 兼容機除了可以安裝 Windows 之外,還可以採用 Unix 系列的 Linux 以及 FreeBSD (也是一種Unix操作系統)等多個操作系統。當然,應用軟件則必須根據不同的操作系統類型來專門開發。CPU 的類型不同,所對應機器的語言也不同,同樣的道理,操作系統的類型不同,應用程序向操作系統傳遞指令的途徑也不同。

應用程序向系統傳遞指令的途徑稱為 API(Application Programming Interface)。Windows 以及 Linux 操作系統的 API,提供了任何應用程序都可以利用的函數組合。因為不同操作系統的 API 是有差異的。所以,如何要將同樣的應用程序移植到另外的操作系統,就必須要覆蓋應用所用到的 API 部分。

鍵盤輸入、鼠標輸入、显示器輸出、文件輸入和輸出等同外圍設備進行交互的功能,都是通過 API 提供的。

這也就是為什麼 Windows 應用程序不能直接移植到 Linux 操作系統上的原因,API 差異太大了。

在同類型的操作系統下,不論硬件如何,API 幾乎相同。但是,由於不同種類 CPU 的機器語言不同,因此本地代碼也不盡相同。

FreeBSD Port 幫你輕鬆使用源代碼

不知道你有沒有這個想法:“既然 CPU 不同會導致本地代碼不同,那為何不將源代碼直接發送給程序呢?”這確實是一種解決辦法,Unix 系列的 FreeBSD 操作系統就使用了這種方式。

Unix 系列操作系統 FreeBSD 中,存在一種名為 Ports 的機制。該機制能夠結合當前運行環境的硬件環境來編譯應用的源代碼,進而得到可以運行的本地代碼。如果目標應用的源代碼在硬件上找不到,Ports 就會自動使用 FTP 連接到相應站點下載代碼。

全球有很多站點都提供適用於 FreeBSD 的應用源代碼。通過使用 Ports 可以利用的程序源代碼,大約有 16000 種。根據不同的領域進行分類,可以隨時使用。

FreeBSD 上應用的源代碼,大部分是用 C 語言來標註的,C 編譯器可以結合 FreeBSD 的運行環境來生成合適的本地代碼。

FTP( File Transfer Protocol) 是連接到互聯網上的計算機之間的傳送文件的協議。

可以使用虛擬機獲取其他環境

即使不通過應用程序的移植,在同一個操作系統上仍然可以使用其他的操作系統,那就是使用 虛擬機軟件。虛擬機(Virtual Machine)指通過軟件的具有完整硬件系統功能的、運行在一個完全隔離環境中的完整計算機系統。在實體計算機中能夠完成的工作在虛擬機中都能夠實現。

提供相同運行環境的 Java 虛擬機

總算是提到大 Java 了, Java 大法好,除了虛擬機的方法之外,還有一種方法能夠提供不依賴於特定硬件和操作系統的程序運行環境,那就是 Java。

大家說的 Java 其實有兩層意思,一種是作為編程語言的 Java;一種是作為程序運行環境的 Java。Java 與其他語言相同,都是通過源代碼編譯后運行的。不過,編譯後生成的不是特定 CPU 使用的本地代碼,而是名為字節代碼 的程序。直接代碼的運行環境就稱為 Java 虛擬機(Java Virtual Machine)。Java 虛擬機是一邊把 Java 字節代碼逐一轉換為本地代碼一邊在運行着。

程序運行時,將編譯后的字節代碼轉換為本地代碼,這樣的操作看上去有些迂迴,但由此可以實現相同的字節碼可以在不同的操作系統環境下運行。

想象一下,你開發完成的應用部署到 Linux 環境下,是不是什麼都不用管?

Windows 有專門的 Windows 虛擬機,Macintosh 有 Macintosh 專門的虛擬機。從操作系統來看,Java虛擬機就是一個應用,從運行環境上來看,Java 虛擬機就是運行環境。

BIOS 和引導

最後對一些比較基礎的部分做一些補充說明。程序的運行環境,存在着名為 BIOS(Basic Input/Output System)的系統。BIOS 存儲在 ROM 中,是預先內置在計算機主機內部的程序。BIOS 除了鍵盤、磁盤和顯卡等基本控制外,還有引導程序的功能。引導程序是存儲在啟動驅動器啟示區域的小程序。操作系統的啟動驅動器一般硬盤。不過有時也可能是 CD-ROM 或軟盤。

電腦開機后,BIOS 會確認硬件是否正常運行,沒有異常的話會直接啟動引導程序。引導程序的功能是把在硬盤等記錄的 OS 加載到內存中運行。雖然啟動應用是 OS 的功能,但 OS 不能啟動自己,是通過引導程序來啟動的。

文章參考:

《程序是怎樣跑起來的》第七章

關注公眾號後台回復 191106 即可獲得《程序是怎樣跑起來的》电子書

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※教你寫出一流的銷售文案?

MapReduce任務提交源碼分析

  為了測試MapReduce提交的詳細流程。需要在提交這一步打上斷點:

   F7進入方法:

   進入submit方法:

   注意這個connect方法,它在連接誰呢?我們知道,Driver是作為客戶端存在的,那麼客戶端連接的應該就是Yarn集群,但是在這個簡單的WordCount案例中,並沒有將任務提交到Yarn集群,而是在本機中執行的。所以先假設這裏連接的自然就是本機。

進入這個connect方法,然後在裏面的Cluster(集群的意思)方法上打上斷點:


 很明顯,這是一個構造器,他把集群抽象成了一個對象。進入此方法:

 初始化了一個客戶端協議,進入這個create方法,看看他是如何初始化客戶端協議的:

   注意這個mapreduce.framework.name,他就是mapred-site.xml文件中的mapreduce.framework.name項的值,由於我並沒有提交到集群上,而是在本機,所以他會加載本機的mapred-site.xml文件,但是我本機下的該文件並沒有像集群上那樣配置了mapred-site.xml文件,只有一份mapred-site.xml.template文件,更沒有mapreduce.framework.name這一項,所以上面代碼中的值就默認為local了。

  本機上的配置:

 集群上的配置:

create方法最終反回了一個LocalJobRunner對象,如果上面的值是yarn,返回的則是YarnJobRunner。繼續往下:

   會發現這個LocalJobRunner就是客戶端。然後一直往下,直到完成connect方法,會發現整個過程中在connect方法中創建了一個Cluster對象,然後在Cluster對象裏面獲取到了客戶端。

  緊接着,由於connect方法初始化了cluster對象,所以接下來創建了submitter對象,用於提交任務。進入submitJobInternal方法打上斷點


這個checkSpecs方法就是用來檢查路徑的,當輸入路徑不存在或輸出路徑已存在時會報錯。進入此方法后再進入內部方法就一目瞭然了:


繼續往下執行,完成checkSpecs方法后完初始化一個路徑:

打開此路徑,此時還是空的文件夾:

繼續往下,隨後做了一些獲取IP和往配置文件中設置IP和hostname的操作:

 繼續往下,隨後又在上面的路徑下隨機創建了一個目錄:

繼續往下,見到copyAndConfigureFiles時,進入此方法,然後在進入內部方法uploadFiles():

在uploadFiles方法中有,執行后的效果:


 這個文件夾暫時不知道幹嘛的,只知道copyAndConfigureFiles方法創建了這個路徑。此方法執行完后,執行到writeSplits進入此方法:

 這個方法是重點:切片是怎麼切的呢?

 maps是int型,這表示這啟動的maptask的數量也該和切片的數量保持一致。而具體切成多少片呢?

上面的方法多態調用到子類的方法writeNewSplits,然後調用getSplits方法:

getSplits方法中有這樣一段:

   也就是說:當剩餘長度比切片尺寸大於1.1時,就會產生新的切片,比如說文件65m,splitSize為32m,第一片切到32m,剩餘33m,由於33/32<1.1,所以就不再切片,65m被切成兩片,0~32、32~65,而不是0~32 、 32~64 、 64~65三片。

   當執行完writeSplits方法后,會在上面創建的目錄下生成幾個文件:

 上面生成的文件中保存了“切片的規劃信息”。繼續往下,當執行到writeConf方法后,會繼續在上面的目錄下生成與此Job相關的配置文件:


   繼續執行,當執行完submitJob方法后,job本身(即WordCount程序本身會被打成jar包被提交)就被提交了:

  但是由於我是直接在本地執行的,直接從main方法進來執行的,沒必要再打成jar包再從main方法進入,所以並不用提交,但是如果是是在yarn 上執行的時候,會把程序打成jar包放在上面的目錄下。

   當任務執行完畢后,上面的目錄會被清空:

   至此,整個任務的提交執行完成,試想一下,如果這個任務在Yarn上執行是什麼樣子呢?基本的邏輯不會變:

  首先,還是執行connect方法,初始化到Cluster對象,然後創建JobRunner,不過在Yarn上執行的JobRunner就不是LocalJobRunner了,而是YarnJobRunner。執行完connect方法後會在HDFS文件系統創建一個路徑,其作用與上面創建的路徑相同,用於保存切片方案信息和配置文件信息,同時會將任務本身的jar包放入其中,最後任務執行完,這些內容又將被銷毀。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※新北清潔公司,居家、辦公、裝潢細清專業服務

python機器學習——隨機梯度下降

上一篇我們實現了使用梯度下降法的自適應線性神經元,這個方法會使用所有的訓練樣本來對權重向量進行更新,也可以稱之為批量梯度下降(batch gradient descent)。假設現在我們數據集中擁有大量的樣本,比如百萬條樣本,那麼如果我們現在使用批量梯度下降來訓練模型,每更新一次權重向量,我們都要使用百萬條樣本,訓練時間很長,效率很低,我們能不能找到一種方法,既能使用梯度下降法,但是又不要每次更新權重都要使用到所有的樣本,於是隨機梯度下降法(stochastic gradient descent)便被提出來了。

隨機梯度下降法可以只用一個訓練樣本來對權重向量進行更新:
\[ \eta(y^i-\phi(z^i))x^i \]
這種方法比批量梯度下降法收斂的更快,因為它可以更加頻繁的更新權重向量,並且使用當個樣本來更新權重,相比於使用全部的樣本來更新更具有隨機性,有助於算法避免陷入到局部最小值,使用這個方法的要注意在選取樣本進行更新時一定要隨機選取,每次迭代前都要打亂所有的樣本順序,保證訓練的隨機性,並且在訓練時的學習率也不是固定不變的,可以隨着迭代次數的增加,學習率逐漸減小,這種方法可以有助於算法收斂。

現在我們有了使用全部樣本的批量梯度下降法,也有了使用單個樣本的隨機梯度下降法,那麼一種折中的方法,稱為最小批學習(mini-batch learning),它每次使用一部分訓練樣本來更新權重向量。

接下來我們實現使用隨機梯度下降法的Adaline

from numpy.random import seed
class AdalineSGD(object):
    """ADAptive LInear NEuron classifier.

    Parameters
    ----------
    eta:float
        Learning rate(between 0.0 and 1.0
    n_iter:int
        Passes over the training dataset.

    Attributes
    ----------
    w_: 1d-array
        weights after fitting.
    errors_: list
        Number of miscalssifications in every epoch.
    shuffle:bool(default: True)
        Shuffle training data every epoch
        if True to prevent cycles.
    random_state: int(default: None)
        Set random state for shuffling
        and initalizing the weights.

    """

    def __init__(self, eta=0.01, n_iter=10, shuffle=True, random_state=None):
        self.eta = eta
        self.n_iter = n_iter
        self.w_initialized = False
        self.shuffle = shuffle
        if random_state:
            seed(random_state)

    def fit(self, X, y):
        """Fit training data.

        :param X:{array-like}, shape=[n_samples, n_features]
        :param y: array-like, shape=[n_samples]
        :return:
        self:object

        """

        self._initialize_weights(X.shape[1])
        self.cost_ = []

        for i in range(self.n_iter):
            if self.shuffle:
                X, y = self._shuffle(X, y)
            cost = []
            for xi, target in zip(X, y):
                cost.append(self._update_weights(xi, target))
            avg_cost = sum(cost)/len(y)
            self.cost_.append(avg_cost)
        return self
    
    def partial_fit(self, X, y):
        """Fit training data without reinitializing the weights."""
        if not self.w_initialized:
            self._initialize_weights(X.shape[1])
        if y.ravel().shape[0] > 1:
            for xi, target in zip(X, y):
                self._update_weights(xi, target)
        else:
            self._update_weights(X, y)
        return self
    
    def _shuffle(self, X, y):
        """Shuffle training data"""
        r = np.random.permutation(len(y))
        return X[r], y[r]
    
    def _initialize_weights(self, m):
        """Initialize weights to zeros"""
        self.w_ = np.zeros(1 + m)
        self.w_initialized = True
    
    def _update_weights(self, xi, target):
        """Apply Adaline learning rule to update the weights"""
        output = self.net_input(xi)
        error = (target - output)
        self.w_[1:] += self.eta * xi.dot(error)
        self.w_[0] += self.eta * error
        cost = 0.5 * error ** 2
        return cost
    
    def net_input(self, X):
        """Calculate net input"""
        return np.dot(X, self.w_[1:]) + self.w_[0]
    
    def activation(self, X):
        """Computer linear activation"""
        return self.net_input(X)
    
    def predict(self, X):
        """Return class label after unit step"""
        return np.where(self.activation(X) >= 0.0, 1, -1)

其中_shuffle方法中,調用numpy.random中的permutation函數得到0-100的一個隨機序列,然後這個序列作為特徵矩陣和類別向量的下標,就可以起到打亂樣本順序的功能。

現在開始訓練

ada = AdalineSGD(n_iter=15, eta=0.01, random_state=1)
ada.fit(X_std, y)

畫出分界圖和訓練曲線圖

plot_decision_region(X_std, y, classifier=ada)
plt.title('Adaline - Stochastic Gradient Desent')
plt.xlabel('sepal length [standardized]')
plt.ylabel('petal length [standardized]')
plt.legend(loc = 'upper left')
plt.show()
plt.plot(range(1, len(ada.cost_) + 1), ada.cost_, marker='o')
plt.xlabel('Epochs')
plt.ylabel('Average Cost')
plt.show()

從上圖可以看出,平均損失下降很快,在大概第15次迭代后,分界線和使用批量梯度下降的Adaline分界線很類似。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開

※幫你省時又省力,新北清潔一流服務好口碑

自己實現 aop 和 spring aop

說到,我們可以在 BeanPostProcessor 中對 bean 的初始化前化做手腳,當時也說了,我完全可以生成一個代理類丟回去。

代理類肯定要為用戶做一些事情,不可能像學設計模式的時候創建個代理類,然後簡單的在前面打印一句話,後面打印一句話,這叫啥事啊,難怪當時聽不懂。最好是這個方法的前後過程可以自戶自己定義。

小明說,這還不好辦,cglib 已經有現成的了,jdk 也可以實現動態代理,看 mybatis 其實也是這麼乾的,不然你想它一個接口怎麼就能找到 xml 的實現呢,可以參照下 mybatis 的代碼。

所以首先學習下 cglib 和 jdk 的動態代理,我們來模擬下 mybatis 是如何通過接口來實現方法調用的

cglib

目標接口:

public interface UserOperator {
    User queryUserByName(String name);
}

代理處理類:

import net.sf.cglib.proxy.MethodInterceptor;
import net.sf.cglib.proxy.MethodProxy;

public class ProxyHandle implements MethodInterceptor{
    // 實現 MethodInterceptor 的代理攔截接口
    public Object intercept(Object obj, Method method, Object[] args, MethodProxy proxy) throws Throwable {
        System.out.println("獲取到 sqlId:"+method);
        System.out.println("獲取到執行參數列表:"+args[0]);
        System.out.println("解析 spel 表達式,並獲取到完整的 sql 語句");
        System.out.println("執行 sql ");
        System.out.println("結果集處理,並返回綁定對象");
        return new User("sanri",1);
    }
}

真正調用處:

Enhancer enhancer = new Enhancer();

enhancer.setSuperclass(UserOperator.class);
enhancer.setCallback(new ProxyHandle());

//可以把這個類添加進 ioc 容器,這就是真正的代理類
UserOperator userOperator = (UserOperator) enhancer.create();

User sanri = userOperator.queryByName("sanri");
System.out.println(sanri);

jdk

import java.lang.reflect.InvocationHandler;
public class ProxyHandler implements InvocationHandler {
    public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
        System.out.println("獲取到 sqlId:"+method);
        System.out.println("獲取到執行參數列表:"+args[0]);
        System.out.println("解析 spel 表達式,並獲取到完整的 sql 語句");
        System.out.println("執行 sql ");
        System.out.println("結果集處理,並返回綁定對象");
        return new User("sanri",1);
    }
}

真正調用處:

UserOperator proxyInstance = (UserOperator)Proxy.newProxyInstance(ClassLoader.getSystemClassLoader(), new Class[]{UserOperator.class}, new ProxyHandler());
User sanri = proxyInstance.queryByName("sanri");
System.out.println(sanri);

注:jdk 只能支持代理接口,但 cglib 是接口和實體類都可以代理; jdk 是使用實現接口方式,可以多實現,但 cglib 是繼承方式,也支持接口方式。

代理模式和裝飾模式的區別:

從這也可以看到代理模式和裝飾模式的區別 ,代理模式的方法簽名一般是不動的,但裝飾模式是為了方法的增強,一般會使用別的更好的方法來代替原方法。

如何織入

回到正文,這時我們已經可以創建一個代理類了,如何把用戶行為給弄進來呢,哎,又只能 回調 了,我們把現場信息給用戶,用戶實現我的接口,然後我找到接口的所有實現類進行順序調用,但這時候小明想到了幾個問題

  • 用戶不一定每個方法都要做代理邏輯,可能只是部分方法需要,我們應該能夠識別出是哪些方法需要做代理邏輯 (Pointcut)
  • 方法加代理邏輯的位置,方法執行前(Before),方法執行后(After),方法返回數據后(AfterReturning),方法出異常后(AfterThrowing),自定義執行(Around)

根據單一職責原則,得寫五個接口,每個接口要包含 getPointCut() 方法和 handler() 方法,或者繞過單一職責原則,在一個接口中定義 6 個方法,用戶不想實現留空即可。總得來說,用戶只需要提交一份規則給我就行,這個規則你不管是用 json,xml ,或者 註解的方式,只要我能夠識別在 這個 pointcut 下,需要有哪些自定義行為,在另一個 pointcut 下又有哪些自定義行為即可。

現拿到用戶行為了和切點了,還需要創建目標類的代理類,並把行為給綁定上去,在什麼時候創建代理類呢,肯定在把 bean 交給容器的時候悄悄的換掉啊, 說到 bean 有一個生命周期是用於做所有 bean 攔截的,並且可以在初始化前和初始化後進行攔截,沒錯,就是 BeanPostProcessor 我們可以在初始化後生成代理類。

這裏需要注意,並不是所有類都需要創建代理。我們可以這樣檢測,讓 pointcut 提供一個方法用於匹配當前方法是否需要代理,當然這也是 pointcut 的職責,如果當前類有一個方法需要代理,那麼當前類是需要代理的,否則認為不需要代理,這麼做需要遍歷所有類的所有方法,如果運氣差的話,看上去很耗費性能 ,但 spring 也是這麼乾的。。。。。。優化的方案可以這麼玩,如果方法需要代理,在類上做一個標識,如果類上存在這個標識,則可以直接創建代理類。

現在我們把用戶行為綁定到代理類,根據上面 jdk 動態代理和 cglib 動態代理的學習,我們發現,它們都有一個共同的傢伙,那就是方法攔截,用於攔截目標類的當前正在執行的方法,並增強其功能,我們可以在創建代理類的時候找到所有的用戶行為並按照順序和類型依次綁定,可以用責任鏈模式。

看一下 spring 是怎麼玩的

spring 也是在 BeanPostProcessor 接口的 postProcessAfterInitialization 生命周期進行攔截,具體的類為 AspectJAwareAdvisorAutoProxyCreator

spring 配置切面有兩種方式,使用註解和使用配置,當然,現在流行註解的方式,更方便,但不管是配置還是註解,最後都會被解析成 Advisor(InstantiationModelAwarePointcutAdvisorImpl),spring 查找了所有實現 Advisor 的類,源代碼在 BeanFactoryAdvisorRetrievalHelper.findAdvisorBeans

advisorNames = BeanFactoryUtils.beanNamesForTypeIncludingAncestors(this.beanFactory, Advisor.class, true, false);

緊接着,spring 會使使用 Advisor 中的 pointcut 來看當前類是否需要創建代理類,跟進方法可以看到 canApply 方法中是遍歷了所有方法一個個匹配來看是否需要創建代理類的,如果有一個需要,則直接返回 true 。當然 spring 更嚴謹一些,它考慮到了可能有接口的方法需要有代理,我上面說在類加標識是不正確的。

然後通過 createProxy 創建了代理類,裏面有區分 cglib 還是 aop ,下面單拿 cglib 來說

在 CglibAopProxy.getProxy 中對類進行增強,主要看 Enhancer 類是如何設置的就好了,有一個 callback 參數 ,我們一般是第 0 個 callback 也即 DynamicAdvisedInterceptor 它是一個 cglib 的 MethodInterceptor

它重寫的是 MethodInterceptor 的 intercept 方法,下面看這個方法,this.advised 是前面傳過來的用戶行為,getInterceptorsAndDynamicInterceptionAdvice 把 Advisor 適配成了 org.aopalliance.intercept.MethodInterceptor 分別對應切面的五種行為

AbstractAspectJAdvice
  |- AspectJAfterReturningAdvice
  |- AspectJAfterAdvice implements org.aopalliance.intercept.MethodInterceptor
  |- AspectJAroundAdvice implements org.aopalliance.intercept.MethodInterceptor
  |- AspectJAfterThrowingAdvice implements org.aopalliance.intercept.MethodInterceptor
  |- AspectJMethodBeforeAdvice

最後它封裝一個執行器,根據順序調用攔截器鏈,也即用戶行為列表,封裝執行的時候是強轉 org.aopalliance.intercept.MethodInterceptor 來執行的,但 AspectJAfterReturningAdvice 和 AspectJMethodBeforeAdvice 沒有實現 org.aopalliance.intercept.MethodInterceptor 怎麼辦,所以 spring 在獲取用戶行為鏈的時候增加了一個適配器,專門用於把這兩種轉換成 MethodInterceptor

其它說明

  • cglib 的 callback 只能寫一個,filter 用於選擇是第幾個 callback ,不要認為也是鏈式的

  • spring aop 中有比較多的設計模式,學設計模式的可以看下這塊的源碼 ,至少責任鏈,適配器,動態代理都可以在這看到
  • 切面類中如果有兩個一樣的行為,比如有兩個 @Before,排序規則為看方法名的 ascii 碼值,只測試過,並沒經過源碼,有興趣的可以自己去看一下。

來個示例更容易理解

我們除了使用 @Aspect 註解把切面規則告訴 spring 外,也可以學本身 aop 的實現,我們自己定義一個 Advisor ,因為 spring 就是掃描這個的,然後實現 pointcut 和 invoke 方法,一樣可以實現 aop 。

聯繫上文: 我們來看看 spring 的 redis-cache 是如何做切面的

文章說到,主要工作的類是 CacheInterceptor 它是一個 org.aopalliance.intercept.MethodInterceptor

Advisor 是 BeanFactoryCacheOperationSourceAdvisor 也就是說創建代理類會掃描到這個類,最後執行會把其轉成 MethodInterceptor,因為它是一個 PointcutAdvisor ,查看 DefaultAdvisorChainFactory.getInterceptorsAndDynamicInterceptionAdvice 方法,第一個就是把 PointcutAdvisor 轉成 MethodInterceptor 繼續進入獲取攔截器的方法,可以知道就是獲取的 advice 屬性 CacheInterceptor

一點小推廣

創作不易,希望可以支持下我的開源軟件,及我的小工具,歡迎來 gitee 點星,fork ,提 bug 。

Excel 通用導入導出,支持 Excel 公式
博客地址:
gitee:

使用模板代碼 ,從數據庫生成代碼 ,及一些項目中經常可以用到的小工具
博客地址:
gitee:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

研究:熱浪恐同時襲擊大糧倉 造成食物短缺

摘錄自2019年12月10日中央社報導

德國波茨坦氣候影響研究中心(Potsdam Institute for Climate Impact Research)氣候學家、也在荷蘭阿姆斯特丹自由大學(VU University Amsterdam)擔任副教授的庫姆(Dim Coumou)共同執筆在「自然氣候變遷」(Nature Climate Change)期刊,該報告警告,氣候變遷可能導致全球各地出現更強烈的熱浪,並在同一時間襲擊各大糧倉,造成食物短缺,引發動亂。

庫姆表示,世界一部分地區的農作物因氣候災難等原因歉收,原本就會抵銷其他收成正常或豐收地區增加的交易量;但高懸地球上空的強烈噴射氣流風,加上氣候導致氣溫更加升高,可能會在同時間襲來,威脅到多個糧倉的作物。

最無法抵擋這種熱浪的地區包括北美西部、西歐、西俄羅斯和烏克蘭,這裡種植的小麥、玉米、大豆、稻米產量占全球主食約1/4。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

※教你寫出一流的銷售文案?

酒精製環保清潔劑 跨界合作友善環境

摘錄自2019年12月13日公視報導

「無酒精」啤酒近年來越來越受歡迎,不過大量酒精廢棄物何去何從,讓業者傷腦筋。有啤酒製造商和清潔劑公司合作,將這類廢棄物用來製造環保洗碗精。

總部設在比利時魯汶的百威英博啤酒集團,是全球最大的啤酒製造商。為了迎合快速成長的無酒精啤酒市場的需求,業者生產這種喝了不醉的飲料時,得將酒精提取出來。不過大量廢棄酒精何去何從?一直讓業者很頭痛。

百威英博後來找上強調使用天然配方的環保清潔產品製造商宜珂,發現將廢棄酒精淨化再處理後,可以用作活性清潔劑和防腐劑成分,雙方一拍即合。不過廢酒精再利用,仍舊會散發酒的味道,宜珂正想盡辦法克服。宜珂創新部主任多曼說:「如何蓋住這個味道,讓我們的產品在消費者使用時聞起來味道很好。因為消費者不希望餐具上留有啤酒味,所以這是我們主要的挑戰。」

宜珂後來使用來自其他廢棄農產品提煉的香味,掩蓋啤酒味,成功推出這款環保洗碗精,上面標註有1/4成分來自啤酒廢棄物。從啤酒泡到清潔劑泡泡,百威英博成功將產業垃圾再利用,透過跨界合作,變成對環境更友善的商品。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

※新北清潔公司,居家、辦公、裝潢細清專業服務

解鎖新夥伴關係 政府、企業與社會的氣候合作

文:李翊僑(荷蘭馬斯垂克大學永續科學、政策與社會碩士生)

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

※評比南投搬家公司費用收費行情懶人包大公開

※幫你省時又省力,新北清潔一流服務好口碑

因應氣候變遷 財政部被賦要角

文:易淇馨(烏特勒支大學國際海洋與環境法碩士生)

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

※教你寫出一流的銷售文案?

聯合國氣候會議 環保署長與各國官員互動多

摘錄自2019年12月13日中央社報導

台灣不是巴黎氣候協定的締約國,仍積極參加聯合國氣候會議。代表台灣參與的環保署長張子敬表示,今年與各國官員的互動比往年多,不過,台灣減碳作為仍有不足的地方。

聯合國氣候變化綱要公約(UNFCCC)第25次締約方會議(COP 25)2日至13日在西班牙首都馬德里舉行,外交部旗下的國際合作發展基金會、交通部中央氣象局、經濟部工業局、工業技術研究院、行政院農業委員會、媽媽監督核電廠聯盟等機關和團體利用會議期間在周邊會議發聲。

張子敬在馬德里接受中央社記者訪問時表示,雖然無法進入大會會場,不過在場外與各國官員的互動比往年都多。除了邦交國,他也與歐盟、英國、瑞典、德國等國代表會晤,各國對台灣對抗氣候變遷的作法相當重視,台灣也樂於幫助需要幫助的國家。

此外,張子敬還接受在地的「ABC日報」等媒體專訪,說明台灣的能源和減碳政策,以及為何因為中國的壓力,無法參與這次的氣候會議。

張子敬表示,在減碳的作為上,台灣仍有許多不足之處。首先,台灣十分依賴進口化石能源,每度電的碳排量過高,住商、農業和交通部門的減碳都有待加強。

其次,除了建立碳交易制度,落實總量管制,張子敬也支持徵收碳稅,「使用者付費本來就應該」。他說,環保署在水污染防治有許多經驗,未來碳稅的收入將專款專用,用來減少碳排。

本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

【其他文章推薦】

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

※別再煩惱如何寫文案,掌握八大原則!