物聯網架構成長之路(47)-利用GitLab實現CI持續集成

0.前言
  前段時間,考慮到要練習部署一套CI/CD的系統。一開始考慮到Jenkins,隨着這两天的了解,發現最新版的GitLab已經提供有CI/CD集成了。所以本次博客,乾脆一步到位,直接用GitLab裏面的CI/CD模塊。Jenkins可能需要更高級的應用場合。經過測試GitLab自帶的功能完全符合我的需求。

1. 安裝GitLab和GitLab-CI(gitlab-runner)
  英語比較好的,可以直接看官方文檔。https://docs.gitlab.com/omnibus/docker/#install-gitlab-using-docker-compose https://docs.gitlab.com/ee/ci/quick_start/README.html
  下面提供我使用的 docker-compose.yml

 1 version: '3'
 2 services:
 3     gitlab:
 4         image: twang2218/gitlab-ce-zh:latest
 5         #image: gitlab/gitlab-ce:rc
 6         restart: always
 7         hostname: '172.16.23.203'
 8         environment:
 9             GITLAB_OMNIBUS_CONFIG: |
10                 external_url 'http://172.16.23.203:8929'
11                 gitlab_rails["time_zone"] = "Asia/Shanghai"
12         ports:
13             - 8929:8929
14             - 1080:80
15             - 1443:443
16             - 1022:22
17         volumes:
18             - /root/workspace/docker/gitlab/1/config:/etc/gitlab
19             - /root/workspace/docker/gitlab/1/logs:/var/log/gitlab
20             - /root/workspace/docker/gitlab/1/data:/var/opt/gitlab
21     gitlab-runner:
22         image: gitlab/gitlab-runner:latest
23         restart: always
24         volumes:
25             - /root/workspace/docker/gitlab/2/config:/etc/gitlab-runner
26             - /var/run/docker.sock:/var/run/docker.sock

  執行docker-compose up -d 就運行起來,幾點需要說明的
    1. gitlab的image,可以選擇中文版或者英文版
    2. hostname 這裏指定本機IP地址
    3. gitlab環境變量,external_url表示提供訪問的IP和端口,時區配置上海
    4. 端口映射,默認是80端口,由於我上面配置了8929,所以映射8929到Host主機
    5. volumes 配置持久化數據
    6. 這裏的/var/run/docker.sock 要映射到主機,因為會用到主機的一些資源,同時還會在docker裏面安裝docker
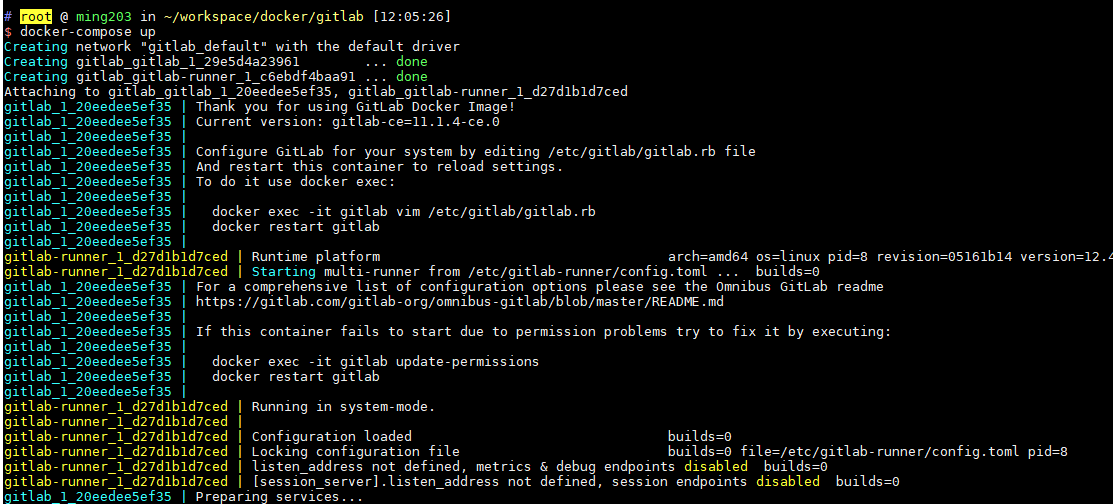
  下面是運行效果,第一次運行會比較久,因為要拉取鏡像和初始化GitLab

2. 登錄使用GitLab
  首次登錄,設置密碼。 登錄默認用戶名是root
  利用模版,新建一個Spring項目

  利用IDE,或者其他工具,或者直接在GitLab修改代碼

3. 配置CI/CD,把機器(gitlab-runner)註冊到GitLab中
  可以在項目配置CI/CD機器,也可以在個人所有項目下配置,也可以由管理員配置所有項目下CI/CD機器。原理和流程都是一樣的,只是比Jenkins更加細粒度控制而已。

  進入gitlab-runner的Docker,執行初始化命令 gitlab-ci-multi-runner register,完整命令如下:

1 sudo docker exec -it gitlab-runner gitlab-ci-multi-runner register

  需要錄入的信息,安裝上圖進行,填寫,後續還可以修改。

  如果需要修改,可以修改之前volumes配置的路徑下, config/config.toml


 1 concurrent = 1
 2 check_interval = 0
 3 
 4 [session_server]
 5   session_timeout = 1800
 6 
 7 [[runners]]
 8   name = "myRunner"
 9   url = "http://172.16.23.203:8929/"
10   token = "96beefdaa54832b0c8369ffa3811c9"
11   executor = "docker"
12   [runners.custom_build_dir]
13   [runners.docker]
14     tls_verify = false
15     image = "docker:latest"
16     privileged = true
17     disable_entrypoint_overwrite = false
18     oom_kill_disable = false
19     disable_cache = false
20     volumes = ["/cache", "/root/.m2:/root/.m2", "/var/run/docker.sock:/var/run/docker.sock"]
21     shm_size = 0
22   [runners.cache]
23     [runners.cache.s3]
24     [runners.cache.gcs]


  上面這個是配置文件,裏面有幾個注意點
    1. privileged 這裏要配置 true,因為要在docker裏面安裝docker
    2. /root/.m2 這個是配置maven的倉庫使用宿主主機的緩存,這樣就不用每次CI都要下載依賴
    3. /var/run/docker.sock 這個也要配置,在構建dockerfile的時候會用到
  還有一個需要配置的就是,這個Runner需要設置tag,這個是標識Runner的名稱。在.gitlab-ci.yml中會用到

4. 配置CI/CD
  默認GitLab是啟用該功能的,根目錄配置新增 .gitlab-ci.yml 文件,然後每次git push,都會觸發CI持續集成。當然可以在yml配置,在主線master觸發。
  來個簡單的配置,測試一下

 1 image: maven:3-jdk-8
 2 cache:
 3     paths:
 4         - .m2/repository
 5 test:
 6     stage: test
 7     script:
 8         - mvn package
 9     tags:
10         - tag

  上面這個配置,寫到.gitlab-ci.yml然後提交到repo,我們提交該文件到gitlab對應項目上去。

1 git add .gitlab-ci.yml
2 git commit -m "Add .gitlab-ci.yml"
3 git push origin master

  如果嫌慢,pom.xml 可以換個阿里源

 1         <repository>
 2             <id>maven-ali</id>
 3             <url>http://maven.aliyun.com/nexus/content/groups/public/</url>
 4             <releases>
 5                 <enabled>true</enabled>
 6             </releases>
 7             <snapshots>
 8                 <enabled>true</enabled>
 9                 <updatePolicy>always</updatePolicy>
10                 <checksumPolicy>fail</checksumPolicy>
11             </snapshots>
12         </repository>

  一提交,就會觸發自動構建

  可以看到整個構建過程,如果出現錯誤,也是到這個日誌裏面排查問題。


5. 測試、打包、發布
  這一步,我們實現一個簡單的測試、打包、發布
5.1 增加 Dockerfile

1 FROM openjdk:8-jdk-alpine
2 VOLUME /tmp
3 COPY  target/demo-0.0.1-SNAPSHOT.jar app.jar
4 ENV PORT 5000
5 EXPOSE $PORT
6 ENTRYPOINT ["java","-Djava.security.egd=file:/dev/./urandom","-Dserver.port=${PORT}","-jar","/app.jar"]

5.2 修改 .gitlab-ci.yml

 1 image: maven:3-jdk-8
 2 
 3 variables:
 4     DOCKER_TAG: test/demo-spring:0.1
 5 
 6 cache:
 7     paths:
 8         - .m2/repository
 9 
10 stages:
11     - test
12     - package
13     - deploy
14 
15 test:
16     stage: test
17     tags:
18         - tag
19     script:
20         - mvn test
21 
22 package:
23     stage: package
24     tags:
25         - tag
26     script:
27         - mvn clean package -Dmaven.test.skip=true
28     artifacts:
29         paths:
30             - target/*.jar
31 
32 deploy:
33     image: docker:latest
34     stage: deploy
35     services:
36         - docker:dind
37     tags:
38         - tag
39     script:
40         - docker version 
41         - docker build -t $DOCKER_TAG .
42         - docker rm -f test || true
43         - docker run -d --name test -p 5000:5000 $DOCKER_TAG

  那個artifacts.paths 配置,提交target目錄下的文件到下一個流水線,因為不同流水線,由於是基於Docker,所以每一步都是隔離的。同時,上傳的附件還可以在構建成功后,在流水線pipelines界面進行下載。每一步的image都是可以指定的,那個tags也是可以指定的。可以提交到不同的機器進行構建。
  上面一共就三步流程,先test(測試),然後package(打包編譯),最後deploy(發布測試)。前兩個比較好理解,就是maven的基本命令。最後那個deploy就是利用docker裏面的docker來進行打包成docker,然後運行起來,作為測試發布。
  更新代碼.gitlab-ci.yml,然後提交,觸發持續集成。

  查看構建日誌

  查看宿主機鏡像和運行狀態

  查看瀏覽器,已經發布到測試環境了

5.3 釘釘通知

 1 image: maven:3-jdk-8
 2 
 3 variables:
 4     DOCKER_TAG: test/demo-spring:0.1
 5 
 6 cache:
 7     paths:
 8         - .m2/repository
 9 
10 stages:
11     - test
12     - package
13     - deploy
14     - notify
15 
16 test:
17     stage: test
18     tags:
19         - tag
20     script:
21         - mvn test
22 
23 package:
24     stage: package
25     tags:
26         - tag
27     script:
28         - mvn clean package -Dmaven.test.skip=true
29     artifacts:
30         paths:
31             - target/*.jar
32 
33 deploy:
34     image: docker:latest
35     stage: deploy
36     services:
37         - docker:dind
38     tags:
39         - tag
40     script:
41         - docker version 
42         - docker build -t $DOCKER_TAG .
43         - docker rm -f test || true
44         - docker run -d --name test -p 5000:5000 $DOCKER_TAG
45 
46 notify:
47     image: appropriate/curl:latest
48     stage: notify
49     tags:
50         - tag
51     script: "curl 'https://oapi.dingtalk.com/robot/send?access_token=d6c15304c1***************************************' -H 'Content-Type: application/json' -d '{\"msgtype\": \"text\", \"text\": {\"content\": \"功能已更新部署至測試環境\"}}' "

  有了這個通知,就可以做很多事情了,寫個腳本,封裝成一個Docker 鏡像,可以發送釘釘,發送郵件,可以對接到第三方系統等。

  更多高級應用,如集成之前了解的Harbor,Rancher。使整個系統更加強大,更加智能化。


參考資料


本文地址:
本系列目錄:
個人主頁:

volumes

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
JavaScript 是否應該重命名

  在誕生 25 年之後,JavaScript 語言仍然讓很多人困惑不已。所以一個老生常談的問題是:它是否應該重命名?呼籲改名的支持者列舉了一系列理由,包括:

  • JavaScript 本意指的是 ECMAScript 的子集,但使用中它經常被指代多種不同的 ECMAScript 超集
  • JavaScript 是甲骨文公司的商標,這與 JavaScript 作為 Web 平台核心組件的身份不相符合,Web 平台是建立在開放技術和標準基礎上的
  • JavaScript 連官方 logo 都沒有
  • JavaScript 與 Java 沒有一點關係,幾十年來它給非技術人員造成了混淆。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※3c收購,鏡頭 收購有可能以全新價回收嗎?

※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

※賣IPHONE,iPhone回收,舊換新!教你怎麼賣才划算?

雅虎日本在其餐廳徵收“油炸食品稅”

  為了推廣健康生活方式,減少僱員中間的肥胖率,雅虎日本在其總部餐廳開始徵收“油炸食品稅”。從 10 月 8 日開始,炸豬排之類的油炸食品價格上漲,而水煮魚或烤魚之類的魚類食品則價格下降。

  它在 2017 年的體檢显示,45% 的僱員 LDL 膽固醇含量較高。它的自助餐廳每天有 1000 名僱員吃飯,油炸食品要比水煮魚或烤魚受歡迎得多。除了炸豬排漲價外,炸雞排也漲了 100 日元至 691 日元。如今到了午餐點,魚類食品一售而空,官員表示效果顯著。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

傳谷歌母公司欲收購Fitbit 擬推自有品牌可穿戴設備

  原標題:Google is reportedly trying to buy Fitbit

  網易科技訊,10 月 29 日消息,據外媒報道,據知情人士透露,谷歌母公司 Alphabet 正在就收購美國可穿戴設備公司 Fitbit 與後者進行談判。不過,目前兩家公司還沒有確認這筆交易,也不清楚 Alphabet 的報價。上個月,有報道稱 Fitbit 正在探索出售的可能。

  多年來,谷歌憑藉其 Wear OS 操作系統在可穿戴市場上佔據了重要地位,但它始終難以與 Apple Watch 競爭,儘管其得到了包括 LG、Fossil 和 TicWatch 在內的眾多公司支持。就連主要的安卓製造商三星也未使用 Wear OS,而是使用自己的 Tizen 操作系統。

  今年 1 月,谷歌斥資 4000 萬美元從 Fossil 手中收購了某種智能手錶技術,但目前尚不清楚該技術到底是什麼,Fossil 高管將其描述為“尚未投放市場的新產品創新”,不過迄今仍然沒有上市。

  多年來,始終有傳言稱谷歌希望推出自家品牌的 Pixel 智能手錶。在 2016 年的某個時候,這些計劃幾乎促使谷歌品牌的智能手錶上市,但該公司最終擱置了計劃,因為其擔心這些手錶可能“傷及谷歌硬件品牌的聲譽”。這些 LG 製造的智能手錶後來在 2017 年以 LG Watch Sports 和 LG Watch Style 的形式發布,評價一般。

  從那時起,谷歌打造自家硬件野心開始膨脹。2017 年,谷歌收購了 HTC 智能手機工程團隊以開發 Pixel 手機,而 Fitbit 的收購可能會幫助其在可穿戴設備領域取得類似的進展。

  與此同時,蘋果在 Apple Watch 上的經驗表明,健康正迅速成為智能手錶的殺手級應用,這也是 Fitbit 自身健身追蹤器越來越關注的一個領域。然而,儘管 Fitbit 在 2016 年收購了智能手錶製造商 Pebble,但其在智能手錶方面的表現卻不盡如人意。例如,今年早些時候發布的健身跟蹤器 Fitbit Versa 2,其實本質上就是一款普通的智能手錶。

  谷歌和 Fitbit 拒絕就上述報道置評。(小小)


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

Three.js – 走進3D的奇妙世界

本文將通過Three.js的介紹及示例帶我們走進3D的奇妙世界。

文章來源:宜信技術學院 & 宜信支付結算團隊技術分享第6期-支付結算部支付研發團隊前端研發高級工程師-劉琳《three.js – 走進3D的奇妙世界》

分享者:宜信支付結算部支付研發團隊前端研發高級工程師-劉琳

原文首發於支付結算團隊公號-“野指針”

隨着人們對用戶體驗越來越重視,Web開發已經不滿足於2D效果的實現,而把目標放到了更加炫酷的3D效果上。Three.js是用於實現web端3D效果的JS庫,它的出現讓3D應用開發更簡單,本文將通過Three.js的介紹及示例帶我們走進3D的奇妙世界。

一、Three.js相關概念

1.1 Three.JS

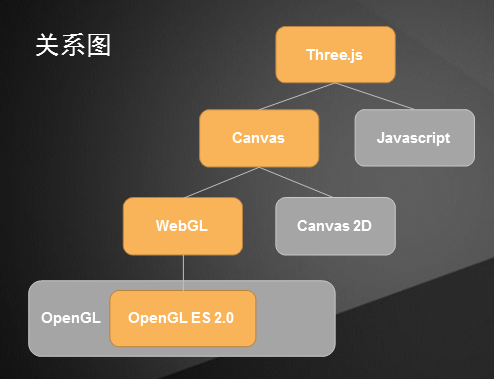
Three.JS是基於WebGL的Javascript開源框架,簡言之,就是能夠實現3D效果的JS庫。

1.2 WebGL

WebGL是一種Javascript的3D圖形接口,把JavaScript和OpenGL ES 2.0結合在一起。

1.3 OpenGL

OpenGL是開放式圖形標準,跨編程語言、跨平台,Javascript、Java 、C、C++ 、 python 等都能支持OpenG ,OpenGL的Javascript實現就是WebGL,另外很多CAD製圖軟件都採用這種標準。OpenGL ES 2.0是OpenGL的子集,針對手機、遊戲主機等嵌入式設備而設計。

1.4 Canvas

Canvas是HTML5的畫布元素,在使用Canvas時,需要用到Canvas的上下文,可以用2D上下文繪製二維的圖像,也可以使用3D上下文繪製三維的圖像,其中3D上下文就是指WebGL。

二、Three.js應用場景

利用Three.JS可以製作出很多酷炫的3D動畫,並且Three.js還可以通過鼠標、鍵盤、拖拽等事件形成交互,在頁面上增加一些3D動畫和3D交互可以產生更好的用戶體驗。

通過Three.JS可以實現全景視圖,這些全景視圖應用在房產、家裝行業能夠帶來更直觀的視覺體驗。在電商行業利用Three.JS可以實現產品的3D效果,這樣用戶就可以360度全方位地觀察商品了,給用戶帶來更好的購物體驗。另外,使用Three.JS還可以製作類似微信跳一跳那樣的小遊戲。隨着技術的發展、基礎網絡的建設,web3D技術還能得到更廣泛的應用。

三、主要組件

在Three.js中,有了場景(scene)、相機(camera)和渲染器(renderer) 這3個組建才能將物體渲染到網頁中去。

1)場景

場景是一個容器,可以看做攝影的房間,在房間中可以布置背景、擺放拍攝的物品、添加燈光設備等。

2)相機

相機是用來拍攝的工具,通過控制相機的位置和方向可以獲取不同角度的圖像。

3)渲染器

渲染器利用場景和相機進行渲染,渲染過程好比攝影師拍攝圖像,如果只渲染一次就是靜態的圖像,如果連續渲染就能得到動態的畫面。在JS中可以使用requestAnimationFrame實現高效的連續渲染。

3.1 常用相機

1)透視相機

透視相機模擬的效果與人眼看到的景象最接近,在3D場景中也使用得最普遍,這種相機最大的特點就是近大遠小,同樣大小的物體離相機近的在畫面上顯得大,離相機遠的物體在畫面上顯得小。透視相機的視錐體如上圖左側所示,從近端面到遠端面構成的區域內的物體才能显示在圖像上。

透視相機構造器

PerspectiveCamera( fov : Number, aspect : Number, near : Number, far : Number )

  • fov — 攝像機視錐體垂直視野角度
  • aspect — 攝像機視錐體長寬比
  • near — 攝像機視錐體近端面
  • far — 攝像機視錐體遠端面

2)正交相機

使用正交相機時無論物體距離相機遠或者近,在最終渲染的圖片中物體的大小都保持不變。正交相機的視錐體如上圖右側所示,和透視相機一樣,從近端面到遠端面構成的區域內的物體才能显示在圖像上。

正交相機構造器

OrthographicCamera( left : Number, right : Number, top : Number, bottom : Number, near : Number, far : Number )

  • left — 攝像機視錐體左側面
  • right — 攝像機視錐體右側面
  • top — 攝像機視錐體上側面
  • bottom — 攝像機視錐體下側面
  • near — 攝像機視錐體近端面
  • far — 攝像機視錐體遠端面

3.2 坐標系

在場景中,可以放物品、相機、燈光,這些東西放置到什麼位置就需要使用坐標系。Three.JS使用右手坐標系,這源於OpenGL默認情況下,也是右手坐標系。從初中、高中到大學的課堂上,教材中所涉及的幾何基本都是右手坐標系。

上圖右側就是右手坐標系,五指併攏手指放平,指尖指向x軸的正方向,然後把四個手指垂直彎曲大拇指分開,併攏的四指指向y軸的正方向,大拇指指向的就是Z軸的正方向。

在Three.JS中提供了坐標軸工具(THREE.AxesHelper),在場景中添加坐標軸后,畫面會出現3條垂直相交的直線,紅色表示x軸,綠色表示y軸,藍色表示z軸(如下圖所示)。

3.3 示例代碼

/* 場景 */
var scene = new THREE.Scene();
scene.add(new THREE.AxesHelper(10)); // 添加坐標軸輔助線

/* 幾何體 */
// 這是自定義的創建幾何體方法,如果創建幾何體後續會介紹
var kleinGeom = createKleinGeom(); 
scene.add(kleinGeom); // 場景中添加幾何體

/* 相機 */
var camera = new THREE.PerspectiveCamera(45, width/height, 1, 100);
camera.position.set(5,10,25); // 設置相機的位置
camera.lookAt(new THREE.Vector3(0, 0, 0)); // 相機看向原點

/* 渲染器 */
var renderer = new THREE.WebGLRenderer({antialias:true});
renderer.setSize(width, height);
// 將canvas元素添加到body
document.body.appendChild(renderer.domElement);
// 進行渲染
renderer.render(scene, camera);


四、幾何體

計算機內的3D世界是由點組成,兩個點能夠組成一條直線,三個不在一條直線上的點就能夠組成一個三角形面,無數三角形面就能夠組成各種形狀的幾何體。

以創建一個簡單的立方體為例,創建簡單的立方體需要添加8個頂點和12個三角形的面,創建頂點時需要指定頂點在坐標系中的位置,添加面的時候需要指定構成面的三個頂點的序號,第一個添加的頂點序號為0,第二個添加的頂點序號為1…

創建立方體的代碼如下:

var geometry = new THREE.Geometry();

// 添加8個頂點
geometry.vertices.push(new THREE.Vector3(1, 1, 1));
geometry.vertices.push(new THREE.Vector3(1, 1, -1));
geometry.vertices.push(new THREE.Vector3(1, -1, 1));
geometry.vertices.push(new THREE.Vector3(1, -1, -1));
geometry.vertices.push(new THREE.Vector3(-1, 1, -1));
geometry.vertices.push(new THREE.Vector3(-1, 1, 1));
geometry.vertices.push(new THREE.Vector3(-1, -1, -1));
geometry.vertices.push(new THREE.Vector3(-1, -1, 1));

// 添加12個三角形的面
geometry.faces.push(new THREE.Face3(0, 2, 1));
geometry.faces.push(new THREE.Face3(2, 3, 1));
geometry.faces.push(new THREE.Face3(4, 6, 5));
geometry.faces.push(new THREE.Face3(6, 7, 5));
geometry.faces.push(new THREE.Face3(4, 5, 1));
geometry.faces.push(new THREE.Face3(5, 0, 1));
geometry.faces.push(new THREE.Face3(7, 6, 2));
geometry.faces.push(new THREE.Face3(6, 3, 2));
geometry.faces.push(new THREE.Face3(5, 7, 0));
geometry.faces.push(new THREE.Face3(7, 2, 0));
geometry.faces.push(new THREE.Face3(1, 3, 4));
geometry.faces.push(new THREE.Face3(3, 6, 4));


4.1 正面和反面

創建幾何體的三角形面時,指定了構成面的三個頂點,如: new THREE.Face3(0, 2, 1),如果把頂點的順序改成0,1,2會有區別嗎?

通過下圖可以看到,按照0,2,1添加頂點是順時針方向的,而按0,1,2添加頂點則是逆時針方向的,通過添加頂點的方向就可以判斷當前看到的面是正面還是反面,如果頂點是逆時針方向添加,當前看到的面是正面,如果頂點是順時針方向添加,則當前面為反面。

下圖所看到的面就是反面。如果不好記,可以使用右手沿頂點添加的方向握住,大拇指所在的面就是正面,很像我們上學時學的電磁感應定律。

五、材質

創建幾何體時通過指定幾何體的頂點和三角形的面確定了幾何體的形狀,另外還需要給幾何體添加皮膚才能實現物體的效果,材質就像物體的皮膚,決定了物體的質感。常見的材質有如下幾種:

  • 基礎材質:以簡單着色方式來繪製幾何體的材質,不受光照影響。
  • 深度材質:按深度繪製幾何體的材質。深度基於相機遠近端面,離近端面越近就越白,離遠端面越近就越黑。
  • 法向量材質:把法向量映射到RGB顏色的材質。
  • Lambert材質:是一種需要光源的材質,非光澤表面的材質,沒有鏡面高光,適用於石膏等表面粗糙的物體。
  • Phong材質:也是一種需要光源的材質,具有鏡面高光的光澤表面的材質,適用於金屬、漆面等反光的物體。
  • 材質捕獲:使用存儲了光照和反射等信息的貼圖,然後利用法線方向進行採樣。優點是可以用很低的消耗來實現很多特殊風格的效果;缺點是僅對於固定相機視角的情況較好。

下圖是使用不同貼圖實現的效果:

六、光源

前面提到的光敏材質(Lambert材質和Phong材質)需要使用光源來渲染出3D效果,在使用時需要將創建的光源添加到場景中,否則無法產生光照效果。下面介紹一下常用的光源及特點。

6.1 點光源

點光源類似蠟燭放出的光,不同的是蠟燭有底座,點光源沒有底座,可以把點光源想象成懸浮在空中的火苗,點光源放出的光線來自同一點,且方向輻射向四面八方,點光源在傳播過程中有衰弱,如下圖所示,點光源在接近地面的位置,物體底部離點光源近,物體頂部離光源遠,照到物體頂部的光就弱些,所以頂部會比底部暗些。

6.2 平行光

平行光模擬的是太陽光,光源發出的所有光線都是相互平行的,平行光沒有衰減,被平行光照亮的整個區域接受到的光強是一樣的。

6.3 聚光燈

類似舞台上的聚光燈效果,光源的光線從一個錐體中射出,在被照射的物體上產生聚光的效果。聚光燈在傳播過程也是有衰弱的。

6.4 環境光

環境光是經過多次反射而來的光,環境光源放出的光線被認為來自任何方向,物體無論法向量如何,都將表現為同樣的明暗程度。

環境光通常不會單獨使用,通過使用多種光源能夠實現更真實的光效,下圖是將環境光與點光源混合后實現的效果,物體的背光面不像點光源那樣是黑色的,而是呈現出深褐色,更自然。

七、紋理

在生活中純色的物體還是比較少的,更多的是有凹凸不平的紋路或圖案的物體,要用Three.JS實現這些物體的效果,就需要使用到紋理貼圖。3D世界的紋理是由圖片組成的,將紋理添加在材質上以一定的規則映射到幾何體上,幾何體就有了帶紋理的皮膚。

7.1 普通紋理貼圖

在這個示例中使用上圖左側的地球紋理,在球形幾何體上進行貼圖就能製作出一個地球。

代碼如下:

/* 創建地球 */
function createGeom() {
    // 球體
    var geom = new THREE.SphereGeometry(1, 64, 64);
    // 紋理
    var loader = new THREE.TextureLoader();
    var texture = loader.load('./earth.jpg');
    // 材質
    var material = new THREE.MeshLambertMaterial({
        map: texture
    });
    var earth = new THREE.Mesh(geom, material);
    return earth;
}


7.2 反面貼圖實現全景視圖

這個例子是通過在球形幾何體的反面進行紋理貼圖實現的全景視圖,實現原理是這樣的:創建一個球體構成一個球形的空間,把相機放在球體的中心,相機就像在一個球形的房間中,在球體的裏面(也就是反面)貼上圖片,通過改變相機拍攝的方向,就能看到全景視圖了。

材質默認是在幾何體的正面進行貼圖的,如果想要在反面貼圖,需要在創建材質的時候設置side參數的值為THREE.BackSide,代碼如下:

/* 創建反面貼圖的球形 */
// 球體
var geom = new THREE.SphereGeometry(500, 64, 64);
// 紋理
var loader = new THREE.TextureLoader();
var texture = loader.load('./panorama.jpg');
// 材質
var material = new THREE.MeshBasicMaterial({
    map: texture,
    side: THREE.BackSide
});
var panorama = new THREE.Mesh(geom, material);


7.3 凹凸紋理貼圖

凹凸紋理利用黑色和白色值映射到與光照相關的感知深度,不會影響對象的幾何形狀,隻影響光照,用於光敏材質(Lambert材質和Phong材質)。

如果只用上圖左上角的磚牆圖片進行貼圖的話,就像一張牆紙貼在上面,視覺效果很差,為了增強立體感,可以使用上圖左下角的凹凸紋理,給物體增加凹凸不平的效果。

凹凸紋理貼圖使用方式的代碼如下:

// 紋理加載器
var loader = new THREE.TextureLoader();
// 紋理
var texture = loader.load( './stone.jpg');
// 凹凸紋理
var bumpTexture = loader.load( './stone-bump.jpg');
// 材質
var material =  new THREE.MeshPhongMaterial( {
    map: texture,
    bumpMap: bumpTexture
} );


7.4 法線紋理貼圖

法線紋理也是通過影響光照實現凹凸不平視覺效果的,並不會影響物體的幾何形狀,用於光敏材質(Lambert材質和Phong材質)。上圖左下角的法線紋理圖片的RGB值會影響每個像素片段的曲面法線,從而改變物體的光照效果。

使用方式的代碼如下:

// 紋理
var texture = loader.load( './metal.jpg');
// 法線紋理
var normalTexture = loader.load( './metal-normal.jpg');
var material =  new THREE.MeshPhongMaterial( {
    map: texture,
    normalMap: normalTexture
} );


7.5 環境貼圖

環境貼圖是將當前環境作為紋理進行貼圖,能夠模擬鏡面的反光效果。在進行環境貼圖時需要使用立方相機在當前場景中進行拍攝,從而獲得當前環境的紋理。立方相機在拍攝環境紋理時,為避免反光效果的小球出現在環境紋理的畫面上,需要將小球設為不可見。

環境貼圖的主要代碼如下:

/* 立方相機 */
var cubeCamera = new THREE.CubeCamera( 1, 10000, 128 );
/* 材質 */
var material = new THREE.MeshBasicMaterial( {
    envMap: cubeCamera.renderTarget.texture
});
/* 鏡面反光的球體 */
var geom = new THREE.SphereBufferGeometry( 10, 32, 16 );
var ball = new THREE.Mesh( geom, material );
// 將立方相機添加到球體
ball.add( cubeCamera );
scene.add( ball );

// 立方相機生成環境紋理前將反光小球隱藏
ball.visible = false;
// 更新立方相機,生成環境紋理
cubeCamera.update( renderer, scene );
balls.visible = true;

// 渲染
renderer.render(scene, camera);


八、加載外部3D模型

Three.JS已經內置了很多常用的幾何體,如:球體、立方體、圓柱體等等,但是在實際使用中往往需要用到一些特殊形狀的幾何體,這時可以使用3D建模軟件製作出3D模型,導出obj、json、gltf等格式的文件,然後再加載到Three.JS渲染出效果。

上圖的椅子是在3D製圖軟件繪製出來的,chair.mtl是導出的材質文件,chair.obj是導出的幾何體文件,使用材質加載器加載材質文件,加載完成后得到材質對象,給幾何體加載器設置材質,加載后得到幾何體對象,然後再創建場景、光源、攝像機、渲染器等進行渲染,這樣就等得到如圖的效果。主要的代碼如下:

// .mtl材質文件加載器
var mtlLoader = new THREE.MTLLoader();
// .obj幾何體文件加載器
var objLoader = new THREE.OBJLoader();

mtlLoader.load('./chair.mtl', function (materials) {
    objLoader.setMaterials(materials)
        .load('./chair.obj', function (obj) {
            scene.add(obj);
            …
        });
});


九、說明

以上內容對Three.JS的基本使用進行了介紹,文中涉及到的示例源碼已上傳到github,感興趣的同學可以下載查看,下載地址:https://github.com/liulinsp/three-demo。使用時如果有不清楚的地方可以查看Three.JS的官方文檔:https://threejs.org/docs/index.html。

作者:劉琳

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

《面試官之你說我聽》:簡明的圖解Redis RDB持久化、AOF持久化

歡迎關注文章這一系列,一起學習

《提升能力,漲薪可待篇》

《面試知識,工作可待篇》

《實戰演練,拒絕996篇》

如果此文對你有幫助、喜歡的話,那就點個讚唄,點個關注唄!

1.持久化

1.1 持久化簡介

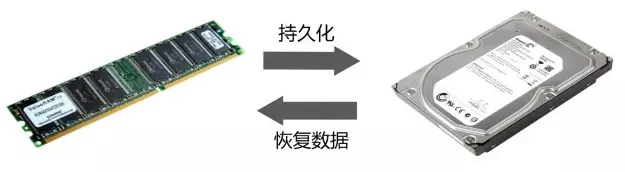
持久化(Persistence),持久化是將程序數據在持久狀態和瞬時狀態間轉換的機制,即把數據(如內存中的對象)保存到可永久保存的存儲設備中(如磁盤)。

1.2 redis持久化

redis為內存數據庫,為了防止服務器宕機以及服務器進程退出后,服務器數據丟失,Redis提供了持久化功能,即將Redis中內存數據持久化到磁盤中。Redis 提供了不同級別的持久化方式:

  • RDB持久化方式:可以在指定的時間間隔能對數據進行快照存儲.

  • AOF持久化方式:記錄每次對服務器寫的操作,當服務器重啟的時候會重新執行這些命令來恢復原始的數據,AOF命令以redis協議追加保存每次寫的操作到文件末尾.Redis還能對AOF文件進行後台重寫,使得AOF文件的體積不至於過大.

如果服務器開啟了AOF持久化功能。服務器會優先使用AOF文件還原數據。只有關閉了AOF持久化功能,服務器才會使用RDB文件還原數據

2. RDB持久化

2.1 RDB文件格式

RDB文件是一個經過壓縮的二進制文件(默認的文件名:dump.rdb),由多個部分組成,RDB格式:

2.2 RDB文件持久化創建與載入

在 Redis持久化時, RDB 程序將當前內存中的數據庫狀態保存到磁盤文件中, 在 Redis 重啟動時, RDB 程序可以通過載入 RDB 文件來還原數據庫的狀態。

2.3 工作方式

當 Redis 需要保存 dump.rdb 文件時, 服務器執行以下操作:

  • Redis 調用forks。同時擁有父進程和子進程。

  • 子進程將數據集寫入到一個臨時 RDB 文件中。

  • 當子進程完成對新 RDB 文件的寫入時,Redis 用新 RDB 文件替換原來的 RDB 文件,並刪除舊的 RDB 文件。

這種工作方式使得 Redis 可以從寫時複製(copy-on-write)機制中獲益。

2.4 創建方式

SAVE

同步操作,在執行該命令時,服務器會被阻塞,拒絕客戶端發送的命令請求

    redis> save

BGSAVE

異步操作,在執行該命令時,子進程執行保存工作,服務器還可以繼續讓主線程處理客戶端發送的命令請求

 redis>bgsave

自動創建

由於BGSAVE命令可不阻塞服務器進程下執行,可以讓用戶自定義save屬性,讓服務器每個一段時間自動執行一次BGSAVE命令(即通過配置文件對 Redis 進行設置, 讓它在“ N 秒內數據集至少有 M 個改動”這一條件被滿足時, 自動進行數據集保存操作)。

比如:
/*服務器在900秒之內,對數據庫進行了至少1次修改*/
Save 900   1
/*服務器在300秒之內,對數據庫進行了至少10次修改*/
Save 300   10
/*服務器在60秒之內,對數據庫進行了至少10000次修改*/
Save 60     10000

只要滿足其中一個條件就會執行BGSAVE命令


2.5 RDB 默認配置

################################ SNAPSHOTTING  ################################
#
# Save the DB on disk:
#在給定的秒數和給定的對數據庫的寫操作數下,自動持久化操作。
#   save <seconds> <changes>
#
save 900 1
save 300 10
save 60 10000
​
#bgsave發生錯誤時是否停止寫入,一般為yes
stop-writes-on-bgsave-error yes
​
#持久化時是否使用LZF壓縮字符串對象?
rdbcompression yes
​
#是否對rdb文件進行校驗和檢驗,通常為yes
rdbchecksum yes
​
# RDB持久化文件名
dbfilename dump.rdb
​
#持久化文件存儲目錄
dir ./


3. AOF持久化

3.1 AOF持久化簡介

AOF持久化是通過保存Redis服務器所執行的寫命令來記錄數據庫狀態


AOF持久化功能實現:

  1. append命令追加:當AOF持久化功能處於打開狀態時,服務器執行完一個寫命令會協議格式被執行的命令追加服務器狀態的aof_buf緩衝區的末尾。

    reids>SET KET VAULE //協議格式 \r\n$3\r\nSET\r\n$3\r\nKEY\r\n$5\r\nVAULE\r\n

  2. 文件寫入和同步sync:Redis的服務器進程是一個事件循環,這個文件事件負責接收客戶端的命令請求以及向客戶端發送命令回復。當執行了append命令追加后,服務器會調用flushAppendOnlyFile函數是否需要將AOF緩衝區的內容寫入和保存到AOF文件

    redis> SET msg "Ccww"
  redis> SADD persistence "rdb" "aof"
  redis> RPUSH size 128 256 512


3.2 AOF持久化策略

AOF持久化策略(即緩衝區內容寫入和同步sync到AOF中),可以通過配置appendfsync屬性來選擇AOF持久化策略:

  • always:將aof_buf緩衝區中的所有內容寫入並同步到AOF文件,每次有新命令追加到 AOF 文件時就執行一次 fsync。

  • everysec(默認):如果上次同步AOF的時間距離現在超過一秒,先將aof_buf緩衝區中的所有內容寫入到AOF文件,再次對AOF文件進行同步,且同步操作由一個專門線程負責執行。

  • no:將aof_buf緩衝區中的所有內容寫入到AOF文件,但並不對AOF文件進行同步,何時同步由操作系統(OS)決定。

AOF持久化策略的效率與安全性:

  • Always:效率最慢的,但安全性是最安全的,即使出現故障宕機,持久化也只會丟失一個事件 循環的命令數據

  • everysec:兼顧速度和安全性,出現宕機也只是丟失一秒鐘的命令數據

  • No:寫入最快,但綜合起來單次同步是時間是最長的,且出現宕機時會丟失上傳同步AOF文件之後的所有命令數據。


3.3 AOF重寫

由於AOF持久化會把執行的寫命令追加到AOF文件中,所以隨着時間寫入命令會不斷增加, AOF文件的體積也會變得越來越大。AOF文件體積大對Reids服務器,甚至宿主服務器造成影響。

為了解決AOF文件體積膨脹的問題,Redis提供了AOF文件重寫(rewrite)功能:

  • 生成一個不保存任何浪費空間的冗餘命令新的AOF文件,且新舊AOF文件保存數據庫狀態一樣的

  • 新的AOF文件是通過讀取數據庫中的鍵值對來實現的,程序無須對現有的AOF文件進行讀入,分析,或者寫入操作。

  • 為防止緩衝區溢出,重寫處理list,hash,set以及Zset時,超過設置常量數量時會多條相同命令記錄一個集合。

  • Redis 2.4 可以通過配置自動觸發 AOF 重寫,觸發參數 auto-aof-rewrite-percentage(觸發AOF文件執行重寫的增長率) 以及 auto-aof-rewrite-min-size(觸發AOF文件執行重寫的最小尺寸)

AOF重寫的作用:

  • 減少磁盤佔用量

  • 加速數據恢復


Redis服務器使用單個線程來處理命令請求,服務器大量調用aof_rewrite函數,在AOF重寫期間,則無法處理client發來的命令請求,所以AOF重寫程序放在子進程執行,好處:

  1. 子進程進行AOF重寫期間,服務器進程可以繼續處理命令請求

  2. 子進程帶有服務器進程的數據副本,保證了數據的安全性。

AOF重寫使用子進程會造成數據庫與重寫后的AOF保存的數據不一致,為了解決這種數據不一致,redis使用了AOF重寫緩衝區 實現:

BGREWRITEAOF命令實現原理(只有信號處理函數執行時才對服務器進程造成阻塞):

  • 執行命令,同時將命令追加到AOF緩衝區和AOF重寫緩衝區

  • 當AOF子進程重寫完成后,發送一個信號給父進程,父進程將執行AOF重寫緩衝區中的所有內容寫入到新AOF文件中,新AOF文件保存的數據庫狀態將和服務器當前的數據庫狀態一致。

  • 對新的AOF文件進行改名,原子性地覆蓋現有AOF文件,完成新舊兩個AOF文件替換處理完成。


3.4 AOF持久化默認參數

############################## APPEND ONLY MODE ###############################
​
#開啟AOF持久化方式
appendonly no
​
#AOF持久化文件名
appendfilename "appendonly.aof"
#每秒把緩衝區的數據fsync到磁盤
appendfsync everysec
# appendfsync no
#是否在執行重寫時不同步數據到AOF文件
no-appendfsync-on-rewrite no
​
# 觸發AOF文件執行重寫的增長率
auto-aof-rewrite-percentage 100
#觸發AOF文件執行重寫的最小size
auto-aof-rewrite-min-size 64mb
​
#redis在恢復時,會忽略最後一條可能存在問題的指令
aof-load-truncated yes
​
#是否打開混合開關
aof-use-rdb-preamble yes

4 持久化方式總結與抉擇

4.1 RDB優缺點

RDB的優點

  • RDB是一個非常緊湊的文件,它保存了某個時間點得數據集,非常適用於數據集的備份,比如你可以在每個小時報保存一下過去24小時內的數據,同時每天保存過去30天的數據,這樣即使出了問題你也可以根據需求恢復到不同版本的數據集.

  • 基於RDB文件緊湊性,便於複製數據到一個遠端數據中心,非常適用於災難恢復.

  • RDB在保存RDB文件時父進程唯一需要做的就是fork出一個子進程,接下來的工作全部由子進程來做,父進程不需要再做其他IO操作,所以RDB持久化方式可以最大化redis的性能.

  • 與AOF相比,在恢復大的數據集的時候,RDB方式會更快一些.

RDB的缺點

  • 如果你希望在redis意外停止工作(例如電源中斷)的情況下丟失的數據最少的話,那麼RDB不適合你.雖然你可以配置不同的save時間點(例如每隔5分鐘並且對數據集有100個寫的操作),是Redis要完整的保存整個數據集是一個比較繁重的工作,你通常會每隔5分鐘或者更久做一次完整的保存,萬一在Redis意外宕機,你可能會丟失幾分鐘的數據.

  • RDB 需要經常fork子進程來保存數據集到硬盤上,當數據集比較大的時候,fork的過程是非常耗時的,可能會導致Redis在一些毫秒級內不能響應客戶端的請求.如果數據集巨大並且CPU性能不是很好的情況下,這種情況會持續1秒,AOF也需要fork,但是你可以調節重寫日誌文件的頻率來提高數據集的耐久度.

4.2 AOF的優缺點

AOF的優點:

  • 使用AOF 會讓你的Redis更加耐久:使用不同的fsync策略:無fsync,每秒fsync,每次寫的時候fsync.使用默認的每秒fsync策略,Redis的性能依然很好(fsync是由後台線程進行處理的,主線程會儘力處理客戶端請求),一旦出現故障,你最多丟失1秒的數據.

  • AOF文件是一個只進行追加的日誌文件,所以不需要寫入seek,即使由於某些原因(磁盤空間已滿,寫的過程中宕機等等)未執行完整的寫入命令,你也可使用redis-check-aof工具修復問題.

  • Redis可以在AOF文件體積變得過大時,自動對 AOF 進行重寫: 重寫后的新 AOF 文件包含了恢復當前數據集所需的最小命令集合。 整個重寫操作是絕對安全的,因為 Redis 在創建新 AOF 文件的過程中,會繼續將命令追加到現有的 AOF 文件裏面,即使重寫過程中發生停機,現有的 AOF 文件也不會丟失。 而一旦新 AOF 文件創建完畢,Redis 就會從舊 AOF 文件切換到新 AOF 文件,並開始對新 AOF 文件進行追加操作。

  • AOF 文件有序地保存了對數據庫執行的所有寫入操作, 這些寫入操作以 Redis 協議的格式保存, 因此 AOF 文件的內容非常容易被人讀懂, 對文件進行分析(parse)也很輕鬆。 導出(export) AOF 文件也非常簡單(例如, 如果你不小心執行了 FLUSHALL 命令, 但只要 AOF 文件未被重寫, 那麼只要停止服務器, 移除 AOF 文件末尾的 FLUSHALL 命令, 並重啟 Redis , 就可以將數據集恢復到 FLUSHALL 執行之前的狀態)。

AOF 缺點:

  • 對於相同的數據集來說,AOF 文件的體積通常要大於 RDB 文件的體積。

  • 根據所使用的 fsync 策略,AOF 的速度可能會慢於 RDB 。 在一般情況下, 每秒 fsync 的性能依然非常高, 而關閉 fsync 可以讓 AOF 的速度和 RDB 一樣快, 即使在高負荷之下也是如此。 不過在處理巨大的寫入載入時,RDB 可以提供更有保證的最大延遲時間(latency)。

4.3 如何選擇使用哪種持久化方式?

一般來說, 如果想達到足以媲美 PostgreSQL 的數據安全性, 你應該同時使用兩種持久化功能。

如果你非常關心你的數據, 但仍然可以承受數分鐘以內的數據丟失, 那麼你可以只使用 RDB 持久化。

有很多用戶都只使用 AOF 持久化, 但我們並不推薦這種方式: 因為定時生成 RDB 快照(snapshot)非常便於進行數據庫備份, 並且 RDB 恢複數據集的速度也要比 AOF 恢復的速度要快, 除此之外, 使用 RDB 還可以避免之前提到的 AOF 程序的 bug 。

也歡迎關注公眾號【Ccww筆記】,原創技術文章第一時間推出

如果此文對你有幫助、喜歡的話,那就點個讚唄,點個關注唄!


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

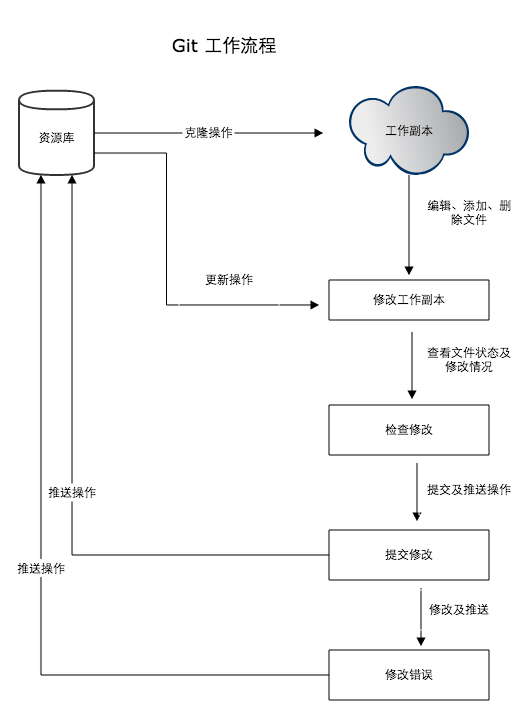
看完這篇還不會用Git,那我就哭了!

你使用過 Git 嗎?也許你已經使用了一段時間,但它的許多奧秘仍然令人困惑。

Git 是一個版本控制系統,是任何軟件開發項目中的主要內容。通常有兩個主要用途:代碼備份和代碼版本控制。你可以逐步處理代碼,在需要回滾到備份副本的過程中保存每一步的進度!

常見的問題是 Git 很難使用。有時版本和分支不同步,你會花很長時間試圖推送代碼!更糟糕的是,不知道某些命令的確切工作方式很容易導致意外刪除或覆蓋部分代碼!

這就是我寫本文的原因,從而學習到如何正確使用 Git,以便在開發中共同進行編碼!

安裝和配置

Git 安裝

首先,我們必須安裝 Git 才能使用它!這裏分 Linux 和 Windows 來演示:

在 Linux 上安裝 Git

我們可以使用 yum 輕鬆快速地做到這一點:

sudo yum install git

在 Windows 上安裝 Git

直接在 https://git-scm.com/downloads 裏面,下載最新版的 Git,默認安裝就可以了。

安裝完成后,在開始菜單里找到 Git->Git Bash,點擊后出現一個類似命令行窗口的東西,就說明 Git 安裝成功。

Git 配置

可以保存 Git 用戶名和电子郵件,這樣就不必在以後的 Git 命令中再次輸入它們。

在命令行中配置本地倉庫的賬號和郵箱:

$ git config --global user.name "wupx"  
$ git config --global user.email "wupx@qq.com"  

好多人都不知道的小技巧是,你可以為 Git 啟用一些額外的顏色,這樣就可以更容易地閱讀命令的輸出!

git config --global color.ui true

Git 基本版本控制

初始化 Git

現在,我們可以開始對項目進行版本控制。使用 cd 命令導航到要在終端中設置版本控制的目錄,現在你可以像這樣初始化 Git 存儲庫:

git init

這將創建一個名為 .git 的新子目錄(Windows 下該目錄為隱藏的),其中包含所有必需的存儲庫文件(Git 存儲庫框架)。至此,你的項目中尚未跟蹤任何內容。

添加並提交

要開始對現有文件進行版本控制,你應該先跟蹤這些文件並進行初始提交。要做到這一點,你首先需要將文件添加到 Git 中,並將它們附加到 Git 項目中。

git add <file>
git commit -m 'first commit'

遠程備份

很棒!你現在已經開始在本地對項目進行版本控制。如果你想遠程保存和備份項目,則需要在 GitHub 上創建一個遠程存儲庫(它是免費的!)。因此,首先轉到 github.com 並創建一個存儲庫。然後,使用存儲庫的鏈接將其添加為本地 git 項目的來源,即該代碼的存儲位置。

# 示例
git remote add origin \
https://github.com/wupeixuan/repo.git 
# 以我的一個倉庫為例
git remote add origin \
https://github.com/wupeixuan/JDKSourceCode1.8.git

然後,你可以繼續將代碼推送到 GitHub!哇,你已經成功備份了你的代碼!

git push origin master

處理文件

狀態檢查

git status 命令用於確定哪些文件處於哪種狀態,它使你可以查看哪些文件已提交,哪些文件尚未提交。如果在所有文件都已提交並推送后運行此命令,則應該看到類似以下內容:

$ git status
# On branch master
nothing to commit (working directory clean)

如果你將新文件添加到項目中,而該文件之前不存在,則在運行 git status 時,你應該看到未跟蹤的文件,如下所示:

$ git status
# On branch master
# Untracked files:
#   (use "git add <file>..." to include in what will be committed)
#
#   README
nothing added to commit but untracked files present (use "git add" to track)

使用 git status 對於快速檢查你已經備份的內容和你僅在本地擁有的內容非常有用。

高級文件添加

還有一些更高級的方法可以將文件添加到 Git 中,從而使你的工作流程更高效。我們可以執行以下操作,而不是試圖查找所有有更改的文件並逐個添加它們:

# 逐個添加文件
git add filename

# 添加當前目錄中的所有文件
git add -A

# 添加當前目錄中的所有文件更改
git add .

# 選擇要添加的更改(你可以 Y 或 N 完成所有更改)
git add -p

高級提交

我們可以使用 git commit -m '提交信息' 來將文件提交到 Git。對於提交簡短消息來說,這一切都很好,但是如果你想做一些更精細的事情,你需要來學習更多的操作:

### 提交暫存文件,通常用於較短的提交消息
git commit -m 'commit message'

### 添加文件並提交一次
git commit filename -m 'commit message'

### 添加文件並提交暫存文件
git commit -am 'insert commit message'

### 更改你的最新提交消息
git commit --amend 'new commit message' 

# 將一系列提交合併為一個提交,你可能會用它來組織混亂的提交歷史記錄
git rebase -i
### 這將為你提供核心編輯器上的界面:
# Commands:
#  p, pick = use commit
#  r, reword = use commit, but edit the commit message
#  e, edit = use commit, but stop for amending
#  s, squash = use commit, but meld into previous commit
#  f, fixup = like "squash", but discard this commit's log message
#  x, exec = run command (the rest of the line) using shell

分支與合併

GitHub存儲庫的master分支應始終包含有效且穩定的代碼。但是,你可能還希望備份一些當前正在處理的代碼,但這些代碼並不完全穩定。也許你要添加一個新功能,你正在嘗試和破壞很多代碼,但是你仍然希望保留備份以保存進度!

分支使你可以在不影響master分支的情況下處理代碼的單獨副本。首次創建分支時,將以新名稱創建master分支的完整克隆。然後,你可以獨立地在此新分支中修改代碼,包括提交文件等。一旦你的新功能已完全集成並且代碼穩定,就可以將其合併到master分支中!

分支

這是你在分支上創建和工作所需的所有東西:

### 創建一個本地分支
git checkout -b branchname

### 在2個分支之間切換
git checkout prc/dev-wupx
git checkout master

### 將新的本地分支作為備份
git push -u origin branch_2

### 刪除本地分支,這不會讓你刪除尚未合併的分支
git branch -d branch_2

### 刪除本地分支,即使尚未合併,這也會刪除該分支!
git branch -D branch_2

### Viewing all current branches for the repository, including both ### local and remote branches. Great to see if you already have a ### branch for a particular feature addition, especially on bigger ### projects
### 查看存儲庫的所有當前分支,包括本地和遠程分支。
git branch -a

### 查看已合併到您當前分支中的所有分支,包括本地和遠程。 非常適合查看所有代碼的來源!
git branch -a --merged

### 查看尚未合併到當前分支中的所有分支,包括本地和遠程
git branch -a --no-merged

### 查看所有本地分支
git branch

### 查看所有遠程分支
git branch -r

# 將主分支重新設置為本地分支
$ git rebase origin/master

# 將分支推送到遠程存儲庫源並對其進行跟蹤
$ git push origin branchname

合併

很棒!現在,你已經學習了如何創建分支並開始敲代碼!將新功能添加到分支中之後,你需要將其合併回master分支,以便您的master具有所有最新的代碼功能。

方法如下:

### 首先確保你正在查看 master 分支
git checkout master

### 現在將你的分支合併到 master 
git merge prc/dev-wupx

你可能必須修复分支與主服務器之間的任何代碼衝突,但是 Git 將向你展示在鍵入該 merge 命令后如何執行所有這些操作。

修復錯誤和回溯

發生錯誤……它們經常在編碼中發生!重要的是我們能夠修復它們。

不要慌!Git 提供了你所需的一切,以防你在所推送的代碼中犯錯,改寫某些內容或者只是想對所推送的內容進行更正。

### 切換到最新提交的代碼版本
git reset HEAD 
git reset HEAD -- filename # for a specific file
### 切換到最新提交之前的代碼版本
git reset HEAD^ -- filename
git reset HEAD^ -- filename # for a specific file
### 切換回3或5次提交
git reset HEAD~3 -- filename
git reset HEAD~3 -- filename # for a specific file
git reset HEAD~5 -- filename
git reset HEAD~5 -- filename # for a specific file
### 切換回特定的提交,其中 0766c053 為提交 ID
git reset 0766c053 -- filename
git reset 0766c053 -- filename # for a specific file
### 先前的命令是所謂的軟重置。 你的代碼已重置,但是git仍會保留其他代碼的副本,以備你需要時使用。 另一方面,--hard 標誌告訴Git覆蓋工作目錄中的所有更改。
git reset --hard 0766c053

對 Git 有用的提示和技巧

我們已經完成了所有細節部分!以下是一些 Git 提示和技巧,你可能會發現它們對改善工作流程非常有用!

搜索

### 搜索目錄中的字符串部分
git grep 'project'

### 在目錄中搜索部分字符串,-n 打印出 git 找到匹配項的行號
git grep -n 'project'

### git grep -C <行數> 'something' 搜索帶有某些上下文的字符串部分(某些行在我們正在尋找的字符串之前和之後)
git grep -C<number of lines> 'project'

### 搜索字符串的一部分,並在字符串之前显示行
git grep -B<number of lines> 'project'

### 搜索字符串的一部分,並在字符串之後显示行
git grep -A<number of lines> 'something'

看誰寫了什麼

### 显示帶有作者姓名的文件的更改歷史記錄
git blame 'filename'

### 显示帶有作者姓名和 git commit ID 的文件的更改歷史記錄
git blame 'filename' -l

日誌

### 显示存儲庫中所有提交的列表 該命令显示有關提交的所有信息,例如提交ID,作者,日期和提交消息
git log

### 提交列表僅显示提交消息和更改
git log -p

### 包含您要查找的特定字符串的提交列表
git log -S 'project'

### 作者提交的清單
git log --author 'wupx'

### 显示存儲庫中提交列表的摘要。显示提交ID和提交消息的較短版本。
git log --oneline

### 显示昨天以來倉庫中的提交列表
git log --since=yesterday

### 显示作者日誌,並在提交消息中搜索特定術語
git log --grep "project" --author "wupx"

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

堆 堆排序 優先隊列 圖文詳解(Golang實現)

引入

在實際應用中,我們經常需要從一組對象中查找最大值或最小值。當然我們可以每次都先排序,然後再進行查找,但是這種做法效率很低。哪么有沒有一種特殊的數據結構,可以高效率的實現我們的需求呢,答案就是堆(heap)

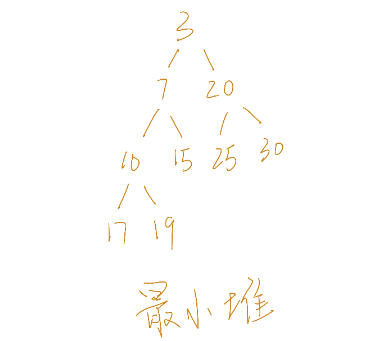
堆分為最小堆和最大堆,它們的性質相似,我們以最小堆為例子。

最小堆

舉例

如上圖所示,就為一個最小堆。

特性

  • 是一棵完全二叉樹

如果一顆二叉樹的任何結點,或者是樹恭弘=叶 恭弘,或者左右子樹均非空,則這棵二叉樹稱做滿二叉樹(full binary tree)

如果一顆二叉樹最多只有最下面的兩層結點度數可以小於2,並且最下面一層的結點都集中在該層最左邊的連續位置上,則此二叉樹稱做完全二叉樹(complete binary tree)

  • 局部有序

最小堆對應的完全二叉樹中所有結點的值均不大於其左右子結點的值,且一個結點與其兄弟之間沒有必然的聯繫

二叉搜索樹中,左子 < 父 < 右子

存儲結構

由於堆是一棵完全二叉樹,所以我們可以用順序結構來存儲它,只需要計算簡單的代數表達式,就能夠非常方便的查找某個結點的父結點和子節點,既避免了使用指針來保持結構,又能高效的執行相應操作。

結點i的左子結點為2xi+1,右子結點為2xi+2
結點i的父節點為(i-1)/2

數據結構

// 本例為最小堆
// 最大堆只需要修改less函數即可
type Heap []int

func (h Heap) swap(i, j int) {
    h[i], h[j] = h[j], h[i]
}

func (h Heap) less(i, j int) bool {
    return h[i] < h[j]
}

如上所示,我們使用slice來存儲我們的數據,為了後續方便我們在此定義了 swap 和 less 函數,分別用來交換兩個結點和比較大小。

插入-Push

如上圖所示,首先,新添加的元素加入末尾。為了保持最小堆的性質,需要沿着其祖先的路徑,自下而上依次比較和交換該結點與父結點的位置,直到重新滿足堆的性質為止。

這樣會出現兩種情況,要麼新結點升到最小堆的頂端,要麼到某一位置時發現父結點比新插入的結點關鍵值小。

上面的流程代碼如下:

func (h Heap) up(i int) {
    for {
        f := (i - 1) / 2 // 父親結點
        if i == f || h.less(f, i) {
            break
        }
        h.swap(f, i)
        i = f
    }
}

實現了最核心的 up 操作后,我們的插入操作 push 便很簡單,代碼如下:

// 注意go中所有參數轉遞都是值傳遞
// 所以要讓h的變化在函數外也起作用,此處得傳指針
func (h *Heap) Push(x int) {
    *h = append(*h, x)
    h.up(len(*h) - 1)
}

刪除-Remove

如上圖所示,首先把最末端的結點填入要刪除節點的位置,然後刪除末端元素,同理,這樣做也可能導致破壞最小堆的堆序特性。

為了保持堆的特性,末端元素需要與被刪除位置的父結點做比較,如果小於父結點,就要up(詳細代碼看插入)如果大於父結點,就要再和被刪除位置的子結點做比較,即down,直到該結點下降到小於最小子結點為止。

上面down的流程代碼如下:

func (h Heap) down(i int) {
    for {
        l := 2*i + 1 // 左孩子
        if l >= len(h) {
            break // i已經是恭弘=叶 恭弘子結點了
        }
        j := l
        if r := l + 1; r < len(h) && h.less(r, l) {
            j = r // 右孩子
        }
        if h.less(i, j) {
            break // 如果父結點比孩子結點小,則不交換
        }
        h.swap(i, j) // 交換父結點和子結點
        i = j        //繼續向下比較
    }
}

實現了核心的 down 操作后,我們的 Remove 便很簡單,代碼如下:

// 刪除堆中位置為i的元素
// 返回被刪元素的值
func (h *Heap) Remove(i int) (int, bool) {
    if i < 0 || i > len(*h)-1 {
        return 0, false
    }
    n := len(*h) - 1
    h.swap(i, n) // 用最後的元素值替換被刪除元素
    // 刪除最後的元素
    x := (*h)[n]
    *h = (*h)[0:n]
    // 如果當前元素大於父結點,向下篩選
    if (*h)[i] > (*h)[(i-1)/2] {
        h.down(i)
    } else { // 當前元素小於父結點,向上篩選
        h.up(i)
    }
    return x, true
}

彈出-Pop

當i=0時,Remove 就是 Pop

// 彈出堆頂的元素,並返回其值
func (h *Heap) Pop() int {
    n := len(*h) - 1
    h.swap(0, n)
    x := (*h)[n]
    *h = (*h)[0:n]
    h.down(0)
    return x
}

初始化-Init

在我們講完了堆的核心操作 up 和 down 后,我們來講如何根據一個數組構造一個最小堆。

其實我們可以寫個循環,然後將各個元素依次 push 進去,但是這次我們利用數學規律,直接由一個數組構造最小堆。

首先,將所有關鍵碼放到一維數組中,此時形成的完全二叉樹並不具備最小堆的特徵,但是僅包含恭弘=叶 恭弘子結點的子樹已經是堆。

即在有n個結點的完全二叉樹中,當 i>n/2-1 時,以i結點為根的子樹已經是堆。

func (h Heap) Init() {
    n := len(h)
    // i > n/2-1 的結點為恭弘=叶 恭弘子結點本身已經是堆了
    for i := n/2 - 1; i >= 0; i-- {
        h.down(i)
    }
}

測試

func main() {
    var h = heap.Heap{20, 7, 3, 10, 15, 25, 30, 17, 19}
    h.Init()
    fmt.Println(h) // [3 7 20 10 15 25 30 17 19]

    h.Push(6)
    fmt.Println(h) // [3 6 20 10 7 25 30 17 19 15]

    x, ok := h.Remove(5)
    fmt.Println(x, ok, h) // 25 true [3 6 15 10 7 20 30 17 19]

    y, ok := h.Remove(1)
    fmt.Println(y, ok, h) // 6 true [3 7 15 10 19 20 30 17]

    z := h.Pop()
    fmt.Println(z, h) // 3 [7 10 15 17 19 20 30]
}

完整代碼

堆排序

在講完堆的基礎知識后,我們再來看堆排序就變得非常簡單。利用最小堆的特性,我們每次都從堆頂彈出一個元素(這個元素就是當前堆中的最小值),即可實現升序排序。代碼如下:

// 堆排序
var res []int
for len(h) != 0 { 
    res = append(res, h.Pop())
}
fmt.Println(res)

優先隊列

優先隊列是0個或者多個元素的集合,每個元素都有一個關鍵碼,執行的操作有查找,插入和刪除等。

優先隊列的主要特點是支持從一個集合中快速地查找並移出具有最大值或最小值的元素。

堆是一種很好的優先隊列的實現方法。

參考資料

  • 《數據結構與算法》張銘 王騰蛟 趙海燕 編著
  • GO SDK 1.13.1 /src/container/heap

最後

本文是自己的學習筆記,在刷了幾道LeetCode中關於堆的題目后,感覺應該系統的學習和總結一下這一重要的數據結構了。

強烈建議看Go的源碼中關於heap的實現,仔細感受面向接口編程的思想,和他們的代碼風格以及質量。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

【集合系列】- 深入淺出的分析 Hashtable

一、摘要

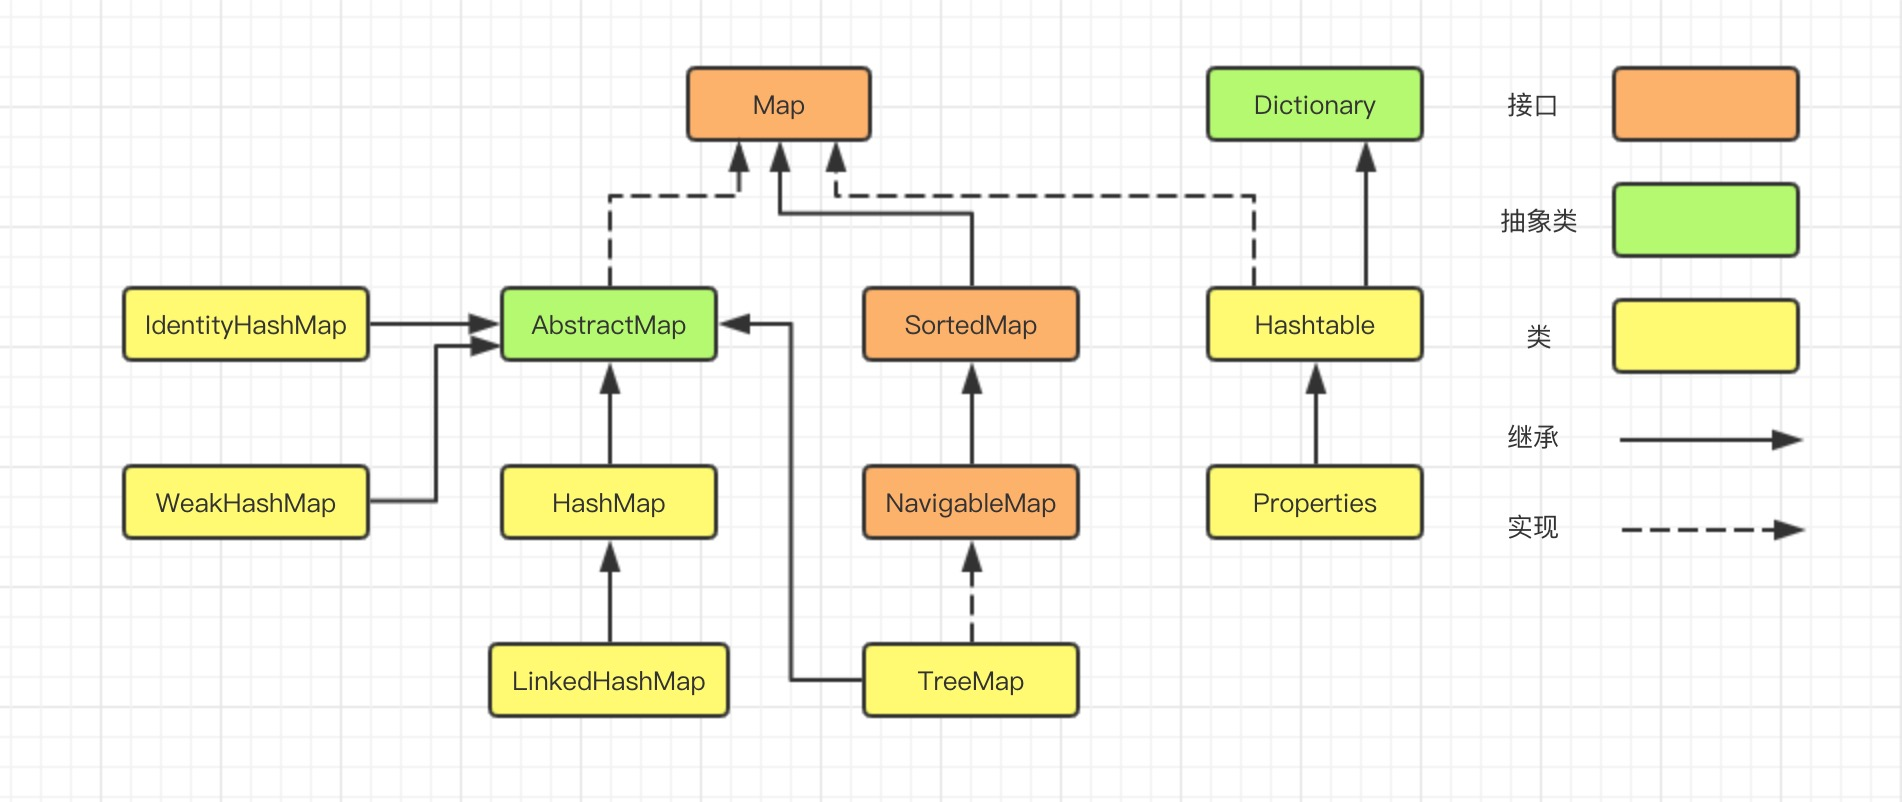
在集合系列的第一章,咱們了解到,Map 的實現類有 HashMap、LinkedHashMap、TreeMap、IdentityHashMap、WeakHashMap、Hashtable、Properties 等等。

本文主要從數據結構和算法層面,探討 Hashtable 的實現,如果有理解不當之處,歡迎指正。

二、簡介

Hashtable 一個元老級的集合類,早在 JDK 1.0 就誕生了,而 HashMap 誕生於 JDK 1.2,在實現上,HashMap 吸收了很多 Hashtable 的思想,雖然二者的底層數據結構都是 數組 + 鏈表 結構,具有查詢、插入、刪除快的特點,但是二者又有很多的不同。

打開 Hashtable 的源碼可以看到,Hashtable 繼承自 Dictionary,而 HashMap 繼承自 AbstractMap。

public class Hashtable<K,V>
    extends Dictionary<K,V>
    implements Map<K,V>, Cloneable, java.io.Serializable {
    .....
}

HashMap 繼承自 AbstractMap,HashMap 類的定義如下:

public class HashMap<K,V> extends AbstractMap<K,V>
    implements Map<K,V>, Cloneable, Serializable {
    .....
}

其中 Dictionary 類是一個已經被廢棄的類,翻譯過來的意思是這個類已經過時,新的實現應該實現 Map 接口而不是擴展此類,這一點我們可以從它代碼的註釋中可以看到:

/**
 * <strong>NOTE: This class is obsolete.  New implementations should
 * implement the Map interface, rather than extending this class.</strong>
 */
public abstract
class Dictionary<K,V> {
    ......
}

Hashtable 和 HashMap 的底層是以數組來存儲,同時,在存儲數據通過key計算數組下標的時候,是以哈希算法為主,因此可能會產生哈希衝突的可能性。

通俗的說呢,就是不同的key,在計算的時候,可能會產生相同的數組下標,這個時候,如何將兩個對象放入一個數組中呢?

而解決哈希衝突的辦法,有兩種,一種開放地址方式(當發生 hash 衝突時,就繼續以此繼續尋找,直到找到沒有衝突的hash值),另一種是拉鏈方式(將衝突的元素放入鏈表)。

Java Hashtable 採用的就是第二種方式,拉鏈法!

於是,當發生不同的key通過一系列的哈希算法計算獲取到相同的數組下標的時候,會將對象放入一個數組容器中,然後將對象以單向鏈表的形式存儲在同一個數組下標容器中,就像鏈子一樣,掛在某個節點上,如下圖:

與 HashMap 類似,Hashtable 也包括五個成員變量:

/**由Entry對象組成的數組*/
private transient Entry[] table;

/**Hashtable中Entry對象的個數*/
private transient int count;

/**Hashtable進行擴容的閾值*/
private int threshold;

/**負載因子,默認0.75*/
private float loadFactor;

/**記錄修改的次數*/
private transient int modCount = 0;

具體各個變量含義如下:

  • table:表示一個由 Entry 對象組成的鏈表數組,Entry 是一個單向鏈表,哈希表的key-value鍵值對都是存儲在 Entry 數組中的;
  • count:表示 Hashtable 的大小,用於記錄保存的鍵值對的數量;
  • threshold:表示 Hashtable 的閾值,用於判斷是否需要調整 Hashtable 的容量,threshold 等於容量 * 加載因子;
  • loadFactor:表示負載因子,默認為 0.75;
  • modCount:表示記錄 Hashtable 修改的次數,用來實現快速失敗拋異常處理;

接着來看看Entry這個內部類,Entry用於存儲鏈表數據,實現了Map.Entry接口,本質是就是一個映射(鍵值對),源碼如下:

 private static class Entry<K,V> implements Map.Entry<K,V> {
         /**hash值*/
        final int hash;
        /**key表示鍵*/
        final K key;
        /**value表示值*/
        V value;
        /**節點下一個元素*/
        Entry<K,V> next;
        ......
}

我們再接着來看看 Hashtable 初始化過程,核心源碼如下:

public Hashtable() {
    this(11, 0.75f);
}

this 調用了自己的構造方法,核心源碼如下:

public Hashtable(int initialCapacity, float loadFactor) {
        .....
        //默認的初始大小為 11
        //並且計算擴容的閾值
        this.loadFactor = loadFactor;
        table = new Entry<?,?>[initialCapacity];
        threshold = (int)Math.min(initialCapacity * loadFactor, MAX_ARRAY_SIZE + 1);
}

可以看到 HashTable 默認的初始大小為 11,如果在初始化給定容量大小,那麼 HashTable 會直接使用你給定的大小;

擴容的閾值threshold等於initialCapacity * loadFactor,我們在來看看 HashTable 擴容,方法如下:

protected void rehash() {
        int oldCapacity = table.length;
        //將舊數組長度進行位運算,然後 +1
        //等同於每次擴容為原來的 2n+1
        int newCapacity = (oldCapacity << 1) + 1;
        
        //省略部分代碼......
        Entry<?,?>[] newMap = new Entry<?,?>[newCapacity];
}

可以看到,HashTable 每次擴充為原來的 2n+1。

我們再來看看 HashMap,如果是執行默認構造方法,會在擴容那一步,進行初始化大小,核心源碼如下:

final Node<K,V>[] resize() {
    int newCap = 0;

    //部分代碼省略......
    newCap = DEFAULT_INITIAL_CAPACITY;//默認容量為 16
    Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
}

可以看出 HashMap 的默認初始化大小為 16,我們再來看看,HashMap 擴容方法,核心源碼如下:

final Node<K,V>[] resize() {
    //獲取舊數組的長度
    Node<K,V>[] oldTab = table;
    int oldCap = (oldTab == null) ? 0 : oldTab.length;
    int newCap = 0;

    //部分代碼省略......
    //當進行擴容的時候,容量為 2 的倍數
    newCap = oldCap << 1;
    Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
}

可以看出 HashMap 的擴容后的數組數量為原來的 2 倍;

也就是說 HashTable 會盡量使用素數、奇數來做數組的容量,而 HashMap 則總是使用 2 的冪作為數組的容量。

我們知道當哈希表的大小為素數時,簡單的取模哈希的結果會更加均勻,所以單從這一點上看,HashTable 的哈希表大小選擇,似乎更高明些。

Hashtable 的 hash 算法,核心代碼如下:

//直接計算key.hashCode()
int hash = key.hashCode();

//通過除法取余計算數組存放下標
// 0x7FFFFFFF 是最大的 int 型數的二進製表示
int index = (hash & 0x7FFFFFFF) % tab.length;

從源碼部分可以看出,HashTable 的 key 不能為空,否則報空指針錯誤!

但另一方面我們又知道,在取模計算時,如果模數是 2 的冪,那麼我們可以直接使用位運算來得到結果,效率要大大高於做除法。所以在 hash 計算數組下標的效率上,HashMap 卻更勝一籌,但是這也會引入了哈希分佈不均勻的問題, HashMap 為解決這問題,又對 hash 算法做了一些改動,具體我們來看看。

HashMap 的 hash 算法,核心代碼如下:

/**獲取hash值方法*/
static final int hash(Object key) {
     int h;
     // h = key.hashCode() 為第一步 取hashCode值(jdk1.7)
     // h ^ (h >>> 16)  為第二步 高位參与運算(jdk1.7)
     return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);//jdk1.8
}

/**獲取數組下標方法*/
static int indexFor(int h, int length) {
    //jdk1.7的源碼,jdk1.8沒有這個方法,但是實現原理一樣的
     return h & (length-1);  //第三步 取模運算
}

HashMap 由於使用了2的冪次方,所以在取模運算時不需要做除法,只需要位的與運算就可以了。但是由於引入的 hash 衝突加劇問題,HashMap 在調用了對象的 hashCode 方法之後,又做了一些高位運算,也就是第二步方法,來打散數據,讓哈希的結果更加均勻。

與此同時,在 jdk1.8 中 HashMap 還引進來紅黑樹實現,當衝突鏈表長度大於 8 的時候,會將鏈表結構改變成紅黑樹結構,讓查詢變得更快,具體實現可以參見《集合系列》中的 HashMap 分析。

三、常用方法介紹

3.1、put方法

put 方法是將指定的 key, value 對添加到 map 里。

put 流程圖如下:

打開 HashTable 的 put 方法,源碼如下:

public synchronized V put(K key, V value) {
        //當 value 值為空的時候,拋異常!
        if (value == null) {
            throw new NullPointerException();
        }

        Entry<?,?> tab[] = table;

        //通過key 計算存儲下標
        int hash = key.hashCode();
        int index = (hash & 0x7FFFFFFF) % tab.length;
        
        //循環遍曆數組鏈表
        //如果有相同的key並且hash相同,進行覆蓋處理
        Entry<K,V> entry = (Entry<K,V>)tab[index];
        for(; entry != null ; entry = entry.next) {
            if ((entry.hash == hash) && entry.key.equals(key)) {
                V old = entry.value;
                entry.value = value;
                return old;
            }
        }
        //加入數組鏈表中
        addEntry(hash, key, value, index);
        return null;
}

put 方法中的 addEntry 方法,源碼如下:

private void addEntry(int hash, K key, V value, int index) {
        //新增修改次數
        modCount++;

        Entry<?,?> tab[] = table;
        if (count >= threshold) {
           //數組容量大於擴容閥值,進行擴容
            rehash();
            
            tab = table;
            //重新計算對象存儲下標
            hash = key.hashCode();
            index = (hash & 0x7FFFFFFF) % tab.length;
        }

        //將對象存儲在數組中
        Entry<K,V> e = (Entry<K,V>) tab[index];
        tab[index] = new Entry<>(hash, key, value, e);
        count++;
}

addEntry 方法中的 rehash 方法,源碼如下:

protected void rehash() {
        int oldCapacity = table.length;
        Entry<?,?>[] oldMap = table;

        //每次擴容為原來的 2n+1
        int newCapacity = (oldCapacity << 1) + 1;
        if (newCapacity - MAX_ARRAY_SIZE > 0) {
            if (oldCapacity == MAX_ARRAY_SIZE)
                //大於最大閥值,不再擴容
                return;
            newCapacity = MAX_ARRAY_SIZE;
        }
        Entry<?,?>[] newMap = new Entry<?,?>[newCapacity];

        modCount++;
        //重新計算擴容閥值
        threshold = (int)Math.min(newCapacity * loadFactor, MAX_ARRAY_SIZE + 1);
        table = newMap;
        //將舊數組中的數據複製到新數組中
        for (int i = oldCapacity ; i-- > 0 ;) {
            for (Entry<K,V> old = (Entry<K,V>)oldMap[i] ; old != null ; ) {
                Entry<K,V> e = old;
                old = old.next;

                int index = (e.hash & 0x7FFFFFFF) % newCapacity;
                e.next = (Entry<K,V>)newMap[index];
                newMap[index] = e;
            }
        }
}

總結流程如下:

  • 1、通過 key 計算對象存儲在數組中的下標;
  • 2、如果鏈表中有 key,直接進行新舊值覆蓋處理;
  • 3、如果鏈表中沒有 key,判斷是否需要擴容,如果需要擴容,先擴容,再插入數據;

有一個值得注意的地方是 put 方法加了synchronized關鍵字,所以,在同步操作的時候,是線程安全的。

3.2、get方法

get 方法根據指定的 key 值返回對應的 value。

get 流程圖如下:

打開 HashTable 的 get 方法,源碼如下:

public synchronized V get(Object key) {
        Entry<?,?> tab[] = table;
        //通過key計算節點存儲下標
        int hash = key.hashCode();
        int index = (hash & 0x7FFFFFFF) % tab.length;
        for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) {
            if ((e.hash == hash) && e.key.equals(key)) {
                return (V)e.value;
            }
        }
        return null;
}

同樣,有一個值得注意的地方是 get 方法加了synchronized關鍵字,所以,在同步操作的時候,是線程安全的。

3.3、remove方法

remove 的作用是通過 key 刪除對應的元素。

remove 流程圖如下:

打開 HashTable 的 remove 方法,源碼如下:

public synchronized V remove(Object key) {
        Entry<?,?> tab[] = table;
        //通過key計算節點存儲下標
        int hash = key.hashCode();
        int index = (hash & 0x7FFFFFFF) % tab.length;
        Entry<K,V> e = (Entry<K,V>)tab[index];
        //循環遍歷鏈表,通過hash和key判斷鍵是否存在
        //如果存在,直接將改節點設置為空,並從鏈表上移除
        for(Entry<K,V> prev = null ; e != null ; prev = e, e = e.next) {
            if ((e.hash == hash) && e.key.equals(key)) {
                modCount++;
                if (prev != null) {
                    prev.next = e.next;
                } else {
                    tab[index] = e.next;
                }
                count--;
                V oldValue = e.value;
                e.value = null;
                return oldValue;
            }
        }
        return null;
}

同樣,有一個值得注意的地方是 remove 方法加了synchronized關鍵字,所以,在同步操作的時候,是線程安全的。

四、總結

總結一下 Hashtable 與 HashMap 的聯繫與區別,內容如下:

  • 1、雖然 HashMap 和 Hashtable 都實現了 Map 接口,但 Hashtable 繼承於 Dictionary 類,而 HashMap 是繼承於 AbstractMap;
  • 2、HashMap 可以允許存在一個為 null 的 key 和任意個為 null 的 value,但是 HashTable 中的 key 和 value 都不允許為 null;
  • 3、Hashtable 的方法是同步的,因為在方法上加了 synchronized 同步鎖,而 HashMap 是非線程安全的;

儘管,Hashtable 雖然是線程安全的,但是我們一般不推薦使用它,因為有比它更高效、更好的選擇 ConcurrentHashMap,在後面我們也會講到它。

最後,引入來自 HashTable 的註釋描述:

If a thread-safe implementation is not needed, it is recommended to use HashMap in place of Hashtable. If a thread-safe highly-concurrent implementation is desired, then it is recommended to use java.util.concurrent.ConcurrentHashMap in place of Hashtable.

簡單來說就是,如果你不需要線程安全,那麼使用 HashMap,如果需要線程安全,那麼使用 ConcurrentHashMap。

HashTable 已經被淘汰了,不要在新的代碼中再使用它。

五、參考

1、JDK1.7&JDK1.8 源碼

2、

作者:炸雞可樂
出處:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

基於 HTML5 WebGL 和 VR 技術的 3D 機房數據中心可視化


前言

在 3D 機房數據中心可視化應用中,隨着視頻監控聯網系統的不斷普及和發展, 網絡攝像機更多的應用於監控系統中,尤其是高清時代的來臨,更加快了網絡攝像機的發展和應用。

在監控攝像機數量的不斷龐大的同時,在監控系統中面臨着嚴峻的現狀問題:海量視頻分散、孤立、視角不完整、位置不明確等問題,始終圍繞着使用者。因此,如何更直觀、更明確的管理攝像機和掌控視頻動態,已成為提升視頻應用價值的重要話題。所以當前項目正是從解決此現狀問題的角度,應運而生。圍繞如何提高、管理和有效利用前端設備採集的海量信息為公共安全服務,特別是在技術融合大趨勢下,如何結合當前先進的視頻融合,虛實融合、三維動態等技術,實現三維場景實時動態可視化監控,更有效的識別、分析、挖掘海量數據的有效信息服務公共應用,已成為視頻監控平台可視化發展的趨勢和方向。目前,在監控行業中,海康、大華等做監控行業領導者可基於這樣的方式規劃公共場所園區等的攝像頭規劃安放布局,可以通過海康、大華等攝像頭品牌的攝像頭參數,調整系統中攝像頭模型的可視範圍,監控方向等,更方便的讓人們直觀的了解攝像頭的監控區域,監控角度等。

以下是項目地址:

效果預覽

整體場景-攝像頭效果圖

局部場景-攝像頭效果圖

代碼生成
攝像頭模型及場景

項目中使用的攝像頭模型是通過 3dMax 建模生成的,該建模工具可以導出 obj 與 mtl 文件,在 HT 中可以通過解析 obj 與 mtl 文件來生成 3d 場景中的攝像頭模型。

項目中場景通過 HT 的 3d 編輯器進行搭建,場景中的模型有些是通過 HT 建模,有些通過 3dMax 建模,之後導入 HT 中,場景中的地面白色的燈光,是通過 HT 的 3d 編輯器進行地面貼圖呈現出來的效果。

錐體建模

3D 模型是由最基礎的三角形面拼接合成,例如 1 個矩形可以由 2 個三角形構成,1 個立方體由 6 個面即 12 個三角形構成, 以此類推更複雜的模型可以由許多的小三角形組合合成。因此 3D 模型定義即為對構造模型的所有三角形的描述, 而每個三角形由三個頂點 vertex 構成, 每個頂點 vertex 由 x, y, z 三維空間坐標決定,HT 採用右手螺旋定則來確定三個頂點構造三角形面的正面。

HT 中通過 ht.Default.setShape3dModel(name, model) 函數,可註冊自定義 3D 模型,攝像頭前方生成的錐體便是通過該方法生成。可以將該錐體看成由 5 個頂點,6 個三角形組成,具體圖如下:

ht.Default.setShape3dModel(name, model)

1. name 為模型名稱,如果名稱與預定義的一樣,則會替換預定義的模型 
2. model 為JSON類型對象,其中 vs 表示頂點坐標數組,is 表示索引數組,uv 表示貼圖坐標數組,如果想要單獨定義某個面,可以通過 bottom_vs,bottom_is,bottom_uv,top_vs,top_is, top_uv 等來定義,之後便可以通過 shape3d.top.*, shape3d.bottom.*  等單獨控制某個面

以下是我定義模型的代碼:

// camera 是當前的攝像頭圖元
// fovy 為攝像頭的張角的一半的 tan 值
var setRangeModel = function(camera, fovy) {
    var fovyVal = 0.5 * fovy; var pointArr = [0, 0, 0, -fovyVal, fovyVal, 0.5, fovyVal, fovyVal, 0.5, fovyVal, -fovyVal, 0.5, -fovyVal, -fovyVal, 0.5]; ht.Default.setShape3dModel(camera.getTag(), [{ vs: pointArr, is: [2, 1, 0, 4, 1, 0, 4, 3, 0, 3, 2, 0], from_vs: pointArr.slice(3, 15), from_is: [3, 1, 0, 3, 2, 1], from_uv: [0, 0, 1, 0, 1, 1, 0, 1] }]); }

我將當前攝像頭的 tag 標籤值作為模型的名稱,tag 標籤在 HT 中用於唯一標識一個圖元,用戶可以自定義 tag 的值。通過 pointArr 記錄當前五面體的五個頂點坐標信息,代碼中通過 from_vs, from_is, from_uv 單獨構建五面體底面,底面用於显示當前攝像頭呈現的圖像。

代碼中設置了錐體 style 對象的 wf.geometry 屬性,通過該屬性可以為錐體添加模型的線框,增強模型的立體效果,並且通過 wf.color,wf.width 等參數調節線框的顏色,粗細等。

相關模型 style 屬性的設置代碼如下:

 1 rangeNode.s({
 2     'shape3d': cameraName, 3 // 攝像頭模型名稱 4 'shape3d.color': 'rgba(52, 148, 252, 0.3)', 5 // 錐體模型顏色 6 'shape3d.reverse.flip': true, 7 // 錐體模型的反面是否显示正面的內容 8 'shape3d.light': false, 9 // 錐體模型是否受光線影響 10 'shape3d.transparent': true, 11 // 錐體模型是否透明 12 '3d.movable': false, 13 // 錐體模型是否可移動 14 'wf.geometry': true // 是否显示錐體模型線框 15 });

攝像頭圖像生成原理

透視投影

透視投影是為了獲得接近真實三維物體的視覺效果而在二維的紙或者畫布平面上繪圖或者渲染的一種方法,它也稱為透視圖。 透視使得遠的對象變小,近的對象變大,平行線會出現先交等更更接近人眼觀察的視覺效果。

如上圖所示,透視投影最終显示到屏幕上的內容只有截頭錐體( View Frustum )部分的內容, 因此 Graph3dView 提供了 eye, center, up, far,near,fovy 和 aspect 參數來控制截頭錐體的具體範圍。具體的透視投影可以參考 HT for Web 的  手冊。

根據上圖的描述,在本項目中可以在攝像頭初始化之後,緩存當前 3d 場景 eyes 眼睛的位置,以及 center 中心的位置,之後將 3d 場景 eyes 眼睛和 center 中心設置成攝像頭中心點的位置,然後在這個時刻獲取當前 3d 場景的截圖,該截圖即為當前攝像頭的監控圖像,之後再將 3d 場景的 center 與 eyes 設置成開始時緩存的 eyes 與 center 位置,通過該方法即可實現 3d 場景中任意位置的快照,從而實現攝像頭監控圖像實時生成。

相關偽代碼如下:

 1 function getFrontImg(camera, rangeNode) {
 2     var oldEye = g3d.getEye(); 3 var oldCenter = g3d.getCenter(); 4 var oldFovy = g3d.getFovy(); 5  g3d.setEye(攝像頭位置); 6  g3d.setCenter(攝像頭朝向); 7  g3d.setFovy(攝像頭張角); 8  g3d.setAspect(攝像頭寬高比); 9  g3d.validateImp(); 10  g3d.toDataURL(); 11  g3d.setEye(oldEye);; 12  g3d.setCenter(oldCenter); 13  g3d.setFovy(oldFovy); 14  g3d.setAspect(undefined); 15  g3d.validateImp(); 16 }

經過測試之後,通過該方法進行圖像的獲取會導致頁面有所卡頓,因為是獲取當前 3d 場景的整體截圖,由於當前3d場景是比較大的,所以 toDataURL 獲取圖像信息是非常慢的,因此我採取了離屏的方式來獲取圖像,具體方式如下:
   1. 創建一個新的 3d 場景,將當前場景的寬度與高度都設置為 200px 的大小,並且當前 3d 場景的內容與主屏的場景是一樣的,HT中通過 new ht.graph3d.Graph3dView(dataModel) 來新建場景,其中的 dataModel 為當前場景的所有圖元,所以主屏與離屏的 3d 場景都共用同一個 dataModel,保證了場景的一致。
   2. 將新創建的場景位置設置成屏幕看不到的地方,並且添加進 dom 中。
   3. 將之前對主屏獲取圖像的操作變成對離屏獲取圖像的操作,此時離屏圖像的大小相對之前主屏獲取圖像的大小小很多,並且離屏獲取不需要保存原來的眼睛 eyes 的位置以及 center 中心的位置,因為我們沒有改變主屏的 eyes 與 center 的位置, 所以也減少的切換帶來的開銷,大大提高了攝像頭獲取圖像的速度。

以下是該方法實現的代碼:

 1 function getFrontImg(camera, rangeNode) {
 2     // 截取當前圖像時將該攝像頭所屬的五面體隱藏
 3     rangeNode.s('shape3d.from.visible', false); 4 rangeNode.s('shape3d.visible', false); 5 rangeNode.s('wf.geometry', false); 6 var cameraP3 = camera.p3(); 7 var cameraR3 = camera.r3(); 8 var cameraS3 = camera.s3(); 9 var updateScreen = function() { 10  demoUtil.Canvas2dRender(camera, outScreenG3d.getCanvas()); 11  rangeNode.s({ 12 'shape3d.from.image': camera.a('canvas') 13  }); 14 rangeNode.s('shape3d.from.visible', true); 15 rangeNode.s('shape3d.visible', true); 16 rangeNode.s('wf.geometry', true); 17  }; 18 19 // 當前錐體起始位置 20 var realP3 = [cameraP3[0], cameraP3[1] + cameraS3[1] / 2, cameraP3[2] + cameraS3[2] / 2]; 21 // 將當前眼睛位置繞着攝像頭起始位置旋轉得到正確眼睛位置 22 var realEye = demoUtil.getCenter(cameraP3, realP3, cameraR3); 23 24  outScreenG3d.setEye(realEye); 25 outScreenG3d.setCenter(demoUtil.getCenter(realEye, [realEye[0], realEye[1], realEye[2] + 5], cameraR3)); 26 outScreenG3d.setFovy(camera.a('fovy')); 27  outScreenG3d.validate(); 28  updateScreen(); 29 }


上面代碼中有一個 getCenter 方法是用於獲取 3d 場景中點 A 繞着點 B 旋轉 angle 角度之後得到的點 A 在 3d 場景中的位置,方法中採用了 HT 封裝的 ht.Math 下面的方法,以下為代碼:

 1 // pointA 為 pointB 圍繞的旋轉點
 2 // pointB 為需要旋轉的點
 3 // r3 為旋轉的角度數組 [xAngle, yAngle, zAngle] 為繞着 x, y, z 軸分別旋轉的角度 
 4 var getCenter = function(pointA, pointB, r3) {
 5     var mtrx = new ht.Math.Matrix4(); 6 var euler = new ht.Math.Euler(); 7 var v1 = new ht.Math.Vector3(); 8 var v2 = new ht.Math.Vector3(); 9 10 mtrx.makeRotationFromEuler(euler.set(r3[0], r3[1], r3[2])); 11 12  v1.fromArray(pointB).sub(v2.fromArray(pointA)); 13  v2.copy(v1).applyMatrix4(mtrx); 14  v2.sub(v1); 15 16 return [pointB[0] + v2.x, pointB[1] + v2.y, pointB[2] + v2.z]; 17 };

這裏應用到向量的部分知識,具體如下:

OA + OB = OC

方法分為以下幾個步驟求解:

   1.  var mtrx = new ht.Math.Matrix4() 創建一個轉換矩陣,通過 mtrx.makeRotationFromEuler(euler.set(r3[0], r3[1], r3[2])) 獲取繞着 r3[0],r3[1],r3[2] 即 x 軸,y 軸,z 軸旋轉的旋轉矩陣。
   2. 通過 new ht.Math.Vector3() 創建 v1,v2 兩個向量。
   3. v1.fromArray(pointB) 為建立一個從原點到 pointB 的一個向量。
   4. v2.fromArray(pointA) 為建立一個從原點到 pointA 的一個向量。
   5. v1.fromArray(pointB).sub(v2.fromArray(pointA)) 即向量 OB – OA 此時得到的向量為 AB,此時 v1 變為向量 AB。
   6. v2.copy(v1) v2 向量拷貝 v1 向量,之後通過 v2.copy(v1).applyMatrix4(mtrx) 對 v2 向量應用旋轉矩陣,變換之後即為 v1向量繞着 pointA 旋轉之後的的向量 v2。
   7. 此時通過 v2.sub(v1) 就獲取了起始點為 pointB,終點為 pointB 旋轉之後點構成的向量,該向量此時即為 v2。
   8. 通過向量公式得到旋轉之後的點為 [pointB[0] + v2.x, pointB[1] + v2.y, pointB[2] + v2.z]。

項目中的 3D 場景例子其實是  最近貴州數博會,HT 上工業互聯網展台的 VR 示例,大眾對 VR/AR 的期待很高,但路還是得一步步走,即使融資了 23 億美金的 Magic Leap 的第一款產品也只能是 ,這話題以後再展開,這裏就上段當時現場的視頻照片:

2d 圖像貼到 3d 模型

通過上一步的介紹我們可以獲取當前攝像機位置的截屏圖像,那麼如何將當前圖像貼到前面所構建的五面體底部呢?前面通過 from_vs, from_is 來構建底部的長方形,所以在 HT 中可以通過將五面體的 style 中 shape3d.from.image 屬性設置成當前圖像,其中 from_uv 數組用來定義貼圖的位置,具體如下圖:

以下為定義貼圖位置 from_uv 的代碼:

 1 from_uv: [0, 0, 1, 0, 1, 1, 0, 1] 

from_uv 就是定義貼圖的位置數組,根據上圖的解釋,可以將 2d 圖像貼到 3d 模型的 from 面。

控制面板

HT 中通過 new ht.widget.Panel() 來生成如下圖的面板:

面板中每個攝像頭都有一個模塊來呈現當前監控圖像,其實這個地方也是一個 canvas,該 canvas 與場景中錐體前面的監控圖像是同一個 canvas,每一個攝像頭都有一個自己的 canvas 用來保存當前攝像頭的實時監控畫面,這樣就可以將該 canvas 貼到任何地方,將該 canvas 添加進面板的代碼如下:

 1 formPane.addRow([{ 2 element: camera.a(‘canvas’) 3 }], 240, 240); 

代碼中將 canvas 節點存儲在攝像頭圖元的 attr 屬性下面,之後便可以通過 camera.a(‘canvas’) 來獲取當前攝像頭的畫面。

在面板中的每一個控制節點都是通過 formPane.addRow 來進行添加,具體可參考 HT for Web 的。之後通過 ht.widget.Panel 將表單面板 formPane 添加進 panel 面板中,具體可參考 HT for Web 的。

部分控制代碼如下:

 1 formPane.addRow(['rotateY', {
 2  slider: { 3 min: -Math.PI, 4  max: Math.PI, 5 value: r3[1], 6 onValueChanged: function() { 7 var cameraR3 = camera.r3(); 8 camera.r3([cameraR3[0], this.getValue(), cameraR3[2]]); 9 rangeNode.r3([cameraR3[0], this.getValue(), cameraR3[2]]); 10  getFrontImg(camera, rangeNode); 11  } 12  } 13 }], [0.1, 0.15]);

控制面板通過 addRow 來添加控制元素,以上代碼為添加攝像頭繞着 y 軸進行旋轉的控制,onValueChanged 在 slider 的數值改變的時候調用,此時通過 camera.r3() 獲取當前攝像頭的旋轉參數, 由於是繞着 y 軸旋轉所以 x 軸與 z 軸的角度是不變的,變的是 y 軸的旋轉角度,所以通過 camera.r3([cameraR3[0], this.getValue(), cameraR3[2]]) 來調整攝像頭的旋轉角度以及通過 rangeNode.r3([cameraR3[0], this.getValue(), cameraR3[2]]) 來設置攝像頭前方錐體的旋轉角度,然後調用之前封裝好的 getFrontImg 函數來獲取此時旋轉角度下面的實時圖像信息。

項目中通過 Panel 面板的配置參數 titleBackground: rgba(230, 230, 230, 0.4) 即可將標題背景設置為具有透明度的背景,其它類似的 titleColor, titleHeight 等標題參數都可以配置,通過 separatorColor,separatorWidth 等分割參數可以設置內部面板之間分割線的顏色,寬度等。最後面板通過 panel.setPositionRelativeTo(‘rightTop’) 將面板的位置設置成右上角,並且通過 document.body.appendChild(panel.getView()) 將面板最外層的 div 添加進頁面中, panel.getView() 用來獲取面板的最外層 dom 節點。

具體初始化面板代碼如下:

 1 function initPanel() {
 2     var panel = new ht.widget.Panel(); 3 var config = { 4 title: "攝像頭控制面板", 5 titleBackground: 'rgba(230, 230, 230, 0.4)', 6 titleColor: 'rgb(0, 0, 0)', 7 titleHeight: 30, 8 separatorColor: 'rgb(67, 175, 241)', 9 separatorWidth: 1, 10 exclusive: true, 11  items: [] 12  }; 13 cameraArr.forEach(function(data, num) { 14 var camera = data['camera']; 15 var rangeNode = data['rangeNode']; 16 var formPane = new ht.widget.FormPane(); 17  initFormPane(formPane, camera, rangeNode); 18  config.items.push({ 19 title: "攝像頭" + (num + 1), 20 titleBackground: 'rgba(230, 230, 230, 0.4)', 21 titleColor: 'rgb(0, 0, 0)', 22 titleHeight: 30, 23 separatorColor: 'rgb(67, 175, 241)', 24 separatorWidth: 1, 25  content: formPane, 26 flowLayout: true, 27 contentHeight: 400, 28 width: 250, 29 expanded: num === 0 30  }); 31  }); 32  panel.setConfig(config); 33 panel.setPositionRelativeTo('rightTop'); 34  document.body.appendChild(panel.getView()); 35 window.addEventListener("resize", 36 function() { 37  panel.invalidate(); 38  }); 39 }

在控制面板中可以調整攝像頭的方向,攝像頭監控的輻射範圍,攝像頭前方錐體的長度等等,並且攝像頭的圖像是實時生成,以下為運行截圖:

以下是本項目採用的 3D 場景結合 HT for Web 的 VR 技術實現的操作:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!