預訓練語言模型整理(ELMo/GPT/BERT…)

目錄

簡介

2018年ELMo/GPT/BERT的相繼提出,不斷刷新了各大NLP任務排行榜,自此,NLP終於找到了一種方法,可以像計算機視覺那樣進行遷移學習,被譽為NLP新時代的開端。
與計算機視覺領域預訓練模型不同的是,其通過採用自監督學習的方法,將大量的無監督文本送入到模型中進行學習,即可得到通用的預訓練模型,而NLP領域中無監督文本數據要多少有多少,2019年發布的後續研究工作(GPT2、Roberta、T5等)表明,採用更大的數據、更強大的煉丹爐可以不斷提高模型性能表現,至少目前看來還沒有達到上限。同時,如何縮減模型參數也成為了另一個研究熱點,並有相應的論文在今年發表(ALBERT、ELECTRA)。這一類工作為NLP研發者趟通並指明了一條光明大道:就是通過自監督學習,把大量非監督的文本充分利用起來,並將其中的語言知識編碼,對各種下游NLP任務產生巨大的积極作用。
為何預訓練語言模型能夠達到如此好的效果?主要有如下幾點:

  • word2vec等詞向量模型訓練出來的都是靜態的詞向量,即同一個詞,在任何的上下文當中,其向量表徵是相同的,顯然,這樣的一種詞向量是無法體現一個詞在不同語境中的不同含義的。
  • 我們採用預訓練模型來代替詞向量的關鍵在於,其能夠更具上下文的不同,對上下文中的詞提取符合其語境的詞表徵,該詞表徵向量為一個動態向量,即不同上下文輸入預訓練模型后,同一個詞的詞表徵向量在兩個上下文中的詞表徵是不同的。
    本文將對一下幾個模型進行簡單的總結,主要關注點在於各大模型的主要結構,預訓練任務,以及創新點:
  • ELMo
  • GPT
  • BERT
  • BERT-wwm
  • ERNIE_1.0
  • XLNET
  • ERNIE_2.0
  • RoBERTa
  • (ALBERT/ELECTRA)
  • …

預訓練任務簡介

總的來說,預訓練模型包括兩大類:自回歸語言模型與自編碼語言模型

自回歸語言模型

通過給定文本的上文,對當前字進行預測,訓練過程要求對數似然函數最大化,即:
\[max_{\theta} \ logp_{\theta}(x) = \sum_{t=1}^{T}log \ p_{\theta}(x_t|x_{<t})\]

代表模型:ELMo/GPT1.0/GPT2.0/XLNet
優點:該模型對文本序列聯合概率的密度估計進行建模,使得該模型更適用於一些生成類的NLP任務,因為這些任務在生成內容的時候就是從左到右的,這和自回歸的模式天然匹配。
缺點:聯合概率是按照文本序列從左至右進行計算的,因此無法得到包含上下文信息的雙向特徵表徵;

自編碼語言模型

BERT系列的模型為自編碼語言模型,其通過隨機mask掉一些單詞,在訓練過程中根據上下文對這些單詞進行預測,使預測概率最大化,即
\[max_{\theta} \ logp_{\theta}(\bar{x}|\hat{x}) \approx \sum_{t=1}^{T}log \ m_tp_{\theta}(x_t|\hat{x}) = \sum_{t=1}^{T}log \ m_tlog\frac{exp(H_{\theta}(\hat{x})_t^Te(x_t))}{\sum_{x’}exp(H_{\theta}(\hat{x})_t^Te(x’))}\]

其本質為去噪自編碼模型,加入的 [MASK] 即為噪聲,模型對 [MASK] 進行預測即為去噪。
優點:能夠利用上下文信息得到雙向特徵表示
缺點:其引入了獨立性假設,即每個 [MASK] 之間是相互獨立的,這使得該模型是對語言模型的聯合概率的有偏估計;另外,由於預訓練中 [MASK] 的存在,使得模型預訓練階段的數據與微調階段的不匹配,使其難以直接用於生成任務。

預訓練模型的簡介與對比

ELMo

原文鏈接:

ELMo為一個典型的自回歸預訓練模型,其包括兩個獨立的單向LSTM實現的單向語言模型進行自回歸預訓練,不使用雙向的LSTM進行編碼的原因正是因為在預訓練任務中,雙向模型將提前看到上下文表徵而對預測結果造成影響。因此,ELMo在本質上還是屬於一個單向的語言模型,因為其只在一個方向上進行編碼錶征,只是將其拼接了而已

細節

  • 引入雙向語言模型,其實是2個單向語言模型(前向和後向)的集成,這樣做的原因在上一節已經解釋過了,用共享詞向量來進行預訓練;
  • 通過保存預訓練好的2層biLSTM,提取每層的詞表徵用於下游任務;

ELMo的下游使用

  • 對於每一個字符,其每一層的ELMo表徵均為輸入詞向量與該層的雙向編碼錶征拼接而成,即:
    \[R_k = \{x^{LM}_k, \overrightarrow{h}^{LM}_{k,j}, \overleftarrow{h}^{LM}_{k,j} | j = 1, …, L\} = \{h^{LM}_{k,j}|j = 0, …, L\}\]

  • 對於下游任務而言,我們需要把所有層的ELMo表徵整合為一個單獨的向量,最簡單的方式是只用最上層的表徵,而更一般的,我們採用對所有層的ELMo表徵採取加權和的方式進行處理,即:
    \[ELMo^{task}_k = E(R_k; \theta ^{task}) = \gamma ^{task}\sum_{j=0}^L s^{task}h^{LM}_{k,j}\]

其中\(s^{task}\)可以作為學習參數,為一個歸一化的權重因子,用於表示每一層的詞向量在整體的重要性。\(\gamma ^{task}\)為縮放參數,允許具體的task模型去放縮 ELMo 的大小,因為ELMo的表徵分佈與具體任務的表徵分佈不一定是一樣的,可以將其作為一個輔助特徵參數。

  • 得到ELMo表徵之後,則需要將其用於下游任務中去,注意,ELMo的微調過程中,並不是嚴格意義上的微調,預訓練模型部分通常是固定的,不參与到後續訓練當中。具體的,有以下幾種操作方法:
    • 方法一:直接將ELMo表徵與詞向量拼接,輸入到下游任務當中去;
    • 方法二:直接將ELMo表徵與下游模型的輸出層拼接
    • 另外,還可以在ELMo模型中加入dropout, 以及採用 L2 loss的方法來提升模型。

GPT/GPT2

GPT:
GPT2:

GPT

GPT是“Generative Pre-Training”的簡稱,從名字上就可以看出其是一個生成式的預訓練模型,即與ELMo類似,是一個自回歸語言模型。與ELMo不同的是,其採用多層Transformer Decoder作為特徵抽取器,多項研究也表明,Transformer的特徵抽取能力是強於LSTM的。

細節

  • 由於GPT仍然是一個生成式的語言模型,因此需要採用Mask Multi-Head Attention的方式來避免預測當前詞的時候會看見之後的詞,因此將其稱為單向Transformer,這也是首次將Transformer應用於預訓練模型,預測的方式就是將position-wise的前向反饋網絡的輸出直接送入分類器進行預測
  • 此外整個GPT的訓練包括預訓練和微調兩個部分,或者說,對於具體的下游任務,其模型結構也必須採用與預訓練相同的結構,區別僅在於數據需要進行不同的處理

微調

對於帶有標籤\(y\)的監督數據\([x_1, …, x_m]\),我們直接將其輸入到已經完成預訓練的模型中,然後利用最後一個位置的輸出對標籤進行預測,即
\[P(y|x^1, …, x^m) = softmax(h_l^mW_y)\]

其中,\(W_y\)為分類器的參數,\(h_l^m\)為最後一層最後一個位置的輸出。則最大化優化目標即為:
\[ L_2(C) = \sum_{(x, y)}^{T}log \ P(y|x^1, …, x^m)\]

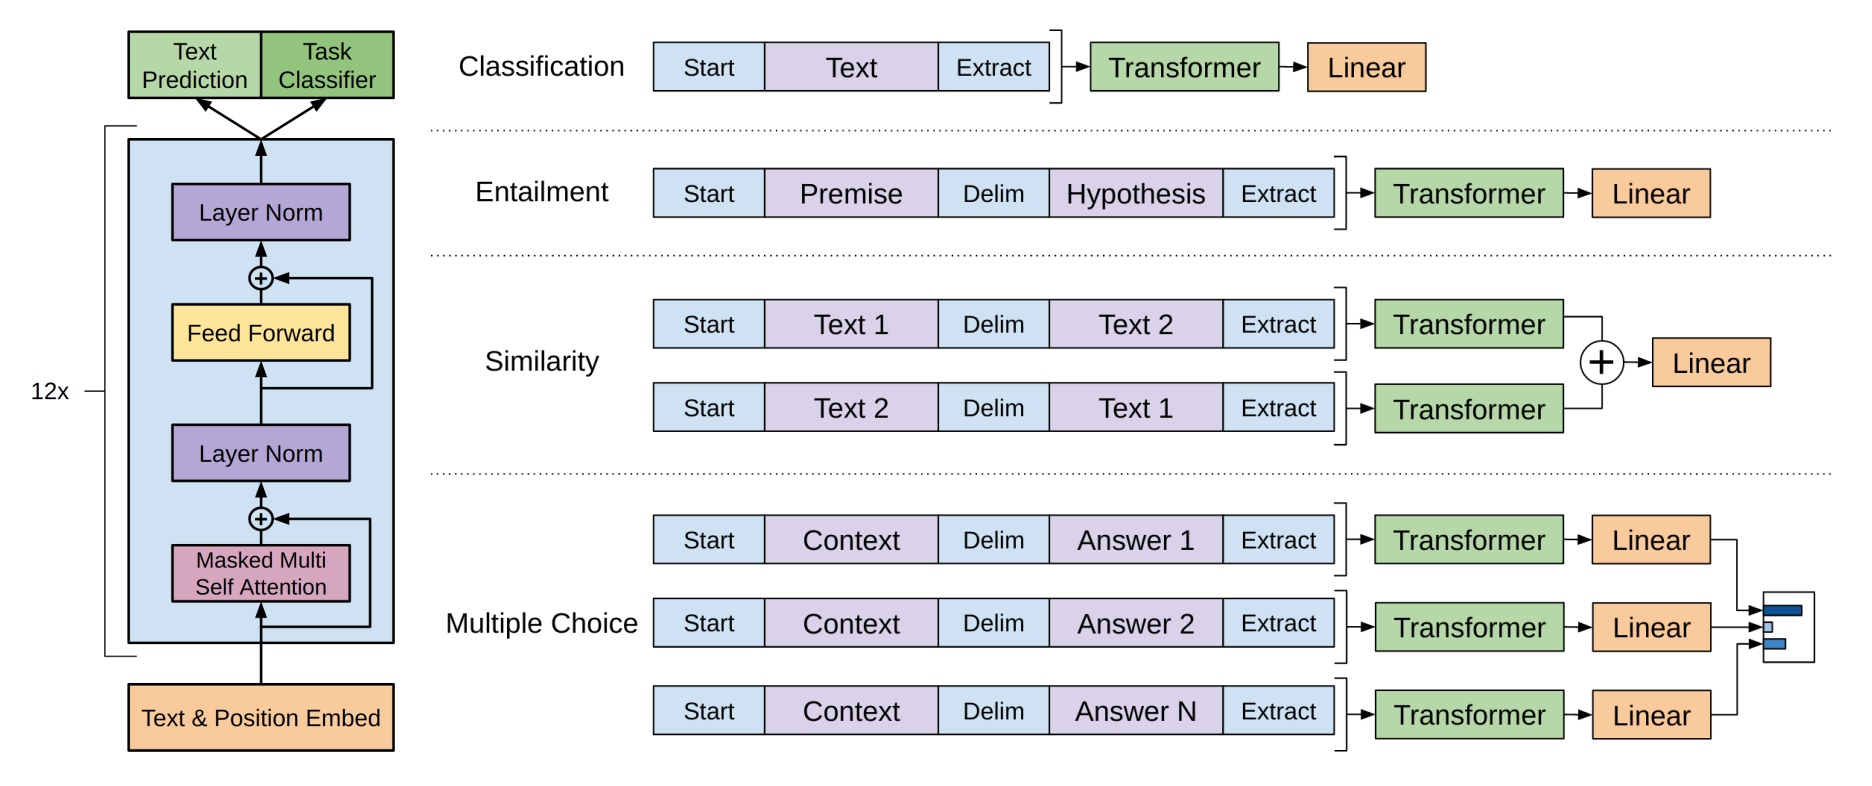
具體的,對於不同的微調任務,我們需要對數據進行如下處理:

GPT2

GPT2 與 GPT 的大致模型框架和預訓練目標是一致的,而區別主要在於以下幾個方面:

  • 其使用了更大的模型
  • 使用了數量更大、質量更高、涵蓋範圍更廣的預訓練數據
  • 採用了無監督多任務聯合訓練的方式,即對於輸入樣本,給予一個該樣本所屬的類別作為引導字符串,這使得該模型能夠同時對多項任務進行聯合訓練,並增強模型的泛化能力

其他的就不深究了

優缺點

BERT

原文鏈接:

BERT 的特徵抽取結構為雙向的 Transformer,簡單來說,就直接套用了 Attention is all you need 中的 Transformer Encoder Block 結構,雖然相比於GPT,僅僅是從單向的變為雙向的,但這也意味着 BERT 無法適用於自回歸語言模型的預訓練方式,因此,BERT提出了兩種預訓練任務來對其模型進行預訓練。

BERT的預訓練

Task 1: MLM

由於BERT需要通過上下文信息,來預測中心詞的信息,同時又不希望模型提前看見中心詞的信息,因此提出了一種 Masked Language Model 的預訓練方式,即隨機從輸入預料上 mask 掉一些單詞,然後通過的上下文預測該單詞,類似於一個完形填空任務。

在預訓練任務中,15%的 Word Piece 會被mask,這15%的 Word Piece 中,80%的時候會直接替換為 [Mask] ,10%的時候將其替換為其它任意單詞,10%的時候會保留原始Token

  • 沒有100%mask的原因
    • 如果句子中的某個Token100%都會被mask掉,那麼在fine-tuning的時候模型就會有一些沒有見過的單詞
  • 加入10%隨機token的原因
    • Transformer要保持對每個輸入token的分佈式表徵,否則模型就會記住這個[mask]是token ’hairy‘
    • 另外編碼器不知道哪些詞需要預測的,哪些詞是錯誤的,因此被迫需要學習每一個token的表示向量
  • 另外,每個batchsize只有15%的單詞被mask的原因,是因為性能開銷的問題,雙向編碼器比單項編碼器訓練要更慢

Task 2: NSP

僅僅一個MLM任務是不足以讓 BERT 解決閱讀理解等句子關係判斷任務的,因此添加了額外的一個預訓練任務,即 Next Sequence Prediction。

具體任務即為一個句子關係判斷任務,即判斷句子B是否是句子A的下文,如果是的話輸出’IsNext‘,否則輸出’NotNext‘。

訓練數據的生成方式是從平行語料中隨機抽取的連續兩句話,其中50%保留抽取的兩句話,它們符合IsNext關係,另外50%的第二句話是隨機從預料中提取的,它們的關係是NotNext的。這個關係保存在圖4中的[CLS]符號中

輸入表徵

BERT的輸入表徵由三種Embedding求和而成:

  • Token Embeddings:即傳統的詞向量層,每個輸入樣本的首字符需要設置為[CLS],可以用於之后的分類任務,若有兩個不同的句子,需要用[SEP]分隔,且最後一個字符需要用[SEP]表示終止
  • Segment Embeddings:為\([0, 1]\)序列,用來在NSP任務中區別兩個句子,便於做句子關係判斷任務
  • Position Embeddings:與Transformer中的位置向量不同,BERT中的位置向量是直接訓練出來的

Fine-tunninng

對於不同的下游任務,我們僅需要對BERT不同位置的輸出進行處理即可,或者直接將BERT不同位置的輸出直接輸入到下游模型當中。具體的如下所示:

  • 對於情感分析等單句分類任務,可以直接輸入單個句子(不需要[SEP]分隔雙句),將[CLS]的輸出直接輸入到分類器進行分類
  • 對於句子對任務(句子關係判斷任務),需要用[SEP]分隔兩個句子輸入到模型中,然後同樣僅須將[CLS]的輸出送到分類器進行分類
  • 對於問答任務,將問題與答案拼接輸入到BERT模型中,然後將答案位置的輸出向量進行二分類並在句子方向上進行softmax(只需預測開始和結束位置即可)
  • 對於命名實體識別任務,對每個位置的輸出進行分類即可,如果將每個位置的輸出作為特徵輸入到CRF將取得更好的效果。

缺點

  • BERT的預訓練任務MLM使得能夠藉助上下文對序列進行編碼,但同時也使得其預訓練過程與中的數據與微調的數據不匹配,難以適應生成式任務
  • 另外,BERT沒有考慮預測[MASK]之間的相關性,是對語言模型聯合概率的有偏估計
  • 由於最大輸入長度的限制,適合句子和段落級別的任務,不適用於文檔級別的任務(如長文本分類);
  • 適合處理自然語義理解類任務(NLU),而不適合自然語言生成類任務(NLG)

ELMo/GPT/BERT對比,其優缺點

ELMo/GPT/BERT 均為在2018年提出的三個模型,且性能是依次提高的,這裏將其放在一起對比,來看看這三者之間的主要區別有哪些

  • ELMo 的特徵提取器為LSTM,特徵抽取能力明顯較Transformer更弱,且并行能力較差
  • ELMo/GPT 均為單向語言模型,即自回歸語言模型,天生適合用於處理生成式任務,但這種特性也決定了無法提取上下文信息用於序列編碼
  • BERT採用雙向Transformer作為特徵抽取結構,能夠有效提取上下文信息用於序列編碼

BERT-wwm

原文鏈接:
Github鏈接:

Whole Word Masking (wwm),暫翻譯為全詞Mask或整詞Mask,是哈工大訊飛聯合實驗室提出的BERT中文預訓練模型的升級版本,主要更改了原預訓練階段的訓練樣本生成策略。 簡單來說,原有基於WordPiece的分詞方式會把一個完整的詞切分成若干個子詞,在生成訓練樣本時,這些被分開的子詞會隨機被mask。

在全詞Mask中,如果一個完整的詞的部分WordPiece子詞被mask,則同屬該詞的其他部分也會被mask,即全詞Mask。這樣的做法強制模型預測整個的詞,而不是詞的一部分,即對同一個詞不同字符的預測將使得其具有相同的上下文,這將加強同一個詞不同字符之間的相關性,或者說引入了先驗知識,使得BERT的獨立性假設在同一個詞的預測上被打破,但又保證了不同的詞之間的獨立性。

作者將全詞Mask的方法應用在了中文中,使用了中文維基百科(包括簡體和繁體)進行訓練,並且使用了哈工大LTP作為分詞工具,即對組成同一個詞的漢字全部進行Mask。這樣一個簡單的改進,使得同樣規模的模型,在中文數據上的表現獲得了全方位的提升

RoBERTa

從模型結構上看,RoBERTa基本沒有什麼太大創新,最主要的區別有如下幾點:

  • 移除了NSP這個預訓練任務,效果變得更好
  • 動態改變mask策略,把數據複製10份,然後統一進行隨機mask;

  • 其他的區別就在於學習率/數據量/batch_size 等

ERNIE(艾尼) 1.0

作者認為BERT在中文文本中的MLM預訓練模型很容易使得模型提取到字搭配這種低層次的語義信息,而對於短語以及實體層次的語義信息抽取能力是較弱的。因此將外部知識引入大規模預訓練語言模型中,提高在知識驅動任務上的性能。具體有如下三個層次的預訓練任務:

  • Basic-Level Masking: 跟bert一樣對單字進行mask,很難學習到高層次的語義信息;
  • Phrase-Level Masking: 輸入仍然是單字級別的,mask連續短語;
  • Entity-Level Masking: 首先進行實體識別,然後將識別出的實體進行mask。

ERNIE 2.0

ERNIE 2.0相比於 1.0 來說,主要的改進在於採取 Multi-task learning(多任務同時學習,同時學習的任務數量逐漸增多)以及 Continue-Learning(不同任務組合輪番學習)的機制。其訓練任務包括了三個級別的任務:

  • 詞級別:
    • Knowledge Masking(短語Masking)
    • Capitalization Prediction(大寫預測)
    • Token-Document Relation Prediction(詞是否會出現在文檔其他地方)
  • 結構級別
    • Sentence Reordering(句子排序分類)
    • Sentence Distance(句子距離分類)
  • 語義級別:
    • Discourse Relation(句子語義關係)
    • IR Relevance(句子檢索相關性)

XLNet

XLNet針對自回歸語言模型單向編碼以及BERT類自編碼語言模型的有偏估計的缺點,提出了一種廣義自回歸語言預訓練方法。

提出背景

  • 傳統的語言模型(自回歸語言模型AR天然適合處理生成任務,但是無法對雙向上下文進行表徵;
  • 而自編碼語言模型(AE)雖然可以實現雙向上下文進行表徵,但是:
    • BERT系列模型引入獨立性假設,沒有考慮預測[MASK]之間的相關性;
    • MLM預訓練目標的設置造成預訓練過程和生成過程不一致;
    • 預訓練時的[MASK]噪聲在finetune階段不會出現,造成兩階段不匹配問題;
  • XLNet提出了一種排列語言模型(PLM),它綜合了自回歸模型和自編碼模型的優點,同時避免他們的缺點

排列語言模型(Permutation Language Model,PLM)

排列語言模型的思想就是在自回歸和自編碼的方式中間額外添加一個步驟,即可將兩者完美統一起來,具體的就是希望語言模型從左往右預測下一個字符的時候,不僅要包含上文信息,同時也要能夠提取到對應字符的下文信息,且不需要引入Mask符號。即在保證位置編碼不變的情況下,將輸入序列的順序打亂,然後預測的順序還是按照原始的位置編碼順序來預測的,但是相應的上下文就是按照打亂順序的上下文來看了,這樣以來,預測對象詞的時候,可以隨機的看到上文信息和下文信息。另外,假設序列長度為\(T\),則我們如果遍歷\(T!\)種分解方法,並且模型參數是共享的,PLM就一定可以學習到預測詞的所有上下文信息。但顯然,遍歷\(T!\)種上下文計算量是十分大的,XLNet採用的是一個部分預測的方法(Partial Prediction),為了減少計算量,作者只對隨機排列后的末尾幾個詞進行預測,並使得如下期望最大化:
\[max_{\theta} \ E_{Z \sim Z_T}[\sum_{t = 1}^{T}logp_{\theta}(x_{z_t}|x_{z < t})]\]

Two-Stream Self-Attention

直接用標準的Transformer來建模PLM,會出現沒有目標(target)位置信息的問題。即在打亂順序之後,我們並不知道下一個要預測的詞是一個什麼詞,這將導致用相同上文預測不同目標的概率是相同的。

XLNet引入了雙流自注意力機制(Two-Stream Self-Attention)來解決這個問題。Two-Stream Self-Attention表明了其有兩個分離的Self-Attention信息流:

  • Query Stream 就為了找到需要預測的當前詞,這個信息流的Self-Attention的Query輸入是僅包含預測詞的位置信息,而Key和Value為上下文中包含內容信息和位置信息的輸入,表明我們無法看見預測詞的內容信息,該信息是需要我們去預測的;
  • Content Stream 主要為 Query Stream 提供其它詞的內容向量,其Query輸入為包含預測詞的內容信息和位置信息,Value和Key的輸入為選中上下文的位置信息和內容信息;

兩個信息流的輸出同樣又作為對應的下一層的雙信息流的輸入。而隨機排列機制實際上是在內部用Mask Attention的機制實現的。

Transformer-XL

Transformer-XL是 XLNet 的特徵抽取結構,其相比於傳統的Transformer能捕獲更長距離的單詞依賴關係。

原始的Transformer的主要缺點在於,其在語言建模中會受到固定長度上下文的限制,從而無法捕捉到更長遠的信息。

Transformer-XL採用片段級遞歸機制(segment-level recurrence mechanism)和相對位置編碼機制(relative positional encoding scheme)來對Transformer進行改進。

  • 片段級遞歸機制:指的是當前時刻的隱藏信息在計算過程中,將通過循環遞歸的方式利用上一時刻較淺層的隱藏狀態,這使得每次的計算將利用更大長度的上下文信息,大大增加了捕獲長距離信息的能力。

  • 相對位置編碼:Transformer本身引入了三角函數向量作為位置編碼向量。而Transformer-XL復用了上文的信息,這就導致位置編碼出現重疊,因此採用了訓練的方式得到相對位置編碼向量。

ALBERT

未完待續…

參考鏈接

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"
Golang 入門系列(十六)鎖的使用場景主要涉及到哪些?讀寫鎖為什麼會比普通鎖快

前面已經講過很多Golang系列知識,感興趣的可以看看以前的文章,,

接下來要說的是golang的鎖的使用場景主要涉及到哪些?讀寫鎖為什麼會比普通鎖快。


一、什麼場景下需要用到鎖

當程序中就一個線程的時候,是不需要加鎖的,但是通常實際的代碼不會只是單線程,有可能是多個線程同時訪問公共資源,所以這個時候就需要用到鎖了,那麼關於鎖的使用場景主要涉及到哪些呢?

1. 多個線程在讀相同的數據時
2. 多個線程在寫相同的數據時
3. 同一個資源,有讀又有寫時


二、Go中鎖分為兩種:

  • 互斥鎖 (sync.Mutex)
  • 讀寫鎖 (sync.RWMutex 底層依賴Mutex實現  )

互斥鎖是併發程序對公共資源訪問限制最常見的方式。在Go中,sync.Mutex 提供了互斥鎖的實現。

當一個goroutine獲得了Mutex后,其他goroutine只能等待,除非該goroutine釋放這個Mutex。

互斥鎖結構:

type Mutex struct {
    state int32
    sema  uint32
}

1. 鎖定狀態值為1,未鎖定狀態鎖未0 。

2. Lock()加鎖、Unlock解鎖。


讀寫鎖則是對讀寫操作進行加鎖。需要注意的是多個讀操作之間不存在互斥關係,這樣提高了對共享資源的訪問效率。

Go中讀寫鎖由 sync.RWMutex 提供,RWMutex在讀鎖佔用的情況下,會阻止寫,但不阻止讀。RWMutex在寫鎖佔用情況下,會阻止任何其他goroutine(無論讀和寫)進來,整個鎖相當於由該goroutine獨佔。

讀寫鎖結構:

type RWMutex struct {
    w           Mutex  // held if there are pending writers
    writerSem   uint32 // semaphore for writers to wait for completing readers
    readerSem   uint32 // semaphore for readers to wait for completing writers
    readerCount int32  // number of pending readers
    readerWait  int32  // number of departing readers
}

1. RWMutex是單寫多讀鎖,該鎖可以加多個讀鎖或者一個寫鎖。

2. 讀鎖佔用的情況會阻止寫,不會阻止讀,多個goroutine可以同時獲取讀鎖。

3. 寫鎖會阻止其他gorotine不論讀或者寫進來,整個鎖由寫鎖goroutine佔用 與第一條共用示範代碼

4. 適用於讀多寫少的場景

三、如何使用互斥鎖

Mutex為互斥鎖,Lock() 加鎖,Unlock() 解鎖,使用Lock() 加鎖后,便不能再次對其進行加鎖,直到利用Unlock()解鎖對其解鎖后,才能再次加鎖.適用於讀寫不確定場景,即讀寫次數沒有明顯的區別,並且只允許只有一個讀或者寫的場景,所以該鎖恭弘=叶 恭弘叫做全局鎖。

互斥鎖只能鎖定一次,當在解鎖之前再次進行加鎖,便會無法加鎖。如果在加鎖前解鎖,便會報錯”panic: sync: unlock of unlocked mutex”。 

package main
import ("fmt"
    "sync"
)

var (
    count int
    lock sync.Mutex
)

func main() {
    for i := 0; i < 2; i++ {
        go func() {
            for i := 1000000; i > 0; i-- {
                lock.Lock()
                count ++
                lock.Unlock()
            }
            fmt.Println(count)
        }()
    }

    fmt.Scanf("\n") //等待子線程全部結束
}

運行結果:
1952533
2000000 //最後的線程打印輸出

對於上面的程序,a作為一個公共的資源,所以對a的改變、讀寫等操作都需要加鎖。


需要注意的問題:

  1. 不要重複鎖定互斥鎖
  2. 不要忘記解鎖互斥鎖,必要時使用 defer 語句
  3. 不要在多個函數之間直接傳遞互斥鎖


四、如何使用讀寫鎖

讀寫鎖的場景主要是在多線程的安全操作下,並且讀的情況多於寫的情況,也就是說既滿足多線程操作的安全性,也要確保性能不能太差,這時候,我們可以考慮使用讀寫鎖。當然你也可以簡單暴力直接使用互斥鎖(Mutex)。

Lock() 寫鎖,如果在添加寫鎖之前已經有其他的讀鎖和寫鎖,則lock就會阻塞直到該鎖可用,為確保該鎖最終可用,已阻塞的 Lock 調用會從獲得的鎖中排除新的讀取器,即寫鎖權限高於讀鎖,有寫鎖時優先進行寫鎖定。

Unlock() 寫鎖解鎖,如果沒有進行寫鎖定,則就會引起一個運行時錯誤。

RLock() 讀鎖,當有寫鎖時,無法加載讀鎖,當只有讀鎖或者沒有鎖時,可以加載讀鎖,讀鎖可以加載多個,所以適用於"讀多寫少"的場景。

RUnlock() 讀鎖解鎖,RUnlock 撤銷單次RLock 調用,它對於其它同時存在的讀取器則沒有效果。若 rw 並沒有為讀取而鎖定,調用 RUnlock 就會引發一個運行時錯誤。

package main
import ("fmt"
    "sync"
)

var (
    count int
    rwLock sync.RWMutex
)

func main() {
    for i := 0; i < 2; i++ {
        go func() {
            for i := 1000000; i > 0; i-- {
                rwLock.Lock()
                count ++
                rwLock.Unlock()
            }
            fmt.Println(count)
        }()
    }

    fmt.Scanf("\n") //等待子線程全部結束
}

運行結果:
1968637
2000000 

看着挺複雜的,其實簡單來說就是:

  1. 讀鎖不能阻塞讀鎖

  2. 讀鎖需要阻塞寫鎖,直到所有讀鎖都釋放

  3. 寫鎖需要阻塞讀鎖,直到所有寫鎖都釋放

  4. 寫鎖需要阻塞寫鎖


五、最後

以上,就把golang中各種鎖的使用場景及怎麼使用互斥鎖和讀寫鎖等相關內容介紹完了,希望能對大家有所幫助。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

如何回答性能優化的問題?

日常工作中,我們多少都會遇到應用的性能問題。在阿裏面試中,性能優化也是常被問到的題目,用來考察是否有實際的線上問題處理經驗。面對這類問題,阿里工程師齊光給出了詳細流程。來阿裏面試前,先看看這篇文章哦。

性能問題和Bug不同,後者的分析和解決思路更清晰,很多時候從應用日誌(文中的應用指分佈式服務下的單個節點)即可直接找到問題根源,而性能問題,其排查思路更為複雜一些。

對應用進行性能優化,是一個系統性的工程,對工程師的技術廣度和技術深度都有所要求。一個簡單的應用,它不僅包含了應用代碼本身,還和容器(虛擬機)、操作系統、存儲、網絡、文件系統等緊密相關,線上應用一旦出現了性能問題,需要我們從多方面去考慮。

與此同時,除了一些低級的代碼邏輯引發的性能問題外,很多性能問題隱藏的較深,排查起來會比較困難,需要我們對應用的各個子模塊、應用所使用的框架和組件的原理有所了解,同時掌握一定的性能優化工具和經驗。

本文總結了我們在進行性能優化時常用的一些工具及技巧,目的是希望通過一個全面的視角,去感知性能優化的整體脈絡。本文主要分為下面三個部分:

  1. 第一部分會介紹性能優化的一些背景知識。
  2. 第二部分會介紹性能優化的通用流程以及常見的一些誤區。
  3. 第三部分會從系統層和業務層的角度,介紹高效的性能問題定位工具和高頻性能瓶頸點分佈。

本文中提到的線程、堆、垃圾回收等名詞,如無特別說明,指的是 Java 應用中的相關概念。


1.性能優化的背景

前面提到過,應用出現性能問題和應用存在缺陷是不一樣的,後者大多數是由於代碼的質量問題導致,會導致應用功能性的缺失或出現風險,一經發現,會被及時修復。而性能問題,可能是由多方面的因素共同作用的結果:代碼質量一般、業務發展太快、應用架構設計不合理等,這些問題處理起來一般耗時較長、分析鏈路複雜,大家都不願意干,因此可能會被一些臨時性的補救手段所掩蓋,如:系統水位高或者單機的線程池隊列爆炸,那就集群擴容增加機器;內存佔用高/高峰時段 OOM,那就重啟分分鐘解決……

臨時性的補救措施只是在給應用埋雷,同時也只能解決部分問題。譬如,在很多場景下,加機器也並不能解決應用的性能問題,如對時延比較敏感的一些應用必須把單機的性能優化到極致,與此同時,加機器這種方式也造成了資源的浪費,長期來看是得不償失的。對應用進行合理的性能優化,可在應用穩定性、成本核算獲得很大的收益。

上面我們闡述了進行性能優化的必要性。假設現在我們的應用已經有了性能問題(eg. CPU 水位比較高),準備開始進行優化工作了,在這個過程中,潛在的痛點會有哪些呢?下面列出一些較為常見的:

  1. 對性能優化的流程不是很清晰。初步定為一個疑似瓶頸點后,就興高采烈地吭哧吭哧開始干,最終解決的問題其實只是一個淺層次的性能瓶頸,真實的問題的根源並未觸達;
  2. 對性能瓶頸點的分析思路不是很清晰。CPU、網絡、內存……這麼多的性能指標,我到底該關注什麼,應該從哪一塊兒開始入手?
  3. 對性能優化的工具不了解。遇到問題后,不清楚該用哪個工具,不知道通過工具得到的指標代表什麼。

    2.性能優化的流程

    在性能優化這個領域,並沒有一個嚴格的流程定義,但是對於絕大多數的優化場景,我們可以將其過程抽象為下面四個步驟。

    1. 準備階段:主要工作是是通過性能測試,了解應用的概況、瓶頸的大概方向,明確優化目標;
    2. 分析階段:通過各種工具或手段,初步定位性能瓶頸點;
    3. 調優階段:根據定位到的瓶頸點,進行應用性能調優;
    4. 測試階段:讓調優過的應用進行性能測試,與準備階段的各項指標進行對比,觀測其是否符合預期,如果瓶頸點沒有消除或者性能指標不符合預期,則重複步驟2和3。
    5. 下圖即為上述四個階段的簡要流程。

    2.1 通用流程詳解

    在上述通用流程的四個步驟當中,步驟2和3我們會在接下來兩個部分重點進行介紹。首先我們來看一下,在準備階段和測試階段,我們需要做一些什麼。

    | 2.1.1 準備階段

    準備階段是非常關鍵的一步,不能省略。

    首先,需要對我們進行調優的對象進行詳盡的了解,所謂知己知彼,百戰不殆。

    1. 對性能問題進行粗略評估,過濾一些因為低級的業務邏輯導致的性能問題。譬如,線上應用日誌級別不合理,可能會在大流量時導致 CPU 和磁盤的負載飆高,這種情況調整日誌級別即可;
    2. 了解應用的的總體架構,比如應用的外部依賴和核心接口有哪些,使用了哪些組件和框架,哪些接口、模塊的使用率較高,上下游的數據鏈路是怎麼樣的等;
    3. 了解應用對應的服務器信息,如服務器所在的集群信息、服務器的 CPU/內存信息、安裝的 Linux 版本信息、服務器是容器還是虛擬機、所在宿主機混部后是否對當前應用有干擾等;

    其次,我們需要獲取基準數據,然後結合基準數據和當前的一些業務指標,確定此次性能優化的最終目標。

    1. 使用基準測試工具獲取系統細粒度指標。可以使用若干 Linux 基準測試工具(eg. jmeter、ab、loadrunnerwrk、wrk等),得到文件系統、磁盤 I/O、網絡等的性能報告。除此之外,類似 GC、Web 服務器、網卡流量等信息,如有必要也是需要了解記錄的;
    2. 通過壓測工具或者壓測平台(如果有的話),對應用進行壓力測試,獲取當前應用的宏觀業務指標,譬如:響應時間、吞吐量、TPS、QPS、消費速率(對於有 MQ 的應用)等。壓力測試也可以省略,可以結合當前的實際業務和過往的監控數據,去統計當前的一些核心業務指標,如午高峰的服務 TPS。

    | 2.1.2 測試階段

    進入到這一階段,說明我們已經初步確定了應用性能瓶頸的所在,而且已經進行初步的調優了。檢測我們調優是否有效的方式,就是在仿真的條件下,對應用進行壓力測試。注意:由於 Java 有 JIT(just-in-time compilation)過程,因此壓力測試時可能需要進行前期預熱。

    如果壓力測試的結果符合了預期的調優目標,或者與基準數據相比,有很大的改善,則我們可以繼續通過工具定位下一個瓶頸點,否則,則需要暫時排除這個瓶頸點,繼續尋找下一個變量。

    2.2 注意事項

    在進行性能優化時,了解下面這些注意事項可以讓我們少走一些彎路。

    1. 性能瓶頸點通常呈現 2/8 分佈,即80%的性能問題通常是由20%的性能瓶頸點導致的,2/8 原則也意味着並不是所有的性能問題都值得去優化;
    2. 性能優化是一個漸進、迭代的過程,需要逐步、動態地進行。記錄基準后,每次改變一個變量,引入多個變量會給我們的觀測、優化過程造成干擾;
    3. 不要過度追求應用的單機性能,如果單機表現良好,則應該從系統架構的角度去思考; 不要過度追求單一維度上的極致優化,如過度追求 CPU 的性能而忽略了內存方面的瓶頸;
    4. 選擇合適的性能優化工具,可以使得性能優化取得事半功倍的效果;
    5. 整個應用的優化,應該與線上系統隔離,新的代碼上線應該有降級方案。

    3.瓶頸點分析工具箱

    性能優化其實就是找出應用存在性能瓶頸點,然後設法通過一些調優手段去緩解。性能瓶頸點的定位是較困難的,快速、直接地定位到瓶頸點,需要具備下面兩個條件:

    1. 恰到好處的工具;
    2. 一定的性能優化經驗。

    工欲善其事,必先利其器,我們該如何選擇合適的工具呢?不同的優化場景下,又該選擇那些工具呢?

    首選,我們來看一下大名鼎鼎的「性能工具(Linux Performance Tools-full)圖」,想必很多工程師都知道,它出自系統性能專家 Brendan Gregg。該圖從 Linux 內核的各個子系統出發,列出了我們在對各個子系統進行性能分析時,可使用的工具,涵蓋了監測、分析、調優等性能優化的方方面面。除了這張全景圖之外,Brendan Gregg 還單獨提供了基準測試工具(Linux Performance Benchmark Tools)圖、性能監測工具(Linux Performance Observability Tools)圖等,更詳細的內容請參考 Brendan Gregg 的網站說明。

    圖片來源:

    上面這張圖非常經典,是我們做性能優化時非常好的參考資料,但事實上,我們在實際運用的時候,會發現可能它並不是最合適的,原因主要有下面兩點:

    1)對分析經驗要求較高。上面這張圖其實是從 Linux 系統資源的角度去觀測性能指標的,這要求我們對 Linux 各個子系統的功能、原理要有所了解。舉例:遇到性能問題了,我們不會拿每個子系統下的工具都去試一遍,大多數情況是:我們懷疑某個子系統有問題,然後根據這張圖上列舉的工具,去觀測或者驗證我們的猜想,這無疑拔高了對性能優化經驗的要求;

    2)適用性和完整性不是很好。我們在分析性能問題時,從系統底層自底向上地分析是較低效的,大多數時候,從應用層面去分析會更加有效。性能工具(Linux Performance Tools-full)圖只是從系統層一個角度給出了工具集,如果從應用層開始分析,我們可以使用哪些工具?哪些點是我們首先需要關注的?

    鑒於上面若干痛點,下面給出了一張更為實用的「性能優化工具圖譜」,該圖分別從系統層、應用層(含組件層)的角度出發,列舉了我們在分析性能問題時首先需要關注的各項指標(其中?標註的是最需要關注的),這些點是最有可能出現性能瓶頸的地方。需要注意的是,一些低頻的指標或工具,在圖中並沒有列出來,如 CPU 中斷、索引節點使用、I/O事件跟蹤等,這些低頻點的排查思路較複雜,一般遇到的機會也不多,在這裏我們聚焦最常見的一些就可以了。

    對比上面的性能工具(Linux Performance Tools-full)圖,下圖的優勢在於:把具體的工具同性能指標結合了起來,同時從不同的層次去描述了性能瓶頸點的分佈,實用性和可操作性更強一些。系統層的工具分為CPU、內存、磁盤(含文件系統)、網絡四個部分,工具集同性能工具(Linux Performance Tools-full)圖中的工具基本一致。組件層和應用層中的工具構成為:JDK 提供的一些工具 + Trace 工具 + dump 分析工具 + Profiling 工具等。

    這裏就不具體介紹這些工具的具體用法了,我們可以使用 man 命令得到工具詳盡的使用說明,除此之外,還有另外一個查詢命令手冊的方法:info。info 可以理解為 man 的詳細版本,如果 man 的輸出不太好理解,可以去參考 info 文檔,命令太多,記不住也沒必要記住。

    上面這張圖該如何使用?

    首先,雖然從系統、組件、應用兩個三個角度去描述瓶頸點的分佈,但在實際運行時,這三者往往是相輔相成、相互影響的。系統是為應用提供了運行時環境,性能問題的本質就是系統資源達到了使用的上限,反映在應用層,就是應用/組件的各項指標開始下降;而應用/組件的不合理使用和設計,也會加速系統資源的耗盡。因此,分析瓶頸點時,需要我們結合從不同角度分析出的結果,抽出共性,得到最終的結論。

    其次,建議先從應用層入手,分析圖中標註的高頻指標,抓出最重要的、最可疑的、最有可能導致性能的點,得到初步的結論后,再去系統層進行驗證。這樣做的好處是:很多性能瓶頸點體現在系統層,會是多變量呈現的,譬如,應用層的垃圾回收(GC)指標出現了異常,通過 JDK 自帶的工具很容易觀測到,但是體現在系統層上,會發現系統當前的 CPU 利用率、內存指標都不太正常,這就給我們的分析思路帶來了困擾。

    最後,如果瓶頸點在應用層和系統層均呈現出多變量分佈,建議此時使用 ZProfiler、JProfiler 等工具對應用進行 Profiling,獲取應用的綜合性能信息(注:Profiling 指的是在應用運行時,通過事件(Event-based)、統計抽樣(Sampling Statistical)或植入附加指令(Byte-Code instrumentation)等方法,收集應用運行時的信息,來研究應用行為的動態分析方法)。譬如,可以對 CPU 進行抽樣統計,結合各種符號表信息,得到一段時間內應用內的代碼熱點。

    下面介紹在不同的分析層次,我們需要關注的核心性能指標,同時,也會介紹如何初步根據這些指標,判斷系統或應用是否存在性能瓶頸點,至於瓶頸點的確認、瓶頸點的成因、調優手段,將會在下一部分展開。

    3.1 CPU&&線程

    和 CPU 相關的指標主要有以下幾個。常用的工具有 top、 ps、uptime、 vmstat、 pidstat等。

    1. CPU利用率(CPU Utilization)
    2. CPU 平均負載(Load Average)
    3. 上下文切換次數(Context Switch)

    top – 12:20:57 up 25 days, 20:49, 2 users, load average: 0.93, 0.97, 0.79

    Tasks: 51 total, 1 running, 50 sleeping, 0 stopped, 0 zombie
    %Cpu(s): 1.6 us, 1.8 sy, 0.0 ni, 89.1 id, 0.1 wa, 0.0 hi, 0.1 si, 7.3 st
    KiB Mem : 8388608 total, 476436 free, 5903224 used, 2008948 buff/cache
    KiB Swap: 0 total, 0 free, 0 used. 0 avail Mem

    PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND

    119680 admin 20 0 600908 72332 5768 S 2.3 0.9 52:32.61 obproxy
    65877 root 20 0 93528 4936 2328 S 1.3 0.1 449:03.61 alisentry_cli

    第一行显示的內容:當前時間、系統運行時間以及正在登錄用戶數。load average 后的三個数字,依次表示過去 1 分鐘、5 分鐘、15 分鐘的平均負載(Load Average)。平均負載是指單位時間內,系統處於可運行狀態(正在使用 CPU 或者正在等待 CPU 的進程,R 狀態)和不可中斷狀態(D 狀態)的平均進程數,也就是平均活躍進程數,CPU 平均負載和 CPU 使用率並沒有直接關係。

    第三行的內容表示 CPU 利用率,每一列的含義可以使用 man 查看。CPU 使用率體現了單位時間內 CPU 使用情況的統計,以百分比的方式展示。計算方式為:CPU 利用率 = 1 – (CPU 空閑時間)/ CPU 總的時間。需要注意的是,通過性能分析工具得到的 CPU 的利用率其實是某個採樣時間內的 CPU 平均值。注:top 工具显示的的 CPU 利用率是把所有 CPU 核的數值加起來的,即 8 核 CPU 的利用率最大可以到達800%(可以用 htop 等更新一些的工具代替 top)。

    使用 vmstat 命令,可以查看到「上下文切換次數」這個指標,如下錶所示,每隔1秒輸出1組數據:

    $ vmstat 1

    procs ———–memory———- —swap– —–io—- -system– ——cpu—–
    r b swpd free buff cache si so bi bo in cs us sy id wa st
    0 0 0 504804 0 1967508 0 0 644 33377 0 1 2 2 88 0 9

    上表的 cs(context switch) 就是每秒上下文切換的次數,按照不同場景,CPU 上下文切換還可以分為中斷上下文切換、線程上下文切換和進程上下文切換三種,但是無論是哪一種,過多的上下文切換,都會把 CPU 時間消耗在寄存器、內核棧以及虛擬內存等數據的保存和恢復上,從而縮短進程真正運行的時間,導致系統的整體性能大幅下降。vmstat 的輸出中 us、sy 分別用戶態和內核態的 CPU 利用率,這兩個值也非常具有參考意義。

    vmstat 的輸只給出了系統總體的上下文切換情況,要想查看每個進程的上下文切換詳情(如自願和非自願切換),需要使用 pidstat,該命令還可以查看某個進程用戶態和內核態的 CPU 利用率。

    CPU 相關指標異常的分析思路是什麼?

    1)CPU 利用率:如果我們觀察某段時間系統或應用進程的 CPU利用率一直很高(單個 core 超過80%),那麼就值得我們警惕了。我們可以多次使用 jstack 命令 dump 應用線程棧查看熱點代碼,非 Java 應用可以直接使用 perf 進行 CPU 采採樣,離線分析採樣數據后得到 CPU 執行熱點(Java 應用需要符號表進行堆棧信息映射,不能直接使用 perf得到結果)。

    2)CPU 平均負載:平均負載高於 CPU 數量 70%,意味着系統存在瓶頸點,造成負載升高的原因有很多,在這裏就不展開了。需要注意的是,通過監控系統監測平均負載的變化趨勢,更容易定位問題,有時候大文件的加載等,也會導致平均負載瞬時升高。如果 1 分鐘/5 分鐘/15 分鐘的三個值相差不大,那說明系統負載很平穩,則不用關注,如果這三個值逐漸降低,說明負載在漸漸升高,需要關注整體性能;

    3)CPU 上下文切換:上下文切換這個指標,並沒有經驗值可推薦(幾十到幾萬都有可能),這個指標值取決於系統本身的 CPU 性能,以及當前應用工作的情況。但是,如果系統或者應用的上下文切換次數出現數量級的增長,就有很大概率說明存在性能問題,如非自願上下切換大幅度上升,說明有太多的線程在競爭 CPU。

    上面這三個指標是密切相關的,如頻繁的 CPU 上下文切換,可能會導致平均負載升高。如何根據這三者之間的關係進行應用調優,將在下一部分介紹。

    CPU 上的的一些異動,通常也可以從線程上觀測到,但需要注意的是,線程問題並不完全和 CPU 相關。與線程相關的指標,主要有下面幾個(均都可以通過 JDK 自帶的 jstack 工具直接或間接得到):

    1. 應用中的總的線程數;
    2. 應用中各個線程狀態的分佈;
    3. 線程鎖的使用情況,如死鎖、鎖分佈等;

    關於線程,可關注的異常有:

    1)線程總數是否過多。過多的線程,體現在 CPU 上就是導致頻繁的上下文切換,同時線程過多也會消耗內存,線程總數大小和應用本身和機器配置相關;

    2)線程的狀態是否異常。觀察 WAITING/BLOCKED 線程是否過多(線程數設置過多或鎖競爭劇烈),結合應用內部鎖使用的情況綜合分析;

    3)結合 CPU 利用率,觀察是否存在大量消耗 CPU 的線程。

    3.2 內存&&堆

    和內存相關的指標主要有以下幾個,常用的分析工具有:top、free、vmstat、pidstat 以及 JDK 自帶的一些工具。

    1. 系統內存的使用情況,包括剩餘內存、已用內存、可用內存、緩存/緩衝區;
    2. 進程(含 Java 進程)的虛擬內存、常駐內存、共享內存;
    3. 進程的缺頁異常數,包含主缺頁異常和次缺頁異常;
    4. Swap 換入和換出的內存大小、Swap 參數配置;
    5. JVM 堆的分配,JVM 啟動參數;
    6. JVM 堆的回收,GC 情況。

    使用 free 可以查看系統內存的使用情況和 Swap 分區的使用情況,top 工具可以具體到每個進程,如我們可以用使用 top 工具查看 Java 進程的常駐內存大小(RES),這兩個工具結合起來,可用覆蓋大多數內存指標。下面是使用 free命令的輸出:

    $free -h

              total        used        free shared buff/cache available

    Mem: 125G 6.8G 54G 2.5M 64G 118G

    Swap: 2.0G 305M 1.7G

    上述輸出各列的具體含義在這裏不在贅述,也比較容易理解。重點介紹下 swap 和 buff/cache 這兩個指標。

    Swap 的作用是把一個本地文件或者一塊磁盤空間作為內存來使用,包括換出和換入兩個過程。Swap 需要讀寫磁盤,所以性能不是很高,事實上,包括 ElasticSearch 、Hadoop 在內絕大部分 Java 應用都建議關掉 Swap,這是因為內存的成本一直在降低,同時這也和 JVM 的垃圾回收過程有關:JVM在 GC 的時候會遍歷所有用到的堆的內存,如果這部分內存被 Swap 出去了,遍歷的時候就會有磁盤 I/O 產生。Swap 分區的升高一般和磁盤的使用強相關,具體分析時,需要結合緩存使用情況、swappiness 閾值以及匿名頁和文件頁的活躍情況綜合分析。

    buff/cache 是緩存和緩衝區的大小。緩存(cache):是從磁盤讀取的文件的或者向磁盤寫文件時的臨時存儲數據,面向文件。使用 cachestat 可以查看整個系統緩存的讀寫命中情況,使用 cachetop 可以觀察每個進程緩存的讀寫命中情況。緩衝區(buffer)是寫入磁盤數據或從磁盤直接讀取的數據的臨時存儲,面向塊設備。free 命令的輸出中,這兩個指標是加在一起的,使用 vmstat 命令可以區分緩存和緩衝區,還可以看到 Swap 分區換入和換出的內存大小。

    了解到常見的內存指標后,常見的內存問題又有哪些?總結如下:

    1. 系統剩餘內存/可用不足(某個進程佔用太多、系統本身內存不足),內存溢出;
    2. 內存回收異常:內存泄漏(進程在一段時間內內存使用持續走高)、GC 頻率異常;
    3. 緩存使用過大(大文件讀取或寫入)、緩存命中率不高;
    4. 缺頁異常過多(頻繁的 I/O 讀);
    5. Swap 分區使用異常(使用過大);

    內存相關指標異常后,分析思路是怎麼樣的?

    1. 使用 free/top 查看內存的全局使用情況,如系統內存的使用、Swap 分區內存使用、緩存/緩衝區佔用情況等,初步判斷內存問題存在的方向:進程內存、緩存/緩衝區、Swap 分區;
    2. 觀察一段時間內存的使用趨勢。如通過 vmstat 觀察內存使用是否一直在增長;通過 jmap 定時統計對象內存分佈情況,判斷是否存在內存泄漏,通過 cachetop 命令,定位緩衝區升高的根源等;
    3. 根據內存問題的類型,結合應用本身,進行詳細分析。

    舉例:使用 free 發現緩存/緩衝區佔用不大,排除緩存/緩衝區對內存的影響后 -> 使用 vmstat 或者 sar 觀察一下各個進程內存使用變化趨勢 -> 發現某個進程的內存時候用持續走高 -> 如果是 Java 應用,可以使用 jmap / VisualVM / heap dump 分析等工具觀察對象內存的分配,或者通過 jstat 觀察 GC 后的應用內存變化 -> 結合業務場景,定位為內存泄漏/GC參數配置不合理/業務代碼異常等。

    3.3 磁盤&&文件

    在分析和磁盤相關的問題時,通常是將其和文件系統同時考慮的,下面不再區分。和磁盤/文件系統相關的指標主要有以下幾個,常用的觀測工具為 iostat和 pidstat,前者適用於整個系統,後者可觀察具體進程的 I/O。

    1. 磁盤 I/O 利用率:是指磁盤處理 I/O 的時間百分比;
    2. 磁盤吞吐量:是指每秒的 I/O 請求大小,單位為 KB;
    3. I/O 響應時間,是指 I/O 請求從發出到收到響應的間隔,包含在隊列中的等待時間和實際處理時間;
    4. IOPS(Input/Output Per Second):每秒的 I/O 請求數;
    5. I/O 等待隊列大小,指的是平均 I/O 隊列長度,隊列長度越短越好;

    使用 iostat 的輸出界面如下:

    $iostat -dx

    Linux 3.10.0-327.ali2010.alios7.x86_64 (loginhost2.alipay.em14) 10/20/2019 x86_64 (32 CPU)

    Device: rrqm/s wrqm/s r/s w/s rkB/s wkB/s avgrq-sz avgqu-sz await r_await w_await svctm %util
    sda 0.01 15.49 0.05 8.21 3.10 240.49 58.92 0.04 4.38 2.39 4.39 0.09 0.07

    上圖中 %util ,即為磁盤 I/O 利用率,同 CPU 利用率一樣,這個值也可能超過 100%(存在并行 I/O);rkB/s 和 wkB/s分別表示每秒從磁盤讀取和寫入的數據量,即吞吐量,單位為 KB;磁盤 I/O處理時間的指標為 r_await 和 w_await 分別表示讀/寫請求處理完成的響應時間,svctm 表示處理 I/O 所需要的平均時間,該指標已被廢棄,無實際意義。r/s + w/s 為 IOPS 指標,分別表示每秒發送給磁盤的讀請求數和寫請求數;aqu-sz 表示等待隊列的長度。

    pidstat 的輸出大部分和 iostat 類似,區別在於它可以實時查看每個進程的 I/O 情況。

    如何判斷磁盤的指標出現了異常?

      1. 當磁盤 I/O 利用率長時間超過 80%,或者響應時間過大(對於 SSD,從 0.0x 毫秒到 1.x 毫秒不等,机械磁盤一般為5ms~10ms),通常意味着磁盤 I/O 存在性能瓶頸;
      2. 如果 %util 很大,而 rkB/s 和 wkB/s 很小,一般是因為存在較多的磁盤隨機讀寫,最好把隨機讀寫優化成順序讀寫,(可以通過 strace 或者 blktrace 觀察 I/O 是否連續判斷是否是順序的讀寫行為,隨機讀寫應可關注 IOPS 指標,順序讀寫可關注吞吐量指標);
      3. 如果 avgqu-sz 比較大,說明有很多 I/O 請求在隊列中等待。一般來說,如果單塊磁盤的隊列長度持續超過2,一般認為該磁盤存在 I/O 性能問題。

    3.4 網絡

    網絡這個概念涵蓋的範圍較廣,在應用層、傳輸層、網絡層、網絡接口層都有不同的指標去衡量。這裏我們討論的「網絡」,特指應用層的網絡,通常使用的指標如下:

    1. 網絡帶寬:表示鏈路的最大傳輸速率;
    2. 網絡吞吐:表示單位時間內成功傳輸的數據量大小;
    3. 網絡延時:表示從網絡請求發出后直到收到遠端響應,所需要的時間;
    4. 網絡連接數和錯誤數;

    一般來說,應用層的網絡瓶頸有如下幾類:

    1. 集群或機器所在的機房的網絡帶寬飽和,影響應用 QPS/TPS 的提升;
    2. 網絡吞吐出現異常,如接口存在大量的數據傳輸,造成帶寬佔用過高;
    3. 網絡連接出現異常或錯誤;
    4. 網絡出現分區。

    帶寬和網絡吞吐這兩個指標,一般我們會關注整個應用的,通過監控系統可直接得到,如果一段時間內出現了明顯的指標上升,說明存在網絡性能瓶頸。對於單機,可以使用 sar 得到網絡接口、進程的網絡吞吐。

    使用 ping 或者 hping3 可以得到是否出現網絡分區、網絡具體時延。對於應用,我們更關注整個鏈路的時延,可以通過中間件埋點后輸出的 trace 日誌得到鏈路上各個環節的時延信息。

    使用 netstat、ss 和 sar 可以獲取網絡連接數或網絡錯誤數。過多網絡鏈接造成的開銷是很大的,一是會佔用文件描述符,二是會佔用緩存,因此系統可以支撐的網絡鏈接數是有限的。

    3.5 工具總結

    可以看到的是,在分析 CPU、內存、磁盤等的性能指標時,有幾種工具是高頻出現的,如 top、vmstat、pidstat,這裏稍微總結一下:

    1. CPU:top、vmstat、pidstat、sar、perf、jstack、jstat;
    2. 內存:top、free、vmstat、cachetop、cachestat、sar、jmap;
    3. 磁盤:top、iostat、vmstat、pidstat、du/df;
    4. 網絡:netstat、sar、dstat、tcpdump;
    5. 應用:profiler、dump分析。

    上述的很多工具,大部分是用於查看系統層指標的,在應用層,除了有 JDK 提供的一系列工具,一些商用的產品如 gceasy.io(分析 GC 日誌)、fastthread.io(分析線程 dump 日誌)也是不錯的。

    排查 Java 應用的線上異常或者分析應用代碼瓶頸,可以使用阿里開源的 Arthas ,這個工具非常強大,下面簡單介紹下。

    Arthas 主要面向線上應用實時診斷,解決的是類似「線上應用異常了,需要在線進行分析和定位」的問題,當然,Arthas 提供的一些方法調用追蹤工具,對我們排查諸如「慢查詢」等問題,也是非常有幫助的。Arthas 提供的主要功能有:

    1. 獲取線程統計,如線程持有的鎖統計、CPU 利用率統計等;
    2. 類加載信息、動態類加載、方法加載信息;
    3. 調用棧追蹤,調用耗時統計;
    4. 方法調用參數、結果檢測;
    5. 系統配置、應用配置信息;
    6. 反編譯加載類;
    7. ….

    需要注意的是,性能工具只是解決性能問題的手段,我們了解常用工具的一般用法即可,不要在工具學習上投入過多精力。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

基於Galera Cluster多主結構的Mysql高可用集群

Galera Cluster特點

1、多主架構:真正的多點讀寫的集群,在任何時候讀寫數據,都是最新的 2、同步複製:集群不同節點之間數據同步,沒有延遲,在數據庫掛掉之後,數據不會丟失 3、併發複製:從節點APPLY數據時,支持并行執行,更好的性能 4、故障切換:在出現數據庫故障時,因支持多點寫入,切換容易 5、熱插拔:在服務期間,如果數據庫掛了,只要監控程序發現的夠快,不可服務時間就會非常少。在節點故障期間,節點本身對集群的影響非常小 6、自動節點克隆:在新增節點,或者停機維護時,增量數據或者基礎數據不需要人工手動備份提供,Galera Cluster會自動拉取在線節點數據,最終集群會變為一致 7、對應用透明:集群的維護,對應用程序是透明的 

Galera Cluster工作過程

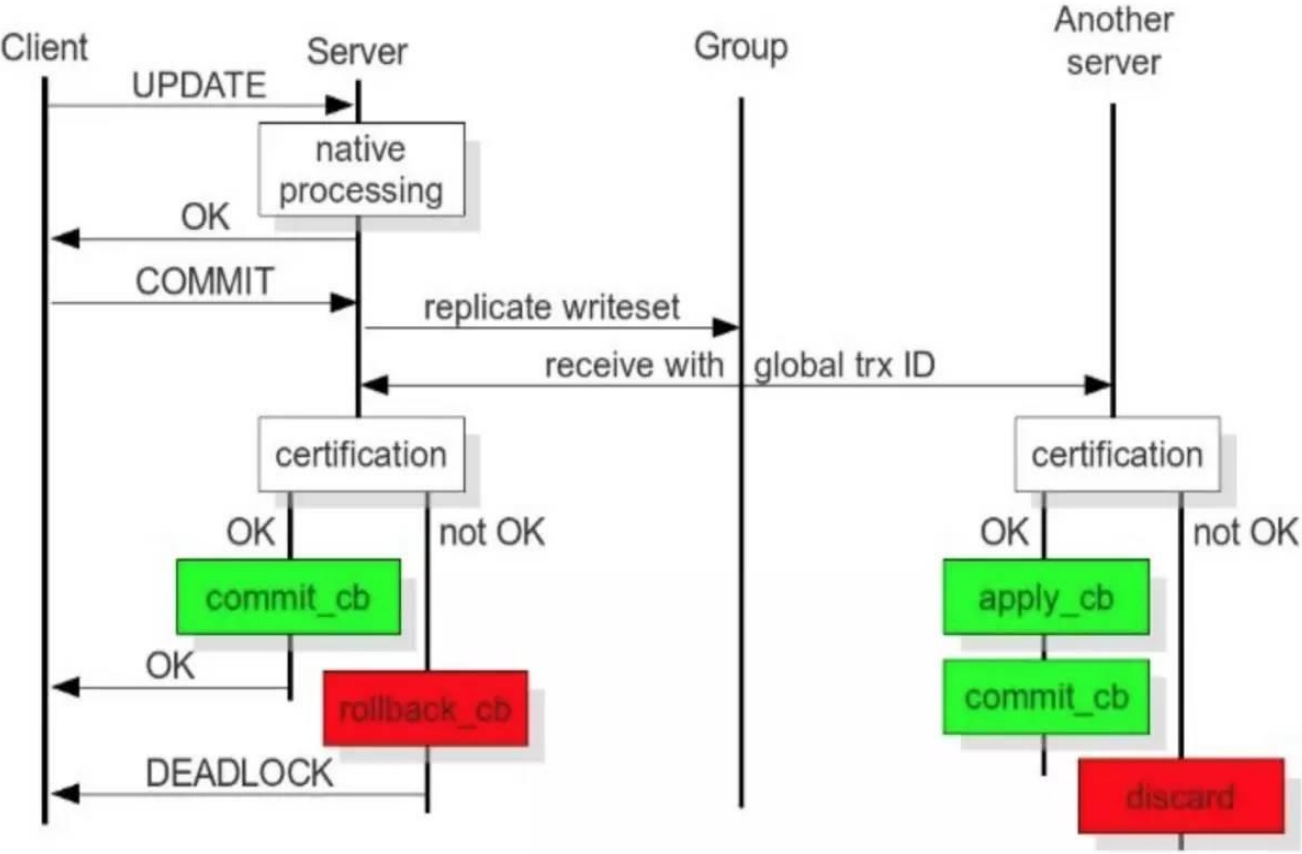
客戶端發送更新指令到mysql服務器,服務器回復OK,但客戶端有可能以事務方式執行,並沒有發送確認指令(commit);當客戶端發送commit指令確認后,mysql服務器會把數據庫的更新複製到同一個集群的其他節點;集群中的所有節點會對數據庫的更新進行校驗,檢查更新完的數據與數據庫中的數據是否衝突,如果不衝突,服務器端會回復OK;如果更新的數據與集群中的任意一個節點數據發生衝突,則都會回復error 

實現Galera Cluster集群

至少需要三台機器;並且Galera Cluster也是一個數據庫服務,下載Galera Cluster必須卸載服務器現有的mysql數據庫服務

master1配置

[root@centos7 ~]# vim /etc/yum.repos.d/base.repo #編輯yum源倉庫 [mysql] name=mysql baseurl=https://mirrors.tuna.tsinghua.edu.cn/mariadb/mariadb-10.0.38/yum/centos7-amd64/ gpgcheck=0 enabled=1 [root@centos7 ~]# scp /etc/yum.repos.d/base.repo 192.168.38.37:/etc/yum.repos.d/mysql.repo #發送給另外兩個主節點 [root@centos7 ~]# scp /etc/yum.repos.d/base.repo 192.168.38.47:/etc/yum.repos.d/mysql.repo [root@centos7 ~]# yum install MariaDB-Galera-server -y [root@centos7 ~]# vim /etc/my.cnf.d/server.cnf #編輯galera配置文件 [galera] wsrep_provider=/usr/lib64/galera/libgalera_smm.so #啟用galera模塊 wsrep_cluster_address="gcomm://192.168.38.7,192.168.38.37,192.168.38.47" #指定集群中節點的IP binlog_format=row #二進制日誌格式必須為行 default_storage_engine=InnoDB #存儲引擎 innodb_autoinc_lock_mode=2 bind-address=0.0.0.0 #綁定本機的所有IP wsrep_cluster_name='mycluster' #設置集群名 wsrep_node_name='node1' #設置節點名 wsrep_node_address='192.168.38.7' #指定本節點的IP [root@centos7 ~]# service mysql start --wsrep-new-cluster #第一次啟動,三個節點中必須有一個節點添加--wsrep-new-cluster參數啟動 

master2

[root@localhost ~]# yum install MariaDB-Galera-server -y #yum源不用配,前面master1主節點已經把yum源和galera配置文件發送到所有節點中 [root@localhost ~]# vim /etc/my.cnf.d/server.cnf [galera] wsrep_cluster_name='mycluster' #上面的galera信息不用修改,修改一下本節點的信息 wsrep_node_name='node2' wsrep_node_address='192.168.38.37' [root@localhost ~]# service mysql start 

master3

[root@localhost ~]# yum install MariaDB-Galera-server -y [root@localhost ~]# vim /etc/my.cnf.d/server.cnf [galera] wsrep_cluster_name='mycluster' wsrep_node_name='node3' wsrep_node_address='192.168.38.47' [root@localhost ~]# service mysql start 

在一個主節點更新數據,會同步到這個集群的其他主節點上;但是假如三個主節點同時創建一張db1表,會發現有兩個主節點報錯,一個主節點成功;這個就是galera cluster的工作特性;最先執行創建表的主節點詢問其餘主節點數據是否發生衝突,不發生衝突則創建表,一個主節點成功創建了db1表,其餘兩個主節點創建的時候也回去詢問,但是有一主節點已經創建完畢,所以會發生數據衝突,則其餘兩個主節點都會報錯

SHOW VARIABLES LIKE 'wsrep_%'; #可以在mysql中查詢集群的相關狀態信息 SHOW STATUS LIKE 'wsrep_%'; SHOW STATUS LIKE 'wsrep_cluster_size'; 

往現有集群中添加一個主節點master4

通過master1,把yum源倉庫文件和galera的配置文件都拷貝給master4

[root@localhost ~]# yum install MariaDB-Galera-server -y [root@localhost ~]# vim /etc/my.cnf.d/server.cnf [galera] wsrep_cluster_address="gcomm://192.168.38.7,192.168.38.37,192.168.38.47,192.168.38.57" #把新的節點master4的IP添加上去 wsrep_cluster_name='mycluster' wsrep_node_name='node4' wsrep_node_address='192.168.38.57' [root@localhost ~]# service mysql start 

其餘所有節點的galera的配置文件都需要添加新的主節點的IP,添加完之後重啟服務

[root@localhost ~]# vim /etc/my.cnf.d/server.cnf wsrep_cluster_address="gcomm://192.168.38.7,192.168.38.37,192.168.38.47,192.168.38.57" [root@localhost ~]# service mysql restart [root@localhost ~]# mysql -e 'SHOW STATUS LIKE "wsrep_cluster_size";' #集群中有4個節點 +--------------------+-------+ | Variable_name | Value | +--------------------+-------+ | wsrep_cluster_size | 4 | +--------------------+-------+

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"
性能測試:深入理解線程數,併發量,TPS,看這一篇就夠了

併發數,線程數,吞吐量,每秒事務數(TPS)都是性能測試領域非常關鍵的數據和指標。

那麼他們之間究竟是怎樣的一個對應關係和內在聯繫?

測試時,我們經常容易將線程數等同於表述為併發數,這一表述正確嗎?

本文就將對性能領域的這些關鍵概念做一次探討。

文章可能會比較長,希望您保持耐心看完。


1. 走進開封菜,了解性能

①老王開了家餐廳

我們的主角老王,在M市投資新開業了一家,前來用餐的顧客絡繹不絕:

餐廳里有4種不同身份的人員:


用戶一次完整的用餐流程如下:

顧客到店小二處付款點餐 => 小二將訂單轉發給后廚 => 后廚與備菜工配合,取材完成烹飪后交給小二 => 小二上菜,顧客用餐。

假設所有顧客都不堂食而是打包帶走,也就是不考慮用戶用餐時間。餐廳完成一次訂單的時間是多久?


訂單時間 = 顧客點單時間 + 前台接收轉發時間 + 后廚取材烹飪時間 + 后廚交給服務員,服務員上菜時間。


說白了就是每個流程的耗時相加。

假設以上時間分別為1,1,5,1(分鐘),那麼一次訂單的完成時間就是8分鐘。


②問題來了

餐廳當然不可能只有一個人就餐,否則老王不要帶着小姨子跑路。

所以我們接下來看多人就餐的情況。

假設同一時間點上有兩人就餐,會發生什麼情況?


第一位用戶與第一個場景一樣,仍然是點單-下單-烹飪-上菜,8分鐘后第一位顧客拿着打包的食物離開。

第二位用戶則有所不同了。假設小二,廚師,備菜都只有一人,而且他們每個人同時只能處理一件事情。

那麼第二位用戶首先需要在點餐時等待小二1分鐘,而後廚師烹飪第一位用戶的菜時,沒有任何人在為他服務。

我們來梳理一下這個過程中,每一分鐘都發生了什麼事情:


可以看到,兩個顧客完成訂單的總時長是13分鐘。

繼續推算我們發現,每增加一人總時長增加5分鐘。

在當前的人員配置下,顧客越多,後來的顧客等待時間就越長。


③這還不是高峰期

如果餐廳在高峰時段只有兩人用餐,那估計老王還得帶着小姨子跑路。

實際一個運營得當的開封菜餐廳,在用餐高峰時段的顧客數可能高達百人。

那麼問題來了,在某個普通工作日,12:00午飯時間,帶着各種工牌的IT男女顧客蜂擁而至,餐廳瞬間擠進來一百人。

這個時候會發生什麼?

現在餐廳已經完全服務不過來了,後續的顧客等的時間越來越長,最後一位可憐的顧客要等到差不多晚上8點才能吃到飯。

這顯然是不可能的,實際上等了不到半個小時吃不上飯的顧客就都要走光了。


老王開始考慮如何應對營業高峰期的情況。

經過上面的分析,老王發現,增加各崗位人手無疑是最直觀的解決辦法!

我們可以計算一下人手增加的情況。假設把所有人員增加為2人配置:


那麼很簡單,2人就餐的情況下,由於所有人員并行服務,就餐的兩名顧客可以同一時間點餐,等待烹飪,上菜后打包走人。

而後來的客人可以看作兩條并行的線,那麼100顧客的用餐時間就很自然的減半了。

看到這裏,終於出現“并行”的概念了。


④繼續調優

通過double人員配置,老王成功的使得用餐高峰期的服務能力提高了一倍,但這還不夠。這種情況下,服務100顧客仍需差不多4個小時。

老王再次思考整個服務團隊的配置和各環節處理能力,他發現,其瓶頸就在於“后廚”。顧客的等待時間,大部分都是在等待烹飪。

那麼增加后廚能力就是重中之重,老王繼續做了一系列措施:

  • 再次double大廚人數,現在廚師們四個人同時并行做菜。
  • 讓備菜員提前將熱門食材準備好。
  • 聘請更有經驗的大廚,每個餐品烹飪時間更快,加上提前備菜,整個配餐時間縮短到2分鐘。
  • 將點餐的過程改為使用手機小程序下單,讓小二專註於上菜。

整個團隊配置變為:


 如此配置之下,這家開封菜終於可以在1小時之內就完成對100人顧客的就餐服務了!


2. 這並不是一篇餐飲管理文章

再繼續討論餐廳的服務能力調優,這可能就要變成一片餐飲博文了。

不過相信敏銳的你能看出來,第一部分我們的討論里,包含了大量與服務器性能相似的概念。

恰好,老王除了開了一家開封菜餐廳,還運營着一家網站=_=!。

這家網站的一次典型事務請求鏈路是這樣的:

你別說,還真挺像用餐流程的吧。

而且就像多人用餐的場景一樣,這個網站同樣也有多用戶請求的情況:

當一條請求從客戶端發起時,它遵循着以上的線路傳遞,線性完成。

老王發現,這家網站的性能關鍵,在於應用服務器上。就像餐廳的服務能力,主要取決於後廚團隊一樣。

當多個客戶端同時發起請求時,服務器必須具備一定的“并行”能力,否則後續進來請求會排隊而且可能超時。

說到這呢,雖然上圖我們畫的是一個,但一般都服務器的都有多處理器,輔以超線程技術。

而主流編程語言都有“多線程編程”的概念,其目的就在於合理的調度任務,將CPU的所有處理器充分的利用起來。

也就是說我們可以認為,這套應用服務本身就有不止一個“大廚”在烹飪。

取決於處理器數和多線程技術,數個事務可以以線程的方式并行處理。


不過老王對於當前服務器的性能並不滿意,就像對於餐廳一樣,老王也針對這個應用服務思考了更多調優方案:

  • 大廚的數量真的夠嗎?是不是要繼續增加人數(CPU核數,服務器節點數-硬件調優)?
  • 大廚的經驗和技術到位嗎?是不是要改聘更資深的大廚(改換具有更高頻CPU的服務器-硬件調優;調整業務邏輯效率-邏輯調優)?
  • 改良熱門餐品的備菜策略?(利用數據庫索引、緩存等技術-邏輯調優)

除了我們強調的調優重點,應用服務/后廚團隊,其他部分也是有可能成為瓶頸,需要調優解決的,比如:

  • 餐廳容量會不會無法容納排隊的客戶?(服務器容量,線程池大小,最大連接數,內存空間)
  • 小二的下單和上菜速度有沒有成為掣肘?(網絡帶寬,路由效率等。對於數據密集型服務而言,網絡帶寬很可能成為瓶頸。)
  • 等等


3. 下面是性能測試環節

接下來我們要討論如何測試一套服務的性能。

線程數:

要實現性能測試的一個必要條件,那就是我們必須要能模擬高峰期的訪問量。這一點通過正常的應用客戶端是很難辦到的(比如web應用的客戶端就是瀏覽器,你很難用瀏覽器併發向服務器發送大量請求)。

這裏就需要性能測試工具來幫忙了,主流的性能測試工具比如,等都能以線程式併發的方式,幫我們達成“短時間內向服務器發送大量請求”這一任務。

多線程式併發測試工具,顧名思義,會啟動複數個線程,讓每個線程獨立向服務器端發出請求。

有時候我們在描述性能測試過程時,會將這個客戶端的獨立線程數表述為“併發數”。

但是注意,這裏的“併發”指的是客戶端併發,很簡單,客戶端能發出很多請求,服務器卻未必能處理得了是不是?

并行數:

那麼服務器一次性能同時處理多少事務請求呢?

根據我們之前的討論,同一時間節點上同時處理的事務數最大就是:CPU處理器數*服務器超線程倍率。

比如對於一個8核未超線程CPU,某時間節點上的同時處理的事務不會超過8個。類比於8個廚師,同一時間點上只能處理8份餐品。

而超線程技術就像是給廚師們來了一場“左右互搏”培訓,讓每個人都能一心二用,一次處理2份餐品。

這裏我們描述的“同時8個”事務,就是“并行/平行”的含義。

併發數:

注意上面我們討論的“并行數”,不是”併發數“。否則我們直接看CPU核數就能確定併發數了。

併發數指的是一個時間段內的事務完成數。這個切片“時間段”常取1秒鐘或1分鐘這樣的整數來做換算。

假設一個廚師平均2分鐘做完一道菜,那麼8個廚師2分鐘完成8道菜,換算一下就是4道/分鐘。

如果以分鐘為單位進行統計,那麼這個数字就是最終結果。

每秒事務數(TPS):

一般應用服務器的處理速度跟廚師做菜是不在一個數量級的,常見的事務請求在應用服務器端的處理時間以毫秒為單位計算。

所以測試性能時,我們更常用“1秒鐘”來作為切片時間段。

一秒鐘完成多少個事務請求,這個數據就是我們耳熟能詳的“每秒事務數”。

這個指標翻譯成英文就是TPS – Transaction Per Seconds。(也有用QPS – Query Per Seconds來統計的,其差異暫時不做討論了)

每秒事務數,就是衡量服務器性能的最重要也是最直觀指標。

每秒能完成的事務數越多,那麼每分鐘能完成的事務就越多,每天完成的事務數就越多 — 簡單的小學數學。

那麼他直接能影響到一個應用服務每天平均能承受的訪問量/請求量,以及業務高峰期能承受的壓力。

平均響應時間:

那麼有哪些因素會影響到TPS數值?

有兩個主要的維度:

  • 單個事務響應速度
  • 同一時間能并行執行的事務

第二點我們說了,它主要跟服務器資源配置,線程池容量,線程調度等相關。

第一點換一個說法就是:事務平均響應時間。單個事務平均下來完成的速度越快,那麼單位時間內能完成的事務數就越多,TPS就越高 — 簡單的小學數學。

所以在進行性能調優時,除了服務器容量資源,單個事務響應速度是另一個關注的重點。

要關注事務響應速度/時間,可以考慮在事務內部邏輯節點添加“耗時探針”的方式,來探測每個步驟分別花費的時間,從而找出可優化的部分。


吞吐量

吞吐量是在性能探測過程中經常冒出來的名詞,怎麼理解他呢?

簡單的結論就是,吞吐量是站在“量”的角度去度量,是一個參考指標。

但是光有“量”的數據有時候並無太大價值,一家餐廳1個小時賣出100份餐品和一個月才賣出100份餐品,單從“量”的維度衡量肯定不行,時間維度很重要!

所以,性能測試領域的吞吐量通常會結合上時間維度進行統計。

如果吞吐量的“量”以“事務”為統計單位的話,結合時間維度,轉化以後可以很容換算成TPS。


4. 最後,關於性能測試的一些碎碎念

測試類型

由於測試目標的不同,性能測試可能存在很多種形式。

比如明確了解日訪問量和巔峰訪問量,測試服務器是否能夠承受響應壓力的測試。

比如用於探測系統負載極限和性能拐點的測試。

比如衡量系統在高負載情況下,長時間運行是否穩定的測試。

這許多種形式我們暫且不做討論,不過所有以上測試的基礎都是它 — “併發測試”。

製造併發,是性能測試的基本實現辦法。

進一步細化理解客戶端線程數和併發量的關係

設服務器併發能力為每秒完成1個事務,即TPS=1/s。且服務器使用單核處理器,現用Jmeter啟動5個線程循環進行併發測試,那麼每個切片時間(每秒)都發生了什麼?

我們可以用如下圖表來分析:

其中,為線程可執行(等待執行),為線程正在執行,表示線程執行完畢。


假設其他條件不變,增加服務器并行處理數為2(增加CPU核數為2,以及合理的線程調度機制)那麼變為:

這裏真實的併發數(服務器單位時間完成的事務數)就是圖中每一秒鐘完成的事務數。

而客戶端啟動的其他未處理的線程則在“排隊等待”。

線程併發數量

那麼製造多少併發,換言之,我應該用多少併發線程數去進行測試?

實際上客戶端發起的線程數與服務器可達到的併發數並無直接關係,但你應該使用足夠的線程數,讓服務器達到事務飽和。

如何判斷服務器是否達到飽和?這時我們可以採取階梯增壓的方式,不斷加大客戶端線程數量,直到服務器處理不過來,事務頻繁超時,這時就得到了服務器處理能力極限。

根據不同的測試類型,取這個極限數量的一定百分比作為客戶端線程數。

比如說,負載測試中,通常取達到這個極限數值的70%。

客戶端損耗

我們在討論餐廳訂單流程和服務器事務流程時,流程圖裡包括了顧客/客戶端。

顧客點餐要不要花時間?當然要,如果他患上選擇困難症,甚至有可能在下單的時候花去大量時間。

同理,客戶端從啟動線程到構造請求併發出,這一過程也有一定的時間損耗。

通常在測試服務器性能的時候,客戶端性能是應該被剝離出去的,所以測試時應該盡量降低客戶端時間損耗。

  • 適當增加客戶端線程循環次數 – 稀釋這些線程啟動的佔用時間
  • 當客戶端線程數需要較大數量時(對jmeter而言,超過1000左右),客戶機/測試機的資源佔用會增大,整個客戶端的請求構造時間會拉長。應該考慮分佈式測試。
  • 盡量減少客戶端請求構造時間,比如beanshell請求加密,如果過程過於複雜也會耗去可觀時間。極限測試情況下應考慮簡化。


那麼本文到這裏告一段落。

希望能幫助理解性能測試領域的這些關鍵概念和原理。


,再繼續討論餐廳的服務能力調優,這可能就要變成一片餐飲博文了。

不過相信敏銳的你能看出來,第一部分我們的討論里,包含了大量與服務器性能相似的概念。

恰好,老王除了開了一家開封菜餐廳,還運營着一家網站=_=!。

這家網站的一次典型事務請求鏈路是這樣的:

你別說,還真挺像用餐流程的吧。

而且就像多人用餐的場景一樣,這個網站同樣也有多用戶請求的情況:

當一條請求從客戶端發起時,它遵循着以上的線路傳遞,線性完成。

老王發現,這家網站的性能關鍵,在於應用服務器上。就像餐廳的服務能力,主要取決於後廚團隊一樣。

當多個客戶端同時發起請求時,服務器必須具備一定的“并行”能力,否則後續進來請求會排隊而且可能超時。

說到這呢,雖然上圖我們畫的是一個,但一般都服務器的都有多處理器,輔以超線程技術。

而主流編程語言都有“多線程編程”的概念,其目的就在於合理的調度任務,將CPU的所有處理器充分的利用起來。

也就是說我們可以認為,這套應用服務本身就有不止一個“大廚”在烹飪。

取決於處理器數和多線程技術,數個事務可以以線程的方式并行處理。


不過老王對於當前服務器的性能並不滿意,就像對於餐廳一樣,老王也針對這個應用服務思考了更多調優方案:

  • 大廚的數量真的夠嗎?是不是要繼續增加人數(CPU核數,服務器節點數-硬件調優)?
  • 大廚的經驗和技術到位嗎?是不是要改聘更資深的大廚(改換具有更高頻CPU的服務器-硬件調優;調整業務邏輯效率-邏輯調優)?
  • 改良熱門餐品的備菜策略?(利用數據庫索引、緩存等技術-邏輯調優)

除了我們強調的調優重點,應用服務/后廚團隊,其他部分也是有可能成為瓶頸,需要調優解決的,比如:

  • 餐廳容量會不會無法容納排隊的客戶?(服務器容量,線程池大小,最大連接數,內存空間)
  • 小二的下單和上菜速度有沒有成為掣肘?(網絡帶寬,路由效率等。對於數據密集型服務而言,網絡帶寬很可能成為瓶頸。)
  • 等等


3. 下面是性能測試環節

接下來我們要討論如何測試一套服務的性能。

線程數:

要實現性能測試的一個必要條件,那就是我們必須要能模擬高峰期的訪問量。這一點通過正常的應用客戶端是很難辦到的(比如web應用的客戶端就是瀏覽器,你很難用瀏覽器併發向服務器發送大量請求)。

這裏就需要性能測試工具來幫忙了,主流的性能測試工具比如,等都能以線程式併發的方式,幫我們達成“短時間內向服務器發送大量請求”這一任務。

多線程式併發測試工具,顧名思義,會啟動複數個線程,讓每個線程獨立向服務器端發出請求。

有時候我們在描述性能測試過程時,會將這個客戶端的獨立線程數表述為“併發數”。

但是注意,這裏的“併發”指的是客戶端併發,很簡單,客戶端能發出很多請求,服務器卻未必能處理得了是不是?

并行數:

那麼服務器一次性能同時處理多少事務請求呢?

根據我們之前的討論,同一時間節點上同時處理的事務數最大就是:CPU處理器數*服務器超線程倍率。

比如對於一個8核未超線程CPU,某時間節點上的同時處理的事務不會超過8個。類比於8個廚師,同一時間點上只能處理8份餐品。

而超線程技術就像是給廚師們來了一場“左右互搏”培訓,讓每個人都能一心二用,一次處理2份餐品。

這裏我們描述的“同時8個”事務,就是“并行/平行”的含義。

併發數:

注意上面我們討論的“并行數”,不是”併發數“。否則我們直接看CPU核數就能確定併發數了。

併發數指的是一個時間段內的事務完成數。這個切片“時間段”常取1秒鐘或1分鐘這樣的整數來做換算。

假設一個廚師平均2分鐘做完一道菜,那麼8個廚師2分鐘完成8道菜,換算一下就是4道/分鐘。

如果以分鐘為單位進行統計,那麼這個数字就是最終結果。

每秒事務數(TPS):

一般應用服務器的處理速度跟廚師做菜是不在一個數量級的,常見的事務請求在應用服務器端的處理時間以毫秒為單位計算。

所以測試性能時,我們更常用“1秒鐘”來作為切片時間段。

一秒鐘完成多少個事務請求,這個數據就是我們耳熟能詳的“每秒事務數”。

這個指標翻譯成英文就是TPS – Transaction Per Seconds。(也有用QPS – Query Per Seconds來統計的,其差異暫時不做討論了)

每秒事務數,就是衡量服務器性能的最重要也是最直觀指標。

每秒能完成的事務數越多,那麼每分鐘能完成的事務就越多,每天完成的事務數就越多 — 簡單的小學數學。

那麼他直接能影響到一個應用服務每天平均能承受的訪問量/請求量,以及業務高峰期能承受的壓力。

平均響應時間:

那麼有哪些因素會影響到TPS數值?

有兩個主要的維度:

  • 單個事務響應速度
  • 同一時間能并行執行的事務

第二點我們說了,它主要跟服務器資源配置,線程池容量,線程調度等相關。

第一點換一個說法就是:事務平均響應時間。單個事務平均下來完成的速度越快,那麼單位時間內能完成的事務數就越多,TPS就越高 — 簡單的小學數學。

所以在進行性能調優時,除了服務器容量資源,單個事務響應速度是另一個關注的重點。

要關注事務響應速度/時間,可以考慮在事務內部邏輯節點添加“耗時探針”的方式,來探測每個步驟分別花費的時間,從而找出可優化的部分。


吞吐量

吞吐量是在性能探測過程中經常冒出來的名詞,怎麼理解他呢?

簡單的結論就是,吞吐量是站在“量”的角度去度量,是一個參考指標。

但是光有“量”的數據有時候並無太大價值,一家餐廳1個小時賣出100份餐品和一個月才賣出100份餐品,單從“量”的維度衡量肯定不行,時間維度很重要!

所以,性能測試領域的吞吐量通常會結合上時間維度進行統計。

如果吞吐量的“量”以“事務”為統計單位的話,結合時間維度,轉化以後可以很容換算成TPS。


4. 最後,關於性能測試的一些碎碎念

測試類型

由於測試目標的不同,性能測試可能存在很多種形式。

比如明確了解日訪問量和巔峰訪問量,測試服務器是否能夠承受響應壓力的測試。

比如用於探測系統負載極限和性能拐點的測試。

比如衡量系統在高負載情況下,長時間運行是否穩定的測試。

這許多種形式我們暫且不做討論,不過所有以上測試的基礎都是它 — “併發測試”。

製造併發,是性能測試的基本實現辦法。

進一步細化理解客戶端線程數和併發量的關係

設服務器併發能力為每秒完成1個事務,即TPS=1/s。且服務器使用單核處理器,現用Jmeter啟動5個線程循環進行併發測試,那麼每個切片時間(每秒)都發生了什麼?

我們可以用如下圖表來分析:

其中,為線程可執行(等待執行),為線程正在執行,表示線程執行完畢。


假設其他條件不變,增加服務器并行處理數為2(增加CPU核數為2,以及合理的線程調度機制)那麼變為:

這裏真實的併發數(服務器單位時間完成的事務數)就是圖中每一秒鐘完成的事務數。

而客戶端啟動的其他未處理的線程則在“排隊等待”。

線程併發數量

那麼製造多少併發,換言之,我應該用多少併發線程數去進行測試?

實際上客戶端發起的線程數與服務器可達到的併發數並無直接關係,但你應該使用足夠的線程數,讓服務器達到事務飽和。

如何判斷服務器是否達到飽和?這時我們可以採取階梯增壓的方式,不斷加大客戶端線程數量,直到服務器處理不過來,事務頻繁超時,這時就得到了服務器處理能力極限。

根據不同的測試類型,取這個極限數量的一定百分比作為客戶端線程數。

比如說,負載測試中,通常取達到這個極限數值的70%。

客戶端損耗

我們在討論餐廳訂單流程和服務器事務流程時,流程圖裡包括了顧客/客戶端。

顧客點餐要不要花時間?當然要,如果他患上選擇困難症,甚至有可能在下單的時候花去大量時間。

同理,客戶端從啟動線程到構造請求併發出,這一過程也有一定的時間損耗。

通常在測試服務器性能的時候,客戶端性能是應該被剝離出去的,所以測試時應該盡量降低客戶端時間損耗。

  • 適當增加客戶端線程循環次數 – 稀釋這些線程啟動的佔用時間
  • 當客戶端線程數需要較大數量時(對jmeter而言,超過1000左右),客戶機/測試機的資源佔用會增大,整個客戶端的請求構造時間會拉長。應該考慮分佈式測試。
  • 盡量減少客戶端請求構造時間,比如beanshell請求加密,如果過程過於複雜也會耗去可觀時間。極限測試情況下應考慮簡化。


那麼本文到這裏告一段落。

希望能幫助理解性能測試領域的這些關鍵概念和原理。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

Python 併發總結,多線程,多進程,異步IO

1 測量函數運行時間

import time
def profile(func):
    def wrapper(*args, **kwargs):
        import time
        start = time.time()
        func(*args, **kwargs)
        end   = time.time()
        print 'COST: {}'.format(end - start)
    return wrapper
 
@profile
def fib(n):
    if n<= 2:
        return 1
    return fib(n-1) + fib(n-2)
 
fib(35)


2 啟動多個線程,並等待完成   2.1 使用threading.enumerate()

import threading
for i in range(2):
    t = threading.Thread(target=fib, args=(35,))
    t.start()
main_thread = threading.currentThread()
 
for t in threading.enumerate():
    if t is main_thread:
        continue
    t.join()


2.2 先保存啟動的線程

threads = []
for i in range(5):
    t = Thread(target=foo, args=(i,))
    threads.append(t)
    t.start()
for t in threads:
    t.join()

  3 使用信號量,限制同時能有幾個線程訪問臨界區

from threading import Semaphore
import time
 
sema = Semaphore(3)
 
def foo(tid):
    with sema:
        print('{} acquire sema'.format(tid))
        wt = random() * 2
        time.sleep(wt)
        print('{} release sema'.format(tid))


4 鎖,相當於信號量為1的情況

from threading import Thread Lock
value = 0
lock = Lock()
def getlock():
    global lock
    with lock:
        new = value + 1
        time.sleep(0.001)
        value = new


  5 可重入鎖RLock     acquire() 可以不被阻塞的被同一個線程調用多次,release()需要和acquire()調用次數匹配才能釋放鎖 6 條件 Condition 一個線程發出信號,另一個線程等待信號 常用於生產者-消費者模型

import time
import threading
 
def consumer(cond):
    t = threading.currentThread()
    with cond:
        cond.wait()
        print("{}: Resource is available to sonsumer".format(t.name))
 
def producer(cond):
    t = threading.currentThread()
    with cond:
        print("{}: Making resource available".format(t.name))
        cond.notifyAll()
 
condition = threading.Condition()
c1 = threading.Thread(name='c1', target=consumer, args=(condition,))
c2 = threading.Thread(name='c2', target=consumer, args=(condition,))
p = threading.Thread(name='p', target=producer, args=(condition,))
 
c1.start()
c2.start()
p.start()


  7 事件 Event 感覺和Condition 差不多

import time
import threading
from random import randint
 
TIMEOUT = 2
 
def consumer(event, l):
    t = threading.currentThread()
    while 1:
        event_is_set = event.wait(TIMEOUT)
        if event_is_set:
            try:
                integer = l.pop()
                print '{} popped from list by {}'.format(integer, t.name)
                event.clear()  # 重置事件狀態
            except IndexError:  # 為了讓剛啟動時容錯
                pass
 
def producer(event, l):
    t = threading.currentThread()
    while 1:
        integer = randint(10, 100)
        l.append(integer)
        print '{} appended to list by {}'.format(integer, t.name)
        event.set()  # 設置事件
        time.sleep(1)
 
event = threading.Event()
l = []
 
threads = []
 
for name in ('consumer1', 'consumer2'):
    t = threading.Thread(name=name, target=consumer, args=(event, l))
    t.start()
    threads.append(t)
 
p = threading.Thread(name='producer1', target=producer, args=(event, l))
p.start()
threads.append(p)
 
 
for t in threads:
    t.join()


  8 線程隊列  線程隊列有task_done() 和 join() 標準庫里的例子 往隊列內放結束標誌,注意do_work阻塞可能無法結束,需要用超時

import queue
def worker():
    while True:
        item = q.get()
        if item is None:
            break
        do_work(item)
        q.task_done()
q = queue.Queue()
threads = []
for i in range(num_worker_threads):
    t = threading.Thread(target=worker)
    t.start()
    threads.append(t)
for item in source():
    q.put(item)
q.join()
for i in range(num_worker_threads):
    q.put(None)
for t in threads:
    t.join()


  9 優先級隊列 PriorityQueue

import threading
from random import randint
from queue import PriorityQueue
 
q = PriorityQueue()
 
def double(n):
    return n * 2
 
def producer():
    count = 0
    while 1:
        if count > 5:
            break
        pri = randint(0, 100)
        print('put :{}'.format(pri))
        q.put((pri, double, pri))  # (priority, func, args)
        count += 1
 
def consumer():
    while 1:
        if q.empty():
            break
        pri, task, arg = q.get()
        print('[PRI:{}] {} * 2 = {}'.format(pri, arg, task(arg)))
        q.task_done()
        time.sleep(0.1)
 
t = threading.Thread(target=producer)
t.start()
time.sleep(1)
t = threading.Thread(target=consumer)
t.start()


  10 線程池 當線程執行相同的任務時用線程池 10.1 multiprocessing.pool 中的線程池

from multiprocessing.pool import ThreadPool
pool = ThreadPool(5)
pool.map(lambda x: x**2, range(5))


10.2 multiprocessing.dummy

from multiprocessing.dummy import Pool


10.3 concurrent.futures.ThreadPoolExecutor

from concurrent.futures improt ThreadPoolExecutor
from concurrent.futures import as_completed
import urllib.request
 
URLS = ['http://www.baidu.com', 'http://www.hao123.com']
 
def load_url(url, timeout):
    with urllib.request.urlopen(url, timeout=timeout) as conn:
        return conn.read()
 
with ThreadPoolExecutor(max_workers=5) as executor:
    future_to_url = {executor.submit(load_url, url, 60): url for url in URLS}
    for future in as_completed(future_to_url):
        url = future_to_url[future]
        try:
            data = future.result()
        execpt Exception as exc:
            print("%r generated an exception: %s" % (url, exc))
        else:
            print("%r page is %d bytes" % (url, len(data)))


11 啟動多進程,等待多個進程結束

import multiprocessing
jobs = []
for i in range(2):
    p = multiprocessing.Process(target=fib, args=(12,))
    p.start()
    jobs.append(p)
for p in jobs:
    p.join()


12 進程池 12.1 multiprocessing.Pool

from multiprocessing import Pool
pool = Pool(2)
pool.map(fib, [36] * 2)


  12.2 concurrent.futures.ProcessPoolExecutor

from concurrent.futures import ProcessPoolExecutor
import math
 
PRIMES = [ 112272535095293, 112582705942171]
 
def is_prime(n):
    if n < 2:
        return False
    if n == 2:
        return True
    if n % 2 == 0:
        return False
    sqrt_n = int(math.floor(math.sqrt(n)))
    for i in range(3, sqrt_n + 1, 2):
        if n % i == 0:
            return False
    return True
 
if __name__ == "__main__":
    with ProcessPoolExecutor() as executor:
        for number, prime in zip(PRIMES, executor.map(is_prime, PRIMES)):
            print("%d is prime: %s" % (number, prime))


  13 asyncio   13.1 最基本的示例,單個任務

import asyncio
 
async def hello():
    print("Hello world!")
    await asyncio.sleep(1)
    print("Hello again")
 
loop = asyncio.get_event_loop()
loop.run_until_complete(hello())
loop.close()


13.2 最基本的示例,多個任務

import asyncio
 
async def hello():
    print("Hello world!")
    await asyncio.sleep(1)
    print("Hello again")
 
loop = asyncio.get_event_loop()
tasks = [hello(), hello()]
loop.run_until_complete(asyncio.wait(tasks))
loop.close()


  13.3 結合httpx 執行多個任務並接收返回結果 httpx 接口和 requests基本一致

import asyncio
import httpx
 
 
async def get_url():
    r = await httpx.get("http://www.baidu.com")
    return r.status_code
 
 
loop = asyncio.get_event_loop()
tasks = [get_url() for i in range(10)]
results = loop.run_until_complete(asyncio.gather(*tasks))
loop.close()
 
 
for num, result in zip(range(10), results):
    print(num, result)


   本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

CQRS+ES項目解析-Diary.CQRS

在《當我們在討論CQRS時,我們在討論些神馬》中,我們討論了當使用CQRS的過程中,需要關心的一些問題。其中與CQRS關聯最為緊密的模式莫過於Event Sourcing了,CQRS與ES的結合,為我們構造高性能、可擴展系統提供了基本思路。本文將介紹
Kanasz Robert在《Introduction to CQRS》中的示例項目Diary.CQRS。

獲取Diary.CQRS項目

該項目為Kanasz Robert為了介紹CQRS模式而寫的一個測試項目,原始項目可以通過訪問《Introduction to CQRS》來獲取,由於項目版本比較舊,沒有使用nuget管理程序包等,導致下載以後並不能正常運行,我下載了這個項目,升級到Visual Studio 2017,重新引用了StructMap框架(使用nuget),移除了Web層報錯的代碼,並上傳到博客園,可以從這裏下載:Diary.CQRS.rar

Diary.CQRS項目簡介

Diary.CQRS項目的場景為日記本管理,提供了新增、編輯、刪除、列表等功能,整個解決方案分為三個項目:

  • Diary.CQRS:核心項目,完成了EventBus、CommandBus、Domain、Storage等功能,也是我們分析的重點。
  • Diary.CQRS.Configuration:服務配置,通過ServiceLocator類進行依賴注入、服務查找功能。
  • Diary.CQRS.Web:用戶界面,MVC項目。

這是一個很好的入門項目,功能簡單、結構清晰,概念覆蓋全面。如果CQRS是一個城堡,那麼Diary.CQRS則是打開第一重門的鑰匙,接下來讓我們一起推開這扇門吧。

Diary.CQRS.Web

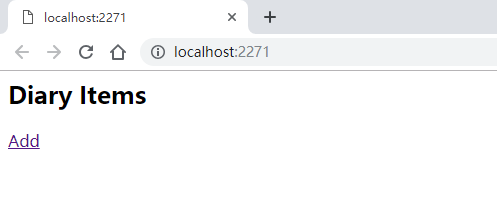
運行項目,最先看到的是一個Web頁面,如下圖:

很簡單,只有一個Add按鈕,當我們點擊以後,會進入添加的頁面:

我們填上一些內容,然後點擊Save按鈕,就會返回到列表頁,我們可以看到已添加的條目:

然後我們進行編輯操作,點擊列表中的Edit按鈕,跳轉到編輯頁面:

雖然頁面中显示的是Add,但確實是Edit頁面。我們編輯以後點擊Save按鈕,然後返回列表頁即可看到編輯后的內容。

在列表頁中,如果我們點擊Delete按鈕,則會刪除改條目。

到此為止,我們已經看到了這個項目的所有頁面,一個簡單的CURD操作。我們繼續看它的代碼(在HomeController中)。

Index:列表頁面

public ActionResult Index()
{
    ViewBag.Model = ServiceLocator.ReportDatabase.GetItems();
    return View();
}

通過ServiceLocator定位ReportDatabase,並從ReportDatabase中獲取所有條目。

Add:新增頁面

public ActionResult Add()
{
    return View();
}

[HttpPost]
public ActionResult Add(DiaryItemDto item)
{
    ServiceLocator.CommandBus.Send(new CreateItemCommand(Guid.NewGuid(), item.Title, item.Description, -1, item.From, item.To));
    return RedirectToAction("Index");
}

兩個方法:

  • Add()方法,處理Get請求,返回新增視圖;
  • Add(DiaryItemDto item)方法,接收DiaryItemDto參數,處理Post請求,創建併發送CreateItemCommand命令,然後返回到Index頁面

Edit:編輯頁面

public ActionResult Edit(Guid id)
{
    var item = ServiceLocator.ReportDatabase.GetById(id);
    var model = new DiaryItemDto()
    {
        Description = item.Description,
        From = item.From,
        Id = item.Id,
        Title = item.Title,
        To = item.To,
        Version = item.Version
    };
    return View(model);
}

[HttpPost]
public ActionResult Edit(DiaryItemDto item)
{
    ServiceLocator.CommandBus.Send(new ChangeItemCommand(item.Id, item.Title, item.Description, item.From, item.To, item.Version));
    return RedirectToAction("Index");
}

仍然是兩個方法:

  • Edit(Guid id)方法,接收Guid作為參數,並從ReportDatabase中獲取數據,構建dto對象返回給頁面
  • Edit(DiaryItemDto item)方法,接收DiaryItemDto對象,處理Post請求,接收到請求以後根據dto對象創建ChangeItemCommand命令,然後返回到Index頁面

Delete:刪除操作

public ActionResult Delete(Guid id)
{
    var item = ServiceLocator.ReportDatabase.GetById(id);
    ServiceLocator.CommandBus.Send(new DeleteItemCommand(item.Id, item.Version));
    return RedirectToAction("Index");
}

對於刪除操作來說,它沒有視圖頁面,接收到請求以後,先獲取該記錄,創建併發送DeleteImteCommand命令,然後返回到Index頁面

題外話:對於改變數據狀態的操作,使用Get請求是不可取的,可能存在安全隱患

通過上面的代碼,你會發現所有的操作都是從ServiceLocator發起的,通過它我們能夠定位到CommandBus和ReportDatabase,從而進行相應的操作,我們在接下來會介紹ServiceLocator類。

Diary.CQRS.Configuration

Diary.CQRS.Configuration 項目中定義了ServiceLocator類,這個類的作用是完成IoC容器的服務註冊、服務定位功能。例如我們可以通過ServiceLocator獲取到CommandBus實例、獲取ReportDatabase實例。

服務註冊

ServiceLocator使用StructureMap作為依賴注入框架,提供了服務註冊、服務導航的功能。ServiceLocator類通過靜態構造函數完成對服務註冊和服務實例化工作:

static ServiceLocator()
{
    if (!_isInitialized)
    {
        lock (_lockThis)
        {
            ContainerBootstrapper.BootstrapStructureMap();
            _commandBus = ObjectFactory.GetInstance<ICommandBus>();
            _reportDatabase = ObjectFactory.GetInstance<IReportDatabase>();
            _isInitialized = true;
        }
    }
}

首先調用ContainerBootstrapper.BootstrapStructureMap()方法,這個方法裡面包含了對將服務添加到容器的代碼;然後使用容器創建CommandBus和ReportDatabase的實例。

  • CommandBus:命令總線,對應Command操作,用來發送命令,程序中需要定義相應的命令處理器,從而完成具體的操作。
  • ReportDatabase:報表數據庫,對應Query操作,用來獲取數據。

ServiceLocator的重要之處在於對外暴露了兩個至關重要的實例,分別處理CQRS中的Command和Query。

為什麼沒有Event相關操作呢?到目前為止我們還沒有涉及到,因為對於UI層來說,用戶的意圖都是通過Command表示的,而數據的狀態變化才會觸發Event。

Diary.CQRS

在ServiceLocator中定義了獲取CommandBus和ReportDatabase的方法,我們順着這兩個對象繼續分析。

CommandBus

在基於消息的系統設計中,我們常會看到總線的身影,Command也是一種消息,所以使用總線是再合適不過的了。CommandBus就是我們在Diary.CQRS項目中用到的一種消息總線。

在Diary.CQRS中,它被定義在Messaging目錄,在這個目錄下面,還有與Event相關的EventBus,我們稍後再進行介紹。

CommandBus實現ICommandBus接口,ICommandBus接口的定義如下:

public interface ICommandBus
{
    void Send<T>(T command) where T : Command;
}

它只包含了Send方法,用來將命令發送到對應的處理程序。

CommandBus是ICommand的實現,具體代碼如下:

public class CommandBus:ICommandBus
{
    private readonly ICommandHandlerFactory _commandHandlerFactory;

    public CommandBus(ICommandHandlerFactory commandHandlerFactory)
    {
        _commandHandlerFactory = commandHandlerFactory;
    }

    public void Send<T>(T command) where T : Command
    {
        var handler = _commandHandlerFactory.GetHandler<T>();
        if (handler!=null)
        {
            handler.Execute(command);
        }
        else
        {
            throw new Exception();
        }
    }
}

在CommandBus中,顯式依賴ICommandHandlerFactory類,通過構造函數進行注入。那麼 _commandHandlerFactory 的作用是什麼呢?我們在Send方法中可以看到,通過 _commandHandlerFactory 可以獲取到與Command對應的CommandHandler(命令處理程序),在程序的設計上,每一個Command都會有一個對應的CommandHandler,而手工判斷類型、實例化處理程序顯然不符合使用習慣,此處採用工廠模式來獲取命令處理程序。

當獲取到與Command對應的CommandHandler后,調用handler的Execute方法,執行該命令。

截止目前為止,我們又接觸了三個概念:CommandHandlerFactory、CommandHandler、Command:

  • CommandHandlerFactory:命令處理程序工廠,通過GetHandler方法獲取到與命令對應的處理程序
  • CommandHandler:命令處理程序,用於執行對應的命令
  • Command:命令,描述用戶的意圖、並包含與意圖相關的數據

CommandHandlerFactory

使用簡單工廠模式,用來獲取與命令對應的處理程序。它的代碼在Utils文件夾中,它的作用是提供一種獲取Handler的方式,所以它只能作為工具存在。

接口定義如下:

public interface ICommandHandlerFactory
{
    ICommandHandler<T> GetHandler<T>() where T : Command;
}

只有GetHandler一個方法,它的實現是 StructureMapCommandHandlerFactory,即通過StructureMap作為依賴注入框架來實現的,代碼也比較簡單,這裏不再貼出來了。

Command和CommandHandler

命令是代表用戶的意圖、並包含與意圖相關的數據,比如用戶想要添加一條數據,這便是一個意圖,於是就有了CreateItemCommand,用戶要在界面上填寫添加操作必須的數據,於是就有了命令的屬性。

關於命令的定義如下:

public interface ICommand
{
    Guid Id { get; }
}

public class Command : ICommand
{
    public Guid Id { get; private set; }
    public int Version { get; set; }

    public Command(Guid id, int version)
    {
        Id = id;
        Version = version;
    }
}
  • ICommand接口:包含Id屬性,這個Id表示Command對應聚合的Id。聚合是領域驅動開發(DDD)的概念,表示一組強關聯的領域對象,而對聚合中狀態的變更,只能通過聚合根(AggregateRoot)來完成。
  • Command類:實現了ICommand接口,並增加了Version屬性,用來標記當前操作對應的聚合跟的版本。

    為什麼要有版本的概念的?因為當使用ES模式的時候,數據庫中的數據都是事件產生的數據鏡像,保存了某個時間點的數據快照,如果要獲取到最新的數據,則需要通過加載該聚合根對應的所有Event來回放到最新狀態。如果引入版本的概念,每一個Event對應一個版本,而景象中的數據也有一個版本,在進行回放的時候,可以僅加載高版本的Event進行回放,節省了系統資源,並提高了運行效率。

命令處理程序,它的作用是處理與它相對應的命令,處理CQRS的核心,接口定義如下:

public interface ICommandHandler<TCommand> where TCommand : Command
{
    void Execute(TCommand command);
}

它接收command作為參數,執行該命令的處理邏輯。每一個命令都有一個與之對應的處理程序。

我們再重新梳理一下流程,首先用戶要新增一個數據,點擊保存按鈕后,生成CreateItemCommand命令,隨後這個命令被發送到CommandBus中,CommandBus通過CommandHandlerFactory找到該Command的處理程序,此時在CommandBus的Send方法中,我們有一個Command和CommandHandler,然後調用CommandHandler的Execute方法,即完成了該方法的處理。至此,Command的處理流程完結。

CreateItemCommand和CreateItemCommandHandler

我們來看一下CreateItemCommand的代碼:

public class CreateItemCommand : Command
{
    public string Title { get; internal set; }
    public string Description { get; internal set; }
    public DateTime From { get; internal set; }
    public DateTime To { get; internal set; }

    public CreateItemCommand(Guid aggregateId, string title,
        string description, int version, DateTime from, DateTime to)
        : base(aggregateId, version)
    {
        Title = title;
        Description = description;
        From = from;
        To = to;
    }
}

它繼承自Command基類,繼承后即擁有了Id和Version屬性,然後又定義了幾個其它的屬性。它只包含數據,與該命令對應的處理程序叫做CreateItemCommandHandler,代碼如下:

public class CreateItemCommandHandler : ICommandHandler<CreateItemCommand>
{
    private IRepository<DiaryItem> _repository;

    public CreateItemCommandHandler(IRepository<DiaryItem> repository)
    {
        _repository = repository;
    }

    public void Execute(CreateItemCommand command)
    {
        if (command == null)
        {
            throw new Exception();
        }
        if (_repository == null)
        {
            throw new Exception();
        }
        var aggregate = new DiaryItem(command.Id, command.Title, command.Description, command.From, command.To);
        aggregate.Version = -1;
        _repository.Save(aggregate, aggregate.Version);
    }
}

這才是我們要分析的核心,在Handler中,我們看到了Repository,看到了DiaryItem聚合:

  • IRepository :倉儲類,代表數據的儲存方式,通過倉儲能夠進行數據操作
  • DiaryItem:領域對象,聚合根,所有數據狀態的變更只能通過聚合根來修改

在上面的代碼中,由於是新增,所以聚合的版本為-1,然後調用倉儲的Save方法進行保存。我們繼續往下扒,看看倉儲和聚合的實現。

Repository

對於Repository的定義,仍然先看一下接口中的定義,代碼如下:

public interface IRepository<T> where T : AggregateRoot, new()
{
    void Save(AggregateRoot aggregate, int expectedVersion);
    T GetById(Guid id);
}

在倉儲中只有兩個方法:

  • Save(AggregateRoot aggregate, int expectedVersion):保存期望版本的聚合根
  • GetById(Guid id):根據聚合根Id獲取聚合根

關於IRepository的實現,代碼在Repository.cs中,我們拆開來進行介紹:

private readonly IEventStorage _eventStorage;
private static object _lock = new object();

public Repository(IEventStorage eventStorage)
{
    _eventStorage = eventStorage;
}

首先是它的構造函數,強依賴IEventStorage,通過構造函數注入。EventStorage是事件的儲存倉庫,有個更為熟知的名字EventStore,我們稍後進行介紹。

public T GetById(Guid id)
{
    IEnumerable<Event> events;
    var memento = _eventStorage.GetMemento<BaseMemento>(id);
    if (memento != null)
    {
        events = _eventStorage.GetEvents(id).Where(e => e.Version >= memento.Version);
    }
    else
    {
        events = _eventStorage.GetEvents(id);
    }
    var obj = new T();
    if (memento != null)
    {
        ((IOriginator)obj).SetMemento(memento);
    }
    obj.LoadsFromHistory(events);
    return obj;
}

GetById(Guid id)方法通過Id獲取一個聚合對象,獲取一個聚合對象有以下幾個步驟:

  • 首先會從EventStorage中獲取到該聚合的快照(memento的翻譯為記憶碎片、紀念品、備忘錄,用來聚合對象的快照)。
  • 加載Event列表,加載到的事件列表將用來做事件回放。

    如果獲取到快照的話,則加載版本高於該快照版本的事件列表,如果沒有獲取到快照,則加載全部事件列表。此處在上面已經介紹過,通過快照的方式保存聚合對象,在獲取數據時可以減少重放事件的數量,起到提高加載速度的作用。

  • 實例化聚合根,對應代碼中的var obj = new T();。
  • 從快照中設置聚合根的狀態。在獲取到快照以後,如果快照不為空,則調用聚合根的SetMemento方法設置為快照中的狀態,SetMemento方法定義在IOriginator接口中,聚合根需要實現該接口。
  • 加載歷史事件,完成重放。完成這個步驟以後,聚合根將更新到最新狀態。

通過這幾個步驟以後,我們得到了一個最新狀態的聚合根對象。

public void Save(AggregateRoot aggregate, int expectedVersion)
{
    if (aggregate.GetUncommittedChanges().Any())
    {
        lock (_lock)
        {
            var item = new T();
            if (expectedVersion != -1)
            {
                item = GetById(aggregate.Id);
                if (item.Version != expectedVersion)
                {
                    throw new Exception();
                }
            }
            _eventStorage.Save(aggregate);
        }
    }
}

Save方法,用來保存一個聚合根對象。在這個方法中,參數expectedVersion表示期望的版本,這裏約定-1為新增的聚合根,當聚合根為新增的時候,會直接調用EventStorage中的Save方法。

關於expectedVersion參數,我們可以理解為對併發的控制,只有當expectedVersion與GetById獲取到的聚合根對象的版本相同時才能進行保存操作。

在介紹Repository類的時候,我們接觸了兩個新的概念:EventStorage和AggregateRoot,接下來我們分別進行介紹。

AggregateRoot

AggregateRoot是聚合根,他表示一組強關聯的領域對象,所有對象的狀態變更只能通過聚合根來完成,這樣可以保證數據的一致性,以及減少併發衝突。應用到EventSourcing模式中,聚合根的好處也是很明顯的,我們所有對數據狀態的變更都通過聚合根完成,而每次變更,聚合根都會生成相應的事件,在進行事件回放的時候,又通過聚合根來完成歷史事件的加載。由此我們可以看到,聚合根對象應該具備生成事件、重放事件的能力。

我們來看看聚合根基類的定義,在Domain文件夾中:

public abstract class AggregateRoot : IEventProvider{
    // ......
}

首先這是一個抽象類,實現了IEventProvider接口,該接口的定義如下:

public interface IEventProvider
{
    void LoadsFromHistory(IEnumerable<Event> history);
    IEnumerable<Event> GetUncommittedChanges();
}

它定義了兩個方法,我們分別進行說明:

  • LoadsFromHistory()方法:加載歷史事件,還原聚合根的最新狀態,我們在Repository中已經用過這個方法。
  • GetUncommittedChanges()方法:獲取未提交的事件。一個命令可能造成聚合根發生多次更改,每次更改都會產生一個事件,這些事件被暫時的保存在聚合根對象中,通過該方法可以獲取到未提交的事件列表。

為了實現這個接口,聚合根中定義了 List<Event> _changes對象,用來臨時存儲所有未提交的事件,該對象在構造函數中進行初始化。

AggregateRoot中對於該事件的實現如下:

public void LoadsFromHistory(IEnumerable<Event> history)
{
    foreach (var e in history)
    {
        ApplyChange(e, false);
    }
    Version = history.Last().Version;
    EventVersion = Version;
}

public IEnumerable<Event> GetUncommittedChanges()
{
    return _changes;
}

LoadsFromHistory方法遍歷歷史事件,並調用ApplyChange方法更新聚合根的狀態,在完成更新後設置版本號為最後一個事件的版本。GetUncommittedChanges方法比較簡單,返回對象的_changes事件列表。

接下來我們看看ApplyChange方法,該方法有兩個實現,代碼如下:

protected void ApplyChange(Event @event)
{
    ApplyChange(@event, true);
}

protected void ApplyChange(Event @event, bool isNew)
{
    dynamic d = this;
    d.Handle(Converter.ChangeTo(@event, @event.GetType()));
    if (isNew)
    {
        _changes.Add(@event);
    }
}

這兩個方法定義為protected,只能被子類訪問。我們可以理解為,ApplyChange(Event @event)方法為簡化操作,對第二個參數進行了默認為true的操作,然後調用ApplyChange(Event @event, bool isNew)方法。

在ApplyChange(Event @event, bool isNew)方法中,調用了聚合根的Handle方法,用來處理事件。如果isNew參數為true,則將事件添加到change列表中,如果為false,則認為是在進行事件回放,所以不進行事件的添加。

需要注意的是,聚合根的Handle方法,與EventHandler不同,當Event產生以後,首先由它對應的聚合根進行處理,因此聚合根要具備處理該事件的能力,如何具備呢?聚合根要實現IHandle接口,該接口的定義如下:

public interface IHandle<TEvent> where TEvent:Event
{
    void Handle(TEvent e);
}

這裏可以看出,IHandle接口是泛型的,它只對一個具體的Event類型生效,在代碼上的體現如下:

public class DiaryItem : AggregateRoot,
    IHandle<ItemCreatedEvent>,
    IHandle<ItemRenamedEvent>,
    IHandle<ItemFromChangedEvent>,
    IHandle<ItemToChangedEvent>,
    IHandle<ItemDescriptionChangedEvent>,
    IOriginator
{
    //......
}

最後,聚合根還定義了清除所有事件的方法,代碼如下:

public void MarkChangesAsCommitted()
{
    _changes.Clear();
}

MarkChangesAsCommitted()方法用來清空事件列表。

Event

終於到我們今天的另外一個核心內容了,Event是ES中的一等公民,所有的狀態變更最終都以Event的形式進行存儲,當我們要查看聚合根最新狀態的時候,可以通過事件回放來獲取。我們來看看Event的定義:

public interface IEvent
{
    Guid Id { get; }
}

IEvent接口定義了一個事件必須擁有唯一的Id進行標識。然後Event實現了IEvent接口:

public class Event:IEvent
{
    public int Version;
    public Guid AggregateId { get; set; }
    public Guid Id { get; private set; }
}

可以看到,除了Id屬性外,還添加了兩個字段Version和AggregateId。AggregateId表示該事件關聯的聚合根Id,通過該Id可以獲取到唯一的聚合根對象;Version表示事件發生時該事件的版本,每次產生新的事件,Version都會進行累加。

從而可以知道,在EventStorage中,聚合根Id對應的所有Event中的Version是順序累加的,按照Version進行排序可以得到事件發生的先後順序。

EventStorage

顧名思義,EventStorage是用來存儲Event的地方。在Diary.CQRS中,EventStorage的定義如下:

public interface IEventStorage
{
    IEnumerable<Event> GetEvents(Guid aggregateId);
    void Save(AggregateRoot aggregate);
    T GetMemento<T>(Guid aggregateId) where T : BaseMemento;
    void SaveMemento(BaseMemento memento);
}
  • GetEvents(Guid aggregateId):根據聚合根Id獲取該聚合根的所有事件
  • Save(AggregateRoot aggregate):保存方法,入參為聚合根對象,在實現上則是獲取聚合根中所有未提交的事件,隨後對這些事件進行處理
  • GetMemento():獲取快照
  • SaveMemento():存儲快照

Diary.CQRS中使用InMemory的方式實現了EventStorage,屬性和構造函數如下:

private List<Event> _events;
private List<BaseMemento> _mementoes;
private readonly IEventBus _eventBus;

public InMemoryEventStorage(IEventBus eventBus)
{
    _events = new List<Event>();
    _mementoes = new List<BaseMemento>();
    _eventBus = eventBus;
}
  • _events:事件列表,內存中存儲事件的位置,所有事件最終都會存儲在該列表中
  • _mementoes:快照列表,用於存儲聚合根的某個事件版本的狀態
  • _eventBus:事件總線,用於發布任務

當Event生成后,它並沒有馬上存入EventStorage,而是在Repository显示調用Save方法時,倉儲將存儲權交給了EventStorage,EventStorage是事件倉庫,事件倉儲在存儲時進行了如下操作:

  • 獲取聚合根中所有未提交的Event,同時獲取到聚合根當前的版本號
  • 遍歷未提交Event列表,根據聚合根版本號自動為Event生成版本號,保持自增長的特性;
  • 生成聚合根快照。示例中每3個版本生成一次,並保持到事件倉儲中。
  • 將任務添加到事件倉庫中。
  • 再次遍歷未提交Event列表,此時將進行任務發布,調用事件總線的Publish方法進行發布。

Save方法的代碼如下:

public void Save(AggregateRoot aggregate)
{
    var uncommittedChanges = aggregate.GetUncommittedChanges();
    var version = aggregate.Version;

    foreach (var @event in uncommittedChanges)
    {
        version++;
        if (version > 2)
        {
            if (version % 3 == 0)
            {
                var originator = (IOriginator)aggregate;
                var memento = originator.GetMemento();
                memento.Version = version;
                SaveMemento(memento);
            }
        }
        @event.Version = version;
        _events.Add(@event);
    }
    foreach (var @event in uncommittedChanges)
    {
        var desEvent = Converter.ChangeTo(@event, @event.GetType());
        _eventBus.Publish(desEvent);
    }
}

至此Event的處理流程就算完結了。此時所有的操作都是在主庫完成的,當事件被發布以後,訂閱了該事件的所有Handler都將會被觸發。

在Diary.CQRS項目中,EventHandler都被用來處理ReportDatabase了。

ReportDatabase

當你使用ES模式時,都存在一個嚴重問題,那就是數據查詢的問題。當用戶進行數據檢索是,必然會使用各種查詢條件,然而無論那種事件倉庫都很難滿足複雜查詢。為了解決此問題,ReportDatabase就顯得格外重要。

ReportDatabase的作用被定義為獲取數據、應對數據查詢、生成報表等,它的結構與主庫不同,可以根據不同的業務場景進行定義。

ReportDatabase的數據不是通過業務邏輯進行更新的,它通過訂閱Event進行更新。在本示例中ReportDatabase實現的很簡單,接口定義如下:

public interface IReportDatabase
{
    DiaryItemDto GetById(Guid id);
    void Add(DiaryItemDto item);
    void Delete(Guid id);
    List<DiaryItemDto> GetItems();
}

實現上,通過內存中維護一個列表,每次接收到事件以後,都對相應數據進行更新,此處不在貼出。

EventHandler、EventHandlerFactory和EventBus

在上文中已經介紹過Event,而針對Event的處理,實現邏輯上與Command非常相似,唯一的區別是,命令只可以有一個對應的處理程序,而事件則可以有多個處理程序。所以在EventHandlerFactory中獲取處理程序的方法返回了EventHandler列表,代碼如下:

public IEnumerable<IEventHandler<T>> GetHandlers<T>() where T : Event
{
    var handlers = GetHandlerType<T>();

    var lstHandlers = handlers.Select(handler => (IEventHandler<T>)ObjectFactory.GetInstance(handler)).ToList();
    return lstHandlers;
}

在EventBus中,如果一個事件沒有處理程序也不會引發錯誤,如果有一個或多個處理程序,則會以此調用他們的Handle方法,代碼如下:

public void Publish<T>(T @event) where T : Event
{
    var handlers = _eventHandlerFactory.GetHandlers<T>();
    foreach (var eventHandler in handlers)
    {
        eventHandler.Handle(@event);
    }
}

總結

Diary.CQRS是一個典型的CQRS+ES演示項目,通過對該項目的分析,我們能了解到Command、AggregateRoot、Event、EventStorage、ReportDatabase的基礎知識,了解他們相互關係,尤其是如何進行事件存儲、如何進行事件回放的內容。

另外,我們發現在使用CQRS+ES的過程中,項目的複雜度增加了很多,我們不可避免的要使用EventStore、Messaging等架構,從而影響那些不了解CQRS的團隊成員的加入,因此在應用到實際項目的時候,要適可而止,慎重選擇,避免過度設計。

由於這是一個示例,項目代碼中存在很多不夠嚴謹的地方,大家在學習的過程中應進行甄別。

由於本人的知識有限,如果內容中存在不準確或錯誤的地方,還請不吝賜教!

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"
Colder框架硬核更新(Sharding+IOC)

目錄

  • 引言
  • 控制反轉
  • 讀寫分離分庫分表
    • 理論基礎
    • 設計目標
    • 現狀調研
    • 設計思路
    • 實現之過五關斬六將
      • 動態對象
      • 動態模型緩存
      • 數據源移植
      • 查詢表達式樹深度移植
      • 數據合併算法
      • 事務支持
    • 實際使用
  • 展望未來

引言

前方硬核警告:全文乾貨11000+字,請耐心閱讀
遙想去年這個時候,差不多剛剛畢業,如今正式工作差不多一年了。Colder開源快速開發框架從上次版本發布至今差不多有三個月了,Github的星星5個版本框架總共也有近800顆,QQ群從最初的一個人發展到現在的500人(吐槽下,人數上限了,太窮開不起SVIP,所以另開了一個,群號在文章末),這都是大家共同發展的結果,本框架能夠幫助到大家鄙人就十分開心。但是,技術是不斷髮展的,本框架也必須適應潮流,不斷升級才能夠與時俱進,在實際意義上提高生產力。本系列框架從原始雛形(鄙人畢業設計)=>.NET45+Easyui=>.NET Core2.1+Easyui=>.NET45+AdminLTE=>.NET Core2.1+AdminLTE,這其中都是根據實際情況不斷升級。例如鄙人最初的畢業設計搭建了框架的雛形(倉儲層不夠完善、界面較簡陋),並不適合實際的生產開發,因此使用Easyui作為前端UI框架(控件豐富,使用簡單),后又由於.NET Core的發展迅速,已經發展到2.0,其基礎類庫組件也相對比較成熟了,因此從.NET45遷移到.NET Core。後來發現Easyui的樣式比較落後,給人一種過時古老的感覺,故而又將前端UI改為基於Bootstrap的AdminLTE,比較成熟主流並且開源。
但是,新的要求又出現了:

  • 由於沒有使用IOC導致各個類通過New導致的強耦合問題
  • 數據庫大數據量如何處理的問題
    因此,本次版本更新主要就是為了解決上述的問題,即全面使用Autofac作為IOC容器實現解耦以及數據庫讀寫分離分庫分表(Sharding)支持。下面將分別介紹。
    這次更新.NET45版本與.NET Core版本同步更新:
.NET版本 前端UI 地址
Core2.2 AdminLTE https://github.com/Coldairarrow/Colder.Fx.Core.AdminLTE
.NET4.52 AdminLTE https://github.com/Coldairarrow/Colder.Fx.Net.AdminLTE

控制反轉

IOC(DI),即控制反轉(依賴注入),相關概念大家應該都知道,並且大多數人應該都已經運用於實際。我就簡單描述下,簡單講就是面向接口編程,通過接口來解除類之間的強耦合,方便開發維護測試。這個概念在JAVA開發中應該比較普遍,因為有Spring框架的正確引導,但是在.NET中可能開發人員的相關意識就沒那麼強,JAVA與.NET我這裏不做評價,但是作為技術人員,天生就是不斷學習的,好的東西當然要學習,畢竟技多不壓身。

在.NET 領域中IOC框架主流有兩個,即Autofac與Unity,這兩個都是優秀的開源框架,經過一番考量后我最終選擇了更加主流的(星星更多)Autofac。

關於Autofac的詳細使用教程請看官方文檔https://autofac.org/,我這裏主要介紹下集成到本框架的思路以及用法。
傳統使用方法通過手動註冊具體的類實現某接口,這種做法顯然不符合實際生產需求,需要一種自動註冊的方式。本框架通過定義兩個接口類:IDependency與ICircleDependency來作為依賴注入標記,所有需要使用IOC的類只需要繼承其中一個接口就好了,其中IDependency是普通注入標記,支持屬性注入但不支持循環依賴,ICircleDependency是循環依賴注入標記,支持循環依賴,實際使用中按需選擇即可。下面代碼就是自動註冊的實現:

var builder = new ContainerBuilder();

var baseType = typeof(IDependency);
var baseTypeCircle = typeof(ICircleDependency);

//Coldairarrow相關程序集
var assemblys = BuildManager.GetReferencedAssemblies().Cast<Assembly>()
    .Where(x => x.FullName.Contains("Coldairarrow")).ToList();

//自動注入IDependency接口,支持AOP
builder.RegisterAssemblyTypes(assemblys.ToArray())
    .Where(x => baseType.IsAssignableFrom(x) && x != baseType)
    .AsImplementedInterfaces()
    .PropertiesAutowired()
    .InstancePerLifetimeScope()
    .EnableInterfaceInterceptors()
    .InterceptedBy(typeof(Interceptor));

//自動注入ICircleDependency接口,循環依賴注入,不支持AOP
builder.RegisterAssemblyTypes(assemblys.ToArray())
    .Where(x => baseTypeCircle.IsAssignableFrom(x) && x != baseTypeCircle)
    .AsImplementedInterfaces()
    .PropertiesAutowired(PropertyWiringOptions.AllowCircularDependencies)
    .InstancePerLifetimeScope();

//註冊Controller
builder.RegisterControllers(assemblys.ToArray())
    .PropertiesAutowired();

//註冊Filter
builder.RegisterFilterProvider();

//註冊View
builder.RegisterSource(new ViewRegistrationSource());

//AOP
builder.RegisterType<Interceptor>();

var container = builder.Build();
DependencyResolver.SetResolver(new AutofacDependencyResolver(container));

AutofacHelper.Container = container;

代碼中有相關註釋,使用方法推薦使用構造函數注入:

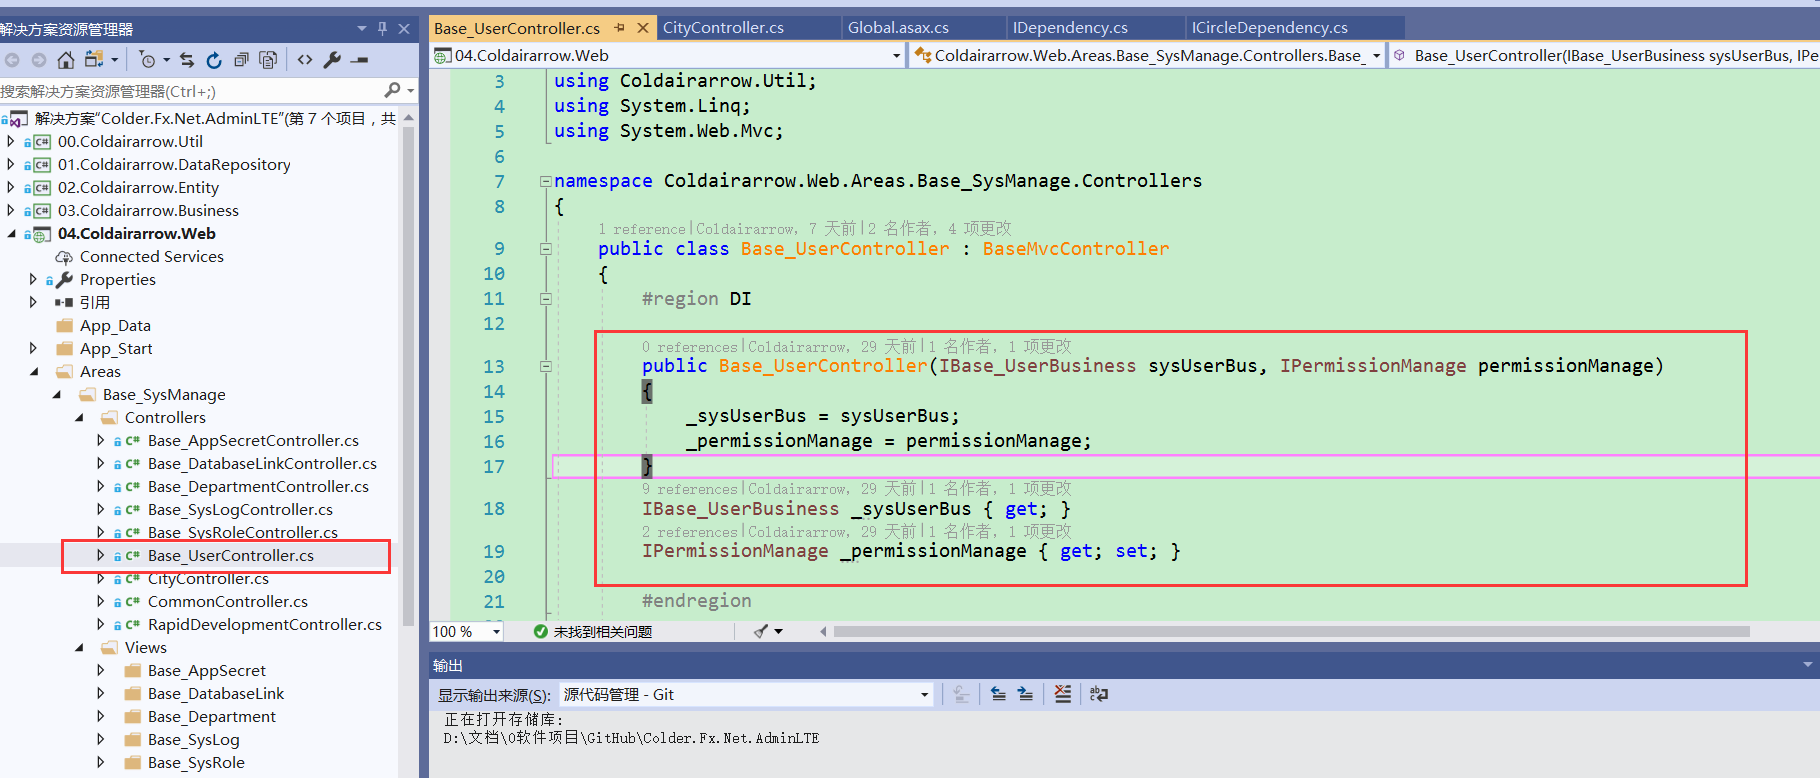
框架已在Business層與Web層全面使用DI,Util層、DataRepository層與Entity層不涉及業務邏輯,因此不使用DI。

讀寫分離分庫分表

前面的IOC或許沒啥可驚喜的,但是數據庫讀寫分離分庫分表應該不會讓大家失望。接下來將闡述下框架支持Sharding的設計思路以及具體使用方法。

理論基礎

數據庫讀寫分離分庫分表(以下簡稱Sharding),這並不是什麼新概念,網上也有許多的相關資料。其根本就是為了解決一個問題,即數據庫大數據量如何處理的問題。

當業務規模較小時,使用一個數據庫即可滿足,但是當業務規模不斷擴大(數據量增大、用戶數增多),數據庫最終將會成為瓶頸(響應慢)。數據庫瓶頸主要有三種情況:數據量不大但是讀寫頻繁、數據量大但是讀寫不頻繁以及數據量大並且讀寫頻繁。

首先,為了解決數據量不大但是讀寫頻繁導致的瓶頸,需要使用讀寫分離,所謂讀寫分離就是將單一的數據庫分為多個數據庫,一些數據庫作為寫庫(主庫),一些數據庫作為讀庫(從庫),並且開啟主從複製(實時將寫入的數據同步到從庫中),這樣將數據的讀寫分離后,將原來單一數據庫用戶的讀寫操作分散到多個數據庫中,極大的降低了數據庫壓力,並且打多數情況下讀操作要遠多於寫操作,因此實際運用中大多使用一主多從的模式。

其次,為了解決數據量大但是讀寫不頻繁導致的瓶頸,需要使用分庫分表。其實思想也是一樣的,即分而治之,一切複雜系統都是通過合理的拆分從而有效的解決問題。分庫分表就是將原來的單一數據庫拆分為多個數據庫,將原來的一張表拆分為多張表,這樣表的數據量就將下來了,從而解決問題。但是,拆表並不是胡亂拆的,隨便拆到時候數據都找不到,那還怎麼玩,因此拆表需要按照一定的規則來進行。最簡單的拆表規則,就是根據Id字段Hash后求余,這種方式使用簡單但是擴容很麻煩(絕大多數都需要遷移,工作量巨大,十分麻煩),因此大多用於基本無需擴容的業務場景。後來經過一番研究后,發現可以使用雪花Id(分佈式自增Id)來解決問題,雪花Id中自帶了時間軸,因此在擴容時可以根據時間段來判斷具體的分片規則,從而擴容時無需數據遷移,但是存在一定程度上的數據熱點問題。最後,找到了葵花寶典-一致性哈希,關於一致性哈希的理論我這裏就不獻醜了,相關資料網上一大把。一致性哈希從一定程度上解決了普通哈希的擴容問題與數據熱點問題,框架也支持使用一致性哈希分片規則。

最後,就是大BOSS,大數據量與大訪問量,很簡單隻需要結合讀寫分離與分庫分表即可,下錶是具體業務場景與採用方案的關係
| 數據量\訪問量 | 小 | 大 |
|-|-|-|
|小| 無| 讀寫分離 |
| 大 | 分庫分表 |讀寫分離分庫分表|

設計目標

首先定一個小目標(先賺他一個億):支持多種數據庫,使用簡單,業務升級改動小。
有了目標就需要調查業界情況,實現Sharding,市面上主要分為兩種,即使用中間件與客戶端實現。

現狀調研

中間件的優點是對客戶端透明,即對於客戶端來講中間件就是數據庫,因此對於業務改動影響幾乎沒有,但是對中間件的要求就很高,目前市面上比較主流成熟的就是mycat,其對MySQL支持比較好,但是對於其他數據庫支持就比較無力(個人測試,沒有深入研究,若有不妥請不要糾結),並且不支持EF,此方案行不通。其它類型數據庫也有對應的中間件,但是都並不如意,自己開發更不現實,因此使用中間件方案行不通。

既然中間件行不通,那就只能選擇客戶端方案了。目前在JAVA中有大名鼎鼎的Sharding-JDBC,了解了下貌似很牛逼,可惜.NET中並沒有Sharding-NET,但是有FreeSql,粗略了解了下是一個比較強大ORM框架,但我的框架原來底層是使用EF的,並且EF是.NET中主流的ORM框架,整體遷移到FreeSql不現實,因此最終沒找到成熟的解決方案。

設計思路

最後終於到了最壞的情況,既沒有完美的中間件方案,又沒有現成的客戶端方案,怎麼辦呢?放棄是不可能的,這輩子都不可能放棄的,終於,內心受到了黨的啟發,決定另起爐灶(既然沒有現成的那就自己早造)、打掃乾淨屋子再請客(重構數據倉儲層,實現Sharding)、一邊倒(堅定目標不改變,不妥協),由於EF支持多種數據庫,已經對底層SQL進行了抽象封裝,因此決定基於EF打造一套讀寫分離分庫分表方案。

數據庫讀寫分離實現:讀寫分離比較簡單,在倉儲接口中已經明確定義了CRUD操作接口,其中增、刪、改就是指寫操作,寫的時候按照具體的讀寫規則找到具體的寫庫進行寫操作即可,讀操作(查數據)按照具體的讀規則找到具體的讀庫進行讀即可。

數據庫分庫分表:分庫還好說,使用不同的數據庫即可,分表就比較麻煩了。首先實現分表的寫操作,可以根據分片規則能夠找到具體的物理表然後進行操作即可,實現比較容易。然後實現分表的讀操作,這個就比較麻煩了,就好比前面的都是斗皇以下的在小打小鬧,而這個卻是斗帝(騎馬),但是,作為一名合格的攻城獅是不怕斗帝的,遇到了困難不要慌,需要冷靜思考處理。前面提到過,解決複雜問題就是一個字“拆”,首先聯表查詢就直接不考慮支持了(大數據量進行笛卡爾積就是一種愚蠢的做法,怎麼優化都沒用,物理數據庫隔絕聯表不現實,實現難度太大放棄)。接下來考慮最常用的方法:分頁查詢、數據篩選、最大值、最小值、平均值、數據量統計,EF中查詢都是通過IQueryable接口實現的,IQueryable中主要包括了數據源(特定表)與關聯的表達式樹Expression,通過考慮將數據源與關聯的表達式樹移植到分表的IQueryable即可實現與抽象表相同的查詢語句,最後將併發多線程查詢分表的數據通過合併算法即可得到最終的實際數據。想法很美好,現實很殘酷,下面為大家簡單闡述下實現過程,可以說是過五關斬六將。

實現之過五關斬六將

動態對象

首先考慮分表的寫操作,傳統用法都有具體的實體類型進行操作,但是分表時,例如Base_UnitTest_0、Base_UnitTest_1、Base_UnitTest_2,這些表全部保存為實體類不現實,因此需要一種非泛型方法,後來在EF的關鍵類DbContext中找到DbEntityEntry Entry(object entity)方法,通過DbEntityEntry可以實現數據的增刪改操作,又注意到傳入參數是object,由此猜測EF支持非泛型操作,即只需要傳入特定類型的object對象也行。例如抽象表是Base_UnitTest,實際需要映射到表Base_UnitTest_0,那麼怎樣將Base_UnitTest類型的對象轉換成Base_UnitTest_0類型的對象?經過查閱資料,可以通過System.Reflection.Emit命名空間下的TypeBuilder在運行時創建動態類型,即可以在運行時創建Base_UnitTest_0類型,該類型擁有與Base_UnitTest完全一樣的屬性(因為表結構完全一樣),創建了需要的類型,接下來只需要通過Json.NET將Base_UnitTest對象轉為Base_UnitTest_0即可。實現到這裏,原以為會順利成功,但是並沒有那麼簡單,EF直接報錯“上下文不包含模型Base_UnitTest_0”,這明顯就是模型的問題了,接下來進入下一關:EF動態模型緩存

動態模型緩存

通常都是通過繼承DbContext重寫OnModelCreating方法來註冊實體模型,這裡有個坑就是OnModelCreating只會執行一次,並最終生成DbCompiledModel然後將其緩存,後續創建的DbContext就會直接使用緩存的DbCompiledModel,由於最初註冊實體模型的時候只有抽象類型Base_UnitTest,所有後續在使用Base_UnitTest_0對象的時候會報錯。為了解決這個問題,需要自己管理DbCompiledModel緩存,實現過程比較麻煩,這裏就不詳細分析了,有興趣的直接看源碼即可。將緩存問題解決后,終於成功的實現了Base_UnitTest_0的增刪改,這時,心裏一喜(有戲)。實現了寫操作(增、刪、改)之後,接下來就是實現查詢了,那麼如何實現查詢呢?EF中查詢操作都是通過IQueryable接口實現的,IQueryable中包括了具體數據表的數據源和關聯的查詢表達式樹,那麼如何將IQueryable < Base_UnitTest >轉換為IQueryable < Base_UnitTest_0 > 並且保留原始查詢語句就成了關鍵問題。

數據源移植

根據經驗,想一舉同時移植數據源與表達式樹應該不現實,實際情況也是如此,移植數據源,通過使用ExpressionVisitor可以找到根數據源,其實是一個ObjectQuery類型,並且在表達式樹中是以ConstantExpression存在,同樣通過ExpressionVisitor則可將原ObjectQuery替換為新的,實現過程省略10000字。

查詢表達式樹深度移植

數據源移植后,別以為就大功告成了,接下來進入一個深坑(最難點),表達式樹移植,經過一番踩坑后發現,表達式樹中的所有節點都是樹狀結構,任何一個查詢(Where、OrderBy、Skip、Take等)在表達式樹中都是以一個節點存在,並且一級扣一級,也就是說你改了數據源沒用,因為數據源只是表達式樹的根節點,下面的所有子節點還都是原來的根節點發的牙,並不能使用,那怎樣才能用新數據源構建與原數據源一樣的表達式樹呢?經過如下分析:IQuryable中的所有操作都是MethodCallExpression一層一層包裹,那麼我從外到內剝開方法,然後再從內到外包裹新的數據源,那不就模擬得一模一樣了嗎?(貌似有戲),想到先進后出腦子里直接就蹦出了數據結構中的棧,強大的.NET當然支持棧了,經過一番操作(奮鬥幾個晚上),此處省略10000字,最終完成IQueryable的移植,即從IQueryable < Base_UnitTest >轉換為IQueryable < Base_UnitTest_0 > 並且保留原始查詢語句。有了分表的IQueryable就能夠獲取分表的數據了,最後需要將獲取的分表數據進行合併。

數據合併算法

分表后的數據合併算法主要參考了網上的一些資料,雖然分庫分表的實現方式各不相同,但是思想都是差不多的,例如需要獲取Count,只需要將各個分表的Count求和即可,最大值只需要所有分表的最大值的最大值即可,最小值只需要所有分表最小值的最小值即可,平均值需要所有分表的和然後除以所有分表的數據條數即可。最後比較麻煩的就是分頁查詢,分頁查詢需要分表排序后獲取前N頁的所有數據(不能直接獲取某一頁的數據,因為不一定就是那一頁),最後將所有表的數據再進行分頁即可。實現到這裏,已經實現了增、刪、改、查了,看似革命已經成功,其實還有最後的大BOSS:事務支持

事務支持

因為分表很可能不在同一個數據庫中,因為普通的單庫事務顯然不能滿足需求,原本框架中已經有分佈式事務支持(多庫事務),這裏需要集成到Sharding中,實現過程省略10000字,最終黃天不負有心人終於實現了。

到這裏,肯定有暴躁老哥坐不住了:你前面BBB那麼多,說得那麼牛逼,到底怎麼用啊???,若文章到此為止,估計就是下圖:

鄙人則回復如下:

深夜12點了,放鬆一下,最後介紹如何使用

實際使用

本框架支持數據庫讀寫分離分庫分表(即Sharding),並且支持主流關係型數據庫(SQLServer、Oracle、MySQL、PostgreSQL),理論上只要EF支持那麼本框架支持。
由於技術原因以及結合實際情況,目前本框架僅支持單表的Sharding,即支持單表的CRUD、分頁、統計(數量、最大值、最小值、平均值),支持跨庫(表分散在不同的數據庫中,不同類型數據庫也支持)。具體如何使用如下:

  • Sharding配置
    首先、要進行分庫分表操作,那麼必要的配置必不可少。配置代碼如下:
ShardingConfigBootstrapper.Bootstrap()
    //添加數據源
    .AddDataSource("BaseDb", DatabaseType.SqlServer, dbBuilder =>
    {
        //添加物理數據庫
        dbBuilder.AddPhsicDb("BaseDb", ReadWriteType.ReadAndWrite);
    })
    //添加抽象數據庫
    .AddAbsDb("BaseDb", absTableBuilder =>
    {
        //添加抽象數據表
        absTableBuilder.AddAbsTable("Base_UnitTest", tableBuilder =>
        {
            //添加物理數據表
            tableBuilder.AddPhsicTable("Base_UnitTest_0", "BaseDb");
            tableBuilder.AddPhsicTable("Base_UnitTest_1", "BaseDb");
            tableBuilder.AddPhsicTable("Base_UnitTest_2", "BaseDb");
        }, new ModShardingRule("Base_UnitTest", "Id", 3));
    });

上述代碼中完成了Sharding的配置:
ShardingConfigBootstrapper.Bootstrap()在一個項目中只能執行一次,所以建議放到Application_Start中(ASP.NET Core中的Startup)
AddDataSource是指添加數據源,數據源可以看做抽象數據庫,一個數據源包含了一組同類型的物理數據庫,即實際的數據庫。一個數據源至少包含一個物理數據庫,多個物理數據庫需要開啟主從複製或主主複製,通過ReadWriteType(寫、讀、寫和讀)參數來指定數據庫的操作類型,通常將寫庫作為主庫,讀庫作為從庫。同一個數據源中的物理數據庫類型相同,表結構也相同。
配置好數據源后就可以通過AddAbsDb來添加抽象數據庫,抽象數據庫中需要添加抽象數據表。如上抽象表Base_UnitTest對應的物理表就是Base_UnitTest_0、Base_UnitTest_1與Base_UnitTest_2,並且這三張表都屬於數據源BaseDb。分表配置當然需要分表規則(即通過一種規則找到具體數據在哪張表中)。
上述代碼中使用了最簡單的取模分片規則,
源碼如下:

可以看到其使用方式及優缺點。
另外還有一致性HASH分片規則

雪花Id的mod分片規則

上述的分片規則各有優劣,都實現IShardingRule接口,實際上只需要實現FindTable方法即可實現自定義分片規則。
實際使用中個人推薦使用雪花Id的mod分片規,這也是為什麼前面數據庫設計規範中默認使用雪花Id作為數據庫主鍵的原因(PS,之前版本使用GUID作為主鍵被各種嫌棄,這次看你們怎麼說)

  • 使用方式
    配置完成,下面開始使用,使用方式非常簡單,與平常使用基本一致
    首先獲取分片倉儲接口IShardingRepository
IShardingRepository _db = DbFactory.GetRepository().ToSharding();

然後即可進行數據操作:

Base_UnitTest _newData  = new Base_UnitTest
{
    Id = Guid.NewGuid().ToString(),
    UserId = "Admin",
    UserName = "超級管理員",
    Age = 22
};
List<Base_UnitTest> _insertList = new List<Base_UnitTest>
{
    new Base_UnitTest
    {
        Id = Guid.NewGuid().ToString(),
        UserId = "Admin1",
        UserName = "超級管理員1",
        Age = 22
    },
    new Base_UnitTest
    {
        Id = Guid.NewGuid().ToString(),
        UserId = "Admin2",
        UserName = "超級管理員2",
        Age = 22
    }
};
//添加單條數據
_db.Insert(_newData);
//添加多條數據
_db.Insert(_insertList);
//清空表
_db.DeleteAll<Base_UnitTest>();
//刪除單條數據
_db.Delete(_newData);
//刪除多條數據
_db.Delete(_insertList);
//刪除指定數據
_db.Delete<Base_UnitTest>(x => x.UserId == "Admin2");
//更新單條數據
_db.Update(_newData);
//更新多條數據
_db.Update(_insertList);
//更新單條數據指定屬性
_db.UpdateAny(_newData, new List<string> { "UserName", "Age" });
//更新多條數據指定屬性
_db.UpdateAny(_insertList, new List<string> { "UserName", "Age" });
//更新指定條件數據
_db.UpdateWhere<Base_UnitTest>(x => x.UserId == "Admin", x =>
{
    x.UserId = "Admin2";
});
//GetList獲取表的所有數據
var list=_db.GetList<Base_UnitTest>();
//GetIQPagination獲取分頁后的數據
var list=_db.GetIShardingQueryable<Base_UnitTest>().GetPagination(pagination);
//Max
var max=_db.GetIShardingQueryable<Base_UnitTest>().Max(x => x.Age);
//Min
var min=_db.GetIShardingQueryable<Base_UnitTest>().Min(x => x.Age);
//Average
var min=_db.GetIShardingQueryable<Base_UnitTest>().Average(x => x.Age);
//Count
var min=_db.GetIShardingQueryable<Base_UnitTest>().Count();
//事務,使用方式與普通事務一致
using (var transaction = _db.BeginTransaction())
{
    _db.Insert(_newData);
    var newData2 = _newData.DeepClone();
    _db.Insert(newData2);
    bool succcess = _db.EndTransaction().Success;
}

上述操作中表面上是操作Base_UnitTest表,實際上卻在按照一定規則使用Base_UnitTest_0~2三張表,使分片對業務操作透明,極大提高開發效率,基本達成了最初定製的小目標。
具體使用方式請參考單元測試源碼:
“\src\Coldairarrow.UnitTests\DataRepository\ShardingTest.cs”

最後放上簡單的測試圖:300W的表分成三張100W的表後效果

看來功夫沒白費,效果明顯(還不快點贊)

展望未來

結束也是是新的開始,版本後續計劃採用前後端完全分離方案,前端使用vue-element-admin,後端以.NET Core為主,傳統的.NET將逐步停止更新,敬請期待!
文章雖然結束了,但是技術永無止境,希望我的文檔能夠幫助到大家。
深夜碼字,實屬不易,文章中難免會出現一些紕漏,一些觀點也不一定完全正確,還望各位大哥不吝賜教。
最後覺得文檔不錯,請點贊,Github請星星,若有各種疑問歡迎進群交流:
QQ群1:373144077(已滿)
QQ群2:579202910

See You

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

Java基礎(六) static五大應用場景

static和final是兩個我們必須掌握的關鍵字。不同於其他關鍵字,他們都有多種用法,而且在一定環境下使用,可以提高程序的運行性能,優化程序的結構。上一個章節我們講了final關鍵字的原理及用法,本章節我們來了解一下static關鍵字原理及其用法。

一. static特點

static是一個修飾符,通常用於修飾變量和方法,如開發過程中用到的字典類數據都會用到static來修飾,工具類方法,如Dateutils,Stringutils這類工具方法也會用到static來修飾,那麼除了這兩種最常用的場景外,是否還有其他場景呢,答案是:有的,總共五種:

  1. static變量
  2. static方法
  3. static代碼塊
  4. static內部類
  5. static包內導入

static修飾的變量、方法、代碼塊、內部類在類加載期間就已經完成初始化,存儲在Java Heap(JDK7.0之前存儲在方法區)中靜態存儲區,因此static優於對象而存在。

static修飾的成員(變量、方法)被所有對象所共享,也叫靜態變量或靜態方法,可直接通過類調用(也建議通過類調用)。

二. static 變量

static變量隨着類的加載而存在,隨着類的消失而消失,當類被加載時,就會為靜態變量在Java Heap中分配內存空間,可以通過【類.變量名】和【對象.變量名】的方式調用,建議直接使用【類.變量名】的方式,

public class Person {
    private String name;

    private static int eyeNum;

    public static int legNum = 2;

    public String getName() {
        return name;
    }

    public void setName(String name) {
        this.name = name;
    }

    public static int getEyeNum() {
        return eyeNum;
    }

    public static void setEyeNum(int eyeNum) {
        Person.eyeNum = eyeNum;
    }
}
public static void main(String[] args) {
    Person person = new Person();
    person.setEyeNum(25);

    Person person1 = new Person();
    person1.setEyeNum(28);
    System.out.println(person.getEyeNum());//28
    System.out.println(person1.getEyeNum());//28
    
    int legNum = person.legNum;
    System.out.println(legNum);//2
}

從上面的例子可以看出靜態變量是對所有對象共享,一個對象對其值的改動,直接就會造成另一個對象取值的不同。

什麼時候使用static變量?

作為共享變量使用,通常搭配final關鍵字一起使用,比如我們常用的字典類數據;

private static final String GENERAL_MAN = "man";

減少對象的創建,比如在類開頭的部分,定義Logger方法,用於異常日誌採集

private static Logger LOGGER = LogFactory.getLoggger(MyClass.class);

始終返回同一變量,比如我們的單例模式。

三. static 方法

靜態方法只能訪問靜態成員(靜態變量、靜態方法),而非靜態方法既可訪問靜態方法也可訪問非靜態方法;因為靜態成員優於對象而存在,因此無法調用和對象相關的關鍵字,如this,super,無法通過關鍵字訪問對象資源。

public class Person {
    private String name;    
    private static int eyeNum;    
    public static int legNum = 2;    
    public String getName() {
        return name;    
    }    
    public void setName(String name) {
        this.name = name;    
    }    
    public static int getEyeNum() {
        System.out.println(name);//編譯出錯,name不可用
        return eyeNum;
    }    
    public static void setEyeNum(int eyeNum) {
        Person.eyeNum = eyeNum;        
        this.name = "";//編譯出錯,this不可用
    }
}

什麼時候使用static方法?

static方法一般用於與當前對象無法的工廠方法、工具方法。如Math.sqrt(),Arrays.sort(),StringUtils.isEmpty()等。

四. static 代碼塊

static代碼塊相對於static變量和static方法來說使用不是那麼廣泛,但也算是比較常見的用法了,static代碼塊在加載一個類的時候最先執行,且只執行一次。

public static Map<String, String> timeTypes;
static {
    timeTypes = new HashMap<>();
    timeTypes.put("year", "年");
    timeTypes.put("quarter", "季");
    timeTypes.put("month", "月");
    timeTypes.put("day", "日");
    System.out.println("初始化1");
}
public static void main(String[] args) {
    System.out.println("初始化2");
}

執行結果是:

初始化1;

初始化2;

什麼時候使用static代碼塊?

一般在進行初始化操作時,比如讀取配置文件信息,獲取當前服務器參數等

五. static內部類

定義一個內部類,加上static,就成為了一個static內部類,static只能修飾內部類,不能修飾頂級類,靜態內部類在業務應用系統開發中使用的不多。

public class StaticCouter {
    private String str0 = "hi";    //非靜態變量    
    private static String str1 = "hello";  //靜態變量   
    static class StaticInnerClass{//靜態內部類
        public void getMessage(){
            System.out.println(str0);//編譯出錯
            System.out.println(str1);
        }
    }    
    class NormalInnerClass{//非靜態內部類
        public void getMessage(){
            System.out.println(str0);
            System.out.println(str1);
        }
    }
}

靜態內部類與非靜態內部類有何異同?

靜態內部類 非靜態內部類
不需要有指向外部類的引用 必須通過外部類的new關鍵字引用
可定義普通變量和方法,也可定義靜態變量和方法 可定義普通變量和方法,不可定義靜態變量和方法
可以調用外部類的靜態成員,不能調用外部類的普通成員 可調用外部類的普通成員和靜態成員
public static void main(String[] args) {
    //創建靜態內部類實例    
    StaticInnerClass staticInnerClass = new StaticInnerClass();    
    //調用靜態內部類方法    
    staticInnerClass.getMessage();    
    //創建靜態內部類實例    
    StaticCouter.StaticInnerClass staticInnerClass1 = new staticCouter.StaticInnerClass();    
    //調用靜態內部類方法
    staticInnerClass1.getMessage();
    //創建普通內部類實例
    StaticCouter.NormalInnerClass normalInnerClass = new StaticCouter().new NormalInnerClass();
    //調用普通內部類方法
    normalInnerClass.getMessage();
}

六. static包內導入

這個概念不太好理解,舉個例子

public static void main(String[] args) {
    int[] arra = {1,4,5,7};
    Arrays.sort(arra);
    Arrays.asList(arra);
    Arrays.fill(arra, 6);
}

static包導入目的就是去掉重複的Arrays類名調用

通過在頂部引入

import static java.util.Arrays.*

即可把Arrays類中所有的靜態變量,方法,內部類等都引入當前類中,調用時直接調用sort(arra),asList(arra),

java5后引入的,不常用,調用類方法時會比較簡單,但可讀性不好,慎用。

七. 總結

static是java中很常用的一個關鍵字,使用場景也很多,本文主要介紹了它的五種用法,static變量,static方法,static代碼塊,static內部類,static包內導入,若有不對之處,請批評指正,望共同進步,謝謝!

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

機器學習之決策樹原理和sklearn實踐

1. 場景描述

時間:早上八點,地點:婚介所

‘閨女,我有給你找了個合適的對象,今天要不要見一面?’

‘多大?’ ‘26歲’

‘長的帥嗎?’ ‘還可以,不算太帥’

‘工資高嗎?’ ‘略高於平均水平’

‘會寫代碼嗎?’ ‘人家是程序員,代碼寫的棒着呢!’

‘好,把他的聯繫方式發過來吧,我抽空見一面’

上面的場景描述摘抄自 ,是一個典型的決策樹分類問題,通過年齡、長相、工資、是否會編程等特徵屬性對介紹對象進行是否約會進行分類

決策樹是一種自上而下,對樣本數據進行樹形分類的過程,由結點和有向邊組成,每個結點(恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘結點除外)便是一個特徵或屬性,恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘結點表示類別。從頂部根結點開始,所有樣本聚在儀器,經過根結點的劃分,樣本被分到不同的子結點中。再根據子結點的特徵進一步劃分,直至樣本都被分到某一類別(恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子結點)中

2. 決策樹原理

決策樹作為最基礎、最常見的有監督學習模型,常被用於分類問題和回歸問題,將決策樹應用集成思想可以得到隨機森林、梯度提升決策樹等模型。其主要優點是模型具有可讀性,分類速度快。決策樹的學習通常包括三個步驟:特徵選擇、決策樹的生成和決策樹的修剪,下面對特徵選擇算法進行描述和區別

2.1 ID3—最大信息增益

在信息論與概率統計中,熵(entropy)是表示隨機變量不確定性的度量,設X是一個取有限個值的隨機變量,其概率分佈為:\[P(X=X_i)=P_i (i = 1,2,…,n)\],則隨機變量X的熵定義為:\[H(X) = -\sum_{i=1}^np_i\log{p_i}\]表達式中的對數以2為底或以e為底,這時熵的單位分別稱作bit或nat,從表達式可以看出X的熵與X的取值無關,所以X的熵也記作\(H(p)\),即\[H(p) = -\sum_{x=1}^np_i\log{p_i}\]熵取值越大,隨機變量的不確定性越大

條件熵:

條件熵H(Y|X)表示在已知隨機變量X的條件下,隨機變量Y的不確定性,隨機變量X給定的條件下隨機變量Y的條件熵定義為X給定條件下Y的條件概率分佈的熵對X的數學期望\[H(Y|X) = \sum_{i=1}^nP(X=X_i)H(Y|X=X_i)\]

信息增益:\[g(D,A) = H(D) – H(D|A)\]

import pandas as pd
data = {
        '年齡':['老','年輕','年輕','年輕','年輕'],
        '長相':['帥','一般','丑','一般','一般'],
        '工資':['高','中等','高','高','低'],
        '寫代碼':['不會','會','不會','會','不會'],
        '類別':['不見','見','不見','見','不見']}
frame = pd.DataFrame(data,index=['小A','小B','小C','小D','小L'])
print(frame)
    年齡  長相  工資 寫代碼  類別
小A   老   帥   高  不會  不見
小B  年輕  一般  中等   會   見
小C  年輕   丑   高  不會  不見
小D  年輕  一般   高   會   見
小L  年輕  一般   低  不會  不見
import math
print(math.log(3/5))
print('H(D):',-3/5 *math.log(3/5,2) - 2/5*math.log(2/5,2))
print('H(D|年齡)',1/5*math.log(1,2)+4/5*(-1/2*math.log(1/2,2)-1/2*math.log(1/2,2)))
print('以同樣的方法計算H(D|長相),H(D|工資),H(D|寫代碼)')
print('H(D|長相)',0.551)
print('H(D|工資)',0.551)
print('H(D|寫代碼)',0)
-0.5108256237659907
H(D): 0.9709505944546686
H(D|年齡) 0.8
以同樣的方法計算H(D|長相),H(D|工資),H(D|寫代碼)
H(D|長相) 0.551
H(D|工資) 0.551
H(D|寫代碼) 0

計算信息增益:g(D,寫代碼)=0.971最大,可以先按照寫代碼來拆分決策樹

2.2 C4.5—最大信息增益比

以信息增益作為劃分訓練數據集的特徵,存在偏向於選擇取值較多的問題,使用信息增益比可以對對着問題進行校正,這是特徵選擇的另一標準
信息增益比定義為其信息增益g(D,A)與訓練數據集D關於特徵A的值的熵\(H_A(D)\)之比:\[g_R(D,A) = \frac{g(D,A)}{H_A(D)}\]

\[H_A(D) = -\sum_{i=1}^n\frac{|D_i|}{|D|}\log\frac{|D_i|}{|D|}\]

拿上面ID3的例子說明:
\[H_年齡(D) = -1/5*math.log(1/5,2)-4/5*math.log(4/5,2)\]

\[g_R(D,年齡) = H_{年齡}(D)/g(D,年齡) = 0.171/0.722 = 0.236 \]

2.3 CART—-最大基尼指數(Gini)

Gini描述的是數據的純度,與信息熵含義類似,分類問題中,假設有K個類,樣本點數據第k類的概率為\(P_k\),則概率分佈的基尼指數定義為:
\[Gini(p) = 1- \sum_{k=1}^Kp_k(1-p_k) = 1 – \sum_{k=1}^Kp_{k}^2\]
對於二分類問題,弱樣本點屬於第1個類的概率是p,則概率分佈的基尼指數為\[Gini(p) = 2p(1-p)\],對於給定的樣本幾何D,其基尼指數為\[Gini(D) = 1 – \sum_{k=1}^K[\frac{|C_k|}{|D|}]^2\]注意這裏\(C_k\)是D種屬於第k類的樣本子集,K是類的個數,如果樣本幾個D根據特徵A是否取某一可能指a被分割成D1和D2兩部分,則在特徵A的條件下,集合D的基尼指數定義為\[Gini(D,A) = \frac{|D_1|}{|D|}Gini(D_1)+\frac{|D_2|}{|D|}Gini(D_2)\]
\[Gini(D|年齡=老)=1/5*(1-1)+4/5*[1-(1/2*1/2+1/2*1/2)] = 0.4\]

CART在每一次迭代種選擇基尼指數最小的特徵及其對應的切分點進行分類

2.4 ID3、C4.5與Gini的區別

2.4.1 從樣本類型角度

從樣本類型角度,ID3隻能處理離散型變量,而C4.5和CART都處理連續性變量,C4.5處理連續性變量時,通過對數據排序之後找到類別不同的分割線作為切割點,根據切分點把連續型數學轉換為bool型,從而將連續型變量轉換多個取值區間的離散型變量。而對於CART,由於其構建時每次都會對特徵進行二值劃分,因此可以很好地適合連續性變量。

2.4.2 從應用角度

ID3和C4.5隻適用於分類任務,而CART既可以用於分類也可以用於回歸

2.4.3 從實現細節、優化等角度

ID3對樣本特徵缺失值比較敏感,而C4.5和CART可以對缺失值進行不同方式的處理,ID3和C4.5可以在每個結點熵產生出多叉分支,且每個特徵在層級之間不會復用,而CART每個結點只會產生兩個分支,因此會形成一顆二叉樹,且每個特徵可以被重複使用;ID3和C4.5通過剪枝來權衡樹的準確性和泛化能力,而CART直接利用全部數據發現所有可能的樹結構進行對比。

3. 決策樹的剪枝

3.1 為什麼要進行剪枝?

對決策樹進行剪枝是為了防止過擬合

根據決策樹生成算法通過訓練數據集生成了複雜的決策樹,導致對於測試數據集出現了過擬合現象,為了解決過擬合,就必須考慮決策樹的複雜度,對決策樹進行剪枝,剪掉一些枝恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘,提升模型的泛化能力

決策樹的剪枝通常由兩種方法,預剪枝和后剪枝

3.2 預剪枝

預剪枝的核心思想是在樹中結點進行擴展之前,先計算當前的劃分是否能帶來模型泛化能力的提升,如果不能,則不再繼續生長子樹。此時可能存在不同類別的樣本同時存於結點中,按照多數投票的原則判斷該結點所屬類別。預剪枝對於何時停止決策樹的生長有以下幾種方法

  • (1)當樹達到一定深度的時候,停止樹的生長
  • (2)當恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘結點數到達某個閾值的時候,停止樹的生長
  • (3)當到達結點的樣本數量少於某個閾值的時候,停止樹的生長
  • (4)計算每次分裂對測試集的準確度提升,當小於某個閾值的時候,不再繼續擴展

預剪枝思想直接,算法簡單,效率高特點,適合解決大規模問題。但如何準確地估計何時停止樹的生長,針對不同問題會有很大差別,需要一定的經驗判斷。且預剪枝存在一定的局限性,有欠擬合的風險

3.3 后剪枝

后剪枝的核心思想是讓算法生成一顆完全生長的決策樹,然後從底層向上計算是否剪枝。剪枝過程將子樹刪除,用一個恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘結點代替,該結點的類別同樣按照多數投票原則進行判斷。同樣地,后剪枝恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘可以通過在測試集上的準確率進行判斷,如果剪枝過後的準確率有所提升,則進行剪枝,后剪枝方法通常可以得到泛化能力更強的決策樹,但時間開銷更大

損失函數

\[C_a(T) = \sum_{t=1}^{|T|}N_tH_t(T) + a|T|\]

\(其中|T|為恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘結點個數,N_t為結點t的樣本個數,H_t(T)為結點t的信息熵,a|T|為懲罰項,a>=0\)

\[C_a(T) = \sum_{t=1}^{|T|}N_tH_t(T) + a|T| = -\sum_{t=1}^{|T|}\sum_{k=1}^KN_{tk}\log \frac{N_{tk}}{N_t} + a|T|\]

注意:上面的公式中是\(N_{tk}\log \frac{N_{tk}}{N_t}\),而不是\(\frac{N_{tk}}{N_t} \log \frac{N_{tk}}{N_t}\)

令:\[C_a(T) = C(T) + a|T|\]

\(C(T)\)表示模型對訓練數據的預測誤差,即模型與訓練數據的擬合程度,|T|表示模型複雜度,參數a>=0控制兩者的影響力,較大的a促使選擇較簡單的模型,較小的a促使選擇複雜的模型,a=0意味着只考慮模型與訓練數據的擬合程度,不考慮模型的複雜度

4. 使用sklearn庫為衛星數據集訓練並微調一個決策樹

4.1 需求

  • a.使用make_moons(n_samples=10000,noise=0.4)生成一個衛星數據集
  • b.使用train_test_split()拆分訓練集和測試集
  • c.使用交叉驗證的網格搜索為DecisionTreeClassifier找到合適的超參數,提示:嘗試max_leaf_nodes的多種值
  • d.使用超參數對整個訓練集進行訓練,並測量模型測試集上的性能

代碼實現

from sklearn.datasets import make_moons
import numpy as np
import pandas as pd
dataset = make_moons(n_samples=10000,noise=0.4)
print(type(dataset))
print(dataset)
<class 'tuple'>
(array([[ 0.24834453, -0.11160162],
       [-0.34658051, -0.43774172],
       [-0.25009951, -0.80638312],
       ...,
       [ 2.3278198 ,  0.39007769],
       [-0.77964208,  0.68470383],
       [ 0.14500963,  1.35272533]]), array([1, 1, 1, ..., 1, 0, 0], dtype=int64))
dataset_array = np.array(dataset[0])
label_array = np.array(dataset[1])
print(dataset_array.shape,label_array.shape)
(10000, 2) (10000,)
# 拆分數據集
from sklearn.model_selection import train_test_split
x_train,x_test = train_test_split(dataset_array,test_size=0.2,random_state=42)
print(x_train.shape,x_test.shape)
y_train,y_test = train_test_split(label_array,test_size=0.2,random_state=42)
print(y_train.shape,y_test.shape)
(8000, 2) (2000, 2)
(8000,) (2000,)
# 使用交叉驗證的網格搜索為DecisionTreeClassifier找到合適的超參數
from sklearn.tree import DecisionTreeClassifier
from sklearn.model_selection import GridSearchCV

decisionTree = DecisionTreeClassifier(criterion='gini')
param_grid = {'max_leaf_nodes': [i for i in range(2,10)]}
gridSearchCV = GridSearchCV(decisionTree,param_grid=param_grid,cv=3,verbose=2)
gridSearchCV.fit(x_train,y_train)
Fitting 3 folds for each of 8 candidates, totalling 24 fits
[CV] max_leaf_nodes=2 ................................................
[CV] ................................. max_leaf_nodes=2, total=   0.0s
[CV] max_leaf_nodes=2 ................................................
[CV] ................................. max_leaf_nodes=2, total=   0.0s
[CV] max_leaf_nodes=2 ................................................
[CV] ................................. max_leaf_nodes=2, total=   0.0s
[CV] max_leaf_nodes=3 ................................................
[CV] ................................. max_leaf_nodes=3, total=   0.0s
[CV] max_leaf_nodes=3 ................................................
[CV] ................................. max_leaf_nodes=3, total=   0.0s
[CV] max_leaf_nodes=3 ................................................
[CV] ................................. max_leaf_nodes=3, total=   0.0s
[CV] max_leaf_nodes=4 ................................................
[CV] ................................. max_leaf_nodes=4, total=   0.0s
[CV] max_leaf_nodes=4 ................................................
[CV] ................................. max_leaf_nodes=4, total=   0.0s
[CV] max_leaf_nodes=4 ................................................
[CV] ................................. max_leaf_nodes=4, total=   0.0s
[CV] max_leaf_nodes=5 ................................................
[CV] ................................. max_leaf_nodes=5, total=   0.0s
[CV] max_leaf_nodes=5 ................................................
[CV] ................................. max_leaf_nodes=5, total=   0.0s
[CV] max_leaf_nodes=5 ................................................
[CV] ................................. max_leaf_nodes=5, total=   0.0s
[CV] max_leaf_nodes=6 ................................................
[CV] ................................. max_leaf_nodes=6, total=   0.0s
[CV] max_leaf_nodes=6 ................................................
[CV] ................................. max_leaf_nodes=6, total=   0.0s
[CV] max_leaf_nodes=6 ................................................
[CV] ................................. max_leaf_nodes=6, total=   0.0s
[CV] max_leaf_nodes=7 ................................................
[CV] ................................. max_leaf_nodes=7, total=   0.0s
[CV] max_leaf_nodes=7 ................................................
[CV] ................................. max_leaf_nodes=7, total=   0.0s
[CV] max_leaf_nodes=7 ................................................
[CV] ................................. max_leaf_nodes=7, total=   0.0s
[CV] max_leaf_nodes=8 ................................................
[CV] ................................. max_leaf_nodes=8, total=   0.0s
[CV] max_leaf_nodes=8 ................................................
[CV] ................................. max_leaf_nodes=8, total=   0.0s
[CV] max_leaf_nodes=8 ................................................
[CV] ................................. max_leaf_nodes=8, total=   0.0s
[CV] max_leaf_nodes=9 ................................................
[CV] ................................. max_leaf_nodes=9, total=   0.0s
[CV] max_leaf_nodes=9 ................................................
[CV] ................................. max_leaf_nodes=9, total=   0.0s
[CV] max_leaf_nodes=9 ................................................
[CV] ................................. max_leaf_nodes=9, total=   0.0s


[Parallel(n_jobs=1)]: Using backend SequentialBackend with 1 concurrent workers.
[Parallel(n_jobs=1)]: Done   1 out of   1 | elapsed:    0.0s remaining:    0.0s
[Parallel(n_jobs=1)]: Done  24 out of  24 | elapsed:    0.0s finished

GridSearchCV(cv=3, error_score='raise-deprecating',
       estimator=DecisionTreeClassifier(class_weight=None, criterion='gini', max_depth=None,
            max_features=None, max_leaf_nodes=None,
            min_impurity_decrease=0.0, min_impurity_split=None,
            min_samples_leaf=1, min_samples_split=2,
            min_weight_fraction_leaf=0.0, presort=False, random_state=None,
            splitter='best'),
       fit_params=None, iid='warn', n_jobs=None,
       param_grid={'max_leaf_nodes': [2, 3, 4, 5, 6, 7, 8, 9]},
       pre_dispatch='2*n_jobs', refit=True, return_train_score='warn',
       scoring=None, verbose=2)
print(gridSearchCV.best_params_)
decision_tree = gridSearchCV.best_estimator_
{'max_leaf_nodes': 4}
# 使用測試集對模型進行評估
from sklearn.metrics import accuracy_score
y_prab = gridSearchCV.predict(x_test)
print('accuracy_score:',accuracy_score(y_test,y_prab))
accuracy_score: 0.8455
# 可視化模型
from sklearn.tree import export_graphviz

export_graphviz(decision_tree,
               out_file='./tree.dot',
               rounded = True,
               filled = True)

生成tree.dot文件,然後使用dot命令\[dot -Tpng tree.dot -o decisontree_moons.png\]

5. 附錄

5.1 sklearn.tree.DecisionTreeClassifier類說明

5.1.1 DecsisionTreeClassifier類參數說明

  • criterion: 特徵選擇方式,string,(‘gini’ or ‘entropy’),default=’gini’
  • splitter: 每個結點的拆分策略,(‘best’ or ‘random’),string,default=’best’
  • max_depth: int,default=None
  • min_samples_split: int,float,default=2,分割前所需的最小樣本數
  • min_samples_leaf:
  • min_weight_fraction_leaf:
  • max_features:
  • random_state:
  • max_leaf_nodes:
  • min_impurity_decrease:
  • min_impurity_split:
  • class_weight:
  • presort: bool,default=False,對於小型數據集(幾千個以內)設置presort=True通過對數據預處理來加快訓練,但對於較大訓練集而言,可能會減慢訓練速度

5.1.2 DecisionTreeClassifier屬性說明

  • classes_:
  • feature_importances_:
  • max_features_:
  • n_classes_:
  • n_features_:
  • n_outputs_:
  • tree_:

5.2 GridSearchCV類說明

5.2.1 GridSearchCV參數說明

  • estimator: 估算器,繼承於BaseEstimator
  • param_grid: dict,鍵為參數名,值為該參數需要測試值選項
  • scoring: default=None
  • fit_params:
  • n_jobs: 設置要并行運行的作業數,取值為None或1,None表示1 job,1表示all processors,default=None
  • cv: 交叉驗證的策略數,None或integer,None表示默認3-fold, integer指定“(分層)KFold”中的摺疊數
  • verbose: 輸出日誌類型

5.2.2 GridSearchCV屬性說明

  • cv_results_: dict of numpy(masked) ndarray
  • best_estimator_:
  • best_score_: Mean cross-validated score of the best_estimator
  • best_params_:
  • best_index_: int,The index (of the “cv_results_“ arrays) which corresponds to the best candidate parameter setting
  • scorer_:
  • n_splits_: The number of cross-validation splits (folds/iterations)
  • refit_time: float

參考資料:

  • (1)
  • (2)
  • (3)李航

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"