Express:模板引擎深入研究

深入源碼

首先,看下express模板默認配置。

  • view:模板引擎模塊,對應 require(‘./view’),結合 res.render(name) 更好了解些。下面會看下 view 模塊。
  • views:模板路徑,默認在 views 目錄下。
// default configuration
this.set('view', View);
this.set('views', resolve('views'));

騰訊IVWEB前端團隊招前端工程師,2年以上工作經驗,本科以上學歷,有意者可私信、留言,或者郵箱聯繫 2377488447@qq.com,JD可參考這裏

從實例出發

從官方腳手架生成的代碼出發,模板配置如下:

  • views:模板文件在 views 目錄下;
  • view engine:用jade這個模板引擎進行模板渲染;
// view engine setup
app.set('views', path.join(__dirname, 'views'));
app.set('view engine', 'jade');

假設此時有如下代碼調用,內部邏輯是如何實現的?

res.render('index');

res.render(view)

完整的 render 方法代碼如下:

/**
 * Render `view` with the given `options` and optional callback `fn`.
 * When a callback function is given a response will _not_ be made
 * automatically, otherwise a response of _200_ and _text/html_ is given.
 *
 * Options:
 *
 *  - `cache`     boolean hinting to the engine it should cache
 *  - `filename`  filename of the view being rendered
 *
 * @public
 */

res.render = function render(view, options, callback) {
  var app = this.req.app;
  var done = callback;
  var opts = options || {};
  var req = this.req;
  var self = this;

  // support callback function as second arg
  if (typeof options === 'function') {
    done = options;
    opts = {};
  }

  // merge res.locals
  opts._locals = self.locals;

  // default callback to respond
  done = done || function (err, str) {
    if (err) return req.next(err);
    self.send(str);
  };

  // render
  app.render(view, opts, done);
};

核心代碼就一句,調用了 app.render(view) 這個方法。

res.render = function (name, options, callback) {
  var app = this.req.app;
  app.render(view, opts, done);
};

app.render(view)

完整源碼如下:

/**
 * Render the given view `name` name with `options`
 * and a callback accepting an error and the
 * rendered template string.
 *
 * Example:
 *
 *    app.render('email', { name: 'Tobi' }, function(err, html){
 *      // ...
 *    })
 *
 * @param {String} name
 * @param {String|Function} options or fn
 * @param {Function} callback
 * @public
 */

app.render = function render(name, options, callback) {
  var cache = this.cache;
  var done = callback;
  var engines = this.engines;
  var opts = options;
  var renderOptions = {};
  var view;

  // support callback function as second arg
  if (typeof options === 'function') {
    done = options;
    opts = {};
  }

  // merge app.locals
  merge(renderOptions, this.locals);

  // merge options._locals
  if (opts._locals) {
    merge(renderOptions, opts._locals);
  }

  // merge options
  merge(renderOptions, opts);

  // set .cache unless explicitly provided
  if (renderOptions.cache == null) {
    renderOptions.cache = this.enabled('view cache');
  }

  // primed cache
  if (renderOptions.cache) {
    view = cache[name];
  }

  // view
  if (!view) {
    var View = this.get('view');

    view = new View(name, {
      defaultEngine: this.get('view engine'),
      root: this.get('views'),
      engines: engines
    });

    if (!view.path) {
      var dirs = Array.isArray(view.root) && view.root.length > 1
        ? 'directories "' + view.root.slice(0, -1).join('", "') + '" or "' + view.root[view.root.length - 1] + '"'
        : 'directory "' + view.root + '"'
      var err = new Error('Failed to lookup view "' + name + '" in views ' + dirs);
      err.view = view;
      return done(err);
    }

    // prime the cache
    if (renderOptions.cache) {
      cache[name] = view;
    }
  }

  // render
  tryRender(view, renderOptions, done);
};

源碼開頭有 cache、engines 兩個屬性,它們在 app.int() 階段就初始化了。

this.cache = {};
this.engines = {};

View模塊源碼

看下View模塊的源碼:

/**
 * Initialize a new `View` with the given `name`.
 *
 * Options:
 *
 *   - `defaultEngine` the default template engine name
 *   - `engines` template engine require() cache
 *   - `root` root path for view lookup
 *
 * @param {string} name
 * @param {object} options
 * @public
 */

function View(name, options) {
  var opts = options || {};

  this.defaultEngine = opts.defaultEngine;
  this.ext = extname(name);
  this.name = name;
  this.root = opts.root;

  if (!this.ext && !this.defaultEngine) {
    throw new Error('No default engine was specified and no extension was provided.');
  }

  var fileName = name;

  if (!this.ext) {
    // get extension from default engine name
    this.ext = this.defaultEngine[0] !== '.'
      ? '.' + this.defaultEngine
      : this.defaultEngine;

    fileName += this.ext;
  }

  if (!opts.engines[this.ext]) {
    // load engine
    opts.engines[this.ext] = require(this.ext.substr(1)).__express;
  }

  // store loaded engine
  this.engine = opts.engines[this.ext];

  // lookup path
  this.path = this.lookup(fileName);
}

核心概念:模板引擎

模板引擎大家不陌生了,關於express模板引擎的介紹可以參考官方文檔。

下面主要講下使用配置、選型等方面的內容。

可選的模版引擎

包括但不限於如下模板引擎

  • jade
  • ejs
  • dust.js
  • dot
  • mustache
  • handlerbar
  • nunjunks

配置說明

先看代碼。

// view engine setup
app.set('views', path.join(__dirname, 'views'));
app.set('view engine', 'jade');

有兩個關於模版引擎的配置:

  1. views:模版文件放在哪裡,默認是在項目根目錄下。舉個例子:app.set('views', './views')
  2. view engine:使用什麼模版引擎,舉例:app.set('view engine', 'jade')

可以看到,默認是用jade做模版的。如果不想用jade怎麼辦呢?下面會提供一些模板引擎選擇的思路。

選擇標準

需要考慮兩點:實際業務需求、個人偏好。

首先考慮業務需求,需要支持以下幾點特性。

  • 支持模版繼承(extend)
  • 支持模版擴展(block)
  • 支持模版組合(include)
  • 支持預編譯

對比了下,jade、nunjunks都滿足要求。個人更習慣nunjunks的風格,於是敲定。那麼,怎麼樣使用呢?

支持nunjucks

首先,安裝依賴

npm install --save nunjucks

然後,添加如下配置

var nunjucks = require('nunjucks');

nunjucks.configure('views', {
    autoescape: true,
    express: app
});

app.set('view engine', 'html');

看下views/layout.html

<!DOCTYPE html>
<html>
<head>
    <title>
        {% block title %}
            layout title
        {% endblock %}
    </title>
</head>
<body>
<h1>
    {% block appTitle %}
        layout app title
    {% endblock %}
</h1>
<p>正文</p>

</body>
</html>

看下views/index.html

{% extends "layout.html" %}
{% block title %}首頁{% endblock %}
{% block appTitle %}首頁{% endblock %}

開發模板引擎

通過app.engine(engineExt, engineFunc)來註冊模板引擎。其中

  • engineExt:模板文件後綴名。比如jade。
  • engineFunc:模板引擎核心邏輯的定義,一個帶三個參數的函數(如下)
// filepath: 模板文件的路徑
// options:渲染模板所用的參數
// callback:渲染完成回調
app.engine(engineExt, function(filepath, options, callback){

    // 參數一:渲染過程的錯誤,如成功,則為null
    // 參數二:渲染出來的字符串
    return callback(null, 'Hello World');
});

比如下面例子,註冊模板引擎 + 修改配置一起,於是就可以愉快的使用後綴為tmpl的模板引擎了。

app.engine('tmpl', function(filepath, options, callback){

    // 參數一:渲染過程的錯誤,如成功,則為null
    // 參數二:渲染出來的字符串
    return callback(null, 'Hello World');
});
app.set('views', './views');
app.set('view engine', 'tmpl');

res.render(view [, locals] [, callback])

參數說明:

  • view:模板的路徑。
  • locals:對象類型。渲染模板時傳進去的本地變量。
  • callback:回調函數。如果聲明了的話,當渲染工作完成時被調用,參數為兩個,分別是錯誤(如果出錯的話)、渲染好的字符串。在這種情況下,response不會自動完成。當錯誤發生時,內部會自動調用 next(err)

view參數說明:

  • 可以是相對路徑(相對於views設置的目錄),或者絕對路徑;
  • 如果沒有聲明文件後綴,則以view engine設置為準;
  • 如果聲明了文件後綴,那麼Express會根據文件後綴,通過 require() 加載對應的模板引擎來完成渲染工作(通過模板引擎的 __express 方法完成渲染)。

locals參數說明:

locals.cache 啟動模板緩存。在生產環境中,模板緩存是默認啟用的。在開發環境,可以通過將 locals.cache 設置為true來啟用模板緩存。

例子:

// send the rendered view to the client
res.render('index');

// if a callback is specified, the rendered HTML string has to be sent explicitly
res.render('index', function(err, html) {
  res.send(html);
});

// pass a local variable to the view
res.render('user', { name: 'Tobi' }, function(err, html) {
  // ...
});

關於view cache

The local variable cache enables view caching. Set it to true, to cache the view during development; view caching is enabled in production by default.
render(view, opt, callback) 這個方法調用時,Express會根據 view 的值 ,進行如下操作

  1. 確定模板的路徑
  2. 根據模板的擴展性確定採用哪個渲染引擎
  3. 加載渲染引擎

重複調用render()方法,如果 cache === false 那麼上面的步驟每次都會重新做一遍;如果 cache === true,那麼上面的步驟會跳過;

關鍵源代碼:

if (renderOptions.cache) {
  view = cache[name];
}

此外,在 view.render(options, callback) 里,options 也會作為參數傳入this.engine(this.path, options, callback)。也就是說,渲染引擎(比如jade)也會讀取到options.cache這個配置。根據options.cache的值,渲染引擎內部也可能會進行緩存操作。(比如為true時,jade讀取模板後會緩存起來,如果為false,每次都會重新從文件系統讀取)

View.prototype.render = function render(options, callback) {
  debug('render "%s"', this.path);
  this.engine(this.path, options, callback);
};

備註:cache配置對渲染引擎的影響是不確定的,因此實際需要用到某個渲染引擎時,需確保對渲染引擎足夠了解。

以jade為例,在開發階段,NODE_ENV !== 'production',cahce默認是false。因此每次都會從文件系統讀取模板,再進行渲染。因此,在開發階段,可以動態修改模板內容來查看效果。

當 NODE_ENV === 'production' ,cache 默認是true,此時會緩存模板,提升性能。

混合使用多種模板引擎

根據對源碼的分析,實現很簡單。只要帶上文件擴展名,Express就會根據擴展名加載相應的模板引擎。比如:

  1. index.jade:加載引擎jade
  2. index.ejs:加載引擎ejss
// 混合使用多種模板引擎
var express = require('express');
var app = express();

app.get('/index.jade', function (req, res, next) {
  res.render('index.jade', {title: 'jade'});
});

app.get('/index.ejs', function (req, res, next) {
  res.render('index.ejs', {title: 'ejs'});
});

app.listen(3000);

同樣的模板引擎,不同的文件擴展名

比如模板引擎是jade,但是因為一些原因,擴展名需要採用.tpl

// 同樣的模板引擎,不同的擴展名
var express = require('express');
var app = express();

// 模板採用 tpl 擴展名
app.set('view engine', 'tpl');
// 對於以 tpl 擴展名結尾的模板,採用 jade 引擎
app.engine('tpl', require('jade').__express);

app.get('/index', function (req, res, next) {
  res.render('index', {title: 'tpl'});
});

app.listen(3000);

相關鏈接

Using template engines with Express
http://expressjs.com/en/guide/using-template-engines.html

res.render 方法使用說明
http://expressjs.com/en/4x/api.html#res.render

騰訊IVWEB前端團隊招前端工程師,2年以上工作經驗,本科以上學歷,有意者可私信、留言,或者郵箱聯繫 2377488447@qq.com,JD可參考這裏

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

[WPF自定義控件庫]排序、篩選以及高亮

1. 如何讓列表的內容更容易查找

假設有這麼一個列表(數據源在本地),由於內容太多,要查找到其中某個想要的數據會比較困難。要優化這個列表,無非就是排序、篩選和高亮。

改造過的結果如上。

2. 排序

在WPF中要實現數據排序的功能有很多種,例如用Linq,但這種場景的標準做法是使用CollectionViewSource。

CollectionViewSource是一種數據集合的代理類。它有兩個很重要的屬性:

  • Source 是數據源的集合;

  • View 是經過處理后的數據視圖。

看上去感覺是不是很像數據庫里的Table和View的關係?

在這個例子里使用CollectionViewSource排序的代碼如下:

private readonly CollectionViewSource _viewSource;

public HighlightSample()
{
    InitializeComponent();
    _viewSource = new CollectionViewSource
    {
        Source = Employee.AllExecutives
    };

    _viewSource.View.Culture = new System.Globalization.CultureInfo("zh-CN");
    _viewSource.View.SortDescriptions.Add(new SortDescription(nameof(Employee.FirstName), ListSortDirection.Ascending));
    EmployeeElement.ItemsSource = _viewSource.View;
}

這段代碼為CollectionViewSource的Source賦值后,把CollectionViewSource的View作為ListBox的數據源。其中SortDescriptions用於描述View的排序方式。如果包含中文,別忘記將Culture設置為zh-cn。

至此排序的功能就實現了。文檔中還提到CollectionViewSource的其它信息:

您可以將集合視圖作為綁定源集合,可用於導航和显示集合中基於排序、 篩選和分組查詢,而無需操作基礎源集合本身的所有頂層。 如果Source實現INotifyCollectionChanged接口,所做的更改引起CollectionChanged事件傳播到View。

由於View不會更改Source,因此每個Source都可以有多個關聯的View。 使用View,可以通過不同方式显示相同數據。 例如,可能希望在頁面左側显示按優先級排序的任務,而在頁面右側显示按區域分組的任務。

3. 篩選

CollectionViewSource的View屬性類型為ICollectionView接口,它提供了Filter屬性用於實現數據的過濾。在這個例子里實現如下:

_viewSource.View.Filter = (obj) => (obj as Employee).DisplayName.ToLower().Contains(FilterElement.Text);

private void OnFilterTextChanged(object sender, TextChangedEventArgs e)
{
    if (_viewSource != null)
        _viewSource.View.Refresh();
}

這段代碼實現了當輸入框的文字改變時刷新View的功能。其中Refresh方法用於重新創建View,也就是刷新視圖。

ICollectionView還提供了一個DeferRefresh函數,這個函數用於進入延遲循環,該循環可用於將更改合併到視圖並延遲自動刷新,在需要多次操作並刷新數據量大的集合時可以用這個函數。

4. 高亮

<TextBox x:Name="FilterElement"
         TextChanged="OnFilterTextChanged"/>
<ListBox Name="EmployeeElement"
         Grid.Row="1"
         Height="200"
         Margin="0,8,0,0">
    <ListBox.ItemTemplate>
        <DataTemplate>
            <StackPanel Orientation="Horizontal">
                <TextBlock Text="{Binding DisplayName}"
                           kino:TextBlockService.HighlightText="{Binding ElementName=FilterElement,Path=Text}" />
            </StackPanel>
        </DataTemplate>
    </ListBox.ItemTemplate>
</ListBox>

UWP的高亮可以使用TextHighlighter這個類,實現起來很簡單。WPF中的高亮則是使用自定義的TextBlockService.HighlightText附加屬性聲明要高亮的文字,然後將TextBlock的Text替換為處理過的Inlines,使用方式如上。

private static void MarkHighlight(TextBlock target, string highlightText)
{
    var text = target.Text;
    target.Inlines.Clear();
    if (string.IsNullOrWhiteSpace(text))
        return;

    if (string.IsNullOrWhiteSpace(highlightText))
    {
        target.Inlines.Add(new Run { Text = text });
        return;
    }

    while (text.Length > 0)
    {
        var runText = string.Empty;
        var index = text.IndexOf(highlightText, StringComparison.InvariantCultureIgnoreCase);
        if (index > 0)
        {
            runText = text.Substring(0, index);
            target.Inlines.Add(new Run { Text = runText, Foreground = _noHighlightBrush });
        }
        else if (index == 0)
        {
            runText = text.Substring(0, highlightText.Length);
            target.Inlines.Add(new Run { Text = runText });
        }
        else if (index == -1)
        {
            runText = text;
            target.Inlines.Add(new Run { Text = runText, Foreground = _noHighlightBrush });
        }

        text = text.Substring(runText.Length);
    }
}

這是實現代碼。其實用Regex.Split代碼會好看很多,但懶得改了。
本來應該是高亮匹配的文字,但實際使用中發覺把未匹配的文字置灰更好看,就這樣實現了。

5. 結語

這篇文章介紹了使用CollectionViewSource實現的排序、篩選功能,以及使用附加屬性和Inlines實現高亮功能。

不過這樣實現的高亮功能有個問題:不能定義高亮(或者低亮)的顏色,不管在代碼中還是在XAML中。一種可行的方法是參考ToolTipService定義一大堆附加屬性,例如這樣:

<TextBox x:Name="FilterElement" 
         ToolTipService.ToolTip="Filter Text"
         ToolTipService.HorizontalOffset="10"
         ToolTipService.VerticalOffset="10"
         TextChanged="OnFilterTextChanged"/>

這種方式的缺點是這一大堆附加屬性會導致代碼變得很複雜,難以維護。ToolTipService還可以創建一個ToolTip類,把這個類設置為附加屬性的值:

<TextBox x:Name="FilterElement" 
         TextChanged="OnFilterTextChanged">
    <ToolTipService.ToolTip>
        <ToolTip Content="Filter Text"
                 HorizontalOffset="10" 
                 VerticalOffset="10"/>
    </ToolTipService.ToolTip>
</TextBox>

這種方式比較容易維護,但有人可能不明白ToolTipService.ToolTip屬性的值為什麼既可以是文本(或圖片等其它內容),又可以是ToolTip類型,XAML如何識別。關於這一點我在下一篇文章會講解,並且重新實現高亮的功能以支持Style等功能。

也可以參考SearchableTextBlock寫一個高亮的文本框,一了百了,但我希望通過這個有趣的功能多介紹幾種知識。

6. 參考

CollectionViewSource Class (System.Windows.Data) Microsoft Docs

TextBlock.Inlines Property (System.Windows.Controls) Microsoft Docs

A WPF Searchable TextBlock Control with Highlighting WPF

7. 源碼

TextBlockService.cs at master

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

Jest — ElasticSearch Java 客戶端

1. 介紹

任何使用過Elasticsearch的人都知道,使用基於rest的搜索API構建查詢可能是單調乏味且容易出錯的。

在本教程中,我們將研究Jest,一個用於Elasticsearch的HTTP Java客戶端。Elasticsearch提供了自己原生的Java客戶端,然而 Jest提供了更流暢的API和更容易使用的接口。

2. Maven 依賴

我們需要做的第一件事是導入Jest庫到我們的POM文件中:

<dependency> <groupId>io.searchbox</groupId> <artifactId>jest</artifactId> <version>6.3.1</version> </dependency> 

Jest的版本是遵循Elasticsearch的主版本號的。
這將確保客戶端和服務端之間的兼容性。

通過包含Jest依賴項,相應的[Elasticsearch庫](https://search.maven.org/search?q=g:org.elasticsearch a:elasticsearch)將被包含為傳遞依賴項。

3. 使用Jest Client

在本節中,我們將研究如何使用Jest client執行Elasticsearch中的常見任務。

要使用Jest client,我們只需使用 JestClientFactory 創建一個 JestClient 對象。這些對象的創建開銷很高,而且是線程安全的,因此我們將創建一個可以在整個應用程序中共享的單例實例:

public JestClient jestClient() { JestClientFactory factory = new JestClientFactory(); factory.setHttpClientConfig( new HttpClientConfig.Builder("http://localhost:9200") .multiThreaded(true) .defaultMaxTotalConnectionPerRoute(2) .maxTotalConnection(10) .build()); return factory.getObject(); } 

這裏將創建一個Jest client,該客戶端連接到本地運行的Elasticsearch。雖然這個連接示例很簡單,但是Jest還完全支持代理、SSL、身份驗證,甚至節點發現。

JestClient 類是通用類,只有少數公共方法。我們將使用的一個主要方法是execute,它接受Action接口的一個實例。Jest客戶端提供了幾個構建器類來幫助創建與Elasticsearch交互的不同操作。

所有Jest調用的結果都是JestResult的一個實例。 我們可以通過調用 issucceeded 方法來檢查是否成功。對於失敗的操作,我們可以調用GetErrorMessage方法來獲取更多詳細信息:

JestResult jestResult = jestClient.execute(new Delete.Builder("1").index("employees").build()); if (jestResult.isSucceeded()) { System.out.println("Success!"); } else { System.out.println("Error: " + jestResult.getErrorMessage()); } 

3.1. 管理索引

檢查索引是否存在,我們使用IndicatesExists操作:

JestResult result = jestClient.execute(new IndicesExists.Builder("employees").build()) 

創建一個索引,我們使用CreateIndex操作:

jestClient.execute(new CreateIndex.Builder("employees").build()); 

這將創建一個具有默認設置的索引。我們可以在創建索引時覆蓋特定的設置:

Map<String, Object> settings = new HashMap<>(); settings.put("number_of_shards", 11); settings.put("number_of_replicas", 2); jestClient.execute(new CreateIndex.Builder("employees").settings(settings).build()); 

使用ModifyAliases操作創建或更改別名也很簡單:

jestClient.execute(new ModifyAliases.Builder( new AddAliasMapping.Builder("employees", "e").build()).build()); jestClient.execute(new ModifyAliases.Builder( new RemoveAliasMapping.Builder("employees", "e").build()).build()); 

3.2. 創建文檔

Jest client使用索引操作類索引或創建新文檔變得容易。Elasticsearch中的文檔只是JSON數據,有多種方法可以將JSON數據傳遞給Jest client 進行索引。

對於這個例子,讓我們使用一個虛構的僱員文檔:

{ "name": "Michael Pratt", "title": "Java Developer", "skills": ["java", "spring", "elasticsearch"], "yearsOfService": 2 } 

表示JSON文檔的第一種方法是使用Java字符串。雖然我們可以手動創建JSON字符串,但我們必須注意正確的格式、大括號和轉義引號字符。因此,更容易的方式是使用一個JSON庫(如Jackson)來構建我們的JSON結構,然後將其轉換為字符串:

ObjectMapper mapper = new ObjectMapper(); JsonNode employeeJsonNode = mapper.createObjectNode() .put("name", "Michael Pratt") .put("title", "Java Developer") .put("yearsOfService", 2) .set("skills", mapper.createArrayNode() .add("java") .add("spring") .add("elasticsearch")); jestClient.execute(new Index.Builder(employeeJsonNode.toString()).index("employees").build()); 

我們還可以使用Java Map 來表示JSON數據,並將其傳遞給索引操作:

Map<String, Object> employeeHashMap = new LinkedHashMap<>(); employeeHashMap.put("name", "Michael Pratt"); employeeHashMap.put("title", "Java Developer"); employeeHashMap.put("yearsOfService", 2); employeeHashMap.put("skills", Arrays.asList("java", "spring", "elasticsearch")); jestClient.execute(new Index.Builder(employeeHashMap).index("employees").build()); 

最後,Jest client 可以接受表示要索引的文檔的任何POJO。假設我們有一個Employee類:

public class Employee { String name; String title; List<String> skills; int yearsOfService; } 

我們可以把這個類的一個實例直接傳遞給Index builder:

Employee employee = new Employee(); employee.setName("Michael Pratt"); employee.setTitle("Java Developer"); employee.setYearsOfService(2); employee.setSkills(Arrays.asList("java", "spring", "elasticsearch")); jestClient.execute(new Index.Builder(employee).index("employees").build()); 

3.3. 讀取文檔

使用Jest client從Elasticsearch訪問文檔有兩種主要方法。首先,如果我們知道文檔ID,我們可以使用get操作直接訪問它:

jestClient.execute(new Get.Builder("employees", "17").build()); 

要訪問返回的文檔,我們必須調用其中一個getSource方法。我們可以將結果作為原始JSON獲取,或者將其反序列化為DTO:

Employee getResult = jestClient.execute(new Get.Builder("employees", "1").build()) .getSourceAsObject(Employee.class); 

訪問文檔的其他方法是使用搜索查詢,這種方式在Jest中是通過搜索操作實現的。

Jest client 支持全部的 Elasticsearch query DSL。 與索引操作一樣,查詢被表示為JSON文檔,並且有多種執行搜索的方法。

首先,我們可以傳遞一個表示搜索查詢的JSON字符串。提醒一下,我們必須確保字符串是正確轉義的,並且是有效的JSON:

String search = "{" + " \"query\": {" + " \"bool\": {" + " \"must\": [" + " { \"match\": { \"name\": \"Michael Pratt\" }}" + " ]" + " }" + " }" + "}"; jestClient.execute(new Search.Builder(search).build()); 

與上面的索引操作一樣,我們可以使用Jackson之類的庫來構建JSON查詢字符串。此外,我們還可以使用原生的Elasticsearch查詢操作API。這樣做的一個缺點是,我們的應用程序必須依賴於完整的Elasticsearch庫。

我們可以使用 getSource 方法來訪問搜索操作中匹配的文檔。然而,Jest還提供了Hit類,它包裝了匹配的文檔並提供有關結果的元數據。 使用Hit類,我們可以訪問每個結果的附加元數據:得分、路由和解釋結果,舉幾個例子:

List<SearchResult.Hit<Employee, Void>> searchResults = jestClient.execute(new Search.Builder(search).build()) .getHits(Employee.class); searchResults.forEach(hit -> { System.out.println(String.format("Document %s has score %s", hit.id, hit.score)); }); 

3.4. 更新文檔

Jest為更新文檔提供了一個簡單的Update操作:

employee.setYearOfService(3); jestClient.execute(new Update.Builder(employee).index("employees").id("1").build()); 

它接受與我們前面看到的索引操作相同的JSON表示,這使得在兩個操作之間共享代碼變得很容易。

3.5. 刪除文檔

從索引中刪除文檔是使用Delete操作完成的。它只需要索引名和文檔ID:

jestClient.execute(new Delete.Builder("17") .index("employees") .build()); 

4. 批量操作

Jest client 同樣支持批量操作。 這意味着我們可以通過同時發送多個操作來節省時間和帶寬。

使用批量操作,我們可以將任意數量的請求組合成單個調用。我們甚至可以將不同類型的請求組合在一起:

jestClient.execute(new Bulk.Builder() .defaultIndex("employees") .addAction(new Index.Builder(employeeObject1).build()) .addAction(new Index.Builder(employeeObject2).build()) .addAction(new Delete.Builder("17").build()) .build()); 

5. 異步操作

Jest client 同樣支持異步操作。 這意味着我們可以使用非阻塞I/O執行上述任何操作。

要異步調用操作,只需使用客戶端的executeAsync方法:

jestClient.executeAsync( new Index.Builder(employeeObject1).build(), new JestResultHandler<JestResult>() { @Override public void completed(JestResult result) { // handle result } @Override public void failed(Exception ex) { // handle exception } }); 

注意,除了(本例中是索引)操作之外,異步流還需要一個JestResultHandler。當操作完成時,Jest client 將調用該對象。該接口有兩個方法—完成和失敗—分別允許處理操作的成功或失敗。

6. 結論

在本教程中,我們簡要介紹了Jest client,一個用於Elasticsearch的RESTful Java客戶端。雖然我們只介紹了它的一小部分功能,但很明顯Jest是一個健壯的Elasticsearch客戶端。它的流暢的構建器類和RESTful接口使其易於學習,並且它對Elasticsearch接口的完全支持使其成為原生客戶端的一個有力的替代方案。

和往常一樣,本教程中的所有代碼示例都在我們的Github頁面上。

原文:https://www.baeldung.com/elasticsearch-jest

作者:Michael Pratt

譯者:huowolf/

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

web跨域及cookie相關知識總結

  之前對於跨域相關的知識一致都很零碎,正好現在的代碼中用到了跨域相關的,現在來對這些知識做一個匯總整理,方便自己查看,說不定也可能對你有所幫助。

本篇主要內容如下:

  • 瀏覽器同源策略
  • http 請求跨域
  • http 請求跨域解決辦法
  • cookie 機制
  • 如何共享 cookie

瀏覽器同源策略

  相信很多人在 web 入門時,都被跨域問題折磨的死去活來。要想完全掌握跨域就得知道為什麼會有跨域這個問題出現。

  簡單來說跨域問題是因為瀏覽器的同源策略導致的。那瀏覽器為什麼要有同源策略呢?

  當然是為了安全。沒有同源策略限制的瀏覽器環境是非常危險的(即使有了同源策略也不是百分百安全),有興趣的可以去了解了解CSRF和XSS攻擊。

  所謂的“同源”指的是“三個相同”:

  • 協議相同。不能一個是 http 協議,一個是 https
  • 域名相同
  • 端口相同

如果非同源頁面有以下限制:

  • LocalStore 和 IndexDB 無法讀取。這兩個顯然是不能讀取的,但是 cookie 有點不一樣,放在後面單獨說明
  • DOM 無法獲取,比如如法在頁面 A 中通過 iframe 獲取異源頁面 B 的 DOM
  • AJAX 請求無法讀取(可以發送請求,但是無法讀取到請求結果。比如在頁面 A 中請求異源接口 B,請求會正常發出處理,但是在頁面 A 中無法獲取請求結果,除非響應頭 Access-Control-Allow-Headers 中允許了頁面 A 的源,這樣就能讀取到結果)

  但是這裡有個例外,所有帶“src”屬性的標籤都可以跨域加載資源,不受同源策略的限制,這樣你應該可以想到一個比較古老的跨域解決方案(JSONP),同時這個特性也會被用作 CSRF 攻擊。

http 請求跨域

  在前端開發中經常會遇到跨域的問題,比如前後端分離中前後端部署在不同的端口上,或者在前端頁面中需要向另外一個服務請求數據,這些都會被跨域所阻擋。

目前主要有以下幾種辦法解決跨域問題:

  1. 關閉瀏覽器同源檢查

  這個太暴力,也太不安全了,不用考慮。

  1. jsonp 實現跨域請求

  前面說過了瀏覽器對於帶 src 屬性的標籤都可以跨域的。因此 jsonp 的實現流失利用了這個特性,在頁面中動態插入一個<script>標籤,然後他的 src 屬性就是接口調用地址,這樣就能訪問過去了,然後再講返回內容特殊處理成立即執行的函數,這樣就看起像進行了一次跨域請求。之所以不推薦這種方式,主要有以下兩個原因:

  • 實現複雜,且需要前後台同時修改才能實現
  • 只能進行 get 請求
  1. 服務器設置運行跨域

  這種方法只需要後台做處理便能實現跨域,前面說的 http 跨域請求是能夠發出去的,只是不能接收,那我們只要在響應頭Access-Control-Allow-Headers中加入允許請求的地址即可,以,分隔,同時*代表所有地址都允許。比如:

Access-Control-Allow-Headers:http://localhost:8081,http://localhost:8082

本方法是較為常用的一中跨域辦法,只需簡單修改服務端代碼即可。

  1. 請求代理

  這也是非常常用的一種跨域方法。跨域限制只是瀏覽器限制,服務端並沒有這個概念,因此我們在前端還是請求同域地址,然後在服務端做一個代理,將請求轉發到真正的 ip 和端口上。通常使用 nginx 實現端口轉發,比如下面一段 nginx 配置:

server {
    # /test1/abc 轉發到 http://a.com:8011/abc
    location /test1/ {
        proxy_pass http://a.com:8011/;
    }

    # /test2/abc 轉發到 http://b.com:8011/main/abc
    location /test2/ {
        proxy_pass http://b.com:8011/main/;
    }

    # /test3/abc 轉發到 http://c.com:8011/test3/abc
    location /test3/ {
        proxy_pass http://c.com:8081;
    }
}

cookie 同源策略

  cookie 的同源策略是通過

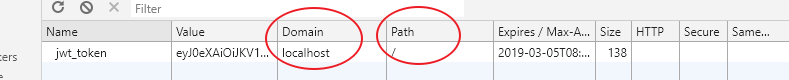
Domain和path兩個部分來共同確認一個 cookie 在哪些頁面上可用。

  Domain確定這個 cookie 所屬的域名,不能帶端口或協議。因此 cookie 便可在不同端口/不同協議下共享,只要域名相同。有一個例外是父子域名間也能共享 cookie,只需將 Domain 設置為.父域名。

  path就簡單多了,通過 Domain 確定哪些域名可以共享 cookie,然後在通過path來確定 cookie 在哪些路徑下可用。使用/表示所有路徑都可共享。

具體如下:

  • Domain : example,path : /a可獲取 cookie:http://example:8081/a,https://example:8081/a
  • Domain : example,path : /可獲取 cookie:http://example:8081/a,https://example:8081/a , http://example:12/abcd
  • Domain : .example,path : /a可獲取 cookie:http://example:8081/a , https://localhost:8081/a , http://test.example:889/a

注意:在跨域請求中,即時目標地址有 cookie 且發起請求的頁面也能讀取到該 cookie,瀏覽器也不會將 cookie 自動設置到該跨域請求中。比如在http://localhost:8082/a頁面中請求http://localhost:8081/abc,這兩個地址下擁有共享cookie,http請求也不會攜帶cookie。

本篇原創發佈於:FleyX 的個人博客

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

編程哲理小故事:Tina的運動會方陣

自從接到任務后,Tina一直 煩惱着如何讓這群繁忙又缺乏才藝的程序員在運動會開幕式上做出一個有趣的方陣表演。


接到了運動會的方陣表演的任務

時間回到1個月前。

Tina正在工位上繁忙地進行着下一期準備上線系統的測試,這時候老大跑了過來

“Tina,我們公司要舉行運動會,開幕式時有方陣的表演,你幫忙組織下?”

Tina心裏咯噔一下,來了一個苦差。

“方陣?就是像奧運會開幕的時候,運動員在體育場跑道上走,展示風採的那種?”

“對,到時要一個6*6共36人的方陣,到時會在市裡最好的體育館進行,公司的大領導會在主席台看我們表演,為了我們部門,你要加油呀”

“嗯,我會加油的,但36個人不少呀,大家最近都挺忙的,感覺我拉不動他們參加呀”,Tina苦笑道。

“怎麼會呢,我看你在男生中還挺有人氣的,不過你不好意思拉人的話,人的問題我解決,你策劃組織好表演就行”


進展緩慢的方陣表演

方陣的排練一周一次,一周一周的過去了,但整體的效果並沒有得到質的提升,排練時總是湊不齊人,舞蹈也相對複雜,交互很多,大家也沒能很好的磨合,方陣表演這件事幾乎成了Tina的心病

“萬一到時我們成了最差的方陣怎麼辦?我會讓老大很失望的”

今天還沒到排練的時間,但她提前到了場地,擔心着,糾結着。

“方陣排練成怎樣啦?”今天老大居然親自過來了。

“我們今晚繼續排練,但效果還不太理想”

“有遇到什麼困難么?”

“唉,一言難盡,待會你看下把,也提一下意見,這個是我們排練模仿的視頻,你也可以看下”

老大把脈

老大在旁邊看着大夥排練,沒有做任何評價與指導,只是在久不久時用言語激勵一下大家。

今天的排練結束了,大夥都散去,Tina和老大留了下來。

“今天的排練我看了,我們的整齊度還略有欠缺,我們的隊伍就像你描述的一樣,經常會有人臨時有事,沒辦法很好的達到一個整體的效果,磨合度有待提升”

“嗯,對呀,但我已經儘力選擇大家都有空的時間了,但要每個人都有空是在是太難了”

“對,這是一個問題,人越多越難協調與同步,我們通過初中數學就可以知道,協調的難度是隨着人數的增加指數級上漲的”

“嗯嗯,但也沒辦法呀,表演方陣要求就是要這麼多人”,Tina應答着,心裏倒翻了個白眼,好好的幹嘛突然扯上數學

“對,總人數是沒辦法減少,但如果分成多個小組,小組人數比較小,是不是集齊一個小組的人更為簡單點?我們可以讓各個小組各自排練,然後每周一次像現在這樣合起來排練。對於類似規模導致的問題,我們大多都可以用分而治之的策略解決,就像公司里把我們的軟件分成了很多子系統一樣”

“啊?那這樣子要怎麼分組,這是一隻完整的舞蹈呀”

“一個完整的舞蹈必然是每個人的交互的有機結合,但舞蹈里必然會有一群人之間的交互更為密切,我們可以把這群人合成一組,那隻涉及他們內部的舞蹈叫可以他們內部自行排練了。”

“但這個界限不是很清晰把?”

“對,更為密切這個概念確實不是很清晰,所以這也是組織設計的藝術之一,甚至於這是一個需要試錯的過程。我們的軟件編碼一樣,強調高內聚低耦合,讓通訊交互成本降到最低的理念是一致的。但我們不能因為無法達到最優的設計而不去分組,分組可能不是最優,但進行了分組就已經在進步了,我們可以在繼續排練的過程中繼續優化”

“嗯嗯,想不到編碼與方陣排練還有這樣類似的東西,哈哈”

“嗯,世界有很多東西是相似的,像公司的組織架構、各種天體系統、人類的各種器官組成等等都有類似高內聚低耦合的特性存在,所以在我看來一個優秀的有悟性的碼農能將其知識遷移到很多領域”

“好,那我認真研究下視頻,然後對團隊進行分組,一個分組的大小多少合適呢?”

“太陽系有8個行星,地球只有1個月球衛星,這都是由於它們質量決定的。一個分組最大能有多少人這實質是由組長的個人能力決定的,組長能協調的人數就是這個組人數的上限,但當然啦,具體人數要和舞蹈自身的需要相結合。組的大小可以取‘舞蹈分組所需人數’和‘組長最大可管理人數’的較小值。”

“這是讓一個組盡可能大的意思么?”

“對的,一個組應該在可控範圍內盡可能的大,因為分組小意味着分組多,而分組多,協調多個分組就會產生更大的成本。當分組很多,甚至於把一個人看成一個組的時候,就跟你當前面臨的情況一樣。對應於我們軟件領域也是一樣的,對於微服務/組件應該拆成多大這個問題,個人理解組件的大小應該在一個普通程序員能理解、控制的複雜度範圍內,程序員就是這個微服務的類、模塊的組長”

“嗯,明白了。我盡量將其分組大小控制在合適範圍內”

“還有一件事就是,每個小組指定了組長之後,之後組內的排練可以適當程度的放權,這樣的話,你才有更多的精力去考慮我們組與組之間的交互應該怎麼進行。但當然啦,如果你得精力足夠的話,去了解和支持某些個特別舞蹈特別複雜的小組的進展也是挺好的。對於人的能力來說,能做高層設計同時也能做底層執行當然是最理想的,但在程序代碼里,一個模塊既處理高層邏輯又處理底層邏輯的話,是一個不好的表現,這會讓我們的代碼更難以理解”

“哈哈,我本來只想看下怎麼排練好方陣,想不到還順便學習了這麼多編碼知識,感謝老大呀!”

“嗯,剛剛的說的都是些簡單的理論,至於落地到實踐還會複雜的多,細節的處理還是得靠你呀,加油~”

最後的展示

有了一些基礎理論的指導,Tina的方陣隊伍的組織架構在排練中演進,各個小組有了組長能自發的組織組內的訓練,各組的表演水平得到了很大的提升。到集體匯總排練的時候,實際上就是以組的維度進行交互,而非之前的以人維度的磨合,因此集體匯總排練的效率也得到了提升。

“起步走!”,方陣前進的音樂和口令在體育館正式響起,方陣邁着整齊的步伐往主席台走去。Tina看着隊伍,再回頭看來下老大,嘴角泛起了自信的微笑。


(最近看了本如何寫小說的書,實踐一下小說風格,哈哈,若本文有錯誤缺陷,請批評負責幫助我進步。若本文對你有所啟發和幫助請不吝點贊轉發。這對我真的很重要,拜託了~)


作者簡介

多年金融行業經驗,現為某Top2互聯網銀行高級搬磚工,曾在兩家TOP3股份制商業銀行及一家互金創業公司工作(架構、核心業務主程),EasyTransaction作者,歡迎關注個人公眾號,在這裏我會分享日常工作、生活中對於架構、編碼和業務的思考


【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

Swoole 啟動一個服務,開啟了哪些進程和線程?

目錄

  • 概述
  • 代碼
  • 小結

概述

Swoole 啟動一個服務,開啟了哪些進程和線程?

為了解決這個問題,咱們啟動一個最簡單的服務,一起看看究竟啟動了哪些進程和線程?

然後結合官網運行流程圖,對每個進程和線程進行歸類。

服務啟動后打印出當前 Swoole 版本 和 當前 CPU 核數。

打印 Swoole 版本,是讓大家可以下載這個版本 去運行代碼。

打印 CPU 核數,是因為這個參數下面會用到。

廢話不多說,直接看代碼吧。

代碼

serv.php

<?php

class Server
{
    private $serv;

    public function __construct() {
        $this->serv = new swoole_server("0.0.0.0", 9502);
        $this->serv->set([
            'worker_num'      => 3,
            'task_worker_num' => 3,
        ]);
        $this->serv->on('Start', function ($serv) {
            echo "SWOOLE:".SWOOLE_VERSION . " 服務已啟動".PHP_EOL;
            echo "SWOOLE_CPU_NUM:".swoole_cpu_num().PHP_EOL;
        });
        $this->serv->on('Receive', function ($serv, $fd, $from_id, $data) { });
        $this->serv->on('Task', function ($serv, $task) { });
        $this->serv->on('Finish', function ($serv, $task_id, $data) {});
        $this->serv->start();
    }
}
$server = new Server();

上面的代碼簡單說下,創建了一個 TCP 服務器,啟動了 3 個 worker 進程, 3 個 task 進程,因為啟用了 task 功能,所以必須註冊 onTask、onFinish 2 個事件的回調函數。

咱們運行一下:

使用 ps 查看下:

16390 的父進程是 16389。

16393、16394、16395、16396、16397、16398 的父進程是 16390。

有沒有發現,16391、16392 去哪啦?是不是很奇怪。

再用 pstree 查看下:

出來了吧,16391、16392 是線程 與 16390 進程一個層級。

現在我們了解了,啟動的這個服務使用了 8 個進程、2 個線程。

我們一起看下官方 Swoole Server 的文檔:

https://wiki.swoole.com/wiki/page/p-server.html

看下這張圖:

通過上面的圖,我們可以得到結論:

16389 是 Master 進程。

16390 是 Manager 進程。

16391、16392 是 Reactor 線程。

16393、16394、16395、16396、16397、16398 包括 3 個 Worker 進程,3 個 Task 進程。

小結

一、為什麼是 3 個 Worker 進程、3 個 Task 進程?

因為,在創建服務的時候我們進行了設置 worker_num = 3, task_worker_num = 3。

worker_num 如果不進行設置,默認為 SWOOLE_CPU_NUM,在上面咱們打印出來了,默認為 2,最大不超過,SWOOLE_CPU_NUM * 1000,具體詳情,看官方文檔。

worker_num 文檔:

https://wiki.swoole.com/wiki/page/275.html

task_worker_num 文檔:

https://wiki.swoole.com/wiki/page/276.html

二、為什麼是 2 個 Reactor 線程?它是干什麼的?

因為,Reactor 線程數,默認為 SWOOLE_CPU_NUM,也可以通過 reactor_num 參數進行設置。

reactor_num 文檔:

https://wiki.swoole.com/wiki/page/281.html

它是真正處理 TCP 連接,收發數據的線程。

Reactor線程 文檔:

https://wiki.swoole.com/wiki/page/347.html

三、Reactor、Worker、TaskWorker 的關係是什麼樣的?

一個通俗的比喻,假設Server就是一個工廠,那Reactor就是銷售,接受客戶訂單。而Worker就是工人,當銷售接到訂單后,Worker去工作生產出客戶要的東西。而TaskWorker可以理解為行政人員,可以幫助Worker幹些雜事,讓Worker專心工作。

官方已經解釋的很詳細了,看官方文檔吧:

https://wiki.swoole.com/wiki/page/163.html

如果你想學習 Swoole 可以看下這個 《Swoole 文章匯總(10 篇)》。

本文歡迎轉發,轉發請註明作者和出處,謝謝!

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

一次給女朋友轉賬引發我對分佈式事務的思考

本文在個人技術博客不同步發布,詳情可用力戳
亦可掃描屏幕右側二維碼關注個人公眾號,公眾號內有個人聯繫方式,等你來撩…

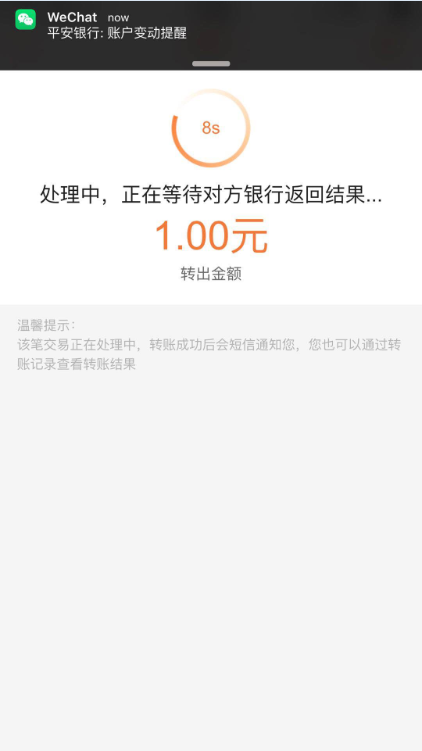
   前两天發了工資,第一反應是想着要給遠方的女朋友一點驚喜!於是打開了平安銀行的APP給女朋友轉點錢!填寫上對方招商銀行卡的卡號、開戶名,一鍵轉賬!搞定!在我點擊的那瞬間,就收到了app的賬戶變動的提醒,並且出現了圖一所示的提示界面:“處理中,正在等待對方銀行返回結果…”。嗯!畢竟是跨行轉賬嘛,等個幾秒也正常!腦海開始浮現出女朋友收到轉賬后驚喜與感動的畫面!


   然而,一切並沒有那麼順利,剛過一會兒,app卻如圖二所示的提示我“由於收款人戶名不符”導致轉賬失敗!!!


   剛剛都已經從我卡里扣過錢了,現在卻提示我轉賬失敗,銀行會不會把我的錢給吞了?轉賬失敗的錢還能退換給我嗎?正在我緊張、焦慮、坐立不安之時又收到一條app沖正的消息,剛剛轉賬失敗的錢已經退還給我了,看來我多慮了……這也證明咱平安銀行的app還是比較安全靠譜的!

   為啥從我卡里扣錢那麼迅速,而對方卻要幾秒才能到賬?並且轉賬失敗后,扣除的錢還能及時的返還到我的卡里?萬一錢返還失敗怎麼辦?又或者我轉一次錢,對方卻收到了兩次轉賬的申請又該如何?帶着這些問題,我腦海中浮現出“事務”二字!

   在我們還在“牙牙學語”的時候,老師經常會通過轉賬的栗子來跟我們講解事務,但跟這裏場景不一樣的是,老師講的是本地事務,而這裏面對的是分佈式事務!我們先來簡單回顧一下本地事務!

本地事務

   談到本地事務,大家可能都很熟悉,因為這個數據庫引擎層面能支持的!所以也稱數據庫事務,數據庫事務四大特徵:原子性(A),一致性(C),隔離性(I)和持久性(D),而在這四大特性中,我認為一致性是最基本的特性,其它的三個特性都為了保證一致性而存在的!

   回到學生時代老師給我們舉的經典栗子,A賬戶給B賬戶轉賬100元(A、B處於同一個庫中),如果A的賬戶發生扣款,B的賬戶卻沒有到賬,這就出現了數據的不一致!為了保證數據的一致性,數據庫的事務機制會讓A賬戶扣款和B在賬戶到賬的兩個操作要麼同時成功,如果有一個操作失敗,則多個操作同時回滾,這就是事務的原子性,為了保證事務操作的原子性,就必須實現基於日誌的REDO/UNDO機制!但是,僅有原子性還不夠,因為我們的系統是運行在多線程環境下,如果多個事務并行,即使保證了每一個事務的原子性,仍然會出現數據不一致的情況。例如A賬戶原來有200元的餘額, A賬戶給B賬戶轉賬100元,先讀取A賬戶的餘額,然後在這個值上減去100元,但是在這兩個操作之間,A賬戶又給C賬戶轉賬100元,那麼最後的結果應該是A減去了200元。但事實上,A賬戶給B賬戶最終完成轉賬后,A賬戶只減掉了100元,因為A賬戶向C賬戶轉賬減掉的100元被覆蓋了!所以為了保證併發情況下的一致性,又引入的隔離性,即多個事務併發執行后的狀態,和它們串行執行后的狀態是等價的!隔離性又有多種隔離級別,為了實現隔離性(最終都是為了保證一致性)數據庫又引入了悲觀鎖、樂觀鎖等等……本文的主題是分佈式事務,所以本地事務就只是簡單回顧一下,需要記住的一點是,事務是為了保證數據的一致性!

分佈式理論

  還記得剛畢業那年,帶着滿腔的熱血就去到了一家互聯網公司,領導給我的第一個任務就是在列表上增加一個修改數據的功能。這能難倒我?我分分鐘給你搞出來!不就是在列表上增加了一個“修改”按鈕,點擊按鈕彈出框修改后保存就好了么。然而一切不像我想象的那麼順利,點擊保存並刷新列表后,頁面上的數據還是显示的修改之前的內容,像沒有修改成功一樣!過一會兒再刷新列表,數據就能正常显示了!測試多次之後都是這樣!沒見過什麼大場面的我開始有點慌了,是我哪裡寫得不對么?最終,我不得不求助組內經驗比較豐富的前輩!他深吸了一口氣告訴我說:“畢竟是剛畢業的小伙子啊!我來跟你講講原因吧!我們的數據庫是做了讀寫分離的,部分讀庫與寫庫在不同的網絡分區。你的數據更新到了寫庫,而讀數據的時候是從讀庫讀取的。更新到寫庫的數據同步到讀庫是有一定的延遲的,也就是說讀庫與寫庫會有短暫的數據不一致”! “這樣不會體驗不好么?為什麼不能做到寫入的數據立馬能讀出來?那我這個功能該怎麼實現呢?” 面對我的一堆問題,同事有些不耐煩的說:“聽說過CAP理論嗎?你先自己去了解一下吧”!是我開始查閱各種資料去了解這個陌生的詞背後的秘密!

  CAP理論是由加州大學Eric Brewer教授提出來的,這個理論告訴我們,一個分佈式系統不可能同時滿足一致性(Consistency)、可用性(Availability)、分區容錯性(Partition tolerance)這三個基本需求,最多只能同時滿足其中兩項。
  一致性:這裏的一致性是指數據的強一致,也稱為線性一致性。是指在分佈式環境中,數據在多個副本之間是否能夠保持一致的特性。也就是說對某個數據進行寫操作后立馬執行讀操作,必須能讀取到剛剛寫入的值。(any read operation that begins after a write operation completes must return that value, or the result of a later write operation)
  可用性:任意被無故障節點接收到的請求,必須能夠在有限的時間內響應結果。(every request received by a non-failing node in the system must result in a response)
  分區容錯性:如果集群中的機器被分成了兩部分,這兩部分不能互相通信,系統是否能繼續正常工作。(the network will be allowed to lose arbitrarily many messages sent from one node to another)

  在分佈式系統中,分區容錯性是基本要保證的。也就是說只能在一致性和可用性之間進行取捨。一致性和可用性,為什麼不可能同時成立?回到之前修改列表的例子,由於數據會分佈在不同的網絡分區,必然會存在數據同步的問題,而同步會存在網絡延遲、異常等問題,所以會出現數據的不一致!如果要保證數據的一致性,那麼就必須在對寫庫進行操作時,鎖定其他讀庫的操作。只有寫入成功且完成數據同步后,才能重新放開讀寫,而這樣在鎖定期間,系統喪失了可用性。更詳細關於CAP理論可以參考這篇文章,該文章講得比較通俗易懂!

分佈式事務

   分佈式事務就是在分佈式的場景下,需要滿足事務的需求!上篇文章我們聊過了消息中間件,那這篇文章我們要聊的是分佈式事務,把兩者一結合,便有了基於消息中間件的分佈式事務解決方案!不管是本地事務,還是分佈式事務,都是為了解決數據的一致性問題!一致性這個詞咱們前面多次提及!與本地事務不同的是,分佈式事務需要保證的是分佈式環境下,不同數據庫表中的數據的一致性問題。分佈式事務的解決方案有多種,如XA協議、TCC三階段提交、基於消息隊列等等,本文只會涉及基於消息隊列的解決方案!

   本地事務講到了一致性,分佈式事務不可避免的面臨着一致性的問題!回到最開始跨行轉賬的例子,如果A銀行用戶向B銀行用戶轉賬,正常流程應該是:

1、A銀行對轉出賬戶執行檢查校驗,進行金額扣減。
2、A銀行同步調用B銀行轉賬接口。
3、B銀行對轉入賬戶進行檢查校驗,進行金額增加。
4、B銀行返回處理結果給A銀行。


   在正常情況對一致性要求不高的場景,這樣的設計是可以滿足需求的。但是像銀行這樣的系統,如果這樣實現大概早就破產了吧。我們先看看這樣的設計最主要的問題:

1、同步調用遠程接口,如果接口比較耗時,會導致主線程阻塞時間較長。
2、流量不能很好控制,A銀行系統的流量高峰可能壓垮B銀行系統(當然B銀行肯定會有自己的限流機制)。
3、如果“第1步”剛執行完,系統由於某種原因宕機了,那會導致A銀行賬戶扣款了,但是B銀行沒有收到接口的調用,這就出現了兩個系統數據的不一致。
4、如果在執行“第3步”后,B銀行由於某種原因宕機了而無法正確回應請求(實際上轉賬操作在B銀行系統已經執行且入庫),這時候A銀行等待接口響應會異常,誤以為轉賬失敗而回滾“第1步”操作,這也會出現了兩個系統數據的不一致。

   對於問題的1、2都很好解決,如果對消息隊列熟悉的朋友應該很快能想到可以引入消息中間件進行異步和削峰處理,於是又重新設計了一個方案,流程如下:

1、A銀行對賬戶進行檢查校驗,進行金額扣減。
2、將對B銀行的請求異步寫入隊列,主線程返回。
3、啟動後台程序從隊列獲取待處理數據。
4、後台程序對B銀行接口進行遠程調用。
5、B銀行對轉入賬戶進行檢查校驗,進行金額增加。
6、B銀行處理完成回調A銀行接口通知處理結果。


   通過上面的圖我們能看到,引入消息隊列后,系統的複雜性瞬間提升了,雖然彌補了我們第一種方案的幾個不足點,但也帶來了更多的問題,比如消息隊列系統本身的可用性、消息隊列的延遲等等!並且,這樣的設計依然沒有解決我們面臨的核心問題-數據的一致性!

1、如果“第1步”剛執行完,系統由於某種原因宕機了,那會導致A銀行賬戶扣款了,但是寫入消息隊列失敗,無法進行B銀行接口調用,從而導致數據不一致。
2、如果B銀行在執行“第5步”時由於校驗失敗而未能成功轉賬,在回調A銀行接口通知回滾時網絡異常或者宕機,會導致A銀行轉賬無法完成回滾,從而導致數據不一致。

   面對上述問題,我們不得不對系統再次進行升級改造。為了解決“A銀行賬戶扣款了,但是寫入消息隊列失敗”的問題,我們需要藉助一個轉賬日誌表,或者叫轉賬流水表,該表簡單的設計如下:

字段名稱 字段描述
tId 交易流水id
accountNo 轉出賬戶卡號
targetBankNo 目標銀行編碼
targetAccountNo 目標銀行卡號
amount 交易金額
status 交易狀態(待處理、處理成功、處理失敗)
lastUpdateTime 最後更新時間

   這個流水表需要怎麼用呢?我們在“第1步”進行扣款時,同時往流水表寫入一條操作流水,狀態為“待處理”,並且這兩個操作必須是原子的,也就是說必須通過本地事務保證這兩個操作要麼同時成功,要麼同時失敗!這就保證了只要轉賬扣款成功,必定會記錄一條狀態為“待處理”的轉賬流水。如果在這一步失敗了,那自然就是轉賬失敗,沒有後續操作了。如果這步操作后系統宕機了導致沒有將消息成功寫入消息隊列(也就是“第2步”)也沒關係,因為我們的流水數據已經持久化了!這時候我們只需要加入一個後台線程進行補償,定期的從轉賬流水表中讀取狀態為“待處理”且最後更新的時間距當前時間大於某個閾值的數據,重新放入消息隊列進行補償。這樣,就保證了消息即使丟失,也會有補償機制!B銀行在處理完轉賬請求後會回調A銀行的接口通知轉賬的狀態,從而更新A銀行流水表中的狀態字段!這樣就完美解決了上一個方案中的兩個不足點。系統設計圖如下:
  

   到目前為止,我們很好的解決了消息丟失的問題,保證了只要A銀行轉賬操作成功,轉賬的請求就一定能發送到B銀行!但是該方案又引入了一個問題,通過後台線程輪詢將消息放入消息隊列處理,同一次轉賬請求可能會出現多次放入消息隊列而多次消費的情況,這樣B銀行會對同一轉賬多次處理導致數據出現不一致!那怎麼保證B銀行轉賬接口的冪等性呢?

   同樣的,我們可以在B銀行系統中需要增加一個轉賬日誌表,或者叫轉賬流水表,B銀行每次接收到轉賬請求,在對賬戶進行操作的時候同時往轉賬日誌表中插入一條轉賬日誌記錄,同樣這兩個操作也必須是原子的!在接收到轉賬請求后,首先根據唯一轉賬流水Id在日誌表中查找判斷該轉賬是否已經處理過,如果未處理過則進行處理,否則直接回調返回! 最終的架構圖如下:
  

   所以,我們這裏最核心的就是A銀行通過本地事務保證日誌記錄+後台線程輪詢保證消息不丟失。B銀行通過本地事務保證日誌記錄從而保證消息不重複消費!B銀行在回調A銀行的接口時會通知處理結果,如果轉賬失敗,A銀行會根據處理結果進行回滾。

   當然,分佈式事務最好的解決方案是盡量避免出現分佈式事務!

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!
代碼榮辱觀-以運用風格為榮,以隨意編碼為恥

編寫代碼的八榮八恥

1. 產品命名:以簡單有趣為榮,以平庸難記為恥。

2. 單個函數:以短小精悍為榮,以冗長費神為恥。

3. 代碼維護:以持續重構為榮,以停滯不前為恥。

4. 編程風格:以運用風格為榮,以隨意編碼為恥。

5. 程序設計:以開關上線為榮,以自信編碼為恥。

6. 接口定義:以用戶易用為榮,以複雜歧義為恥。

7. 斷言分支:以實時報警為榮,以忽略分支為恥。

8. 監控報警:以定時調整為榮,以放棄維護為恥。

5Why分析

(一)

Q: 誰需要學習編寫代碼的八榮八恥?

A: 項目中的開發人員、項目經理、架構師

(二)

Q: 為什麼學習編寫代碼的八榮八恥?

A: 可以作為實際代碼編寫和review(複查)的指導規範

(三)

Q: 什麼人什麼時候需要review代碼?

A: 

對開發人員來說,需要在時間允許的條件下定期的review自己和別人的代碼,加深對項目的整體理解。對自己的成長做總結。如果過了一段時間,還看到自己之前的代碼,覺得寫的很好的話,就需要質疑自己的成長,更努力的學習了。

對於項目經理和架構師來說,鼓勵所有上線的功能都每周抽出時間來做個組內review。或者定期抽取一些模塊做review。鼓勵大家重構代碼。在review過程中,作為領導者需要對大家有輸出,對代碼怎麼寫是更好的有一些理論基礎。這時候就需要使用編寫代碼的八榮八恥作為review的指導規範。

(四)

Q: 怎麼用作review的指導規範?

A: 八榮八恥中不但介紹了每個條目的意義,而且有通俗易懂的代碼實例便於和實際中的代碼在頭腦中做對比。文中明確的指出了哪些寫法是鼓勵的、哪些是不鼓勵的,是基於什麼理由不鼓勵這樣做。

(五)

Q: 編寫代碼的八榮八恥對於高可用有什麼意義?

A: 我利用美團的內部運維平台對自己參與過的項目可用性做過統計。將影響可用性的case(具體事件)分成:開發因素和設計因素。開發因素包括系統bug、開發不規範、上線不規範、監控報警不及時(影響可用性的恢復時長)等由於具體開發者在設計階段覆蓋不到的階段發生的。設計因素包括機器故障、網絡中斷、異常流量、中間件故障等可以通過設計做容災的。結果95%以上的可用性問題都是開發因素造成的。編寫代碼的八榮八恥是對避免開發因素產生可用性問題的指導規範。


編程風格:以運用風格為榮,以隨意編碼為恥

引子

在工作中,經常發現有些程序員用面向對象的語言寫出了面向過程的代碼而自己並沒有感覺到:

前面提到有個java軟件工程師,叫Margaret。她對工作有三個要求:錢多、有趣、離家近。HR想針對這些要求和她具體溝通,問她最低標準是什麼。每一項最低要求回復一個星級。


星級

錢多

有趣

離家近

☆

1

年薪10萬

出差+旅遊占工時1%

40公里

☆☆

2

年薪20萬

出差+旅遊占工時10%

20公里

☆☆☆

3

年薪50萬

出差+旅遊占工時20%

10公里

☆☆☆☆

4

年薪100萬

出差+旅遊占工時50%

2公里

☆☆☆☆☆

5

年薪500萬

出差+旅遊占工時80%

1公里

Margaret在外地,所以用了一個常用的數據交換格式json給HR回復如下:

{"moreMoney”:4,"moreFun”:2,"closerToHome”:3}

拿到這個回復時面向過程的解析方式是這樣寫的:

Map json = (HashMap) JSONUtils.parse("{\"moreMoney\":4,\"moreFun\":2,\"closerToHome\":3}");
int moreMoney = (int)json.get("moreMoney");int moreFun = (int)json.get("moreFun");int closerToHome = (int)json.get("closerToHome");

接收方將接收到的數據轉成了json,代碼里一堆get完成了功能。為什麼說這是面向過程的呢?map是一種數據結構,沒有直接的業務意義。功能實現了,表達的意義卻不清晰。

這段代碼更好的一個實現方式是將接收的數據結構定義成一個對象,在java里可以使用jackson等工具直接將json轉成有業務含義的對象。

ObjectMapper objectMapper = new ObjectMapper();
Requirement requirement = objectMapper.readValue("{\"moreMoney\":4,\"moreFun\":2,\"closerToHome\":3}",JavaSoftwareEngineerMargaretRequirement.class);

這樣做,HR拿到的requirement不是一列列数字,需要自己對核對每一項都是什麼意思。而是一個有完整語義的對象,利於理解。而以這種思路來進行編寫的代碼我經常稱他們叫面向對象風格的代碼。

WHY

來看一段寫赤壁山旅行的文章:

今天有幸登上赤壁山,看到這山上的景物,不禁想起了當前戰場上廝殺的場面。想起當年要不是周瑜運氣好,大冬天颳起了東風,恐怕吳國就被曹操滅了。

再來看唐代詩人杜牧經過赤壁山這個著名的古戰場,有感於三國時代的英雄成敗而寫下的《赤壁》:

折戟沉沙鐵未銷,自將磨洗認前朝。

東風不與周郎便,銅雀春深鎖二喬。

前兩句意思是在沙子底下找到一隻斷戟,磨洗之後發現“made in 赤壁”。讀者讀了這兩句不禁會聯想起當前戰場上廝殺的場面吧。

后兩句意思是要不是周瑜運氣好,大冬天颳起了東風。那孫權的老婆大喬和周瑜的老婆小喬這兩位絕世美女都要被曹操這個色老頭關進銅雀台了。因為曹操久仰大小喬的美貌,提前為二人修築銅雀台,作為打敗吳國的戰利品。

杜牧隻字未提戰場和如果沒有東風的運氣,將會亡國的下場。但是讀者卻能心領神會,印象深刻。這是因為杜牧採用了以小見大的風格手法。

代碼與代碼的區別如同文章與文章的區別。能否讓讀者以更短的時間、更輕鬆的讀懂?代碼是給人整體感還是噁心感?這些都決定了代碼的可維護性。而它和系統可用性、穩定性的最直接關係在工作中非常常見:“爺爺的!這是誰寫的代碼這麼爛?忍不了了,老子不幹了。”而這個代碼的作者之所以離職也是因為忍受不了自己的爛代碼。頻繁的人員更替,新接手人員要有學習的成本。成本就包括要踩坑來加深對系統的理解。

HOW

除了開頭提到的面向對象的風格,編寫java代碼時下面三種風格也很常見。

1.fluent風格

fluent風格的代碼常以Builder結尾。比如StringBuilder就是典型的fluent風格。定義一個人的對象,這個對象使用fluent風格代碼這麼寫:

public class Person {    private String name;    private int armCount=2;//胳膊數默認為2 private int legCount=2;//腿數默認為2
    public static Person builder() {        return new Person.Builder(); }
    public Person setName(String name) {        this.name = name;        return this; }
    public Person armCount(int armCount) {        this.armCount = armCount;        return this; }
    public void legCount(int legCount) {        this.legCount = legCount;    }}

如上,就是每次給對象賦屬性的時候同時返回對象本身。這樣調用的時候:

Person.builder().name("Jane").armCount(2).legCount(2);

這樣寫的好處是比每個屬性都用一句set簡潔。在屬性多的時候,用構造函數。調用時容易表達不清楚屬性的含義。方法名起到了解釋的作用。現在流行的做法是代碼即註釋,註釋不用在每個方法都寫。這時候能表達自身意義的代碼就更加重要。注意:我們也可以保留setXXX、getXXX的命名規範,因為jackson等序列化反序列化的組件會根據set、get方法對參數賦值,上面的明明風格在序列化時會有問題。

當然,這個類也可以直接用lombok註解得到。

@Data@Buildrpublic class Person {    private String name;    private int armCount=2;//胳膊數默認為2    private int legCount=2;//腿數默認為2}

2.lambda函數式編程風格

lambda函數式編程比傳統的命令式編程更加簡潔。比如:現在有一群人。

List<Person> personList = Lists.newArrayList();
personList.add(Person.builder().name("Jane"));personList.add(Person.builder().name("Joe").armCount(1));personList.add(Person.builder().name("Stark").legCount(1));

要找出所有的殘疾人:

List<Person> disabledPersonList = Lists.newArrayList();for(Person person : personList) {    if(person.legCount()!=2 || person.armCount()!=2) {        disabledPersonList.add(person);    }}

或者使用lambda函數式編程:

List<Person> disabledPersonList = personList.stream().filter(person -> person.legCount()!=2 || person.armCount()!=2).collect(Collectors.toList());

3.設計模式風格

1995年,GoF(Gang of Four,四人幫)合作出版了《設計模式:可復用面向對象軟件的基礎》一書,共收錄了23中設計模式,人稱“GoF設計模式”。這23種設計模式的本質是面向對象設計原則的實際運用,是一種最佳實踐。

在各種java源碼中,經常看到以設計模式命名的類名和方法名。在我們日常編碼中,設計模式也非常實用。設計模式風格的例子請參考:平時代碼中用不到設計模式?Are you kidding me?

總結

寫有技術追求的代碼


相關閱讀

編寫代碼的「八榮八恥」- 以用戶易用為榮,以複雜歧義為恥

編寫代碼的「八榮八恥」- 以開關上線為榮,以自信編碼為恥

編寫代碼的「八榮八恥」(上篇)


【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

Python 爬蟲從入門到進階之路(四)

之前的文章我們做了一個簡單的例子爬取了百度首頁的 html,我們用到的是 urlopen 來打開請求,它是一個特殊的opener(也就是模塊幫我們構建好的)。但是基本的 urlopen() 方法不支持代理、cookie等其他的HTTP/HTTPS高級功能,所以我們需要用到 Python 的 opener 來自定義我們的請求內容。

具體步驟:

  1. 使用相關的 Handler處理器 來創建特定功能的處理器對象;
  2. 然後通過 build_opener()方法使用這些處理器對象,創建自定義opener對象;
  3. 使用自定義的opener對象,調用open()方法發送請求。

我們先來回顧一下使用 urlopen 獲取百度首頁的 html 代碼實例:

 1 # 導入urllib 庫
 2 import urllib.request
 3 
 4 # url 作為Request()方法的參數,構造並返回一個Request對象
 5 request = urllib.request.Request("http://www.baidu.com")
 6 # Request對象作為urlopen()方法的參數,發送給服務器並接收響應
 7 response = urllib.request.urlopen(request)
 8 # 類文件對象支持 文件對象的操作方法,如read()方法讀取文件全部內容,返回字符串
 9 html = response.read().decode("utf-8")
10 # 打印字符串
11 print(html)

接下來我們看一下使用 opener 的處理方式:

 1 from urllib import request
 2 
 3 # 構建一個HTTPHandler 處理器對象,支持處理HTTP請求
 4 http_handler = request.HTTPHandler()
 5 
 6 # 構建一個HTTPSHandler 處理器對象,支持處理HTTPS請求
 7 # http_handler = request.HTTPSHandler()
 8 
 9 # 調用 request.build_opener()方法,創建支持處理HTTP請求的opener對象
10 opener = request.build_opener(http_handler)
11 
12 # 構建 Request請求
13 request = request.Request("http://www.baidu.com/")
14 
15 # 調用自定義opener對象的open()方法,發送request請求
16 response = opener.open(request)
17 
18 # 獲取服務器響應內容
19 html = response.read().decode("utf-8")
20 
21 # 打印字符串
22 print(html)


在上面的第一段代碼中,我們是通過直接  import urllib.request   來導入我們需要的包,這樣當我們要使用時需要   urllib.request   來使用,第二段代碼我們是通過  from urllib import request  來導入我們需要的包,這樣當我們使用時直接  request 來使用就可以了。

第一段代碼在前面的文章中我們已經說過了,這裏就不多做解釋了。

第二段代碼中,我們使用了 opener 的方法來處理我們的請求,這樣我們就可以對代理,cookie 等做進一步的操作,後續文章會講到。最終結果如下:

在  http_handler = request.HTTPHandler() 中,我們還可以添加一個  debuglevel=1 參數,會將 Debug Log 打開,這樣程序在執行的時候,會把收包和發包的報頭在屏幕上自動打印出來,方便調試,有時可以省去抓包的工作。

代碼如下:

 1 from urllib import request
 2 
 3 # 構建一個HTTPHandler 處理器對象,支持處理HTTP請求
 4 http_handler = request.HTTPHandler(debuglevel=1)
 5 
 6 # 構建一個HTTPHandler 處理器對象,支持處理HTTPS請求
 7 # http_handler = request.HTTPSHandler(debuglevel=1)
 8 
 9 # 調用 request.build_opener()方法,創建支持處理HTTP請求的opener對象
10 opener = request.build_opener(http_handler)
11 
12 # 構建 Request請求
13 request = request.Request("http://www.baidu.com/")
14 
15 # 調用自定義opener對象的open()方法,發送request請求
16 response = opener.open(request)
17 
18 # 獲取服務器響應內容
19 html = response.read().decode("utf-8")
20 
21 # 打印字符串
22 print(html)

輸出結果如下:

可以看出在響應結果的時候會為我們打印輸出一些請求信息。


【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

C#規範整理·異常與自定義異常

這裡會列舉在C#中處理CLR異常方面的規範,幫助大家構建和開發一個運行良好和可靠的應用系統。

前言

  迄今為止,CLR異常機制讓人關注最多的一點就是“效率”問題。其實,這裏存在認識上的誤區,因為正常控制流程下的代碼運行並不會出現問題,只有引發異常時才會帶來效率問題。基於這一點,很多開發者已經達成共識:不應將異常機制用於正常控制流中。達成的另一個共識是:CLR異常機制帶來的“效率”問題不足以“抵消”它帶來的巨大收益。
CLR異常機制至少有以下幾個優點:

  • 正常控制流會被立即中止,無效值或狀態不會在系統中繼續傳播。
  • 提供了統一處理錯誤的方法。
  • 提供了在構造函數、操作符重載及屬性中報告異常的便利機制。
  • 提供了異常堆棧,便於開發者定位異常發生的位置。

  另外,“異常”其名稱本身就說明了它的發生是一個小概率事件。所以,因異常帶來的效率問題會被限制在一個很小的範圍內。實際上,try catch所帶來的效率問題幾乎是可以忽略的。在某些特定的場合,如Int32的Parse方法中,確實存在着因為濫用而導致的效率問題。在這種情況下,我們就應該考慮提供一個TryParse方法,從設計的角度讓用戶選擇讓程序運行得更快。另一種規避因為異常而影響效率的方法是:Tester-doer模式

正文

1.用拋出異常代替返回錯誤代碼

在異常機制出現之前,應用程序普遍採用返回錯誤代碼的方式來通知調用者發生了異常。本建議首先闡述為什麼要用拋出異常的方式來代替返回錯誤代碼的方式。對於一個成員方法而言,它要麼執行成功,要麼執行失敗。成員方法執行成功的情況很容易理解,但是如果執行失敗了卻沒有那麼簡單,因為我們需要將導致執行失敗的原因通知調用者。拋出異常和返回錯誤代碼都是用來通知調用者的手段。

但是當我們想要告訴調用者更多細節的時候,就需要與調用者約定更多的錯誤代碼。於是我們很快就會發現,錯誤代碼飛速膨脹,直到看起來似乎無法維護,因為我們總在查找並確認錯誤代碼。
在沒有異常處理機制之前,我們只能返回錯誤代碼。但是,現在有了另一種選擇,即使用異常機制。如果使用異常機制,那麼最終的代碼看起來應該是下面這樣的:

static void Main(string[]args)
{    
try  
    {   
     SaveUser(user); 
    }    
catch(IOException)   
    {       
    //IO異常,通知當前用戶 
    }    
catch(UnauthorizedAccessException)
    {       
    //權限失敗,通知客戶端管理員  
    }    
catch(CommunicationException) 
    {        
   //網絡異常,通知發送E-mail給網絡管理員  
    }
}

private static void SaveUser(User user)
{   
  SaveToFile(user); 
  SaveToDataBase(user);
}

使用CLR異常機制后,我們會發現代碼變得更清晰、更易於理解了。至於效率問題,還可以重新審視“效率”的立足點:throw exception產生的那點效率損耗與等待網絡連接異常相比,簡直微不足道,而CLR異常機制帶來的好處卻是顯而易見的。

這裏需要稍加強調的是,在catch(CommunicationExcep-tion)這個代碼塊中,代碼所完成的功能是“通知發送”而不是“發送”本身,因為我們要確保在catch和finally中所執行的代碼是可以被執行的。換句話說,盡量不要在catch和finally中再讓代碼“出錯”,那會讓異常堆棧信息變得複雜和難以理解。

在本例的catch代碼塊中,不要真的編寫發送郵件的代碼,因為發送郵件這個行為可能會產生更多的異常,而“通知發送”這個行為穩定性更高(即不“出錯”)。

以上通過實際的案例闡述了拋出異常相比於返回錯誤代碼的優越性,以及在某些情況下錯誤代碼將無用武之地,如構造函數、操作符重載及屬性。語法特性決定了其不能具備任何返回值,於是異常機制被當做取代錯誤代碼的首要選擇。

2.不要在不恰當的場合下引發異常

程序員,尤其是類庫開發人員,要掌握的兩條首要原則是:
正常的業務流程不應使用異常來處理。
不要總是嘗試去捕獲異常或引發異常,而應該允許異常向調用堆棧往上傳播。
那麼,到底應該在怎樣的情況下引發異常呢?

第一類情況 如果運行代碼後會造成內存泄漏、資源不可用,或者應用程序狀態不可恢復,則應該引發異常。
在微軟提供的Console類中有很多類似這樣的代碼:

if((value<1)||(value>100))
{    
    throw new ArgumentOutOfRangeException("value",value, Environment.GetResourceString("ArgumentOutOfRange_CursorSize"));
}

或者:

if(value==null)
{    
  throw new ArgumentNullException("value");
}

在開頭首先提到的就是:對在可控範圍內的輸入和輸出不引發異常。沒錯,區別就在於“可控”這兩個字。所謂“可控”,可定義為:發生異常后,系統資源仍可用,或資源狀態可恢復。

第二類情況 在捕獲異常的時候,如果需要包裝一些更有用的信息,則引發異常。
這類異常的引發在UI層特別有用。系統引發的異常所帶的信息往往更傾向於技術性的描述;而在UI層,面對異常的很可能是最終用戶。如果需要將異常的信息呈現給最終用戶,更好的做法是先包裝異常,然後引發一個包含友好信息的新異常。

第三類情況 如果底層異常在高層操作的上下文中沒有意義,則可以考慮捕獲這些底層異常,並引發新的有意義的異常。
例如在下面的代碼中,如果拋出InvalidCastException,則沒有任何意義,甚至會造成誤解,所以更好的方式是拋出一個ArgumentException:

private void CaseSample(object o)
{  
  if(o==null)    
  {        
   throw new ArgumentNullException("o");   
  }
}   
 
User user=null;   
try  
{   
   user=(User)o; 
}    
catch(InvalidCastException)
{    
   throw new ArgumentException("輸入參數不是一個User","o"); 
}  

//do something}

需要重點介紹的正確引發異常的典型例子就是捕獲底層API錯誤代碼,並拋出。查看Console這個類,還會發現很多地方有類似的代碼:

int errorCode=Marshal.GetLastWin32Error();
if(errorCode==6)
{   
  throw new InvalidOperationException(Environment.GetResourceString("InvalidOperation_ConsoleKeyAvailableOnFile"));
}

Console為我們封裝了調用Windows API返回的錯誤代碼,而讓代碼引發了一個新的異常。

很顯然,當需要調用Windows API或第三方API提供的接口時,如果對方的異常報告機制使用的是錯誤代碼,最好重新引發該接口提供的錯誤,因為你需要讓自己的團隊更好地理解這些錯誤。

3.重新引發異常時使用Inner Exception

當捕獲了某個異常,將其包裝或重新引發異常的時候,如果其中包含了Inner Exception,則有助於程序員分析內部信息,方便代碼調試。
以一個分佈式系統為例,在進行遠程通信的時候,可能會發生的情況有:
1)網卡被禁用或網線斷開,此時會拋出SocketException,消息為:“由於目標計算機積極拒絕,無法連接。”
2)網絡正常,但是要連接的目標機沒有端口沒有處在偵聽狀態,此時,會拋出SocketException,消息為:“由於連接方在一段時間后沒有正確答覆或連接的主機沒有反應,連接嘗試失敗。”
3)連接超時,此時需要通過代碼實現關閉連接,並拋出一個SocketException,消息為:“連接超過約定的時長。”
發生以上三種情況中的任何一種情況,在返回給最終用戶的時候,我們都需要將異常信息包裝成為“網絡連接失敗,請稍候再試”。

所以,一個分佈式系統的業務處理方法,看起來應該是這樣的:

try
{    
SaveUser5(user);
}
catch(SocketException err)
{  
  throw new CommucationFailureException("網絡連接失敗,請稍後再試",err);
}

但是,在提示這條消息的時候,我們可能需要將原始異常信息記錄到日誌里,以供開發者分析具體的原因(因為如果這種情況頻繁出現,這有可能是一個Bug)。那麼,在記錄日誌的時候,就非常有必要記錄導致此異常出現的內部異常或是堆棧信息。
上文代碼中的:就是將異常重新包裝成為一個CommucationFailureException,並將SocketException作為Inner Exception(即err)向上傳遞。

此外還有一個可以採用的技巧,如果不打算使用Inner Exception,但是仍然想要返回一些額外信息的話,可以使用Exception的Data屬性。如下所示:

try
{   
 SaveUser5(user);
}
catch(SocketException err)
{    
 err.Data.Add("SocketInfo","網絡連接失敗,請稍後再試");   
 throw err;
}

在上層進行捕獲的時候,可以通過鍵值來得到異常信息:

catch(SocketException err)
{   
 Console.WriteLine(err.Data["SocketInfo"].ToString());
}

4.避免在finally內撰寫無效代碼

你應該始終認為finally內的代碼會在方法return之前執行,哪怕return是在try塊中。
C#編譯器會清理那些它認為完全沒有意義的C#代碼。

private static int TestIntReturnInTry()
{   
  int i;    
  try    
  {        
    return i=1;  
  } 
  
finally   
 {        
    i=2;      
   Console.WriteLine("\t將int結果改為2,finally執行完畢");   
 }
}

5.避免嵌套異常

應該允許異常在調用堆棧中往上傳播,不要過多使用catch,然後再throw。過多使用catch會帶來兩個問題:

  • 代碼更多了。這看上去好像你根本不知道該怎麼處理異常,所以你總在不停地catch。
  • 隱藏了堆棧信息,使你不知道真正發生異常的地方。

嵌套異常會導致 調用堆棧被重置了。最糟糕的情況是:如果方法捕獲的是Exception。所以也就是說,如果這個方法中還存在另外的異常,在UI層將永遠不知道真正發生錯誤的地方。
除了第3點提到的需要包裝異常的情況外,無故地嵌套異常是我們要極力避免的。當然,如果真的需要捕獲這個異常來恢復一些狀態,然後重新拋出,代碼看起來應該是這樣的:

try{ 
  MethodTry();
}
catch(Exception)
{ 
   //工作代碼   
 throw;
}

或者:

try
{    
 MethodTry();
}
catch
{    
  //工作代碼 
   throw;
}

盡量避免像下面這樣引發異常:

catch(Exception err)
{   
 //工作代碼  
  throw err;
}

直接throw err而不是throw將會重置堆棧信息。

6.避免“吃掉”異常

嵌套異常是很危險的行為,一不小心就會將異常堆棧信息,也就是真正的Bug出處隱藏起來。但這還不是最嚴重的行為,最嚴重的就是“吃掉”異常,即捕獲,然後不向上層throw拋出。如果你不知道如何處理某個異常,那麼千萬不要“吃掉”異常,如果你一不小心“吃掉”了一個本該往上傳遞的異常,那麼,這裏可能誕生一個Bug,而且,解決它會很費周折。

避免“吃掉”異常,並不是說不應該“吃掉”異常,而是這裏面有個重要原則:該異常可被預見,並且通常情況它不能算是一個Bug。 比如有些場景存在你可以預見的但不重要的Exception,這個就不算一個bug。

7.為循環增加Tester-Doer模式而不是將try-catch置於循環內

如果需要在循環中引發異常,你需要特別注意,因為拋出異常是一個相當影響性能的過程。應該盡量在循環當中對異常發生的一些條件進行判斷,然後根據條件進行處理。

8.總是處理未捕獲的異常

處理未捕獲的異常是每個應用程序應具備的基本功能,C#在AppDomain提供了UnhandledException事件來接收未捕獲到的異常的通知。常見的應用如下:

static void Main(string[]args)
{    
  AppDomain.CurrentDomain.UnhandledException+=new  UnhandledExceptionEventHandler(CurrentDomain_UnhandledException);
}

static void CurrentDomain_UnhandledException(object sender, UnhandledExceptionEventArgs e)
{    
  Exception error=(Exception)e.ExceptionObject;   
 Console.WriteLine("MyHandler caught:"+error.Message);
}

未捕獲的異常通常就是運行時期的Bug,我們可以在App-Domain.CurrentDomain.UnhandledException的註冊事件方法CurrentDomain_UnhandledException中,將未捕獲異常的信息記錄在日誌中。值得注意的是,UnhandledException提供的機制並不能阻止應用程序終止,也就是說,執行CurrentDomain_UnhandledException方法后,應用程序就會被終止。

9.正確捕獲多線程中的異常

多線程的異常處理需要採用特殊的方法。以下的處理方式會存在問題:

try{  
  Thread t=new Thread((ThreadStart)delegate    
{        
  throw new Exception("多線程異常");    
});   

 t.Start();
}

catch(Exception error)
{ 
   MessageBox.Show(error.Message+Environment.NewLine+error.StackTrace);
}

應用程序並不會在這裏捕獲線程t中的異常,而是會直接退出。從.NET 2.0開始,任何線程上未處理的異常,都會導致應用程序的退出(先會觸發AppDomain的UnhandledException)。上面代碼中的try-catch實際上捕獲的還是當前線程的異常,而t屬於新起的異常,所以,正確的做法應該是把 try-catch放在線程裏面

Thread t=new Thread((ThreadStart)delegate
{    
try   
 {      
  throw new Exception("多線程異常");   
 }    
catch(Exception error)   {  ....   });

t.Start();

10.慎用自定義異常

除非有充分的理由,否則一般不要創建自定義異常。如果要對某類程序出錯信息做特殊處理,那就自定義異常。需要自定義異常的理由如下:
1)方便調試。通過拋出一個自定義的異常類型實例,我們可以使捕獲代碼精確地知道所發生的事情,並以合適的方式進行恢復。
2)邏輯包裝。自定義異常可包裝多個其他異常,然後拋出一個業務異常。
3)方便調用者編碼。在編寫自己的類庫或者業務層代碼的時候,自定義異常可以讓調用方更方便處理業務異常邏輯。例如,保存數據失敗可以分成兩個異常“數據庫連接失敗”和“網絡異常”。
4)引入新異常類。這使程序員能夠根據異常類在代碼中採取不同的操作。

11.從System.Exception或其他常見的基本異常中派生異常

這個不說了,自定義異常一般是從System.Exception派生。。事實上,現在如果你在Visual Studio中輸入Exception,然後使用快捷鍵Tab,VS會自動創建一個自定義異常類。

12.應使用finally避免資源泄漏

前面已經提到過,除非發生讓應用程序中斷的異常,否則finally總是會先於return執行。finally的這個語言特性決定了資源釋放的最佳位置就是在finally塊中;另外,資源釋放會隨着調用堆棧由下往上執行(即由內到外釋放)。

13.避免在調用棧較低的位置記錄異常

即避免在內部深處處理記錄異常。最適合記錄異常和報告的是應用程序的最上層,這通常是UI層。
並不是所有的異常都要被記錄到日誌,一類情況是異常發生的場景需要被記錄,還有一類就是未被捕獲的異常。未被捕獲的異常通常被視為一個Bug,所以,對於它的記錄,應該被視為系統的一個重要組成部分。

如果異常在調用棧較低的位置被記錄或報告,並且又被包裝后拋出;然後在調用棧較高位置也捕獲記錄異常。這就會讓記錄重複出現。在調用棧較低的情況下,往往異常被捕獲了也不能被完整的處理。所以,綜合考慮,應用程序在設計初期,就應該為開發成員約定在何處記錄和報告異常。

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!