一次線上Redis類轉換異常排查引發的思考

之前同事反饋說線上遇到Redis反序列化異常問題,異常如下:

XxxClass1 cannot be cast to XxxClass2

已知信息如下:

  • 該異常不是必現的,偶爾才會出現;
  • 出現該異常后重啟應用或者過一會就好了;
  • 序列化協議使用了hessian。

因為偶爾出現,首先看了報異常那塊業務邏輯是不是有問題,看了一遍也發現什麼問題。看了下對應日誌,發現是在Redis讀超時之後才出現的該異常,因此懷疑redis client操作邏輯那塊導致的(公司架構組對redis做了一層封裝),發現獲取/釋放redis連接如下代碼:

 1 try {
 2     jedis = jedisPool.getResource();
 3     // jedis業務讀寫操作
 4 } catch (Exception e) {
 5     // 異常處理
 6 } finally {
 7     if (jedis != null) {
 8         // 歸還給連接池
 9         jedisPool.returnResourceObject(jedis);
10     }
11 }

初步認定原因為:發生了讀寫超時的連接,直接歸還給連接池,下次使用該連接時讀取到了上一次Redis返回的數據。因此本地驗證下,示例代碼如下:

 1 @Data
 2 @NoArgsConstructor
 3 @AllArgsConstructor
 4 static class Person implements Serializable {
 5     private String name;
 6     private int age;
 7 }
 8 @Data
 9 @NoArgsConstructor
10 @AllArgsConstructor
11 static class Dog implements Serializable {
12     private String name;
13 }
14 
15 public static void main(String[] args) throws Exception {
16     JedisPoolConfig config = new JedisPoolConfig();
17     config.setMaxTotal(1);
18     JedisPool jedisPool = new JedisPool(config, "192.168.193.133", 6379, 2000, "123456");
19 
20     Jedis jedis = jedisPool.getResource();
21     jedis.set("key1".getBytes(), serialize(new Person("luoxn28", 26)));
22     jedis.set("key2".getBytes(), serialize(new Dog("tom")));
23     jedisPool.returnResourceObject(jedis);
24 
25     try {
26         jedis = jedisPool.getResource();
27         Person person = deserialize(jedis.get("key1".getBytes()), Person.class);
28         System.out.println(person);
29     } catch (Exception e) {
30         // 發生了異常之後,未對該連接做任何處理
31         System.out.println(e.getMessage());
32     } finally {
33         if (jedis != null) {
34             jedisPool.returnResourceObject(jedis);
35         }
36     }
37 
38     try {
39         jedis = jedisPool.getResource();
40         Dog dog = deserialize(jedis.get("key2".getBytes()), Dog.class);
41         System.out.println(dog);
42     } catch (Exception e) {
43         System.out.println(e.getMessage());
44     } finally {
45         if (jedis != null) {
46             jedisPool.returnResourceObject(jedis);
47         }
48     }
49 }

連接超時時間設置2000ms,為了方便測試,可以在redis服務器上使用gdb命令斷住redis進程(如果redis部署在Linux系統上的話,還可以使用iptable命令在防火牆禁止某個回包),比如在執行 jedis.get("key1".getBytes() 代碼前,對redis進程使用gdb命令斷住,那麼就會導致讀取超時,然後就會觸發如下異常:

Person cannot be cast to Dog

既然已經知道了該問題原因並且本地復現了該問題,對應解決方案是,在發生異常時歸還給連接池時關閉該連接即可(jedis.close內部已經做了判斷),代碼如下:

 1 try {
 2     jedis = jedisPool.getResource();
 3     // jedis業務讀寫操作
 4 } catch (Exception e) {
 5     // 異常處理
 6 } finally {
 7     if (jedis != null) {
 8         // 歸還給連接池
 9         jedis.close();
10     }
11 }

至此,該問題解決。注意,因為使用了hessian序列化(其包含了類型信息,類似的有Java本身序列化機制),所有會報類轉換異常;如果使用了json序列化(其只包含對象屬性信息),反序列化時不會報異常,只不過因為不同類的屬性不同,會導致反序列化后的對象屬性為空或者屬性值混亂,使用時會導致問題,並且這種問題因為沒有報異常所以更不容易發現。


既然說到了Redis的連接,要知道的是,Redis基於RESP(Redis Serialization Protocol)協議來通信,並且通信方式是停等方式,也就說一次通信獨佔一個連接直到client讀取到返回結果之後才能釋放該連接讓其他線程使用。小夥伴們可以思考一下,Redis通信能否像dubbo那樣使用單連接+序列號(標識單次通信)通信方式呢?理論上是可以的,不過由於RESP協議中並沒有一個”序列號”的字段,所以直接靠原生的通信方法來實現是不現實的。不過我們可以通過echo命令傳遞並返回”序列號”+正常的讀寫方式來實現,這裏要保證二者執行的原子性,可以通過lua腳本或者事務來實現,事務方式如下:

MULTI
ECHO "唯一序列號"
GET key1
EXEC

然後客戶端收到的結果是一個 [ "唯一序列號", "value1" ]的列表,你可以根據前一項識別出這是你發送的哪個請求。

為什麼Redis通信方式並沒有採用類似於dubbo這種通信方式呢,個人認為有以下幾點:

  • 使用停等這種通信方式實現簡單,並且協議字段盡可能緊湊;
  • Redis都是內存操作,處理性能較強,停等協議不會造成客戶端等待時間較長;
  • 目前來看,通信方式這塊不是Redis使用上的性能瓶頸,這一點很重要。


推薦閱讀:

  • 別再問我ConcurrentHashMap了
  • 分佈式鎖設計與實現

  • ConcurrentHashMap竟然也有死循環問題?

  • 你的ThreadLocal線程安全么

 歡迎小夥伴掃描以下二維碼閱讀更多精彩好文。


【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

高級Java工程師必備 —– 深入分析 Java IO (一)BIO

BIO編程

最原始BIO

網絡編程的基本模型是C/S模型,即兩個進程間的通信。

服務端提供IP和監聽端口,客戶端通過連接操作想服務端監聽的地址發起連接請求,通過三次握手連接,如果連接成功建立,雙方就可以通過套接字進行通信。

傳統的同步阻塞模型開發中,ServerSocket負責綁定IP地址,啟動監聽端口;Socket負責發起連接操作。連接成功后,雙方通過輸入和輸出流進行同步阻塞式通信。
最原始BIO通信模型圖:

存在的問題:

  • 同一時間,服務器只能接受來自於客戶端A的請求信息;雖然客戶端A和客戶端B的請求是同時進行的,但客戶端B發送的請求信息只能等到服務器接受完A的請求數據后,才能被接受。(acceptor只有在接受完client1的請求后才能接受client2的請求)
  • 由於服務器一次只能處理一個客戶端請求,當處理完成並返回后(或者異常時),才能進行第二次請求的處理。很顯然,這樣的處理方式在高併發的情況下,是不能採用的。

一請求一線程BIO

那有沒有方法改進呢? ,答案是有的。改進后BIO通信模型圖:

此種BIO通信模型的服務端,通常由一個獨立的Acceptor線程負責監聽客戶端的連接,它接收到客戶端連接請求之後為每個客戶端創建一個新的線程進行鏈路處理沒處理完成后,通過輸出流返回應答給客戶端,線程銷毀。即典型的一請求一應答通宵模型。

代碼演示

服務端:

package demo.com.test.io.bio;

import java.io.IOException;
import java.io.InputStream;
import java.io.OutputStream;
import java.net.ServerSocket;
import java.net.Socket;

import demo.com.test.io.nio.NioSocketServer;

public class BioSocketServer {
   //默認的端口號  
   private static int DEFAULT_PORT = 8083;  

   public static void main(String[] args) {
       ServerSocket serverSocket = null;
       try {
           System.out.println("監聽來自於"+DEFAULT_PORT+"的端口信息");
           serverSocket = new ServerSocket(DEFAULT_PORT);
           while(true) {
               Socket socket = serverSocket.accept();
               SocketServerThread socketServerThread = new SocketServerThread(socket);
               new Thread(socketServerThread).start();
           }
       } catch(Exception e) {

       } finally {
           if(serverSocket != null) {
               try {
                   serverSocket.close();
               } catch (IOException e) {
                   // TODO Auto-generated catch block
                   e.printStackTrace();
               }
           }
       }

        //這個wait不涉及到具體的實驗邏輯,只是為了保證守護線程在啟動所有線程后,進入等待狀態
       synchronized (NioSocketServer.class) {
           try {
               BioSocketServer.class.wait();
           } catch (InterruptedException e) {
               // TODO Auto-generated catch block
               e.printStackTrace();
           }
       }
   }
}  

class SocketServerThread implements Runnable {
   private Socket socket;
   public SocketServerThread (Socket socket) {
       this.socket = socket;
   }
   @Override
   public void run() {
       InputStream in = null;
       OutputStream out = null;
       try {
           //下面我們收取信息
           in = socket.getInputStream();
           out = socket.getOutputStream();
           Integer sourcePort = socket.getPort();
           int maxLen = 1024;
           byte[] contextBytes = new byte[maxLen];
           //使用線程,同樣無法解決read方法的阻塞問題,
           //也就是說read方法處同樣會被阻塞,直到操作系統有數據準備好
           int realLen = in.read(contextBytes, 0, maxLen);
           //讀取信息
           String message = new String(contextBytes , 0 , realLen);

           //下面打印信息
           System.out.println("服務器收到來自於端口:" + sourcePort + "的信息:" + message);

           //下面開始發送信息
           out.write("回發響應信息!".getBytes());
       } catch(Exception e) {
           System.out.println(e.getMessage());
       } finally {
           //試圖關閉
           try {
               if(in != null) {
                   in.close();
               }
               if(out != null) {
                   out.close();
               }
               if(this.socket != null) {
                   this.socket.close();
               }
           } catch (IOException e) {
               System.out.println(e.getMessage());
           }
       }
   }
}

客戶端:

package demo.com.test.io.bio;

import java.io.IOException;
import java.io.InputStream;
import java.io.OutputStream;
import java.net.Socket;
import java.net.URLDecoder;
import java.util.concurrent.CountDownLatch;

public class BioSocketClient{
   public static void main(String[] args) throws Exception {
       Integer clientNumber = 20;
       CountDownLatch countDownLatch = new CountDownLatch(clientNumber);

       // 分別開始啟動這20個客戶端,併發訪問
       for (int index = 0; index < clientNumber; index++, countDownLatch.countDown()) {
           ClientRequestThread client = new ClientRequestThread(countDownLatch, index);
           new Thread(client).start();
       }

       // 這個wait不涉及到具體的實驗邏輯,只是為了保證守護線程在啟動所有線程后,進入等待狀態
       synchronized (BioSocketClient.class) {
           BioSocketClient.class.wait();
       }
   }
}


/**
* 一個ClientRequestThread線程模擬一個客戶端請求。
* @author keep_trying
*/
class ClientRequestThread implements Runnable {


   private CountDownLatch countDownLatch;

   /**
    * 這個線程的編號
    * @param countDownLatch
    */
   private Integer clientIndex;

   /**
    * countDownLatch是java提供的同步計數器。
    * 當計數器數值減為0時,所有受其影響而等待的線程將會被激活。這樣保證模擬併發請求的真實性
    * @param countDownLatch
    */
   public ClientRequestThread(CountDownLatch countDownLatch , Integer clientIndex) {
       this.countDownLatch = countDownLatch;
       this.clientIndex = clientIndex;
   }

   @Override
   public void run() {
       Socket socket = null;
       OutputStream clientRequest = null;
       InputStream clientResponse = null;

       try {
           socket = new Socket("localhost",8083);
           clientRequest = socket.getOutputStream();
           clientResponse = socket.getInputStream();

           //等待,直到SocketClientDaemon完成所有線程的啟動,然後所有線程一起發送請求
           this.countDownLatch.await();

           //發送請求信息
           clientRequest.write(("這是第" + this.clientIndex + " 個客戶端的請求。 over").getBytes());
           clientRequest.flush();

           //在這裏等待,直到服務器返回信息
          System.out.println("第" + this.clientIndex + "個客戶端的請求發送完成,等待服務器返回信息");
           int maxLen = 1024;
           byte[] contextBytes = new byte[maxLen];
           int realLen;
           String message = "";
           //程序執行到這裏,會一直等待服務器返回信息(注意,前提是in和out都不能close,如果close了就收不到服務器的反饋了)
           while((realLen = clientResponse.read(contextBytes, 0, maxLen)) != -1) {
               message += new String(contextBytes , 0 , realLen);
           }
           //String messageEncode = new String(message , "UTF-8");
           message = URLDecoder.decode(message, "UTF-8");
           System.out.println("第" + this.clientIndex + "個客戶端接收到來自服務器的信息:" + message);
       } catch (Exception e) {

       } finally {
           try {
               if(clientRequest != null) {
                   clientRequest.close();
               }
               if(clientResponse != null) {
                   clientResponse.close();
               }
           } catch (IOException e) {

           }
       }
   }
}   

存在的問題:

  • 雖然在服務器端,請求的處理交給了一個獨立線程進行,但是操作系統通知accept()的方式還是單個的。也就是,實際上是服務器接收到數據報文後的“業務處理過程”可以多線程,但是數據報文的接受還是需要一個一個的來(acceptor只有在接受完client1的請求后才能接受client2的請求),下文會驗證。
  • 在linux系統中,可以創建的線程是有限的。我們可以通過cat /proc/sys/kernel/threads-max命令查看可以創建的最大線程數。當然這個值是可以更改的,但是線程越多,CPU切換所需的時間也就越長,用來處理真正業務的需求也就越少。
  • 另外,如果您的應用程序大量使用長連接的話,線程是不會關閉的。這樣系統資源的消耗更容易失控。

偽異步I/O編程

為了改進這種一連接一線程的模型,我們可以使用線程池來管理這些線程,實現1個或多個線程處理N個客戶端的模型(但是底層還是使用的同步阻塞I/O),通常被稱為“偽異步I/O模型“。

偽異步I/O模型圖:

代碼演示

只給出服務端,客戶端和上面相同

package demo.com.test.io.bio;

import java.io.IOException;
import java.io.InputStream;
import java.io.OutputStream;
import java.net.ServerSocket;
import java.net.Socket;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

import demo.com.test.io.nio.NioSocketServer;

public class BioSocketServerThreadPool {
   //默認的端口號  
   private static int DEFAULT_PORT = 8083;  
   //線程池 懶漢式的單例  
   private static ExecutorService executorService = Executors.newFixedThreadPool(60);  

   public static void main(String[] args) {
       ServerSocket serverSocket = null;
       try {
           System.out.println("監聽來自於"+DEFAULT_PORT+"的端口信息");
           serverSocket = new ServerSocket(DEFAULT_PORT);
           while(true) {
               Socket socket = serverSocket.accept();
               //當然業務處理過程可以交給一個線程(這裏可以使用線程池),並且線程的創建是很耗資源的。
               //最終改變不了.accept()只能一個一個接受socket的情況,並且被阻塞的情況
               SocketServerThreadPool socketServerThreadPool = new SocketServerThreadPool(socket);
               executorService.execute(socketServerThreadPool);
           }
       } catch(Exception e) {

       } finally {
           if(serverSocket != null) {
               try {
                   serverSocket.close();
               } catch (IOException e) {
                   // TODO Auto-generated catch block
                   e.printStackTrace();
               }
           }
       }

        //這個wait不涉及到具體的實驗邏輯,只是為了保證守護線程在啟動所有線程后,進入等待狀態
       synchronized (NioSocketServer.class) {
           try {
               BioSocketServerThreadPool.class.wait();
           } catch (InterruptedException e) {
               // TODO Auto-generated catch block
               e.printStackTrace();
           }
       }
   }
}  

class SocketServerThreadPool implements Runnable {
   private Socket socket;
   public SocketServerThreadPool (Socket socket) {
       this.socket = socket;
   }
   @Override
   public void run() {
       InputStream in = null;
       OutputStream out = null;
       try {
           //下面我們收取信息
           in = socket.getInputStream();
           out = socket.getOutputStream();
           Integer sourcePort = socket.getPort();
           int maxLen = 1024;
           byte[] contextBytes = new byte[maxLen];
           //使用線程,同樣無法解決read方法的阻塞問題,
           //也就是說read方法處同樣會被阻塞,直到操作系統有數據準備好
           int realLen = in.read(contextBytes, 0, maxLen);
           //讀取信息
           String message = new String(contextBytes , 0 , realLen);

           //下面打印信息
           System.out.println("服務器收到來自於端口:" + sourcePort + "的信息:" + message);

           //下面開始發送信息
           out.write("回發響應信息!".getBytes());
       } catch(Exception e) {
           System.out.println(e.getMessage());
       } finally {
           //試圖關閉
           try {
               if(in != null) {
                   in.close();
               }
               if(out != null) {
                   out.close();
               }
               if(this.socket != null) {
                   this.socket.close();
               }
           } catch (IOException e) {
               System.out.println(e.getMessage());
           }
       }
   }
}

服務器端的執行效果

在 Socket socket = serverSocket.accept(); 處打了斷點,有20個客戶端同時發出請求,可服務端還是一個一個的處理,其它線程都處於阻塞狀態

推薦博客

  程序員寫代碼之外,如何再賺一份工資?

阻塞的問題根源

 那麼重點的問題並不是“是否使用了多線程、或是線程池”,而是為什麼accept()、read()方法會被阻塞。API文檔中對於 serverSocket.accept() 方法的使用描述:

Listens for a connection to be made to this socket and accepts it. The method blocks until a connection is made.

服務器線程發起一個accept動作,詢問操作系統 是否有新的socket套接字信息從端口xx發送過來。

注意,是詢問操作系統。也就是說socket套接字的IO模式支持是基於操作系統的,那麼自然同步IO/異步IO的支持就是需要操作系統級別的了。如下圖:

 如果操作系統沒有發現有套接字從指定的端口xx來,那麼操作系統就會等待。這樣serverSocket.accept()方法就會一直等待。這就是為什麼accept()方法為什麼會阻塞:它內部的實現是使用的操作系統級別的同步IO。

  • 阻塞IO 和 非阻塞IO
    這兩個概念是程序級別的。主要描述的是程序請求操作系統IO操作后,如果IO資源沒有準備好,那麼程序該如何處理的問題:前者等待;後者繼續執行(並且使用線程一直輪詢,直到有IO資源準備好了)
  • 同步IO 和非同步IO
    這兩個概念是操作系統級別的。主要描述的是操作系統在收到程序請求IO操作后,如果IO資源沒有準備好,該如何處理相應程序的問題:前者不響應,直到IO資源準備好以後;後者返回一個標記(好讓程序和自己知道以後的數據往哪裡通知),當IO資源準備好以後,再用事件機制返回給程序。

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

集成學習總結

1 基本概念

  • 集成學習的主要思路是先通過一定的規則生成多個學習器,再採用某種集成策略進行組合,最後綜合判斷輸出最終結果。一般而言,通常所說的集成學習中的多個學習器都是同質的”弱學習器”。基於該弱學習器,通過樣本集擾動、輸入特徵擾動、輸出表示擾動、算法參數擾動等方式生成多個學習器,進行集成后獲得一個精度較好的”強學習器”。
  • 目前集成學習算法大多源於bagging、boosting、stacking三種思想。

2 bagging

  • 一種提高分類模型的方法。
    • (1) 從訓練集\(S\)中有放回的隨機選取數據集\(M\)\((∣M∣ < ∣S∣)\);
    • (2) 生成一個分類模型\(C\);
    • (3) 重複以上步驟\(m\)次,得到\(m\)個分類模型\(C_1,C_2,…,C_m\);
    • (4)對於分類問題,每一個模型投票決定,少數服從多數原則;
    • (5)對於回歸問題,取平均值。
  • 注意:這種抽樣的方式會導致有的樣本取不到,大約有\(\lim_{n \to \infty}(1-\frac{1}{n})^n\) = \(36.8%\)的樣本取不到,這部分可用來做測試集。

  • 優點: 通過減少方差來提高預測結果。
  • 缺點: 失去了模型的簡單性。

2.1 Random Forest

  • 是一種基於樹模型的bagging算法改進的模型。假定數據集中有\(M\)個特徵和 \(N\)個觀測值。每一個樹有放回的隨機抽出\(N\)個觀測值\(m\)(\(m=M\)或者\(m=logM\))個特徵。把每一個單一決策樹的結果綜合起來。

  • 優點:
    • (1) 減少了模型方差,提高了預測準確性。
    • (2) 不需要給樹做剪枝。
    • (3) 在大規模數據集,尤其是特徵較多的情況下,依然可以保持高效率。
    • (4) 不用做特徵選擇,並且可以給出特徵變量重要性的排序估計。
  • 缺點:
    • (1) 隨機森林已經被證明在某些噪音較大的分類或回歸問題上會過擬合
    • (2) 對於有不同取值的屬性的數據,取值劃分較多的屬性會對隨機森林產生更大的影響,所以隨機森林在這種數據上產出的屬性權值是不可信的。

3 boosting

  • 每一輪根據上一輪的分類結果動態調整每個樣本在分類器中的權重,訓練得到k個弱分類器,他們都有各自的權重,通過加權組合的方式得到最終的分類結果(綜合所有的基模型預測結果)。主要算法有AdaBoost/GBDT/Xgboost/LightGBM。

3.1 Adboost

  • 給定數據集\(S\),它包含\(n\)個元組\((X_1,y_1),(X_2,y_2),…,(X_n,y_n)(X_1,y_1), (X_2,y_2), …, (X_n,y_n)\),其中\(y_i\)是數據對象\(X_i\)的類標號。
  • (1) 開始時,Adaboost對每個訓練元組賦予相等的權重\(1/n\)。組合分類器包含\(T\)個基本分類器。
  • (2) 針對第\(t\)個分類器\(M_t\):
    • 首先,從S中的元組進行抽樣,形成大小為\(n\)的訓練集\(S_t\),此處抽樣方式為有放回的抽樣,抽樣過程中,每個元組被選中的機會由它的權重決定;
    • 然後,根據\(S_t\)導出(訓練出)分類器\(M_t\),使用\(S_t\)檢驗分類器\(M_t\)的分類誤差,並計算該分類器的“表決權”的權重;
    • 最後,訓練元組的權重根據分類器\(M_t\)的分類情況調整。
    • 如果元組被錯誤分類,則它的權重增加。
    • 如果元組被正確分類,則它的權重減少。
    • 元組的權重反映元組被分類的困難程度——權重越高,被錯誤分類的可能性越高。然後,使用這些權重,為下一輪分類器(下一個分類器)產生訓練樣本。
  • 其基本的思想是,當建立分類器時,希望它更關註上一輪分類器(上一個分類器)錯誤分類的元組。整個分類過程中,某些分類器對某些“困難”元組的分類效果可能比其他分類器好。這樣,建立了一個互補的分類器系列。
  • 用於二分類或多分類的應用場景。
  • 優點
    • (1) 很好的利用了弱分類器進行級聯。
    • (2)可以將不同的分類算法作為弱分類器。
    • (3)AdaBoost具有很高的精度。
    • (4) 相對於bagging算法和Random Forest算法,AdaBoost充分考慮的每個分類器的權重。
  • 缺點:
    • (1) AdaBoost迭代次數也就是弱分類器數目不太好設定,可以使用交叉驗證來進行確定。
    • (2) 數據不平衡導致分類精度下降。
    • (3) 訓練比較耗時,每次重新選擇當前分類器最好切分點。

3.2 GBDT

  • 採用決策樹作為弱分類器的Gradient Boosting算法被稱為GBDT,有時又被稱為MART(Multiple Additive Regression Tree)。GBDT中使用的決策樹通常為CART。
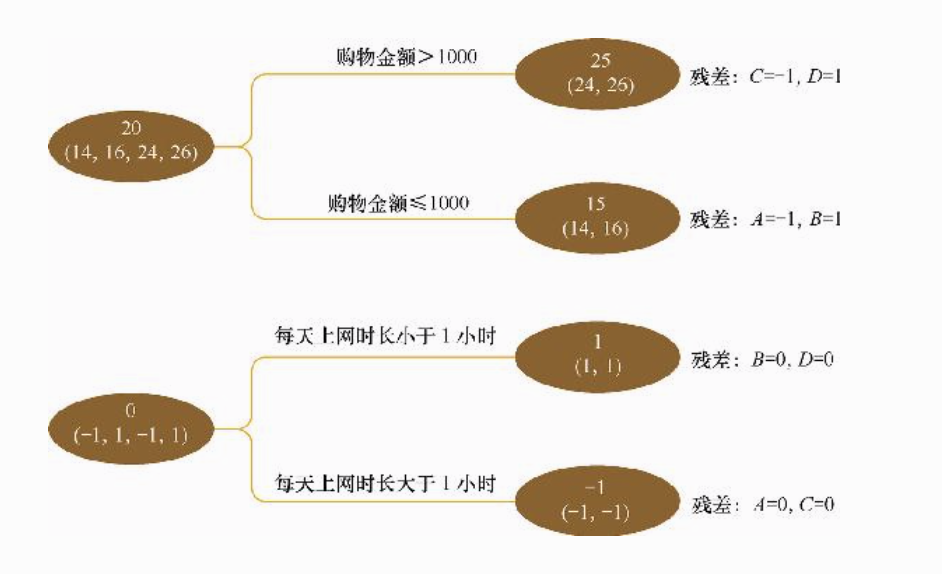
  • 用一個很簡單的例子來解釋一下GBDT訓練的過程,如圖下圖所示。模型的任務是預測一個人的年齡,訓練集只有A、B、C、D 4個人,他們的年齡分別是14、16、24、26,特徵包括了 “月購物金額”、”上網時長”、”上網歷史” 等。
  • 下面開始訓練第一棵樹:
    • 訓練的過程跟傳統決策樹相同,簡單起見,我們只進行一次分枝。訓練好第一棵樹后,求得每個樣本預測值與真實值之間的殘差。
    • 可以看到,A、B、C、D的殘差分別是−1、1、−1、1。
    • 這時我們就用每個樣本的殘差訓練下一棵樹,直到殘差收斂到某個閾值以下,或者樹的總數達到某個上限為止。
  • 由於GBDT是利用殘差訓練的,在預測的過程中,我們也需要把所有樹的預測值加起來,得到最終的預測結果。

  • 優點:
    • (1)預測階段的計算速度快,樹與樹之間可并行化計算。
    • (2)在分佈稠密的數據集上,泛化能力和表達能力都很好,這使得GBDT在Kaggle的眾多競賽中,經常名列榜首。
    • (3)採用決策樹作為弱分類器使得GBDT模型具有較好的解釋性和魯棒性,能夠自動發現特徵間的高階關係,並且也不需要對數據進行特殊的預處理如歸一化等。
  • 缺點:
    • (1)GBDT在高維稀疏的數據集上,表現不如支持向量機或者神經網絡。
    • (2)GBDT在處理文本分類特徵問題上,相對其他模型的優勢不如它在處理數值特徵時明顯。
    • (3)訓練過程需要串行訓練,只能在決策樹內部採用一些局部并行的手段提高訓練速度。

3.3 Xgboost

  • XGBoost是陳天奇等人開發的一個開源機器學習項目,高效地實現了GBDT算法並進行了算法和工程上的許多改進。
  • 目標函數:
    \[L^{(t)} = \sum_{i=1}^{n}l(y_i, \hat{y}_i^{(t)}) + \Omega(f_t) \]
  • 優點:
    • (1)計算效率高,使用了二階導。
    • (2)有正則化,減少過擬合。
    • (3)列特徵抽樣減少過擬合,同時有利於并行計算。
  • 缺點:
    • (1)每次迭代時都要遍歷整個數據集。
    • (2)內存佔用大。

3.4 GBDT與XGboost聯繫與區別

  • (1) GBDT是機器學習算法,XGBoost是該算法的工程實現。
  • (2) 在使用CART作為基分類器時,XGBoost顯式地加入了正則項來控制模型的複雜度,有利於防止過擬合,從而提高模型的泛化能力。
  • (3) GBDT在模型訓練時只使用了代價函數的一階導數信息,XGBoost對代價函數進行二階泰勒展開,可以同時使用一階和二階導數。
  • (4) 傳統的GBDT採用CART作為基分類器,XGBoost支持多種類型的基分類器,比如線性分類器。
  • (5) 傳統的GBDT在每輪迭代時使用全部的數據,XGBoost則採用了與隨機森林相似的策略,支持對數據進行採樣。
  • (6) 傳統的GBDT沒有設計對缺失值進行處理,XGBoost能夠自動學習出缺失值的處理策略。

3.5 LightGBM

  • LightGBM也是一種基於決策樹的梯度提升算法,相比XGboost有做了許多改進。
    在樹分裂計算分裂特徵的增益時,xgboost 採用了預排序的方法來處理節點分裂,這樣計算的分裂點比較精確。但是,也造成了很大的時間開銷。為了解決這個問題,Lightgbm 選擇了基於 histogram 的決策樹算法。相比於pre-sorted算法,histogram在內存消耗和計算代價上都有不少優勢。
  • Histogram算法簡單來說,就是先對特徵值進行裝箱處理,形成一個一個的bins。在Lightgbm中默認的#bins為256(1個字節的能表示的長度,可以設置)。具體如下:
    • (1) 把連續的浮點特徵值離散化成N個整數,構造一個寬度為N的直方圖;對於分類特徵,則是每一種取值放入一個bin,且當取值的個數大於max_bin數時,會忽略那些很少出現的category值。
    • (2) 遍曆數據時,根據離散化后的值作為索引在直方圖中累積統計量。
    • (3) 一次遍歷后,直方圖累積了需要的統計量,然後根據直方圖的離散值,遍歷尋找最優的分割點。
  • Level-wise 和 Leaf-wise
    • 相對於xgboost的level—wise的生長策略,lightgbm使用了leaf-wise樹生長策略。由於level-wise在分裂時,部分增益小的樹也得到了增長,雖然容易控制誤差,但是分裂有時是不合理的,而lightgbm使用level-wise,只在增益大的樹上分裂生長,甚至對Feature f如果分裂無收益,那麼後續也將不會對f計算。體現在參數上,xgboost使用max_depth,而lightgbm使用num_leaves控制過擬合。
    • Level-wise過一次數據可以同時分裂同一層的恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子,容易進行多線程優化,也好控制模型複雜度,不容易過擬合。但實際上Level-wise是一種低效的算法,因為它不加區分的對待同一層的恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子,帶來了很多沒必要的開銷,因為實際上很多恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子的分裂增益較低,沒必要進行搜索和分裂。
    • Leaf-wise則是一種更為高效的策略,每次從當前所有恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子中,找到分裂增益最大的一個恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子,然後分裂,如此循環。因此同Level-wise相比,在分裂次數相同的情況下,Leaf-wise可以降低更多的誤差,得到更好的精度。Leaf-wise的缺點是可能會長出比較深的決策樹,產生過擬合。因此LightGBM在Leaf-wise之上增加了一個最大深度的限制,在保證高效率的同時防止過擬合。

3.6 Xgboost與LightGBM對比

3.6.1 切分算法(切分點的選取)

  • 佔用的內存更低,只保存特徵離散化后的值,而這個值一般用8位整型存儲就足夠了,內存消耗可以降低為原來的1/8。
  • 降低了計算的代價:預排序算法每遍歷一個特徵值就需要計算一次分裂的增益,而直方圖算法只需要計算k次(k可以認為是常數),時間複雜度從O(#data#feature)優化到O(k#features)。(相當於LightGBM犧牲了一部分切分的精確性來提高切分的效率,實際應用中效果還不錯)
  • 空間消耗大,需要保存數據的特徵值以及特徵排序的結果(比如排序后的索引,為了後續快速計算分割點),需要消耗兩倍於訓練數據的內存
  • 時間上也有較大開銷,遍歷每個分割點時都需要進行分裂增益的計算,消耗代價大
  • 對cache優化不友好,在預排序后,特徵對梯度的訪問是一種隨機訪問,並且不同的特徵訪問的順序不一樣,無法對cache進行優化。同時,在每一層長樹的時候,需要隨機訪問一個行索引到恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子索引的數組,並且不同特徵訪問的順序也不一樣,也會造成較大的cache miss。
  • XGBoost使用的是pre-sorted算法(對所有特徵都按照特徵的數值進行預排序,基本思想是對所有特徵都按照特徵的數值進行預排序;然後在遍歷分割點的時候用O(#data)的代價找到一個特徵上的最好分割點最後,找到一個特徵的分割點后,將數據分裂成左右子節點。優點是能夠更精確的找到數據分隔點;但這種做法有以下缺點
  • LightGBM使用的是histogram算法,基本思想是先把連續的浮點特徵值離散化成k個整數,同時構造一個寬度為k的直方圖。在遍曆數據的時候,根據離散化后的值作為索引在直方圖中累積統計量,當遍歷一次數據后,直方圖累積了需要的統計量,然後根據直方圖的離散值,遍歷尋找最優的分割點;優點在於

3.6.2 決策樹生長策略

  • XGBoost採用的是帶深度限制的level-wise生長策略,Level-wise過一次數據可以能夠同時分裂同一層的恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子,容易進行多線程優化,不容易過擬合;但不加區分的對待同一層的恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子,帶來了很多沒必要的開銷(因為實際上很多恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子的分裂增益較低,沒必要進行搜索和分裂)
  • LightGBM採用leaf-wise生長策略,每次從當前所有恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子中找到分裂增益最大(一般也是數據量最大)的一個恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子,然後分裂,如此循環;但會生長出比較深的決策樹,產生過擬合(因此 LightGBM 在leaf-wise之上增加了一個最大深度的限制,在保證高效率的同時防止過擬合)。
  • Histogram做差加速。一個容易觀察到的現象:一個恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子的直方圖可以由它的父親節點的直方圖與它兄弟的直方圖做差得到。通常構造直方圖,需要遍歷該恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子上的所有數據,但直方圖做差僅需遍歷直方圖的k個桶。利用這個方法,LightGBM可以在構造一個恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子的直方圖后,可以用非常微小的代價得到它兄弟恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子的直方圖,在速度上可以提升一倍。
  • 直接支持類別特徵:LightGBM優化了對類別特徵的支持,可以直接輸入類別特徵,不需要額外的0/1展開。並在決策樹算法上增加了類別特徵的決策規則。

3.6.3 分佈式訓練方法上(并行優化)

  • 在特徵并行算法中,通過在本地保存全部數據避免對數據切分結果的通信;
  • 在數據并行中使用分散規約(Reducescatter)把直方圖合併的任務分攤到不同的機器,降低通信和計算,並利用直方圖做差,進一步減少了一半的通信量。基於投票的數據并行(ParallelVoting)則進一步優化數據并行中的通信代價,使通信代價變成常數級別。
  • 特徵并行的主要思想是在不同機器在不同的特徵集合上分別尋找最優的分割點,然後在機器間同步最優的分割點。
  • 數據并行則是讓不同的機器先在本地構造直方圖,然後進行全局的合併,最後在合併的直方圖上面尋找最優分割點。
  • Cache命中率優化
  • 基於直方圖的稀疏特徵優化
  • DART(Dropout + GBDT)
  • GOSS(Gradient-based One-Side Sampling):一種新的Bagging(row subsample)方法,前若干輪(1.0f /gbdtconfig->learning_rate)不Bagging;之後Bagging時, 採樣一定比例g(梯度)大的樣本。

4 stacking

  • stacking的思想是將每個基模型的輸出組合起來作為一個特徵向量,重新進行訓練。可以理解為:將訓練好的所有基模型對整個訓練集進行預測,第j個基模型對第i個訓練樣本的預測值將作為新的訓練集中第i個樣本的第j個特徵值,最後基於新的訓練集進行訓練。同理,預測的過程也要先經過所有基模型的預測形成新的測試集,最後再對測試集進行預測。
  • 具體算法如下(為方便理解我舉例說明):
    • (1) 訓練集大小\(400\times10\),400個樣本,每個樣本10個特徵,(如果算上target有11列)。測試集大小為\(120\times10\)。
    • (2) 首先對訓練集4折劃分:\(S_1\),\(S_2\),\(S_3\),\(S_4\),每個\(S_i\)的大小都收是\(100\times10\)。模型\(M_1\)第一次用\(S_1\),\(S_2\),\(S_3\)訓練,用\(S_4\)預測得到預測結果\(100\times1\)。重複訓練步驟,直到每一個\(S_i\)都有對應的預測結果\(100\times1\)。合併所有預測結果得到\(P_1\)\(400\times1\)。用\(M_1\)預測得到原始測試集的預測結果\(T_1\)\(120\times1\)。
    • (3) 模型\(M_2\)用4折叫交叉得到訓練集的預測結果:\(P_2\)\(400\times1\);得到測試集的預測結果:\(T_2\)\(120\times1\)。
    • (4) 模型\(M_3\)用4折叫交叉得到訓練集的預測結果:\(P_3\)\(400\times1\);得到測試集的預測結果:\(T_3\)\(120\times1\)。
    • (5) 綜合(2)(3)(4)底層模型得到的訓練集的預測結果\(P_1\)、\(P_2\)、\(P_3\),得到上層模型的訓練集\(P_{train}\)\(400\times3\);得到上層模型的測試集\(T_{test}\)\(120\times3\)。
    • (6) 用(5)得到的訓練集和測試集進行上層模型的訓練。
  • 優點:學習了底層模型之間的關係
  • 缺點:對於數據量要求比較大,因為要平衡第一層和第二層

    5 參考

  • 《百面機器學習》
  • https://zhuanlan.zhihu.com/p/26890738
  • https://www.imooc.com/article/29530
  • https://blog.csdn.net/anshuai_aw1/article/details/83040541

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

【讀後感1】SQL2008技術內幕- SQL邏輯查詢處理

引言觀點

1. 編程語言日新月異,但是從沒有人否定sql 在現代編程中的巨大作用和 持續的可利用性。SQL以對人類友好的閱讀體驗提供數據查詢能力( 相比其他編程語言 ), 同時在各種數據庫平台中,基礎SQL元素是相同或大同小異的,

從我們最早接觸的SQL,Mysql到公司大數據impala 支持SQL, Es也提供類似SQL的查詢, 阿里提出SQLFlow AI框架, SQL的生命力極其頑強。

2. 在我近6年的開發生涯中,確實覺得SQL語言沒有得到開發者足夠的重視,尤其是流行的ORM概念使得了編寫SQL機會越來越少,使用ORM映射框架是需要一些代碼的, 另外ORM只能用於基礎的關係型二維查詢,對於複雜的查詢無能為力,部分工作可通過巧妙的SQL查詢,存儲過程,觸發器來完成。

3. SQL編程有許多獨特之處: 面向集合的思維方式、 查詢元素的邏輯處理順序、三值邏輯(three value logic),理解不透的話在實際編寫SQL時會產生很多錯誤的寫法、性能低下的代碼。

1987年SQL稱為ISO標準,ANSI宣布該語言發音為“ess kyoo ell”, 但由於歷史原因,很多專業人士還是將SQL發音成sequel,而且從英文習慣上,sequel發音更為流暢。 互聯網如此之大,容得下不同的聲音。

結合《SQL2008 技術內幕 T-SQL查詢》和工作經驗,提煉出Web開發者需要熟練掌握以下SQL查詢。

  • SQL邏輯查詢處理

  • SQL 面向集合的思維方式

不敢妄自宣稱是高級編程經驗, 只是認為Web開發者應該Cover這些常見SQL用法。  

SQL邏輯查詢處理

  開發者、數據分析師每天都在寫【SELECT 列a,聚合函數 FROM 表名 WHERE 過濾條件 GROUP BY 列a HAVING 篩選條件】這樣的查詢語句。

  SQL與其他語言不同的最明顯特徵是代碼的處理順序,大多數編程語言中,代碼是按照編寫順序來處理的,但在SQL中第一個要處理的子句是FROM子句,儘管SELECT語句第一個出現,但基本都在最後處理。

       每一步都會生成一個虛擬表,該虛擬表會作為下一步的輸入, 這些虛擬表對於調用者(客戶端應用程序或者外部查詢)都是不可用的,只有最後一步生成的虛擬表才會返回給調用者,這種形態可對比LINQ理解。


①FROM        FROM階段負責標識表或要查詢的表,如果指定了表運算符(JOIN, APPLY,PIVOT,UNPIVOT ),還要進行表運算符的處理。

              例如:表聯接運算中涉及的階段是 笛卡爾積、ON篩選器和 添加外部行,FROM階段生成虛擬表VT1.

②WHERE           這個階段根據在WHERE子句中出現的謂詞對VT1中進行篩選,只有讓謂詞計算結果為TRUE的行,才會插入VT2中。

③GROUP BY     按照GROUP BY 子句中指定的列名列表,對VT2中的行進行分組,生成VT3, 最終每個分組只有一個結果行。

④HAVING          根據HAVING子句中出現的謂詞,對VT3中行記錄進行篩選,只有讓謂詞結果為TRUE的行記錄,才會進入VT4, Having 篩選器是唯一可用於分組數據的篩選器。

⑤SELECT    處理SELECT子句中字段(某些字段可能進行一些操作,形成新的字段),形成虛擬表VT5

⑥ORDER BY  根據ORDER BY子句中指定的列名列表,對VT5 中行進行排序,輸出最後結果。


着重理解:

  • 第一步的FROM表運算, 一般情況下是TABLE、TempTable,CTE, 還有可能是表運算符(我們常用的是聯接運算符), 所以不能單純認為FROM後面是一個表結構。

  • 表聯接運算符  ON篩選器 與 WHERE有所不同,若採用OUTER JOIN, 應用ON篩選出來的結果不一定是此階段最終結果,因為涉及【添加外部行】, 而WHERE過濾出的結果是此階段的最終結果。 

  • GROUP BY x,y 意味着將(x,y)作為一個整體來分組

  • 有SELECT 和WHERE的時候,先執行WHERE,再執行SELECT,這樣就很容易理解以下SQL的業務含義:

SELECT page_original_url,server_session_id,access_order-1 as access_order FROM PageViewMeasure WHERE access_order >= 2
--- 查詢過濾出access_order>=2的基礎數據集,然後將(原列值-1)重命名為原列名,重命名的用法業務上也許是為了形成新的SQL聯接

SELECT keyword_id,Coalesce(full_keywords,keywords)  as  not_nullField,profile_id,session_server_time,count (*) over () as Count FROM pageview 
WHERE  profile_id =5254 and keyword_id != '-' and day =20181008  and  not_nullField !='-'   
ORDER BY session_server_time 
--- SQL報錯:Could not resolve column/field reference: 'not_nullfield' 也容易理解了:先執行where, 執行where的時候not_nullField字段還沒有形成
  • ROW_NUMBER() OVER(PARTITION BY UserId ORDER BY PageViewServerTime)排名函數中ORDER BY 與SQL語句最後的ORDER BY 同時存在,哪個ORDER BY起最終排序作用?

SELECT page_original_url as name,page_view_server_time, ROW_NUMBER() OVER(PARTITION BY page_original_url ORDER BY page_view_server_time ) as partition_rank ,wd3_page_duration
  FROM pageview WHERE profile_id=5198 AND day between 20190616 and 20190621   
  ORDER  BY wd3_page_duration desc 
  LIMIT 100

  可以認為 ROW_NUMBER() OVER(PARTITION BY col1 ORDER BY col2) as rank 本質上還是產生一個列值,實際是對應以上的第⑤步,因此SQL最後的ORDER BY起最終排序作用,例證如下:

           某些轉載文章寫有: 以上over函數里的分組及排序的執行晚於“where,group by,order by”的執行 ,這樣的結論是錯誤的

  • 若存在LIMIT子句,則LIMIT子句必須在ORDER BY 語法之後


      上圖來自《SQL技術內幕T-SQL查詢》邏輯查詢處理一章


 這裏拋出一個困惑點:

  在FROM子句中,若存在JOIN表運算符, 可能會按照 【計算笛卡爾積】 【應用ON篩選】【添加外部行】的順序來完成 JOIN的過程, 但是試想一下: 如果兩個表都為大表,先計算笛卡爾積,再篩選 豈不很費內存,

  我也搜索了很多資料,某些資料認為先進行【ON篩選】再進行【JOIN】運算:

https://www.cnblogs.com/liuzhendong/archive/2011/10/27/2226805.html

https://docs.microsoft.com/en-us/previous-versions/sql/sql-server-2008/ms189499(v=sql.100)

我更願意相信《SQL技術內幕T-SQL查詢》書中所言:

本章描述的某些邏輯處理步驟可能看起來非常低效,但要記住, 在實踐中,
查詢的實際物理處理可能與邏輯處理有很大不同。

在SQL Server 中負責生成實際工作計劃的組件是查詢優化器,以何種順序訪問表、使用什麼訪問方法和索引,應用哪種聯接算法等都是查詢優化器來決定的,優化器會生成多個有效執行計劃並選擇一個開銷最低的計劃。

邏輯查詢處理中各個階段都有其特定的順序,而優化器缺經常可以在它生成的物理執行計劃中走捷徑。

 我們思考一個簡單的SQL:

SELECT * FROM pageview LEFT JOIN  share  ON  pageview.share_pv_id = share.page_view_id
 WHERE pageview.profile_id =5313 AND pageview.day  between 20190615 and 20190624

若實際物理查詢按照上面描述的 邏輯查詢處理, 先進行 FROM 子句中的 LEFT JOIN 計算,再進行 WHERE過濾, 根本無法查出(在FROM子句可能內存就爆滿了)

  現在我們能夠查詢出來,能夠印證 實際物理查詢確實與邏輯查詢處理有很大不同。 

PS: 以上是個人從現象上推斷書中理論,對於實際物理查詢處理並沒有理論支持,若網友們有相關資料,可留言給我。


作者: JulianHuang

感謝您的認真閱讀,如有問題請大膽斧正;覺得有用,請下方或加關注。

本文歡迎轉載,但請保留此段聲明,且在文章頁面明顯位置註明本文的作者及原文鏈接。

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

SpringBoot第十七篇:定時任務

作者:追夢1819
原文:https://www.cnblogs.com/yanfei1819/p/11076555.html
版權聲明:本文為博主原創文章,轉載請附上博文鏈接!

引言

  相信大家對定時任務很熟悉,其重要性也不言而喻。定時發短信、定時批量操作、定時統計數據等,都離不開定時任務。本文將講解定時任務在 SpringBoot 項目中的應用。

版本信息

  • JDK:1.8
  • SpringBoot :2.0.1.RELEASE
  • maven:3.3.9
  • IDEA:2019.1.1
  • quartz:2.3.0

定時任務實現方式

JDK自帶的Timer

  Timer 是Java 自帶的定時任務類。可以用作比較簡單的定時任務。通常用的不多。下面以一個小的示例展示其用法。

SpringBoot集成的schedule

這種方式是 SpringBoot 集成的,使用很簡單。

首先,引入 SpringBoot 的基礎 jar:

  <dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter</artifactId>
  </dependency>

然後再啟動類中添加註解 @EnableScheduling 即可開啟 SpringBoot 定時任務:

@SpringBootApplication
@EnableScheduling
public class TimedTaskDemoApplication {
    public static void main(String[] args) {
        SpringApplication.run(TimedTaskDemoApplication.class, args);
    }
}

下面根據 @Scheduled 的不同屬性創建幾個任務:

任務一:

@Component
public class FirstTask {
    /**
     * cron 表達式
     */
//    @Scheduled(cron = "0/2 * * * * *")
    @Scheduled(cron="${cron.schedule}")
    public void run(){
        System.out.println("這是創建的第一個定時任務");
    }
}

作幾點說明:

  1. cron 表達式是 @Scheduled 的屬性之一,其值可以直接設置為 cron 表達式;
  2. @Scheduled(cron="${cron.schedule}") 是動態讀取 application.properties 配置文件中的 cron 表達式。例如項目中的一個需求是每天凌晨0點執行,但是對於測試人員來說,不可能等到凌晨測試。動態讀取可以幫助解決該問題。

任務二:

@Component
public class SecondTask {
    /**
     * 上一次執行完畢時間點之後多長時間再執行(ms)
     */
    @Scheduled(fixedDelay = 2000)
    public void run(){
        System.out.println("這是創建的第二個定時任務");
    }
}

任務三:

@Component
public class ThirdTask {
    /**
     * 與fixedDelay功能相同,上一次執行完畢時間點之後多長時間再執行(ms),區別是:1、時間是字符串;2、支持佔位符
     */
    // @Scheduled(fixedDelayString = "2000")
    @Scheduled(fixedDelayString = "${time.fixedDelay}")
    public void run(){
        System.out.println("這是創建的第三個定時任務");
    }
}

上面的三個任務列舉了 @Scheduled 註解的三個參數。其實除此之外,查看 @Scheduled 的源碼可知,還有其餘的幾個參數:

  • fixedRate:上一次開始執行時間點之後多長時間再執行;
  • fixedRateString:上一次開始執行時間點之後多長時間再執行;
  • fixedRateString:與fixedRate 意思相同,只是使用字符串的形式。唯一不同的是支持佔位符;
  • initialDelay:第一次延遲多長時間后再執行;
  • initialDelayString:與 initialDelay 意思相同,只是使用字符串的形式。唯一不同的是支持佔位符;

整合Quartz

  如果以上的方式都無法滿足項目的需求,則可以試試 Quartz 調度框架。它功能的強大以及使用無需多說了。此處我們看看 Quartz 在 SpringBoot 中的使用。

創建項目,引入 Quartz 調度框架啟動器:

<dependency>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-quartz</artifactId>
</dependency>

  需要注意版本信息,如果 SpringBoot 版本是2.0以後的版本,直接引入 Quartz 啟動器即可。但是如果是2.0以前的版本,需要引入以下 jar 包:

<dependency>
    <groupId>org.quartz-scheduler</groupId>
    <artifactId>quartz</artifactId>
    <version>2.3.0</version>
</dependency>
<dependency>
    <groupId>org.springframework</groupId>
    <artifactId>spring-context-support</artifactId>
</dependency>

下面創建任務了:

public class QuartzTask extends QuartzJobBean {
    @Override
    protected void executeInternal(JobExecutionContext jobExecutionContext) throws JobExecutionException {
        System.out.println(new Date());
    }
}

任務需要繼承 QuartzJobBean 抽象類,並重寫 executeInternal 方法。

第三步,創建 quartz 配置類,添加 @Configuration 註解:

@Configuration
public class QuartzConfig {
    @Bean
    public JobDetail testQuartzTask() {
        return JobBuilder.newJob(QuartzTask.class).withIdentity("quartztask").storeDurably().build();
    }
    @Bean
    public Trigger testQuartzTrigger2() {
        //cron方式,每隔5秒執行一次
        return TriggerBuilder.newTrigger().forJob(testQuartzTask())
                .withIdentity("quartztask")
                .withSchedule(CronScheduleBuilder.cronSchedule("*/5 * * * * ?"))
                .build();
    }
}

  上面的示例是使用 cron 表達式,當然也可以是固定時間間隔。本節是闡述 SpringBoot 和 Quartz 的整合,不作 Quartz 的詳細使用。感興趣的讀者可以登錄 Quartz 的官網 或者中文官網自行研究。

總結

  定時任務的實現方式有很多種,除了上面說到的幾種方式,還有利用線程池實現定時任務,有的系統是通過 Liunx 實現定時任務。總之,定時任務的實現方式多種多樣,其方式要根據項目的實際情況而選。切不可為了實現而實現。

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

【朝花夕拾】Android自定義View篇之(七)Android事件分發機制(下)滑動衝突解決方案總結

前言

       轉載請聲明,轉自【https://www.cnblogs.com/andy-songwei/p/11072989.html】,謝謝!

       前面兩篇文章,花了很大篇幅講解了Android的事件分發機制的原理性知識。然而,“紙上得來終覺淺,絕知此事要躬行”,前面講的那些原理,也都是為解決實際問題而服務的。本文將結合實際工作中經常遇到的滑動衝突案例,總結滑動衝突的場景以及解決方案。本文的主要內容如下:


一、滑動衝突簡介

       滑動組合在平時的UI開發中非常常見,比如下圖中某App界面(圖片來源:https://www.jb51.net/article/90032.htm),該頁面上半部分显示商品列表,而下半部分显示頁面導航。當滑動上面的列表時,列表部分滑動;當列表滑動到底或者滑動下半部分時,整個頁面一起滑動。

       但是在平時的開發中,可能會經常遇到這樣的場景,滑動列表部分時,整個頁面一起滑動,而不是只滑動列表內容。或者一會兒是列表滑動,一會兒是整個頁面滑動,而不是按照預期的要求來滑動。這就是我們常說的滑動衝突問題。滑動衝突的問題,經常讓開發者們頭痛不已。因為經常很多滑動相關的控件,如ScrollView、ListView等,在單獨使用的時候酷炫不已,但將他們組合在一起使用,就失靈了。比如上圖中,手指在屏幕上上下滑動,列表和整個頁面都有滑動功能,此時如果處理不當,就會導致系統也不知道要讓誰來消費這個滑動事件,這就是滑動衝突產生的原因。


二、滑動衝突的三種場景

       儘管實際工作中滑動衝突的場景看似各種各樣,但最終可以歸納為三種,如下圖所示:1)圖一:外部滑動和內部滑動方向不一致;2)圖二:外部滑動和內部滑動方向不一致;3)圖三:多層滑動疊加。


  1、外部滑動和內部滑動方向不一致

       圖一中只示意了外部為左右滑動,內部為上下滑動的場景。顯然,內外滑動不一致,還包括外部為上下滑動,內部為左右滑動的場景。對於這種場景,平時工作中最常見的使用大概是外層為PageView,內層為一個Fragment+ListView/RecyclerView了。慶幸的是,控件PageView和RecyclerView對事件衝突做了處理的,所以平時使用這兩個控件的時候不會感受到滑動衝突的存在。如果是ScrollView+GridView等這類組合,就需要解決衝突了。

  2、外部滑動和內部滑動方向一致

       同樣,這種場景除了圖二中的內外都是上下滑動的情況外,還包括內外到時左右滑動的場景了。ScollView(垂直滾動)+ListView的組合就是比較常見的場景。第一節中的動態圖就是一個外部滑動和內部滑動方向一致的例子。

  3、多層滑動嵌套

       這種場景一般就是前面兩種場景的嵌套。“騰訊新聞”客戶端就是典型的多層滑動嵌套的使用案例,如下圖中,圖一的左邊是主頁向右滑動時才出現的滑動側邊欄,圖二是主頁界面,頂部導航欄在主頁左右滑動時可以切換,整個“要聞”界面可以上下滑動,“熱點精選”是一個可以左右滑動的橫向列表,下方還有豎直方向的列表……可見這其中嵌套層數不少。


三、滑動衝突三種場景的處理思路

       儘管滑動衝突看起來比較複雜,但是上述將它們分為三類場景后,就可以根據這三類場景來分別找出對應的分析思路。

  1、內外滑動方向不一致時處理思路

       這一類場景其實比較容易分析,因為外層和內層滑動的方向不一致,所以根據手勢的動向來確定把事件給誰。我們前面兩篇文章中分析過,默認情況下,當點擊內層控件時,事件會先一層層從外層傳到內層,由內層來處理。這裏以外層為左右滑動,內層為上下滑動為例。當判定手勢的滑動為左右時,需要外層來消費事件,所以外層將事件攔截,即在外層的onInterceptTouchEvent中檢測為ACTION_MOVE時返回true;而如果判定手勢的滑動為上下時,需要內層來消費事件,外層不需要攔截,事件會傳遞到內層來處理(具體的代碼實現,在後面會詳細列出)。這樣就通過判斷滑動的方向來決定事件的處理對象,從而解決滑動衝突的問題。

       那麼,如何來判定手勢的滑動方向呢?最常用的辦法就是比較水平和豎直方向上的位移值來判斷。 MotionEvent事件包含了事件的坐標,只要記錄一次移動事件的起點和終點坐標,如下圖所示,通過比較在水平方向的位移|dx|和|dy|的大小,來決定滑動的方向:|dy|>|dx|,本次移動的方向認為是豎直方向;反之,則認為是水平方向。當然,還可以通過夾角α的大小、斜率、速率等方式來作為判斷條件。

  2、內外滑動方向一致時處理思路

       這種場景要比上面一種複雜一些,因為滑動方向一致,所以無法通過上述的方式來判斷將事件交給誰處理。在這種情況下,往往需要根據業務的需要來判定誰來處理事件。比如豎直方向的ScrollView嵌套ListView的場景下,手指在ListView上上下滑動時:當ListView滑動到頂部且手勢向下時,顯然ListView不能再向下滑動了,這種情況下事件需要被外層控件攔截,由ScrollView來消費;當ListView滑動到底部且手勢向上時,顯然ListView也不能再向上滑動了,這種情況下事件也需要被外層控件攔截,由ScrollView來消費;其它情況下,ScrollView就不能再攔截了,滑動事件就需要由ListView來消費了,即此時上下滑動時,滑動的是ListView,而不是ScrollView。後面會以這為案例進行編碼實現。

  3、多層滑動嵌套時處理思路

       場景3看起來比較複雜,但前面也說過了,也是由前面兩種場景嵌套形成的。所以在處理場景的處理方式,就是將其拆分為簡單的場景,然後按照前面的場景分析方式來處理。


四、滑動衝突的兩種解決套路

       前面我們將滑動衝突分為了3種場景,並根據每一種場景提供了解決衝突的思路。但是這些思路解決的是判斷條件問題,即什麼情況下事件交給誰的問題。這一節將拋開前面的場景分類,介紹對所有場景適用的兩種通用解決方法,可以通俗地理解為處理滑動衝突的“套路”。這兩種解決滑動衝突的方式為:外部攔截法和內部攔截法。

  1、外部攔截法

       顧名思義,就是在外部滑動控件中處理攔截邏輯。這需要外部控件重寫父類的onInterceptTouchEvent方法,在其中判斷什麼時候需要攔截事件由自身處理,什麼時候需要放行將事件傳給內層控件處理,內部控件不需要做任何處理。這個“套路”的偽代碼錶示所示:

 1 @Override
 2 public boolean onInterceptTouchEvent(MotionEvent ev) {
 3     boolean intercepted = false;
 4     switch (ev.getAction()){
 5         case MotionEvent.ACTION_DOWN:
 6             intercepted = false;
 7             break;
 8         case MotionEvent.ACTION_MOVE:
 9             if(父容器需要自己處理改事件){
10                 intercepted = true;
11             }else {
12                 intercepted = false;
13             }
14             break;
15         case MotionEvent.ACTION_UP:
16             intercepted = false;
17             break;
18             default:
19             break;
20     }
21     return intercepted;
22 }

前面對滑動處理的場景分類,並對不同場景給了分析思路,它們的作用就是在這裏的第9行來做判斷條件的。所以,不論什麼場景,都可以在這個套路的基礎上,修改判斷是否攔截事件的條件語句即可。另外,需要說明一下的是,第6行和第16行,這裏都賦值為false,因為ACTION_DOWN如果被攔截了,該動作序列的其它事件就都無法傳遞到子View中了,ListView也就永遠不能滑動了;而ACTION_UP如果被攔截,那子View就無法被點擊了,這兩點我們前面的文章都講過,這裏再強調一下。


  2、內部攔截法

       顧名思義,就是將事件是否需要攔截的邏輯,放到內層控件中來處理。這種方式需要結合requestDisllowInterceptTouchEvent(boolean),在內層控件的重寫方法dispatchTouchEvent中,根據邏輯來決定外層控件何時需要攔截事件,何時需要放行。偽代碼如下:

 1 @Override
 2 public boolean dispatchTouchEvent(MotionEvent ev) {
 3     switch (ev.getAction()){
 4         case MotionEvent.ACTION_DOWN:
 5             getParent().requestDisallowInterceptTouchEvent(true);
 6             break;
 7         case MotionEvent.ACTION_MOVE:
 8             if (父容器需要處理改事件) {
 9                 //允許外層控件攔截事件
10                 getParent().requestDisallowInterceptTouchEvent(false);
11             } else {
12                 //需要內部控件處理該事件,不允許上層viewGroup攔截
13                 getParent().requestDisallowInterceptTouchEvent(true);
14             }
15             break;
16         case MotionEvent.ACTION_UP:
17             break;
18         default:
19             break;
20     }
21     return super.dispatchTouchEvent(ev);
22 }

除此之外,還需要外層控件在onInterceptTouchEvent中做一點處理:

1 @Override
2 public boolean onInterceptTouchEvent(MotionEvent ev) {
3     if (ev.getAction() == MotionEvent.ACTION_DOWN) {
4         return false;
5     } else {
6         return true;
7     }
8 }

ACTION_DOWN事件仍然不能攔截,上一篇文章分析源碼的時候講過,ACTION_DOWN時會初始化一些狀態和標誌位等變量,requestDisllowInterceptTouchEvent(boolean)作用會失效。這裏再順便強調一下,不明白的可以去上一篇文章中閱讀這部分內容。 

       這種方式比“外部攔截法”稍微複雜一些,所以一般推薦使用前者。同前者一樣,這也是一個套路用法,無論是之前提到的何種場景,只要根據實際判斷條件修改上述if語句即可。對於requestDisllowInterceptTouchEvent(boolean)的相關信息,在前面的文章中介紹過,這裏不再贅述了。


 五、代碼示例

       前面通過文字描述和偽代碼,對滑動衝突進行了介紹,並提供了一些對應的解決方案。本節將通過一個具體的實例,分別使用上述的套路來解決一個滑動衝突,從而具體演示前面“套路”的使用。

  1、未解決衝突前的示例情況

       本示例外層為一個ScrollView,內層為TextView+ListView+TextView,這兩個TextView分別為“Tittle”和”Bottom”,显示在ListView的頂部和底部,添加它們是為了方便觀察ScrollView的滑動效果。最終的布局效果如下所示:

在手機上的显示效果為:


在沒有解決衝突前,如果滑動中間的ListView部分,會出現ListView中的列表內容不會滑動,而是整個ScrollView滑動的現象,或者一會兒ListView滑動,一會兒ScrollView滑動。顯然,這不是我們希望看到的結果。我們希望的是,如果ListView滑到頂部時,而且手勢繼續下滑時,整個頁面下滑,即ScrollView滑動;如果ListView滑到底部了,而且手勢繼續上滑時,希望整個頁面上滑,即也是ScrollView向上滑動。


  2、用外部攔截法解決滑動衝突的示例

       前面說過了,這種方式需要外層的控件在重寫的onInterceptTouchEvent時進行攔截判斷,所以需要自定義一個ScrollView控件。

 1 public class CustomScrollView extends ScrollView {
 2 
 3     ListView listView;
 4     private float mLastY;
 5     public CustomScrollView(Context context, AttributeSet attrs) {
 6         super(context, attrs);
 7     }
 8 
 9     @Override
10     public boolean onInterceptTouchEvent(MotionEvent ev) {
11         super.onInterceptTouchEvent(ev);
12         boolean intercept = false;
13         switch (ev.getAction()){
14             case MotionEvent.ACTION_DOWN:
15                 intercept = false;
16                 break;
17             case MotionEvent.ACTION_MOVE:
18                 listView = (ListView) ((ViewGroup)getChildAt(0)).getChildAt(1);
19                    //ListView滑動到頂部,且繼續下滑,讓scrollView攔截事件
20                 if (listView.getFirstVisiblePosition() == 0 && (ev.getY() - mLastY) > 0) {
21                     //scrollView攔截事件
22                     intercept = true;
23                 }
24                 //listView滑動到底部,如果繼續上滑,就讓scrollView攔截事件
25                 else if (listView.getLastVisiblePosition() ==listView.getCount() - 1 && (ev.getY() - mLastY) < 0) {
26                     //scrollView攔截事件
27                     intercept = true;
28                 } else {
29                     //不允許scrollView攔截事件
30                     intercept = false;
31                 }
32                 break;
33             case MotionEvent.ACTION_UP:
34                 intercept = false;
35                 break;
36             default:
37                 break;
38         }
39         mLastY = ev.getY();
40         return intercept;
41     }
42 }

       相比於前面的偽代碼,這裏需要注意一點的是多了第12行。因為本控件是繼承自ScrollView,而ScrollView中的onInterceptTouchEvent做了很多的工作,這裏需要使用ScrollView中的處理邏輯,才需要加上這一句。如果是完全自繪的控件,即直接繼承自ViewGroup,那就無需這一句了,因為控件需要自己完成自己的特色功能。第18行是獲取子控件ListView的實例,這個是參照後面的布局文件activity_event_examples來定位的,也可以通過其它的方式來獲取實例。另外就是ListView的實例可以通過其它方式一次性賦值,而不用這裏每次ACTION_MOVE都獲取一次實例,從性能上考慮會更好,這裏為了便於演示,先忽略這一點。其它要點在註釋中也說得比較明確了,這裏不贅述。

       使用CustomScrollView控件,界面的布局如下:

 1 //==============activity_event_examples=============
 2 <?xml version="1.0" encoding="utf-8"?>
 3 <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android"
 4     android:layout_width="match_parent"
 5     android:layout_height="match_parent"
 6     android:orientation="vertical">
 7 
 8     <com.example.demos.customviewdemo.CustomScrollView
 9         android:id="@+id/demo_scrollview"
10         android:layout_width="match_parent"
11         android:layout_height="match_parent">
12 
13         <LinearLayout
14             android:layout_width="match_parent"
15             android:layout_height="match_parent"
16             android:orientation="vertical">
17 
18             <TextView
19                 android:id="@+id/tv_title"
20                 android:layout_width="match_parent"
21                 android:layout_height="100dp"
22                 android:background="@android:color/darker_gray"
23                 android:gravity="center"
24                 android:text="Title"
25                 android:textSize="50dp" />
26 
27             <ListView
28                 android:id="@+id/demo_lv"
29                 android:layout_width="match_parent"
30                 android:layout_height="600dp" />
31 
32             <TextView
33                 android:layout_width="match_parent"
34                 android:layout_height="100dp"
35                 android:background="@android:color/darker_gray"
36                 android:gravity="center"
37                 android:text="Bottom"
38                 android:textSize="50dp" />
39         </LinearLayout>
40     </com.example.demos.customviewdemo.CustomScrollView>
41 </LinearLayout>

這裏需要注意的是,在ScrollView中嵌套ListView時,ListView的高度需要特別處理,如果設置為match_parent或者wrap_content,都會一次只能看到一條item,所以上面給了固定的高度600dp來演示效果。平時工作中,往往還需要對ListView的高度做一些特殊的處理,這不是本文的重點,這裏不細講,讀者可以自行去研究。

       最後就是給ListView填充足夠的數據:

 1 public class EventExmaplesActivity extends AppCompatActivity {
 2 
 3     private String[] data = {"Apple", "Banana", "Orange", "Watermelon",
 4             "Pear", "Grape", "Pineapple", "Strawberry", "Cherry", "Mango",
 5             "Apple", "Banana", "Orange", "Watermelon",
 6             "Pear", "Grape", "Pineapple", "Strawberry", "Cherry", "Mango"};
 7 
 8     @Override
 9     protected void onCreate(Bundle savedInstanceState) {
10         super.onCreate(savedInstanceState);
11         setContentView(R.layout.activity_event_exmaples);
12         showList();
13     }
14 
15     private void showList() {
16         ArrayAdapter<String> adapter = new ArrayAdapter<String>(
17                 EventExmaplesActivity.this, android.R.layout.simple_list_item_1, data);
18         ListView listView = findViewById(R.id.demo_lv);
19         listView.setAdapter(adapter);
20     }
21 }


  3、用內部攔截法解決滑動衝突的示例

       同樣,前面的偽代碼中也講過,這裏需要在內層控件中重寫的dispatchTouchEvent方法處判斷外層控件的攔截邏輯,所以首先需要自定義ListView。

 1 public class CustomListView extends ListView {
 2 
 3     public CustomListView(Context context, AttributeSet attrs) {
 4         super(context, attrs);
 5     }
 6 
 7     //為listview/Y,設置初始值,默認為0.0(ListView條目一位置)
 8     private float mLastY;
 9 
10     @Override
11     public boolean dispatchTouchEvent(MotionEvent ev) {
12         int action = ev.getAction();
13         switch (action) {
14             case MotionEvent.ACTION_DOWN:
15                 //不允許上層的ScrollView攔截事件.
16                 getParent().requestDisallowInterceptTouchEvent(true);
17                 break;
18             case MotionEvent.ACTION_MOVE:
19                 //滿足listView滑動到頂部,如果繼續下滑,那就允許scrollView攔截事件
20                 if (getFirstVisiblePosition() == 0 && (ev.getY() - mLastY) > 0) {
21                     //允許ScrollView攔截事件
22                     getParent().requestDisallowInterceptTouchEvent(false);
23                 }
24                 //滿足listView滑動到底部,如果繼續上滑,允許scrollView攔截事件
25                 else if (getLastVisiblePosition() == getCount() - 1 && (ev.getY() - mLastY) < 0) {
26                     //允許ScrollView攔截事件
27                     getParent().requestDisallowInterceptTouchEvent(false);
28                 } else {
29                     //其它情形時不允ScrollView攔截事件
30                     getParent().requestDisallowInterceptTouchEvent(true);
31                 }
32                 break;
33             case MotionEvent.ACTION_UP:
34                 break;
35         }
36 
37         mLastY = ev.getY();
38         return super.dispatchTouchEvent(ev);
39     }
40 }

可能有讀者會有些疑惑,從布局結構上看,listView和ScrollView之間還隔了一層LinearLayout,getParent().requestDisallowInterceptTouchEvent(boolean)方法會奏效嗎?實際上這個方法是針對所有的父布局的,而不是只針對直接父布局,這一點需要注意。

       參照偽代碼的套路,這裏還需要對外層的ScrollView做一些邏輯處理:

 1 public class CustomScrollView extends ScrollView {
 2     public CustomScrollView(Context context, AttributeSet attrs) {
 3         super(context, attrs);
 4     }
 5 
 6     @Override
 7     public boolean onInterceptTouchEvent(MotionEvent ev) {
 8         if (ev.getAction() == MotionEvent.ACTION_DOWN) {
 9             return false;
10         } else {
11             return true;
12         }
13     }
14 }

       在布局文件中使用CustomListView,將前面activity_event_examples.xml布局文件中的第27行的ListView替換為com.example.demos.customviewdemo.CustomListView即可。其它的和前面外部攔截法示例一樣,這裏不贅述。


結語

       關於滑動衝突的內容就講完了。實際工作中的場景可能比這裏demo中要複雜一些,筆者為了突出重點,所舉的例子選得比較簡單,但原理都一樣的,所以希望讀者能夠好好理解,重要的地方,甚至需要記下來。同樣,Android事件分發機制系列的知識點,要講的也講完了,三篇文章側重於三個方面:1)第一篇重點總結了Touch相關的三個重要方法對事件的處理邏輯;2)第二篇重點分析源碼,從源碼的角度來分析第一篇文章中的邏輯;3)第三篇重點在實踐,側重解決實際工作中經常遇到的事件衝突問題——滑動衝突。當然,事件分發相關的問題遠不是這3篇文章能說清楚的,文中若有描述錯誤或者不妥的地方,歡迎讀者來拍磚!!!


參考資料

       任玉剛《Android開發藝術探索》

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

記:使用IScroll.js 開發picker日曆組件遇到的問題及經驗總結

IScroll中文文檔

第一個問題: 邊界留白


  就是這種,上邊界(最小),下邊界(最大)有兩個列表的位置是不能選擇的。解決的辦法是:


  在HTML中,添加空白節點就行了。


第二個問題:初始化之後的滾動停止的事件的第二個參數問題。  

var myScroll = new IScroll('#wrapper');
myScroll.on('scrollEnd', function(){
    //這裏一定不要寫成es6箭頭函數
    //要執行的代碼
    //這個函數沒有參數
});

(1) 第二的個參數,是個函數。它沒有參數,而且不要寫成,不要寫成,不要寫成箭頭的形式。因為這函數裏面的this,是綁定的一些有用信息,比如:this.y是當前滾動的距離等。還有哪些信息可以看 文檔中的 滾動條信息 這一欄。如果寫成ES6的形式,那this指向就變了,這樣就獲取不了所需的信息。

(2) 第二個參數是沒有形參的。即沒有任何可使用的參數。


第三個問題:定義了snap選項,但是滾動有偏差

  開發的日曆選擇組件picker是使用rem單位自適應的,雖然在配置項中 有個options.snap,官方說可以對齊到固定的位置和元素,但是在使用自適應單位的情況中,這個配置並沒有展現出真正的效果,滾動的時候一定會出現偏差。

  那怎麼解決這個自適應的問題呢?由於是在滾動結束之後,位置才出現的偏差。那麼我就在滾動結束之後立馬調用修正位置的函數就行了。

  我是在vue中使用的。所以定義下面的函數,因為有 年,月,日,時四個滾動項。所以需要判斷是哪一個正在滾動

fixPos: function(target,num) {
    var step = Math.abs(Math.round(target.y / this.itemHeight));
    var maxYearLen = this.yearArr.length;
    var maxMonthLen = this.monthArr.length;
    var maxDayLen = this.dayArr.length;
    var maxHourLen = this.hourArr.length;
    switch(num){
        case 0:
            step = step > maxYearLen ? maxYearLen - 1 : step;
            break;
        case 1:
            step = step > maxMonthLen ? maxMonthLen - 1 : step;
            break;
        case 2:
            step = step > maxDayLen ? maxDayLen - 1 : step;
            break;
        case 3:
            step = step > maxHourLen ? maxHourLen - 1 : step;
            break;
    }
    var fixPos = step * this.itemHeight;//重新計算較為精確的位置
    target.y = fixPos;//重置原來的滾動距離 this.selectArr[num] = step;//這是保存每個列表滾動的索引值
    target.scrollTo(0, -fixPos);//這是滾動到修正後的位置
},

(1) 大致的思路就是:首先用當前滾動的距離,來除以滾動內容中,每個列表的高度。然後取最近似的值,就是當前應該滾動的列表的個數。

(2) 如果出現突然滾動到最底部,這時候需要滾動的個數大於了滾動內容的最大列表個數,那麼就糾正一下個數為最大列表數 – 1。

(3) 然後設置較為精確的滾動距離。再滾動到指定的位置。

(4) this.itemHeight是在created生命周期的時候就聲明的 this.itemHeight = (document.body.offsetWidth / 750) * 100 * 0.8;  相當於在375px寬度下,每個列表就是40px的高度。在iPhone5 320px下,就是34.133334了。

  調用的時候: 

var yearScroll = new IScroll('#calendarYear');
var that = this;
yearScroll.on('scrollEnd', function() {
    that.fixPos(this, 0);
})


第四個問題:使用自適應單位時最大滾動距離不準確

  這個問題和第二個問題類似,解決的方法:

fixMaxScrollY: function(target, num) {
    var yearLen = this.yearArr.length - 1;
    var monthLen = this.monthArr.length - 1;
    var dayLen = this.dayArr.length - 1;
    var hourLen = this.hourArr.length - 1;
    switch(num) {
        case 0:
            target.maxScrollY = -(Math.round(yearLen * this.itemHeight));
            break;
        case 1:
            target.maxScrollY = -(Math.round(monthLen * this.itemHeight));
            break;
        case 2:
            target.maxScrollY = -(Math.round(dayLen * this.itemHeight));
            break;
        case 3:
            target.maxScrollY = -(Math.round(hourLen * this.itemHeight));
            break;
    }
},

(1)  實例化后的滾動對象,有個最大滾動值maxScrollY,主要也是根據滾動內容的列表長度來重置最大滾動距離

(2)  因為有四個滾動的內容項,所以需要傳入當前是第幾個滾動的內容。

  調用的時候:

var yearScroll = new IScroll('#calendarYear');
this.fixMaxScrollY(yearScroll, 0);


第五個問題: 日曆組件的內容是在點擊某個按鈕之後再觸發显示的,最初是隱藏。但就是這個原因,導致显示出來的內容滾動不了。

  解決的辦法是:使用 xxx.refresh() 刷新函數。這個函數具體的說明可以看文檔中 刷新 這個選項內容

  在控制組件显示的函數中,調用刷新的方法。

this.$nextTick(function(){
    this.scrollTarget[0].refresh();
    this.scrollTarget[1].refresh();
    this.scrollTarget[2].refresh();
    this.scrollTarget[3].refresh();
    //如果默認隱藏,則必須修復滾動的位置
    this.scrollTarget[0].scrollTo(0, -this.itemHeight * this.selectArr[0]);
    this.scrollTarget[1].scrollTo(0, -this.itemHeight * this.selectArr[1]);
    this.scrollTarget[2].scrollTo(0, -this.itemHeight * this.selectArr[2]);
    this.scrollTarget[3].scrollTo(0, -this.itemHeight * this.selectArr[3]);
})

(1) scrollTarget 是初始化滾動實例之後,保存的滾動實例。因為多次會用到。

(2) 因為有年,月,日,時四個滾動內容,所以要刷新四個滾動器。

(3) 如果日曆有最初的滾動位置,那麼也會出現不能跳到指定的位置的問題。所以,也需要初始化最初始的位置。

(4) selectArr 是滾動器滾動的索引值。比如我月份是1月到12月,當前滾動到了6月,那麼此時selectArr[1] 就是5 。

(5) 官方是推薦用setTimeout來使用刷新,但是我使用的是vue來開發的,所以,這裏用vm.$nextTick()來代替setTimeout。


第六個問題: 日曆組件復用時,只能初始化滾動第一個日曆組件,而且第一個日曆組件滾動還是有問題。

  這個問題產生的原因很簡單:因為 IScroll 在初始化實例的時候, var myScroll = new IScroll(‘.wrapper’);  它這個css選擇器使用的是querySelector 而不是 querySelectorAll,所以iScroll只會作用到選擇器選中元素的第一個。如果你需要對多個對象使用iScroll,你需要構建自己的循環機制。這是官方的說法。那麼怎樣建立循環機制呢?難道我要在初始化的時候還要循環去 new IScroll(xxx)創建實例嗎?

  其實沒必要。只需要改一改源碼就行了。

  我使用的是 iscroll-lite 這個版本。這裏面 在定義 IScroll 這個函數的時候有這段代碼

this.wrapper = typeof el == 'string' ? document.querySelector(el) : el;

  它每次初始化時,只選擇了 el  滾動對象的第一個元素,那麼,我只需要傳入當前是第幾個日曆組件,再改成querySelectorAll就行了。即:

this.wrapper = typeof el == 'string' ? document.querySelectorAll(el)[childIndex] : el;

  然後在這個定義的 IScroll 函數的參數中,再增加一個參數,表示第幾個元素。

  然後在初始化滾動實例的時候:

var options = {
    snap: '.calendar-scroll-item', //對齊的位置,相當於自動糾正每次移動的距離
    //scrollbars: true,//是否显示滾動條
}
//初始化滾動
var yearScroll = new IScroll('.calendar-scroll>.calendarYear', options , this.curIndex);

  當然這個時候,css選擇器就不要用 id 了。

  然後在 組件的 prop 裏面添加一個屬性。

curIndex:{
    type:Number,
    default:0
}

(1) 默認只使用一個組件,即不傳這個prop 的話就是默認初始化第一個組件的滾動內容。

  使用組件的時候:引入,註冊等步驟就省略了

<calendar :cur-index='0'/>
<calendar :cur-index='1'/>
<calendar :cur-index='2'/>

   這樣不管使用多少個,都能正常初始化滾動了。而且互不影響 。注意,如果傳的是数字,需要v-bind 告訴vue這不是字符串,是表達式。不然傳過去的是字符串


【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

Appium+python自動化(九)- 定位元素工具(義結金蘭的兩位異性兄弟)(超詳解)

簡介

   環境搭建好了,其他方面的知識也準備的差不多了,那麼我們就開始下一步元素定位,元素定位宏哥主要介紹如何使用uiautomatorviewer,通過定位到頁面上的元素,然後進行相應的點擊等操作. 此外在介紹另一款工具:Inspector。

uiautomatorviewer是android-sdk自帶的一個元素定位工具,非常簡單好用,使用uiautomatorviewer,你可以檢查一個應用的UI來查看應用的布局和組件以及相關的屬性。

  那麼宏哥先來給各位小夥伴們介紹大哥–uiautomatorviewer,再來介紹小弟–Inspector。

一、大哥–uiautomatorviewer

  大哥人物簡介:

  大哥是皇族後裔,但是比劉皇叔強多了。人家有一個好爹–Google。

  Android 4.1發布的,uiautomator是用來做UI測試的。也就是普通的手工測試,點擊每個控件元素 看看輸出的結果是否符合預期。比如 登陸界面 分別輸入正確和錯誤的用戶名密碼然後點擊登陸按鈕看看是否能否登陸以及是否有錯誤提示等。

功能性或者黑盒UI測試不需要測試人員了解程序如何實現的,只需要驗證各種操作的結果是否符合預期即可。這樣的測試可以分離團隊的開發人員和測試人員。大家各干各的沒有太多的交集。

  常用的UI測試方式就是人工驗證啦,就是測試人員拿着各種手機分別安裝要測試的程序然後看看是否能正確完成各種預定的功能。但是這種驗證方式是非常耗時間的,每次回歸都要全部驗證一邊,並且還容易出現人為錯誤。比較高效和可靠的UI測試方式就是自動化測試。自動化UI測試創建測試代碼來執行測試任務,各種測試任務分別覆蓋不同的使用場景,然後使用測試框架來運行這些測試任務。而uiautomator 就是你的自動化UI測試工具。

Android SDK在4.1中提供了如下工具來支持UI自動化測試:

  • uiautomatorviewer – 一個圖形界面工具來掃描和分析應用的UI控件。
  • uiautomator – 一個測試的Java庫,包含了創建UI測試的各種API和執行自動化測試的引擎。

要大哥出山也就是使用該工具,需要滿足如下條件:

  • Android SDK Tools, Revision 21 or higher
  • Android SDK Platform, API 16 or higher

一、啟動uiautomatorviewer.bat

兩種啟動方法:

第一種方法:

1、打開目錄D:\software\android-sdk-windows\tools


2、雙擊啟動,啟動之後出現如下界面


第二種方法:

1、如果不喜歡雙擊啟動的話,也可以在cmd裏面通過指令啟動

先cd到tools目錄下,然後輸入uiautomatorviewer.bat回車后啟動服務

二、連接手機

1、cmd打開輸入adb devices,確認手機已連上(以夜神模擬器為例)


2、打開手機淘寶頁面,讓屏幕處於點亮狀態


3、點左上角安卓機器人按鈕Devices Screenshot按鈕刷新頁面


三、定位元素

1、移動鼠標到需要定位的元素上,如搜索輸入框


2、右下角可以看到元素對應的屬性

text:好沙發需要好坐墊

resource-id:com.taobao.taobao:id/home_searchedit

class:android.widget.EditText

四、點搜索框

1、前面一篇啟動app后,休眠五秒,等待頁面加載完成

2、通過id來定位到搜索框,然後點擊


五、參考代碼

# coding=utf-8
# 1.先設置編碼,utf-8可支持中英文,如上,一般放在第一行

# 2.註釋:包括記錄創建時間,創建人,項目名稱。
'''
Created on 2019-6-24
@author: 北京-宏哥   QQ交流群:707699217
Project:學習和使用定位元素工具
'''
# 3.導入模塊
from appium import webdriver
import time
desired_caps = {}
desired_caps['platformName'] = 'Android'   #android的apk還是IOS的ipa
desired_caps['platformVersion'] = '8.0'  #android系統的版本號
desired_caps['deviceName'] = '127.0.0.1:62001'    #手機設備名稱,通過adb devices  查看
desired_caps['appPackage'] = 'com.taobao.taobao'  #apk的包名
desired_caps['appActivity'] = 'com.taobao.tao.welcome.Welcome'  #apk的launcherActivity
#desired_caps['unicodeKeyboard'] = True   #使用unicodeKeyboard的編碼方式來發送字符串
#desired_caps['resetKeyboard'] = True   #將鍵盤給隱藏起來
driver = webdriver.Remote('http://127.0.0.1:4723/wd/hub', desired_caps) #啟動服務器地址,後面跟的是手機信息
# 休眠五秒等待頁面加載完成
time.sleep(5)

driver.find_element_by_id("com.taobao.taobao:id/home_searchedit").click()

# driver.quit()


六、元素定位

1、appium的webdriver提供了11種元素定位方法,在selenium的基礎上擴展了三個,可以在pycharm裏面輸入driver.find_element_by然後會自動匹配出來


2、多的三種如下,在後面的會詳細介紹

driver.find_element_by_accessibility_id()

driver.find_element_by_android_uiautomator()

driver.find_element_by_ios_uiautomation()

(第三個是ios的可以暫時不用管)

二、小弟–Inspector

   小弟人物簡介:

  小弟不是很牛叉,但是小弟的存在必定有小弟存在的必要,之前看了好多文章都要放棄小弟,我覺地不要放棄,沒準小弟可以替大哥大哥擋刀呢,呵呵,說笑了,畢竟過河的卒子可以當車!!!

  Appium Inspector是appium自帶的一個元素定位工具,前邊介紹了如何使用uiautomatorviewer進行元素定位。這裏就學習Appium Inspector是如何定位的。

  Appium Inspector 對於測試的同學不得不說是一個神器,可以查詢到我們需要定位的元素的 id 等各種信息 ,還可以 錄製用戶行為,翻譯成腳本。逆天的是可以翻譯成多種語言的腳本。這並不意味着測試的同學可以不用學習語言和編程了,因為機器翻譯出的腳本一般很難一次執行成功,其中很可能還需要經過人工修改后才能順利執行,但是這已經可以為測試腳本的編寫帶來很大的遍歷,所以 Appium Inspector 還是值得我們去學習和使用。

一、設置appium

1、先不要啟動appium,因為啟動以後就不能操作appium設置界面,必須在未啟動的時候進行操作

2、點開android setting界面(機器人圖標)

3、勾選Application Path,添加被測app的路徑

4、Devices name處添加設備名稱(adb devices查看到的)


(注意:通過這種方法也可查看到apk的包名和Launch Activity)


二、開啟appium

1、手機確保連接電腦(adb devices查看)(仍然以夜神模擬器為例)


2、點appium右上角三角形圖標,會啟動服務


3、這時候可以看到手機上安裝淘寶應用,並會啟動淘寶

4、點appium右上角的搜索圖標


5、點Inspector Window界面的 Refresh 按鈕刷新界面


三、Ispector Window

1、手機上打開需要單位元素的界面,然後點Refresh按鈕刷新

2、左邊菜單樹,可以挨個點開

3、如果想單位界面上的“是”和“否”按鈕,從菜單樹就可以看到這兩個元素的結構

四、查看屬性

1、選中左側菜單樹對應的元素,在右下角查看對應屬性


五、常見異常

1、在使用過程中,你會發現經常會報以下這個錯誤

2、每次啟動都會給你手機上重新安裝一次應用

3、並且不能用鼠標指定某個元素,沒有uiautomatorviewer使用方便

(要是以上三種問題你都遇到了,怎麼辦???那就放棄吧!!!)​

相信很多人在使用過程中,都會遇到中文無法輸入問題,宏哥在後續文章里會手把手教大家如何輸入中文。

三、小結

Android SDK中的UIAutomator中本身是不支持網頁中的UI元素定位,下面介紹幾種常用的定位app內部的網頁的UI元素的方法。

一、使用chrome瀏覽器調試移動端網頁

       這是使用最多的一種方法。首頁確保自己的手機已經跟電腦連接且處於開發者模式。

       打開PC端的谷歌瀏覽器,輸入chrome://inspect/#devices,會看到下圖所示界面:


     點擊需要測試的網頁下方的inspect,且保證手機界面停留在那個頁面。


      這樣打開后是不是就熟悉了,點擊上方紅色標記的就可以操作進行定位了~~~


 二、Android手機的鋪助功能帶有TalkBack

        之前一直用的是谷歌的方法,但是最近發現使用talkback可以直接用UIAutomator定位元素。  

        Android系統一般自帶一個TalkeBack功能。但這裏千萬要注意:打開之後整個系統的操作都變得不同了!!滑動界面需要兩個手指,單擊變成雙擊。打開之後用UiAutomatorViewer獲取webview界面的內容,你就會發現原來webview裏面獲取不到的ui元素,現在已經可以可以獲取到了。即使現在你關掉TalkBack,也能獲取到,除非重啟手機才會回到不能獲取的狀態,所以開啟后我們可以立即關閉,以方便操作。有些手機沒有talkBack的可以去應用市場下載。

       功能路徑:
       原生系統:設置 – 輔助功能(Accessibility) – TalkBack
       華為EMUI系統:設置 – 高級設置 – 輔助功能 – TalkBack

三、宏哥在小弟哪裡遇到的問題


查看appium日誌的error發現沒有設備名字報錯


將夜神模擬器的名字加上就成功了

宏哥不能保證所整理都符合大家的口味,但我能保證每一篇都是用心去寫和用心去整理,我始終認同“分享的越多,你的價值增值越大”,歡迎大家關注我的博客和個人公眾號的技術分享。在分享中進步,越努力越幸運,期待我們都有美好的明天!

支持宏哥的朋友們和宏哥的宏粉記得點波推薦哦,您的肯定就是我進步的動力。鄙人先在這裏給您道謝了,謝您嘞~~

個人公眾號(因為許多文章都被搬到別人的公眾號里了,還是原創,所以宏哥果斷也開一個公眾號。打算與博客園文章同步,希望大家隨時隨地學習與進步):

微信群(因為有人給我發短消息說公司不讓用QQ,就幫忙建立一個微信群,歡迎加入討論和交流)


我的博客即將同步至騰訊雲+社區,邀請大家一同入駐:https://cloud.tencent.com/developer/support-plan?invite_code=2k3h2stkvscgc

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

大量文件名記錄的樹形結構存儲

十多年來,NAS中已經存在的目錄和文件達到10億之多,在設計和開發備份系統的過程中碰到了很多挑戰,本文將分享大量文件名記錄的樹形結構存儲實踐。

一、引言

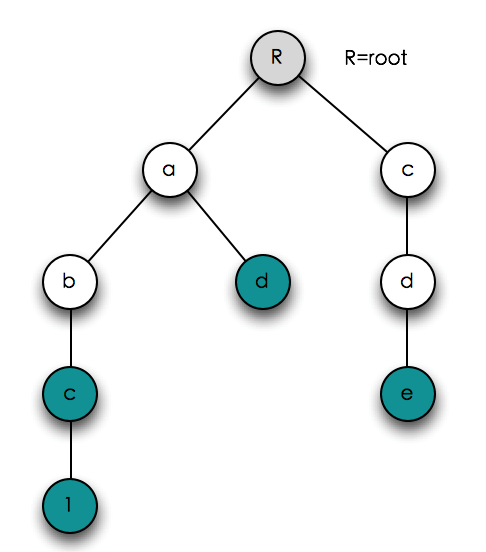
既然是定期備份,肯定會有1次以上的備份。對於一個特定目錄,每次備份時都要與上次備份時進行比較,以期找出哪些文件被刪除了,又新增了哪些文件,這就需要每次備份時把該目錄下的所有文件名進行保存。我們首先想到的是把所有文件名用特定字符進行拼接后保存。由於我們使用了MySQL保存這些信息,當目錄下文件很多時,這種拼接的方式很可能超出MySQL的Blob長度限制。根據經驗,當一個目錄有大量文件時,這些文件的名稱往往是程序生成的,有一定規律的,而且開頭一般是重複的,於是我們想到了使用一種樹形結構來進行存儲。

例如,一個有abc、abc1、ad、cde 4個文件的目錄對應的樹如圖1所示。

圖1 樹形結構示例

圖1中,R表示根節點,青色節點我們稱為結束節點,從R到每個結束節點的路徑都表示一個文件名。可以在樹中查找是否含有某個文件名、遍歷樹中所有的文件名、對樹序列化進行保存、由序列化結果反序列化重新生成樹。

二、涉及的數據結構

注意:我們使用java編寫,文中涉及語言特性相關的知識點都是指java。

2.1 Node的結構

包括根節點在內的每個節點都使用Node類來表示。代碼如下:

 class Node {
        private char value;
        private Node[]children = new Node[0];
        private byte end = 0;
    }


字段說明:

  • value:該節點表示的字符,當Node表示根節點時,value無值。
  • children:該節點的所有子節點,初始化為長度為0的數組。
  • end:標記節點是否是結束節點。0不是;1是。恭弘=恭弘=恭弘=叶 恭弘 恭弘 恭弘子節點肯定是結束節點。默認非結束節點。

2.2 Node的操作

   public Node(char v);
    public Node findChild(char v);
    public Node addChild(char v);


操作說明:

  • Node:構造方法。將參數v賦值給this.value。
  • findChild:查找children中是否含有value為v的子節點。有則返回子節點,沒有則返回null。
  • addChild:首先查找children中是否已經含有value為v的子節點,如果有則直接將查到的子節點返回;否則創建value為v的節點,將children的長度延長1,將新創建的節點作為children的最後一個元素,並返回新創建的節點。

2.3 Tree的結構

  class Tree {
        public Node root = new Node();
    }


字段說明:Tree只含有root Node。如前所述,root的value無值,end為0。初始時的children長度為0。

2.4 Tree的操作

  public void addName(String name) ;
    public boolean contain(String name);
    public Found next(Found found);
    public void writeTo(OutputStream out);
    public static Tree readFrom(InputStream in);


操作說明:

  • addName:向樹中增加一個新的文件名,即參數name。以root為起點,name中的每個字符作參數調用addChild,返回值又作為新的起點,直到name中的全部字符添加完畢,對最後一次調用addChild的返回值標記為結束節點。
  • contain:查詢樹中是否含有一個文件名。
  • next:對樹中包含的所有文件名進行遍歷,為了使遍歷能夠順利進行,我們引入了新的類Found,細節會在後文詳述。
  • writeTo:將樹寫入一個輸出流以進行持久化。
  • readFrom:此方法是靜態方法。從一個輸入流來重新構建樹。

三、樹的構建

在新建的Tree上調用addName方法,將所有文件名添加到樹中,樹構建完成。仍然以含有abc、abc1、ad、cde 四個文件的目錄為例,對樹的構建進行圖示。

圖2 樹的構建過程

圖2中,橙色節點表示需要在該節點上調用addChild方法增加子節點,同時addChild的返回值作為新的橙色節點。直到沒有子節點需要增加時,把最後的橙色節點標記為結束節點。

四、樹的查詢

查找樹中是否含有一個某個文件名,對應Tree的contain方法。在圖2中的結果上分別查找ef、ab和abc三個文件來演示查找的過程。如圖3所示。

圖3 樹的查詢示意圖

圖3中,橙色節點表示需要在該節點上調用findChild方法查找子節點。

五、樹的遍歷

此處的遍歷不同於一般樹的遍歷。一般遍歷是遍歷樹中的節點,而此處的遍歷是遍歷根節點到所有結束節點的路徑。

我們採用從左到右、由淺及深的順序進行遍歷。我們引入了Found類,並作為next方法的參數進行遍歷。

5.1 Found的結構

 class Found {    
        private String name;
        private int[] idx ;
    }


為了更加容易的說明問題,在圖1基礎上進行了小小的改造,每個節點的右下角增加了下標,如圖4。

圖4 帶下標的Tree

對於abc這個文件名,Found中的name值為“abc”,idx為{0,0,0}。

對於abc1這個文件名,Found中的name值為“abc1”,idx為{0,0,0,0}。

對於ad這個文件名,Found中的name值為“ad”,idx為{0,1}。

對於cde這個文件名,Found中的name值為“cde”,idx為{1,0,0}。

5.2 如何遍歷

對於圖4而言,第一次調用next方法應傳入null,則返回第一個結果,即abc代表的Found;繼續以這個Found作為參數進行第二次next的調用,則返回第二個結果,即abc1代表的Found;再繼續以這個Found作為參數進行第三次next的調用,則返回第三個結果,即ad所代表的Found;再繼續以這個Found作為參數進行第四次next的調用,則返回第四個結果,即cde所代表的Found;再繼續以這個Found作為參數進行第五次調用,則返回null,遍歷結束。

六、序列化與反序列化

6.1 序列化

首先應該明確每個節點序列化后應該包含3個信息:節點的value、節點的children數量和節點是否為結束節點。

6.1.1 節點的value

雖然之前所舉的例子中節點的value都是英文字符,但實際上文件名中可能含有漢字或者其他語言的字符。為了方便處理,我們沒有使用變長編碼。而是直接使用unicode碼。字節序採用大端編碼。

6.1.2 節點的children數量

由於節點的value使用了unicode碼,所以children的數量不會多於unicode能表示的字符的數量,即65536。children數量使用2個字節。字節序同樣採用大端編碼。

6.1.3 節點的end

0或1可以使用1位(1bit)來表示,但java中最小單位是字節。如果採用1個字節來表示end,有些浪費空間,其實任何一個節點children數量達到65536/2的可能性都是極小的,因此我們考慮借用children數量的最高位來表示end。

綜上所述,一個節點序列化后佔用4個字節,以圖4中的根節點、value為b的節點和value為e的節點為例:

表1 Node序列化示例

  value的unicode children數量 end children數量/(end<<15) 最終結果
根節點 0x0000 2 0 0x0002 0x00020000
b節點 0x0062 1 0 0x0001 0x00010062
e節點 0x0065 0 1 0x8000 0x80000065

6.1.4 樹的序列化過程

對樹進行廣度遍歷,在遍歷過程中需要藉助隊列,以圖4的序列化為例進行說明: 

圖5 對圖4的序列化過程

6.2 反序列化

反序列化是序列化的逆過程,由於篇幅原因不再進行闡述。值得一提的是,反序列化過程同樣需要隊列的協助。

七、討論

7.1 關於節省空間

為方便討論,假設目錄下的文件名是10個阿拉伯数字的全排列,當位數為1時,目錄下含有10個文件,即0、1、2……8、9,當位數為2時,目錄下含有100個文件,即00、01、02……97、98、99,以此類推。

比較2種方法,一種使用“/”分隔,另一種是本文介紹的方法。

表2 2種方法的存儲空間比較(單位:字節)

位數 方法 1 2 3 4 5 6
“/”分隔 19 299 3999 49999 599999 6999999
Tree 44 444 4444 44444 444444 4444444

由表2可見,當位數為4時,使用Tree的方式開始節省空間,位數越多節省的比例越高,這正是我們所需要的。

表中,使用“/”分隔時,字節數佔用是按照utf8編碼計算的。如果直接使用unicode進行存儲,佔用空間會加倍,那麼會在位數為2時就開始節省空間。同樣使用“/”分隔,看起來utf8比使用unicode會更省空間,但實際上,文件名中有時候會含有漢字,漢字的utf8編碼佔用3個字節。

7.2 關於時間

在樹的構建、序列化反序列化過程中,引入了額外的運算,根據我們的實踐,user CPU並沒有明顯變化。

7.3 關於理想化假設

最初我們就是使用了“/”分隔的方法對文件名進行存儲,並且數據庫的相應字段類型是Blob(Blob的最大值是65K)。在測試階段就發現,超出65K是一件很平常的事情。在不可能預先統計最大目錄里所有文件名拼接后的大小的情況下,我們採取了2種手段,一是使用LongBlob類型,另一種就是盡量減小拼接結果的大小,即本文介紹的方法。

即使使用樹形結構來存儲文件名,也不能夠保證最終結果不超出4G(LongBlob類型的最大值),至少在我們實踐的過程並未出現問題,如果真出現這種情況,只能做特殊處理了。

7.4 關於其他壓縮方法

把文件名使用“/”拼接后,使用gzip等壓縮算法對拼接結果進行壓縮后再存儲,在節省存儲空間方面會取得更好的效果。但是在壓縮之前,拼接結果存在於內存,這樣對JVM的堆內存有比較高的要求;另外,使用“/”拼接時,查找會比較麻煩。

作者:牛寧昌

來源:宜信技術學院

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!
實際項目中,看 ECharts 和 HighCharts 渲染性能對比,表面看衣裝,本質看內功!!!

     最近做項目,使用的是echarts显示圖表數據,但是數據量比較多的時候,有卡頓的情況。後來同事拿echarts和HighCharts做了對比,僅供大家參考。同時感謝同事做的工作。

一、查詢1天的源數據,屬性1、屬性2、屬性3、屬性4

       Echarts查詢3.61s,渲染0.786s(約8.6M數據)

       HighCharts查詢3.10s,渲染0.768s(約8.7M數據)

二、查詢7天的源數據,屬性1、屬性2、屬性3、屬性4

      Echarts查詢21.67秒,渲染5.38秒。(約60.7M數據)。渲染完成后

      HighCharts查詢22.18s,渲染5.39s。(約60.5M數據)

三、查詢14天的源數據,屬性1、屬性2、屬性3、屬性4

      Echarts渲染不出來,瀏覽器崩潰。

      HighCharts查詢41.42s,渲染10.82s。(約121M數據)

四、內存佔用對比:7天數據

      Echarts渲染后瀏覽器佔用內存約3280M。

      HighCharts渲染后瀏覽器佔用內存約637M。

五、操作對比

圖表類型

1天數據

7天數據

14天數據

Echarts

卡頓

無法操作

瀏覽器崩潰

HighCharts

流暢

流暢

流暢


雲端操作系統:http://www.ineuos.net

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"