你知道和你不知道的冒泡排序

這篇文章包含了你一定知道的,和你不一定知道的冒泡排序。

gif看不了可以點擊【原文】查看gif。

1. 什麼是冒泡排序

可能對於大多數的人來說比如我,接觸的第一個算法就是冒泡排序。

我看過的很多的文章都把冒泡排序描述成我們喝的汽水,底部不停的有二氧化碳的氣泡往上冒,還有描述成魚吐泡泡,都特別的形象。

其實結合一杯水來對比很好理解,將我們的數組豎著放進杯子,數組中值小的元素密度相對較小,值大的元素密度相對較大。這樣一來,密度大的元素就會沉入杯底,而密度小的元素會慢慢的浮到杯子的最頂部,稍微專業一點描述如下。

冒泡算法會運行多輪,每一輪會依次比較數組中相鄰的兩個元素的大小,如果左邊的元素大於右邊的元素,則交換兩個元素的位置。最終經過多輪的排序,數組最終成為有序數組。

2. 排序過程展示

我們先不聊空間複雜度和時間複雜度的概念,我們先通過一張動圖來了解一下冒泡排序的過程。

這個圖形象的還原了密度不同的元素上浮和下沉的過程。

3. 算法V1

3.1 代碼實現

private void bubbleSort(int[] arr) {
  for (int i = 0; i < arr.length; i++) {
    for (int j = 0; j < arr.length - 1; j++) {
      if (arr[j] > arr[j + 1]) {
        exchange(arr, j, j + 1);
      }
    }
  }
}

private void exchange(int arr[], int i, int j) {
  int temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

int[] arr = new int[]{5, 1, 3, 7, 6, 2, 4};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]

3.2 實現分析

各位大佬看了上面的代碼之後先別激動,坐下坐下,日常操作。可能很多的第一個冒泡排序算法就是這麼寫的,比如我,同時還自我感覺良好,覺得算法也不過如此。

我們還是以數組[5, 1, 3, 7, 6, 2, 4]為例,我們通過動圖來看一下過程。

思路很簡單,我們用兩層循環來實現冒泡排序。

  • 第一層,控制冒泡排序總共執行的輪數,例如例子數組的長度是7,那麼總共需要執行6輪。如果長度是n,則需要執行n-1輪
  • 第二層,負責從左到右依次的兩兩比較相鄰元素,並且將大的元素交換到右側

這就是冒泡排序V1的思路。

下錶是通過對一個0-100000的亂序數組的標準樣本,使用V1算法進行排序所總共執行的次數,以及對同一個數組執行100次V1算法的所花的平均時間。

算法執行情況 結果
樣本 [0 – 100000] 的亂序數組
算法 V1 執行的總次數 99990000 次(9999萬次)
算法 V1 運行 100 次的平均時間 181 ms

4. 算法V2

4.1 實現分析

仔細看動圖我們可以發現,每一輪的排序,都從數組的最左端再到最右。而每一輪的冒泡,都可以確定一個最大的數,固定在數組的最右邊,也就是密度最大的元素會冒泡到杯子的最上面。

還是拿上面的數組舉例子。下圖是第一輪冒泡之後數組的元素位置。

第二輪排序之後如下。

可以看到,每一輪排序都會確認一個最大元素,放在數組的最後面,當算法進行到後面,我們根本就沒有必要再去比較數組後面已經有序的片段,我們接下來針對這個點來優化一下。

4.2 代碼實現

這是優化之後的代碼。

private void bubbleSort(int[] arr) {
  for (int i = 0; i < arr.length - 1; i++) {
    for (int j = 0; j < arr.length - 1 - i; j++) {
      if (arr[j] > arr[j + 1]) {
        exchange(arr, j, j + 1);
      }
    }
  }
}

private void exchange(int arr[], int i, int j) {
  int temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

int[] arr = new int[]{5, 1, 3, 7, 6, 2, 4};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]

優化之後的實現,也就變成了我們動圖中所展示的過程。

每一步之後都會確定一個元素在數組中的位置,所以之後的每次冒泡的需要比較的元素個數就會相應的減1。這樣一來,避免了去比較已經有序的數組,從而減少了大量的時間。

算法執行情況 結果
樣本 [0 – 10000] 的亂序數組
算法 V2 執行的總次數 49995000 次(4999萬次)
算法 V2 運行 100 次的平均時間 144 ms
運行時間與 V1 對比 V2 運行時間減少 20.44 %
執行次數與 V1 對比 V2 運行次數減少 50.00 %

可能會有人看到,時間大部分已經會覺得滿足了。從數據上看,執行的次數減少了50%,而運行的時間也減少了20%,在性能上已經是很大的提升了。而且已經減少了7億次的執行次數,已經很NB了。 那是不是到這就已經很完美了呢?

答案是No。

4.3 哪裡可以優化

同理,我們還是拿上面長度為7的數組來舉例子,只不過元素的位置有所不同,假設數組的元素如下。

[7, 1, 2, 3, 4, 5, 6]

我們再來一步一步的執行V2算法, 看看會發生什麼。

第一步執行完畢后,數組的情況如下。

繼續推進,當第一輪執行完畢后,數組的元素位置如下。

這個時候,數組已經排序完畢,但是按照目前的V2邏輯,仍然有5輪排序需要繼續,而且程序會完整的執行完5輪的排序,如果是100000輪呢?這樣將會浪費大量的計算資源。

5. 算法V3

5.1 代碼實現

private void bubbleSort(int[] arr) {
  for (int i = 0; i < arr.length - 1; i++) {
    boolean flag = true;
    for (int j = 0; j < arr.length - 1 - i; j++) {
      if (arr[j] > arr[j + 1]) {
        flag = false;
        exchange(arr, j, j + 1);
      }
    }
    if (flag) {
      break;
    }
  }
}

private void exchange(int arr[], int i, int j) {
  int temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

int[] arr = new int[]{5, 1, 3, 7, 6, 2, 4};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]

5.2 實現分析

我們在V2代碼的基礎上,在第一層循環,也就是控制總冒泡輪數的循環中,加入了一個標誌為flag。用來標示該輪冒泡排序中,數組是否是有序的。每一輪的初始值都是true。

當第二層循環,也就是冒泡排序的元素兩兩比較完成之後,flag的值仍然是true,則說明在這輪比較中沒有任何元素被交換了位置。也就是說,數組此時已經是有序狀態了,沒有必要再執行後續的剩餘輪數的冒泡了。

所以,如果flag的值是true,就直接break了(沒有其他的操作return也沒毛病)。

算法執行情況 結果
樣本 [0 – 10000] 的亂序數組
算法 V3 執行的總次數 49993775 次
算法 V3 運行 100 次的平均時間 142 ms
運行時間與 V2 對比 V3 運行時間減少 00.00 %
執行次數與 V2 對比 V3 運行次數減少 00.00 %

5.3 數據分析

大家看到數據可能有點懵逼。

你這個優化之後,運行時間執行次數都沒有減少。你這優化的什麼東西?

其實,這就要說到算法的適用性了。V3的優化是針對原始數據中存在一部分或者大量的數據已經是有序的情況,V3的算法對於這樣的樣本數據才最適用。

其實是我們還沒有到優化這種情況的那一步,但是其實仍然有這樣的說法,面對不同的數據結構,幾乎沒有算法是萬能的

而目前的樣本數據仍然是隨機的亂序數組,所以並不能發揮優化之後的算法的威力。所謂對症下藥,同理並不是所有的算法都是萬能的。對於不同的數據我們需要選擇不同的算法。例如我們選擇[9999,1,2,…,9998]這行的數據做樣本來分析,我們來看一下V3算法的表現。

算法執行情況 結果
樣本 [0 – 10000] 的亂序數組
算法 V3 執行的總次數 19995 次
算法 V3 運行 100 次的平均時間 1 ms
運行時間與 V3 亂序樣例對比 V3 運行時間減少 99.96 %
執行次數與 V3 亂序樣例對比 V3 運行次數減少 99.29 %

可以看到,提升非常明顯。

5.4 適用情況

當冒泡算法運行到後半段的時候,如果此時數組已經有序了,需要提前結束冒泡排序。V3針對這樣的情況就特別有效。

6. 算法V4

嗯,什麼?為什麼不是結束語?那是因為還有一種沒有考慮到啊。

6.1 適用情況總結

我們總結一下前面的算法能夠處理的情況。

  • V1:正常亂序數組
  • V2:正常亂序數組,但對算法的執行次數做了優化
  • V3:大部分元素已經有序的數組,可以提前結束冒泡排序

還有一種情況是冒泡算法的輪數沒有執行完,甚至還沒有開始執行,後半段的數組就已經有序的數組,例如如下的情況。

這種情況,在數組完全有序之前都不會觸發V3中的提前停止算法,因為每一輪都有交換存在,flag的值會一直是true。而下標2之後的所有的數組都是有序的,算法會依次的冒泡完所有的已有序部分,造成資源的浪費。我們怎麼來處理這種情況呢?

6.2 實現分析

我們可以在V3的基礎之上來做。

當第一輪冒泡排序結束后,元素3會被移動到下標2的位置。在此之後沒有再進行過任意一輪的排序,但是如果我們不做處理,程序仍然會繼續的運行下去。

我們在V3的基礎上,加上一個標識endIndex來記錄這一輪最後的發生交換的位置。這樣一來,下一輪的冒泡就只冒到endIndex所記錄的位置即可。因為後面的數組沒有發生任何的交換,所以數組必定有序。

6.3 代碼實現

private void bubbleSort(int[] arr) {
  int endIndex = arr.length - 1;
  for (int i = 0; i < arr.length - 1; i++) {
    boolean flag = true;
    int endAt = 0;
    for (int j = 0; j < endIndex; j++) {
      if (arr[j] > arr[j + 1]) {
        flag = false;
        endAt = j;
        exchange(arr, j, j + 1);
      }
    }
    endIndex = endAt;
    if (flag) {
      break;
    }
  }
}

private void exchange(int arr[], int i, int j) {
  int temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

int[] arr = new int[]{5, 1, 3, 7, 6, 2, 4};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]

7. 算法V5

這一節仍然不是結束語…

7.1 算法優化

我們來看一下這種情況。

對於這種以上的算法都將不能發揮其應有的作用。每一輪算法都存在元素的交換,同時,直到算法完成以前,數組都不是有序的。但是如果我們能直接從右向左冒泡,只需要一輪就可以完成排序。這就是雞尾酒排序,冒泡排序的另一種優化,其適用情況就是上圖所展示的那種。

7.2 代碼實現

private void bubbleSort(int[] arr) {
  int leftBorder = 0;
  int rightBorder = arr.length - 1;

  int leftEndAt = 0;
  int rightEndAt = 0;

  for (int i = 0; i < arr.length / 2; i++) {
    boolean flag = true;
    for (int j = leftBorder; j < rightBorder; j++) {
      if (arr[j] > arr[j + 1]) {
        flag = false;
        exchange(arr, j, j + 1);
        rightEndAt = j;
      }
    }
    rightBorder = rightEndAt;
    if (flag) {
      break;
    }

    flag = true;
    for (int j = rightBorder; j > leftBorder; j--) {
      if (arr[j] < arr[j - 1]) {
        flag = false;
        exchange(arr, j, j - 1);
        leftEndAt = j;
      }
    }
    leftBorder = leftEndAt;
    if (flag) {
      break;
    }
  }
}

private void exchange(int arr[], int i, int j) {
  int temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

int[] arr = new int[]{2, 3, 4, 5, 6, 7, 1};
bubbleSort(arr);
System.out.println(Arrays.toString(arr)); // [1, 2, 3, 4, 5, 6, 7]

7.3 實現分析

第一層循環同樣用於控制總的循環輪數,由於每次需要從左到右再從右到左,所以總共的輪數是數組的長度 / 2。

內存循環則負責先實現從左到右的冒泡排序,再實現從右到左的冒泡,並且同時結合了V4的優化點。

我們來看一下V5與V4的對比。

算法執行情況 結果
樣本 [2,3,4…10000,1] 的數組
算法 V5 執行的總次數 19995 次
算法 V5 運行 100 次的平均時間 1 ms
運行時間與 V4 對比 V5 運行時間減少 99.97 %
執行次數與 V4 對比 V5 運行次數減少 99.34 %

8. 總結

以下是對同一個數組,使用每一種算法對其運行100次的平均時間和執行次數做的的對比。

[0 – 10000] 的亂序數組 V1 V2 V3 V4 V5
執行時間(ms) 184 142 143 140 103
執行次數(次) 99990000 49995000 49971129 49943952 16664191
大部分有序的情況 V1 V2 V3 V4 V5
執行時間(ms) 181 141 146 145 107
執行次數(次) 99990000 49995000 49993230 49923591 16675618

而冒泡排序的時間複雜度分為最好的情況和最快的情況。

  • 最好的情況為O($n$). 也就是我們在V5中提到的那種情況,數組2, 3, 4, 5, 6, 7, 1。使用雞尾酒算法,只需要進行一輪冒泡,即可完成對數組的排序。
  • 最壞的情況為O($n^2$).也就是V1,V2,V3和V4所遇到的情況,幾乎大部分數據都是無序的。

往期文章:

  • 聊聊微服務集群當中的自動化工具
  • go源碼解析-Println的故事
  • 用go-module作為包管理器搭建go的web服務器
  • WebAssembly完全入門——了解wasm的前世今身
  • 小強開飯店-從單體應用到微服務

相關:

  • 微信公眾號: SH的全棧筆記(或直接在添加公眾號界面搜索微信號LunhaoHu)

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

redis的五種數據類型及應用場景

前言

redis是用鍵值對的形式來保存數據,鍵類型只能是String,但是值類型可以有String、List、Hash、Set、Sorted Set五種,來滿足不同場景的特定需求。

本博客中的示例不是將控制台作為redis的一個客戶端,而是將redis運用在java里進行測試

需要有java redis的驅動包,可以通過引入maven的依賴即可

        <dependency>
            <groupId>org.rarefiedredis.redis</groupId>
            <artifactId>redis-java</artifactId>
            <version>0.0.17</version>
        </dependency>


String

String類型是最基礎的一種key-value存儲形式,value其實不僅僅可以是String,也可以是數值類型。常常用來做計數器這類自增自減的功能,可用在粉絲數、微博數等。

示例

 1         //連接本地的 Redis 服務
 2         Jedis jedis = new Jedis("localhost");
 3         System.out.println("連接成功");
 4         //查看服務是否運行
 5         System.out.println("服務正在運行: "+jedis.ping());
 6         //String實例
 7         jedis.set("hello", String.valueOf(1));
 8         jedis.incr("hello");
 9         jedis.set("hello1","word1");
10         System.out.println(jedis.get("hello"));
11         System.out.println(jedis.mget("hello","hello1"));

常用命令

  • set
  • get
  • mget
  • incr
  • decr


List

list就是鏈表,在redis實現為一個雙向鏈表,可以從兩邊插入、刪除數據。應用場景可以有微博的關注列表、粉絲列表、消息列表等。

有一個lrange函數,可以從某個元素開始讀取多少個元素,可用來實現分頁功能。

示例

 1         /*list實例,雙向鏈表結構,適合做消息隊列,
 2         但其實真正應用中一般都會用專門做消息隊列的中間件例如RabbitMQ*/
 3         jedis.lpush("201宿舍","hlf");
 4         jedis.lpush("201宿舍","css");
 5         jedis.lpush("201宿舍","ty");
 6         jedis.lpush("201宿舍","jy");
 7         List<String> name = jedis.lrange("201宿舍",0,3);
 8         for (String person:name
 9              ) {
10             System.out.print(person+" ");
11         }


常用命令

  •  lpush
  • rpush
  • lpush
  • lpop
  • lrange


Hash

hash就是值類型存儲的是一個鍵值對形式,適合存儲對象類型信息,例如個人信息、商品信息等。

示例

 1         //hash實例,適合存儲對象
 2         HashMap<String,String> map = new HashMap<String, String>();
 3         map.put("name","hlf");
 4         map.put("sex","女");
 5         map.put("age","21");
 6         jedis.hmset("hlf",map);
 7         jedis.hset("hlf","major","software");
 8         Map<String,String> map1 = jedis.hgetAll("hlf");
 9         String age = jedis.hget("hlf","age");
10         System.out.println(map1);
11         System.out.println(age);


常用命令

  • hset
  • hmset
  • hget
  • hgetAll


Set

set表示存儲的一個元素不重合的集合,因為set集合支持查緝、並集操作,因此適合做共同好友等功能

示例

1         //set實例
2         jedis.sadd("set","hhh");
3         jedis.sadd("set","ff");
4         jedis.sadd("set","hhh");
5         System.out.println(jedis.smembers("set"));
6         jedis.sadd("set1","oo");
7         jedis.sadd("set1","ff");
8         System.out.println("交集:"+jedis.sinter("set","set1"));
9         System.out.println("合集:"+jedis.sunion("set","set1"));


常用命令

  • sadd
  • spop
  • smembers
  • sunion
  • sinter


Sorted Set

相對於Set,Sorted Set多了一個Score作為權重,使集合裏面的元素可以按照score排序,注意它是Set,所以它裏面的元素也不能重複

示例

        //sorted set實例
        jedis.zadd("set2",4,"redis");
        jedis.zadd("set2",3,"mysql");
        jedis.zadd("set2",2,"kk");
        jedis.zadd("set2",1,"redis");
        System.out.println(jedis.zrangeByScore("set2",0,4));


常用命令

  • zadd
  • zpop
  • zrangeByScore


【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

高級Java工程師必備 —– 深入分析 Java IO (二)NIO

接着上一篇文章 高級Java工程師必備 —– 深入分析 Java IO (一)BIO,我們來講講NIO

多路復用IO模型

場景描述

一個餐廳同時有100位客人到店,當然到店后第一件要做的事情就是點菜。但是問題來了,餐廳老闆為了節約人力成本目前只有一位大堂服務員拿着唯一的一本菜單等待客人進行服務。

方法A: 無論有多少客人等待點餐,服務員都把僅有的一份菜單遞給其中一位客人,然後站在客人身旁等待這個客人完成點菜過程。在記錄客人點菜內容后,把點菜記錄交給後堂廚師。然後是第二位客人。。。。然後是第三位客人。很明顯,只有腦袋被門夾過的老闆,才會這樣設置服務流程。因為隨後的80位客人,再等待超時后就會離店(還會給差評)。

方法B: 老闆馬上新雇傭99名服務員,同時印製99本新的菜單。每一名服務員手持一本菜單負責一位客人(關鍵不只在於服務員,還在於菜單。因為沒有菜單客人也無法點菜)。在客人點完菜后,記錄點菜內容交給後堂廚師(當然為了更高效,後堂廚師最好也有100名)。這樣每一位客人享受的就是VIP服務咯,當然客人不會走,但是人力成本可是一個大頭哦(虧死你)。

方法C: 就是改進點菜的方式,當客人到店后,自己申請一本菜單。想好自己要點的才后,就呼叫服務員。服務員站在自己身邊後記錄客人的菜單內容。將菜單遞給廚師的過程也要進行改進,並不是每一份菜單記錄好以後,都要交給後堂廚師。服務員可以記錄號多份菜單后,同時交給廚師就行了。那麼這種方式,對於老闆來說人力成本是最低的;對於客人來說,雖然不再享受VIP服務並且要進行一定的等待,但是這些都是可接受的;對於服務員來說,基本上她的時間都沒有浪費,基本上被老闆壓桿了最後一滴油水。

到店情況:併發量。到店情況不理想時,一個服務員一本菜單,當然是足夠了。所以不同的老闆在不同的場合下,將會靈活選擇服務員和菜單的配置。
客人:客戶端請求
點餐內容:客戶端發送的實際數據
服務員:操作系統內核用於IO操作的線程(內核線程)
廚師:應用程序線程(當然廚房就是應用程序進程咯)
餐單傳遞方式:包括了阻塞式和非阻塞式兩種。

  • 方法A:阻塞式/非阻塞式 同步IO
  • 方法B:使用線程進行處理的 阻塞式/非阻塞式 同步IO
  • 方法C:阻塞式/非阻塞式 多路復用IO

多路復用IO技術最適用的是“高併發”場景,所謂高併發是指1毫秒內至少同時有上千個連接請求準備好。其他情況下多路復用IO技術發揮不出來它的優勢。另一方面,使用JAVA NIO進行功能實現,相對於傳統的Socket套接字實現要複雜一些,所以實際應用中,需要根據自己的業務需求進行技術選擇。

NIO

概念

JDK 1.4中的java.nio.*包中引入新的Java I/O庫,其目的是提高速度。實際上,“舊”的I/O包已經使用NIO重新實現過,即使我們不顯式的使用NIO編程,也能從中受益。速度的提高在文件I/O和網絡I/O中都可能會發生,但本文只討論後者。

NIO我們一般認為是New I/O(也是官方的叫法),因為它是相對於老的I/O類庫新增的(其實在JDK 1.4中就已經被引入了,但這個名詞還會繼續用很久,即使它們在現在看來已經是“舊”的了,所以也提示我們在命名時,需要好好考慮),做了很大的改變。但民間跟多人稱之為Non-block I/O,即非阻塞I/O,因為這樣叫,更能體現它的特點。而下文中的NIO,不是指整個新的I/O庫,而是非阻塞I/O。

面向流與面向緩衝

Java IO和NIO之間第一個最大的區別是,IO是面向流的,NIO是面向緩衝區的。 Java IO面向流意味着每次從流中讀一個或多個字節,直至讀取所有字節,它們沒有被緩存在任何地方。此外,它不能前後移動流中的數據。如果需要前後移動從流中讀取的數據,需要先將它緩存到一個緩衝區。

面向塊的 NIO一次處理一個數據塊,按塊處理數據比按流處理數據要快得多。數據讀取到一個它稍後處理的緩衝區,需要時可在緩衝區中前後移動。這就增加了處理過程中的靈活性。但是,還需要檢查是否該緩衝區中包含所有您需要處理的數據。而且,需確保當更多的數據讀入緩衝區時,不要覆蓋緩衝區里尚未處理的數據。

阻塞與非阻塞IO

Java IO的各種流是阻塞的。這意味着,當一個線程調用read() 或 write()時,該線程被阻塞,直到有一些數據被讀取,或數據完全寫入。該線程在此期間不能再干任何事情了。Java NIO的非阻塞模式,使一個線程從某通道發送請求讀取數據,但是它僅能得到目前可用的數據,如果目前沒有數據可用時,就什麼都不會獲取,而不是保持線程阻塞,所以直至數據變的可以讀取之前,該線程可以繼續做其他的事情。 非阻塞寫也是如此。一個線程請求寫入一些數據到某通道,但不需要等待它完全寫入,這個線程同時可以去做別的事情。 線程通常將非阻塞IO的空閑時間用於在其它通道上執行IO操作,所以一個單獨的線程現在可以管理多個輸入和輸出通道(channel)。

通道

通道 Channel 是對原 I/O 包中的流的模擬,可以通過它讀取和寫入數據。

通道與流的不同之處在於,流只能在一個方向上移動(一個流必須是 InputStream 或者 OutputStream 的子類),而通道是雙向的,可以用於讀、寫或者同時用於讀寫。

通道包括以下類型:

  • FileChannel:從文件中讀寫數據;
  • DatagramChannel:通過 UDP 讀寫網絡中數據;
  • SocketChannel:通過 TCP 讀寫網絡中數據;
  • ServerSocketChannel:可以監聽新進來的 TCP 連接,對每一個新進來的連接都會創建一個 SocketChannel。

緩衝區

發送給一個通道的所有數據都必須首先放到緩衝區中,同樣地,從通道中讀取的任何數據都要先讀到緩衝區中。也就是說,不會直接對通道進行讀寫數據,而是要先經過緩衝區。

緩衝區實質上是一個數組,但它不僅僅是一個數組。緩衝區提供了對數據的結構化訪問,而且還可以跟蹤系統的讀/寫進程。

Buffer有兩種工作模式:寫模式和讀模式。在讀模式下,應用程序只能從Buffer中讀取數據,不能進行寫操作。但是在寫模式下,應用程序是可以進行讀操作的,這就表示可能會出現臟讀的情況。所以一旦您決定要從Buffer中讀取數據,一定要將Buffer的狀態改為讀模式。

注意:ServerSocketChannel通道它只支持對OP_ACCEPT事件的監聽,所以它是不能直接進行網絡數據內容的讀寫的。所以ServerSocketChannel是沒有集成Buffer的。

緩衝區包括以下類型:

  • ByteBuffer
  • CharBuffer
  • ShortBuffer
  • IntBuffer
  • LongBuffer
  • FloatBuffer
  • DoubleBuffer


可以用三個值指定緩衝區在任意時刻的狀態:

  • position
  • limit
  • capacity

Position

您可以回想一下,緩衝區實際上就是美化了的數組。在從通道讀取時,您將所讀取的數據放到底層的數組中。 position 變量跟蹤已經寫了多少數據。更準確地說,它指定了下一個字節將放到數組的哪一個元素中。因此,如果您從通道中讀三個字節到緩衝區中,那麼緩衝區的 position 將會設置為3,指向數組中第四個元素。

同樣,在寫入通道時,您是從緩衝區中獲取數據。 position 值跟蹤從緩衝區中獲取了多少數據。更準確地說,它指定下一個字節來自數組的哪一個元素。因此如果從緩衝區寫了5個字節到通道中,那麼緩衝區的 position 將被設置為5,指向數組的第六個元素。

Limit

limit 變量表明還有多少數據需要取出(在從緩衝區寫入通道時),或者還有多少空間可以放入數據(在從通道讀入緩衝區時)。

position 總是小於或者等於 limit。

Capacity

緩衝區的 capacity 表明可以儲存在緩衝區中的最大數據容量。實際上,它指定了底層數組的大小 ― 或者至少是指定了准許我們使用的底層數組的容量。

limit 決不能大於 capacity。


在實際操作數據時它們有如下關係圖:

① 新建一個大小為 8 個字節的緩衝區,此時 position 為 0,而 limit = capacity = 8。capacity 變量不會改變,下面的討論會忽略它。

② 從輸入通道中讀取 5 個字節數據寫入緩衝區中,此時 position 為 5,limit 保持不變。

③ 在將緩衝區的數據寫到輸出通道之前,需要先調用 flip() 方法,這個方法將 limit 設置為當前 position,並將 position 設置為 0。

④ 從緩衝區中取 4 個字節到輸出緩衝中,此時 position 設為 4。

⑤ 最後需要調用 clear() 方法來清空緩衝區,此時 position 和 limit 都被設置為最初位置。


文件複製 NIO 實例

以下展示了使用 NIO 快速複製文件的實例:

public static void fastCopy(String src, String dist) throws IOException {

    /* 獲得源文件的輸入字節流 */
    FileInputStream fin = new FileInputStream(src);

    /* 獲取輸入字節流的文件通道 */
    FileChannel fcin = fin.getChannel();

    /* 獲取目標文件的輸出字節流 */
    FileOutputStream fout = new FileOutputStream(dist);

    /* 獲取輸出字節流的文件通道 */
    FileChannel fcout = fout.getChannel();

    /* 為緩衝區分配 1024 個字節 */
    ByteBuffer buffer = ByteBuffer.allocateDirect(1024);

    while (true) {

        /* 從輸入通道中讀取數據到緩衝區中 */
        int r = fcin.read(buffer);

        /* read() 返回 -1 表示 EOF */
        if (r == -1) {
            break;
        }

        /* 切換讀寫 */
        buffer.flip();

        /* 把緩衝區的內容寫入輸出文件中 */
        fcout.write(buffer);

        /* 清空緩衝區 */
        buffer.clear();
    }
}

選擇器

NIO 常常被叫做非阻塞 IO,主要是因為 NIO 在網絡通信中的非阻塞特性被廣泛使用。

NIO 實現了 IO 多路復用中的 Reactor 模型,一個線程 Thread 使用一個選擇器 Selector 通過輪詢的方式去監聽多個通道 Channel 上的事件,從而讓一個線程就可以處理多個事件。

通過配置監聽的通道 Channel 為非阻塞,那麼當 Channel 上的 IO 事件還未到達時,就不會進入阻塞狀態一直等待,而是繼續輪詢其它 Channel,找到 IO 事件已經到達的 Channel 執行。

例如,當多個客戶端通過通道向服務端傳輸數據時,是通過 ByteBuffer 來傳輸,一個文件通過多次,從輸入通道中讀取 N 個字節數據寫入ByteBuffer,然後再將將緩衝區的數據寫到輸出通道,這個過程可以看成是不連續的,因為只有當緩衝區寫滿后,通過 buffer.flip() 切換成讀模式后,才開始向輸出通道寫入,所以當ByteBuffer還在寫入狀態時,服務器是不會等待這個通道的ByteBuffer寫滿,而是去處理其他客戶端Channel 為可讀的狀態,當然這個處理業務的工作可以開啟多線程來處理。

因為創建和切換線程的開銷很大,因此使用一個線程來處理多個事件而不是一個線程處理一個事件,對於 IO 密集型的應用具有很好地性能。

應該注意的是,只有套接字 Channel 才能配置為非阻塞,而 FileChannel 不能,為 FileChannel 配置非阻塞也沒有意義。

套接字 NIO 實例

package com.chenhao.nio;

import java.io.IOException;
import java.net.InetSocketAddress;
import java.nio.ByteBuffer;
import java.nio.channels.SelectionKey;
import java.nio.channels.Selector;
import java.nio.channels.ServerSocketChannel;
import java.nio.channels.SocketChannel;
import java.util.Date;
import java.util.Iterator;
import java.util.Scanner;

import org.junit.Test;

/*
 * 一、使用 NIO 完成網絡通信的三個核心:
 * 
 * 1. 通道(Channel):負責連接
 *         
 *        java.nio.channels.Channel 接口:
 *             |--SelectableChannel
 *                 |--SocketChannel
 *                 |--ServerSocketChannel
 *                 |--DatagramChannel
 * 
 * 2. 緩衝區(Buffer):負責數據的存取
 * 
 * 3. 選擇器(Selector):是 SelectableChannel 的多路復用器。用於監控 SelectableChannel 的 IO 狀況
 * 
 */
public class TestNonBlockingNIO {
    
    //客戶端
    @Test
    public void client() throws IOException{
        //1. 獲取通道
        SocketChannel sChannel = SocketChannel.open(new InetSocketAddress("127.0.0.1", 9898));
        
        //2. 切換非阻塞模式
        sChannel.configureBlocking(false);
        
        //3. 分配指定大小的緩衝區
        ByteBuffer buf = ByteBuffer.allocate(1024);
        
        //4. 發送數據給服務端
        Scanner scan = new Scanner(System.in);
        
        while(scan.hasNext()){
            String str = scan.next();
            buf.put((new Date().toString() + "\n" + str).getBytes());
            buf.flip();
            sChannel.write(buf);
            buf.clear();
        }
        
        //5. 關閉通道
        sChannel.close();
    }

    //服務端
    @Test
    public void server() throws IOException{
        //1. 獲取通道
        ServerSocketChannel ssChannel = ServerSocketChannel.open();
        
        //2. 切換非阻塞模式
        ssChannel.configureBlocking(false);
        
        //3. 綁定連接
        ssChannel.bind(new InetSocketAddress(9898));
        
        //4. 獲取選擇器
        Selector selector = Selector.open();
        
        //5. 將通道註冊到選擇器上, 並且指定“監聽接收事件”
        ssChannel.register(selector, SelectionKey.OP_ACCEPT);
        
        //6. 輪詢式的獲取選擇器上已經“準備就緒”的事件
        //使用 select() 來監聽到達的事件,它會一直阻塞直到有至少一個事件到達。
        while(selector.select() > 0){
            
            //7. 獲取當前選擇器中所有註冊的“選擇鍵(已就緒的監聽事件)”
            Iterator<SelectionKey> it = selector.selectedKeys().iterator();
            
            while(it.hasNext()){
                //8. 獲取準備“就緒”的是事件
                SelectionKey sk = it.next();
                
                //9. 判斷具體是什麼事件準備就緒
                if(sk.isAcceptable()){
                    //10. 若“接收就緒”,獲取客戶端連接
                    SocketChannel sChannel = ssChannel.accept();
                    
                    //11. 切換非阻塞模式
                    sChannel.configureBlocking(false);
                    
                    //12. 將該通道註冊到選擇器上
                    sChannel.register(selector, SelectionKey.OP_READ);
                }else if(sk.isReadable()){
                    //13. 獲取當前選擇器上“讀就緒”狀態的通道
                    SocketChannel sChannel = (SocketChannel) sk.channel();
                    
                    //14. 讀取數據
                    ByteBuffer buf = ByteBuffer.allocate(1024);
                    
                    int len = 0;
                    while((len = sChannel.read(buf)) > 0 ){
                        buf.flip();
                        System.out.println(new String(buf.array(), 0, len));
                        buf.clear();
                    }
                }
                
                //15. 取消選擇鍵 SelectionKey
                //每一個“事件關鍵字”被處理后都必須移除,否則下一次輪詢時,這個事件會被重複處理
                it.remove();
            }
        }
    }
}

NIO傳輸文件

服務器端代碼

public class Server {
    private ByteBuffer buffer = ByteBuffer.allocate(1024*1024);
        //使用Map保存每個連接,當OP_READ就緒時,根據key找到對應的文件對其進行寫入。若將其封裝成一個類,作為值保存,可以再上傳過程中显示進度等等
    Map<SelectionKey, FileChannel> fileMap = new HashMap<SelectionKey, FileChannel>();
    public static void main(String[] args) throws IOException{
        Server server = new Server();
        server.startServer();
    }
    public void startServer() throws IOException{
        Selector selector = Selector.open();
        ServerSocketChannel serverChannel = ServerSocketChannel.open();
        serverChannel.configureBlocking(false);
        serverChannel.bind(new InetSocketAddress(8888));
        serverChannel.register(selector, SelectionKey.OP_ACCEPT);
        System.out.println("服務器已開啟...");
        while (true) {
            int num = selector.select();
            if (num == 0) continue;
            Iterator<SelectionKey> it = selector.selectedKeys().iterator();
            while (it.hasNext()) {
                SelectionKey key = it.next();
                if (key.isAcceptable()) {
                    ServerSocketChannel serverChannel1 = (ServerSocketChannel) key.channel();
                    SocketChannel socketChannel = serverChannel1.accept();
                    if (socketChannel == null) continue;
                    socketChannel.configureBlocking(false);
                    SelectionKey key1 = socketChannel.register(selector, SelectionKey.OP_READ);
                    InetSocketAddress remoteAddress = (InetSocketAddress)socketChannel.getRemoteAddress();
                    File file = new File(remoteAddress.getHostName() + "_" + remoteAddress.getPort() + ".txt");
                    FileChannel fileChannel = new FileOutputStream(file).getChannel();
                    fileMap.put(key1, fileChannel);
                    System.out.println(socketChannel.getRemoteAddress() + "連接成功...");
                    writeToClient(socketChannel);
                }
                else if (key.isReadable()){
                    readData(key);
                }
                // NIO的特點只會累加,已選擇的鍵的集合不會刪除,ready集合會被清空
                // 只是臨時刪除已選擇鍵集合,當該鍵代表的通道上再次有感興趣的集合準備好之後,又會被select函數選中
                it.remove();
            }
        }
    }
    private void writeToClient(SocketChannel socketChannel) throws IOException {
        buffer.clear();
        buffer.put((socketChannel.getRemoteAddress() + "連接成功").getBytes());
        buffer.flip();
        socketChannel.write(buffer);
        buffer.clear();
    }
    private void readData(SelectionKey key) throws IOException  {
        FileChannel fileChannel = fileMap.get(key);
        buffer.clear();
        SocketChannel socketChannel = (SocketChannel) key.channel();
        int num = 0;
        try {
            while ((num = socketChannel.read(buffer)) > 0) {
                buffer.flip();
                // 寫入文件
                fileChannel.write(buffer);
                buffer.clear();
                }
        } catch (IOException e) {
            key.cancel();
            e.printStackTrace();
            return;
        }
        // 調用close為-1 到達末尾
        if (num == -1) {
            fileChannel.close();
            System.out.println("上傳完畢");
            buffer.put((socketChannel.getRemoteAddress() + "上傳成功").getBytes());
            buffer.clear();
            socketChannel.write(buffer);
            key.cancel();
        }
    }
}


客戶端模擬三個客戶端同時向服務器發送文件

public class Client {
    public static void main(String[] args) {
        for (int i = 0; i < 3; i++) {
            // 模擬三個發端
            new Thread() {
                public void run() {
                    try {
                        SocketChannel socketChannel = SocketChannel.open();
                        socketChannel.socket().connect(new InetSocketAddress("127.0.0.1", 8888));
                        File file = new File("E:\\" + 11 + ".txt");
                        FileChannel fileChannel = new FileInputStream(file).getChannel();
                        ByteBuffer buffer = ByteBuffer.allocate(100);
                        socketChannel.read(buffer);
                        buffer.flip();
                        System.out.println(new String(buffer.array(), 0, buffer.limit(), Charset.forName("utf-8")));
                        buffer.clear();
                        int num = 0;
                        while ((num=fileChannel.read(buffer)) > 0) {
                            buffer.flip();                        
                            socketChannel.write(buffer);
                            buffer.clear();
                        }
                        if (num == -1) {
                            fileChannel.close();
                            socketChannel.shutdownOutput();
                        }
                        // 接受服務器
                        socketChannel.read(buffer);
                        buffer.flip();
                        System.out.println(new String(buffer.array(), 0, buffer.limit(), Charset.forName("utf-8")));
                        buffer.clear();
                        socketChannel.close();
                    } catch (IOException e) {
                        e.printStackTrace();
                    }
                    
                };
            }.start();
            
        }
        Thread.yield();
    }
}

可見這裏我們僅僅使用了一個線程就管理了三個連接,相比以前使用阻塞的Socket要在accept函數返回后開啟線程來管理這個連接,而使用NIO我們在accept返回后,僅僅將其註冊到選擇器上,讀操作在下次檢測到有可讀的鍵的集合時就會去處理。

NIO+線程池改進

public class ThreadPoolServer extends Server{
    private ExecutorService exec = Executors.newFixedThreadPool(10);
    public static void main(String[] args) throws IOException {
        ThreadPoolServer server = new ThreadPoolServer();
        server.startServer();
    }

    @Override
    protected void readData(final SelectionKey key) throws IOException {
        // 移除掉這個key的可讀事件,已經在線程池裡面處理,如果不改變當前Key的狀態,這裏交給另外一個線程去處理,主線程下一次遍歷此KEY還是可讀事件,會重複開啟線程處理任務
        key.interestOps(key.interestOps() & (~SelectionKey.OP_READ));
        exec.execute(new Runnable() {
            @Override
            public void run() {
                ByteBuffer buffer = ByteBuffer.allocate(1024 * 1024);
                FileChannel fileChannel = fileMap.get(key);
                buffer.clear();
                SocketChannel socketChannel = (SocketChannel) key.channel();
                int num = 0;
                try {
                    while ((num = socketChannel.read(buffer)) > 0) {
                        buffer.flip();
                        // 寫入文件
                        fileChannel.write(buffer);
                        buffer.clear();
                    }
                } catch (IOException e) {
                    key.cancel();
                    e.printStackTrace();
                    return;
                }
                // 調用close為-1 到達末尾
                if (num == -1) {
                    try {
                        fileChannel.close();
                        System.out.println("上傳完畢");
                        buffer.put((socketChannel.getRemoteAddress() + "上傳成功").getBytes());
                        buffer.clear();
                        socketChannel.write(buffer);
                    } catch (IOException e) {
                        e.printStackTrace();
                    }
                    // 只有調用cancel才會真正從已選擇的鍵的集合裏面移除,否則下次select的時候又能得到
                    // 一端close掉了,其對端仍然是可讀的,讀取得到EOF,返回-1
                    key.cancel(); 
                    return;
                }
                // Channel的read方法可能返回0,返回0並不一定代表讀取完了。
                // 工作線程結束對通道的讀取,需要再次更新鍵的ready集合,將感興趣的集合重新放在裏面
                key.interestOps(key.interestOps() | SelectionKey.OP_READ);
                // 調用wakeup,使得選擇器上的第一個還沒有返回的選擇操作立即返回即重新select
                key.selector().wakeup();
            }
        });
    }
}

推薦博客

  程序員寫代碼之外,如何再賺一份工資?

多路復用IO的優缺點

  • 不用再使用多線程來進行IO處理了(包括操作系統內核IO管理模塊和應用程序進程而言)。當然實際業務的處理中,應用程序進程還是可以引入線程池技術的
  • 同一個端口可以處理多種協議,例如,使用ServerSocketChannel的服務器端口監聽,既可以處理TCP協議又可以處理UDP協議。
  • 操作系統級別的優化:多路復用IO技術可以是操作系統級別在一個端口上能夠同時接受多個客戶端的IO事件。同時具有之前我們講到的阻塞式同步IO和非阻塞式同步IO的所有特點。Selector的一部分作用更相當於“輪詢代理器”。

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

雲遊戲流媒體整體架構設計(雲遊戲流媒體技術前瞻,最近雲遊戲概念很火,加之對流媒體技術略有研究,簡單寫一些)

前言:

遙想當年阿法狗戰敗一眾圍棋國手,風氣一轉,似乎所有人都懂AI。這次谷歌又放出了stadia,國內鵝廠再次跑步進場,貴州某xx雲提前布局。

閑來無事,嘗試體驗了一下貴州某xx雲的雲遊戲(不打廣告),暫且不評論如何如何,剛好對流媒體技術略有研究,僅在這裏簡單聊一下這方面涉及的架構和技術。

架構設計:

總體架構自上而下大致分為四端:

1、雲遊戲主機端(雲遊戲運行端,或者叫雲遊戲畫面渲染端,需要接收控制指令並錄屏推流到流媒體服務)

主機端需要運行遊戲並讓通過錄屏推流程序把渲染好的遊戲畫面(其實就是錄屏)推流到流媒體服務進行實時視頻分發。

有人會想這個雲遊戲主機端可能會很複雜,其實也還好,只是包含了錄屏、推流、用戶控制指令接收和一些其他諸如計費此類的相關功能。

2、流媒體服務(用於轉發主機端推上來的遊戲實時視頻並分發出去,所有用戶都可以觀看這個視頻)

這個不需要多講了,只是用來轉發遊戲實時視頻,並不涉及雲遊戲主機的控制權。

3、控制指令轉發服務(用戶需要獲取控制指令服務的所有權才能控制雲遊戲主機)

這個是雲遊戲的控制核心,獲取某台雲遊戲主機的用戶就可以通過鍵盤或者鼠標進行雲遊戲的試玩(操作),理論上講能夠獲取該控制權的不是只有一個用戶,完全可以支持多個用戶同時控制一台雲遊戲主機。

4、客戶端(瀏覽器,pc客戶端,ios,安卓客戶端等)

客戶端需要從流媒體服務拉取實時遊戲視頻,用戶需要先獲取雲遊戲主機的控制權,才能夠發送控制指令來試玩(操作)雲遊戲(鼠標,鍵盤,手柄等)

靈魂畫師繪製結構圖:

架構示意圖-來自靈魂畫師的傾情手繪

難點或者叫待解決的點:

1、流媒體協議的選擇?高延遲才是最大殺手

從流媒體技術出身開始,實時視頻延遲一直是個比較棘手的問題,比如rtmp/http-flv等基於tcp的協議本身優化到極點也要幾百毫秒的延遲,hls這種超高延遲到幾秒的不提也罷。就目前看只有sip、rtsp以及基於udp的一些協議能夠滿足這種超低延遲的需求,但是這種協議就很難在瀏覽器上就很難實現了,除了webrtc,而webrtc協議是谷歌力推的下一代流媒體協議,不排除這次是谷歌webrtc技術的奠基之作,拭目以待。

2、雲遊戲主機控制指令的所有權?依然是延遲

這個所有權其實不算是難點,只是用戶獲取某台雲遊戲主機的控制權而已。難點在於控制指令的延遲,沒錯,就是網絡延遲。尤其是在拉取實時視頻時,在視頻已經佔用大量帶寬的情況下,在這種網絡負載或者網絡波動較大的情況下控制指令延遲或許值得重視。

跟很多朋友討論過雲遊戲這個話題,不約而同第一個想到的都是網絡延遲,當然這個延遲不僅包含控制指令的延遲也指實時遊戲視頻的延遲。


後言(啰嗦幾句):

其實這塊依然屬於共享經濟的後續,類似共享單車。

給大家舉個栗子:我有一百台性能強勁的遊戲主機,每台主機價值一萬,當二手貨賣掉可能還會虧點,好可惜。那麼我把他共享出來,假設現在有十萬個用戶想租我這一百台機器,然後每人只收10塊錢月租,不考慮電費等其他成本,請問我什麼時候能回本?

作者:eguid

說明:原CSDN相關博客文章已經全部轉移到博客園

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

如何在C#中調試LINQ查詢

原文:How to Debug LINQ queries in C#
作者:Michael Shpilt
譯文:如何在C#中調試LINQ查詢
譯者:Lamond Lu

在C#中我最喜歡的特性就是LINQ。使用LINQ, 我們可以獲得一種易於編寫和理解的簡潔語法,而不是單調的foreach循環,它可以讓你的代碼更加美觀。

但是LINQ也有不好的地方,就是調試起來非常難。我們無法知道查詢中到底發生了什麼。我們可以看到輸入值和輸出值,但是僅此而已。當代碼出現問題的時候,我們只能盯着代碼看嗎?答案是否定的,這裡有幾種可以使用的LINQ的調試方法。

LINQ調試

儘管很困難,但是這裏還是有幾種可選的方式來調試LINQ的。

這裏首先,我們先創建一個測試場景。假設我們現在想要獲取一個列表,這個列表中包含了3個超過平均工資的男性員工的信息,並且按照年齡排序。這是一個非常普通的查詢,下面就是我針對這個場景編寫的查詢方法。

public IEnumerable<Employee> MyQuery(List<Employee> employees)
{
    var avgSalary = employees.Select(e=>e.Salary).Average();
 
    return employees
        .Where(e => e.Gender == "Male")
        .Take(3)
        .Where(e => e.Salary > avgSalary)
        .OrderBy(e => e.Age);
}

這裏我們使用的數據集如下:

Name Age Gender Salary
Peter Claus 40 “Male” 61000
Jose Mond 35 “male” 62000
Helen Gant 38 “Female” 38000
Jo Parker 42 “Male” 52000
Alex Mueller 22 “Male” 39000
Abbi Black 53 “female” 56000
Mike Mockson 51 “Male” 82000

當運行以上查詢之後, 我得到的結果是

Peter Claus, 61000, 40

這個結果看起來不太對…這裏應該查出3個員工。這裏我們計算出的平均工資應該是56400, 所以’Jose Mond’和’Mick Mockson’應該也是滿足條件的結果。

所以呢,這裡在我的LINQ查詢中有BUG, 那麼我們該怎麼做? 當然我可以一直盯着代碼來找出問題,在某些場景下這種方式可能是行的通的。或者呢我們可以來嘗試調試它。

下面讓我們看一下,我們有哪些可選的調試方法。

1. 使用Quickwatch

這裏比較容易的方法是使用QuickWatch窗口來查看查詢的不同部分的結果。你可以從第一個操作開始,一步一步的追加過濾條件。

例:

這裏我們可以看到,在經過第一個查詢之後,就出錯了。 ‘Jose Mond’應該是一個男性,但是在結果集中缺失了。那麼我們的BUG應該就是出在這裏了,我們可以只盯着這一小段代碼來查找問題。沒錯,這裏的BUG原因是數據集中將男性拼寫為了’male’, 而不是我們查詢的’Male’。

因此,現在我可以通過忽略大小寫來修復這個問題。

var res = employees
        .Where(e => e.Gender.Equals("Male", StringComparison.OrdinalIgnoreCase))
        .Take(3)
        .Where(e => e.Salary > avgSalary)
        .OrderBy(e => e.Age);
 

現在我們將得到如下結果集:

Jose Mond, 62000, 35
Peter Claus, 61000, 40

在結果集中’Jose’已經包含在內了,所以這裏第一個Bug已經被修復了。但是問題是’Mike Mockson’依然沒有出現在結果集裏面。我們將使用後面的調試方式來解決它。

Quickwatch看似很美好,其實是有一個很大的缺點。如果你要從一個很大的數據集中找到一個指定的數據項,你可以需要花非常多的時間。

而且需要注意有些查詢可能會改變應用的狀態。例如,你可能在lambda表達式中,通過調用某個方法來改變一些變量的值,例如var res = source.Select(x => x.Age++)。在Quickwatch中運行這段代碼,你的應用狀態會被修改,調試上下文會不一致。不過在Quickwatch你可以使用添加nse這個”無副作用”標記,來避免調試上下文的變更。你可以在你的LINQ表達式後面追加, nse的後綴來啟用“無副作用”標記。

例:

2. 在lambda表達式部分放置斷點

另外一種非常好用的調試方式是在lambda表達式內部放置斷點。這可以讓你查看每個獨立數據項的值。針對比較大的數據集,你可以使用條件斷點。

在我們的用例中,我們發現’Mike Mockson’不在第一個Where操作結果集中。這時候我們就可以在.Where(e => e.Gender == "Male")代碼部分添加一個條件斷點,斷點條件是e.Name=="Mike Mockson"

在我們的用例中,這個斷點永遠不會被觸發。而且在我們將查詢條件改為

.Where(e => e.Gender.Equals("Male", StringComparison.OrdinalIgnoreCase))

之後也不會觸發。你知道這是為什麼?

現在不要在盯着代碼了,這裏我們使用斷點的Actions功能,這個功能允許你在斷點觸發時,在Output窗口中輸出日誌。

再次調試之後,我們會在Output窗口中得到如下結果:

只有3個人名被打印出來了。這是因為在我們的查詢中使用了.Take(3), 它會讓數據集只返回前3個匹配的數據項。

這裏我們本來的意願是想列出超過平均工資的前三位男性,並且按照年齡排序。所以這裏我們應該把Take放到工資過濾代碼的後面。

var res = employees
        .Where(e => e.Gender.Equals("Male", StringComparison.OrdinalIgnoreCase))
        .Where(e => e.Salary > avgSalary)
        .Take(3)
        .OrderBy(e => e.Age);
 

再次運行之後,結果集正確显示了Jose Mond,Peter Claus和Mike Mockson。

注: LINQ to SQL中,這個方式不起作用。

3. 為LINQ添加日誌擴展方法

現在讓我們把代碼還原到Bug還未修復的最初狀態.

下面我們來使用擴展方法來幫助調試Query。


public static IEnumerable<T> LogLINQ<T>(this IEnumerable<T> enumerable, string logName, Func<T, string> printMethod)
{
#if DEBUG
    int count = 0;
    foreach (var item in enumerable)
    {
        if (printMethod != null)
        {
            Debug.WriteLine($"{logName}|item {count} = {printMethod(item)}");
        }
        count++;
        yield return item;
    }
    Debug.WriteLine($"{logName}|count = {count}");
#else   
    return enumerable;
#endif
}
 

你可以像這樣使用你的調試方法。

var res = employees
        .LogLINQ("source", e=>e.Name)
        .Where(e => e.Gender == "Male")
        .LogLINQ("logWhere", e=>e.Name)
        .Take(3)
        .LogLINQ("logTake", e=>e.Name)
        .Where(e => e.Salary > avgSalary)
        .LogLINQ("logWhere2", e=>e.Name)
        .OrderBy(e => e.Age);
 

輸出結果如下:

說明和解釋:

  • LogLINQ方法需要放在你的每個查詢條件後面。它會輸出所有滿足條件的數據項及其總數
  • logName是一個輸出日誌的前綴,使用它可以很容易了解到當前運行的是哪一步查詢
  • Func<T, string> printMethod是一個委託,它可以幫助打印任何你指定的變量值,在上述例子中,我們打印了員工的名字
  • 為了優化代碼,這個代碼應該是只在調試模式使用。所以我們添加了#if DEBUG。

下面我們來分析一下輸出窗口的結果,你會發現這幾個問題:

  • source中包含”Jose Mond”, 但是logWhere中不包含,這就是我們前面發現的大小寫問題
  • “Mike Mockson”沒有出現在任何結果中,原因是過早的使用Take, 過濾了許多正確的結果。

4. 使用OzCode的LINQ功能

如果你需要一個強力的工具來調試LINQ, 那麼你可以使用OzCode這個Visual Studio插件。

OzCode可以提供一個可視化的LINQ查詢界面來展示每一個數據項的行為。首先,它可以展示每次操作后,滿足條件的所有數據項的數量。

然後呢,當你點擊任何一個数字按鈕的時候,你可以查看所有滿足條件的數據項。

我們可以看到”Jo Parker”是源數據的第四個,經過第一個Where查詢時候,變成了數據源中的第三項。這裏可以看到在最後2步操作OrderBy和Take返回的結果集中沒有這一項了,因為他已經被過濾掉了。

就調試LINQ而言,OzCode基本上已經可以滿足你的所有需求了。

總結

LINQ的調試不是非常直觀,但是通過一些內置和第三方組件還是可以很好調試結果。

這裏我沒有提到LINQ查詢語法,因為它使用得並不多。只有方式#2 (lambda表達式部分放置斷點)和技術#4 (OzCode)可以使用查詢語法。

LINQ既適用於內存集合,也適用於數據源。直接數據源可以是SQL數據庫、XML模式和web服務。但是並非所有上述技術都適用於數據源。特別是,方式#2 (lambda表達式部分放置斷點)根本不起作用。方式#3(日誌中間件)可以用於調試,但最好避免使用它,因為它將集合從IQueryable更改為IEnumerable。不要讓LogLINQ方法用於生產數據源。方式#4 (OzCode)對於大多數LINQ提供程序都可以很好地工作,但是如果LINQ提供程序以非標準的方式工作,那麼可能會有一些細微的變化。

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

北冥有 Data,其名為鯤,鯤之大,一個 MySQL 放不下!

千萬量級的數據,用 MySQL 要怎麼存?

初學者在看到這個問題的時候,可能首先想到的是 MySQL 一張表到底能存放多少條數據?

根據 MySQL 官方文檔的介紹,MySQL 理論上限是 (232)2 條數據,然而實際操作中,往往還受限於下面兩條因素:

  1. myisam_data_pointer_size,MySQL 的 myisam_data_pointer_size 一般默認是 6,即 48 位,那麼對應的行數就是 248-1。
  2. 表的存儲大小 256TB

那有人會說,只要我的數據大小不超過上限,數據行數也不超過上限,是不是就沒有問題了?其實不盡然。

在實際項目中,一般沒有哪個項目真的觸發到 MySQL 數據的上限了,因為當數據量變大了之後,查詢速度會慢的嚇人,而一般這個時候,你的數據量離 MySQL 的理論上限還遠着呢!

傳統的企業應用一般數據量都不大,數據也都比較容易處理,但是在互聯網項目中,上千萬、上億的數據量並不鮮見。在這種時候,還要保證數據庫的操作效率,我們就不得不考慮數據庫的分庫分表了。

那麼接下來就和大家簡單聊一聊數據庫分庫分表的問題。

數據庫切分

看這個名字就知道,就是把一個數據庫切分成 N 多個數據庫,然後存放在不同的數據庫實例上面,這樣做有兩個好處:

  1. 降低單台數據庫實例的負載
  2. 可以方便的實現對數據庫的擴容

一般來說,數據庫的切分有兩種不同的切分規則:

  1. 水平切分
  2. 垂直切分

接下來我們就對這兩種不同的切分規則分別進行介紹。

水平切分

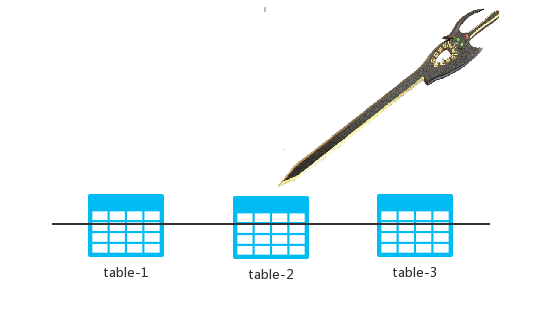
先來一張簡單的示意圖,大家感受一下什麼是水平切分:

假設我的 DB 中有 table-1、table-2 以及 table-3 三張表,水平切分就是拿着我的絕世好劍,對準黑色的線條,砍一劍或者砍 N 劍!

砍完之後,將砍掉的部分放到另外一個數據庫實例中,變成下面這樣:

這樣,原本放在一個 DB 中的 table 現在放在兩個 DB 中了,觀察之後我們發現:

  1. 兩個 DB 中表的個數都是完整的,就是原來 DB 中有幾張表,現在還是幾張。
  2. 每張表中的數據是不完整的,數據被拆分到了不同的 DB 中去了。

這就是數據庫的水平切分,也可以理解為按照數據行進行切分,即按照表中某個字段的某種規則來將表數據分散到多個庫之中,每個表中包含一部分數據。

這裏的某種規則都包含哪些規則呢?這就涉及到數據庫的分片規則問題了,這個松哥在後面的文章中也會和大家一一展開詳述。這裏先簡單說幾個常見的分片規則:

  1. 按照日期劃分:不容日期的數據存放到不同的數據庫中。
  2. 對 ID 取模:對表中的 ID 字段進行取模運算,根據取模結果將數據保存到不同的實例中。
  3. 使用一致性哈希算法進行切分。

詳細的用法,將在後面的文章中和大家仔細說。

垂直切分

先來一張簡單的示意圖,大家感受一下垂直切分:

所謂的垂直切分就是拿着我的屠龍刀,對準了黑色的線條砍。砍完之後,將不同的表放到不同的數據庫實例中去,變成下面這個樣子:

這個時候我們發現如下幾個特點:

  1. 每一個數據庫實例中的表的數量都是不完整的。
  2. 每一個數據庫實例中表的數據是完整的。

這就是垂直切分。一般來說,垂直切分我們可以按照業務來劃分,不同業務的表放到不同的數據庫實例中。

老實說,在實際項目中,數據庫垂直切分並不是一件容易的事,因為表之間往往存在着複雜的跨庫 JOIN 問題,那麼這個時候如何取捨,就要考驗架構師的水平了!

優缺點分析

通過上面的介紹,相信大家對於水平切分和垂直切分已經有所了解,優缺點其實也很明顯了,松哥再來和大家總結一下。

水平切分

  • 優點
  1. 水平切分最大的優勢在於數據庫的擴展性好,提前選好切分規則,數據庫後期可以非常方便的進行擴容。
  2. 有效提高了數據庫穩定性和系統的負載能力。拆分規則抽象好, join 操作基本可以數據庫做。
  • 缺點
  1. 水平切分后,分片事務一致性不容易解決。
  2. 拆分規則不易抽象,對架構師水平要求很高。
  3. 跨庫 join 性能較差。

垂直切分

  • 優點
  1. 一般按照業務拆分,拆分后業務清晰,可以結合微服務一起食用。
  2. 系統之間整合或擴展相對要容易很多。
  3. 數據維護相對簡單。
  • 缺點
  1. 最大的問題在於存在單庫性能瓶頸,數據表擴展不易。
  2. 跨庫 join 不易。
  3. 事務處理複雜。

結語

雖然 MySQL 中數據存儲的理論上限比較高,但是在實際開發中我們不會等到數據存不下的時候才去考慮分庫分表問題,因為在那之前,你就會明顯的感覺到數據庫的各項性能在下降,就要開始考慮分庫分表了。

好了,今天主要是向大家介紹一點概念性的東西,算是我們分佈式數據庫中間件正式出場前的一點鋪墊。

參考資料:

  1. MySQL 官方文檔

關注公眾號【江南一點雨】,專註於 Spring Boot+微服務以及前後端分離等全棧技術,定期視頻教程分享,關注后回復 Java ,領取松哥為你精心準備的 Java 乾貨!

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

你值得關注的幾種常見的js設計模式

前言

潜水了一段時間,今天空閑時間復盤下之前的知識點,聊聊 js 幾種常見的設計模式。

掌握 JavaScript 中常見的一些設計模式,對我們書寫規範性代碼,可維護性代碼有很大的幫助。

ps:最近在一些好友的鼓勵下,pubdreamcc 準備着手經營一個公眾號了,具體信息會在接下來的两天時間內發布,新手上路,歡迎大夥提供一些寶貴的建議,cc 在這裏先謝了~

內容主體

單例模式

所謂單例模式即為:保證一個類僅有一個實例,並提供一個訪問它的全局訪問點。

這裏其實利用的是 js閉包 來實現這樣的功能。

假如現在我們有這樣的需求,設置一個管理員,無論創建多次都只是設置一次。


function SetManager(name) {
  this.manager = name;
}

SetManager.prototype.getName = function() {
  console.log(this.manager);
};

var SingletonSetManager = (function() {
  var manager = null;

  return function(name) {
    if (!manager) {
        manager = new SetManager(name);
    }

    return manager;
  }
})();

SingletonSetManager('a').getName(); // a
SingletonSetManager('b').getName(); // a
SingletonSetManager('c').getName(); // a

這種方法有一個缺點就是:如果我們需要再次創建一個 HR,則需要將代碼再複製一遍,所以我們可以提取通用的單例。

function getSingleton(fn) {
  var instance = null;

  return function() {
    if (!instance) {
        instance = fn.apply(this, arguments);
    }

    return instance;
  }
}


// 設置管理員
var managerSingleton = getSingleton(function(name){
  var manager = new SetManager(name);
  return manager;
})

managerSingleton('a').getName(); // a
managerSingleton('b').getName(); // a
managerSingleton('c').getName(); // a

// 設置 HR

function SetHr(name) {
  this.hr = name;
}

SetHr.prototype.getName = function() {
  console.log(this.hr);
};

var hrSingleton = getSingleton(function(name) {
  var hr = new SetHr(name);
  return hr;
});

hrSingleton('aa').getName(); // aa
hrSingleton('bb').getName(); // aa
hrSingleton('cc').getName(); // aa

這樣我們的代碼可通用性就會變得更好,省去了一些重複性的代碼。

代理模式

所謂代理模式就是:我們不方便直接訪問某個對象時,可以為對象創建一個佔位符(代理),以便控制對它的訪問,我們實際上訪問的是代理對象。

這裏我們以一個過濾敏感字符來說明這種模式

// 主體,發送消息
function sendMsg(msg) {
  console.log(msg);
}

// 代理,對消息進行過濾
function proxySendMsg(msg) {
  // 無消息則直接返回
  if (typeof msg === 'undefined') {
    console.log(null);
    return;
  }
  
  // 有消息則進行過濾
  msg = ('' + msg).replace(/泥\s*煤/g, '');

  sendMsg(msg);
}


sendMsg('泥煤呀泥 煤呀'); // 泥煤呀泥 煤呀
proxySendMsg('泥煤呀泥 煤'); // 呀
proxySendMsg(); // null

這樣操作的意圖很明顯,當沒有消息的時候,控制對主體對象的訪問,代理直接返回一個 null ,有消息,則會過濾掉敏感字符,實現虛擬代理。

策略模式

策略模式就是內部封裝一些算法,它們之間可以互相替換,但是它們不隨客戶端變化而變化。

策略模式我們外部看不到算法的具體實現,我們也只關心算法實現的結果,不關注過程。

這裏以一個商品促銷的例子來說明下:在聖誕節,某些商品需要八折出售,有些商品需要九折出售,到了元旦節,普通客戶滿100減30,vip客戶滿100減50。可以看到商品出售的價格需要根據不同的條件來規定,分別採取不同的算法實現,所以我們採用策略模式。

// 價格策略對象
class PriceStrategy {
  constructor() {
      // 內部算法對象
    this.stragtegy = {
        // 100返30
      return30(price) {
          return +price + parseInt( price / 100) * 30;
      },
      // 100 返 50
      return50(price) {
          return +price + parseInt(price/ 100) * 50;
      },
      // 9 折
      percent90(price) {
          return price * 100 * 90 / 10000
      },
      percent80(price) {
          return price * 100 * 80 / 10000
      },
      percent50(price) {
          return price * 100 * 50 / 10000
      }
    }
  }
  // 策略算法調用接口
  getPrice(algorithm, price) {
    return this.stragtegy[algorithm] && this.stragtegy[algorithm](price);
  }
}
let priceStrategy = new PriceStrategy();
let price = priceStrategy.getPrice('return50', 314.67);
console.log(price);

這樣,我們可以採取不同的策略算法得到商品的不同價格。

觀察者模式

觀察者模式又稱為 “發布-訂閱模式”,通過定義一種依賴關係,當一個對象狀態發生改變時,訂閱者會得到通知。

其實,我們傳統的 DOM 事件綁定就是一種發布-訂閱模式。

// 訂閱
document.body.addEventListener('click', function() {
  console.log('click1');
}, false);

document.body.addEventListener('click', function() {
  console.log('click2');
}, false);

// 發布
document.body.click(); // click1  click2

裝飾者模式

裝飾者模式就是在不改變原對象基本功能的基礎上,通過增加功能使得原本對象滿足用戶的更為複雜的需求。

比如有這麼一個需求:

用戶點擊輸入框時,如果輸入框輸入的內容有限制,那麼在其後面显示用戶輸入內容的限制格式的提示文案

—————->>>>>>> 現在要改為:

多加一條需求,默認輸入框上邊显示一行文案,當用戶點擊輸入框的時候,文案消失。

這裡是以前的代碼:

// 輸入框元素
let telInput = document.getElementById('tel_input');
// 輸入框提示文案
let telWarnText = document.getElementById('tel_warn_text');
// 點擊輸入框显示輸入框輸入格式提示文案
input.onclick = function () {
  telWarnText.style.display = 'inline-block';
};

修改之後的代碼:

// 輸入框元素
let telInput = document.getElementById('tel_input');
// 輸入框輸入格式提示文案
let telWarnText = document.getElementById('tel_warn_text');
// 輸入框提示輸入文案
let telDemoText = document.getElementById('tel_demo_text');
// 點擊輸入框显示輸入框輸入格式提示文案
input.onclick = function () {
  telWarnText.style.display = 'inline-block';
  telDemoText.style.display = 'none';
};

但是緊接着悲劇就來了,修改了電話輸入框,還有姓名、地址輸入框等等;

裝飾已有的功能對象

原有的功能已經不滿足用戶的需求了,此時需要做的是對原有的功能添加,設置新的屬性和方法來滿足新的需求,但是有不影響原來已經有的部分。

let decorator = function (input, fn) {
  let getInput = document.getElementById(input);
  if(typeof getInput.onclick === 'function') {
    let oldClick = getInput.onclick;
    getInput.onclick = function() {
        // 原來的事件回調函數
        oldClick();
        // 新增的事件回調函數
        fn();
    }
  } else {
    getInput.onclick = fn;
  }
  // 其他事件
};

// 電話輸入框功能裝飾
decorator('tel_input', function() {
  document.getElementById('tel_demo_text').sytle.display = 'none'
});
// 姓名輸入框裝飾
decorator('name_input', function() {
  document.getElementById('name_demo_text').sytle.display = 'none'
});
// 地址輸入框裝飾
decorator('address_input', function() {
  document.getElementById('address_demo_text').sytle.display = 'none'
});

后語

本編文章出自於我的 github 倉庫 ,歡迎喜歡的夥伴 star ,謝謝 。

倉庫地址 前端學習

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

大型網站如何防止崩潰,解決高併發帶來的問題

大型網站,比如門戶網站,在面對大量用戶訪問、高併發請求方面帶來的問題
1大併發:在同一個時間點,有大量的客戶來訪問我們的網站,如果訪問量過大,就可能造成網站癱瘓。
2大流量:當網站大后,有大量的圖片,視頻, 這樣就會對流量要求高,需要更多更大的帶寬。
3大存儲:你的數據量會成海量的數據,如果我們的數據放入一張表,是無法應對的。可能對數據保存和查詢出現問題。

基本的解決方案集中在這樣幾個環節:使用高性能的服務器、高性能的數據庫、高效率的編程語言、還有高性能的Web容器,(對架構分層+負載均衡+集群)這幾個解決思路在一定程度上意味着更大的投入。

解決方案:

   一、提高硬件能力、增加系統服務器。(當服務器增加到某個程度的時候系統所能提供的併發訪問量幾乎不變,所以不能根本解決問題)

   二、使用緩存(本地緩存:本地可以使用JDK自帶的 Map、Guava Cache.分佈式緩存:Redis、Memcache.本地緩存不適用於提高系統併發量,一般是用處用在程序中。比如Spring是如何實現單例的呢?大家如果看過源碼的話,應該知道,Spiring把已經初始過的變量放在一個Map中,下次再要使用這個變量的時候,先判斷Map中有沒有,這也就是系統中常見的單例模式的實現。)

 分佈式緩存利器Redis集群,Redis集群的搭建至少需要三主三從。

1. 所有的redis節點彼此互聯(PING-PONG機制),內部使用二進制協議優化傳輸速度和帶寬。

2. 節點的fail是通過集群中超過半數的節點檢測失效時才生效(所以一個集群中至少要有三個節點)。

3. 客戶端與redis節點直連,不需要中間proxy層.客戶端不需要連接集群所有節點,連接集群中任何一個可用節點即可。

4. 集群中每一個節點都存放不同的內容,每一個節點都應有備份機。

5. redis-cluster把所有的物理節點映射到[0-16383]slot上,cluster 負責維護node<->slot<->value


Redis 集群中內置了16384 個哈希槽,當需要在Redis 集群中放置一個key-value 時,redis先對 key 使用 crc16 算法算出一個結果,然後把結果對16384 求餘數,這樣每個key 都會對應一個編號在0-16383 之間的哈希槽,redis會根據節點數量大致均等的將哈希槽映射到不同的節點。

   三 、消息隊列 (解耦+削峰+異步)通過異步處理提高系統性能,降低系統耦合性

在不使用消息隊列服務器的時候,用戶的請求數據直接寫入數據庫,在高併發的情況下數據庫壓力劇增,使得響應速度變慢。但是在使用消息隊列之後,用戶的請求數據發送給消息隊列之後立即 返回,再由消息隊列的消費者進程從消息隊列中獲取數據,異步寫入數據庫。由於消息隊列服務器處理速度快於數據庫(消息隊列也比數據庫有更好的伸縮性),因此響應速度得到大幅改善。


通過使用消息中間件對Dubbo服務間的調用進行解耦, 消息中間件可利用高效可靠的消息傳遞機制進行平台無關的數據交流,並基於數據通信來進行分佈式系統的集成。通過提供消息傳遞和消息排隊模型,可以在分佈式環境下擴展進程間的通信。通過消息中間件,應用程序或組件之間可以進行可靠的異步通訊,從而降低系統之間的耦合度,提高系統的可擴展性和可用性。

   四 、採用分佈式開發 (不同的服務部署在不同的機器節點上,並且一個服務也可以部署在多台機器上,然後利用 Nginx 負載均衡訪問。這樣就解決了單點部署(All In)的缺點,大大提高的系統併發量)

   五 、數據庫分庫(讀寫分離)、分表(水平分表、垂直分表)

PXC高可用集群與Replication集群結合方案

這種的集群在遇到單表數據量超過2000萬的時候,mysql性能會受損,所以一個集群還不夠,我們需要把數據分到另一個集群,這個稱為“切片”,就是把大量的數據拆分到不同的集群中,每個集群的數據都是不一樣的,通過MyCat這個阿里巴巴的開源中間件,可以把sql分到不同的集群裏面去。

PXC集群方案與Replication區別

PXC集群方案所有節點都是可讀可寫的,Replication從節點不能寫入,因為主從同步是單向的,無法從slave節點向master點同步。

PXC同步機制是同步進行的,這也是它能保證數據強一致性的根本原因,Replication同步機制是異步進行的,它如果從節點停止同步,依然可以向主節點插入數據,正確返回,造成數據主從數據的不一致性。

PXC是用犧牲性能保證數據的一致性,Replication在性能上是高於PXC的。所以兩者用途也不一致。PXC是用於重要信息的存儲,例如:訂單、用戶信息等。Replication用於一般信息的存儲,能夠容忍數據丟失,例如:購物車,用戶行為日誌等

   六、 採用集群 (多台機器提供相同的服務)系統架構方案

   七、CDN 加速 (將一些靜態資源比如圖片、視頻等等緩存到離用戶最近的網絡節點)

   八、瀏覽器緩存 頁面靜態化(使用php自己的ob緩存技術實現, 主流的mvc框架(tp,yii,laravel)模板引擎一般都自帶頁面靜態化 )      

   九、使用合適的連接池(數據庫連接池、線程池等等)

   十、適當使用多線程進行開發。

   十一、使用鏡像

鏡像是大型網站常採用的提高性能和數據安全性的方式,鏡像的技術可以解決不同網絡接入商和地域帶來的用戶訪問速度差異,比如ChinaNet和EduNet之間的差異就促使了很多網站在教育網內搭建鏡像站點,數據進行定時更新或者實時更新。有很多專業的現成的解決架構和產品可選。也有廉價的通過軟件實現的思路,比如Linux上的rsync等工具。

   十二、圖片服務器分離

大家知道,對於Web服務器來說,不管是Apache、IIS還是其他容器,圖片是最消耗資源的,於是我們有必要將圖片與頁面進行分離,這是基本上大型網站都會採用的策略,他們都有獨立的、甚至很多台的圖片服務器。這樣的架構可以降低提供頁面訪問請求的服務器系統壓力,並且可以保證系統不會因為圖片問題而崩潰。

在應用服務器和圖片服務器上,可以進行不同的配置優化,比如apache在配置ContentType的時候可以盡量少支持、盡可能少的LoadModule,保證更高的系統消耗和執行效率。


【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

WebApp 安全風險與防護課堂開課了!

本文由葡萄城技術團隊於原創並首發

轉載請註明出處:葡萄城官網,葡萄城為開發者提供專業的開發工具、解決方案和服務,賦能開發者。


2018 網絡安全事故頻發,從數據泄露、信息竊取,到 DDOS 攻擊、勒索病毒,不僅威脅的總數在增加,威脅態勢也變得更加多樣化,攻擊者在不斷開發新的攻擊途徑的同時,也儘力在攻擊過程中掩蓋其蹤跡,使網絡安全防護變得越發棘手。未來是萬物互聯的時代,唯有把握住網絡信息安全,才能避免被降維打擊。

為了回饋社區,我們特邀葡萄城高級架構師、安全專家Carl作為分享嘉賓,於葡萄城技術公開課上,以 WebApp 安全防護為出發點,帶你了解更多意想不到的安全防護措施與黑客攻擊手段,助你提高網絡安全意識,最終學會如何規避風險隱患,避免遭受網絡安全攻擊。

本次課程共分三節,計劃講的內容如下:

第一節:開闊眼界 – 提升安全意識

提升網絡安全意識對項目團隊中的每一個角色、每一個流程都至關重要。同時,也只有具備了網絡安全意識,才願意為數據安全投入更多的時間和精力。下面,我將為您展示部分2018年發生的網絡安全事故,這些事故造成的損失,也許遠遠超出你的想象。

2018 網絡安全事故回顧

Facebook數據泄露事件:2018年9月,Facebook因安全系統漏洞而遭受黑客攻擊,導致約5000萬用戶信息泄露。

上市公司數據堂,涉嫌侵犯數百億條公民個人信息:大數據行業知名企業數據堂在短短8個月的時間內,日均泄露公民個人信息1.3億餘條,累計傳輸數據壓縮后約為4000GB。

圓通10億快遞信息泄露: 10億條用戶數據遭公開售賣,這些數據包括寄(收)件人姓名、電話、地址等隱私信息。

萬豪酒店5億用戶開房信息泄露:萬豪酒店客房預訂數據庫遭黑客入侵,約5億名客戶的信息可能被泄露。

更多數據泄露事件

  1. 國泰航空數據泄露,940萬乘客受影響
  2. MongoDB 數據庫被入侵, 1100 萬份郵件記錄遭泄露
  3. SHEIN 數據泄露影響 642 萬用戶
  4. GovPayNet憑證系統存在漏洞,1400萬交易記錄被曝光
  5. 小米有品平台泄露個人隱私 約2000萬用戶數據遭泄露
  6. …
  7. 美國亞特蘭大市政府受到勒索軟件攻擊
  8. 美國巴爾的摩市遭遇勒索軟件攻擊,導致911緊急調度服務的計算機輔助調度(CAD)功能掉線
  9. 台積電勒索病毒事件,約造成17.6 億元的營收損失,股票市值下跌78億
  10. 很多個人電腦和中小網站都曾遭受攻擊
  11. 平昌冬奧會開幕式服務器遭到身份不明的黑客入侵
  12. GitHub遭1.35T級流量攻擊
  13. CPU數據緩存機制漏洞
  14. iOS 平台WebView組件漏洞(UIWebView/ WKWebView)跨域訪問漏洞(CNNVD-201801-515)
  15. Oracle WebLogic Server WLS核心組件遠程代碼執行漏洞
  16. 微信支付SDKXXE漏洞
  17. Apache Struts2 S2-057安全漏洞

勒索病毒事件

DDoS 攻擊

年度重大漏洞盤點

第二節:知己知彼 – 黑客如何攻擊系統

一名黑客攻擊網站的典型步驟,主要分為以下5步:

  1. 信息收集和漏洞掃描
  2. 漏洞利用
  3. 上傳木馬
  4. 獲取服務器的控制權
  5. 清理痕迹

總結:

黑客不是手動測試系統漏洞的,而是有很多強大的工具可以自動化完成

黑客不是利用系統中的一個漏洞,而是要利用一系列,不同層次的漏洞

黑客經常批量攻擊一系列網站,選取其中漏洞較多,較好利用的重點突破

第三節:十大安全風險(OWASP Top 10)

不安全的軟件正在破壞着我們的金融、醫療、國防、能源和其他重要的基礎設施。隨着我們的軟件變得愈加龐大、複雜且相互關聯,實現應用程序安全的難度也呈指數級增長。而現代軟件開發過程的飛速發展,使得快速、準確地識別軟件安全風險變得愈發的重要,OWASP 組織也因此誕生。

OWASP,即開放式Web應用程序安全項目(Open Web Application Security Project),作為一個開源的、非盈利的全球性安全組織,它提供了有關計算機和互聯網應用程序的公正、實際、有成本效益的信息,其目的是協助個人、企業和機構來發現並使用可信賴的軟件。

OWASP Top 10是由OWASP組織公布,最具權威性的“10項最嚴重的Web應用程序安全風險預警”,其就安全問題從威脅性和脆弱性兩方面進行可能性分析,並結合技術和商業影響的分析結果,輸出公認的、最嚴重的十類Web應用安全風險排名。OWASP Top 10旨在針對上述風險,提出解決方案,幫助IT公司和開發團隊規範應用程序開發流程和測試流程,提高Web產品的安全性。

OWASP敦促所有公司在其組織內採用OWASP Top 10文檔,並確保其Web應用程序最大限度地降低這些風險,採用OWASP Top 10可能是將企業內的軟件開發文化轉變為生成安全代碼文化最行之有效的一步。

OWASP Top 10包括:

  1. 注入
  2. 失效的身份認證
  3. 敏感信息泄露
  4. XML外部實體(XXE)
  5. 失效的訪問控制
  6. 安全配置錯誤
  7. 跨站腳本(XSS)
  8. 不安全的反序列化
  9. 使用含有已知漏洞的組件

10. 不足的日誌記錄和監控

講師介紹:

Carl(陳慶),葡萄城高級架構師、安全專家、葡萄城技術公開課講師。擁有15年項目開發經驗,專註於產品架構、編程技術等領域,對網絡安全有着獨到見解,曾擔任微軟TechEd講師,樂於研究各種前沿技術並分享。

請點擊該地址報名觀看直播:http://live.vhall.com/137416596

錯過本場直播?沒關係,所有直播內容我們會存放在葡萄城公開課頁面,便於您隨時觀看、學習。後續我們也會將Carl老師講的內容整理成文章,發布在社區,敬請關注。

“賦能開發者”葡萄城除了為所有開發人員提供免費的開發技巧分享、項目實戰經驗外,還提供了眾多高水準、高品質的開發工具和開發者解決方案,可有效幫助開發人員提高效率,縮短項目周期,使開發人員能更專註於業務邏輯,順利完成高質量的項目交付,歡迎您深入了解。

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

kafka消費者客戶端

Kafka消費者

1.1 消費者與消費者組

消費者與消費者組之間的關係

​ 每一個消費者都隸屬於某一個消費者組,一個消費者組可以包含一個或多個消費者,每一條消息只會被消費者組中的某一個消費者所消費。不同消費者組之間消息的消費是互不干擾的。

為什麼會有消費者組的概念

​ 消費者組出現主要是出於兩個目的:

​ (1) 使整體的消費能力具備橫向的伸縮性。可以適當增加消費者組中消費者的數量,來提高整體的消費能力。但是每一個分區至多被消費者組的中一個消費者所消費,因此當消費者組中消費者數量超過分區數時,多出的消費者不會分配到任何一個分區。當然這是默認的分區分配策略,可通過partition.assignment.strategy進行配置。

​ (2) 實現消息消費的隔離。不同消費者組之間消息消費互不干擾,從而實現發布訂閱這種消息投遞模式。

注意:

​ 消費者隸屬的消費者組可以通過group.id進行配置。消費者組是一個邏輯上的概念,但消費者並不是一個邏輯上的概念,它可以是一個線程,也可以是一個進程。同一個消費者組內的消費者可以部署在同一台機器上,也可以部署在不同的機器上。

1.2 消費者客戶端開發

​ 一個正常的消費邏輯需要具備以下幾個步驟:

  • 配置消費者客戶端參數及創建相應的消費者實例。

  • 訂閱主題

  • 拉取消息並消費

  • 提交消費位移

  • 關閉消費者實例

  public class KafkaConsumerAnalysis {
  public static final String brokerList="node112:9092,node113:9092,node114:9092";
  public static final String topic = "topic-demo";
  public static final String groupId = "group.demo";
  public static final AtomicBoolean isRunning = new AtomicBoolean(true);
​
  public static Properties initConfig() {
      Properties prop = new Properties();
      prop.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, brokerList);
      prop.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
      prop.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
      prop.put(ConsumerConfig.GROUP_ID_CONFIG, groupId);
      prop.put(ConsumerConfig.CLIENT_DNS_LOOKUP_CONFIG, "consumer.client.di.demo");
      return prop;
  }
​
​
  public static void main(String[] args) {
      KafkaConsumer<String, String> consumer = new KafkaConsumer<String, String>(initConfig());
       
      for (ConsumerRecord<String, String> record : records) {
          System.out.println("topic = " + record.topic() + ", partition =" +                                               record.partition() + ", offset = " + record.offset());
          System.out.println("key = " + record.key() + ", value = " + record.value());
              }
          }
      } catch (Exception e) {
          e.printStackTrace();
      }finally {
          consumer.close();
      }
  }
}
​

1.2.1 訂閱主題和分區

​ 先來說一下消費者訂閱消息的粒度:一個消費者可以訂閱一個主題、多個主題、或者多個主題的特定分區。主要通過subsribe和assign兩個方法實現訂閱。

(1)訂閱一個主題:

​ public void subscribe(Collection<String> topics),當集合中有一個主題時。

(2)訂閱多個主題:

​ public void subscribe(Collection<String> topics),當集合中有多個主題時。

​ public void subscribe(Pattern pattern),通過正則表達式實現消費者主題的匹配。通過這種方式,如果在消息消費的過程中,又添加了新的能夠匹配到正則的主題,那麼消費者就可以消費到新添加的主題。 consumer.subscribe(Pattern.compile(“topic-.*”));

(3)多個主題的特定分區

​ public void assign(Collection<TopicPartition> partitions),可以實現訂閱某些特定的主題分區。TopicPartition包括兩個屬性:topic(String)和partition(int)。

​ 如果事先不知道有多少分區該如何處理,KafkaConsumer中的partitionFor方法可以獲得指定主題分區的元數據信息:

​ public List<PartitionInfo> partitionsFor(String topic)

​ PartitionInfo的屬性如下:

  
public class PartitionInfo {
  private final String topic;//主題
  private final int partition;//分區
  private final Node leader;//分區leader
  private final Node[] replicas;//分區的AR
  private final Node[] inSyncReplicas;//分區的ISR
  private final Node[] offlineReplicas;//分區的OSR
}

​ 因此也可以通過這個方法實現某個主題的全部訂閱。

​ 需要指出的是,subscribe(Collection)、subscirbe(Pattern)、assign(Collection)方法分別代表了三種不同的訂閱狀態:AUTO_TOPICS、AUTO_PATTREN和USER_ASSIGN,這三種方式是互斥的,消費者只能使用其中一種,否則會報出IllegalStateException。

​ subscirbe方法可以實現消費者自動再平衡的功能。多個消費者的情況下,可以根據分區分配策略自動分配消費者和分區的關係,當消費者增加或減少時,也能實現負載均衡和故障轉移。

​ 如何實現取消訂閱:

​ consumer.unsubscribe()

1.2.2 反序列化

​ KafkaProducer端生產消息進行序列化,同樣消費者就要進行相應的反序列化。相當於根據定義的序列化格式的一個逆序提取數據的過程。

  
import com.gdy.kafka.producer.Company;
import org.apache.kafka.common.errors.SerializationException;
import org.apache.kafka.common.serialization.Deserializer;
​
import java.io.UnsupportedEncodingException;
import java.nio.ByteBuffer;
import java.util.Map;
​
public class CompanyDeserializer implements Deserializer<Company> {
  @Override
  public void configure(Map<String, ?> configs, boolean isKey) {
​
  }
​
  @Override
  public Company deserialize(String topic, byte[] data) {
      if(data == null) {
          return null;
      }
​
      if(data.length < 8) {
          throw new SerializationException("size of data received by Deserializer is shorter than expected");
      }
​
      ByteBuffer buffer = ByteBuffer.wrap(data);
      int nameLength = buffer.getInt();
      byte[] nameBytes = new byte[nameLength];
      buffer.get(nameBytes);
      int addressLen = buffer.getInt();
      byte[] addressBytes = new byte[addressLen];
      buffer.get(addressBytes);
      String name,address;
      try {
          name = new String(nameBytes,"UTF-8");
          address = new String(addressBytes,"UTF-8");
      }catch (UnsupportedEncodingException e) {
          throw new SerializationException("Error accur when deserializing");
      }
​
      return new Company(name, address);
  }
​
  @Override
  public void close() {
​
  }
}

​ 實際生產中需要自定義序列化器和反序列化器時,推薦使用Avro、JSON、Thrift、ProtoBuf或者Protostuff等通用的序列化工具來包裝。

1.2.3 消息消費

​ Kafka中消息的消費是基於拉模式的,kafka消息的消費是一個不斷輪旋的過程,消費者需要做的就是重複的調用poll方法。

  
public ConsumerRecords<K, V> poll(final Duration timeout)

​ 這個方法需要注意的是,如果消費者的緩衝區中有可用的數據,則會立即返回,否則會阻塞至timeout。如果在阻塞時間內緩衝區仍沒有數據,則返回一個空的消息集。timeout的設置取決於應用程序對效應速度的要求。如果應用線程的位移工作是從Kafka中拉取數據並進行消費可以將這個參數設置為Long.MAX_VALUE。

​ 每次poll都會返回一個ConsumerRecords對象,它是ConsumerRecord的集合。對於ConsumerRecord相比於ProducerRecord多了一些屬性:

  
private final String topic;//主題
  private final int partition;//分區
  private final long offset;//偏移量
  private final long timestamp;//時間戳
  private final TimestampType timestampType;//時間戳類型
  private final int serializedKeySize;//序列化key的大小
  private final int serializedValueSize;//序列化value的大小
  private final Headers headers;//headers
  private final K key;//key
  private final V value;//value
  private volatile Long checksum;//CRC32校驗和

​ 另外我們可以按照分區維度對消息進行消費,通過ConsumerRecords.records(TopicPartiton)方法實現。

  
ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(1000));
    Set<TopicPartition> partitions = records.partitions();
    for (TopicPartition tp : partitions) {
        for (ConsumerRecord<String, String> record : records.records(tp)) {
              System.out.println(record.partition() + " ," + record.value());
        }
    }

​ 另外還可以按照主題維度對消息進行消費,通過ConsumerRecords.records(Topic)實現。

  
for (String topic : topicList) {
      for (ConsumerRecord<String, String> record : records.records(topic)) {
              System.out.println(record.partition() + " ," + record.value());
      }
}

1.2.4 消費者位移提交

​ 首先要 明白一點,消費者位移是要做持久化處理的,否則當發生消費者崩潰或者消費者重平衡時,消費者消費位移無法獲得。舊消費者客戶端是將位移提交到zookeeper上,新消費者客戶端將位移存儲在Kafka內部主題_consumer_offsets中。

​ KafkaConsumer提供了兩個方法position(TopicPatition)和commited(TopicPartition)。

​ public long position(TopicPartition partition)—–獲得下一次拉取數據的偏移量

​ public OffsetAndMetadata committed(TopicPartition partition)—–給定分區的最後一次提交的偏移量。

還有一個概念稱之為lastConsumedOffset,這個指的是最後一次消費的偏移量。

​ 在kafka提交方式有兩種:自動提交和手動提交。

(1)自動位移提交

​ kafka默認情況下採用自動提交,enable.auto.commit的默認值為true。當然自動提交並不是沒消費一次消息就進行提交,而是定期提交,這個定期的周期時間由auto.commit.intervals.ms參數進行配置,默認值為5s,當然這個參數生效的前提就是開啟自動提交。

​ 自動提交會造成重複消費和消息丟失的情況。重複消費很容易理解,因為自動提交實際是延遲提交,因此很容易造成重複消費,然後消息丟失是怎麼產生的?

(2)手動位移提交

​ 開始手動提交的需要配置enable.auto.commit=false。手動提交消費者偏移量,又可分為同步提交和異步提交。

​ 同步提交:

​ 同步提交很簡單,調用commitSync() 方法:

  
while (isRunning.get()) {
        ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(1000));
        for (ConsumerRecord<String, String> record : records) {
            //consume message
            consumer.commitSync();
        }
}

​ 這樣,每消費一條消息,提交一個偏移量。當然可用過緩存消息的方式,實現批量處理+批量提交:

  
while (isRunning.get()) {
      ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(1000));
      for (ConsumerRecord<String, String> record : records) {
            buffer.add(record);
      }
      if (buffer.size() >= minBaches) {
          for (ConsumerRecord<String, String> record : records) {
              //consume message
          }
          consumer.commitSync();
          buffer.clear();
      }
}

​ 還可以通過public void commitSync(final Map<TopicPartition, OffsetAndMetadata> offsets)這個方法實現按照分區粒度進行同步提交。

  
while (isRunning.get()) {
  ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(1000));
  for (TopicPartition tp : records.partitions()) {
      List<ConsumerRecord<String, String>> partitionRecords = records.records(tp);
      for (ConsumerRecord record : partitionRecords) {
          //consume message
      }
      long lastConsumerOffset = partitionRecords.get(partitionRecords.size() - 1).offset();
      consumer.commitSync(Collections.singletonMap(tp,new                                                               OffsetAndMetadata(lastConsumerOffset+1)));
  }
}

​ 異步提交:

​ commitAsync異步提交的時候消費者線程不會被阻塞,即可能在提交偏移量的結果還未返回之前,就開始了新一次的拉取數據操作。異步提交可以提升消費者的性能。commitAsync有三個重載:

​ public void commitAsync()

​ public void commitAsync(OffsetCommitCallback callback)

​ public void commitAsync(final Map<TopicPartition, OffsetAndMetadata> offsets, OffsetCommitCallback )

​ 對照同步提交的方法參數,多了一個Callback回調參數,它提供了一個異步提交的回調方法,當消費者位移提交完成后回調OffsetCommitCallback的onComplement方法。以第二個方法為例:

  
ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(1000));
  for (ConsumerRecord<String, String> record : records) {
      //consume message
  }
  consumer.commitAsync(new OffsetCommitCallback() {
      @Override
      public void onComplete(Map<TopicPartition, OffsetAndMetadata> offsets, Exception e) {
          if (e == null) {
              System.out.println(offsets);
          }else {
                e.printStackTrace();
          }
      }
});

1.2.5 控制和關閉消費

​ kafkaConsumer提供了pause()和resume() 方法分別實現暫停某些分區在拉取操作時返回數據給客戶端和恢復某些分區向客戶端返回數據的操作:

​ public void pause(Collection<TopicPartition> partitions)

​ public void resume(Collection<TopicPartition> partitions)

​ 優雅停止KafkaConsumer退出消費者循環的方式:

​ (1)不要使用while(true),而是使用while(isRunning.get()),isRunning是一個AtomicBoolean類型,可以在其他地方調用isRunning.set(false)方法退出循環。

​ (2)調用consumer.wakup()方法,wakeup方法是KafkaConsumer中唯一一個可以從其他線程里安全調用的方法,會拋出WakeupException,我們不需要處理這個異常。

​ 跳出循環后一定要显示的執行關閉動作和釋放資源。

1.2.6 指定位移消費

KafkaConsumer可通過兩種方式實現實現不同粒度的指定位移消費。第一種是通過auto.offset.reset參數,另一種通過一個重要的方法seek。

(1)auto.offset.reset

auto.offset.reset這個參數總共有三種可配置的值:latest、earliest、none。如果配置不在這三個值當中,就會拋出ConfigException。

latest:當各分區下有已提交的offset時,從提交的offset開始消費;無提交的offset或位移越界時,消費新產生的該分區下的數據

earliest:當各分區下有已提交的offset時,從提交的offset開始消費;無提交的offset或位移越界時,從頭開始消費

none:topic各分區都存在已提交的offset時,從offset后開始消費;只要有一個分區不存在已提交的offset或位移越界,則拋出NoOffsetForPartitionException異常

消息的消費是通過poll方法進行的,poll方法對於開發者來說就是一個黑盒,無法精確的掌控消費的起始位置。即使通過auto.offsets.reset參數也只能在找不到位移或者位移越界的情況下粗粒度的從頭開始或者從末尾開始。因此,Kafka提供了另一種更細粒度的消費掌控:seek。

(2)seek

seek可以實現追前消費和回溯消費:

  
public void seek(TopicPartition partition, long offset)

可以通過seek方法實現指定分區的消費位移的控制。需要注意的一點是,seek方法只能重置消費者分配到的分區的偏移量,而分區的分配是在poll方法中實現的。因此在執行seek方法之前需要先執行一次poll方法獲取消費者分配到的分區,但是並不是每次poll方法都能獲得數據,所以可以採用如下的方法。

  
consumer.subscribe(topicList);
  Set<TopicPartition> assignment = new HashSet<>();
  while(assignment.size() == 0) {
      consumer.poll(Duration.ofMillis(100));
      assignment = consumer.assignment();//獲取消費者分配到的分區,沒有獲取返回一個空集合
  }
​
  for (TopicPartition tp : assignment) {
      consumer.seek(tp, 10); //重置指定分區的位移
  }
  while (true) {
      ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(1000));
      //consume record
    }

如果對未分配到的分區執行了seek方法,那麼會報出IllegalStateException異常。

在前面我們已經提到,使用auto.offsets.reset參數時,只有當消費者分配到的分區沒有提交的位移或者位移越界時,才能從earliest消費或者從latest消費。seek方法可以彌補這一中情況,實現任意情況的從頭或從尾部消費。

   Set<TopicPartition> assignment = new HashSet<>();
  while(assignment.size() == 0) {
      consumer.poll(Duration.ofMillis(100));
      assignment = consumer.assignment();
  }
  Map<TopicPartition, Long> offsets = consumer.endOffsets(assignment);//獲取指定分區的末尾位置
  for (TopicPartition tp : assignment) {
      consumer.seek;
  }

與endOffset對應的方法是beginningOffset方法,可以獲取指定分區的起始位置。其實kafka已經提供了一個從頭和從尾消費的方法。

  
public void seekToBeginning(Collection<TopicPartition> partitions)
public void seekToEnd(Collection<TopicPartition> partitions)

還有一種場景是這樣的,我們並不知道特定的消費位置,卻知道一個相關的時間點。為解決這種場景遇到的問題,kafka提供了一個offsetsForTimes()方法,通過時間戳來查詢分區消費的位移。

      Map<TopicPartition, Long> timestampToSearch = new HashMap<>();
  for (TopicPartition tp : assignment) {
      timestampToSearch.put(tp, System.currentTimeMillis() - 24 * 3600 * 1000);
  }
//獲得指定分區指定時間點的消費位移
  Map<TopicPartition, OffsetAndTimestamp> offsets =                                                                                   consumer.offsetsForTimes(timestampToSearch);
  for (TopicPartition tp : assignment) {
      OffsetAndTimestamp offsetAndTimestamp = offsets.get(tp);
      if (offsetAndTimestamp != null) {
              consumer.seek(tp, offsetAndTimestamp.offset());
      }
  }

由於seek方法的存在,使得消費者的消費位移可以存儲在任意的存儲介質中,包括DB、文件系統等。

1.2.7 消費者的再均衡

再均衡是指分區的所屬權從一個消費者轉移到另一消費者的行為,它為消費者組具備高可用和伸縮性提高保障。不過需要注意的地方有兩點,第一是消費者發生再均衡期間,消費者組中的消費者是無法讀取消息的。第二點就是消費者發生再均衡可能會引起重複消費問題,所以一般情況下要盡量避免不必要的再均衡。

KafkaConsumer的subscribe方法中有一個參數為ConsumerRebalanceListener,我們稱之為再均衡監聽器,它可以用來在設置發生再均衡動作前後的一些準備和收尾動作。

  public interface ConsumerRebalanceListener {
  void onPartitionsRevoked(Collection<TopicPartition> partitions);
  void onPartitionsAssigned(Collection<TopicPartition> partitions);
}

onPartitionsRevoked方法會在再均衡之前和消費者停止讀取消息之後被調用。可以通過這個回調函數來處理消費位移的提交,以避免重複消費。參數partitions表示再均衡前分配到的分區。

onPartitionsAssigned方法會在再均衡之後和消費者消費之間進行調用。參數partitons表示再均衡之後所分配到的分區。

  consumer.subscribe(topicList);
  Map<TopicPartition, OffsetAndMetadata> currentOffsets = new HashMap<>();
  consumer.subscribe(topicList, new ConsumerRebalanceListener() {
      @Override
      public void onPartitionsRevoked(Collection<TopicPartition> partitions) {
          consumer.commitSync(currentOffsets);//提交偏移量
      }
​
      @Override
      public void onPartitionsAssigned(Collection<TopicPartition> partitions) {
          //do something
      }
  });
​
  try {
      while (isRunning.get()) {
          ConsumerRecords<String, String> records = consumer.poll(Duration.ofMillis(1000));
          for (ConsumerRecord<String, String> record : records) {
              //process records
              //記錄當前的偏移量
              currentOffsets.put(new TopicPartition(record.topic(), record.partition()),new                               OffsetAndMetadata( record.offset() + 1));
          }
          consumer.commitAsync(currentOffsets, null);
      }
​
      } catch (Exception e) {
          e.printStackTrace();
      }finally {
          consumer.close();
      }

1.2.8 消費者攔截器

消費者攔截器主要是在消費到消息或者提交消費位移時進行一些定製化的操作。消費者攔截器需要自定義實現org.apache.kafka.clients.consumer.ConsumerInterceptor接口。

  public interface ConsumerInterceptor<K, V> extends Configurable {    
  public ConsumerRecords<K, V> onConsume(ConsumerRecords<K, V> records);
  public void onCommit(Map<TopicPartition, OffsetAndMetadata> offsets);
  public void close();
}

onConsume方法是在poll()方法返回之前被調用,比如修改消息的內容、過濾消息等。如果onConsume方法發生異常,異常會被捕獲並記錄到日誌中,但是不會向上傳遞。

Kafka會在提交位移之後調用攔截器的onCommit方法,可以使用這個方法來記錄和跟蹤消費的位移信息。

  
public class ConsumerInterceptorTTL implements ConsumerInterceptor<String,String> {
  private static final long EXPIRE_INTERVAL = 10 * 1000; //10秒過期
  @Override
  public ConsumerRecords<String, String> onConsume(ConsumerRecords<String, String> records) {
      long now = System.currentTimeMillis();
      Map<TopicPartition, List<ConsumerRecord<String, String>>> newRecords = new HashMap<>();
​
      for (TopicPartition tp : records.partitions()) {
          List<ConsumerRecord<String, String>> tpRecords = records.records(tp);
          List<ConsumerRecord<String, String>> newTpRecords = records.records(tp);
          for (ConsumerRecord<String, String> record : tpRecords) {
              if (now - record.timestamp() < EXPIRE_INTERVAL) {//判斷是否超時
                  newTpRecords.add(record);
              }
          }
          if (!newRecords.isEmpty()) {
              newRecords.put(tp, newTpRecords);
          }
​
​
      }
      return new ConsumerRecords<>(newRecords);
  }
​
  @Override
  public void onCommit(Map<TopicPartition, OffsetAndMetadata> offsets) {
      offsets.forEach((tp,offset) -> {
          System.out.println(tp + ":" + offset.offset());
      });
  }
​
  @Override
  public void close() {}
​
  @Override
  public void configure(Map<String, ?> configs) {}
}

使用這種TTL需要注意的是如果採用帶參數的位移提交方式,有可能提交了錯誤的位移,可能poll拉取的最大位移已經被攔截器過濾掉。

1.2.9 消費者的多線程實現

KafkaProducer是線程安全的,然而KafkaConsumer是非線程安全的。KafkaConsumer中的acquire方法用於檢測當前是否只有一個線程在操作,如果有就會拋出ConcurrentModifiedException。acuqire方法和我們通常所說的鎖是不同的,它不會阻塞線程,我們可以把它看做是一個輕量級的鎖,它通過線程操作計數標記的方式來檢測是否發生了併發操作。acquire方法和release方法成對出現,分表表示加鎖和解鎖。

  //標記當前正在操作consumer的線程
private final AtomicLong currentThread = new AtomicLong(NO_CURRENT_THREAD);
//refcount is used to allow reentrant access by the thread who has acquired currentThread,
//大概可以理解我加鎖的次數
private final AtomicInteger refcount = new AtomicInteger(0);
private void acquire() {
long threadId = Thread.currentThread().getId();
if (threadId != currentThread.get()&&!currentThread.compareAndSet(NO_CURRENT_THREAD, threadId))
      throw new ConcurrentModificationException("KafkaConsumer is not safe for multi-threaded access");
      refcount.incrementAndGet();
}
​
private void release() {
  if (refcount.decrementAndGet() == 0)
      currentThread.set(NO_CURRENT_THREAD);
}

kafkaConsumer中的每個共有方法在調用之前都會執行aquire方法,只有wakeup方法是個意外。

KafkaConsumer的非線程安全並不意味着消費消息的時候只能以單線程的方式執行。可以通過多種方式實現多線程消費。

(1)Kafka多線程消費第一種實現方式——–線程封鎖

所謂線程封鎖,就是為每個線程實例化一個KafkaConsumer對象。這種方式一個線程對應一個KafkaConsumer,一個線程(可就是一個consumer)可以消費一個或多個分區的消息。這種消費方式的併發度受限於分區的實際數量。當線程數量超過分分區數量時,就會出現線程限制額的情況。

  import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.common.serialization.StringDeserializer;
import java.time.Duration;
import java.util.Arrays;
import java.util.Properties;
​
public class FirstMutiConsumerDemo {
  public static final String brokerList="node112:9092,node113:9092,node114:9092";
  public static final String topic = "topic-demo";
  public static final String groupId = "group.demo";
​
  public static Properties initConfig() {
      Properties prop = new Properties();
      prop.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, brokerList);
      prop.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
      prop.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
      prop.put(ConsumerConfig.GROUP_ID_CONFIG, groupId);
      prop.put(ConsumerConfig.CLIENT_DNS_LOOKUP_CONFIG, "consumer.client.di.demo");
      prop.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, true);
      return prop;
  }
​
  public static void main(String[] args) {
      Properties prop = initConfig();
      int consumerThreadNum = 4;
      for (int i = 0; i < 4; i++) {
          new KafkaCoosumerThread(prop, topic).run();
      }
  }
​
  public static class KafkaCoosumerThread extends Thread {
  //每個消費者線程包含一個KakfaConsumer對象。
      private KafkaConsumer<String, String> kafkaConsumer;
      public KafkaCoosumerThread(Properties prop, String topic) {
          this.kafkaConsumer = new KafkaConsumer<String, String>(prop);
          this.kafkaConsumer.subscribe(Arrays.asList(topic));
      }
​
      @Override
      public void run() {
          try {
              while (true) {
                  ConsumerRecords<String, String> records = kafkaConsumer.poll(Duration.ofMillis(100));
                  for (ConsumerRecord<String, String> record : records) {
                      //處理消息模塊
                  }
              }
          } catch (Exception e) {
              e.printStackTrace();
          }finally {
              kafkaConsumer.close();
          }
      }
  }
}
​

這種實現方式和開啟多個消費進程的方式沒有本質的區別,優點是每個線程可以按照順序消費消費各個分區的消息。缺點是每個消費線程都要維護一個獨立的TCP連接,如果分區數和線程數都很多,那麼會造成不小的系統開銷。

(2)Kafka多線程消費第二種實現方式——–多個消費線程同時消費同一分區

多個線程同時消費同一分區,通過assign方法和seek方法實現。這樣就可以打破原有消費線程個數不能超過分區數的限制,進一步提高了消費的能力,但是這種方式對於位移提交和順序控制的處理就會變得非常複雜。實際生產中很少使用。

(3)第三種實現方式——-創建一個消費者,records的處理使用多線程實現

一般而言,消費者通過poll拉取數據的速度相當快,而整體消費能力的瓶頸也正式在消息處理這一塊。基於此

考慮第三種實現方式。

  import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.common.serialization.StringDeserializer;
import java.time.Duration;
import java.util.Arrays;
import java.util.Properties;
import java.util.concurrent.ArrayBlockingQueue;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.ThreadPoolExecutor;
import java.util.concurrent.TimeUnit;
​
public class ThirdMutiConsumerThreadDemo {
  public static final String brokerList="node112:9092,node113:9092,node114:9092";
  public static final String topic = "topic-demo";
  public static final String groupId = "group.demo";
​
  public static Properties initConfig() {
      Properties prop = new Properties();
      prop.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, brokerList);
      prop.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
      prop.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
      prop.put(ConsumerConfig.GROUP_ID_CONFIG, groupId);
      prop.put(ConsumerConfig.CLIENT_DNS_LOOKUP_CONFIG, "consumer.client.di.demo");
      prop.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, true);
      return prop;
  }
​
  public static void main(String[] args) {
      Properties prop = initConfig();
      KafkaConsumerThread consumerThread = new KafkaConsumerThread(prop, topic, Runtime.getRuntime().availableProcessors());
      consumerThread.start();
  }
​
​
  public static class KafkaConsumerThread extends Thread {
      private KafkaConsumer<String, String> kafkaConsumer;
      private ExecutorService executorService;
      private int threadNum;
​
      public KafkaConsumerThread(Properties prop, String topic, int threadNum) {
          this.kafkaConsumer = new KafkaConsumer<String, String>(prop);
          kafkaConsumer.subscribe(Arrays.asList(topic));
          this.threadNum = threadNum;
          executorService = new ThreadPoolExecutor(threadNum, threadNum, 0L, TimeUnit.MILLISECONDS,
            new ArrayBlockingQueue<>(1000), new ThreadPoolExecutor.CallerRunsPolicy());
      }
​
      @Override
      public void run() {
          try {
              while (true) {
                  ConsumerRecords<String, String> records = kafkaConsumer.poll(Duration.ofMillis(100));
                  if (!records.isEmpty()) {
                      executorService.submit(new RecordHandler(records));
                  }
              }
          } catch (Exception e) {
              e.printStackTrace();
          }finally {
              kafkaConsumer.close();
          }
      }
  }
​
  public static class RecordHandler implements Runnable {
      public final ConsumerRecords<String,String> records;
      public RecordHandler(ConsumerRecords<String, String> records) {
          this.records = records;
      }
       
      @Override
      public void run() {
          //處理records
      }
  }
}
​
​

KafkaConsumerThread類對應一個消費者線程,裏面通過線程池的方式調用RecordHandler處理一批批的消息。其中線程池採用的拒絕策略為CallerRunsPolicy,當阻塞隊列填滿時,由調用線程處理該任務,以防止總體的消費能力跟不上poll拉取的速度。這種方式還可以進行橫向擴展,通過創建多個KafkaConsumerThread實例來進一步提升整體的消費能力。

這種方式還可以減少TCP連接的數量,但是對於消息的順序處理就變得困難了。這種方式需要引入一個共享變量Map<TopicPartition,OffsetAndMetadata> offsets參與消費者的偏移量提交。每一個RecordHandler類在處理完消息后都將對應的消費位移保存到共享變量offsets中,KafkaConsumerThread在每一次poll()方法之後都要進讀取offsets中的內容並對其進行提交。對於offsets的讀寫要採用加鎖處理,防止出現併發問題。並且在寫入offsets的時候需要注意位移覆蓋的問題。針對這個問題,可以將RecordHandler的run方法做如下改變:

  public void run() {
          for (TopicPartition tp : records.partitions()) {
              List<ConsumerRecord<String, String>> tpRecords = this.records.records(tp);
              //處理tpRecords
              long lastConsumedOffset = tpRecords.get(tpRecords.size() - 1).offset();
              synchronized (offsets) {
                  if (offsets.containsKey(tp)) {
                      offsets.put(tp, new OffsetAndMetadata(lastConsumedOffset + 1));
                  }else {
                      long positioin = offsets.get(tp).offset();
                      if(positioin < lastConsumedOffset + 1) {
                      offsets.put(tp, new OffsetAndMetadata(lastConsumedOffset + 1));
                      }
                  }
              }
          }
      }

對應的位移提交代碼也應該在KafkaConsumerThread的run方法中進行體現

  public void run() {
  try {
      while (true) {
          ConsumerRecords<String, String> records = kafkaConsumer.poll(Duration.ofMillis(100));
          if (!records.isEmpty()) {
              executorService.submit(new RecordHandler(records));
              synchronized (offsets) {
                  if (!offsets.isEmpty()) {
                      kafkaConsumer.commitSync(offsets);
                      offsets.clear();
                    }
              }
          }
      }
  } catch (Exception e) {
      e.printStackTrace();
    }finally {
        kafkaConsumer.close();
      }
    }
}

其實這種方式並不完美,可能造成數據丟失。可以通過更為複雜的滑動窗口的方式進行改進。

1.2.10 消費者重要參數

  • fetch.min.bytes

    kafkaConsumer一次拉拉取請求的最小數據量。適當增加,會提高吞吐量,但會造成額外延遲。

  • fetch.max.bytes

    kafkaConsumer一次拉拉取請求的最大數據量,如果kafka一條消息的大小超過這個值,仍然是可以拉取的。

  • fetch.max.wait.ms

    一次拉取的最長等待時間,配合fetch.min.bytes使用

  • max.partiton.fetch.bytes

    每個分區里返回consumer的最大數據量。

  • max.poll.records

    一次拉取的最大消息數

  • connection.max.idle.ms

    多久之後關閉限制的連接

  • exclude.internal.topics

    這個參數用於設置kafka中的兩個內部主題能否被公開:consumer_offsets和transaction_state。如果設為true,可以使用Pattren訂閱內部主題,如果是false,則沒有這種限制。

  • receive.buffer.bytes

    socket接收緩衝區的大小

  • send.buffer.bytes

    socket發送緩衝區的大小

  • request.timeout.ms

    consumer等待請求響應的最長時間。

  • reconnect.backoff.ms

    重試連接指定主機的等待時間。

  • max.poll.interval.ms

    配置消費者等待拉取時間的最大值,如果超過這個期限,消費者組將剔除該消費者,進行再平衡。

  • auto.offset.reset

    自動偏移量重置

  • enable.auto.commit

    是否允許偏移量的自動提交

  • auto.commit.interval.ms

    自動偏移量提交的時間間隔

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"