Android-Handler消息機制實現原理

一、消息機制流程簡介

在應用啟動的時候,會執行程序的入口函數main(),main()裏面會創建一個Looper對象,然後通過這個Looper對象開啟一個死循環,這個循環的工作是,不斷的從消息隊列MessageQueue裏面取出消息即Message對象,並處理。然後看下面兩個問題:
循環拿到一個消息之後,如何處理?
是通過在Looper的循環里調用Handler的dispatchMessage()方法去處理的,而dispatchMessage()方法裏面會調用handleMessage()方法,handleMessage()就是平時使用Handler時重寫的方法,所以最終如何處理消息由使用Handler的開發者決定。
MessageQueue里的消息從哪來?
使用Handler的開發者通過調用sendMessage()方法將消息加入到MessageQueue裏面。

上面就是Android中消息機制的一個整體流程,也是 “Android中Handler,Looper,MessageQueue,Message有什麼關係?” 的答案。通過上面的流程可以發現Handler在消息機制中的地位,是作為輔助類或者工具類存在的,用來供開發者使用。

對於這個流程有兩個疑問:

  • Looper中是如何能調用到Handler的方法的?
  • Handler是如何能往MessageQueue中插入消息的?

這兩個問題會在後面給出答案,下面先來通過源碼,分析一下這個過程的具體細節:

二、消息機制的源碼分析

首先main()方法位於ActivityThread.java類裏面,這是一個隱藏類,源碼位置:frameworks/base/core/java/android/app/ActivityThread.java

public static void main(String[] args) {
    ......
    Looper.prepareMainLooper();

    ActivityThread thread = new ActivityThread();
    thread.attach(false);

    if (sMainThreadHandler == null) {
        sMainThreadHandler = thread.getHandler();
    }

    Looper.loop();

    throw new RuntimeException("Main thread loop unexpectedly exited");
}

Looper的創建可以通過Looper.prepare()來完成,上面的代碼中prepareMainLooper()是給主線程創建Looper使用的,本質也是調用的prepare()方法。創建Looper以後就可以調用Looper.loop()開啟循環了。main方法很簡單,不多說了,下面看看Looper被創建的時候做了什麼,下面是Looper的prepare()方法和變量sThreadLocal:

static final ThreadLocal<Looper> sThreadLocal = new ThreadLocal<Looper>();

private static void prepare(boolean quitAllowed) {
    if (sThreadLocal.get() != null) {
        throw new RuntimeException("Only one Looper may be created per thread");
    }
    sThreadLocal.set(new Looper(quitAllowed));
}

很簡單,new了一個Looper,並把new出來的Looper保存到ThreadLocal裏面。ThreadLocal是什麼?它是一個用來存儲數據的類,類似HashMap、ArrayList等集合類。它的特點是可以在指定的線程中存儲數據,然後取數據只能取到當前線程的數據,比如下面的代碼:

ThreadLocal<Integer> mThreadLocal = new ThreadLocal<>();
private void testMethod() {

    mThreadLocal.set(0);
    Log.d(TAG, "main  mThreadLocal=" + mThreadLocal.get());

    new Thread("Thread1") {
        @Override
        public void run() {
            mThreadLocal.set(1);
            Log.d(TAG, "Thread1  mThreadLocal=" + mThreadLocal.get());
        }
    }.start();

    new Thread("Thread2") {
        @Override
        public void run() {
            mThreadLocal.set(2);
            Log.d(TAG, "Thread1  mThreadLocal=" + mThreadLocal.get());
        }
    }.start();

    Log.d(TAG, "main  mThreadLocal=" + mThreadLocal.get());
}

輸出的log是

main  mThreadLocal=0
Thread1  mThreadLocal=1
Thread2  mThreadLocal=2
main  mThreadLocal=0

通過上面的例子可以清晰的看到ThreadLocal存取數據的特點,只能取到當前所在線程存的數據,如果所在線程沒存數據,取出來的就是null。其實這個效果可以通過HashMap<Thread, Object>來實現,考慮線程安全的話使用ConcurrentMap<Thread, Object>,不過使用Map會有一些麻煩的事要處理,比如當一個線程結束的時候我們如何刪除這個線程的對象副本呢?如果使用ThreadLocal就不用有這個擔心了,ThreadLocal保證每個線程都保持對其線程局部變量副本的隱式引用,只要線程是活動的並且 ThreadLocal 實例是可訪問的;在線程消失之後,其線程局部實例的所有副本都會被垃圾回收(除非存在對這些副本的其他引用)。更多ThreadLocal的講解參考:Android線程管理之ThreadLocal理解及應用場景

好了回到正題,prepare()創建Looper的時候同時把創建的Looper存儲到了ThreadLocal中,通過對ThreadLocal的介紹,獲取Looper對象就很簡單了,sThreadLocal.get()即可,源碼提供了一個public的靜態方法可以在主線程的任何地方獲取這個主線程的Looper(注意一下方法名myLooper(),多個地方會用到):

public static @Nullable Looper myLooper() {
    return sThreadLocal.get();
}

Looper創建完了,接下來開啟循環,loop方法的關鍵代碼如下:

public static void loop() {
    final Looper me = myLooper();
    if (me == null) {
        throw new RuntimeException("No Looper; Looper.prepare() wasn't called on this thread.");
    }
    final MessageQueue queue = me.mQueue;

    for (;;) {
        Message msg = queue.next(); // might block
        if (msg == null) {
            // No message indicates that the message queue is quitting.
            return;
        }

        try {
            msg.target.dispatchMessage(msg);
        } finally {
            if (traceTag != 0) {
                Trace.traceEnd(traceTag);
            }
        }

        msg.recycleUnchecked();
    }
}

上面的代碼,首先獲取主線程的Looper對象,然後取得Looper中的消息隊列final MessageQueue queue = me.mQueue;,然後下面是一個死循環,不斷的從消息隊列里取消息Message msg = queue.next();,可以看到取出的消息是一個Message對象,如果消息隊列里沒有消息,就會阻塞在這行代碼,等到有消息來的時候會被喚醒。取到消息以後,通過msg.target.dispatchMessage(msg);來處理消息,msg.target 是一個Handler對象,所以這個時候就調用到我們重寫的Hander的handleMessage()方法了。
msg.target 是在什麼時候被賦值的呢?要找到這個答案很容易,msg.target是被封裝在消息裏面的,肯定要從發送消息那裡開始找,看看Message是如何封裝的。那麼就從Handler的sendMessage(msg)方法開始,過程如下:

public final boolean sendMessage(Message msg) {
    return sendMessageDelayed(msg, 0);
}

public final boolean sendMessageDelayed(Message msg, long delayMillis) {
    if (delayMillis < 0) {
        delayMillis = 0;
    }
    return sendMessageAtTime(msg, SystemClock.uptimeMillis() + delayMillis);
}

public boolean sendMessageAtTime(Message msg, long uptimeMillis) {
    MessageQueue queue = mQueue;
    if (queue == null) {
        RuntimeException e = new RuntimeException(
                this + " sendMessageAtTime() called with no mQueue");
        Log.w("Looper", e.getMessage(), e);
        return false;
    }
    return enqueueMessage(queue, msg, uptimeMillis);
}

private boolean enqueueMessage(MessageQueue queue, Message msg, long uptimeMillis) {
    msg.target = this;
    if (mAsynchronous) {
        msg.setAsynchronous(true);
    }
    return queue.enqueueMessage(msg, uptimeMillis);
}

可以看到最後的enqueueMessage()方法中msg.target = this;,這裏就把發送消息的handler封裝到了消息中。同時可以看到,發送消息其實就是往MessageQueue裏面插入了一條消息,然後Looper裏面的循環就可以處理消息了。Handler裏面的消息隊列是怎麼來的呢?從上面的代碼可以看到enqueueMessage()裏面的queue是從sendMessageAtTime傳來的,也就是mQueue。然後看mQueue是在哪初始化的,看Handler的構造方法如下:

public Handler(Callback callback, boolean async) {
    if (FIND_POTENTIAL_LEAKS) {
        final Class<? extends Handler> klass = getClass();
        if ((klass.isAnonymousClass() || klass.isMemberClass() || klass.isLocalClass()) &&
                (klass.getModifiers() & Modifier.STATIC) == 0) {
            Log.w(TAG, "The following Handler class should be static or leaks might occur: " +
                klass.getCanonicalName());
        }
    }

    mLooper = Looper.myLooper();
    if (mLooper == null) {
        throw new RuntimeException(
            "Can't create handler inside thread that has not called Looper.prepare()");
    }
    mQueue = mLooper.mQueue;
    mCallback = callback;
    mAsynchronous = async;
}

mQueue的初始化很簡單,首先取得Handler所在線程的Looper,然後取出Looper中的mQueue。這也是Handler為什麼必須在有Looper的線程中才能使用的原因,拿到mQueue就可以很容易的往Looper的消息隊列里插入消息了(配合Looper的循環+阻塞就實現了發送接收消息的效果)。

以上就是主線程中消息機制的原理。

那麼,在任何線程下使用handler的如下做法的原因、原理、內部流程等就非常清晰了:

new Thread() {
    @Override
    public void run() {
        Looper.prepare();
        Handler handler = new Handler();
        Looper.loop();
    }
}.start();
  1. 首先Looper.prepare()創建Looper並初始化Looper持有的消息隊列MessageQueue,創建好后將Looper保存到ThreadLocal中方便Handler直接獲取。
  2. 然後Looper.loop()開啟循環,從MessageQueue裏面取消息並調用handler的 dispatchMessage(msg) 方法處理消息。如果MessageQueue里沒有消息,循環就會阻塞進入休眠狀態,等有消息的時候被喚醒處理消息。
  3. 再然後我們new Handler()的時候,Handler構造方法中獲取Looper並且拿到Looper的MessageQueue對象。然後Handler內部就可以直接往MessageQueue裏面插入消息了,插入消息即發送消息,這時候有消息了就會喚醒Looper循環去處理消息。處理消息就是調用dispatchMessage(msg) 方法,最終調用到我們重寫的Handler的handleMessage()方法。

三、通過一些問題的研究加強對消息機制的理解

源碼分析完了,下面看一下文章開頭的兩個問題:

  • Looper中是如何能調用到Handler的方法的?
  • Handler是如何能往MessageQueue中插入消息的?

這兩個問題源碼分析中已經給出答案,這裏做一下總結,首先搞清楚以下對象在消息機制中的關係:

Looper,MessageQueue,Message,ThreadLocal,Handler
  1. Looper對象有一個成員MessageQueue,MessageQueue是一個消息隊列,用來存儲消息Message
  2. Message消息中帶有一個handler對象,所以Looper取出消息后,可以很方便的調用到Handler的方法(問題1解決)
  3. Message是如何帶有handler對象的?是handler在發送消息的時候把自己封裝到消息里的。
  4. Handler是如何發送消息的?是通過獲取Looper對象從而取得Looper裏面的MessageQueue,然後Handler就可以直接往MessageQueue裏面插入消息了。(問題2解決)
  5. Handler是如何獲取Looper對象的?Looper在創建的時候同時把自己保存到ThreadLocal中,並提供一個public的靜態方法可以從ThreadLocal中取出Looper,所以Handler的構造方法里可以直接調用靜態方法取得Looper對象。

帶着上面的一系列問題看源碼就很清晰了,下面是知乎上的一個問答:

Android中為什麼主線程不會因為Looper.loop()里的死循環卡死?

原因很簡單,循環里有阻塞,所以死循環並不會一直執行,相反的,大部分時間是沒有消息的,所以主線程大多數時候都是處於休眠狀態,也就不會消耗太多的CPU資源導致卡死。

  1. 阻塞的原理是使用Linux的管道機制實現的
  2. 主線程沒有消息處理時阻塞在管道的讀端
  3. binder線程會往主線程消息隊列里添加消息,然後往管道寫端寫一個字節,這樣就能喚醒主線程從管道讀端返回,也就是說looper循環里queue.next()會調用返回…

這裏說到binder線程,具體的實現細節不必深究,考慮下面的問題:
主線程的死循環如何處理其它事務?
首先需要看懂這個問題,主線程進入Looper死循環后,如何處理其他事務,比如activity的各個生命周期的回調函數是如何被執行到的(注意這裡是在同一個線程下,代碼是按順序執行的,如果在死循環這阻塞了,那麼進入死循環后循環以外的代碼是如何執行的)。
首先再看main函數的源碼

Looper.prepareMainLooper();

ActivityThread thread = new ActivityThread();
thread.attach(false);

if (sMainThreadHandler == null) {
    sMainThreadHandler = thread.getHandler();
}

Looper.loop();

在Looper.prepare和Looper.loop之間new了一個ActivityThread並調用了它的attach方法,這個方法就是開啟binder線程的,另外new ActivityThread()的時候同時會初始化它的一個H類型的成員,H是一個繼承了Handler的類。此時的結果就是:在主線程開啟loop死循環之前,已經啟動binder線程,並且準備好了一個名為H的Handler,那麼接下來在主線程死循環之外做一些事務處理就很簡單了,只需要通過binder線程向H發送消息即可,比如發送 H.LAUNCH_ACTIVITY 消息就是通知主線程調用Activity.onCreate() ,當然不是直接調用,H收到消息後會進行一系列複雜的函數調用最終調用到Activity.onCreate()。
至於誰來控制binder線程來向H發消息就不深入研究了,下面是《Android開發藝術探索》裏面的一段話:

ActivityThread 通過 ApplicationThread 和 AMS 進行進程間通訊,AMS 以進程間通信的方式完成 ActivityThread 的請求後會回調 ApplicationThread 中的 Binder 方法,然後 ApplicationThread 會向 H 發送消息,H 收到消息後會將 ApplicationThread 中的邏輯切換到 ActivityThread 中去執行,即切換到主線程中去執行,這個過程就是主線程的消息循環模型。

這個問題就到這裏,更多內容看知乎原文

最後

和其他系統相同,Android應用程序也是依靠消息驅動來工作的。網上的這句話還是很有道理的。

文章參考:

《Android開發藝術探索》
Android中為什麼主線程不會因為Looper.loop()里的死循環卡死?
Android線程管理之ThreadLocal理解及應用場景
Android 消息機制——你真的了解Handler
Android Handler到底是什麼

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

分享工作中一次優化程序的過程


程序應用場景:

年初從總公司交接了一個評分系統,系統大概情況是80w考生,每個考生105條作答數據,作答數據主要是客觀題(單選題,多選題,判斷題),評分時間大概40分鐘左右。

需求:優化代碼,提升評分效率,優化之後評分完成在20分鐘左右。

已有代碼優化邏輯:

1.程序方面:

多線程,通過計算評分的人數,得到需要的線程數量,開啟線程分別進行評分

2.查詢數據:

成績表建立自增長Id,查詢匹配需要評分的數據用where id> =Start and id< End

3.插入數據:

採用DataTable數據導入到Sql Server,提示評分完成時保存數據效率

詳細說一下第二點的邏輯

假設數據庫有100w條需要評分的數據,這時通過計算大概得到需要開啟25個線程去同時進行評分,也就是說第一個線程去評分數據庫Id在  1~40000考生的數據,也就是說去查詢數據時,大概查詢語句select * from A where Id>=1 and Id<40000這樣能夠保證查詢出來得效率是最高的;

但是這裡會有缺陷,如果數據存在刪除過在插入肯定數據就不是連續的,也就是

where Id>=1 and Id<40000不能保證查詢得到40000條數據,數據庫表中存在的Id不一定是從1開始,所以目前這種查詢方式是很理想化的。後續這裏還需要在這快研究和學習下。

本次優化細節

代碼片段1

優化前:


優化后:


總結:提取線程內查詢數據存儲到內存中,從而只會查詢一次。

代碼片段2

優化前:


優化后:


總結:修改List集合取一條數據的方式,Where修改成Find,如果還需要在這裏提升查詢效率可以修改成for循環,但會導致代碼可讀性會變差。

代碼片段3

優化前


優化后


總結:修改DataTable表Select查詢方式,先存儲到Dictionary中,在通過Key去取對應的數據。

最後通過測試全部完成評分時間大概20分鐘左右,也算成功的完成了這個任務,可能還需要在研究研究代碼,看能否有其他地方可以改善的。

存在的疑惑:

線程運算佔用的電腦Cpu的具體的值?

是否存在最佳線程數量?

電腦Cpu處理能力越強是否也能夠提升程序的評分效率?

總結:

1.線程里反覆查詢而且不變的基礎數據放到線程外查詢存儲到變量中

2.List集合的Where查詢修改成Find查詢,極高的提升查詢效率

3.DataTable的Select改用Dictionary<string,DataRow[]>,同樣極高的提升查詢效率

這次能夠站在前人的肩膀上完成這一次代碼的優化還有學習到了很多,瑾以寫在這片文章分享個人在平時工作中的解決的一些問題,希望這次能夠通過分享此篇文章讓自己更多的去記錄和分享工作中遇到以及解決的問題,提升自己的競爭力。

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

C#中多線程中變量研究

今天在知乎上看到一個問題【為什麼在同一進程中創建不同線程,但線程各自的變量無法在線程間互相訪問?】。在多線程中,每個線程都是獨立運行的,不同的線程有可能是同一段代碼,但不會是同一作用域,所以不會共享。而共享內存,並沒有作用域之分,同一進程內,不管什麼線程都可以通過同一虛擬內存地址來訪問,不同進程也可以通過ipc等方式共享內存數據。全局變量:任何線程都可以訪問;局部變量(棧變量):任何線程執行到該函數時均可訪問,函數外不可訪問;線程變量:每個線程只能訪問自己的那個拷貝,其他線程不可見。今天就用C#來實現同一段代碼的不同線程,全局變量、局部變量、線程變量。

了解進程與線程

什麼是多任務,簡單來說就是操作系統同時可以運行多個任務。例如:一遍聽歌,一遍寫文檔等。多核CPU可以執行多任務,但是單核CPU也可以執行多任務,CPU是順序執行的,操作系統讓任務輪流執行,例如:聽歌執行一次,停頓0.01s,寫文檔執行一次,停頓0.01s等等。由於CPU的執行速度很快,我們感覺就像所有的任務都是同時執行。對操作系統來說,一個任務就是一個進程,一個進程至少有一個線程。進程是資源分配的最小單位,線程是CPU調度的最小單位。

普通的程序寫法

private static List<int> data = Enumerable.Range(1, 1000).ToList();

public static void SimpleTest()
{
    for (int i = 0; i < 10; i++)
    {
        List<int> tempData = new List<int>();
        foreach (var d in data)
        {
            tempData.Add(d);
        }
        Console.WriteLine($"i:{i},合計:{data.Sum()},是否相等:{data.Sum() == tempData.Sum()}");
    }

    Console.WriteLine("單線程運行結束");
}

多線程寫法

private static List<int> data = Enumerable.Range(1, 1000).ToList();

public static async Task MoreTaskTestAsync()
{
    List<Task> tasks = new List<Task>();
    for (int i = 0; i < 10; i++)
    {
        var tempi = i;
        var t = Task.Run(() =>
        {
            List<int> tempData = new List<int>();
            foreach (var d in data)
            {
                tempData.Add(d);
            }
            Console.WriteLine($"i:{tempi},合計:{data.Sum()},是否相等:{data.Sum() == tempData.Sum()}");
        });
        tasks.Add(t);
    }

    await Task.WhenAll(tasks); //或者Task.WaitAll(tasks.ToArray());
    Console.WriteLine("多線程運行結束");
}

不同的線程同一段代碼,但不會是同一作用域,所以tempData數據沒有互相影響。

全局變量:data,多個線程都可以訪問,list只讀的時候是線性安全
局部變量:i就是局部變量,訪問的線程可以訪問,去掉【var tempi = i;】,運行結果打印出來,值都是一樣的,增加的都是每個線程都訪問單獨的tempi變量

i:10,合計:500500,是否相等:True

線程變量:tempData,每個線程只訪問自己的,互不影響,運行結果

i:3,合計:500500,是否相等:True
i:6,合計:500500,是否相等:True
i:0,合計:500500,是否相等:True
i:1,合計:500500,是否相等:True
i:4,合計:500500,是否相等:True
i:2,合計:500500,是否相等:True
i:7,合計:500500,是否相等:True
i:5,合計:500500,是否相等:True
i:8,合計:500500,是否相等:True
i:9,合計:500500,是否相等:True

寫多線程的時候需要注意,變量的作用域,否則程序運行出來的結果將不會是想要的結果,注意,注意變量作用域。

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

MySQL數據庫詳解(三)MySQL的事務隔離剖析

提到事務,你肯定不陌生,和數據庫打交道的時候,我們總是會用到事務。最經典的例子就是轉賬,你要給朋友小王轉 100 塊錢,而此時你的銀行卡只有 100 塊錢。

轉賬過程具體到程序里會有一系列的操作,比如查詢餘額、做加減法、更新餘額等,這些操作必須保證是一體的,不然等程序查完之後,還沒做減法之前,你這 100 塊錢,完全可以藉著這個時間差再查一次,然後再給另外一個朋友轉賬,如果銀行這麼整,不就亂了么?這時就要用到“事務”這個概念了。

簡單來說,事務就是要保證一組數據庫操作,要麼全部成功,要麼全部失敗。在 MySQL 中,事務支持是在引擎層實現的。你現在知道,MySQL 是一個支持多引擎的系統,但並不是所有的引擎都支持事務。比如 MySQL 原生的 MyISAM 引擎就不支持事務,這也是 MyISAM 被InnoDB 取代的重要原因之一。

今天的文章里,我將會以 InnoDB 為例,剖析 MySQL 在事務支持方面的特定實現,並基於原理給出相應的實踐建議,希望這些案例能加深你對 MySQL 事務原理的理解。

隔離性與隔離級別

提到事務,你肯定會想到 ACID(Atomicity、Consistency、Isolation、Durability,即原子性、一致性、隔離性、持久性),今天我們就來說說其中 I,也就是“隔離性”。

當數據庫上有多個事務同時執行的時候,就可能出現臟讀(dirty read)、不可重複讀(non reapeatable read)、幻讀(phantom read)的問題,為了解決這些問題,就有了“隔離級別”的概念。

在談隔離級別之前,你首先要知道,你隔離得越嚴實,效率就會越低。因此很多時候,我們都要在二者之間尋找一個平衡點。SQL 標準的事務隔離級別包括:讀未提交(read uncommitted)、讀提交(read committed)、可重複讀(repeatable read)和串行化serializable )。

下面我逐一為你解釋:

  • 讀未提交是指,一個事務還沒提交時,它做的變更就能被別的事務看到。
  • 讀提交是指,一個事務提交之後,它做的變更才會被其他事務看到。
  • 可重複讀是指,一個事務執行過程中看到的數據,總是跟這個事務在啟動時看到的數據是一致的。當然在可重複讀隔離級別下,未提交變更對其他事務也是不可見的。
  • 串行化,顧名思義是對於同一行記錄,“寫”會加“寫鎖”,“讀”會加“讀鎖”。當出現讀寫鎖衝突的時候,后訪問的事務必須等前一個事務執行完成,才能繼續執行。
  • 其中“讀提交”和“可重複讀”比較難理解,所以我用一個例子說明這幾種隔離級別。假設數據表 T 中只有一列,其中一行的值為 1,下面是按照時間順序執行兩個事務的行為。
mysql> create table T(c int) engine=InnoDB;
insert into T(c) values(1);

我們來看看在不同的隔離級別下,事務 A 會有哪些不同的返回結果,也就是圖裡面 V1、V2、V3 的返回值分別是什麼。

若隔離級別是“讀未提交”, 則 V1 的值就是 2。這時候事務 B 雖然還沒有提交,但是結果已經被 A 看到了。因此,V2、V3 也都是 2。

若隔離級別是“讀提交”,則 V1 是 1,V2 的值是 2。事務 B 的更新在提交后才能被 A 看到。所以, V3 的值也是 2。

若隔離級別是“可重複讀”,則 V1、V2 是 1,V3 是 2。之所以 V2 還是 1,遵循的就是這個要求:事務在執行期間看到的數據前後必須是一致的。

若隔離級別是“串行化”,則在事務 B 執行“將 1 改成 2”的時候,會被鎖住。直到事務 A提交后,事務 B 才可以繼續執行。所以從 A 的角度看, V1、V2 值是 1,V3 的值是 2。

在實現上,數據庫裏面會創建一個視圖,訪問的時候以視圖的邏輯結果為準。在“可重複讀”隔離級別下,這個視圖是在事務啟動時創建的,整個事務存在期間都用這個視圖。在“讀提交”隔離級別下,這個視圖是在每個 SQL 語句開始執行的時候創建的。這裏需要注意的是,“讀未提交”隔離級別下直接返回記錄上的最新值,沒有視圖概念;而“串行化”隔離級別下直接用加鎖的方式來避免并行訪問。

我們可以看到在不同的隔離級別下,數據庫行為是有所不同的。Oracle 數據庫的默認隔離級別其實就是“讀提交”,因此對於一些從 Oracle 遷移到 MySQL 的應用,為保證數據庫隔離級別的一致,你一定要記得將 MySQL 的隔離級別設置為“讀提交”。

配置的方式是,將啟動參數 transaction-isolation 的值設置成 READ-COMMITTED。你可以用show variables 來查看當前的值。

mysql> show variables like 'transaction_isolation';
+-----------------------+----------------+
| Variable_name | Value |
+-----------------------+----------------+
| transaction_isolation | READ-COMMITTED |
+-----------------------+----------------+

總結來說,存在即合理,哪個隔離級別都有它自己的使用場景,你要根據自己的業務情況來定。我想你可能會問那什麼時候需要“可重複讀”的場景呢?我們來看一個數據校對邏輯的案例。

假設你在管理一個個人銀行賬戶表。一個表存了每個月月底的餘額,一個表存了賬單明細。這時候你要做數據校對,也就是判斷上個月的餘額和當前餘額的差額,是否與本月的賬單明細一致。

你一定希望在校對過程中,即使有用戶發生了一筆新的交易,也不影響你的校對結果。這時候使用“可重複讀”隔離級別就很方便。事務啟動時的視圖可以認為是靜態的,不受其他事務更新的影響。

事務隔離的實現

理解了事務的隔離級別,我們再來看看事務隔離具體是怎麼實現的。這裏我們展開說明“可重複讀”。

在 MySQL 中,實際上每條記錄在更新的時候都會同時記錄一條回滾操作。記錄上的最新值,通過回滾操作,都可以得到前一個狀態的值。

假設一個值從 1 被按順序改成了 2、3、4,在回滾日誌裏面就會有類似下面的記錄。

當前值是 4,但是在查詢這條記錄的時候,不同時刻啟動的事務會有不同的 read-view。如圖中看到的,在視圖 A、B、C 裏面,這一個記錄的值分別是 1、2、4,同一條記錄在系統中可以存在多個版本,就是數據庫的多版本併發控制(MVCC)。對於 read-view A,要得到 1,就必須將當前值依次執行圖中所有的回滾操作得到。

同時你會發現,即使現在有另外一個事務正在將 4 改成 5,這個事務跟 read-view A、B、C 對應的事務是不會衝突的。

你一定會問,回滾日誌總不能一直保留吧,什麼時候刪除呢?答案是,在不需要的時候才刪除。也就是說,系統會判斷,當沒有事務再需要用到這些回滾日誌時,回滾日誌會被刪除。

什麼時候才不需要了呢?就是當系統里沒有比這個回滾日誌更早的 read-view 的時候。基於上面的說明,我們來討論一下為什麼建議你盡量不要使用長事務。

長事務意味着系統裏面會存在很老的事務視圖。由於這些事務隨時可能訪問數據庫裏面的任何數據,所以這個事務提交之前,數據庫裏面它可能用到的回滾記錄都必須保留,這就會導致大量佔用存儲空間。

在 MySQL 5.5 及以前的版本,回滾日誌是跟數據字典一起放在 ibdata 文件里的,即使長事務最終提交,回滾段被清理,文件也不會變小。我見過數據只有 20GB,而回滾段有 200GB 的庫。最終只好為了清理回滾段,重建整個庫。

除了對回滾段的影響,長事務還佔用鎖資源,也可能拖垮整個庫,這個我們會在後面講鎖的時候展開。

事務的啟動方式

如前面所述,長事務有這些潛在風險,我當然是建議你盡量避免。其實很多時候業務開發同學並不是有意使用長事務,通常是由於誤用所致。MySQL 的事務啟動方式有以下幾種:

  1. 顯式啟動事務語句, begin 或 start transaction。配套的提交語句是 commit,回滾語句
    是 rollback。
  2. set autocommit=0,這個命令會將這個線程的自動提交關掉。意味着如果你只執行一個select 語句,這個事務就啟動了,而且並不會自動提交。這個事務持續存在直到你主動執行commit 或 rollback 語句,或者斷開連接。

有些客戶端連接框架會默認連接成功后先執行一個 set autocommit=0 的命令。這就導致接下來的查詢都在事務中,如果是長連接,就導致了意外的長事務。

因此,我會建議你總是使用 set autocommit=1, 通過顯式語句的方式來啟動事務。

但是有的開發同學會糾結“多一次交互”的問題。對於一個需要頻繁使用事務的業務,第二種方式每個事務在開始時都不需要主動執行一次 “begin”,減少了語句的交互次數。如果你也有這個顧慮,我建議你使用 commit work and chain 語法。

在 autocommit 為 1 的情況下,用 begin 顯式啟動的事務,如果執行 commit 則提交事務。如果執行 commit work and chain,則是提交事務並自動啟動下一個事務,這樣也省去了再次執行 begin 語句的開銷。同時帶來的好處是從程序開發的角度明確地知道每個語句是否處於事務中。

你可以在 information_schema 庫的 innodb_trx 這個表中查詢長事務,比如下面這個語句,用於查找持續時間超過 60s 的事務。

select * from information_schema.innodb_trx where TIME_TO_SEC(timediff(now(),trx_started))>60

小結

這篇文章裏面,我介紹了 MySQL 的事務隔離級別的現象和實現,根據實現原理分析了長事務存在的風險,以及如何用正確的方式避免長事務。希望我舉的例子能夠幫助你理解事務,並更好地使用 MySQL 的事務特性。

我給你留一個問題吧。你現在知道了系統裏面應該避免長事務,如果你是業務開發負責人同時也是數據庫負責人,你會有什麼方案來避免出現或者處理這種情況呢?

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

監測元素resize

前言

近來有需求要做分頁,聽起來可能有點Low。 所以我要把Low的事情做得有點逼格。
分頁本身沒啥,但是數據量起來了,比如十萬。 要是不做點處理, 那你的頁面估計爽得很,機器也爽得很。 放心,我不會讓你這麼爽。

大量數據展現方案

比較流行的當然是虛擬滾動(無限滾動)。

  1. 始終展示的是有限的固定節點。
  2. 外層創建滾動層。

一句話,就是反覆利用固定節點展現數據。

其中還有兩個點

何時需要加載新的分頁數據

  1. scrollTop , clientHeight, scrollHeight
  2. IntersectionObserver (chrome 55+)

如何知道容器寬高變化
本文就圍繞着這個展開

因為使用的是react框架,使用了 react-window, react-window就是用來展現海量數據的react列表組件。
因為項目需要,還要不通尺寸一行展現不同數量的數據。 肯定有人就說,監聽window.resize。

沒錯,監聽resize一定程度,但是window.resize, 並不能讓我知道容器本身的尺寸,當

然可以通過getComputedStyle獲取。 要是window沒有resize的情況呢。

我就想實時的知道尺寸的變化。

尺寸變化監測方案

監測元素resize這裡有幾種方案的測試和源碼。

Cross-Browser, Event-based, Element Resize Detection

思路:

如果IE,直接註冊onresize(這個點贊啊)

否則: 創建 type為text/html的object

設置position為absolute, 高度100%, 寬度100% (這樣可以獲得父容器的寬高)

設置pointer-events:none,利用點擊穿透(讓object窗體變成幽靈)

object元素的高度變化后,通知訂閱者

resize事件節流

問題:

  1. 創建object
  2. 事件處理函數掛載了元素本身上

javascript-detect-element-resize

創建三個子元素,利用scroll事件來監測變化。

原理:

https://zhuanlan.zhihu.com/p/24887312
The scroll event is fired when the document view or an element has been scrolled.
當文檔視圖或者元素滾動的時候會觸發 scroll 事件。
也就是說元素滾動的時候會觸發這個事件,那麼什麼時候元素會滾動?當元素大於其父級元素,且父級元素允許其滾動的時候,該元素可以進行滾動。
換句話說,元素可以滾動意味着父子元素大小不一致,這是這個方法的核心。
那麼我們需要讓元素大小發生改變時,使得 scrollLeft 或者 scrollTop 發生改變,從而觸發 scroll 事件,進一步得知其大小發生了改變。

visibility: hidden; opacity: 0; position: absolute;讓自己變得虛無

addEventListener(“scroll”, scrollListener, true) 在捕捉階段攔截事件,使用false無效

div.expand-trigger 變大

div.expand-trigger 變小

animationstart來監聽显示,比如style.display = ‘none’然後style.display = ‘block’

問題:

  1. 額外創建四個元素節點以及一個style節點
  2. 事件都掛載了元素本身身上,

ResizeObserver

原生自帶的方案, 兼容性並不高, resize-observer-polyfill 基於resize和MutationOberver的polyfill實現了ResizeObserver。

 const resizeObserver = new ResizeObserver(entries => {
        for (let entry of entries) {
            
            console.log(entry.target.id, `height:${entry.contentRect.height}  width:${entry.contentRect.width}`);
        }
        });
        resizeObserver.observe(document.querySelector('#my_element'));
        resizeObserver.observe(document.querySelector('#my_element2'));

此外

當然,我覺得還

  1. 定時器 + getComputedStyle 也是很低成本的實現。
  2. resize + MutationOberver 也是很簡單的方案。

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

.NET Core 微服務之Polly重試策略

接着上一篇說,正好也是最近項目里用到了,正好拿過來整理一下,園子里也有一些文章介紹比我詳細。

簡單介紹一下紹輕量的故障處理庫 Polly  Polly是一個.NET彈性和瞬態故障處理庫

允許我們以非常順暢和線程安全的方式來執行諸如重試、斷路器、超時、隔離、緩存、後退等策略, 能為我們在微服務架構提供更穩定的服務。當然,目前的 Service Mesh 顯得更高大上,而且更強大,它更偏向從運維層面解決以上問題,不過這還是的看具體項目中怎麼去使用和決定了。


在微服務架構下,我們可能會遇到類似以下問題:

  1. 某些接口異常,最終造成應用程序池奔潰;
  2. 某些接口不穩定、偶爾超時,數據獲取異常;
  3. 某些服務不穩定,調用方連接不上;
  4. 某些服務異常,最終主服務掛掉(雪崩效應);


 當然在實際情況下,我們可能只需要確保提供給用戶的服務是可用狀態,不出現 “Service Unavailable” 這樣的畫面就好。至於接口偶爾異常,可能對某些類型的項目來說並不太關鍵,用戶可能通過重新請求、刷新頁面就可以解決,當然我們還可以在代碼層面做兼容,滿滿的try/catch、for/while 循環解決重試來保證更高的可靠性。

 這個時候Polly就能很好的起來作用,Polly 的使用相對比較簡單,當然還是得看項目結構。我們的主項目在調用微服務接口時使用了AOP,類似這種情況下,所以調用微服務的接口都是統一入口,所以我們只需要在AOP內加上 Polly 的一些策略,其他代碼不用做任何修改,就可以解決一些問題了。

安裝

Install-Package Polly

使用步驟說明

  1. 定義策略
  2. 執行方法

可以看一下代碼,我們項目主要使用的是Grpc這個框架,其他的微服務框架,使用起來大致差不多
public void Intercept(IInvocation invocation)
{
    // some code 
    try
    {
        // 創建一個策略,如果 invocation.Proceed 的執行出現 Grpc.Core.RpcException 異常,並且 StatusCode == Grpc.Core.StatusCode.Unavailable,則重試一次
        var policy = Policy
        .Handle<Grpc.Core.RpcException>(t => t.Status.StatusCode == Grpc.Core.StatusCode.Unavailable)
        .Retry(); // 默認一次

        // 將策略應用到 invocation.Proceed 方法上
        policy.Execute(invocation.Proceed);
    }
    catch (Exception ex)
    {
        // some code 
        Console.WriteLine($"{ ex.Message},{ex.StackTrace}");
    }
}


策略條件定義

策略的執行需要依賴於條件,Polly 支持對異常與結果進行策略條件定義。

異常

// 指定某個異常
Policy
  .Handle<SomeExceptionType>();

// 指定某個異常條件
Policy
  .Handle<SomeExceptionType>(ex => ex.xxx == "xxx")

// 指定多個異常
Policy
  .Handle<SomeExceptionType1>()
  .Or<SomeExceptionType2>()

// 指定多個可能異常條件
Policy
  .Handle<SomeExceptionType1>(ex => ex.xxx1 == "xxx")
  .Or<SomeExceptionType2>(ex => ex.xxx2 == "xxx")

返回結果

// 指定某個結果
Policy
  .HandleResult<ResponseMessage>(r => r.xxx == "xxx")

// 指定多個可能的結果
Policy
  .HandleResult<ResponseMessage>(r => r.xxx1 == "xxx")
  .OrResult<ResponseMessage>(r => r.xxx2 == "xxx")

重試策略(Retry )

// 指定異常下重試一次
Policy
  .Handle<SomeExceptionType>()
  .Retry();

// 指定異常下重試3次
Policy
  .Handle<SomeExceptionType>()
  .Retry(3);

// 指定異常下無限重試
Policy
  .Handle<SomeExceptionType>()
  .RetryForever();

// 每次重試之間等待指定的時間間隔
Policy
  .Handle<SomeExceptionType>()
  .WaitAndRetry(new[]
  {
    TimeSpan.FromSeconds(1),
    TimeSpan.FromSeconds(3),
    TimeSpan.FromSeconds(7)
  });

Retry 可以指定一個要執行的 Action。Action 參數:exception 當前異常信息,retryCount 當前執行第幾次,context 當前執行上下文信息。

測試一下:

private static int times = 0;

public static void TestPolicy()
{
    var policy = Policy
        .Handle<Exception>()
        .Retry(3, (exception, retryCount, context) => // 出異常會執行以下代碼
        {
            Console.WriteLine($"exception:{ exception.Message}, retryCount:{retryCount}, id:{context["id"]}, name:{context["name"]}");
        });

    try
    {
        // 通過 new Context 傳遞上下文信息
        var result = policy.Execute(Test, new Context("data", new Dictionary<string, object>() { { "id", "1" }, { "name", "beck" } }));
        Console.WriteLine($"result:{result}");
    }
    catch (Exception ex)
    {
        Console.WriteLine(ex.Message);
    }
}

private static string Test()
{
    // 每執行一次加1
    times++;

    // 前2次都拋異常
    if (times < 3)
    {
        throw new Exception("exception message");
    }
    return "success";
}

測試結果:


可以看到得到了咱們想要的效果,具體項目可以具體去實施,下一篇咱們接着說Polly的熔斷策略。感興趣可以自行搜索Polly的相關文檔看看。

參考鏈接

  • Polly
  • Polly Project
  • PollySamples


沒有彩蛋


【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

java8 函數式接口——Function/Predict/Supplier/Consumer

Function

我們知道Java8的最大特性就是函數式接口。所有標註了@FunctionalInterface註解的接口都是函數式接口,具體來說,所有標註了該註解的接口都將能用在lambda表達式上。

接口介紹

/**
 * Represents a function that accepts one argument and produces a result.
 *
 * <p>This is a <a href="package-summary.html">functional interface</a>
 * whose functional method is {@link #apply(Object)}.
 *
 * @param <T> the type of the input to the function
 * @param <R> the type of the result of the function
 *
 * @since 1.8
 */

上述描述可知: Function中傳遞的兩個泛型:T,R分別代表 輸入參數類型和返回參數類型。下面將逐個介紹Function中的各個接口:

接口1: 執行具體內容接口
R apply(T t);

實例1:apply使用
    // 匿名類的方式實現
    Function<Integer, Integer> version1 = new Function<Integer, Integer>() {
        @Override
        public Integer apply(Integer integer) {
            return integer++;
        }
    };
    int result1 = version1.apply(20);


    // lamda表達式
    Function<Integer, Integer> version2 = integer -> integer++;
    int result2 = version1.apply(20);
    

接口2: compose
該方法是一個默認方法,這個方法接收一個function作為參數,將參數function執行的結果作為參數給調用的function,以此來實現兩個function組合的功能。

// compose 方法源碼
default <V> Function<V, R> compose(Function<? super V, ? extends T> before) {
        Objects.requireNonNull(before);
        return (V v) -> apply(before.apply(v));
    }
實例2:compose使用
public int compute(int a, Function<Integer, Integer> function1, Function<Integer, Integer> function2) {
    return function1.compose(function2).apply(a);
}

// 調用上述方法
test.compute(2, value -> value * 3, value -> value * value) 
// 執行結果: 12 (有源碼可以看出先執行before)

接口3 : andThen
了解了compose方法,我們再來看andThen方法就好理解了,聽名字就是“接下來”,andThen方法也是接收一個function作為參數,與compse不同的是,先執行本身的apply方法,將執行的結果作為參數給參數中的function。

public interface Function<T, R> {
    default <V> Function<T, V> andThen(Function<? super R, ? extends V> after) {
        Objects.requireNonNull(after);
        return (T t) -> after.apply(apply(t));
    }
}
實例3:andThen使用
public int compute2(int a, Function<Integer, Integer> function1, Function<Integer, Integer> function2) {
    return function1.andThen(function2).apply(a);
}

// 調用上述方法
test.compute2(2, value -> value * 3, value -> value * value) 
// 執行結果 : 36

反思: 多個參數

Function接口雖然很簡潔,但是由Function源碼可以看出,他只能傳一個參數,實際使用中肯定不能滿足需求。下面提供幾種思路:

  1. BiFunction可以傳遞兩個參數(Java8中還提供了其它相似Function)
  2. 通過封裝類來解決
  3. void函數還是無法解決

因為參數原因“自帶的Function”函數必然不能滿足業務上複雜多變的需求,那麼就自定義Function接口吧

@FunctionalInterface
    static interface ThiConsumer<T,U,W>{
        void accept(T t, U u, W w);

        default ThiConsumer<T,U,W> andThen(ThiConsumer<? super T,? super U,? super W> consumer){
            return (t, u, w)->{
                accept(t, u, w);
                consumer.accept(t, u, w);
            };
        }
    }

自此,Function接口介紹完畢。

斷言性接口:Predicate

接口介紹:

/**
 * Represents a predicate (boolean-valued function) of one argument.
 *
 * <p>This is a <a href="package-summary.html">functional interface</a>
 * whose functional method is {@link #test(Object)}.
 *
 * @param <T> the type of the input to the predicate
 *
 * @since 1.8
 */
@FunctionalInterface
public interface Predicate<T> {

Predicate是個斷言式接口其參數是<T,boolean>,也就是給一個參數T,返回boolean類型的結果。跟Function一樣,Predicate的具體實現也是根據傳入的lambda表達式來決定的。

源碼不再具體分析,主要有 test/and/or/negate方法,以及一個靜態方法isEqual,具體使用實例如下:

    private static void testPredict() {
        int[] numbers = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15};
        List<Integer> list = new ArrayList<>();
        for (int i : numbers) {
            list.add(i);
        }
        
        // 三個判斷
        Predicate<Integer> p1 = i -> i > 5;
        Predicate<Integer> p2 = i -> i < 20;
        Predicate<Integer> p3 = i -> i % 2 == 0;
        List test = list.stream()
                .filter(p1
                        .and(p2)
//                        .and(Predicate.isEqual(8))
                        .and(p3))
                .collect(Collectors.toList());
        System.out.println(test.toString());
        //print:[6, 8, 10, 12, 14]
    }

供給性接口:Supplier

接口介紹

/**
 * Represents a supplier of results.
 *
 * <p>There is no requirement that a new or distinct result be returned each
 * time the supplier is invoked.
 *
 * <p>This is a <a href="package-summary.html">functional interface</a>
 * whose functional method is {@link #get()}.
 *
 * @param <T> the type of results supplied by this supplier
 *
 * @since 1.8
 */
@FunctionalInterface
public interface Supplier<T> 

使用實例:

        Supplier supplier = "Hello"::toLowerCase;
        System.out.println(supplier);

消費性:Consumer

接口介紹

/**
 * Represents an operation that accepts a single input argument and returns no
 * result. Unlike most other functional interfaces, {@code Consumer} is expected
 * to operate via side-effects.
 *
 * <p>This is a <a href="package-summary.html">functional interface</a>
 * whose functional method is {@link #accept(Object)}.
 *
 * @param <T> the type of the input to the operation
 *
 * @since 1.8
 */
@FunctionalInterface
public interface Consumer<T> {

實際使用

    NameInfo info = new NameInfo("abc", 123);
    Consumer<NameInfo> consumer = t -> {
        String infoString = t.name + t.age;
        System.out.println("consumer process:" + infoString);
    };
    consumer.accept(info);

總結:
本文主要介紹Java8的接口式編程,以及jdk中提供的四種函數接口(FunctionalInterface)。Predict/Supplier/Consumer其實是Function的一種變形,所以沒有詳細介紹。
疑問: FunctionalInterface註解是如何和lamada表達式聯繫在一起,函數接口在編譯時又是如何處理的?後面再了解下

【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

百萬級日活 App 的屏幕錄製功能是如何實現的

Android 從 4.0 開始就提供了手機錄屏方法,但是需要 root 權限,比較麻煩不容易實現。但是從 5.0 開始,系統提供給了 App 錄製屏幕的一系列方法,不需要 root 權限,只需要用戶授權即可錄屏,相對來說較為簡單。

基本上根據 官方文檔 便可以寫出錄屏的相關代碼。

屏幕錄製的基本實現步驟

在 Manifest 中申明權限
<uses-permission android:name="android.permission.RECORD_AUDIO" />
<uses-permission android:name="android.permission.WRITE_EXTERNAL_STORAGE"/>
<uses-permission android:name="android.permission.READ_EXTERNAL_STORAGE"/>
獲取 MediaProjectionManager 並申請權限
private val mediaProjectionManager by lazy { activity.getSystemService(Context.MEDIA_PROJECTION_SERVICE) as? MediaProjectionManager }
private var mediaProjection: MediaProjection? = null
if (mediaProjectionManager == null) {
    Log.d(TAG, "mediaProjectionManager == null,當前手機暫不支持錄屏")
    showToast(R.string.phone_not_support_screen_record)
    return
}
// 申請相關權限
PermissionUtils.permission(PermissionConstants.STORAGE, PermissionConstants.MICROPHONE)
        .callback(object : PermissionUtils.SimpleCallback {
            override fun onGranted() {
                Log.d(TAG, "start record")
                mediaProjectionManager?.apply {
                    // 申請相關權限成功后,要向用戶申請錄屏對話框
                    val intent = this.createScreenCaptureIntent()
                    if (activity.packageManager.resolveActivity(intent, PackageManager.MATCH_DEFAULT_ONLY) != null) {
                        activity.startActivityForResult(intent, REQUEST_CODE)
                    } else {
                        showToast(R.string.phone_not_support_screen_record)
                    }
                }
            }
            override fun onDenied() {
                showToast(R.string.permission_denied)
            }
        })
        .request()
重寫 onActivityResult() 對用戶授權進行處理
override fun onActivityResult(requestCode: Int, resultCode: Int, data: Intent) {
    if (requestCode == REQUEST_CODE) {
        if (resultCode == Activity.RESULT_OK) {
            mediaProjection = mediaProjectionManager!!.getMediaProjection(resultCode, data)
            // 實測,部分手機上錄製視頻的時候會有彈窗的出現,所以我們需要做一個 150ms 的延遲
            Handler().postDelayed({
                if (initRecorder()) {
                    mediaRecorder?.start()
                } else {
                    showToast(R.string.phone_not_support_screen_record)
                }
            }, 150)
        } else {
            showToast(R.string.phone_not_support_screen_record)
        }
    }
}

private fun initRecorder(): Boolean {
    Log.d(TAG, "initRecorder")
    var result = true
    // 創建文件夾
    val f = File(savePath)
    if (!f.exists()) {
        f.mkdirs()
    }
    // 錄屏保存的文件
    saveFile = File(savePath, "$saveName.tmp")
    saveFile?.apply {
        if (exists()) {
            delete()
        }
    }
    mediaRecorder = MediaRecorder()
    val width = Math.min(displayMetrics.widthPixels, 1080)
    val height = Math.min(displayMetrics.heightPixels, 1920)
    mediaRecorder?.apply {
        // 可以設置是否錄製音頻
        if (recordAudio) {
            setAudioSource(MediaRecorder.AudioSource.MIC)
        }
        setVideoSource(MediaRecorder.VideoSource.SURFACE)
        setOutputFormat(MediaRecorder.OutputFormat.MPEG_4)
        setVideoEncoder(MediaRecorder.VideoEncoder.H264)
        if (recordAudio){
            setAudioEncoder(MediaRecorder.AudioEncoder.AMR_NB)
        }
        setOutputFile(saveFile!!.absolutePath)
        setVideoSize(width, height)
        setVideoEncodingBitRate(8388608)
        setVideoFrameRate(VIDEO_FRAME_RATE)
        try {
            prepare()
            virtualDisplay = mediaProjection?.createVirtualDisplay("MainScreen", width, height, displayMetrics.densityDpi,
                    DisplayManager.VIRTUAL_DISPLAY_FLAG_AUTO_MIRROR, surface, null, null)
            Log.d(TAG, "initRecorder 成功")
        } catch (e: Exception) {
            Log.e(TAG, "IllegalStateException preparing MediaRecorder: ${e.message}")
            e.printStackTrace()
            result = false
        }
    }
    return result
}   

上面可以看到,我們可以設置一系列參數,各種參數的意思就希望大家自己去觀摩官方文檔了。其中有一個比較重要的一點是我們通過 MediaProjectionManager 創建了一個 VirtualDisplay,這個 VirtualDisplay 可以理解為虛擬的呈現器,它可以捕獲屏幕上的內容,並將其捕獲的內容渲染到 Surface 上,MediaRecorder 再進一步把其封裝為 mp4 文件保存。

錄製完畢,調用 stop 方法保存數據

private fun stop() {
    if (isRecording) {
        isRecording = false
        try {
            mediaRecorder?.apply {
                setOnErrorListener(null)
                setOnInfoListener(null)
                setPreviewDisplay(null)
                stop()
                Log.d(TAG, "stop success")
            }
        } catch (e: Exception) {
            Log.e(TAG, "stopRecorder() error!${e.message}")
        } finally {
            mediaRecorder?.reset()
            virtualDisplay?.release()
            mediaProjection?.stop()
            listener?.onEndRecord()
        }
    }
}

/**
 * if you has parameters, the recordAudio will be invalid
 */
fun stopRecord(videoDuration: Long = 0, audioDuration: Long = 0, afdd: AssetFileDescriptor? = null) {
    stop()
    if (audioDuration != 0L && afdd != null) {
        syntheticAudio(videoDuration, audioDuration, afdd)
    } else {
        // saveFile
        if (saveFile != null) {
            val newFile = File(savePath, "$saveName.mp4")
            // 錄製結束后修改後綴為 mp4
            saveFile!!.renameTo(newFile)
            // 刷新到相冊
            val intent = Intent(Intent.ACTION_MEDIA_SCANNER_SCAN_FILE)
            intent.data = Uri.fromFile(newFile)
            activity.sendBroadcast(intent)
            showToast(R.string.save_to_album_success)
        }
        saveFile = null
    }

}

我們必須來看看 MediaRecorder 對 stop() 方法的註釋。

/**
 * Stops recording. Call this after start(). Once recording is stopped,
 * you will have to configure it again as if it has just been constructed.
 * Note that a RuntimeException is intentionally thrown to the
 * application, if no valid audio/video data has been received when stop()
 * is called. This happens if stop() is called immediately after
 * start(). The failure lets the application take action accordingly to
 * clean up the output file (delete the output file, for instance), since
 * the output file is not properly constructed when this happens.
 *
 * @throws IllegalStateException if it is called before start()
 */
public native void stop() throws IllegalStateException; 

根據官方文檔,stop() 如果在 prepare() 后立即調用會崩潰,但對其他情況下發生的錯誤卻沒有做過多提及,實際上,當你真正地使用 MediaRecorder 做屏幕錄製的時候,你會發現即使你沒有在 prepare() 后立即調用 stop(),也可能拋出 IllegalStateException 異常。所以,保險起見,我們最好是直接使用 try...catch... 語句塊進行包裹。

比如你 initRecorder 中某些參數設置有問題,也會出現 stop() 出錯,數據寫不進你的文件。

完畢后,釋放資源
fun clearAll() {
    mediaRecorder?.release()
    mediaRecorder = null
    virtualDisplay?.release()
    virtualDisplay = null
    mediaProjection?.stop()
    mediaProjection = null
}

無法繞過的環境聲音

上面基本對 Android 屏幕錄製做了簡單的代碼編寫,當然實際上,我們需要做的地方還不止上面這些,感興趣的可以移步到 ScreenRecordHelper 進行查看。

但這根本不是我們的重點,我們極其容易遇到這樣的情況,需要我們錄製音頻的時候錄製系統音量,但卻不允許我們把環境音量錄進去。

似乎我們前面初始化 MediaRecorder 的時候有個設置音頻源的地方,我們來看看這個 MediaRecorder.setAudioSource() 方法都支持設置哪些東西。

從官方文檔 可知,我們可以設置以下這些音頻源。由於官方註釋太多,這裏就簡單解釋一些我們支持的可以設置的音頻源。

//設定錄音來源於同方向的相機麥克風相同,若相機無內置相機或無法識別,則使用預設的麥克風
MediaRecorder.AudioSource.CAMCORDER 
//默認音頻源
MediaRecorder.AudioSource.DEFAULT  
//設定錄音來源為主麥克風
MediaRecorder.AudioSource.MIC
//設定錄音來源為語音撥出的語音與對方說話的聲音
MediaRecorder.AudioSource.VOICE_CALL
// 攝像頭旁邊的麥克風
MediaRecorder.AudioSource.VOICE_COMMUNICATION
//下行聲音
MediaRecorder.AudioSource.VOICE_DOWNLINK
//語音識別
MediaRecorder.AudioSource.VOICE_RECOGNITION
//上行聲音
MediaRecorder.AudioSource.VOICE_UPLINK

咋一看沒有我們想要的選項,實際上你逐個進行測試,你也會發現,確實如此。我們想要媒體播放的音樂,總是無法擺脫環境聲音的限制。

奇怪的是,我們使用華為部分手機的系統錄屏的時候,卻可以做到,這就感嘆於 ROM 的定製性更改的神奇,當然,千奇百怪的第三方 ROM 也一直讓我們 Android 適配困難重重。

曲線救國剝離環境聲音

既然我們通過調用系統的 API 始終無法實現我們的需求:錄製屏幕,並同時播放背景音樂,錄製好保存的視頻需要只有背景音樂而沒有環境音量,我們只好另闢蹊徑。

不難想到,我們完全可以在錄製視頻的時候不設置音頻源,這樣得到的視頻就是一個沒有任何聲音的視頻,如果此時我們再把音樂強行剪輯進去,這樣就可以完美解決用戶的需要了。

對於音視頻的混合編輯,想必大多數人都能想到的是大名鼎鼎的 FFmpeg ,但如果要自己去編譯優化得到一個穩定可使用的 FFmpge 庫的話,需要花上不少時間。更重要的是,我們為一個如此簡單的功能大大的增大我們 APK 的體積,那是萬萬不可的。所以我們需要把目光轉移到官方的 MediaExtractor 上。

從 官方文檔 來看,能夠支持到 m4a 和 aac 格式的音頻文件合成到視頻文件中,根據相關文檔我們就不難寫出這樣的代碼。

/**
 * https://stackoverflow.com/questions/31572067/android-how-to-mux-audio-file-and-video-file
 */
private fun syntheticAudio(audioDuration: Long, videoDuration: Long, afdd: AssetFileDescriptor) {
    Log.d(TAG, "start syntheticAudio")
    val newFile = File(savePath, "$saveName.mp4")
    if (newFile.exists()) {
        newFile.delete()
    }
    try {
        newFile.createNewFile()
        val videoExtractor = MediaExtractor()
        videoExtractor.setDataSource(saveFile!!.absolutePath)
        val audioExtractor = MediaExtractor()
        afdd.apply {
            audioExtractor.setDataSource(fileDescriptor, startOffset, length * videoDuration / audioDuration)
        }
        val muxer = MediaMuxer(newFile.absolutePath, MediaMuxer.OutputFormat.MUXER_OUTPUT_MPEG_4)
        videoExtractor.selectTrack(0)
        val videoFormat = videoExtractor.getTrackFormat(0)
        val videoTrack = muxer.addTrack(videoFormat)

        audioExtractor.selectTrack(0)
        val audioFormat = audioExtractor.getTrackFormat(0)
        val audioTrack = muxer.addTrack(audioFormat)

        var sawEOS = false
        var frameCount = 0
        val offset = 100
        val sampleSize = 1000 * 1024
        val videoBuf = ByteBuffer.allocate(sampleSize)
        val audioBuf = ByteBuffer.allocate(sampleSize)
        val videoBufferInfo = MediaCodec.BufferInfo()
        val audioBufferInfo = MediaCodec.BufferInfo()

        videoExtractor.seekTo(0, MediaExtractor.SEEK_TO_CLOSEST_SYNC)
        audioExtractor.seekTo(0, MediaExtractor.SEEK_TO_CLOSEST_SYNC)

        muxer.start()

        // 每秒多少幀
        // 實測 OPPO R9em 垃圾手機,拿出來的沒有 MediaFormat.KEY_FRAME_RATE
        val frameRate = if (videoFormat.containsKey(MediaFormat.KEY_FRAME_RATE)) {
            videoFormat.getInteger(MediaFormat.KEY_FRAME_RATE)
        } else {
            31
        }
        // 得出平均每一幀間隔多少微妙
        val videoSampleTime = 1000 * 1000 / frameRate
        while (!sawEOS) {
            videoBufferInfo.offset = offset
            videoBufferInfo.size = videoExtractor.readSampleData(videoBuf, offset)
            if (videoBufferInfo.size < 0) {
                sawEOS = true
                videoBufferInfo.size = 0
            } else {
                videoBufferInfo.presentationTimeUs += videoSampleTime
                videoBufferInfo.flags = videoExtractor.sampleFlags
                muxer.writeSampleData(videoTrack, videoBuf, videoBufferInfo)
                videoExtractor.advance()
                frameCount++
            }
        }
        var sawEOS2 = false
        var frameCount2 = 0
        while (!sawEOS2) {
            frameCount2++
            audioBufferInfo.offset = offset
            audioBufferInfo.size = audioExtractor.readSampleData(audioBuf, offset)

            if (audioBufferInfo.size < 0) {
                sawEOS2 = true
                audioBufferInfo.size = 0
            } else {
                audioBufferInfo.presentationTimeUs = audioExtractor.sampleTime
                audioBufferInfo.flags = audioExtractor.sampleFlags
                muxer.writeSampleData(audioTrack, audioBuf, audioBufferInfo)
                audioExtractor.advance()
            }
        }
        muxer.stop()
        muxer.release()
        videoExtractor.release()
        audioExtractor.release()

        // 刪除無聲視頻文件
        saveFile?.delete()
    } catch (e: Exception) {
        Log.e(TAG, "Mixer Error:${e.message}")
        // 視頻添加音頻合成失敗,直接保存視頻
        saveFile?.renameTo(newFile)

    } finally {
        afdd.close()
        Handler().post {
            refreshVideo(newFile)
            saveFile = null
        }
    }
}

於是成就了錄屏幫助類 ScreenRecordHelper

經過各種兼容性測試,目前在 DAU 超過 100 萬的 APP 中穩定運行了兩個版本,於是抽出了一個工具類庫分享給大家,使用非常簡單,代碼註釋比較全面,感興趣的可以直接點擊鏈接進行訪問:https://github.com/nanchen2251/ScreenRecordHelper

使用就非常簡單了,直接把 [README] (https://github.com/nanchen2251/ScreenRecordHelper/blob/master/README.md) 貼過來吧。

Step 1. Add it in your root build.gradle at the end of repositories:
allprojects {
    repositories {
        ...
        maven { url 'https://jitpack.io' }
    }
}       
Step 2. Add the dependency
dependencies {
    implementation 'com.github.nanchen2251:ScreenRecordHelper:1.0.2'
}
Step 3. Just use it in your project
// start screen record
if (screenRecordHelper == null) {
    screenRecordHelper = ScreenRecordHelper(this, null, PathUtils.getExternalStoragePath() + "/nanchen")
}
screenRecordHelper?.apply {
    if (!isRecording) {
        // if you want to record the audio,you can set the recordAudio as true
        screenRecordHelper?.startRecord()
    }
}

// You must rewrite the onActivityResult
override fun onActivityResult(requestCode: Int, resultCode: Int, data: Intent?) {
    super.onActivityResult(requestCode, resultCode, data)
    if (Build.VERSION.SDK_INT >= Build.VERSION_CODES.LOLLIPOP && data != null) {
        screenRecordHelper?.onActivityResult(requestCode, resultCode, data)
    }
}
    
// just stop screen record
screenRecordHelper?.apply {
    if (isRecording) {
        stopRecord()     
    }
}
Step 4. if you want to mix the audio into your video,you just should do
// parameter1 -> The last video length you want
// parameter2 -> the audio's duration
// parameter2 -> assets resource
stopRecord(duration, audioDuration, afdd)
Step 5. If you still don’t understand, please refer to the demo

由於個人水平有限,雖然目前抗住了公司產品的考驗,但肯定還有很多地方沒有支持全面,希望有知道的大佬不嗇賜教,有任何兼容性問題請直接提 issues,Thx。

參考文章:http://lastwarmth.win/2018/11/23/media-mix/
https://juejin.im/post/5afaee7df265da0ba2672608

【精選推薦文章】

如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

想要讓你的商品在網路上成為最夯、最多人討論的話題?

網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師"嚨底家"!!

SpringCloud-分佈式配置中心【入門介紹】

案例代碼:https://github.com/q279583842q/springcloud-e-book

一、 為什麼需要使用配置中心

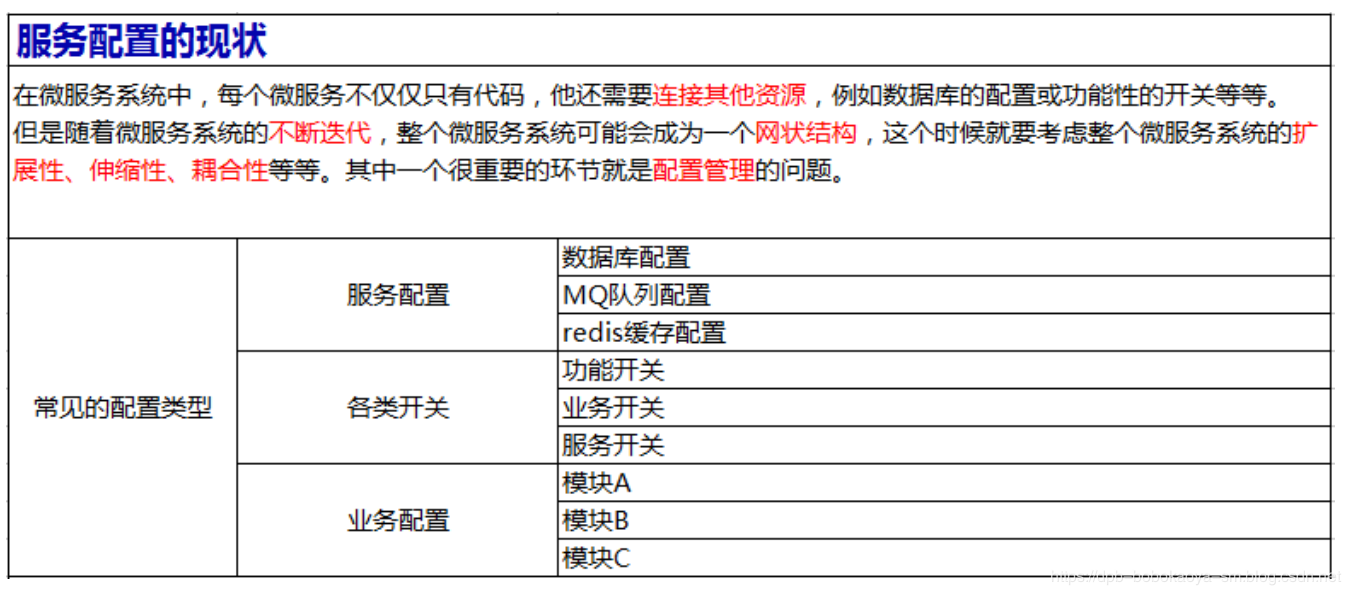
1 服務配置的現狀

2 常用的配置管理解決方案的缺點

3 為什麼要使用 spring cloud config 配置中心?

4 spring cloud config配置中心,它解決了什麼問題?

二、 編寫配置中心入門案例

1.編寫配置中心的服務端

1.1 創建服務端項目

  創建一個SpringCloud項目。

1.2 修改pom文件

  我們需要添加config-server的依賴,具體如下

<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
    xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <parent>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-parent</artifactId>
        <version>1.5.13.RELEASE</version>
    </parent>
    <groupId>com.bobo</groupId>
    <artifactId>config-server</artifactId>
    <version>0.0.1-SNAPSHOT</version>
    <dependencyManagement>
        <dependencies>
            <dependency>
                <groupId>org.springframework.cloud</groupId>
                <artifactId>spring-cloud-dependencies</artifactId>
                <version>Dalston.SR5</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
        </dependencies>
    </dependencyManagement>
    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.cloud</groupId>
            <artifactId>spring-cloud-starter-eureka</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.cloud</groupId>
            <artifactId>spring-cloud-config-server</artifactId>
        </dependency>
    </dependencies>
    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
    </build>
</project>

1.3 修改配置文件

  在此處的配置文件中我們需要關聯碼雲或者GitHub。以碼雲為例

碼雲處理

  首先我們需要在碼雲上註冊一個賬號(https://gitee.com) 然後創建一個新的項目。

配置文件處理

  在配置文件中添加如下配置

spring.application.name=config-server
server.port=9050
# 設置服務註冊中心地址,指向另一個註冊中心
eureka.client.serviceUrl.defaultZone=http://dpb:123456@eureka1:8761/eureka/,http://dpb:123456@eureka2:8761/eureka/

#Git 配置
spring.cloud.config.server.git.uri=https://gitee.com/dengpbs/config
#spring.cloud.config.server.git.username=
#spring.cloud.config.server.git.password=

創建四個配置文件

四個配置文件都有一個e-book屬性,只是值不一樣。然後將這個四個配置文件上傳到碼雲中我們新創建的倉庫

然後將項目中的四個配置文件刪除

1.4 修改啟動類

  我們需要在啟動類中添加eureka客戶端和config服務端的註解,具體如下:

@SpringBootApplication
@EnableEurekaClient
@EnableConfigServer
public class ConfigServerStart {

    public static void main(String[] args) {
        SpringApplication.run(ConfigServerStart.class, args);
    }
}

1.5 訪問測試

  啟動服務,訪問測試
http://localhost:9050/config-client/test

http://localhost:9050/config-client/default

http://localhost:9050/config-client/dev

通過訪問,我們獲取到了位於碼雲倉庫中的屬性信息。

1.6 配置文件的命名規則與訪問

  注意,上面案例中的配置文件的名稱,並不是隨便命名的,而是有一定的規則來約束的,具體如下:

2.編寫客戶端程序

2.1 創建項目

  創建一個SpringCloud項目

2.2 pom文件修改

  配置中心的客戶端使用的依賴需要注意,不是config-server了,具體如下:

<project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
    xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">
    <modelVersion>4.0.0</modelVersion>
    <parent>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-parent</artifactId>
        <version>1.5.13.RELEASE</version>
    </parent>
    <groupId>com.bobo</groupId>
    <artifactId>config-client</artifactId>
    <version>0.0.1-SNAPSHOT</version>
    <dependencyManagement>
        <dependencies>
            <dependency>
                <groupId>org.springframework.cloud</groupId>
                <artifactId>spring-cloud-dependencies</artifactId>
                <version>Dalston.SR5</version>
                <type>pom</type>
                <scope>import</scope>
            </dependency>
        </dependencies>
    </dependencyManagement>
    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.cloud</groupId>
            <artifactId>spring-cloud-starter-eureka</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.cloud</groupId>
            <artifactId>spring-cloud-starter-config</artifactId>
        </dependency>
    </dependencies>
    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
    </build>
</project>

2.3 修改配置文件

  注意在配置中心的客戶端服務中,配置文件的名稱必須是bootstrap.properties或者bootstrap.yml文件。
官方解釋:

Spring Cloud 構建於 Spring Boot 之上,在 Spring Boot 中有兩種上下文,一種是 bootstrap, 另外一種是 application, bootstrap 是應用程序的父上下文,也就是說 bootstrap 加載優先於 applicaton。bootstrap 主要用於從額外的資源來加載配置信息,還可以在本地外部配置文件中解密屬性。這兩個上下文共用一個環境,它是任何Spring應用程序的外部屬性的來源。bootstrap 裏面的屬性會優先加載,它們默認也不能被本地相同配置覆蓋。

spring.application.name=config-client
server.port=9051
#設置服務註冊中心地址,指向另一個註冊中心
eureka.client.serviceUrl.defaultZone=http://dpb:123456@eureka1:8761/eureka/,http://dpb:123456@eureka2:8761/eureka/

#默認 false,這裏設置 true,表示開啟讀取配置中心的配置
spring.cloud.config.discovery.enabled=true
#對應 eureka 中的配置中心 serviceId,默認是 configserver
spring.cloud.config.discovery.serviceId=config-server
#指定環境
spring.cloud.config.profile=dev
#git 標籤
spring.cloud.config.label=master

2.4 修改啟動類

@SpringBootApplication
@EnableEurekaClient
public class ConfigClientStart {

    public static void main(String[] args) {
        SpringApplication.run(ConfigClientStart.class, args);
    }
}

2.5 創建控制器

  在控制中我們嘗試獲取配置中心的數據,具體如下:

@RestController
public class ShowController {
    
    @Value("${e-book}")
    private String msg;
    
    @RequestMapping("/showMsg")
    public String showMsg(){
        return msg;
    }
}

2.6 啟動測試

訪問:http://localhost:9051/showMsg

搞定~

【精選推薦文章】

自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

python算法與數據結構-順序表(37)


1、順序表介紹

  順序表是最簡單的一種線性結構,邏輯上相鄰的數據在計算機內的存儲位置也是相鄰的,可以快速定位第幾個元素,中間不允許有空,所以插入、刪除時需要移動大量元素。順序表可以分配一段連續的存儲空間Maxsize,用elem記錄基地址,用length記錄實際的元素個數,即順序表的長度, 

  上圖1表示的是順序表的基本形式,數據元素本身連續存儲,每個元素所佔的存儲單元大小固定相同,元素的下標是其邏輯地址,而元素存儲的物理地址(實際內存地址)可以通過存儲區的起始地址Loc (e0)加上邏輯地址(第i個元素)與存儲單元大小(c)的乘積計算而得,即:Loc(element i) = Loc(e0) + c*i

所以、訪問指定元素時無需從頭遍歷,通過計算便可獲得對應地址,其時間複雜度為O(1)。

  如果元素的大小不統一,則須採用圖2的元素外置的形式,將實際數據元素另行存儲,而順序表中各單元位置保存對應元素的地址信息(即鏈接)。由於每個鏈接所需的存儲量相同,通過上述公式,可以計算出元素鏈接的存儲位置,而後順着鏈接找到實際存儲的數據元素。注意,圖2中的c不再是數據元素的大小,而是存儲一個鏈接地址所需的存儲量,這個量通常很小。

圖2這樣的順序表也被稱為對實際數據的索引,這是最簡單的索引結構。

2、順序表的結構 


  一個順序表的完整信息包括兩部分,一部分是表中的元素集合,另一部分是為實現正確操作而需記錄的信息,即有關表的整體情況的信息,這部分信息主要包括元素存儲區的容量和當前表中已有的元素個數兩項。

3、順序表的兩種基本實現方式

  1為一體式結構,存儲表信息的單元與元素存儲區以連續的方式安排在一塊存儲區里,兩部分數據的整體形成一個完整的順序表對象。一體式結構整體性強,易於管理。但是由於數據元素存儲區域是表對象的一部分,順序表創建后,元素存儲區就固定了。

  2為分離式結構,表對象里只保存與整個表有關的信息(即容量和元素個數),實際數據元素存放在另一個獨立的元素存儲區里,通過鏈接與基本表對象關聯。

 4、元素存儲區替換

  一體式結構由於順序表信息區與數據區連續存儲在一起,所以若想更換數據區,則只能整體搬遷,即整個順序表對象(指存儲順序表的結構信息的區域)改變了。分離式結構若想更換數據區,只需將表信息區中的數據區鏈接地址更新即可,而該順序表對象不變。

5、元素存儲區擴充

  採用分離式結構的順序表,若將數據區更換為存儲空間更大的區域,則可以在不改變表對象的前提下對其數據存儲區進行了擴充,所有使用這個表的地方都不必修改。只要程序的運行環境(計算機系統)還有空閑存儲,這種表結構就不會因為滿了而導致操作無法進行。人們把採用這種技術實現的順序表稱為動態順序表,因為其容量可以在使用中動態變化。

擴充的兩種策略

  • 每次擴充增加固定數目的存儲位置,如每次擴充增加10個元素位置,這種策略可稱為線性增長。

    特點:節省空間,但是擴充操作頻繁,操作次數多。

  • 每次擴充容量加倍,如每次擴充增加一倍存儲空間。

    特點:減少了擴充操作的執行次數,但可能會浪費空間資源。以空間換時間,推薦的方式。

6、順序表的增刪改查操作的Python代碼實現

# 創建順序表
class Sequence_Table():
    
    # 初始化
    def __init__(self):
        self.date = [None]*100
        self.length = 0
    
    # 判斷是否已經滿了
    def isFull(self):
        if self.length>100:
            print("該順序表已滿,無法添加元素")
            return 1
        else:
            return 0
    
    # 按下錶索引查找
    def selectByIndex(self,index):
        if index>=0 and index<=self.length-1:
            return self.date[index]
        else:
            print("你輸入的下標不對,請重新輸入\n")
            return 0
        
    # 按元素查下標
    def selectByNum(self,num):
        isContain = 0
        for i in range(0,self.length):
            if self.date[i] == num:
                isContain = 1
                print("你要查找的元素下標是%d\n"%i)
        if isContain == 0:
            print("沒有找你你要的數據")
    
    # 追加數據
    def addNum(self,num):
        if self.isFull() == 0:
            self.date[self.length] = num
            self.length += 1
            
    # 打印順序表
    def printAllNum(self):
        for i in range(self.length):
            print("a[%s]=%s"%(i,self.date[i]),end=" ")
        print("\n")
        
    # 按下標插入數據
    def insertNumByIndex(self,num,index):
        if index<0 or index>self.length:
            return 0
        self.length += 1
        for i in range(self.length-1,index,-1):
            temp = self.date[i]
            self.date[i] = self.date[i-1]
            self.date[i-1] = temp
        self.date[index] = num
        return 1
    # 按下標刪除數據
    def delectNumByIndex(self,index):
        if self.length <= 0:
            print("該順序表內沒有數據,不用刪除")
            
        for i in range(index,self.length-1):
            temp = self.date[i]
            self.date[i] = self.date[i + 1]
            self.date[i + 1] = temp
        self.date[self.length-1] = 0
        self.length -= 1

def main():
    # 創建順序表對象
    seq_t = Sequence_Table()
    
    # 插入三個元素
    seq_t.addNum(1)
    seq_t.addNum(2)
    seq_t.addNum(3)
    
    # 打印驗證
    seq_t.printAllNum()
    
    # 按照索引查找
    num = seq_t.selectByIndex(2)
    print("你要查找的數據是%d\n" % num)
    
    # 按照索引插入數據
    seq_t.insertNumByIndex(4, 1)
    seq_t.printAllNum()
    
    # 按照数字查下標
    seq_t.selectByNum(4)
    
    #刪除數據
    seq_t.delectNumByIndex(1)
    seq_t.printAllNum()
     
if __name__ == "__main__":
    main()

運行結果為:

a[0]=1 a[1]=2 a[2]=3 

你要查找的數據是3

a[0]=1 a[1]=4 a[2]=2 a[3]=3 

你要查找的元素下標是1

a[0]=1 a[1]=2 a[2]=3 

7、順序表的增刪改查操作的C語言代碼實現

#include<stdio.h>
// 1、定義順序表的儲存結構
typedef struct
{
    //用數組存儲線性表中的元素
    int data[100];
    // 順序表中的元素個數
    int length;
}Sequence_table,*p_Sequence_table;

// 2、順序表的初始化,
void initSequenceTable(p_Sequence_table T)
{
    // 判斷傳過來的表是否為空,為空直接退出
    if (T == NULL)
    {
        return;
    }
    // 設置默認長度為0
    T->length = 0;
}

// 3、求順序表的長度
int lengthOfSequenceTable(p_Sequence_table T)
{
    if (T==NULL)
    {
        return 0;
    }
    return T->length;
}

// 4、判斷順序表是否已滿
int isFull(p_Sequence_table T)
{
    if (T->length>=100)
    {
        printf("該順序表已經裝滿,無法再添加元素");
        return 1;
    }
    return 0;
}

// 5、按序號查找
int selectSequenceTableByIndex(p_Sequence_table T,int index)
{
    if (index>=0&&index<=T->length-1)
    {
        return T->data[index];
    }
    printf("你輸入的序號不對,請重新輸入\n");
    return 0;
}

// 6、按內容查找是否存在
void selectSequenceTableByNum(p_Sequence_table T,int num)
{
    int isContain = 0;
    for (int i=0; i<T->length; i++)
    {
        if (T->data[i] == num)
        {
            isContain = 1;
            printf("你要找的元素的下標是:%d\n",i);
        }
    }
    if (isContain == 0)
    {
        printf("沒有找到你要的數據\n");
    }
}

// 7、添加元素(在隊尾添加)
void addNumber(p_Sequence_table T,int num)
{
    // 順序表還沒有滿的時候
    if (isFull(T) == 0)
    {
        T->data[T->length] = num;
        T->length++;
    }
}

// 8、順序表的遍歷
void printAllNumOfSequenceTable(p_Sequence_table T)
{
    for (int i = 0; i<T->length; i++)
    {
        printf("T[%d]=%d ",i,T->data[i]);
    }
    printf("\n");
}

//9、插入操作
int insertNumByIndex(p_Sequence_table T, int num,int index)
{
    if (index<0||index>T->length)
    {
        return 0;
    }
    T->length++;
    for (int i = T->length-1; i>index; i--)
    {
        int temp = T->data[i];
        T->data[i] = T->data[i-1];
        T->data[i-1] = temp;
    }
    T->data[index] = num;
    return 1;
}

// 10、刪除元素
void delectNum(p_Sequence_table T,int index)
{
    if (T->length <= 0)
    {
        printf("該順序表中沒有數據,不用刪除");
    }
    for (int i = index;i<T->length-1; i++)
    {
        int temp = T->data[i];
        T->data[i] = T->data[i+1];
        T->data[i+1] = temp;
    }
    T->data[T->length-1] = 0;
    T->length--;
}


int main(int argc, const char * argv[]) {
    
    // 創建順序表的結構體
    Sequence_table seq_t;
    // 初始化
    initSequenceTable(&seq_t);
    // 添加數據
    addNumber(&seq_t, 1);
    addNumber(&seq_t, 2);
    addNumber(&seq_t, 3);
    // 打印驗證
    printAllNumOfSequenceTable(&seq_t);
    // 根據索引下標查內容
    int num = selectSequenceTableByIndex(&seq_t, 2);
    printf("你查的數據是:%d\n",num);
    // 插入
    insertNumByIndex(&seq_t, 4, 1);
    printAllNumOfSequenceTable(&seq_t);
    // 根據內容查下標
    selectSequenceTableByNum(&seq_t, 4);
    // 根據下標刪除數據
    delectNum(&seq_t, 1);
    printAllNumOfSequenceTable(&seq_t);
    return 0;
}

運行結果為:

T[0]=1 T[1]=2 T[2]=3 
你查的數據是:3
T[0]=1 T[1]=4 T[2]=2 T[3]=3 
你要找的元素的下標是:1
T[0]=1 T[1]=2 T[2]=3 


【精選推薦文章】

智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

帶您來看台北網站建置,台北網頁設計,各種案例分享

廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益